入门机器学习(十八)--异常检测(Anomaly Detection)
异常检测(Anomaly Detection)
1. 问题动机(Problem Motivation)
什么是异常检测呢?顾名思义,就是在正常的数据中检测出发生异常的数据,我们来看一个例子:
假如你是一个飞机引擎的制造商,当你生产的飞机引擎从生厂线上流出时,你需要进行质量检测,你测量了飞机引擎的一些特征变量,比如引擎运转时产生的热量,或者引擎的振动等。这样一来,我们就有了一个数据集,从
x
(
1
)
x^{(1)}
x(1)到
x
(
m
)
x^{(m)}
x(m),如果你生产了m个引擎的话,我们将得到下面这个数据图表:
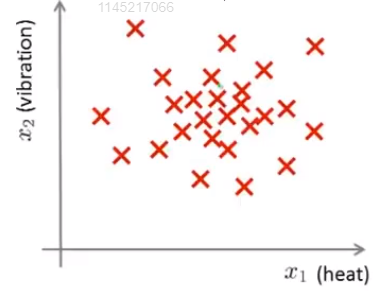
这里的每个数据都是无标签数据,假如每个数据都是正常引擎的测试数据,如果有一天,有两个新的飞机引擎的测试数据被绘制到了这个图中,如下图中绿色的标记所示:
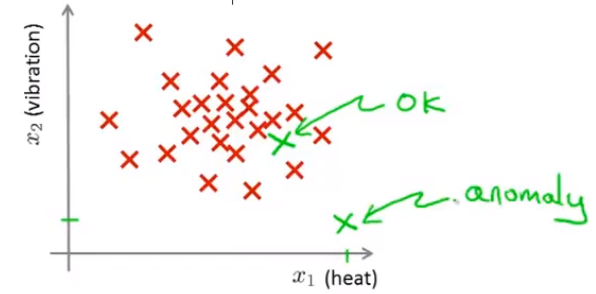
我们可以很清晰的知道特征靠近中心的引擎大概率是正常的,而偏离数据中心的引擎大概率是异常的,需要进行进一步的测试。
给定数据集
x
(
1
)
x^{(1)}
x(1),
x
(
2
)
x^{(2)}
x(2),…,
x
(
m
)
x^{(m)}
x(m),我们假设数据集是正常的,我们希望知道新的数据
x
t
e
s
t
x_{test}
xtest是不是异常的,即这个测试数据不属于改组数据的几率如何。我们所构建的模型应该能根据该测试数据的位置告诉我们其属于一组数据的可能性p(x)。
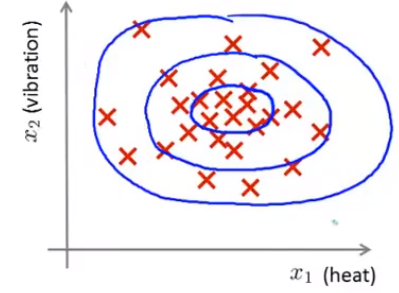
上图中,在蓝色圈内的数据属于该组数据的可能性较高,而越是偏远的数据,其属于该组数据的可能性就越低。这种方法称为密度估计,表达如下:
i
f
p
(
x
)
{
<
ε
a
n
o
m
a
l
y
≥
ε
n
o
r
m
a
l
if p(x)\begin{cases}<\varepsilon\quad anomaly\\ \geq\varepsilon \quad normal \end{cases}
ifp(x){<εanomaly≥εnormal
异常检测的主要应用是识别欺诈,例如在线采集的有关用户的数据,一个特征向量中可能会包含如:用户多久登录一次,访问过的页面,发帖子的数量等。尝试根据这些特征构建一个模型,可以用这个模型来识别哪些不符合该模式的用户。
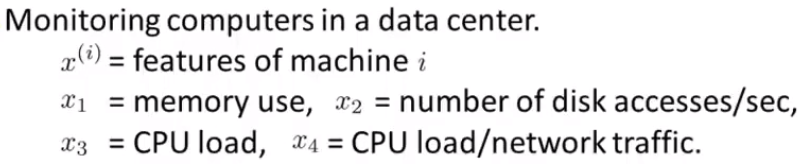
还有一个应用例子是检测一个数据中心,特征可能包含:内存使用情况,被访问的磁盘数量,CPU的负载,网络的通信量等。根据这些可以构建一个模型,用来判断某些计算机是不是有可能出错了。
2. 高斯分布(Gaussian Distribution)
高斯分布也称为正态分布。通常如果我们认为变量x符合高斯分布x~N(
μ
,
δ
2
\mu,\delta^2
μ,δ2),则其概率密度函数为:
p
(
x
,
μ
,
δ
2
)
=
1
2
π
σ
e
x
p
(
−
(
x
−
μ
)
2
2
σ
2
)
p(x,\mu,\delta^2)=\frac{1}{\sqrt{2\pi}\sigma}exp(-\frac{(x-\mu)^2}{2\sigma^2})
p(x,μ,δ2)=2πσ1exp(−2σ2(x−μ)2)
我们可以利用已有的数据来预测总体中的
μ
\mu
μ和
σ
2
\sigma^2
σ2的计算方法如下:
μ
=
1
m
∑
i
=
0
m
x
(
i
)
\mu=\frac{1}{m}\sum_{i=0}^mx^{(i)}
μ=m1i=0∑mx(i)
σ
2
=
1
m
∑
i
=
1
m
(
x
(
i
)
−
μ
)
2
\sigma^2=\frac{1}{m}\sum_{i=1}^m(x^{(i)}-\mu)^2
σ2=m1i=1∑m(x(i)−μ)2
不同的
μ
\mu
μ和
σ
\sigma
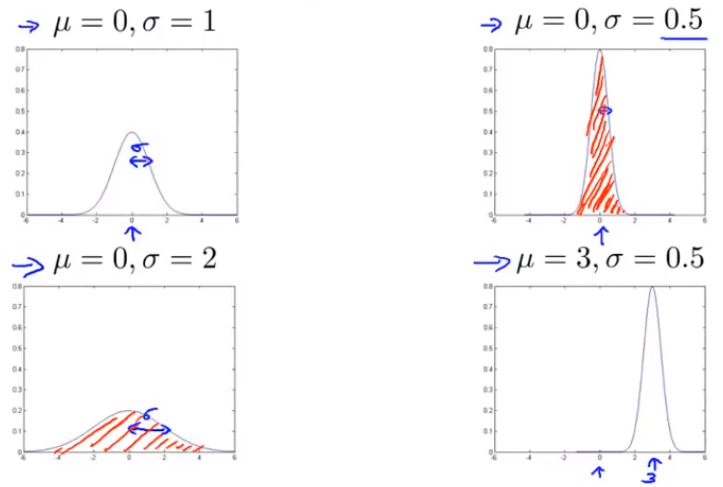
σ下,高斯分布的样例:
3. 算法(Algorithm)
异常检测的算法是怎样的呢?对于给定的数据集
x
(
1
)
x^{(1)}
x(1),
x
(
2
)
x^{(2)}
x(2),…,
x
(
m
)
x^{(m)}
x(m),我们要对每一个特征计算
μ
\mu
μ和
σ
\sigma
σ的估计值:
μ
=
1
m
∑
i
=
0
m
x
(
i
)
\mu=\frac{1}{m}\sum_{i=0}^mx^{(i)}
μ=m1i=0∑mx(i)
σ
2
=
1
m
∑
i
=
1
m
(
x
(
i
)
−
μ
)
2
\sigma^2=\frac{1}{m}\sum_{i=1}^m(x^{(i)}-\mu)^2
σ2=m1i=1∑m(x(i)−μ)2
一旦我们获得了平均值和方差的估计值,给定了新的一个训练实例,根据模型计算
p
(
x
)
p(x)
p(x):
p
(
x
)
=
∏
j
=
1
n
p
(
x
j
;
μ
j
,
σ
j
2
)
=
∏
j
=
1
1
1
2
π
σ
e
x
p
(
−
(
x
−
μ
)
2
2
σ
2
)
p(x)=\prod_{j=1}^np(x_j;\mu_j,\sigma_j^2)=\prod_{j=1}^1\frac{1}{\sqrt{2\pi}\sigma}exp(-\frac{(x-\mu)^2}{2\sigma^2})
p(x)=j=1∏np(xj;μj,σj2)=j=1∏12πσ1exp(−2σ2(x−μ)2)
当
p
(
x
)
<
ε
p(x)<\varepsilon
p(x)<ε时,数据为异常。
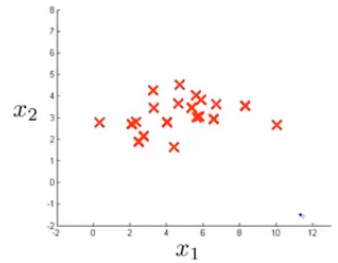
下面举个例子,下图所示是一个由两个特征的训练集,以及特征的分布情况:
两个特征
x
1
x_1
x1和
x
2
x_2
x2的平均值和偏差如下所示:
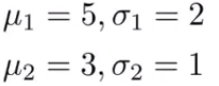
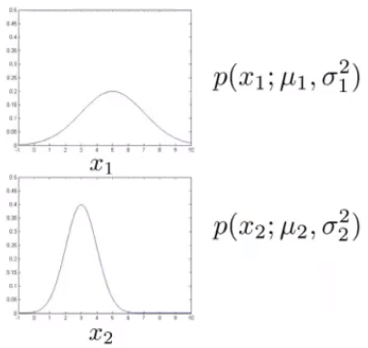
概率分布如下图所示:
下图表示的是密度估计函数,z轴为根据两个特征值所估计的
p
(
x
)
p(x)
p(x)的值。
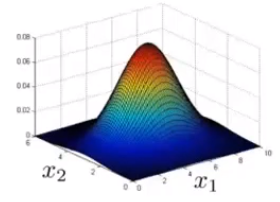
我们在图中可以选择一个
ε
\varepsilon
ε,将
p
(
x
)
=
ε
p(x)=\varepsilon
p(x)=ε作为我们的判定边界,当
p
(
x
)
>
ε
p(x)>\varepsilon
p(x)>ε时预测数据为正常数据,否则为异常数据。
4. 开发和评价一个异常检测系统(Developing and Evaluating an Anomaly Detection System)
异常检测算法是一个非监督学习算法,意味着我们无法根据结果变量y的值来告诉我们数据是否真的是异常的。我们需要另一种方法来帮助检验算法是否有效。当我们开发一个异常检测系统时,我们从带标记的数据着手,从其中选择一部分正常数据用于构建训练集,然后用剩下的正常数据和异常数据混合的数据构成交叉验证集和测试集。
举个栗子:
我们有10000台正常工作的引擎的数据,有20台异常引擎的数据,我们这样分配数据:
6000台正常引擎的数据作为训练集;2000台正常引擎和10台异常引擎的数据作为交叉验证集;2000台正阳引擎和10台异常引擎的数据作为测试集。
具体的评价方法如下:
- 根据测试集数据,我们估计特征的平均值和方差并构建p(x)函数;
- 对交叉验证集,我们尝试使用不用的 ε \varepsilon ε值作为阈值,并预测数据是否异常,根据F1值或者查准率与查全率的比例来选择 ε \varepsilon ε;
- 选出 ε \varepsilon ε后,针对测试集进行预测,计算异常检验系统的F1值,或者查准率和查全率之比。
5. 异常检测与监督学习对比(Anomaly Detection vs. Supervised Learning)
我们构建的异常监测系统也是用了带标记的数据,与监督学习有些相似,下面的对比有助于选择采用监督学习还是异常检测:
两者比较:
| 异常检测 | 监督学习 |
|---|---|
| 非常少量的正向类(异常数据y=1),大量的负向类(y=0) | 同时有大量的正向类和负向类 |
| 许多不同种类的异常,非常难。根据非常少的正向类数据来训练算法 | 有足够多的正向类实例,足够用于训练算法,未来遇到的正向类实例可能与训练集中的非常相似 |
| 未来遇到的异常可能与已掌握的异常非常的不同 | 未来遇到的负向类与已知负向类差别不大 |
| 例如:欺诈行为检测,检测数据中心的计算机运行状况 | 邮件过滤器,天气预报,肿瘤分类等 |
6. 选择特征(Choosing What Features to Use)
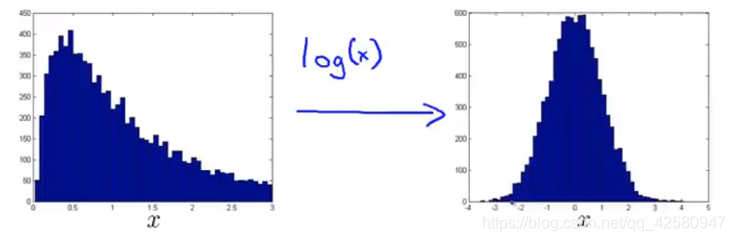
对于异常检测算法,我们使用的特征是至关重要的。异常检测假设特征符合高斯分布,如果数据的分布不是高斯分布,异常算法也能够正常工作,但是最好还是将数据转换成高斯分布。如下图所示,我们可以通过一些转变比如说log(x)将左图中的非高斯分布转换成右图所示的类高斯分布。相似的变换有比如
l
o
g
(
x
+
1
)
log(x+1)
log(x+1),
x
c
x^c
xc等等方法。在Python中,通常用np.log1p()函数,log1p就是log(x+1),可以避免出现负数结果。
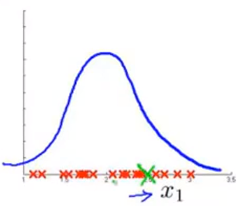
一个常见的问题就是:一些异常的值可能也会有比较高的p(x)值,因而算法认为是正常的。如下图所示, 假设绿色的点时异常的点但是在
x
1
x_1
x1上的
p
(
x
)
p(x)
p(x)比较高,所以我们可能需要增加一些新的特征。
加入我们增加了一个新的特征
x
2
x_2
x2,绿色的点在新的二维特征上的分布如下所示:
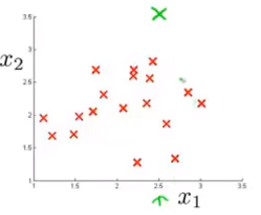
增加新的特征后获得的新算法能够帮助我们更好地进行异常检测。我们通常可以通过将一些相关的特征进行组合,来获得一些新的更好的特征(异常数据的该特征值异常地大或小),例如,在检测数据中心的计算机状况的例子中,我们可以用CPU负载与网络通信量的比例作为一个新的特征,如果该值异常地大,便有可能是服务器出现了一些问题。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献7条内容

所有评论(0)