企业微信智能客服的挑战与实现(三):知识库与AI自主学习
摘要:智能客服的下限由对话机制决定,上限由知识库决定。而企业知识库有两个老大难:一是企业的说明书天然是图文并茂的,传统机器人知识库只吃纯文本——"第一步看这张图、第二步看那张图"的内容根本进不去;二是知识是活的,业务天天变,上线时精心构建的知识库,三个月后就开始过时,越过时越没人用,越没人用越没动力维护,系统就这样慢慢废掉。本文是系列完结篇,继续以 冰石机器人(官网 icestonebot.com) 为例,拆解三级应答链路、图文知识库导入的完整流水线,以及用 AI 自主学习让知识库自动保鲜的机制。
本系列共三篇:
① 人机协同——机器人客服与真人客服如何共处一个会话
② 专属客户群与拟人化体验——让企微客服更像"一个团队在服务"
③(本篇)知识库与 AI 自主学习
一、三级应答链路:不是所有问题都值得调大模型
先看机器人收到一条客户消息后的应答决策。冰石机器人采用关键词 → FAQ → 大模型的三级链路:
- 第一级 关键词:精确/包含匹配,命中即回预设话术。适合"报价"“地址”"营业时间"这类答案完全固定的问题。零成本、零延迟、零幻觉;
- 第二级 FAQ:常见问题库的模糊匹配(算法见下),命中即回标准答案。本地计算,同样不花大模型的钱;
- 第三级 大模型:前两级都没接住的,才交给大模型自由应答——而且发给大模型的上下文里会带上 FAQ/商品库中匹配到的候选知识和最近聊天记录(默认 15 条),让它有据可答。
这个设计的经济账很清楚:客服流量里高频重复问题占大头,让便宜的机制消化大头,大模型只处理真正需要理解力的长尾。
FAQ 这一级的匹配算法值得一说。冰石机器人没有用 embedding 向量检索,而是一套零依赖的字面相似度加权融合:
相似度 = 0.4 × 词频余弦相似度      (jieba 分词 + 去停用词后的词频向量)
       + 0.3 × Jaccard 相似度      (词集合交并比)
       + 0.2 × 编辑距离相似度      (字符级序列相似)
       + 0.1 × 关键词命中得分      (命中 FAQ 配置的关键词)
阈值 0.6 判命中;标记"优先级"的 FAQ 得分 ×1.1 加成。四路融合的用意:余弦看用词重合,Jaccard 看词集合覆盖,编辑距离兜底近形句(错别字、语序颠倒),关键词项让运营可以人工干预召回——给 FAQ 配上"喷头堵了""不出墨"这类口语词,客户怎么说都能命中。
为什么不用向量检索?企业客服的 FAQ 库通常几百到几千条,字面加权 + 关键词人工兜底在这个量级上效果够用,还省掉了 embedding 模型的部署成本和延迟。工程上"够用的简单方案"优于"先进的复杂方案"。另外系统同时维护了一份 SQLite FTS5 全文索引(BM25),用于给大模型注入上下文时的候选召回——两条检索通道各司其职。
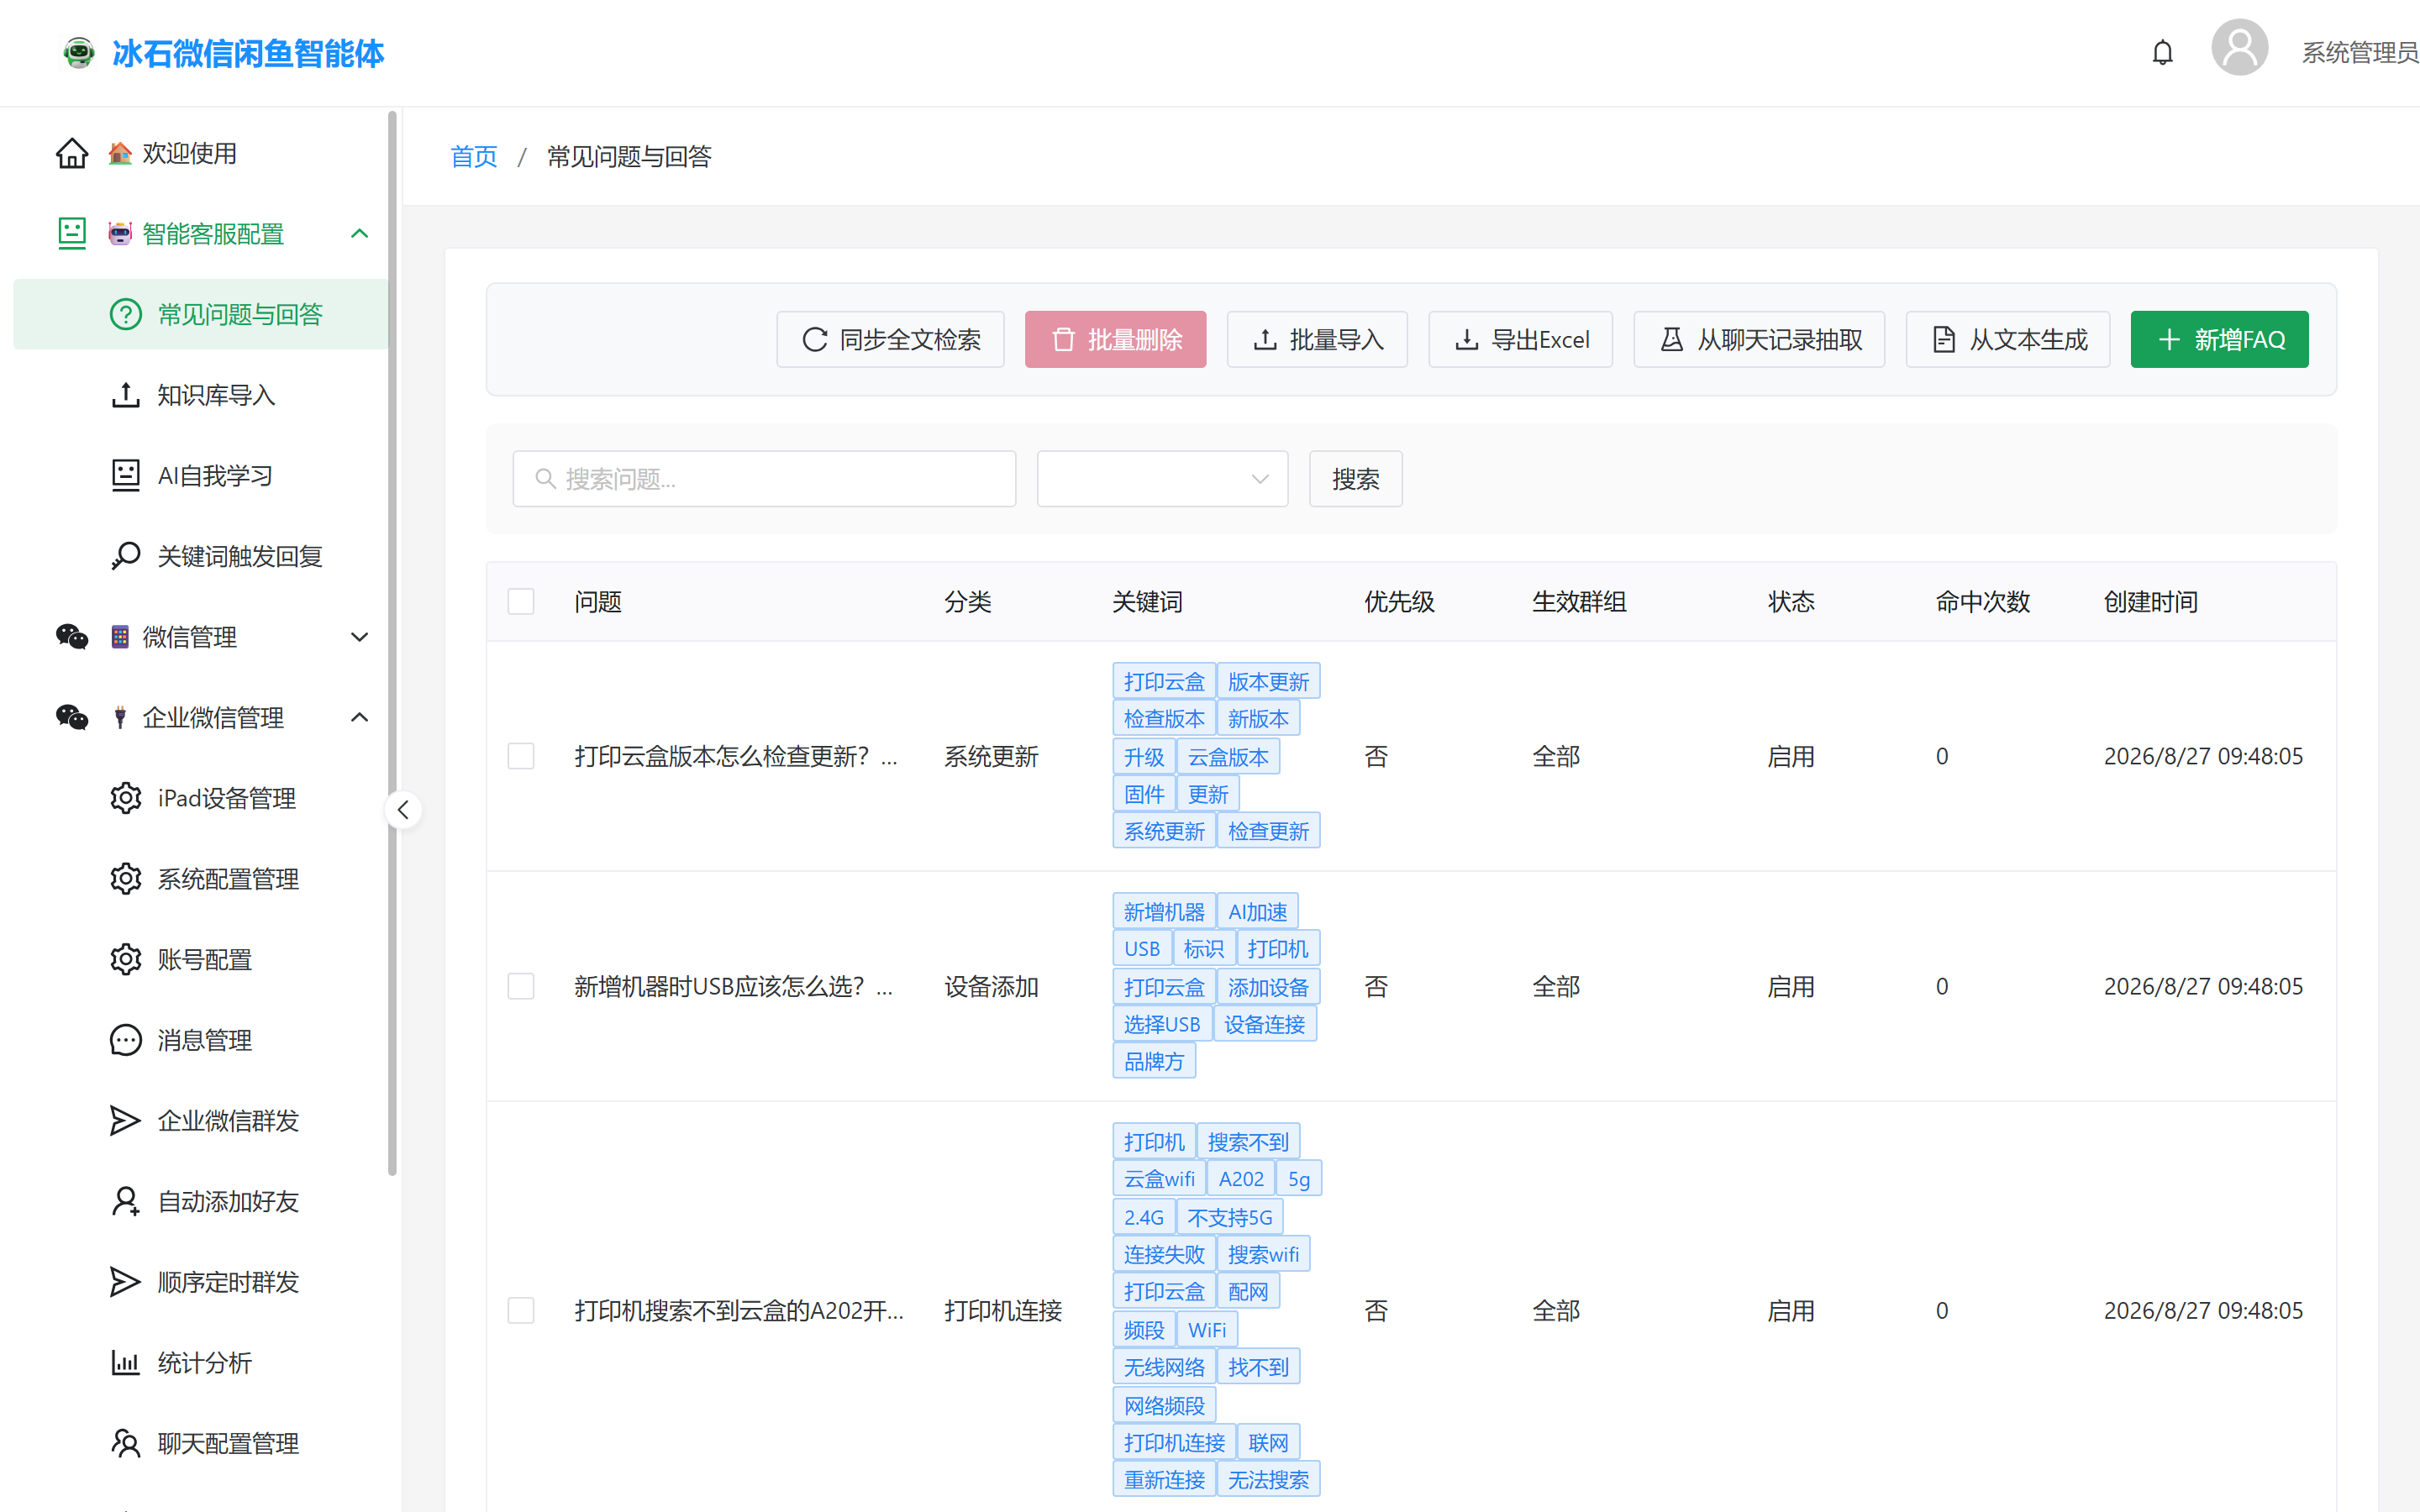
上图是实际运行中的 FAQ 库:每条问答带分类、一组关键词标签、优先级和命中统计。注意这些条目的来源——它们大部分不是人工录入的,而是接下来两节要讲的文档导入和AI 自主学习自动生成的。
二、图文并茂的知识库:从 Word 说明书到交错回复
2.1 痛点:说明书是图文的,知识库是纯文本的
企业最好的知识素材是现成的产品说明书——通常是 Word 文档,图文交错:“第一步,打开设置页(配图1),点击右上角(配图2)……”
传统机器人知识库只能存文本,最多对图片做个 OCR 提文字。结果就是:要么把图丢掉(客户对着纯文字根本操作不来),要么运营被迫把说明书手工拆成一条条问答再想办法塞图——构建成本高到劝退。
冰石机器人的知识库导入功能把这条路打通了:把 Word 文档原样丢进去,系统自动拆出图文问答;客户问到时,一段文字一张图交错发出,还原说明书的阅读体验。
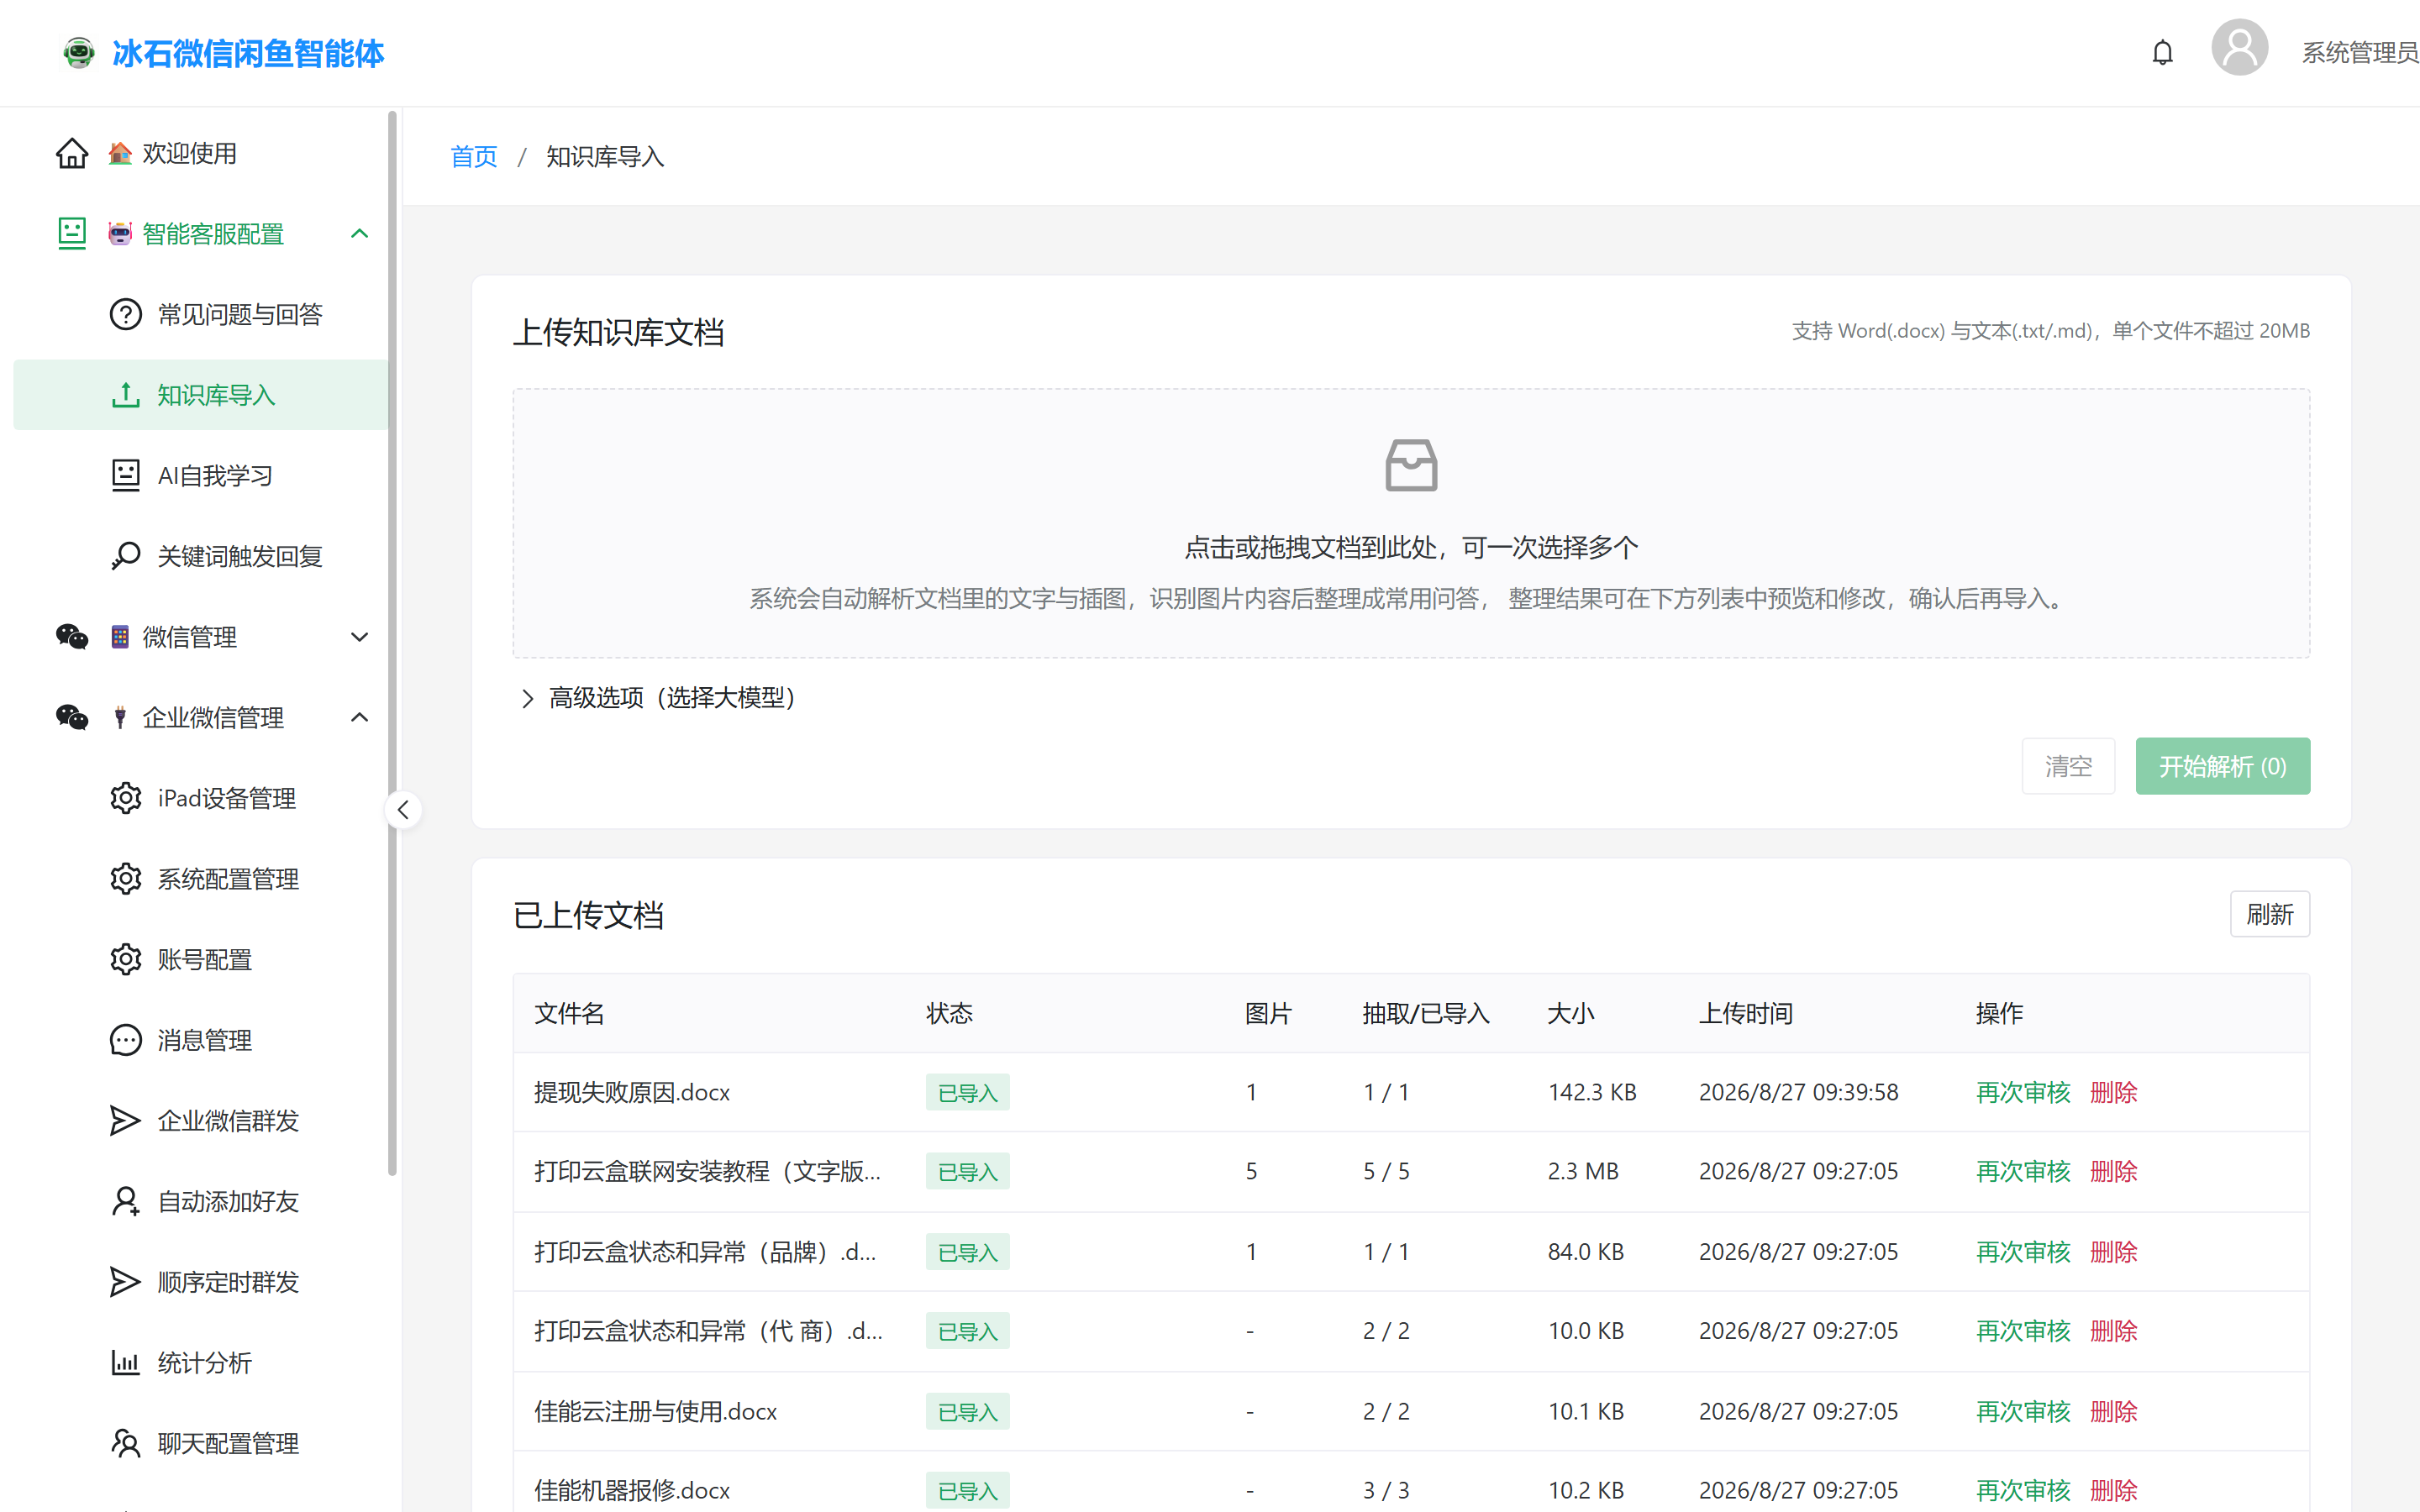
支持 .docx / .txt / .md,单文件 ≤20MB,单文档识图上限 60 张。上传后全自动解析,解析完成可以逐条预览、修改,确认后导入 FAQ 库。
2.2 流水线拆解:保序是灵魂
整条导入流水线有五步,每一步都藏着实战细节:
第一步:保序解析 docx。
最关键的要求是图片必须待在它原来的位置——"第三步"的配图错位到"第五步"后面,教程就废了。常见的 python-docx 用法 document.paragraphs 有两个坑:会丢掉表格,且无法保证段落与表格的相对顺序。冰石机器人的做法是绕过高层 API、直接顺序遍历文档 XML 的 body 子元素:
for block in body.iterchildren():          # 严格按文档顺序
    if block is paragraph:
        emit_text(paragraph_text(block))   # 保留制表符/换行
        for image in images_in(block):     # 段内引用的图片
            emit_line(f"[图|{image.filename}]")   # 占位行,紧跟所属段落
    elif block is table:
        emit_text(render_table(block))     # 表格渲染成 | a | b | 文本
图片抽取同时兼容 Word 的两种嵌图格式(新版 DrawingML 和老文档常见的 VML);小于 1.5KB 的小图(分隔线、logo 装饰)自动跳过;tif/bmp/svg 等非 Web 格式统一转成 png——最后这条还有个安全动机:图片要落到 Web 可访问的静态目录里,svg 这类"能执行脚本的图片"绝不能原样落盘。
第二步:识图模型标注。
纯靠 LLM 看"[图|img05.png]"这样的占位行,它不知道图里是什么,也就没法正确决定这张图属于哪个问答。所以导入前先用视觉模型逐张标注,把结果以注释行插回原位:
[图片|faq_media/doc_108/img05.png|界面文字:检查更新 当前版本 v2.3|画面:云盒设置页面,右上角有检查更新按钮]
标注提示词里有一条很有意思的硬要求:界面截图必须逐字抄录界面上的文字,一个字都不许改写——因为客户会照着屏幕上的字来提问,改写了就搜不到了。
第三步:大模型抽取问答对。
带着图片标注的全文交给大模型,抽取成"问题 + 答案 + 关键词"。图片以媒体行格式内嵌在答案里,独占一行:
[媒体|image|faq_media/doc_108/img05.png|打印云盒联网第六步中检查云盒版本并更新到新版本的界面]
长文档按约 2.8 万字分批处理,切分点有一条铁律:图片注释行不能和它前面的段落切开——否则跨批次的图就"失联"了。大模型偶尔漏引用的图片,系统还会按上下文自动挂到最相关的问答末尾兜底。
导入后的成品长这样(实际生产数据):
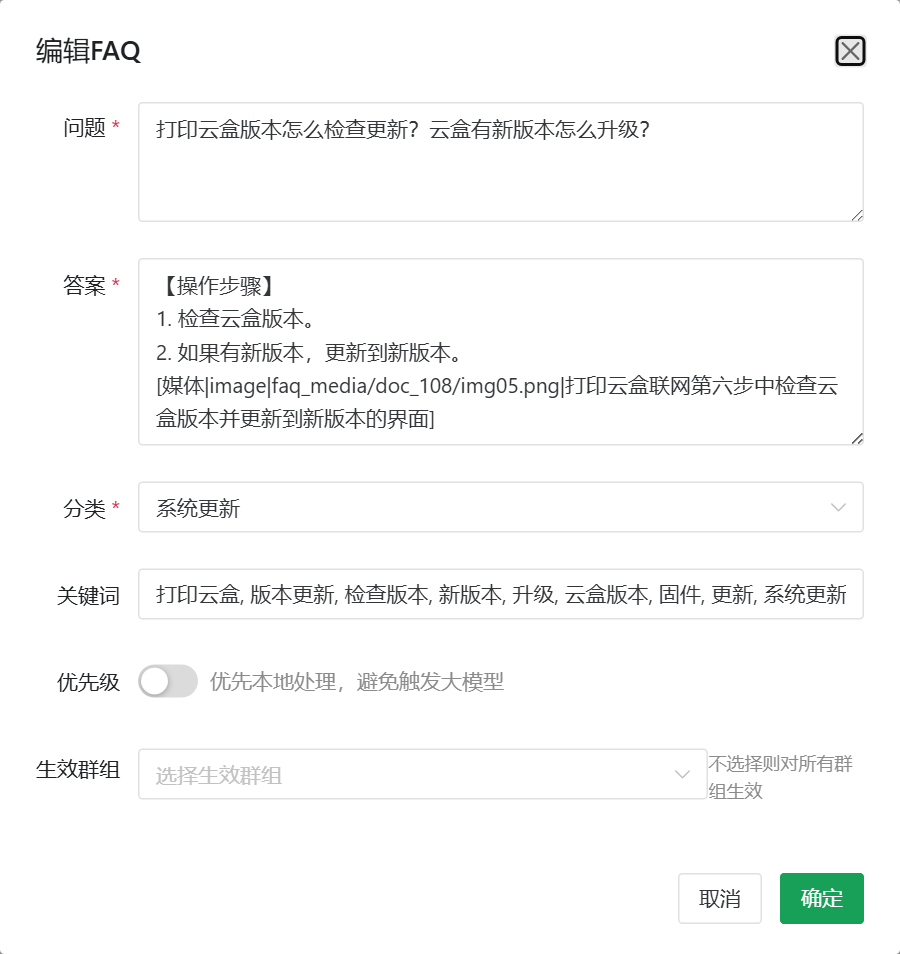
答案里文字和媒体行交错,就是说明书的结构化形态。
第四步/第五步:交错发送。
客户问到这条 FAQ 时,回复侧把答案按媒体行拆成段序列:
segments = split_media_segments(faq.answer)
# → [{"type":"text","content":"【操作步骤】1.检查云盒版本..."},
#    {"type":"image","content":"faq_media/doc_108/img05.png"}, ...]
for i, seg in enumerate(segments):
    send(chat_id, seg)                 # 文字→图→文字→图,按序逐条发
    if i < len(segments) - 1:
        sleep(0.5)                     # 段间小间隔,观感像真人逐条发
客户在企微里收到的就是"一段话、一张图、一段话、一张图"——照着一步一步做就行。
发送前还有一道不起眼但重要的校验:媒体行里的路径必须解析到上传目录内部(用路径规范化 + 公共前缀校验)。因为 FAQ 答案源自客户上传的文档,理论上可以构造 [媒体|file|../../数据库文件|...] 这样的文档投毒,把服务器上的任意文件"回复"给聊天对象——路径逃逸校验把这条路堵死了。
顺带一提,如果这条问题没走 FAQ 直接命中、而是进了大模型,图文能力同样在线:系统会把一段专门的"图片文件提示词"注入给大模型,引导它按"这一步文本 → 这一步配图"的节奏交替调用发送工具,效果一致。
三、AI 自主学习:解决"知识库越用越旧"
3.1 痛点:知识库的死亡螺旋
几乎每个上过客服系统的企业都经历过这个循环:
上线时花大力气建知识库 → 用得不错 → 业务变了,答案过时了 → 大家都忙,没人去更新 → 机器人开始答错 → 客服和客户都不信任机器人 → 系统逐渐荒废。
根因是知识维护是一项额外的、无人负责的工作。指望客服在忙碌之余"顺手更新知识库",被无数实践证明不现实。
冰石机器人的思路是釜底抽薪:别让人更新知识库,让 AI 从真人客服的日常回复里自动学。 真人客服每天本来就在回答客户——那些回答本身就是最新鲜、最准确的知识,只是从来没人把它们沉淀下来。
3.2 三步机制:挑、炼、存
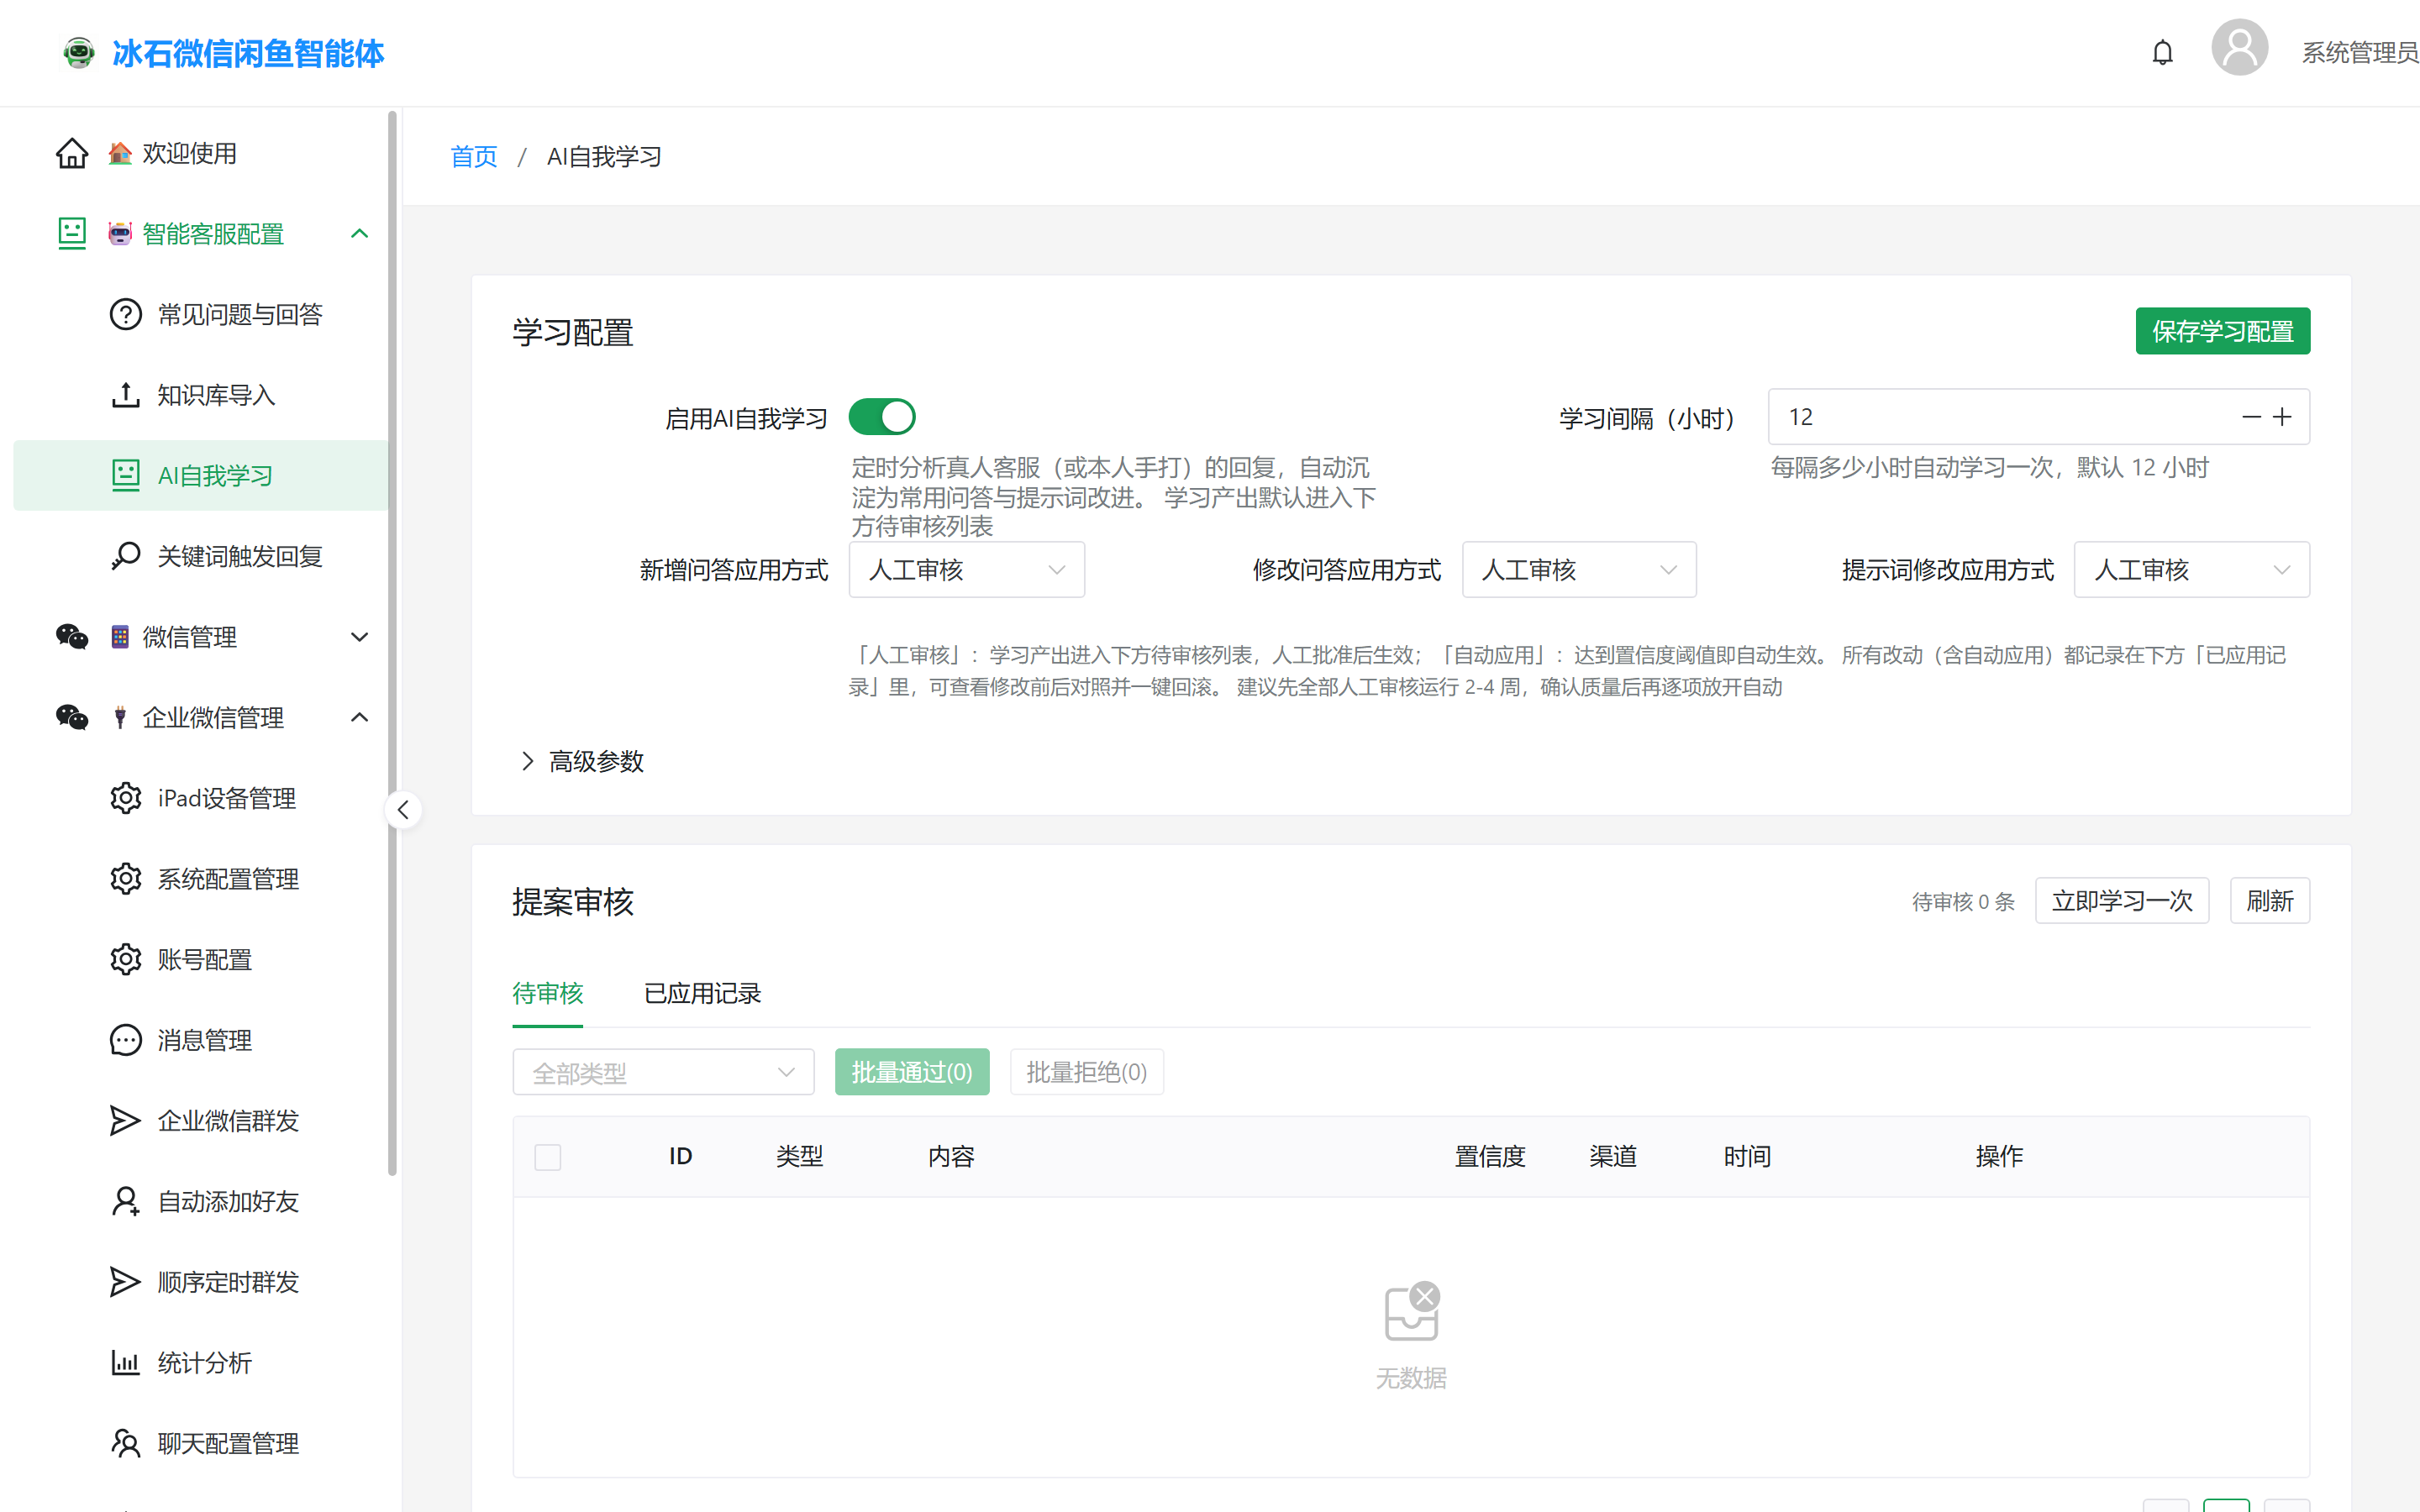
功能入口在「智能客服配置 → AI 自我学习」,核心机制三步:
| 步骤 | 系统做什么 |
|---|---|
| 挑 | 每隔一段时间(默认 12 小时)扫一遍聊天记录,只挑出**真人客服(或老板本人手打)**的那些回复 |
| 炼 | 把对话上下文交给大模型,让它看真人是怎么答的,提炼成一问一答,并配上关键词 |
| 存 | 生成"学习提案"进入审核队列,批准后写入 FAQ 库。下次客户问同样的问题,机器人自己就会答了 |
关键的一点:它只学真人说的话,机器人自己说过的话它不学——否则机器人答错的内容会越学越牢,形成自我污染。角色判定复用了第一篇讲的真人客服名单:扫描时每条消息被标注为 [客户] / [机器人] / [真人客服],只有含真人客服参与的会话片段才会进入提炼。
一个真实例子(来自实际部署环境):客户问"投影仪报修之后师傅什么时候来",机器人满口答应说已经在催师傅了。真人客服看到后接了一句:“投影仪的事儿师傅不管,无非就是电源跟遥控器电池的检查,让客人自己先看看。”——机器人答错了,真人把它纠正了。12 小时内,学习任务扫到这段对话,生成一条修改问答提案:把原来那条 FAQ 的答案替换成真人的说法。人工点一下"通过",下次再有客户问,机器人答的就是对的。
3.3 三种学习产出
学到的东西分三类,各自独立配置生效方式:
| 类型 | 什么情况下产生 | 生效后改了什么 |
|---|---|---|
| 新增问答 | 真人答的是知识库里没有的内容 | FAQ 库多一条 |
| 修改问答 | 库里原有这条,但真人把它答得不一样了(更正或补充) | 原答案被替换,关键词只增不减 |
| 提示词修改 | 与具体问题无关的行为规范(如"客户催发货要先道歉再报进度") | 融进对应聊天配置的大模型提示词 |
第三类最特别:它学的不是"知识"而是"话风和规矩"。为了防止把某个客服一次性的个人习惯固化成全局规则,提示词类提案有一个频次门槛——同一条行为规范要在至少 2 个不同会话里出现过才会成为提案。
3.4 分层去重:学习系统最难的部分
自动学习最大的风险不是学不到,而是学重、学乱:同一个问题客服每天都在答,直接入库就是几十条重复 FAQ。冰石机器人做了一套四层去重漏斗:
- Layer 0 源去重:已经学过的对话片段做内容哈希登记,下轮扫描直接跳过——省的不只是重复条目,还有大模型调用费;
- Layer 1 同问快路:新问题与库里某条相似度极高(≥0.85)→ 答案也一样就丢弃;答案不一样,说明业务变了,自动转成修改提案;
- Layer 2 答案同源合并:答案几乎相同、问题也沾边 → 这是"同一知识的另一种问法",不新增条目,只把新问法的关键词增量并入老 FAQ——库不膨胀,召回率还提升了;
- Layer 3 大模型终审:字面相似度进入灰色地带的(像又不像),交给大模型判定是重复、是答案冲突、还是确属新知识。
最后还有一道数据库层的兜底:每条提案按"类型+问题+媒体指纹"生成去重键并加唯一索引,并发场景下也不会写入重复提案。
3.5 审核、置信度与一键回滚
自动学习最让企业不放心的是"学错了怎么办"。冰石机器人的三道保险:
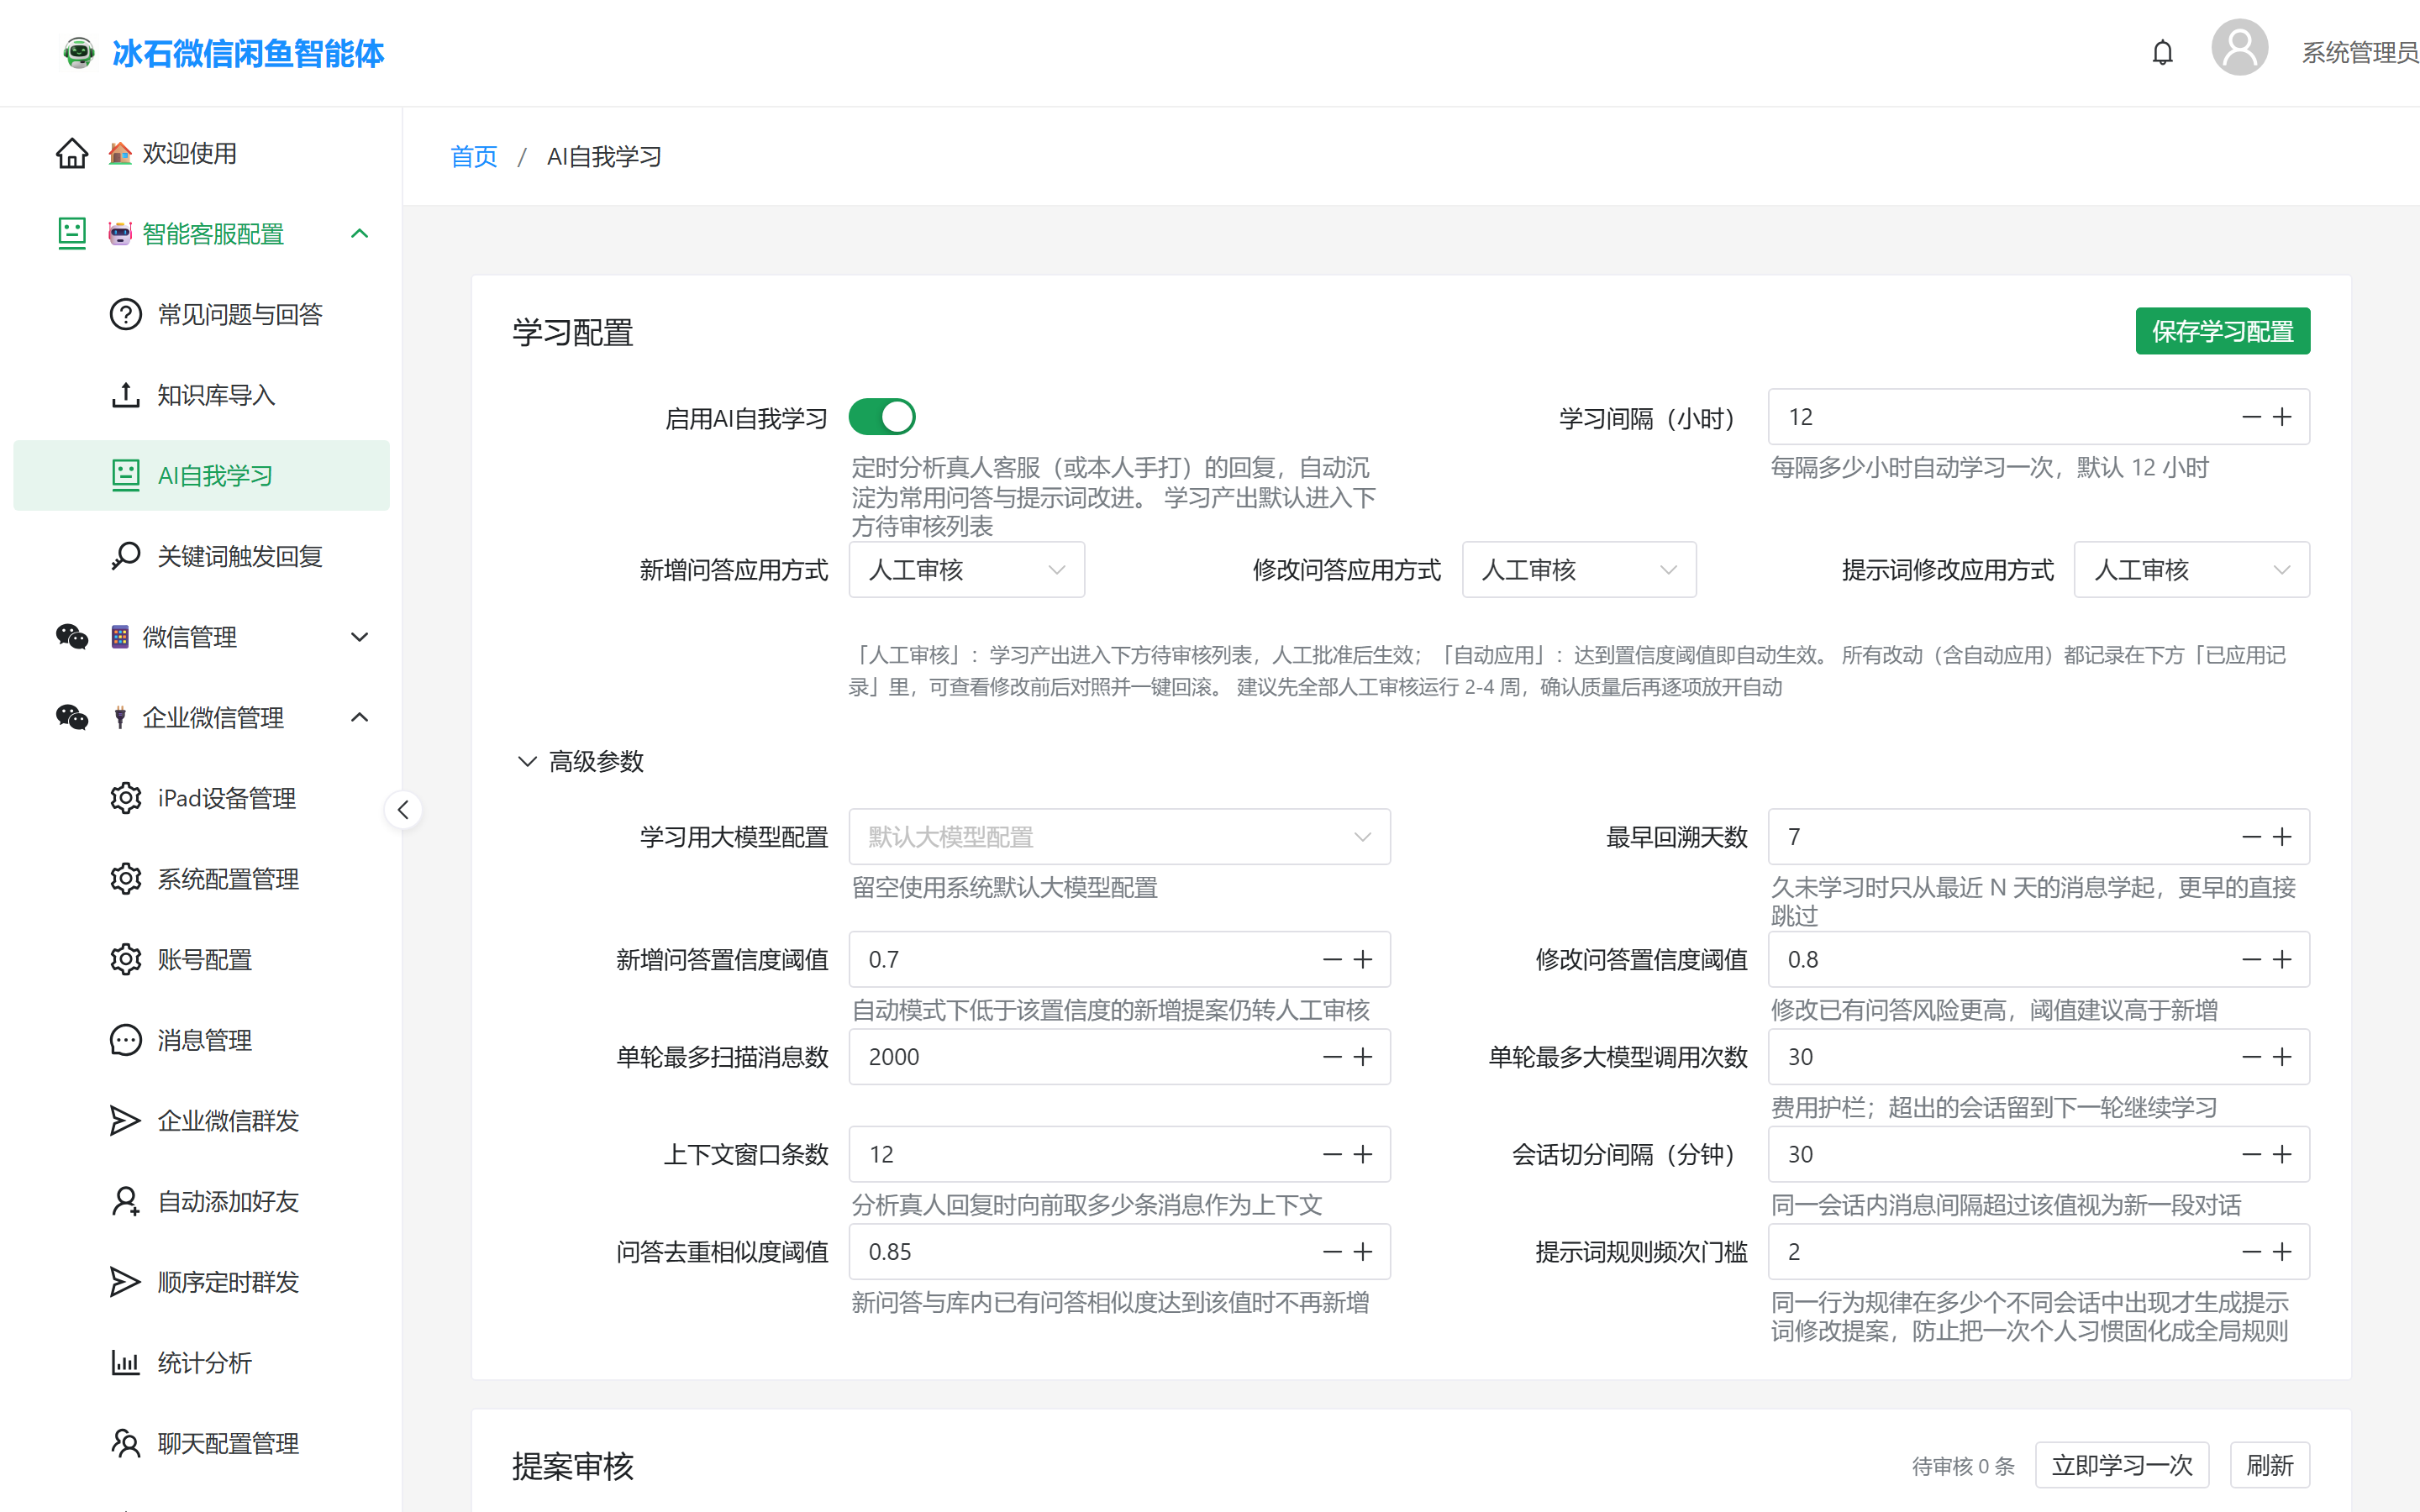
保险一:人工审核(默认)。 三类产出各自可选"人工审核 / 自动应用"。每条提案展开可见依据(为什么学这条)、提炼出的问答、关键词、以及最底下的原始对话证据——每条提案都能追到出处,不是凭空编的。审核就是通过 / 编辑后通过 / 拒绝三个按钮。
保险二:置信度阈值。 选择"自动应用"模式后也不是无脑全收:大模型对每条提案给出 0~1 的置信度,新增问答需 ≥0.7、修改问答需 ≥0.8(改动已有问答风险更高,阈值更严),低于阈值的仍转人工审核。学习提示词里也明确要求:“不确定就压低 confidence,宁可少提炼,不要提炼错。”
保险三:快照回滚。 每笔已生效的改动都保留了改动前的快照:
def apply_update_faq(proposal):
    faq = get_faq(proposal.target_id)
    proposal.old_snapshot = snapshot(faq)     # 没有快照,不允许写库
    faq.answer = proposal.new_answer
    faq.keywords |= proposal.new_keywords     # 关键词只增不减

def rollback(proposal):
    faq = get_faq(proposal.target_id)
    if faq.answer != proposal.applied_value:
        raise Conflict("该FAQ在本次应用后又被人工改过,拒绝盲目覆盖")
    restore(faq, proposal.old_snapshot)
回滚前会核对"当前内容是否仍等于当时写入的值"——如果后来有人手工改过,系统拒绝盲目覆盖。这条防御让"放开自动应用"变得敢用:错了随时一键撤销,且撤销永远不会误伤人工修改。
此外还有一组成本护栏:单轮最多扫 2000 条消息、最多调 30 次大模型(学习用的模型可以单独指定一个便宜的),没扫完的留到下一轮接着扫,不会一次跑飞。
3.6 它不学什么
一个成熟的学习系统,"不学什么"和"学什么"同样重要:
| 不学的内容 | 原因 |
|---|---|
| 一次性信息(订单号、手机号、当场砍价金额) | 学了对下一个客户也没用 |
| 机器人自己说的话 | 防止答错的内容越学越牢 |
| 重复的话(客服每天复读的欢迎语) | 只学一次,不堆几十条重复问答 |
| 只出现一次的行为规范 | 防止把个人习惯固化成全局规则 |
四、系列总结:企微智能客服的完整拼图
三篇下来,把冰石机器人在企业微信场景的解法拼在一起:
| 挑战 | 机制 | 篇目 |
|---|---|---|
| 机器人答不了所有问题 | 真人客服名单 + 等待秒数 + 人工接管命令 + 触发词召唤 | ① |
| 机器人不能抢真人的话 | 排队回复撤销 + 回声防自激 | ① |
| 企业要"一个团队服务一个客户" | 自动建专属群 + 超时事件找回 + 缺省配置继承 | ② |
| 机器人说话要像真人 | 多条消息合并 + 无回复续聊(哨兵串协议) | ② |
| 大模型调用要省钱 | 关键词 → FAQ → LLM 三级链路 | ③ |
| 说明书是图文的 | 保序解析 + 识图标注 + 媒体行 + 交错发送 | ③ |
| 知识库越用越旧 | AI 自主学习:只学真人 + 分层去重 + 审核/置信度/回滚 | ③ |
贯穿始终的设计哲学有三条:
- 真人永远优先:所有机制默认把话语权让给真人,机器人的定位是兜底和体力活;
- 对使用者零学习成本:客服不用学任何新工具,接管是发一句话,教机器人新知识是正常地回答客户;
- 自动化必须配刹车:延迟可取消、接管可切换、学习可审核、应用可回滚——每个自动机制都有对应的人工干预出口。
企业微信正在成为企业服务客户的主阵地,而"机器人 + 真人"的混合客服团队会是未来几年的常态。希望这个系列对正在做(或正在选型)企微智能客服的你有所启发。
冰石机器人官网:icestonebot.com
本文界面截图来自冰石机器人企业微信版实际部署环境(版本 20260827),配置项名称、默认值与算法细节以实际部署版本为准。请在遵守企业微信平台规范的前提下合规使用。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 7
 0
- 0


 已为社区贡献6条内容

所有评论(0)