【生成式模型入门】(二):DDPM去噪扩散概率模型 — 从条件均值到逐步去噪(下:实现与实验)
·
前言
- 上篇我们把 DDPM 的推导走完了一遍:前向过程的闭式解、后验分布与 ε \varepsilon ε 参数化下的反向均值、 L simple L_{\text{simple}} Lsimple 的化简,以及 DDIM 的跳步原理
- 但推导只回答"公式长什么样",回答不了"它到底成不成立":闭式解是否真的把数据变成噪声、训练出的 ε θ \varepsilon_\theta εθ 是否真的指向数据、DDIM 跳步之后质量掉多少,这些都只能靠实验
- 本篇是下篇,负责把上篇的结论逐条落地:先把整条链路实现出来,再用一组二维合成云完成六组实验,最后把同一套机制放到图像生成与机器人动作生成这两类真实应用里看一遍
- 六组实验与上篇论断的对应关系是:前向加噪、噪声调度、反向去噪路径、噪声场、无条件生成、DDIM 步数扫描
- 本篇的交叉引用沿用上篇的编号,文中的 2-x 节指上篇第 2 章的小节
- 之所以选用二维合成云,是因为它的中间状态可以直接画出来:每一帧都能当散点图画在平面上,而高维动作序列做不到这一点
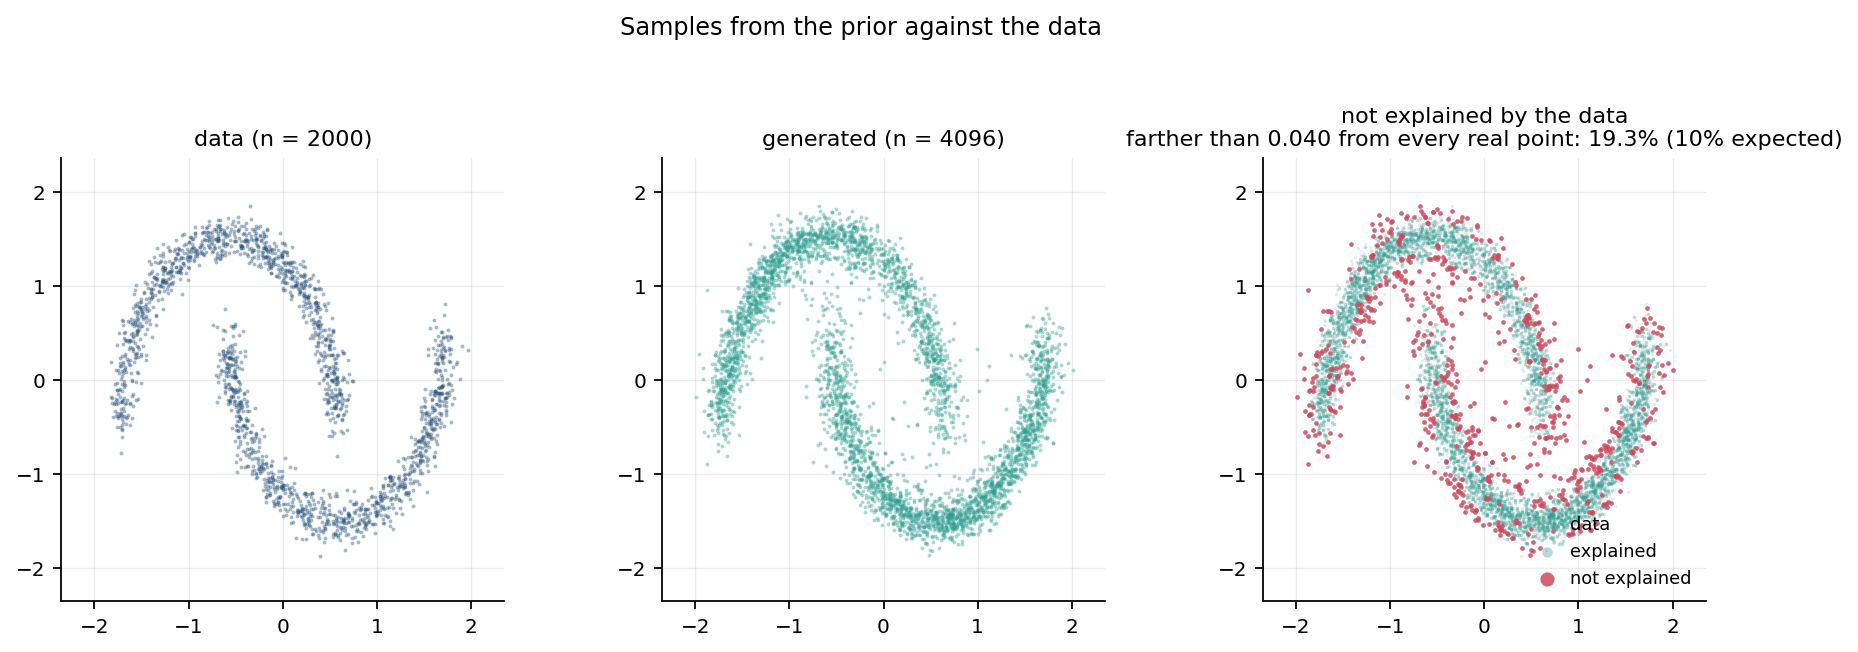
- 效果如下:
3 DDPM 代码实现
3-1 介绍
- 本章用一组实验核对第 2 章的每一条论断。实验在二维合成云上完成,共六组
- 六组实验按第 2 章的顺序展开,每一项都对应理论部分的一个具体论断
| 小节 | 核对的对象 |
|---|---|
| 3-5 前向加噪 | 2-3 节的闭式解 q ( x t ∣ x 0 ) q(x_t \mid x_0) q(xt∣x0) |
| 3-6 噪声调度 | 1-4 节关于线性调度末段行为的论断 |
| 3-7 反向去噪路径 | 2-4 节的后验方差与反向链形态 |
| 3-8 噪声场 | 2-5 节选择 ε \varepsilon ε 作为预测目标的理由 |
| 3-9 无条件生成 | 整条流程的采样质量 |
| 3-10 DDIM 步数扫描 | 2-8 节关于步数与质量关系的论断 |
- 本章不以"公式得以复现"为结论。凡属可以量化的论断均给出实测数值及其不确定度;凡实测结果与理论预期不符之处,一并说明
- 之所以选用二维合成云,原因在于 2-6 节所强调的性质:前向过程、损失函数与采样器均与数据语义无关,扩散过程本身并不知道自己在处理什么
- 把数据换成二维点云,2-1 至 2-8 节的每一条公式仍然成立,代码也无需更改,变的只是张量最后两个维度
- 而在二维上,整条反向链的每一个中间状态都可以画出来,这是图像或动作序列做不到的。本章的图全部来自这一数据源
说人话:好看
- 3-2 至 3-4 节给出这套实验所依赖的实现,依次为数据与形状约定、噪声调度、去噪网络与训练循环
3-2 数据集
- 数据源是二维合成云,代码内置
moons、spiral、circles三种形状,本章使用moons - 每个点由下式生成,之后逐轴标准化到零均值、单位方差
def make_toy2d(n, kind="moons", noise=0.06, seed=0):
    """Draw `n` points from one of the classic 2-D diffusion benchmarks."""
    rng = np.random.default_rng(seed)
    if kind == "moons":
        half = n // 2
        theta = rng.uniform(0.0, np.pi, half)
        upper = np.stack([np.cos(theta), np.sin(theta)], axis=1)
        lower = np.stack([1.0 - np.cos(theta), 0.5 - np.sin(theta)], axis=1)
        pts = np.concatenate([upper, lower], axis=0)[:n]
    ...
    pts = pts + rng.normal(0.0, noise, pts.shape)
    return ((pts - pts.mean(0)) / pts.std(0)).astype(np.float32)
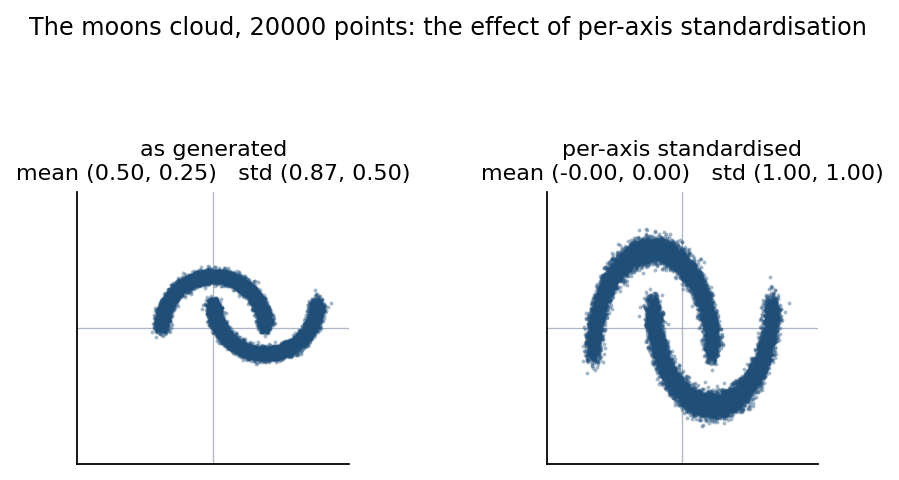
- 下图为同一个随机种子画出的两组点,左图为生成函数直接输出的形状,右图为逐轴标准化之后的形状,两者逐点对应
- 标准化这一步并非装饰性的
- 前向过程的 T T T 与 β \beta β 取值是针对 O ( 1 ) O(1) O(1) 量级的数据标定的,其目标是使 α ˉ T \bar\alpha_T αˉT 足够小,从而保证 x T x_T xT 确实是噪声
- 若数据尺度为 ± 20 \pm 20 ±20,则需要远大于 1000 的 T T T 才能将其破坏。标准化把这一标定问题固定下来,使其不随数据源变化
- 训练集与验证集在此处是纯随机划分。与滑窗不同,各点独立采样,不存在泄漏问题
- 训练 20000 个点,验证集占 10%
3-3 代码实现
3-3-1 张量形状速查
- 整套实现围绕一个形状约定展开:最后一个维度是通道,其余维度是数据自身的形状
- 二维合成云的形状如下
| 量 | 形状 | 说明 |
|---|---|---|
| x 0 x_0 x0 | ( B , 2 ) (B, 2) (B,2) | 一个 batch 的干净样本 |
| t t t | ( B , ) (B,) (B,) | 每个样本一个整数步 |
| ε \varepsilon ε | ( B , 2 ) (B, 2) (B,2) | 与 x 0 x_0 x0 同形 |
| 网络输入 | ( B , 2 + 64 ) (B, 2 + 64) (B,2+64) | 把 x t x_t xt 展平后与 64 维时间嵌入拼接 |
- t t t 按样本给出而非按 batch 给出,这一点在 2-6 节已经说明:一个 batch 内的样本必须覆盖不同的噪声水平
- 所有逐样本标量( α ˉ t \sqrt{\bar\alpha_t} αˉt、 1 − α ˉ t \sqrt{1-\bar\alpha_t} 1−αˉt、 σ t \sigma_t σt)都需要补足维度之后才能与 x t x_t xt 广播
def _match_ndim(x, ndim):
    """Reshape a per-sample scalar `(B,)` for broadcasting against `(B, ...)`."""
    return x.reshape(x.shape[0], *([1] * (ndim - 1)))
- 该函数即前文公式中反复出现的 [ ⋅ , None , None ] [\cdot, \text{None}, \text{None}] [⋅,None,None],它是整个实现中唯一需要处理形状差异的地方
- 之所以将其单独封装,是因为这一整形在扩散模型的每一处公式中都会出现,散落在各处会掩盖公式本身的结构
3-3-2 噪声调度
- 噪声调度的实现只需保存
β
t
\beta_t
βt 一张表,其余量均为其累积结果
- 以防你忘记, β t \beta_t βt表示第 t t t步准备加入多少噪声。
- 也就是 β 1 , β 2 , … , β T \beta_1,\beta_2,\ldots,\beta_T β1,β2,…,βT随着时间越来越靠后,每一步加的噪声越来越多
class NoiseSchedule:
    """beta_t plus the cumulative products the closed forms need."""

    def __init__(self, betas, kind):
        self.kind = kind
        self.betas = betas
        self.alphas = 1.0 - betas
        self.abars = torch.cumprod(self.alphas, dim=0)
        self.T = int(betas.shape[0])

        # Posterior variance of q(x_{t-1} | x_t, x_0), Eq (7) of the paper.
        # `abars[t-2]` is abar_{t-1}; the t = 1 entry has no posterior and is
        # filled with the beta it would collapse to.
        prev = torch.cat([self.betas.new_ones(1), self.abars[:-1]])
        self.beta_tilde = betas * (1.0 - prev) / (1.0 - self.abars)
- 表中仅有 β t \beta_t βt 一项需要构造,其余三张表( α t \alpha_t αt、 α ˉ t \bar\alpha_t αˉt、 β ~ t \tilde\beta_t β~t)均由它推出。这一设计意味着更换调度只需替换 β t \beta_t βt 的生成方式
- 两种调度的构造分别为
if kind == "linear":
    betas = torch.linspace(beta_start, beta_end, T, dtype=torch.float64)
elif kind == "cosine":
    steps = torch.arange(T + 1, dtype=torch.float64) / T
    f = torch.cos((steps + cosine_s) / (1.0 + cosine_s) * math.pi / 2) ** 2
    abars = f / f[0]
    betas = torch.clip(1.0 - abars[1:] / abars[:-1], 1e-8, 0.999)
- 余弦调度并非直接给出 β t \beta_t βt,而是先给出 α ˉ t \bar\alpha_t αˉt 的解析式,再反解 β t = 1 − α ˉ t / α ˉ t − 1 \beta_t = 1 - \bar\alpha_t / \bar\alpha_{t-1} βt=1−αˉt/αˉt−1
clip的作用是防止相除之后出现非正的 β t \beta_t βt。在 t t t 较大时 α ˉ t / α ˉ t − 1 \bar\alpha_t / \bar\alpha_{t-1} αˉt/αˉt−1 已接近 1,浮点误差足以使其越过 1- 训练开始前存在一处守卫条件,它检查 α ˉ T \bar\alpha_T αˉT 是否足够小
ABAR_T_MAX = 1e-2

abar_T = float(schedule.abars[-1])
if abar_T > ABAR_T_MAX:
    raise ValueError(
        f"abar_T = {abar_T:.3e} with T={schedule.T} and a {schedule.kind} schedule: "
        f"x_T still carries {abar_T**0.5:.1%} of the data's scale, so it is not noise. "
        f"Raise diffusion.T or diffusion.beta_end (want abar_T <= {ABAR_T_MAX:g})."
    )
- 该检查的必要性来自 2-7 节的采样起点:整条反向链从
x
T
∼
N
(
0
,
I
)
x_T \sim \mathcal{N}(0, I)
xT∼N(0,I) 出发,而这一假设只在
α
ˉ
T
≈
0
\bar\alpha_T \approx 0
αˉT≈0 时成立
- 若 α ˉ T \bar\alpha_T αˉT 偏大,采样器将从网络从未训练过的分布出发,最后若干步属于外推。这类错误不会报错,只会让生成结果轻微偏色,难以定位
- 守卫条件使该假设成为一条显式契约:若把 T T T 降到 200,线性调度只能达到 α ˉ T = 0.13 \bar\alpha_T = 0.13 αˉT=0.13,该配置会被直接拒绝
说人话:反向采样已经假设输入是纯噪声,前向过程最后必须变成噪声
- 两种调度的实测值为:线性 α ˉ T = 4.04 × 10 − 5 \bar\alpha_T = 4.04 \times 10^{-5} αˉT=4.04×10⁻⁵,余弦 α ˉ T = 2.43 × 10 − 9 \bar\alpha_T = 2.43 \times 10^{-9} αˉT=2.43×10⁻⁹。二者均通过检查,但相差四个数量级,这正是 3-6 节对比的对象
3-3-3 去噪网络
- 去噪网络用于实现 ϵ θ ( x t , t ) \epsilon_\theta(x_t,t) ϵθ(xt,t)即根据当前的噪声数据 x t x_t xt 和扩散时间步 t t t,预测其中包含的噪声。
- 网络结构非常简单:首先将 t t t 通过正弦时间嵌入转换成高维向量,再与 x t x_t xt 拼接,最后送入三层 MLP:
class DenoiseMLP(nn.Module):
    """eps_theta(x_t, t). `in_shape` is the trailing data shape, e.g. (20, 7)."""

    def __init__(self, in_shape, hidden=256, t_dim=128, layers=3):
        super().__init__()
        self.in_shape = tuple(int(s) for s in in_shape)
        self.in_dim = int(math.prod(self.in_shape))
        self.time_embed = SinusoidalEmbedding(t_dim)
        self.net = mlp([self.in_dim + t_dim] + [hidden] * layers + [self.in_dim],
                       activate_last=False)
        self.reset_parameters()

    def forward(self, x, t):
        h = torch.cat([x.reshape(x.shape[0], -1), self.time_embed(t)], dim=-1)
        return self.net(h).reshape(x.shape)
- 时间步
t
t
t 不能以整数形式直接送入 MLP
- 若直接输入整数,网络必须从两个毫不相关的输入插值出 t = 999 t = 999 t=999 与 t = 1000 t = 1000 t=1000 之间的行为
- 正弦嵌入将相邻的 t t t 映射到相邻的点:每一对频率贡献一个 cos/sin 分量,两个嵌入之间的距离随步数之差单调增长
- 该嵌入与 Transformer 的位置编码完全相同,只是把位置换成了扩散步
- 输出头被零初始化
# Zero the output head: the model starts by predicting "no noise", which
# is the identity denoiser. A randomly initialised head emits eps of O(1)
# at step 1, where the true noise is 0.01 -- the first gradients would be
# entirely about undoing that, and training starts from a much worse place.
nn.init.zeros_(self.net[-1].weight)
nn.init.zeros_(self.net[-1].bias)
- 零初始化使模型在训练开始时输出恒为零,即一个恒等去噪器
说人话:训练刚开始时,网络统一认为这里没有噪声,这是为了防止在于训练刚开始的时候,网络的随机输出可能太离谱。
- 与之相对,随机初始化的输出头在 t = 1 t = 1 t=1 处会输出 O ( 1 ) O(1) O(1) 量级的噪声估计,而该处的真实噪声仅为 0.01。此时最初的若干次梯度更新几乎全部用于抵消这一初始偏差,训练从一个明显更差的位置起步
- 该技巧在扩散模型的实现中普遍存在,其收益在小批量、少轮数的实验中尤为明显
3-3-4 统一两种参数化
- 2-5 节提到网络可以预测 ε \varepsilon ε 或 x 0 x_0 x0,二者之间可以相互换算。实现上并不需要为两种参数化写两套代码
def model_eps(self, model, x_t, t):
    """Whatever the network predicts, expressed as an eps estimate."""
    out = model(x_t, t)
    return out if self.predict == "eps" else self.eps_from_x0(x_t, t, out)

def model_x0(self, model, x_t, t):
    out = model(x_t, t)
    return out if self.predict == "x0" else self.x0_from_eps(x_t, t, out)
- 两个函数各自把网络输出换算成 ε \varepsilon ε 估计或 x 0 x_0 x0 估计,损失与采样器只调用这两个入口
- 由此带来的结果是:切换参数化只需改动一个配置项
diffusion.predict,损失函数、 L simple L_{\text{simple}} Lsimple 与全部采样器的代码均保持不变 - 需要留意的是 ε \varepsilon ε 与 x 0 x_0 x0 的换算中出现了除以 α ˉ t \sqrt{\bar\alpha_t} αˉt 与 1 − α ˉ t \sqrt{1 - \bar\alpha_t} 1−αˉt 的操作。这正是 2-8 节所讨论的病态来源 —— 在 t t t 接近两端时其中一个分母接近零
3-4 训练
- 训练循环的核心只有三行
for epoch in range(1, total_epochs + 1):
    for step, (batch,) in enumerate(train_loader, start=1):
        batch = batch.to(device, non_blocking=True)
        terms = diffusion.loss_terms(model, batch)
        loss = terms["loss"]

        optimiser.zero_grad(set_to_none=True)
        loss.backward()
        if cfg.train.grad_clip:
            torch.nn.utils.clip_grad_norm_(model.parameters(), float(cfg.train.grad_clip))
        optimiser.step()
- 梯度裁剪的阈值取 1.0。由于
t
t
t 每步重新采样,损失本身的方差较大,裁剪可避免个别 batch 的极端梯度破坏优化器二阶矩估计的稳定性
- 学习率采用余弦退火,其理由在于该损失的噪声是结构性的( t t t 每次重新采样),常数学习率会使最后若干轮持续在最优点附近震荡
- 需要指出一处实现细节:
CosineAnnealingLR的T_max取为总轮数时,最后一轮的学习率恰为零,该轮的参数更新量为零。这浪费一个 epoch,但不影响结果,因为最优检查点在此之前已经保存 - 每轮结束之后写入一行训练历史,其中同时保留训练目标与两个评估量
| 字段 | 含义 |
|---|---|
train_loss | 本轮训练集上的平均损失 |
val_loss | 验证集上的平均损失,用于挑选最优检查点 |
val_mse | 逐样本 MSE |
val_x0_mae | 换算到 x 0 x_0 x0 空间之后的平均绝对误差 |
elapsed_s | 累计耗时 |
val_mse与val_loss在默认配置下完全相等,这一现象可以从 2-6 节的公式直接读出:weighted=false时损失就是逐样本 MSE 在 batch 上的平均,不存在额外权重- 评估在每个 epoch 结束之后调用,其内部只做一次前向,不做采样
@torch.no_grad()
def evaluate(model, diffusion, loader, device):
    """Validation objective over the whole split.

    Cheap: one forward pass per batch, no sampling. `x0_mae` is accumulated in
    the *normalised* space, which is the only space where the trajectory and the
    toy cloud are on the same scale.
    """
- 之所以不把采样质量作为逐轮评估量,原因在于代价:一次完整采样需要 1000 次网络前向,是单次评估的千倍量级。若每轮都采样,400 轮的训练无法在半分钟内完成
- 代价是训练过程中看到的曲线不直接反映生成质量。2-6 节已经说明, x 0 x_0 x0 空间误差在均匀 t t t 上取平均时主要由高噪声步主导,因此该量只能作为一个固定的参照点,而非进度指标。生成质量留到 3-9 节,在采样之后单独度量
- 该数据源的规模与训练成本为
| 训练样本 | 验证样本 | 参数量 | 轮数 | 总耗时 | 单轮耗时 |
|---|---|---|---|---|---|
| 18000 | 2000 | 41858 | 400 | 25.8 s | 0.064 s |
- 实测收敛情况为:验证损失由第 1 轮的 0.2929 降至第 144 轮的 0.1952,第 400 轮为 0.2244,最优检查点取在第 144 轮
- 训练后期验证损失回升,对扩散模型而言通常不代表过拟合,而更可能源于评估量本身的噪声:验证损失是在随机抽取的 t t t 与随机噪声上估计的,其波动幅度与第 100 轮之后的变化量已相当
3-5 前向加噪
- 2-3 节给出的闭式解 q ( x t ∣ x 0 ) q(x_t \mid x_0) q(xt∣x0) 意味着可以一步跳至任意 t t t,即不必逐步执行 x 0 → x 1 → ⋯ → x t x_0 \to x_1 \to \cdots \to x_t x0→x1→⋯→xt。该性质是训练能够并行的前提,其正确性可以直接看出来
- 对同一批数据在五个时刻分别加噪,得到下图
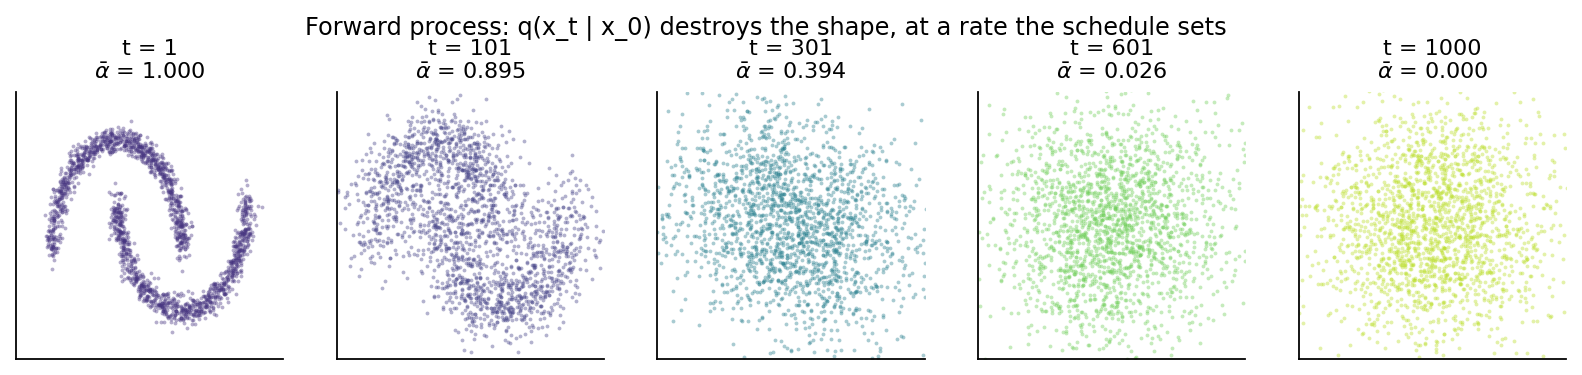
- 五个面板分别为 t = 1 , 101 , 301 , 601 , 1000 t = 1, 101, 301, 601, 1000 t=1,101,301,601,1000 时的点云,颜色随信号强度变化,面板标题同时给出该步的 α ˉ t \bar\alpha_t αˉt
- t = 101 t = 101 t=101 时双月牙形状仍清晰可辨,至 t = 601 t = 601 t=601 已接近各向同性的噪声云, t = 1000 t = 1000 t=1000 时已看不出任何残余结构
- 实测的 α ˉ t \bar\alpha_t αˉt 取值为
| t t t | 1 | 101 | 301 | 601 | 1000 |
|---|---|---|---|---|---|
| α ˉ t \bar\alpha_t αˉt | 0.99990 | 0.89514 | 0.39401 | 0.025567 | 4.04 × 10 − 5 4.04 \times 10^{-5} 4.04×10⁻⁵ |
| α ˉ t \sqrt{\bar\alpha_t} αˉt(信号尺度) | 0.99995 | 0.94612 | 0.62770 | 0.15990 | 0.006352 |
- 这里有一个容易被误读之处:线性调度的
β
t
\beta_t
βt 是单调递增的,即每步注入的噪声量在
t
t
t 接近
T
T
T 时最大;但图中
t
t
t 最大处反而看不出变化
- 原因是 α ˉ t \bar\alpha_t αˉt 的衰减是乘法累积的,看的是相对量而非绝对量。信号尺度降到 10 − 3 10^{-3} 10−3 量级之后,继续按同样的比例衰减,也只是从"看不见"变为"更看不见"
- 该性质在下一节中会转化为一个预算分配问题
3-6 噪声调度
- 上一节的最后一点提出了本节的问题: β t \beta_t βt 在末段最大, α ˉ t \bar\alpha_t αˉt 却在末段衰减最剧烈,那么这 1000 步的加噪进度究竟是如何分布的
- 下图给出当前配置(线性调度)的三个量
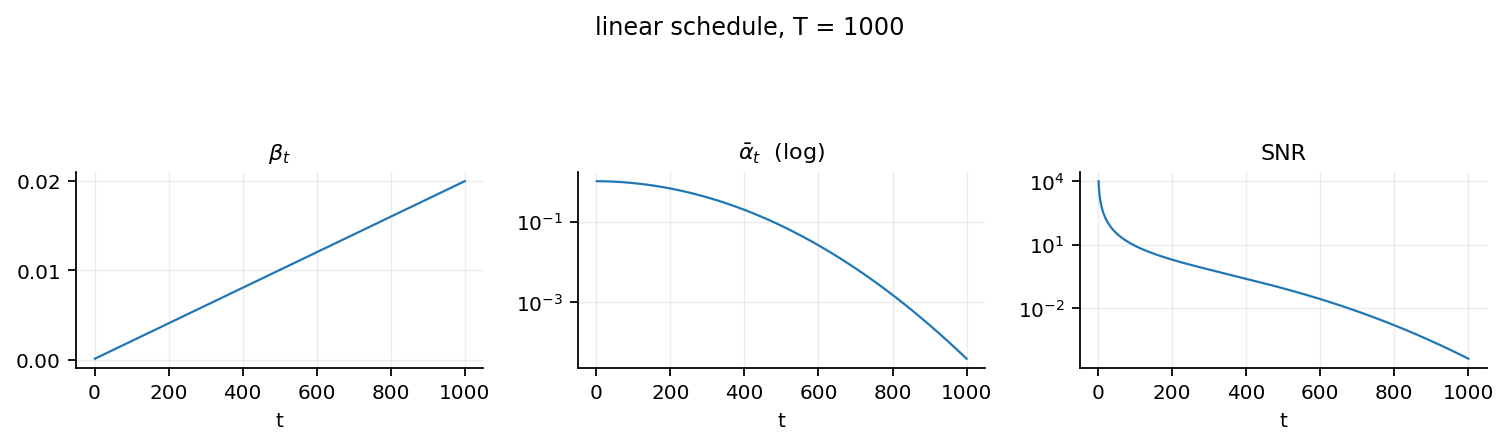
- 三个面板依次为
β
t
\beta_t
βt、
α
ˉ
t
\bar\alpha_t
αˉt(对数纵轴)与信噪比
S
N
R
(
t
)
=
α
ˉ
t
/
(
1
−
α
ˉ
t
)
\mathrm{SNR}(t) = \bar\alpha_t / (1 - \bar\alpha_t)
SNR(t)=αˉt/(1−αˉt)(对数纵轴)
- β t \beta_t βt:这一小步加多少噪声
- α ˉ t \bar\alpha_t αˉt:到目前为止还剩多少信号
- S N R ( t ) = α ˉ t / ( 1 − α ˉ t ) \mathrm{SNR}(t) = \bar\alpha_t / (1 - \bar\alpha_t) SNR(t)=αˉt/(1−αˉt):信号/噪声比例
- 三张图:
- 左图证实了上一节的观察: β t \beta_t βt 是一条直线,故末段的单步加噪量最大
- 中图的 α ˉ t \bar\alpha_t αˉt 在对数坐标下大部分区间接近直线,说明该区间内 α ˉ t \bar\alpha_t αˉt 近似按几何速率衰减;末段则明显下折,即衰减在末尾进一步加速
- 右图的信噪比自 10 4 10^4 104 一路降至 4 × 10 − 5 4 \times 10^{-5} 4×10⁻⁵,跨越约九个数量级。对数纵轴在此不是修饰,若改用线性轴,整个 t > 300 t > 300 t>300 的区间都会被压成一条贴着零的直线
- 把"信号已接近为零"定义为一个判据,即可量化两种调度的差别。下表由 3-3-2 节的两段调度构造直接解出
| 判据 | 线性调度 | 余弦调度 |
|---|---|---|
| α ˉ t < 0.01 \bar\alpha_t < 0.01 αˉt<0.01 的首个 t t t(占 T = 1000 T = 1000 T=1000 的比例) | 674(32.7%) | 936(6.5%) |
| α ˉ t \bar\alpha_t αˉt 在 t = T t = T t=T 处 | 4.04 × 10 − 5 4.04 \times 10^{-5} 4.04×10⁻⁵ | 2.43 × 10 − 9 2.43 \times 10^{-9} 2.43×10⁻⁹ |
| β T \beta_T βT | 0.0200 | 0.9990 |
| σ T = β T \sigma_T = \sqrt{\beta_T} σT=βT | 0.1414 | 0.9995 |
- 线性调度有 32.7% 的步落在 α ˉ t < 0.01 \bar\alpha_t < 0.01 αˉt<0.01 的区间,即近三分之一的训练预算花在几乎不含信号的样本上;余弦调度该比例仅为 6.5%
- 这正是 1-4 节所引用的"线性调度在 t t t 接近 T T T 时将信号压缩至近乎为零"的量化形式:所谓"压缩至近乎为零",指的并非某一步的问题,而是大量步都落在那一段
- 但该现象的影响不像数字看上去那样直接
- 落在该区间的样本,其训练目标 ε \varepsilon ε 仍服从标准高斯,网络在这一区间学到的是"输出接近输入中所含的噪声",这本身是一个良定义的回归问题。因此该步数占比影响的是训练预算的分配效率,而不是训练能否收敛;判断哪种调度更好,需要比较采样质量,而非比较训练损失
- 表的最后两行是 3-3-2 节那段
clip的副作用:上界 0.999 本意是防浮点误差,实测余弦调度的 β T \beta_T βT 恰好取到该上界,即裁剪确实生效。后果是最后一步的 σ T = 0.9995 \sigma_T = 0.9995 σT=0.9995,而线性调度为 0.1414,二者在 2-7 节的反向采样中对应注入的随机噪声量相差七倍- 该差别只在最后一步出现,属于调度构造的实现细节,而非余弦调度本身的定义。但它说明:更换调度时,需要一并核对的不只是 α ˉ T \bar\alpha_T αˉT,还有末段的 β t \beta_t βt 是否被裁剪改写过
3-7 反向去噪路径
- 2-4 节给出了后验方差 β ~ t \tilde\beta_t β~t 的形式,本节给出反向链上各中间状态的实际形态
- 下图由反向链在若干时间点的快照连接而成
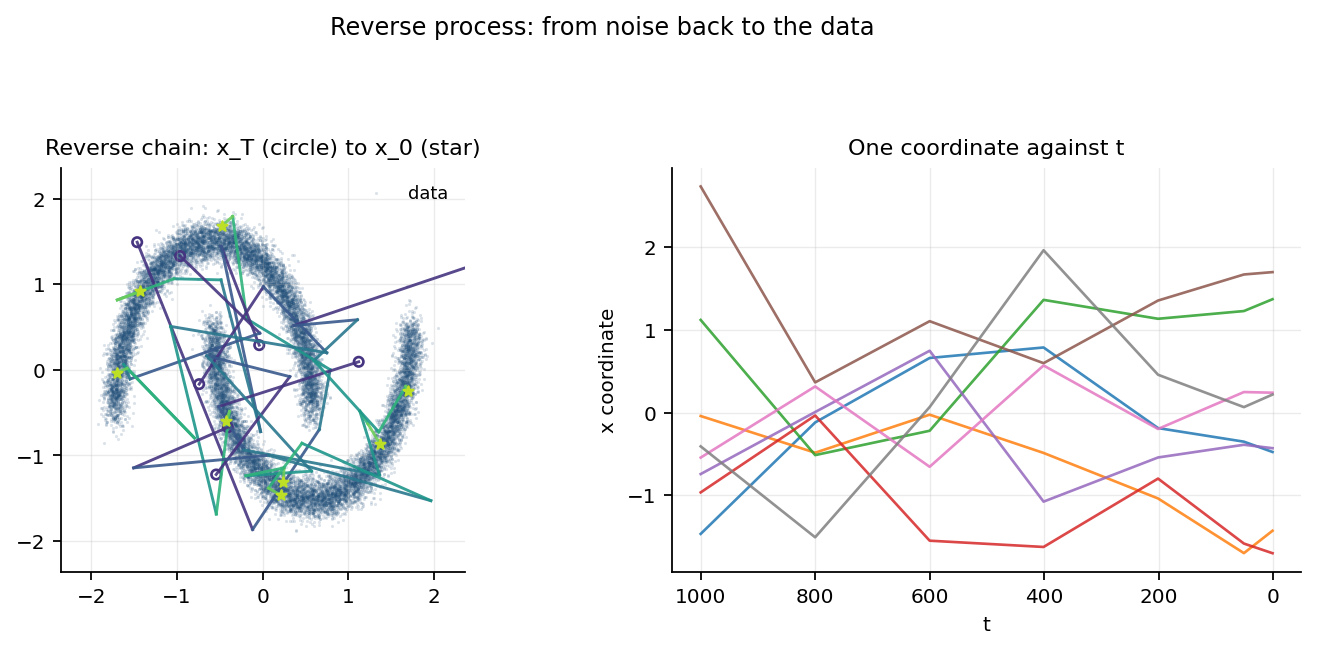
- 左图为平面内的 8 条反向链。空心圆为起点
x
T
x_T
xT(纯噪声),星号为终点
x
0
x_0
x0,线段颜色由深至浅对应由高噪声走向数据,背景点云为真实数据
- 链上只记录了 t = 1000 , 800 , 600 , 401 , 201 , 51 , 1 t = 1000,\ 800,\ 600,\ 401,\ 201,\ 51,\ 1 t=1000, 800, 600, 401, 201, 51, 1 这七个时刻的位置,折线是这些记录点的连线,而非逐步轨迹
- 两个记录点之间隔着 50 至 200 个反向步,高噪声区间一步的位移又大,所以线段长、相互交叉,甚至穿出数据区域
- 右图把同一条链的 x x x 坐标单独画出来,横轴自左端的 t = 1000 t = 1000 t=1000 递减至右端的 t = 1 t = 1 t=1。位移的大头集中在左端,即噪声仍然很高的阶段
说人话:这里展示了八个点如何从随机噪声随着 t = 1000 t = 1000 t=1000 递减至 t = 1 t = 1 t=1归位
- 三个定量指标为
| 指标 | 数值 | 含义 |
|---|---|---|
step_move_mean | 1.0876 | 相邻快照之间的平均位移 |
step_move_max | 3.6146 | 相邻快照之间的最大位移 |
low_t_third_share_of_movement | 0.1444 | 低噪声三分之一区段贡献的位移占比 |
- 第三行是这里最值得注意的一项:把 t t t 最小的三分之一( t < 333 t < 333 t<333)所贡献的位移全部加起来,只占总位移的 14.44%
- 也就是说,约 86% 的移动量发生在高噪声区间,最后三分之一的反向步基本只做微调
- 这与 2-4 节的推导一致:当 t t t 较小时 β ~ t \tilde\beta_t β~t 被 1 − α ˉ t − 1 1 - \bar\alpha_{t-1} 1−αˉt−1 压得很小,反向步接近确定性,其更新量也随之变小
- 各快照的形态同时说明了另一件事:反向链并非先勾勒轮廓再填充细节,而是在高噪声阶段就已经完成整体的形状定位
3-8 噪声场
- 2-5 节确定了网络的预测目标是 ε \varepsilon ε。训练收敛之后,该函数在平面上呈现如下形态
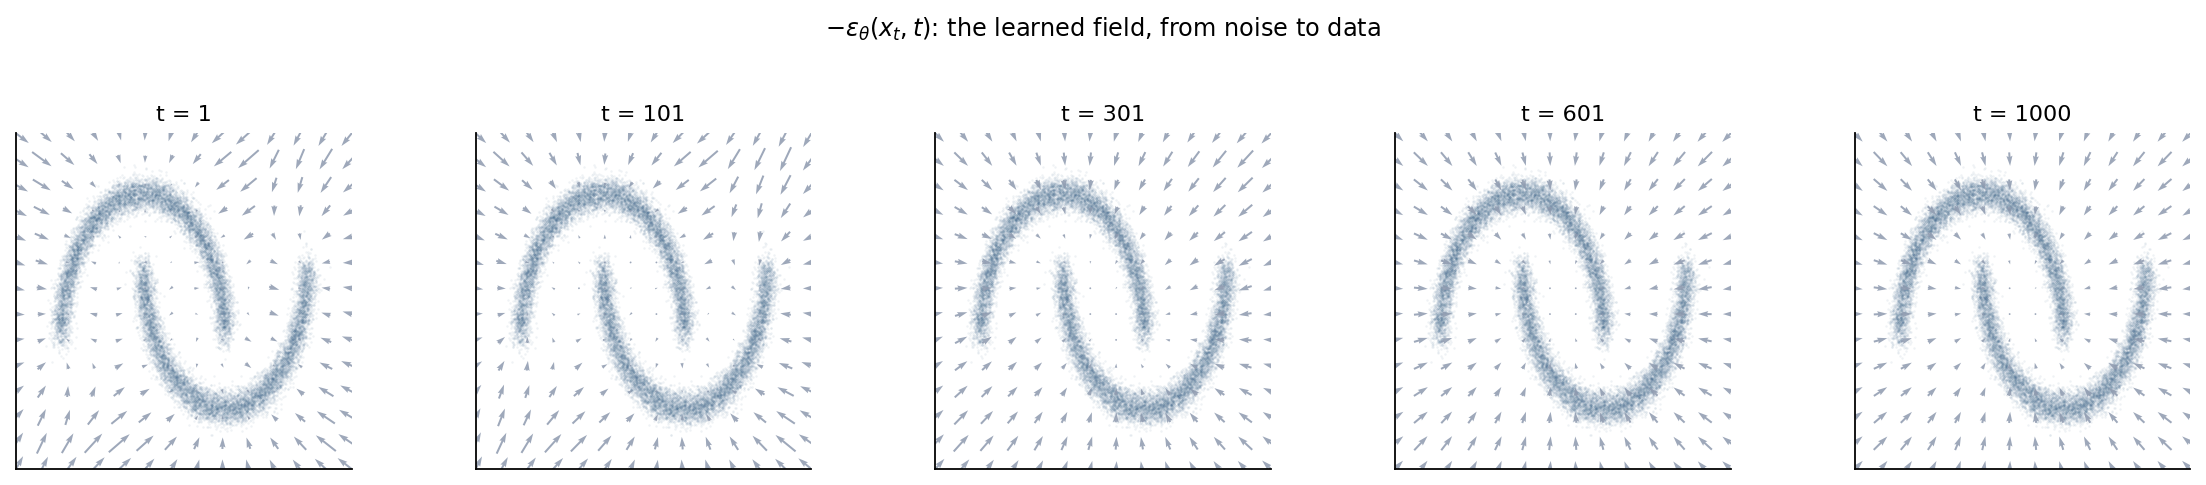
- 左图为整个平面上的 ε θ ( x , t ) \varepsilon_\theta(x, t) εθ(x,t) 向量场,右图为其模长的热力图
- 将该场在 t t t 较大与 t t t 较小时分别观察,可以对照 2-5 节的论断
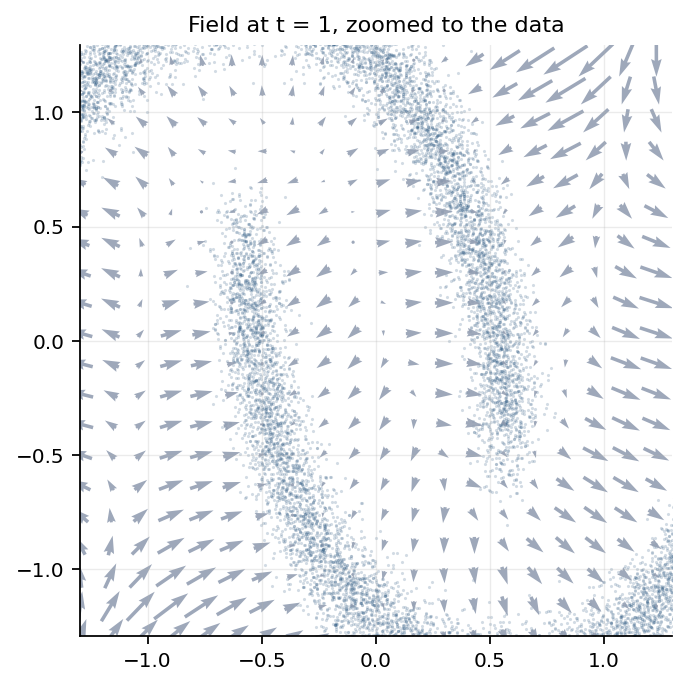
- 在 t t t 较大时,该向量场接近各向同性的随机方向,说明网络判断该处不含结构信息
- 在 t t t 较小时,双月牙形状附近呈现出明显的指向性,即网络所执行的操作是将样本推回数据分布
- 该指向性正是"去噪"这一名称的来源,也是扩散模型与分数匹配得以对应之处 —— ε θ \varepsilon_\theta εθ 与 ∇ x log p t ( x ) \nabla_x \log p_t(x) ∇xlogpt(x) 仅相差一个系数
- 还有一项可以定量核对的性质:网络输出的模长。实测的逐点
∥
ε
θ
∥
\|\varepsilon_\theta\|
∥εθ∥ 在这五个
t
t
t 上分别约为 1.36、1.64、1.58、1.85、1.87
- 该量在全部 t t t 上都保持在 1 至 2 之间,与真实噪声自身的模长同量级
- 这正是 2-5 节选择 ε \varepsilon ε 作为预测目标的理由之一:该量的尺度不随 t t t 变化,网络不必去拟合一个尺度剧烈变化的量
- 作为对照,后验均值 μ ~ t \tilde\mu_t μ~t 的尺度在 t t t 较大时接近 0、在 t t t 较小时接近 x 0 x_0 x0,其动态范围要大得多
3-9 无条件生成
- 前四节验证的是过程是否正确,本节检验结果。该数据源的优势在于:真值分布可以直接画出,生成结果的任何形态异常都能被立即识别
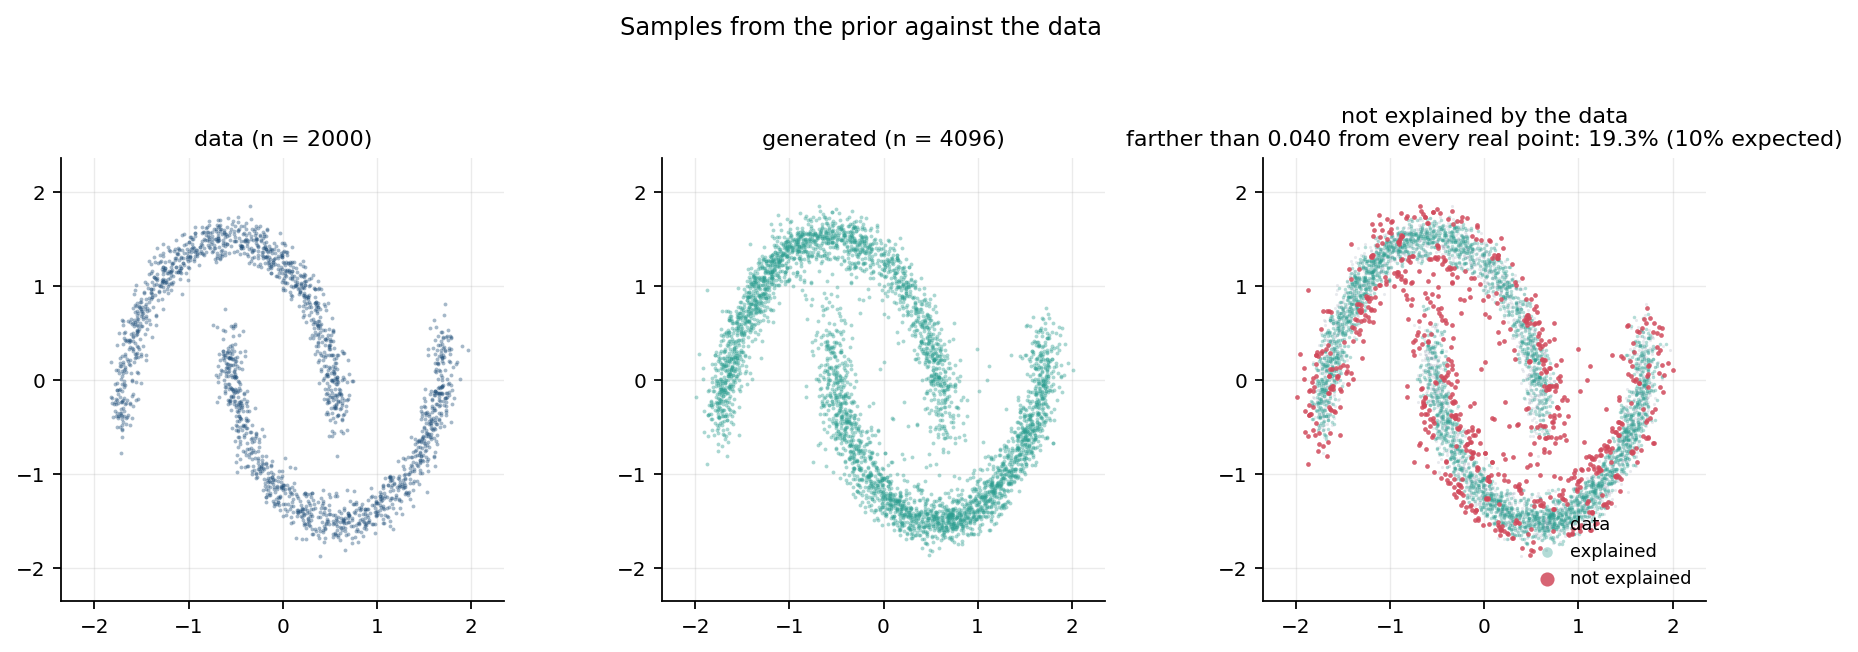
- 左图为真实数据,中图为从先验采样的 4096 个点。右图不与中图重复,而是回答中图回答不了的问题
- 右图直接标出这部分质量:以真实数据自身为标尺,若某个生成点到全部真实点的距离都超出了数据内部的正常间距,它就落在数据没有覆盖的位置
- 阈值取自真实集内最近邻距离分布的 90 分位数,实测为 0.0403 0.0403 0.0403。取 90 分位数意味着一个完美的生成器也会有 10% 的点天然越过它,因此该比例应与 10% 对照阅读
- 实测越过阈值的比例为 19.3 % 19.3\% 19.3%,接近该基准的两倍。右图中以红色标出的即为这部分点,它们并不另成一块,而是沿两条月牙的外缘与两臂之间的空腔散开
- 也就是说,生成分布在主体上与真实数据贴合,差异集中在弥散程度上:主体密度已接近,尾部则比数据更散
- 三项统计量的对照如下
| 量 | 真实数据 | 生成样本 |
|---|---|---|
| 均值 | [ 0.0129 , 0.0351 ] [0.0129,\ 0.0351] [0.0129, 0.0351] | [ 0.0037 , − 0.0558 ] [0.0037,\ -0.0558] [0.0037, −0.0558] |
| 标准差 | [ 0.9850 , 1.0007 ] [0.9850,\ 1.0007] [0.9850, 1.0007] | [ 1.0171 , 1.0131 ] [1.0171,\ 1.0131] [1.0171, 1.0131] |
| 到真实集的最近邻中位数 | 0.0190 0.0190 0.0190 | 0.0213 0.0213 0.0213 |
- 最后一行中的 0.0190 0.0190 0.0190 为真实数据自身的最近邻中位数(排除自身),它构成一个参照距离:任何生成器都无法优于该值,因为数据本身就不存在更近的点
- 生成样本的最近邻中位数为 0.0213 0.0213 0.0213,比参照距离高约 12%,说明生成分布与真实分布在中位密度上已相当接近
- 需要如实说明一处偏差:生成样本的
y
y
y 轴均值低于真实值约
0.06
0.06
0.06,即整体存在一个平移。这不是采样失败,而是该规模模型在
t
t
t 较大区间的系统性偏差
- 该量在两次独立采样中分别为 0.11 0.11 0.11 与 0.06 0.06 0.06:方向一致、幅度相差近一倍。也就是说偏差本身是稳定的,但其大小随初始噪声而变,不宜按单次采样的数值引用
- 与此相关的是两个标准差几乎一致( 1.0171 1.0171 1.0171 对 0.9850 0.9850 0.9850),说明尺度并未塌缩,偏差表现为平移而非收缩
- 上表来自单次采样。3-10 节会对同一指标做 16 次重复,其满步 DDPM 的最近邻中位数为 0.02099 0.02099 0.02099,与本节相差 1.5 % 1.5\% 1.5%,该量级即单次采样的波动幅度,两节数值不必逐位对齐
3-10 DDIM 步数扫描
- 2-8 节提出了一个问题:推理是否必须执行 1000 步。该节同时指出 DDIM 在 η = 0 \eta = 0 η=0 时是确定性采样器,步数可以任意压缩
- 本节给出该论断的实测。步数网格取 1000 , 100 , 50 , 20 , 10 , 4 1000, 100, 50, 20, 10, 4 1000,100,50,20,10,4,另加一组跑满 1000 步的 DDPM 作为对照, η \eta η 固定为 0
- 质量指标沿用 3-9 节的最近邻中位数,即生成样本到验证集的最近邻距离中位数,参照距离同为
0.01900
0.01900
0.01900
- 选该指标而非训练损失,是因为本节比较的是采样器而非网络。两者共用同一个已训练好的模型,差别只来自反向链如何离散
- 每个设置重复 16 次并报告标准误。各步数之间的质量差距只有百分之几,单次抽样无法区分"DDIM-20 确实更差"与"只是换了一次初始噪声"
- 每次重复使用不同的初始噪声种子,因此 DDPM 与 η = 0 \eta = 0 η=0 的 DDIM 都会表现出跨次波动。实测两者的标准差分别为 0.00022 0.00022 0.00022 与 0.00028 0.00028 0.00028,同一量级
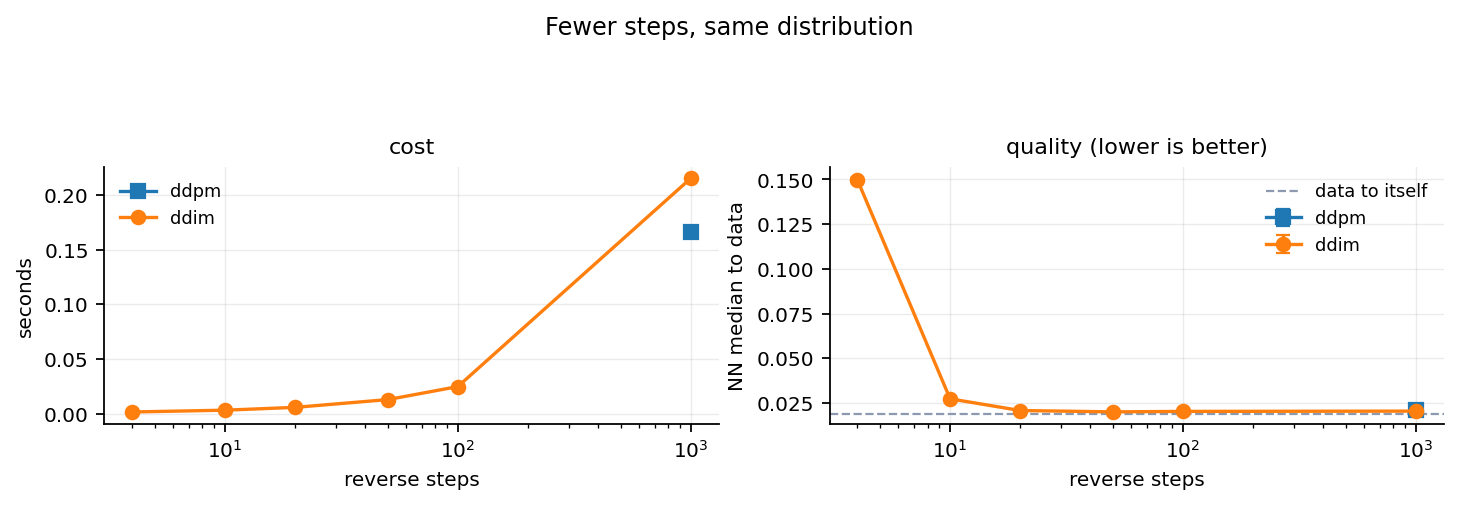
- 左图为耗时,右图为质量,横轴均为反向步数(对数刻度)。右图中的水平虚线为参照距离
- 图中可见一条先降后升的曲线,而非单调曲线。具体数值为
| 方法 | 步数 | 耗时 (s) | 质量 | 标准误 | 相对满步加速 | 高于参照距离 |
|---|---|---|---|---|---|---|
| DDPM | 1000 | 0.1666 | 0.02099 | 0.00006 | 1.0× | +10.5% |
| DDIM | 1000 | 0.2153 | 0.02048 | 0.00007 | 0.8× | +7.8% |
| DDIM | 100 | 0.0246 | 0.02033 | 0.00005 | 6.8× | +7.0% |
| DDIM | 50 | 0.0127 | 0.02007 | 0.00006 | 13.1× | +5.6% |
| DDIM | 20 | 0.0056 | 0.02081 | 0.00007 | 29.6× | +9.6% |
| DDIM | 10 | 0.0030 | 0.02737 | 0.00016 | 54.8× | +44.0% |
| DDIM | 4 | 0.0014 | 0.14972 | 0.00087 | 119.2× | +688% |
| 参照 | — | — | 0.01900 | — | — | 0 |
- 四项结论可以直接从表中读出
- 最低点出现在 50 步,它与相邻设置的差距远超抽样波动
- 步数不是越多越好:自该点继续增加,质量单调变差,与"反向步越细,离散误差越小"的直觉相反
- 满步的 DDIM 并未劣于满步的 DDPM,两者处于同一水平,前者还略好一些。这一点需要如实说明:在二维合成云上, η = 0 \eta = 0 η=0 的确定性采样器跑满全程不会带来退化
- 4 步完全失败,质量比参照距离高出近一个数量级,是全部设置中最差的一项
- 第二条与第三条合起来说明,该曲线的形状与 2-8 节所讨论的病态条件并不完全对应。一个可能的解释是:二维问题上的离散误差远小于 140 维动作窗口,末端分母 α ˉ t \sqrt{\bar\alpha_t} αˉt 变小的副作用不足以压过步数增加带来的收益;维度更高时二者的相对大小会发生反转
- 最实用的一条就是该最低点:比满步 DDPM 快一个数量级,质量还更好。更快的设置虽然省时更多,但其相对 DDPM 的优势已不能与抽样噪声区分
- 这条曲线需要给出一个限定
- 除两端外,各设置到参照距离的差距都只有百分之几,即都已贴着噪声下限运行。因此"最低点"统计上成立、实用上意义有限:在该区间内,步数的选择主要影响耗时
- 真正有量程的是两端:步数压到十步量级时质量开始明显恶化,个位数步数则彻底失败
- 表中最右一列与最后一行构成了 2-8 节那条部署动机的直接回应:实际部署的策略模型(ABot-M0 与 Embodied-R1.5)取
num_inference_timesteps: 4,而该步数在本实验中恰是唯一完全失败的设置- 这并不说明这些工作用错了步数:它们所压缩的并非朴素 DDIM,而是经过蒸馏或隐式微调的采样器。该结果说明的是,把满步压到 4 步仅靠更换确定性采样器并不够,还需要额外的训练手段,这部分留待后续讨论 Flow Matching 时展开
- 表中的耗时需要一处说明:满步 DDIM 比满步 DDPM 慢,而两者的网络前向次数完全相同,该差值来自采样循环中构造时间步子序列与索引取值的额外开销,属于实现代价,与算法本身无关
4 DDPM 的运用
4-1 介绍
- 前三章走完了 DDPM 的原理、训练与采样,实验部分也把整条链路跑通了一遍
- 到这里我们手上已经有了一个能工作的生成模型:前向过程有闭式解,训练目标退化成预测噪声,采样还可以按 DDIM 跳步
- 但它的本质始终是一件事:学习"如何从噪声中逐步恢复数据",从而由随机噪声出发,生成符合数据分布的新样本
- 也正因为被学的只是一个通用的一步去噪映射,它的适用范围并不限于图像。只要能把任务写成一个合适的生成过程,同一套机制就可以搬过去
- 加噪公式、 L simple L_{\text{simple}} Lsimple 与反向采样循环都不用改;变的是被去噪的对象是什么,以及去噪网络该长成什么样
说人话:DDPM 学的是"去噪"这件事本身,它并不关心被去噪的是图像、动作还是音频
- 本节不再推导新的公式,只梳理扩散模型在几个典型领域的落地方式,以及可以顺着往下读的开源项目
4-2 图像生成
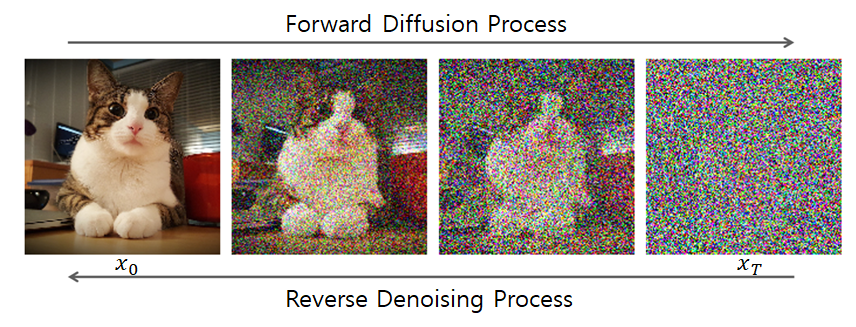
- 扩散模型最广为人知的应用是图像生成
- 前面的实验其实就是这件事的最小版本:从
x
T
∼
N
(
0
,
I
)
x_T \sim \mathcal{N}(0, I)
xT∼N(0,I) 出发,沿反向链逐步去噪得到
x
0
x_0
x0
- 当时生成的对象是二维平面上的点,不是图像。二者的差别只在数据的维度与去噪网络的结构:把每个像素看成一个维度,网络由全连接换成
U-Net,采样过程本身不变 - 因此 3-9 节那套分布检验可以整体照搬,只是图像上画不出散点图,需要用别的量化指标来比较生成分布与真实分布
- 当时生成的对象是二维平面上的点,不是图像。二者的差别只在数据的维度与去噪网络的结构:把每个像素看成一个维度,网络由全连接换成
- Hugging Face 的
Diffusers提供了 DDPM 的完整实现,也可以直接加载社区权重做无条件图像生成,是上手最快的一档:Diffusers - 如果目的是对照公式读源码,
denoising-diffusion-pytorch更合适:加噪、采样与训练循环都集中在单个文件里,与 2-3 至 2-7 节的推导基本逐段对应:denoising-diffusion-pytorch - 两者都实现了 DDIM 与多种噪声调度,可以直接拿来做 3-6 节与 3-10 节的对照实验
4-3 机器人
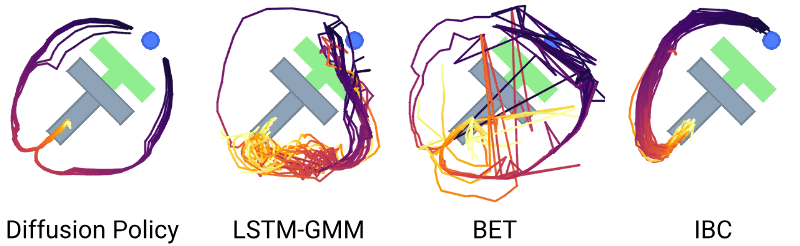
- 扩散模型在机器人领域最重要的应用是动作生成,也就是前言里提到的 Diffusion Policy 这条路线
- 这时被去噪的对象不再是图像,而是一段动作序列:以当前的视觉观测与本体状态为条件,从随机噪声出发,逐步去噪出一段可直接执行的动作
- 代表工作是
Diffusion Policy(Chi 等,2023),它把机器人策略本身写成一个条件扩散模型:Diffusion Policy- 条件项是当前观测,在原始工作中分为图像与本体状态两路编码
- 被去噪的量是一段动作序列,而不是单个动作
- 训练目标与 2-6 节的 L simple L_{\text{simple}} Lsimple 完全相同,只是 ε θ \varepsilon_\theta εθ 多了一路条件输入
- 原始工作在多个仿真基准与真实机器人任务上做了验证,并公开了代码与数据
- 这里的变化只有一个:图像生成中的 x t x_t xt 是一张加噪图像,而动作生成中的 x t x_t xt 是一段加噪动作
- 这样一来,第 1 章留下的那个动机在这里得到了正面回应
- 1-2 节举的绕杯子例子中,自左侧绕过与自右侧绕过是两条合法解,单步回归策略给出的是二者的折中,也就是一条撞上杯子的轨迹
- 扩散策略不输出这个折中解,而是从整个动作分布中采样,因而可以复现其中任意一条。
Diffusion Policy正是把"能够表达多模态的动作分布"作为选择扩散模型的理由
- 代价来自同一个地方:采样要跑多次网络前向,而控制回路有硬性的周期约束,因此推理端的步数必须压下来,这条约束与 3-10 节量到的量程边界是同一件事
这个我们后面会出一期文章来讲,不着急
4-4 其他应用
- 除图像与动作之外,扩散模型还被用于音频、视频、三维生成等任务,做法都是在对应数据的维度上重复同一套加噪与去噪
Diffusers里也不只有图像一类的管线,其官方示例覆盖了 Text-to-Image、ControlNet、InstructPix2Pix 等任务,可以作为继续往下读的入口- 把前面几节的应用放在一起,变的是什么、不变的是什么就很清楚了
| 应用方向 | 代表工作 | 被去噪的对象 | 条件输入 |
|---|---|---|---|
| 图像生成 | Diffusers、denoising-diffusion-pytorch | 图像 | 无,或文本等条件 |
| 机器人动作 | Diffusion Policy | 动作序列 | 视觉观测、本体状态 |
| 音频与其他 | Diffusers 的多任务管线 | 音频、视频等 | 文本等条件 |
- 核心思想并没有变:从随机噪声出发,通过逐步去噪生成目标数据
变的只是被去噪的对象,不变的是"从噪声出发、逐步去噪"这件事
总结
- 本篇接着上篇的推导,把 DDPM 完整实现了一遍,并在二维合成云上用六组实验逐条核对了上篇的论断:上篇给出闭式解、变分下界、 ε \varepsilon ε 参数化与 DDIM 四段推导,本篇负责把它们跑起来
- 下一期我们会在此基础上进入 Flow Matching,看它如何绕过扩散模型的迭代采样,把"逐步去噪"换成一条可直接求解的传输路径,并讨论为什么这条路线更适合动作生成这一类需要低延迟的任务
- 如有错误,欢迎指出!
- 感谢观看!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献23条内容

所有评论(0)