Agent 工具调用很顺,团队协作却崩了?从三个核心组件看维护成本
聊《Agent火了之后,为什么团队反而更关心维护成本?》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
摘要:最近把 Agent 从个人项目搬到团队协作,踩了一堆坑。模型调用和工具注册看着都没问题,但协作效率反而下降了。复盘后发现,问题不在模型能力,而在工具调用、记忆管理和任务规划这三个核心组件的设计取舍。本文用一次真实踩坑记录,拆解 Agent 底层机制,以及团队落地时需要补的工程能力。
---
目录
- Agent 的本质:不只是调 API 的聊天机器人
- 规划能力:从串行执行到可恢复的任务图
- 工具调用:注册容易,维护难
- 记忆系统:上下文窗口不是免费的
- 失败恢复:Agent 崩了,怎么知道是哪一步错了
- 总结:团队协作比 Demo 难在哪
---
目录
- Agent 的本质:不只是调 API 的聊天机器人
- 规划能力:从串行执行到可恢复的任务图
- 工具调用:注册容易,维护难
- 记忆系统:上下文窗口不是免费的
- 失败恢复:Agent 崩了,怎么知道是哪一步错了
- 总结:团队协作比 Demo 难在哪
Agent 的本质:不只是调 API 的聊天机器人
很多人第一次接触 Agent,是从一个能写代码的 Demo 开始的。输入需求,输出代码,跑通,觉得"这就完了?"。
真实情况是,Demo 能跑和团队能维护是两回事。
我最近带团队把 Agent 接入到一个内部项目的代码审查流程里。需求很明确:让 Agent 读取 PR 描述、检查代码变更、输出 Review 意见。模型选的是国产主流开源模型,工具注册了 Git 操作和代码搜索,记忆用了简单的会话历史。
跑起来之后,问题暴露了。
第一个 PR 没问题,第二个 PR 开始,Agent 记错了上一个 PR 的结论,第三个 PR 直接卡死在工具调用环节。团队效率没提升,反而因为要反复纠正 Agent 的错误判断,多了不少沟通成本。
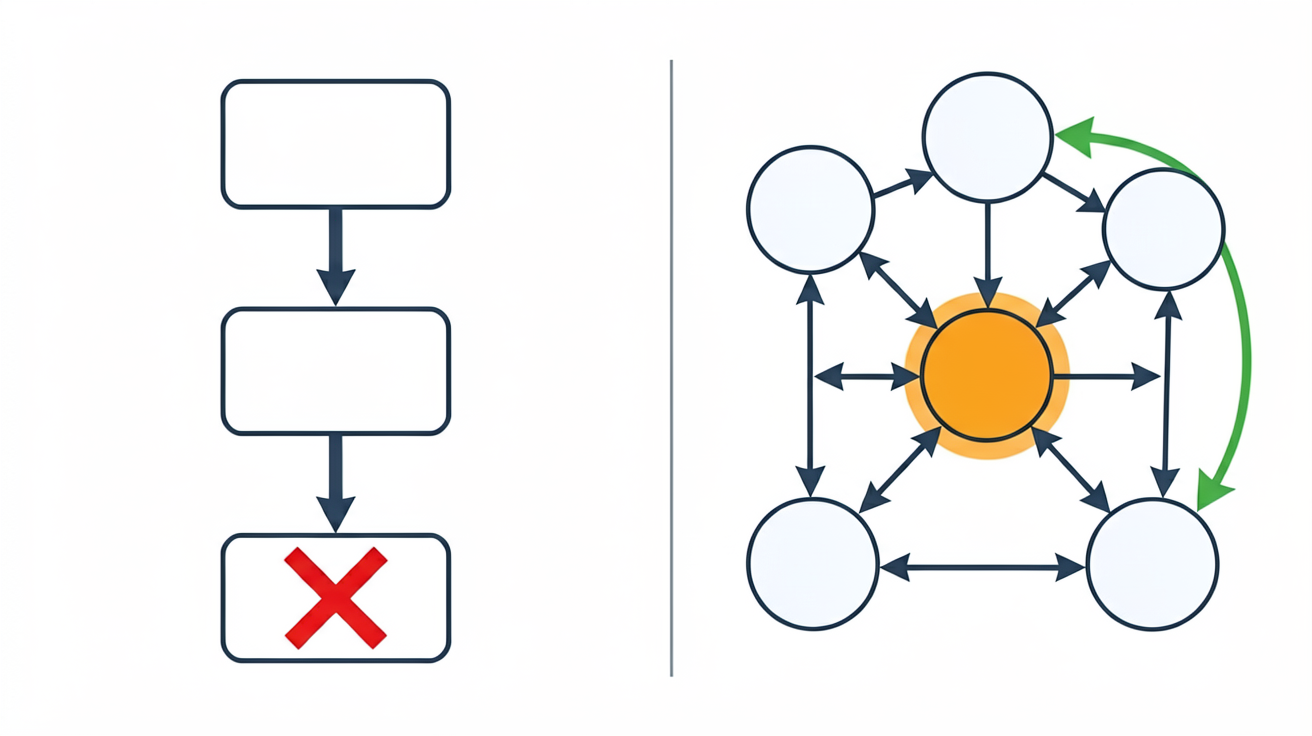
这个问题值得拆解。Agent 不是"调模型 + 调工具"那么简单,它的核心是三个组件的协同:规划能力决定它怎么分解任务,工具调用决定它能做什么,记忆系统决定它能不能记住上下文。任何一个组件设计不好,团队协作就会出问题。
---
规划能力:从串行执行到可恢复的任务图
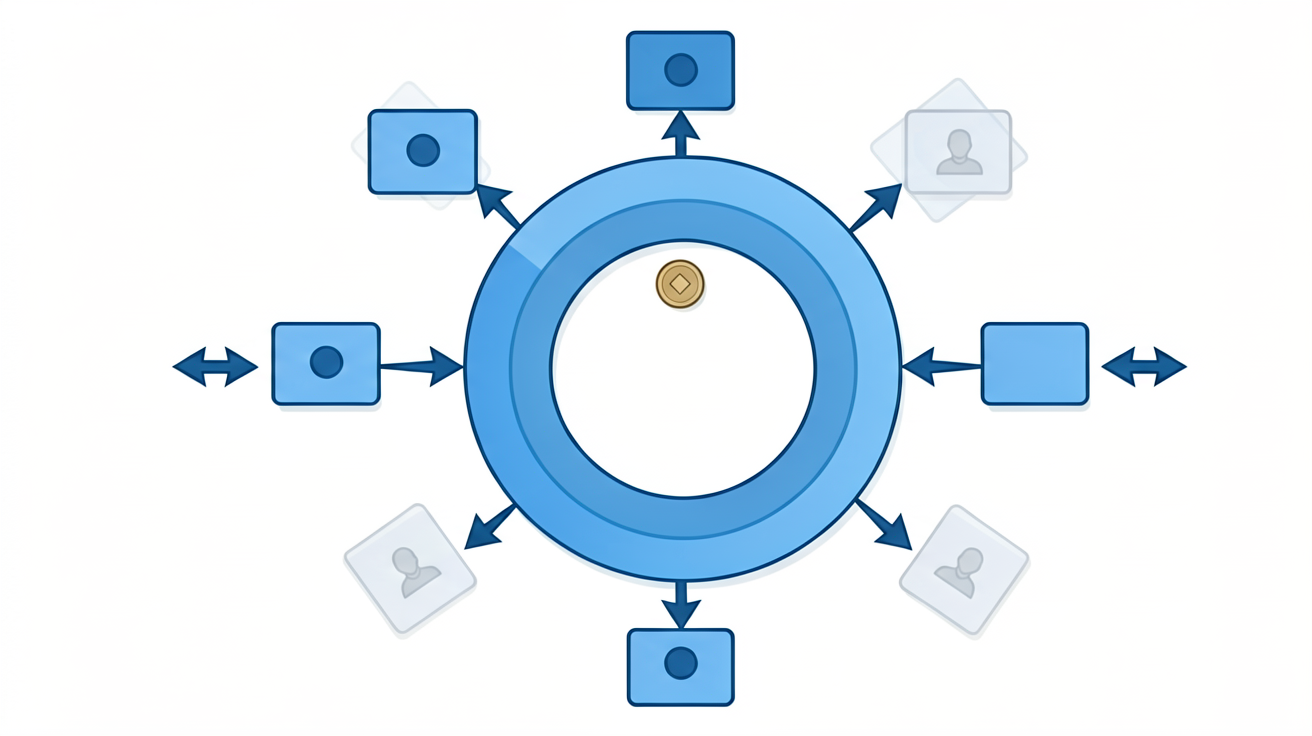
Agent 的规划能力,本质上是把一个大任务拆成小步骤,并决定执行顺序。
我们遇到的第一个问题是:Agent 把 PR Review 拆成了串行步骤,读描述、查变更、写意见,一步接一步。看起来合理,但一旦某一步失败,整个任务就卡住了。
更关键的是,这种串行规划没有"回退"机制。第二步失败了,Agent 不会重新评估第一步的结果,而是直接报错。
排查过程:
1. 现象:第三个 PR 卡死,日志显示工具调用超时
2. 验证:单独跑第三步(写意见),能正常完成;单独跑前两步,也能完成
3. 排除:不是模型能力问题,是规划逻辑问题
4. 结论:串行规划没有容错,一步失败全局失败
解决方案是把规划改成基于图的结构,每个步骤有明确的输入输出依赖,失败时可以回退到上一个检查点重新规划。
# 简单的任务图结构,用于替代串行规划
class TaskNode:
    def __init__(self, name, tool, condition=None):
        self.name = name          # 步骤名称
        self.tool = tool          # 调用的工具
        self.condition = condition # 执行条件(可选)
        self.dependencies = []    # 依赖的上一步
        self.result = None        # 执行结果
        self.error = None         # 错误信息

    def execute(self, context):
        try:
            # 检查依赖是否完成
            for dep in self.dependencies:
                if dep.result is None and dep.error is not None:
                    return {"status": "blocked", "error": f"依赖 {dep.name} 失败"}

            # 执行工具调用
            result = self.tool.run(context)
            self.result = result
            return {"status": "success", "result": result}
        except Exception as e:
            self.error = str(e)
            return {"status": "error", "error": str(e)}
代码解释:
这个 TaskNode 是任务图的基本单元。输入是 context(当前任务上下文),核心逻辑是检查依赖、执行工具、保存结果。输出是一个状态字典,包含 status、result 和 error 字段。异常处理在 execute 方法内部,捕获所有异常并记录到 error 字段,而不是直接抛出。
这种设计的优势是:每个步骤独立失败,不影响其他步骤;回退时只需要重跑失败的节点,不需要重跑整个任务。
---
工具调用:注册容易,维护难
工具注册是 Agent 开发里最简单的一步。定义一个函数,注册到工具列表,完事。
但团队协作时,问题来了。
我们团队有五个开发者,每个人都有自己的工具函数。A 写了 Git 操作工具,B 写了代码搜索工具,C 写了 PR 检查工具。看起来分工明确,但实际运行时,工具冲突频繁发生。
排查过程:
1. 现象:同一个工具名,不同开发者注册了不同版本
2. 验证:查看工具注册表,发现 tool_name 重复
3. 排除:不是调用逻辑问题,是注册管理问题
4. 结论:缺少工具命名规范和版本管理
失败原因分析:
- 业务错误:工具返回的数据格式不符合预期,比如搜索工具返回的是字符串,但下游步骤期望的是列表
- 配置错误:工具参数配置错误,比如权限配置缺失,导致工具调用失败
- 环境错误:工具依赖的外部服务不可用,比如代码搜索服务超时
这三种错误在排查时很容易混淆。业务错误需要改工具逻辑,配置错误需要改配置,环境错误需要排查基础设施。如果不区分,Debug 效率会很低。
我们的解决方案是建立工具注册表,每个工具必须有明确的 name、version、inputschema、outputschema。调用时做参数校验,失败时记录错误类型,方便快速定位。
# 工具注册表结构
TOOL_REGISTRY = {
    "git_operation": {
        "version": "1.2.0",
        "input_schema": {
            "operation": {"type": "string", "enum": ["diff", "log", "status"]},
            "repo_path": {"type": "string"}
        },
        "output_schema": {
            "type": "object",
            "properties": {
                "success": {"type": "boolean"},
                "data": {"type": "string"},
                "error": {"type": "string"}
            }
        },
        "executor": GitToolExecutor
    }
}
代码解释:
TOOLREGISTRY 是工具注册表,key 是工具名,value 是工具元数据。inputschema 定义输入参数类型和约束,output_schema 定义输出格式。executor 是实际的执行类。调用前可以先校验输入是否符合 schema,不符合直接返回错误,避免走到执行阶段才发现问题。
---
记忆系统:上下文窗口不是免费的
记忆系统是 Agent 最容易忽视的组件。
很多人以为把对话历史传给模型就够了。但团队协作时,问题很明显:每个 PR 的 Review 都是独立任务,但 Agent 会记住上一个 PR 的内容,导致判断混淆。
排查过程:
1. 现象:Agent 在 Review 第二个 PR 时,引用了第一个 PR 的结论
2. 验证:查看记忆存储,发现会话历史没有按任务隔离
3. 排除:不是模型理解问题,是记忆管理问题
4. 结论:缺少任务级别的记忆隔离
失败原因:
- 业务错误:记忆内容本身没有问题,但下游步骤错误地使用了其他任务的记忆
- 配置错误:记忆存储的 TTL(过期时间)配置不合理,导致旧记忆没有及时清除
- 环境错误:记忆存储服务不可用,导致记忆读写失败
解决方案是按任务隔离记忆,每个 PR 的 Review 任务有独立的记忆空间,任务结束后记忆可以清理或归档。
# 任务级记忆隔离
class TaskMemory:
    def __init__(self, task_id):
        self.task_id = task_id
        self.memory = []  # 当前任务的记忆

    def add(self, entry):
        self.memory.append(entry)

    def get_recent(self, n=5):
        # 只返回最近 n 条记忆
        return self.memory[-n:]

    def clear(self):
        # 任务结束后清理记忆
        self.memory.clear()
代码解释:
TaskMemory 是任务级记忆容器。每个任务实例化一个对象,add 方法添加记忆条目,get_recent 方法只返回最近的 n 条记忆(避免上下文过长),clear 方法在任务结束后清理记忆。这种设计保证了任务之间的记忆隔离,避免混淆。
适用边界:这种记忆隔离方案适合任务边界清晰的场景,比如 PR Review、代码检查。如果任务之间有强依赖关系,可能需要共享记忆,这时需要额外的记忆融合逻辑。
---
失败恢复:Agent 崩了,怎么知道是哪一步错了
Agent 失败是常态,关键是恢复能力。
我们遇到的问题是:Agent 执行到一半失败,日志只有一行"工具调用失败",不知道是第几步、为什么失败、怎么恢复。
排查过程:
1. 现象:Agent 执行中断,日志信息不足
2. 验证:查看执行轨迹,发现没有步骤级别的错误记录
3. 排除:不是工具本身的问题,是监控和日志缺失
4. 结论:缺少执行轨迹记录,无法快速定位失败点
失败恢复的核心是记录执行轨迹。每一步的输入、输出、耗时、错误信息都要记录下来,这样失败时可以快速定位问题,也可以支持重试和回退。
# 执行轨迹记录
class ExecutionTrace:
    def __init__(self, task_id):
        self.task_id = task_id
        self.steps = []  # 每步的执行记录

    def record_step(self, step_name, input_data, output_data, error=None, duration_ms=0):
        self.steps.append({
            "step": step_name,
            "input": input_data,
            "output": output_data,
            "error": error,
            "duration_ms": duration_ms
        })

    def get_failed_step(self):
        # 返回第一个失败的步骤
        for step in self.steps:
            if step["error"]:
                return step
        return None

    def get_summary(self):
        # 生成执行摘要
        return {
            "task_id": self.task_id,
            "total_steps": len(self.steps),
            "failed_steps": sum(1 for s in self.steps if s["error"]),
            "steps": self.steps
        }
代码解释:
ExecutionTrace 记录 Agent 的每一步执行。recordstep 方法记录单步执行信息,getfailedstep 方法返回第一个失败的步骤,getsummary 方法生成执行摘要。这种设计让失败定位变得简单:直接调用 getfailedstep,就能看到哪一步错了、错在哪里。
适用边界:执行轨迹记录适合所有 Agent 场景,但要注意存储成本。如果步骤很多、数据很大,可以考虑只记录关键步骤或压缩存储。
---
总结:团队协作比 Demo 难在哪
回到开头的问题:Agent 工具调用很顺,团队协作却崩了。
根本原因是 Demo 思维和工程思维的差异。Demo 关注的是"能不能跑通",工程关注的是"能不能稳定维护"。
工具调用、记忆管理、任务规划,这三个组件在 Demo 里可能不是问题,但在团队协作里,每个组件都需要额外的工程能力:
- 工具调用需要注册管理和版本控制
- 记忆管理需要任务隔离和生命周期管理
- 任务规划需要图结构和失败恢复机制
这些能力不复杂,但容易被忽视。团队落地 Agent 时,建议先做三件事:建立工具注册规范、设计任务级记忆隔离、记录执行轨迹。这三件事做了,维护成本会大幅下降。
最后说一个判断标准:如果你的 Agent 在团队里需要频繁人工干预才能跑通,说明工程化还没到位。不是模型的问题,是组件设计的问题。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
需要这份AI大模型资料清单的话,在评论区回复「清单」即可;我会根据大家的问题继续补充对应的实战内容。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 17
 0
- 0


 已为社区贡献11条内容

所有评论(0)