机器学习知识点总结 - 为什么L1正则化比L2正则化更稀疏
·
机器学习优化过程中的损失函数通常由经验损失和正则项两部分组成。经验损失反映了模型的预测值与真实数据的误差值;而正则项则对模型的复杂程度进行约束,使其不至于对数据进行过分表达,即减少过拟合的风险。
L1和L2范式是比较常用的正则项,相比于L2,L1正则化将产生稀疏的权值。这里面的原因是什么呢?
首先我们来看看L1和L2范式的数学定义:
- L1:向量元素绝对值之和,也称街区距离(city-block)
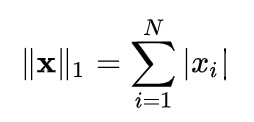
- L2:向量元素的平方和再开方。Euclid范数,也称欧几里得范数,欧氏距离
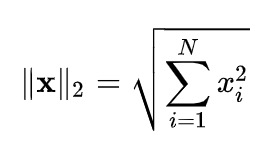
机器学习的优化目标是使得损失函数最小,即:

模型的训练过程就是尽可能选择最简单的模型使得经验误差尽可能的小,这样的话优化目标就等价于:
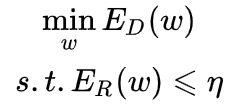
现在,我们可以用图来表示优化过程中L1正则化和L2正则化的区别:
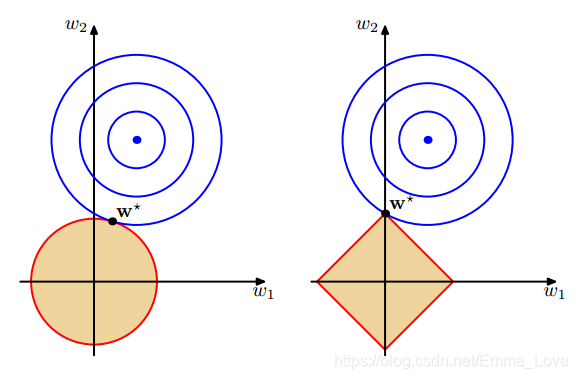
上图中,左图是对应L2范式,右图对应L1范式,w*是对应最优解,即经验误差和模型复杂度达到trade off。从图中可以看到,L2范式更平滑,倾向于为各个分量均分一些权重,因而更稠密;L1范式更有棱角,倾向于将部分分量设置为0,因而更稀疏。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)