企业微信智能客服的挑战与实现(四):从单机版到SaaS——多租户改造实录
摘要:一套单机版 AI 客服系统,要变成一个实例服务上百家企业的 SaaS,最难的往往不是加一列
tenant_id,而是另外三件事:老客户的库不能因为升级而出问题;隔离不能靠每个开发者记得加 where;还有「登录进来的都是自己人」这个前提,已经悄悄不成立了。本文是系列续篇,以冰石机器人接入微信官方客服、上架企业微信应用市场(应用名「冰石AI客服」)的改造为例,拆解租户模型选型、运行时双模式、框架级租户隔离、真机踩坑、开通与登录的自动化和容量路线。
本系列:
① 人机协同——机器人客服与真人客服如何共处一个会话
② 专属客户群与拟人化体验——让企微客服更像"一个团队在服务"
③ 知识库与 AI 自主学习
④(本篇)从单机版到 SaaS:多租户改造实录
一、为什么是微信客服,为什么现在做 SaaS
前三篇讲的都是一家企业一套部署:机器人跑在客户自己的 Windows 机器上,通过桌面自动化接管个人微信或企业微信。这条路功能最全,但有个天然的上限:一个实例对应一个账号、一台机器。每多一家客户,就要多装一台机器、多做一次运维。
企业微信的「微信客服」提供了另一条路:客户在微信里扫码或点链接进入客服会话,消息通过官方回调接口推给服务商,回复也走官方 API。它和前三篇的方案对比如下:
| 桌面自动化(个微 / 企微 RPA) | 微信客服官方接口 | |
|---|---|---|
| 运行形态 | 依赖一台常驻的 Windows 机器 | 纯服务端,回调驱动 |
| 一个实例服务 | 一个账号 | 任意多家企业 |
| 合规性 | 需自行把握平台规范 | 官方开放能力,第三方应用上架审核 |
| 能否 SaaS 化 | 只能做托管私有部署 | ✅ |
所以第一个结论很简单:回调驱动的渠道进 SaaS 主线,依赖桌面环境的渠道留在私有部署。两者共用一套代码,用构建变体(--version=wxkf)隐藏 SaaS 版里不需要的渠道菜单。
第二个结论是,租户键不用自己造。企业在应用市场安装应用时,企微会把授权企业的 corpid 推过来,后续每条消息回调也按它路由。于是 tenant_id = corpid,平台自己的数据、历史单机版的数据统一记为 default。
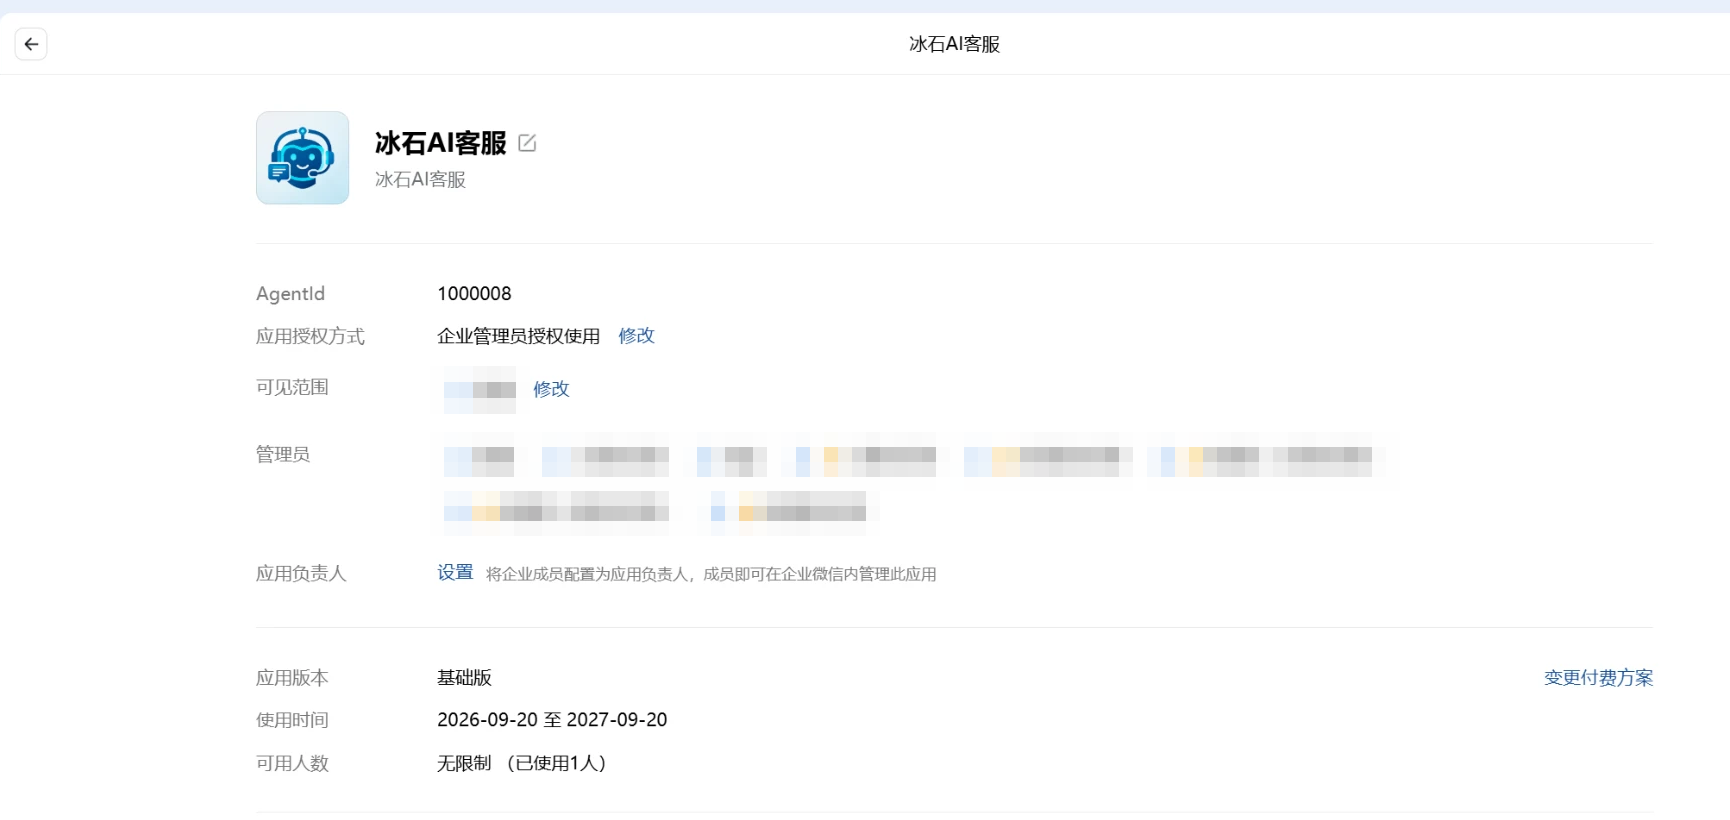
企业安装「冰石AI客服」后,在企业微信管理后台看到的应用详情(成员姓名已打码)
二、租户模型:共表 + tenant_id
多租户的数据隔离有三种经典形态,我们逐个算了账:
| 方案 | 几十家 | 几百上千家 | 结论 |
|---|---|---|---|
| 每租户一个实例 | 可行 | 每个实例常驻几百 MB(分词词典、模型客户端),上千个进程的编排等于自己造一个 K8s,而且大量租户是闲置的 | ❌ |
| 每租户一个数据库 | 可行 | 每次迁移要跑 N 遍、跨租户统计要跨 N 个库、连接管理失控 | ❌(只留给有合规要求、愿意付大钱的大客户) |
| 共表 + tenant_id | 可行 | 单库点查,索引带上租户前缀即可 | ✅ |
正确的形态是:消息入口按 corpid 给消息打上租户标,后面是一个共享的无状态 worker 池。
共表的最大风险是"某处代码漏写了 WHERE tenant_id = ?",一次漏写就是一次跨企业数据泄漏。第四节专门讲怎么让这件事不依赖人的记性。
三、老客户不能出问题:运行时双模式
改造时已经有一批在跑的单机版客户。给 18 张业务表加 tenant_id 列,意味着他们的老库和新代码之间出现了结构差。
最危险的不是启动失败,而是运行中失败:SQLAlchemy 的 create_all(checkfirst=True) 只建缺失的表、不补列。老库跑新代码,启动一切正常,等到某个查询带上 tenant_id 时才抛 no such column,而且是在客户正在接待客人的时候。
我们的做法是:不做启动自动迁移,由库的实际结构决定进程跑哪种模式。
def detect_mode() -> bool:
    cols = columns_of("users")          # 每个安装都有、行数极少的哨兵表
    if not cols:                        # 表不存在 = 全新库,create_all 直接建新 schema
        return True
    return "tenant_id" in cols          # 有列 = 已迁移过;没列 = 未升级的老库

TENANT_MODE = detect_mode()             # import 时冻结,迁移后必须重启进程
模式决定了模型本身长什么样:
if TENANT_MODE:
    class TenantMixin:
        tenant_id = Column(String(64), nullable=False, index=True,
                           default="default", server_default="default")
else:
    class TenantMixin:
        """legacy 空壳:不带任何列,表结构与改造前逐字节一致"""
| 库的状态 | 模式 | 行为 |
|---|---|---|
| 老库,未升级 | legacy | 没有 tenant_id、不注册任何过滤事件,行为与改造前完全一致 |
| 手工升级过 | tenant | 多租户全量生效 |
| 全新安装 | tenant | 直接建出新 schema;单机版客户的数据全部归 default 租户,功能无差别 |
几个细节:
- 加列必带默认值:
ADD COLUMN tenant_id TEXT NOT NULL DEFAULT 'default'。SQLite 只改元数据、不重写表,千万行也是毫秒级。存量数据自动归入 default,单机版客户永远活在 default 租户里,零感知。 - 回滚安全:旧代码的 SELECT 都写明了列名,会忽略多出来的 tenant_id,所以旧代码跑新库也没问题。
- 两种模式各跑一遍全量测试,失败集合必须完全一致。有一个专门的测试文件锁住"单渠道版跑在 tenant schema 上"这条路径,因为新装的个微版、闲鱼版客户,库其实也是 tenant 结构。
启动日志里有一行 schema_mode: tenant/legacy,客户报问题时先看这一行。
四、隔离靠框架,不靠自觉
业务代码里散落着几百处 db.query(...),逐个加 where 必然有遗漏,新写的代码也会忘。所以隔离必须在一个地方强制执行。
4.1 租户上下文:ContextVar
"当前这段代码在为哪个租户干活"放在一个 ContextVar 里,由入口负责设置:
- 管理后台请求:中间件从登录 token 的
tid字段取出并设置; - 消息回调链路:定位到客服账号后按账号归属设置(第六节会讲为什么不能按回调里的 corpid)。
关键在于没设置时怎么办:
def resolve_tenant():
    value = _current_tenant.get()
    if value is _UNSET or value is None:
        return "default"            # fail-closed:忘了设,只会看不到别家数据
    return value
忘记设上下文的代码只会看到 default 的数据。这种 bug 表现为功能缺失,很容易被发现,而且不会泄漏。反过来,如果默认是"不过滤",那就是一次静默的跨企业泄漏。
平台管理员需要跨租户查看时,必须显式传入 ALL_TENANTS 哨兵,不存在"不小心看到全部"。
4.2 一处注册,覆盖全部查询
SQLAlchemy 的两个 Session 事件承担了全部执法:
@event.listens_for(SessionLocal, "do_orm_execute")
def tenant_read_filter(state):
    if not (state.is_select or state.is_update or state.is_delete):
        return
    tid = resolve_tenant()
    if tid is ALL_TENANTS:                      # 平台视角:显式声明才放开
        return
    state.statement = state.statement.options(
        with_loader_criteria(TenantMixin,
                             lambda cls: cls.tenant_id == tid,
                             include_aliases=True))

@event.listens_for(SessionLocal, "before_flush")
def tenant_write_guard(session, flush_context, instances):
    tid = resolve_tenant()
    for obj in session.new:                     # 新行自动填 tenant_id
        if isinstance(obj, TenantMixin) and obj.tenant_id is None:
            obj.tenant_id = tid
    for obj in [*session.dirty, *session.deleted]:
        if isinstance(obj, TenantMixin) and obj.tenant_id != tid:
            raise PermissionError("跨租户写被拦截")   # 纵深防御
with_loader_criteria 会把条件加到所有挂了 TenantMixin 的实体上,包括 join 和别名,所以业务代码一行都不用改。写守卫是第二道防线:正常业务根本查不到别家的行,能走到这里,说明有代码用 ALL_TENANTS 捞出了对象,又切回某个租户的上下文去写,这本身就是 bug。
4.3 框架覆盖不到的地方
ORM 事件管不到的面必须一个个列出来,写进开发纪律:
- 原生 SQL(
text(...)、Core insert、bulk 操作):新代码禁止用裸 SQL 读写租户表; - FTS5 全文索引:虚表不走 ORM,加一列
tenant_id UNINDEXED,查询侧显式AND tenant_id = ?,性能损耗可以忽略; - 线程池:
ContextVar不会自动跨executor.submit传播。回复后处理、识图这些提交到线程池的任务,一旦丢了上下文就会回落到 default。所有 submit 点统一包一层:
executor.submit(run_with_current_tenant(fn, *args)) # 内部是 contextvars.copy_context()
- 唯一约束:原来"分类名唯一""SKU 唯一"是全局唯一。多租户后,A 企业建了「售后」分类,B 企业就建不了,导入 FAQ 整批失败。唯一约束要全部改成
(tenant_id, name)。
五、"登录进来的都是自己人"这个前提不成立了
单机版里,能登录后台的就是客户自己的员工,所以大量历史接口只校验"是否登录"。SaaS 之后,每个租户都拿着一个合法 token。
5.1 平台接口的收口
逐个排查后发现,租户拿着自己的 token 可以调用大模型对话接口(消耗平台的 API Key),也能驱动闲鱼、群发这些根本不属于他的渠道。
逐个端点补依赖一定会漏,而且新写的端点默认仍然是"租户可访问"。所以改成在 router 级别声明一次:
_PLATFORM_ONLY = [Depends(platform_scope(get_current_active_user))] if TENANT_MODE else []

api_router.include_router(llm_router, prefix="/llm", dependencies=_PLATFORM_ONLY)
api_router.include_router(unified_broadcast_router, prefix="/unified-broadcast", dependencies=_PLATFORM_ONLY)
api_router.include_router(xianyu_router, prefix="/xianyu", dependencies=_PLATFORM_ONLY)
# ... 共十几个平台专属 router
例外要想清楚:含有企微回调这类免登录端点的 router 不能挂闸门,否则闸门会要求回调带登录态,企微的推送会直接被 403。这类 router 靠端点级的权限依赖来保护。
再配一条结构性测试:遍历这批前缀下的所有路由,断言每条都带着闸门。以后有人新增平台 router 却忘了挂闸门,CI 会直接挡下。靠测试守住约定,比靠文档提醒可靠得多。
5.2 进程级单例:多租户的隐形杀手
比接口更隐蔽的是进程内的全局状态。两个真实的例子:
关键词匹配器原来是一个进程级单例,保存关键词时整体重建。多租户之后,任何一家企业保存一次关键词,就会把整个进程的匹配规则换成它那一份(缓存 60 秒)。在这 60 秒里,所有企业的客户收到的都是这家的关键词回复。修法是按租户各维护一套匹配器,default 租户复用原来的单例,保证单机版行为不变。
大模型客户端池也是进程级的,按配置 id 键控。租户点一次「设为默认」会触发刷新,原来的刷新逻辑是"清空后按当前可见的配置重建"。而在租户上下文里"可见的配置"只有自己那几条,结果把平台和其他所有租户的客户端全清掉了。修法是初始化时显式切到 ALL_TENANTS,注册全部租户的配置。
教训是:做多租户改造时,要把所有"进程级、没有租户键"的状态列一张清单,逐项确认它是真的全局,还是只是"以前恰好只有一个客户"。
5.3 每家企业可以用自己的大模型
大模型配置表也挂上了租户过滤:企业可以填自己的 Key;没配置时回落到平台默认,不填 Key 的租户和改造前完全一样。这里有三个容易出安全问题的点:
- 按 id 取配置时只允许命中"本租户 + 平台"的行。否则租户把配置 id 改成别人的行号,就能用别人的 Key;
- 配置管理接口不用这个回落逻辑,否则
GET /llm/configs/{id}会把平台配置的 Key 明文返回给租户; - 租户自填的
api_base过 SSRF 闸门:只允许 http/https,解析出的地址不能落在回环、私网或保留网段。因为租户既能建配置又能点「测试」,而测试接口会把上游的错误响应原样回显,不拦的话就是一个能读内网的 SSRF。平台账号不受这个限制,因为自建的 Ollama / vLLM 本来就跑在内网里。
开通新企业时,会把平台的整套模型配置克隆一份给他:同名、同参数,但 Key 为空、默认不启用。企业进来看到的是一整排熟悉的选项,逐个填 Key 就能用,平台的 Key 一个都不会暴露。
六、真机踩坑:回调里的 corpid 不可信
消息链路的租户归属,第一版是按回调里带的 corpid 判断的,看起来天经地义。上真机后发现:回调明文里的那个字段,有时是 suite_id,有时是空串,有时是自建应用的 corpid。
后果很曲折:
有意思的是,写守卫拦对了。它发现了归属不一致,拒绝了跨租户写。但外层有一个"防止单条失败影响整批"的宽泛 except,把这个信号吞掉了。表现出来就是一批消息被反复拉取,而日志里什么都看不出来。
修法是换一个归属真源:客服账号行(它在授权时就绑定了所属企业)。入口先用 default 起步,定位到账号行之后,按行上的 tenant_id 校正本轮上下文,后续的回复、落库、后处理全部按它来。
同一类问题还有一个反方向的例子:平台超管的控制台里,「授权企业」表的账号数恒为 0。原因是超管的上下文恒为 default,fail-closed 的过滤把所有企业的账号行都藏起来了。这里需要显式放开:只在真正的平台视角下切到 ALL_TENANTS 去读;定位到行之后要写时,再切回 row.tenant_id,让写守卫继续按行的真实归属生效。
排查客户问题时,平台超管还需要"以某家企业的身份"看数据。我们做了一个租户视角:超管在顶栏选一家企业,之后浏览器的每个请求都带上 X-Tenant-Id,中间件校验通过后把这次请求的租户上下文切成这家,现有页面零改动就能显示这家企业的数据,顶栏下方常驻一条橙色警示。校验条件是显式合取的:token 签名有效、token 属于平台、数据库里这个账号确实是平台管理员、目标企业存在,任何一条不满足就不切换。还有一条最容易忽略:没有有效 token 时,这个请求头一律忽略。消息回调端点是免登录的,否则任何人 POST 时带上这个头,就能冒充别家企业走回调链路。
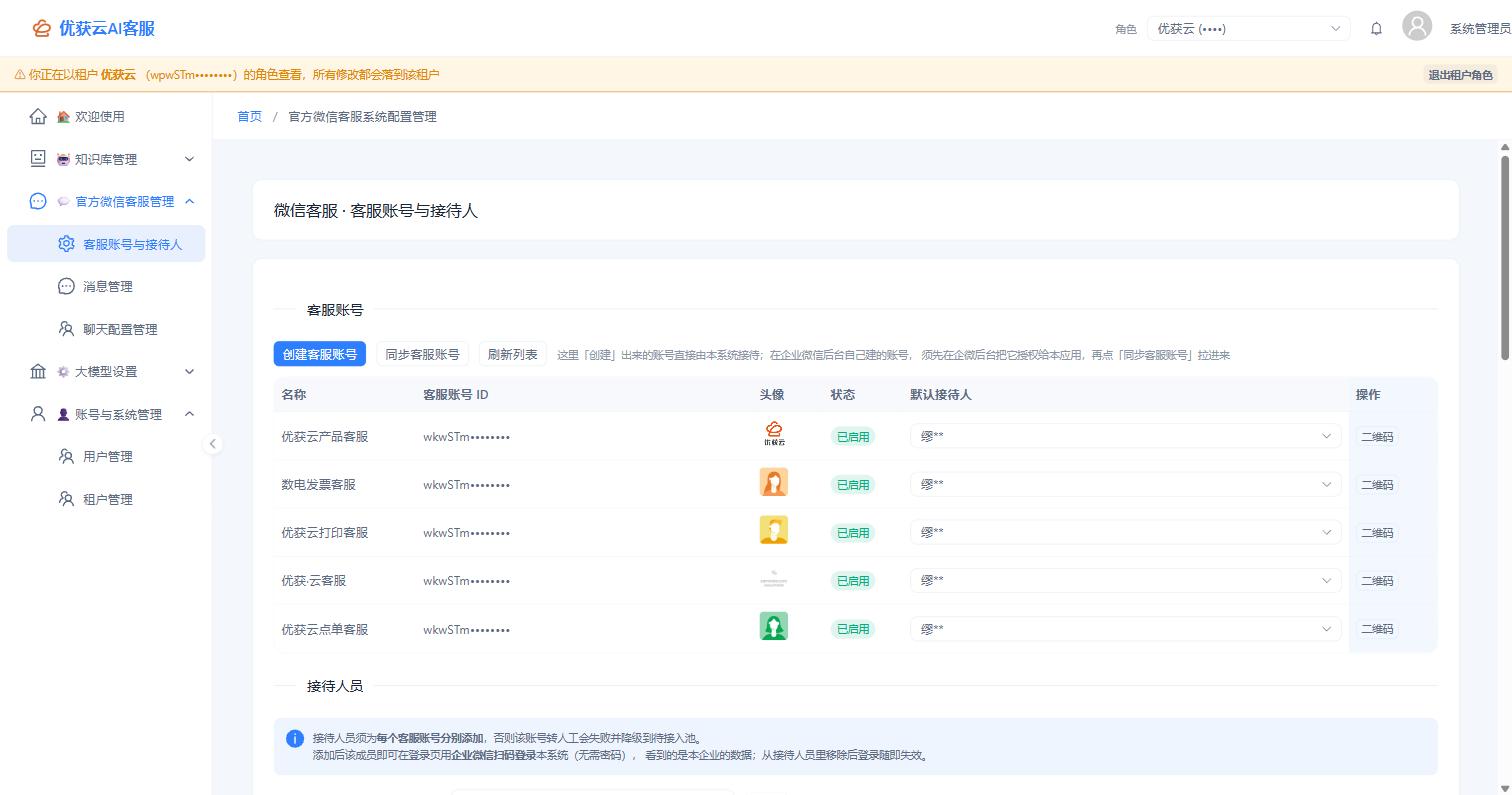
平台超管以租户视角查看某家企业的「客服账号与接待人」页,顶部橙色条提示当前视角。这家企业用的是 OEM 贴牌版,所以界面品牌显示为合作方自己的名称(成员姓名、企业与账号 ID 已打码)
这两个坑放在一起看,正好说明了 fail-closed 的代价和价值:它会制造"看不到"的 bug,但不会制造"看到别人"的 bug。前者一上真机就暴露,后者可能永远没人发现。
七、开通与登录:让客户自己走完
SaaS 能不能规模化,要看开通链路里有没有"需要平台人工介入"的步骤。我们的目标是:企业在应用市场点安装之后,不需要找任何人。
7.1 授权即开户
企业扫码授权后,回调里换取永久授权码,随后自动完成:建租户记录、建登录账号、同步客服账号并打上租户标、克隆模型配置。企业卸载应用时,租户标记为已取消、登录账号停用,已经签发的 token 在下一次请求时就会被拒(每个请求都校验租户状态),数据全部保留;重新授权后自动恢复。
这里有一个事务边界的坑:克隆模型配置那一步如果和建账号放在同一个事务里,一旦老库还没迁移好、查询抛出 no such column,回滚会把刚建的租户和账号一起带走。结果是客户授权成功了,却永远登不进来,日志里只有一句"不影响授权流程"。所以身份先单独提交,附属的初始化各自用独立事务。
7.2 客户拿不到自己的用户名
登录账号的用户名是 corpid。但服务商模式下,企微给服务商的是服务商专属的密文 corpid,客户在自己的管理后台只能看到明文 corpid。也就是说,客户根本不知道自己的用户名。
最后做了三条登录路径,都不用平台人工告知:
| 方式 | 链路 | 要点 |
|---|---|---|
| 工作台点开应用 | 企微内置浏览器天然带着成员身份,走静默网页授权 | 客户什么都不用输,这是推荐入口 |
| 电脑浏览器扫码 | 手机企微扫码 → 手机上点「确认登录」→ 电脑端轮询换 token | 手机上那一下确认是防二维码钓鱼:生成二维码的接口不需要登录,攻击者可以自己生成一个码丢进企业群骗人扫;所以放行凭证是回调时现发、只出现在扫码人页面上的一次性 token |
| 明文企业 ID + 密码 | 后端调用官方"明文转密文"接口定位账号 | 只有长得像 corpid 的输入才去调接口;解析失败统一报"用户名或密码错误",不让登录接口变成"某企业是否已授权"的探测器 |
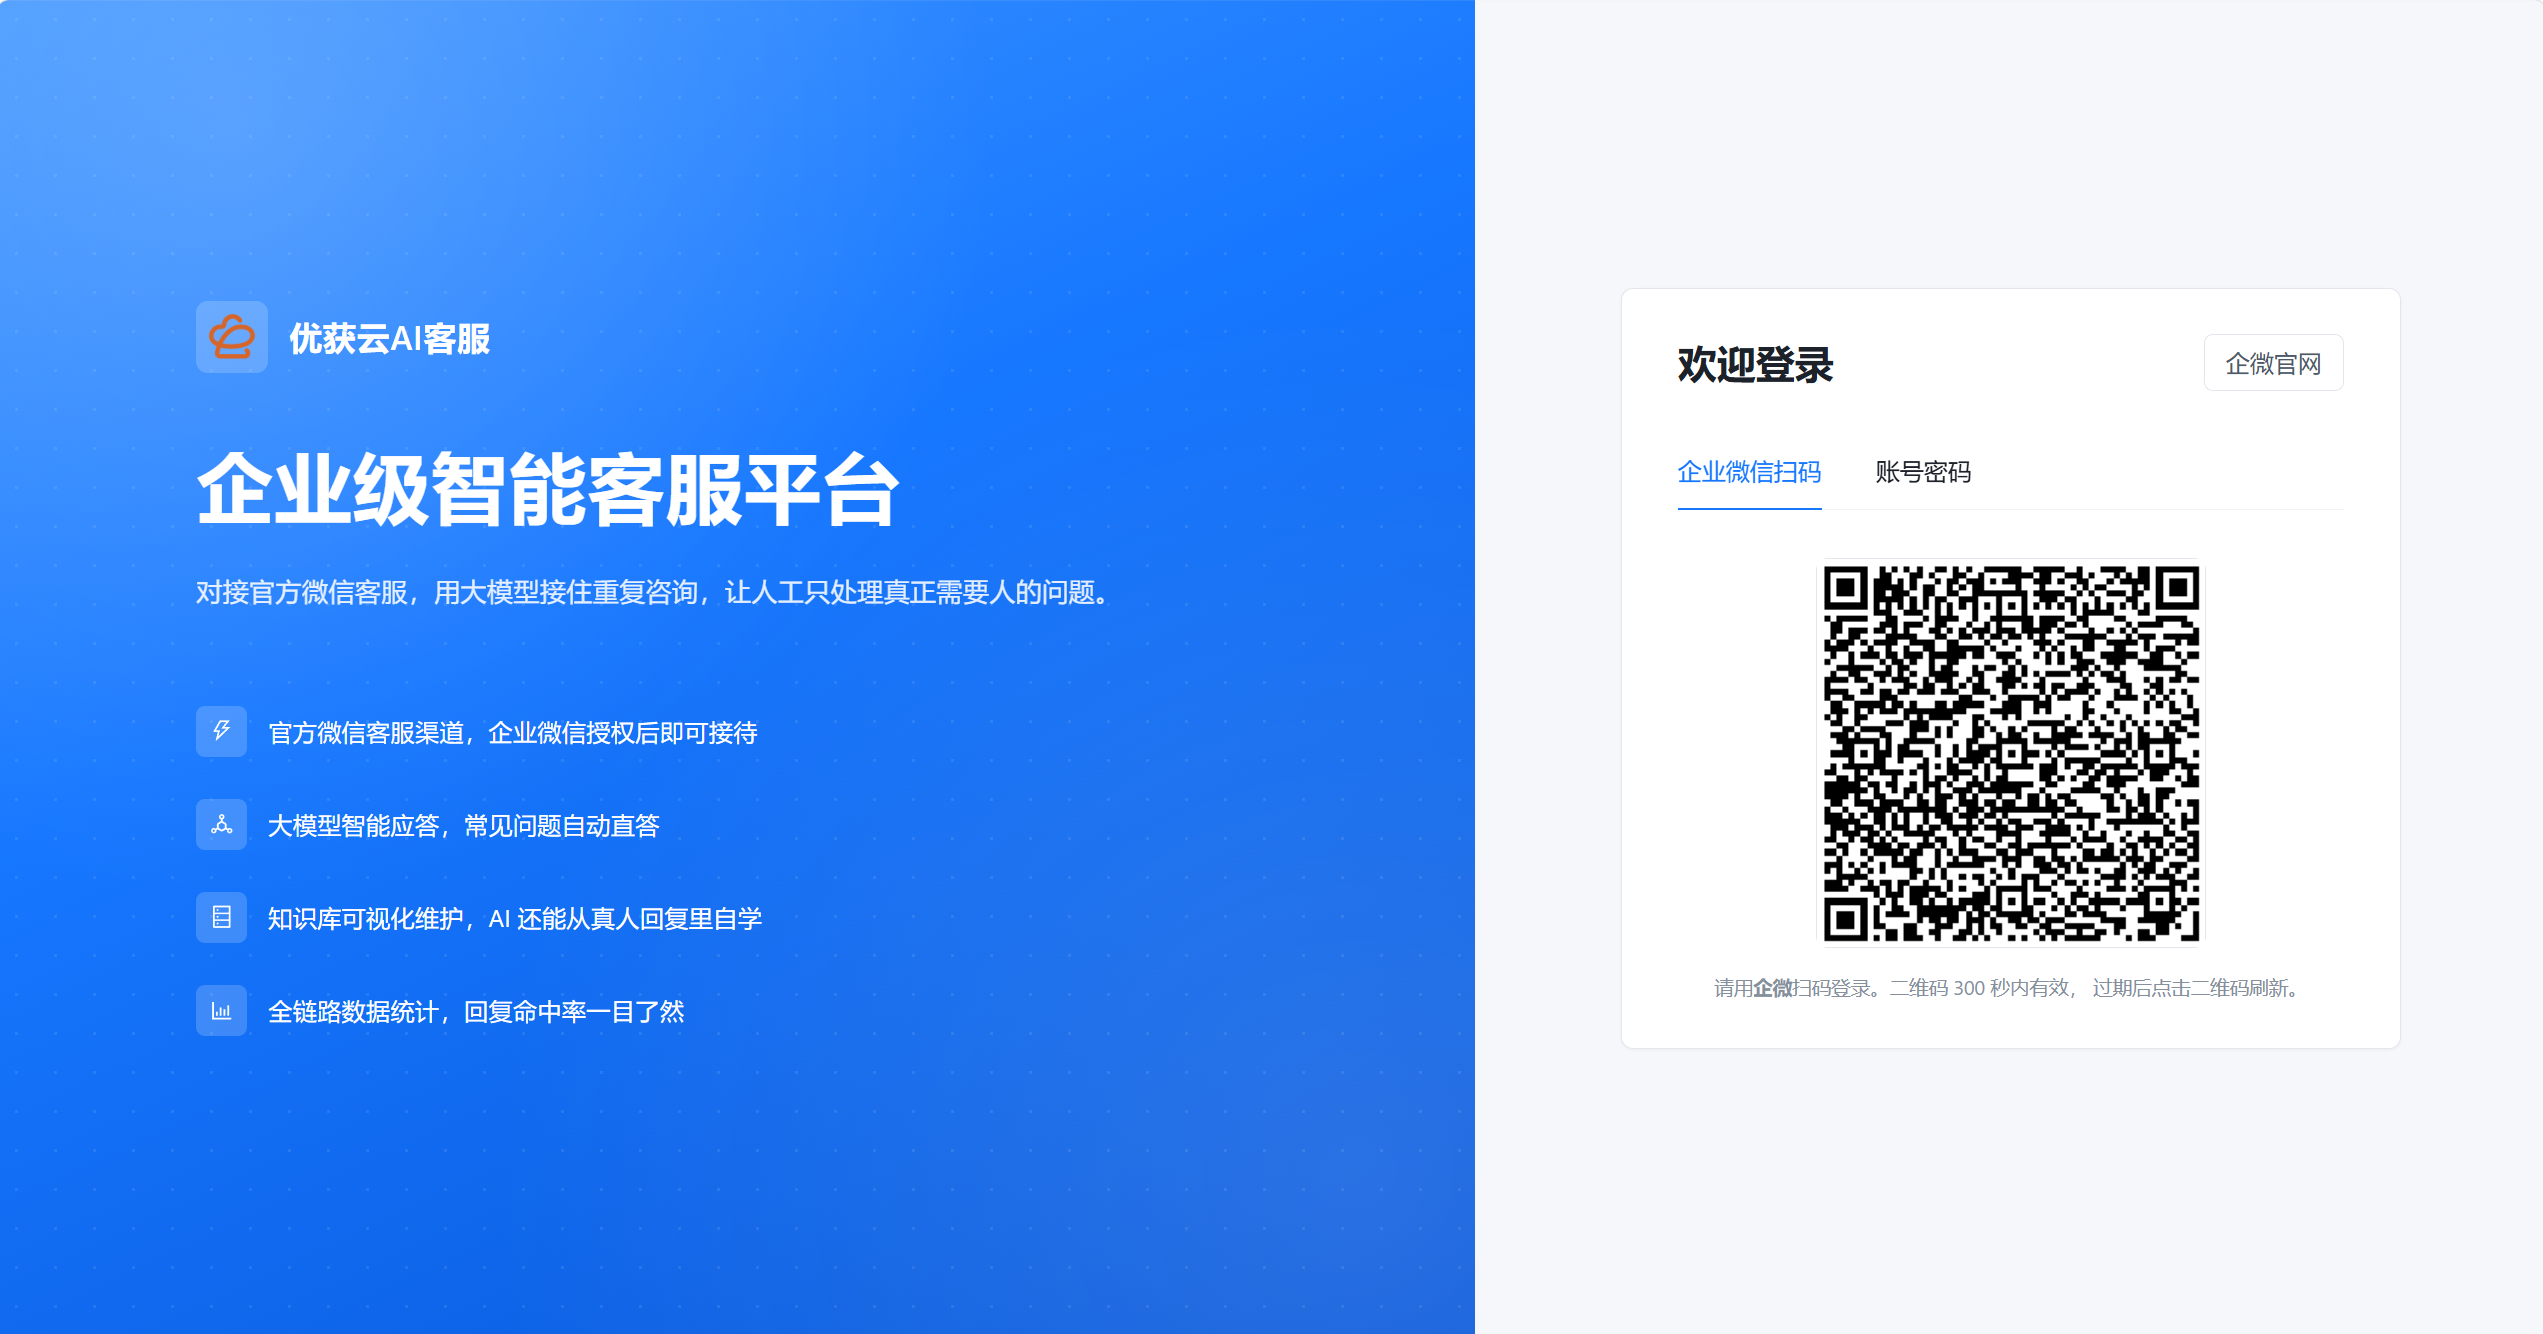
登录页默认是企业微信扫码;OEM 贴牌版的品牌名、Logo 与文案可按合作方定制
7.3 接待人员名单即登录授权
开户时只建了一个管理员账号,可每天看会话、回消息的是接待员。我们把"这个企微成员在本企业的接待人员名单里"直接当作登录授权:管理员在后台把人加进名单,这个人就能扫码登录;移出名单,登录权限随即失效。
名单的真源在企微侧,并且是按客服账号分别维护的。对账时有两条硬约束:
- 必须按全租户所有客服账号的并集来算。同一个人常常挂在多个客服账号下,只按当前账号对账,会把别的账号下的接待员误停;
- 名单取不全时只增不停。任何一个账号的名单拉取失败,本轮就一律不停用任何人,并且把"本次不完整"透传给操作者。否则"移除了却还能登录"没有人看得见。
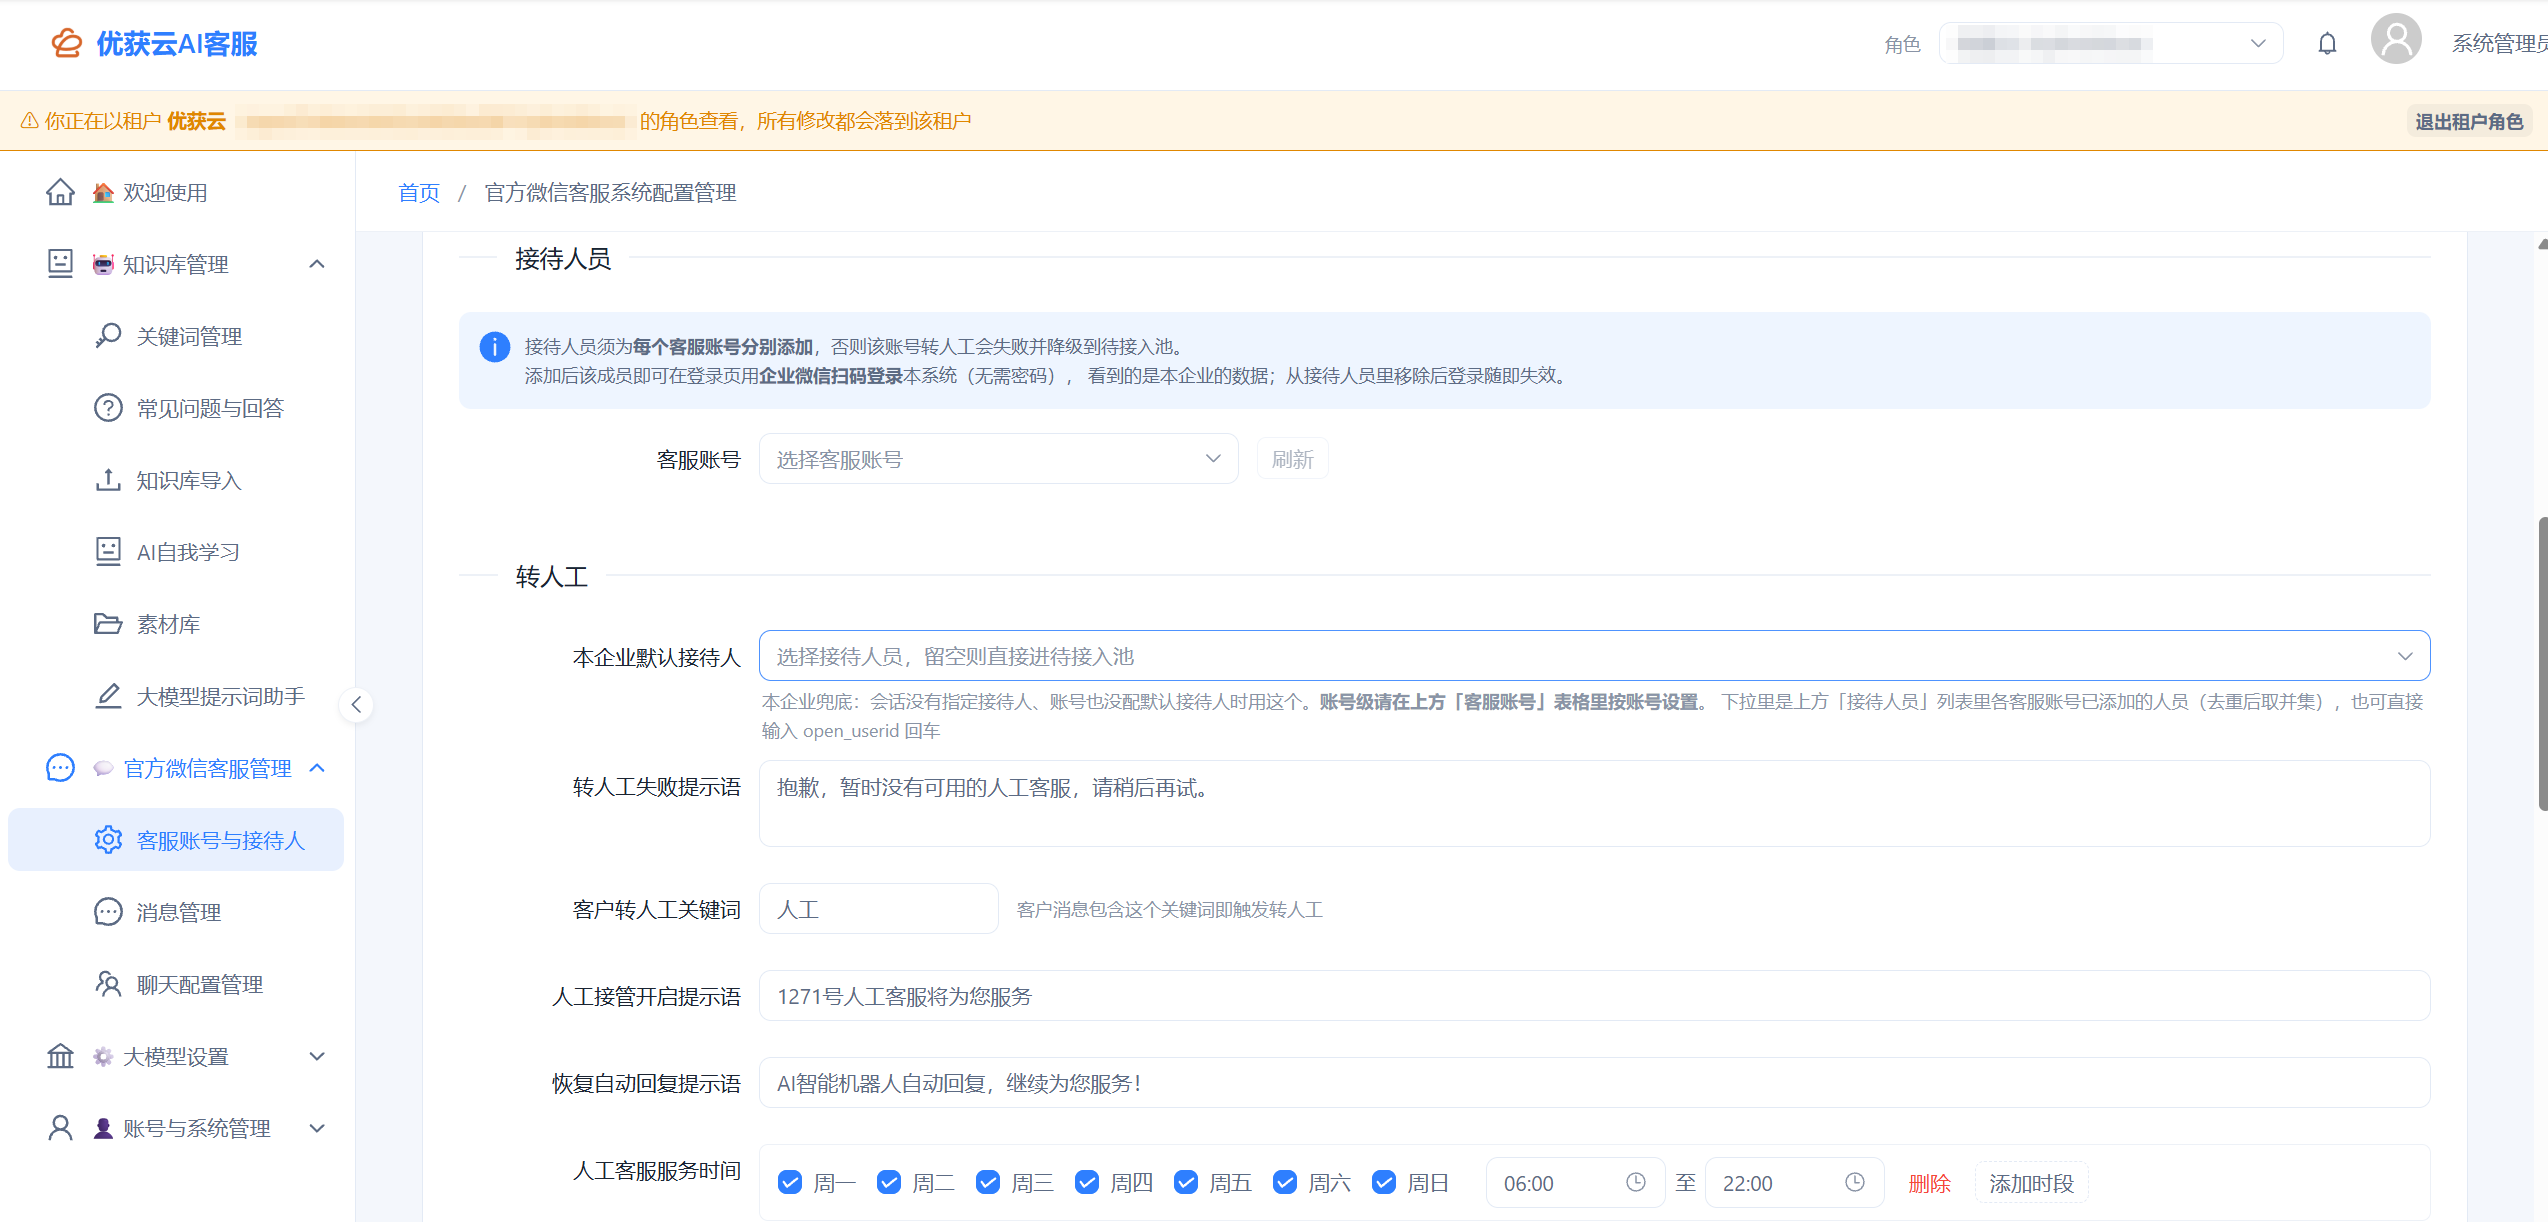
租户自己能配置的那部分:接待人员按客服账号分别添加,加进名单即可扫码登录;转人工的提示语、关键词、服务时段都是企业级配置,没设置过的项回落平台默认值(企业 ID 已打码)
八、能撑多少家
按每家企业每天 5000 次回复估算,SQLite 单机的容量是这样的:
| 状态 | 容量 | 瓶颈 |
|---|---|---|
| 代码原样 | 5~10 家 | 取历史记录全表扫描 + SQLite 默认配置 |
| 修完两个硬伤 + 消息归档 + 合并写事务 | 约 50 家舒适,100 家天花板 | 单进程 Python、共享的 LLM 线程池、单库无故障隔离 |
两个硬伤都很典型:
- 取会话历史走了全表扫描。查询条件是
receiver_id = ? OR group_id = ?,而表上的三个索引一个都用不上,于是每次回复的成本随消息表总行数线性增长。这个 OR 有历史原因(微信客服的会话 id 格式和其他渠道不同,只比一个字段会让聊天界面查不到消息),所以修法是给两个字段各建一个带时间的复合索引,让 OR 走索引合并。 - 生产环境的 SQLite 跑在默认配置上。
journal_mode=DELETE+synchronous=FULL,每次提交两次 fsync,写期间所有读被锁。一次回复有 4~5 个写事务,实际写吞吐只有每秒 50~150 个事务。改成 WAL +synchronous=NORMAL+busy_timeout,要在每个连接建立时通过 connect 事件设置,因为后两个参数是按连接生效的。
再往上,每一步都不推翻上一步:
| 阶段 | 客户数 | 形态 |
|---|---|---|
| 1 | ~50 | 单体 + SQLite 修补 + tenant_id 落地(当前) |
| 2 | ~1000 | 拆成"接入 + Worker",PostgreSQL + Redis + 消息队列 |
| 3 | ~1 万 | 上 K8s,Worker 按队列深度自动伸缩,消息历史迁到宽表存储 |
| 4 | ~10 万 | 分舱(cell):每舱一套 Worker + 库分片,服务约 5000 家;扩容等于加舱,故障关在舱内 |
算到 10 万家时,结论可能有点反直觉:最大的成本和瓶颈是大模型调用费和推理并发,不是基础设施。到那个量级,需要一个独立的 LLM 网关层,负责租户级并发池、令牌计量(这就是计费依据)和多供应商路由降级。
为了让后面的阶段能平滑过渡,现在就要埋下三颗种子:
- tenant_id 贯穿所有数据,包括全文索引、上传文件的目录(素材库已经按
uploads/tenants/{corpid}/分目录,corpid 拼进路径前先过白名单); - 进程内状态全部外置:人工接管开关、各种进程缓存、单进程定时任务。在这之前,
workers=1是硬前提; - 回调入口和消息处理解耦:回调只做验签、落队列、返回 200。
九、总结
| 挑战 | 机制 |
|---|---|
| 老客户的库不能因升级出问题 | 按库结构决定运行模式;加列带默认值;两种模式各跑一遍全量测试 |
| 隔离不能靠人记得加 where | ContextVar + with_loader_criteria 自动过滤 + 写守卫;FTS5、线程池、唯一约束逐项补齐 |
| 忘了设租户怎么办 | fail-closed:折叠为 default,只会少看,不会多看 |
| 租户拿着合法 token | 平台 router 级闸门 + 结构性测试;进程级单例按租户拆分 |
| 企业用自己的大模型 | 按 id 白名单、Key 不外泄、api_base 过 SSRF 闸门 |
| 回调里的 corpid 不可信 | 以客服账号行作为归属真源 |
| 开通不能靠人工 | 授权即开户;三条登录路径;接待人员名单即登录授权 |
| 能撑多少家 | 修两个硬伤到约 50 家;四阶段路线到 10 万家 |
三条贯穿始终的经验:
1. 默认值决定安全性。 忘了设租户就折叠成 default,平台视角必须显式声明,新 router 默认要挂闸门。出错时,选那个"容易被发现、不会造成不可逆伤害"的方向:看不到数据的 bug 一上真机就暴露,而数据一旦泄漏给别家企业,就收不回来了。
2. 约定要靠测试守住。 “平台 router 必须挂闸门”“两种模式失败集合一致”“跨租户写必须被守卫拦下”,这些都不是写在文档里的提醒,而是 CI 里的断言。
3. 多租户改造的难点在"以前恰好只有一个客户"的地方。 进程级单例、全局唯一约束、"登录即自己人"的接口、全平台共用的配置,它们以前都不是 bug,只是隐含了一个已经不成立的前提。
这次改造的成果,就是已经上架企业微信应用市场的 「冰石AI客服」。企业在应用市场搜索安装后,不需要申请任何大模型 Key,三步就能让 AI 接待微信客服:
- 配置客服账号与接待人:直接创建客服账号,或同步企业已有的账号,再添加转人工时接手的员工;
- 生成提示词:用提示词助手按企业情况生成机器人的"岗位说明书",一键应用到客服账号;
- 导入知识库:上传 Word / PDF / PPT / Excel 等资料,自动整理成问答,审核后生效。
前三篇讲到的三级应答链路、图文知识库、AI 自主学习、转人工,在 SaaS 版里都可以直接使用。同一套 SaaS 也支持 OEM 贴牌:合作伙伴可以用自己的品牌名、Logo 和后台域名为客户提供服务,上文截图里的租户就是这样一家 OEM 客户。
冰石机器人官网:icestonebot.com
本文所述机制基于冰石AI客服 2026 年 9 月的实际部署版本,配置项名称、默认值与实现细节以实际版本为准。请在遵守企业微信平台规范的前提下合规使用。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)