十大经典机器学习算法简介
目前比较主流的机器学习大概有这些:线性回归(Linear Regression)、逻辑回归(Logistic Regression)、决策树(Decision Trees)、K近邻算法(K-Nearest Neighbors,KNN)、支持向量机(Support Vector Machines,SVM)、朴素贝叶斯(Naive Bayes)、K均值聚类(K-Means Clustering)、主成分分析(Principal Component Analysis,PCA)、随机森林(Random Forest)、神经网络(Neural Networks)。
一、线性回归
线性回归基于以下基本原理:
线性关系假设:假设目标变量与特征之间存在线性关系。
最小化误差:通过最小化实际观测值与模型预测值之间的误差来确定最佳拟合直线。
import matplotlib
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

# 加载加州房价数据集
housing = fetch_california_housing()
X = pd.DataFrame(housing.data, columns=housing.feature_names)
y = housing.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 训练线性回归模型
lr = LinearRegression()
lr.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = lr.predict(X_test)

# 计算均方误差
mse = mean_squared_error(y_test, y_pred)
print("均方误差:", mse)

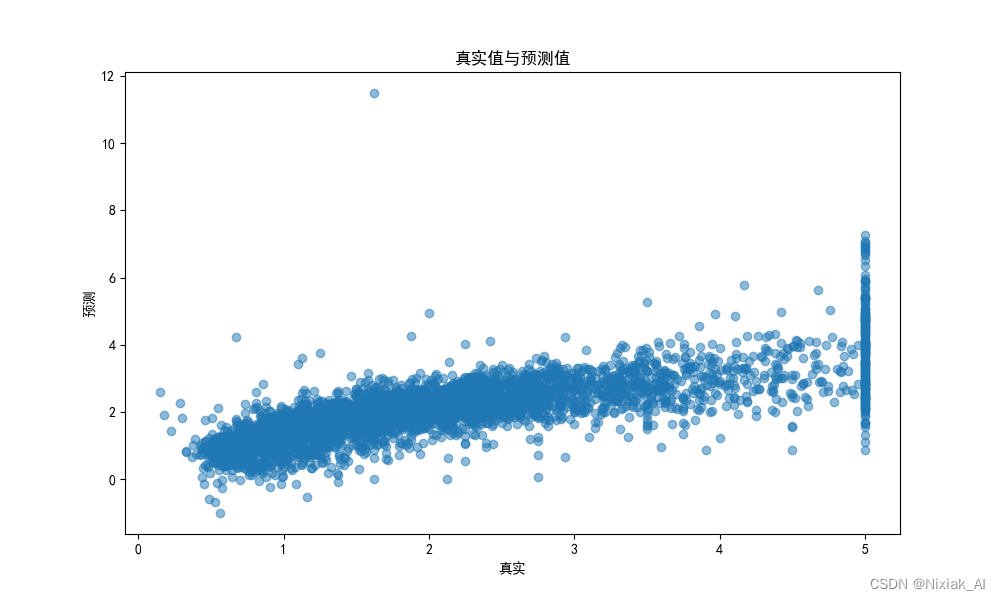
# 绘制预测值与真实值的散点图
matplotlib.rcParams['font.sans-serif'] = ['SimHei']
matplotlib.rcParams['axes.unicode_minus'] = False
plt.figure(figsize=(10, 6))
plt.scatter(y_test, y_pred, alpha=0.5)
plt.xlabel("真实")
plt.ylabel("预测")
plt.title("真实值与预测值")
plt.show()
二、逻辑回归
逻辑回归的基本原理如下:
假设数据服从一个二项分布。
使用线性回归模型的线性组合来建模数据的对数几率。
对线性组合应用逻辑函数(Sigmoid函数),将连续的输出转换为概率值。
根据概率值进行分类,通常设置一个阈值来决定类别。
import numpy as np
import matplotlib
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix
from matplotlib.colors import ListedColormap

# 加载鸢尾花数据集
iris = load_iris()
X = iris.data[:, :2]  # 只选择前两个特征用于可视化
y = iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 训练逻辑回归模型
lr = LogisticRegression()
lr.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = lr.predict(X_test)

# 计算准确率
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)

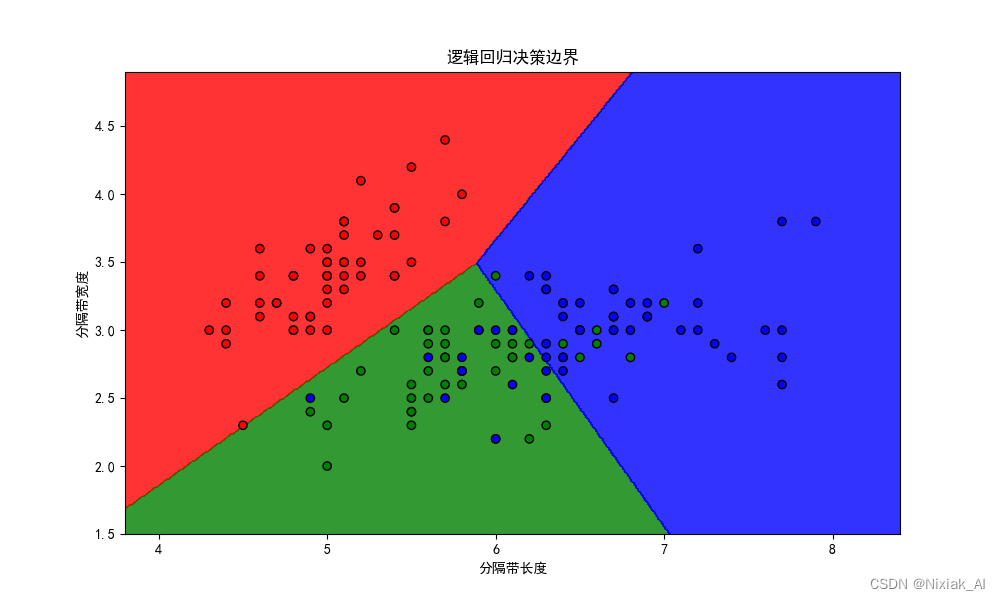
# 绘制决策边界
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.01),
                     np.arange(y_min, y_max, 0.01))
Z = lr.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

# 绘制结果
matplotlib.rcParams['font.sans-serif'] = ['SimHei']
matplotlib.rcParams['axes.unicode_minus'] = False
plt.figure(figsize=(10, 6))
plt.contourf(xx, yy, Z, alpha=0.8, cmap=ListedColormap(('red', 'green', 'blue')))
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=ListedColormap(('red', 'green', 'blue')), edgecolors='k')
plt.xlabel('分隔带长度')
plt.ylabel('分隔带宽度')
plt.title('逻辑回归决策边界')
plt.show()
三、决策树
决策树的基本原理如下:
根据数据集中的特征,选择最优的特征进行划分。
递归地将数据集划分为子集,直到满足停止条件。
每个叶节点表示一个类别或一个数值。
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, plot_tree
from sklearn.metrics import accuracy_score

# 加载鸢尾花数据集
iris = load_iris()
X = iris.data
y = iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 构建决策树模型
dt = DecisionTreeClassifier()
dt.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = dt.predict(X_test)

# 计算准确率
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)

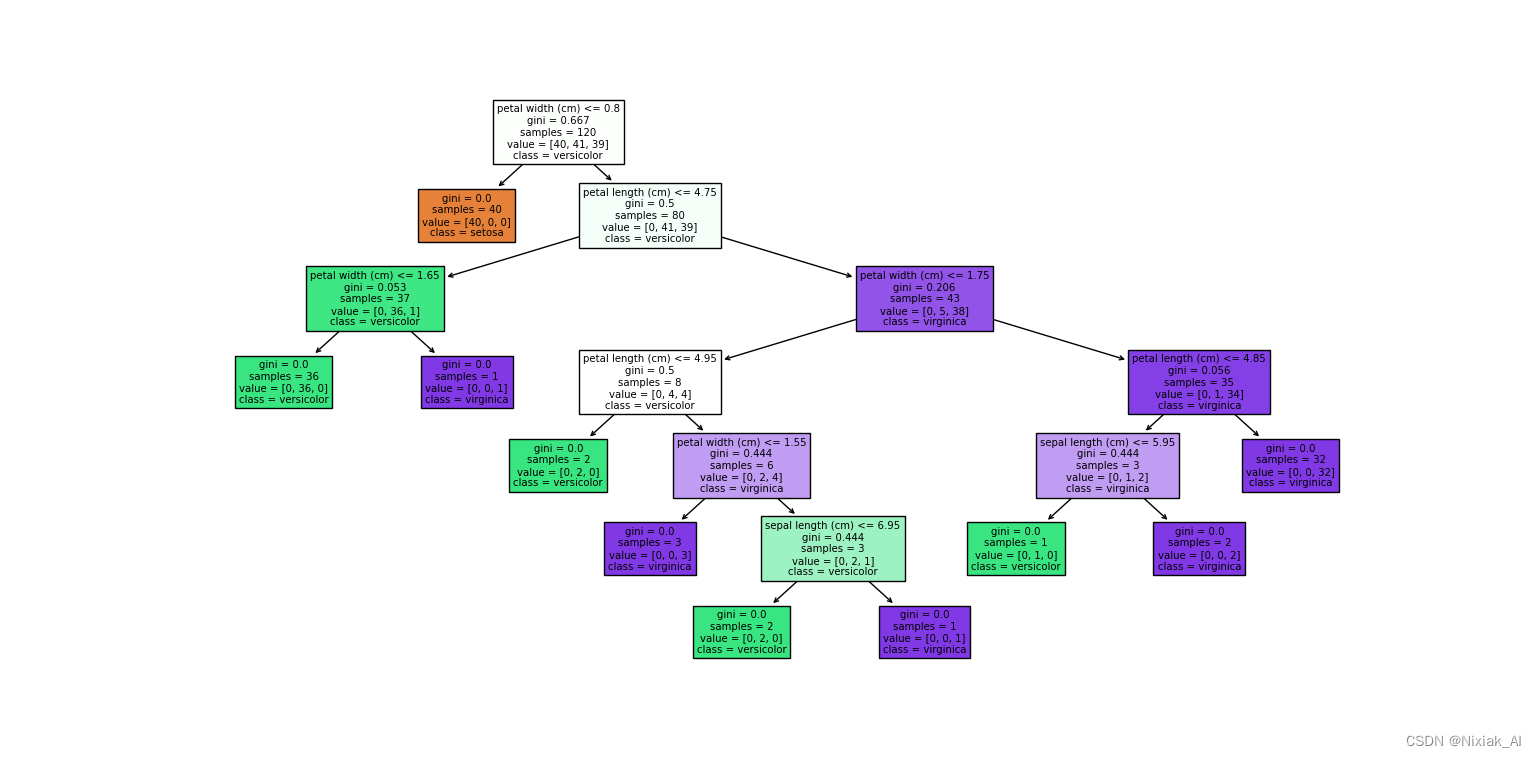
# 绘制决策树
plt.figure(figsize=(12, 8))
plot_tree(dt, filled=True, feature_names=iris.feature_names, class_names=iris.target_names)
plt.show()
四、K近邻算法
K近邻算法的基本原理如下:
对于每个待分类或预测的样本,计算其与训练集中所有样本的距离。
选择与待分类样本距离最近的 k 个训练样本。
对于分类问题,根据这 k 个样本中最常见的类别来决定待分类样本的类别;对于回归问题,根据这 k 个样本的平均值或加权平均值来估计待预测样本的数值。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score, confusion_matrix

# 加载手写数字数据集
digits = load_digits()
X = digits.data
y = digits.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 构建K近邻模型
knn = KNeighborsClassifier(n_neighbors=5)
knn.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = knn.predict(X_test)

# 计算准确率
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)

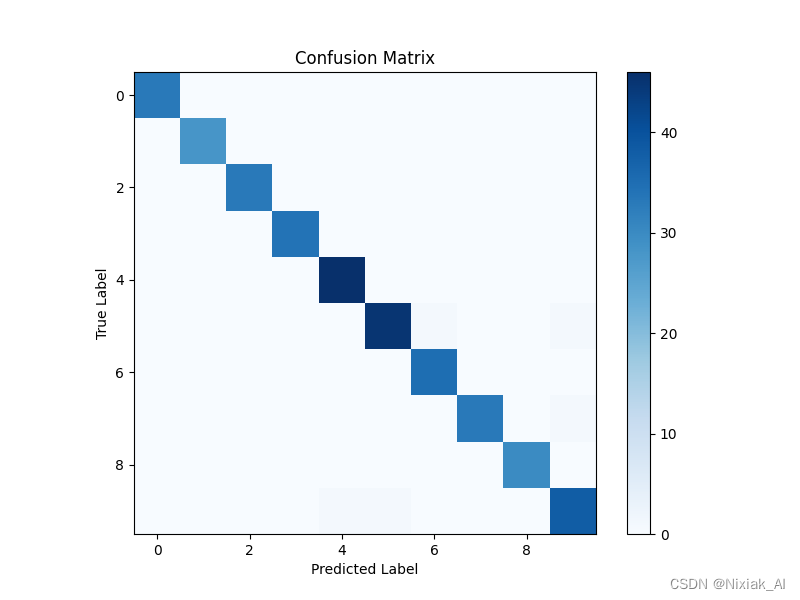
# 绘制混淆矩阵
conf_matrix = confusion_matrix(y_test, y_pred)
plt.figure(figsize=(8, 6))
plt.imshow(conf_matrix, cmap='Blues')
plt.colorbar()
plt.xlabel('Predicted Label')
plt.ylabel('True Label')
plt.title('Confusion Matrix')
plt.show()

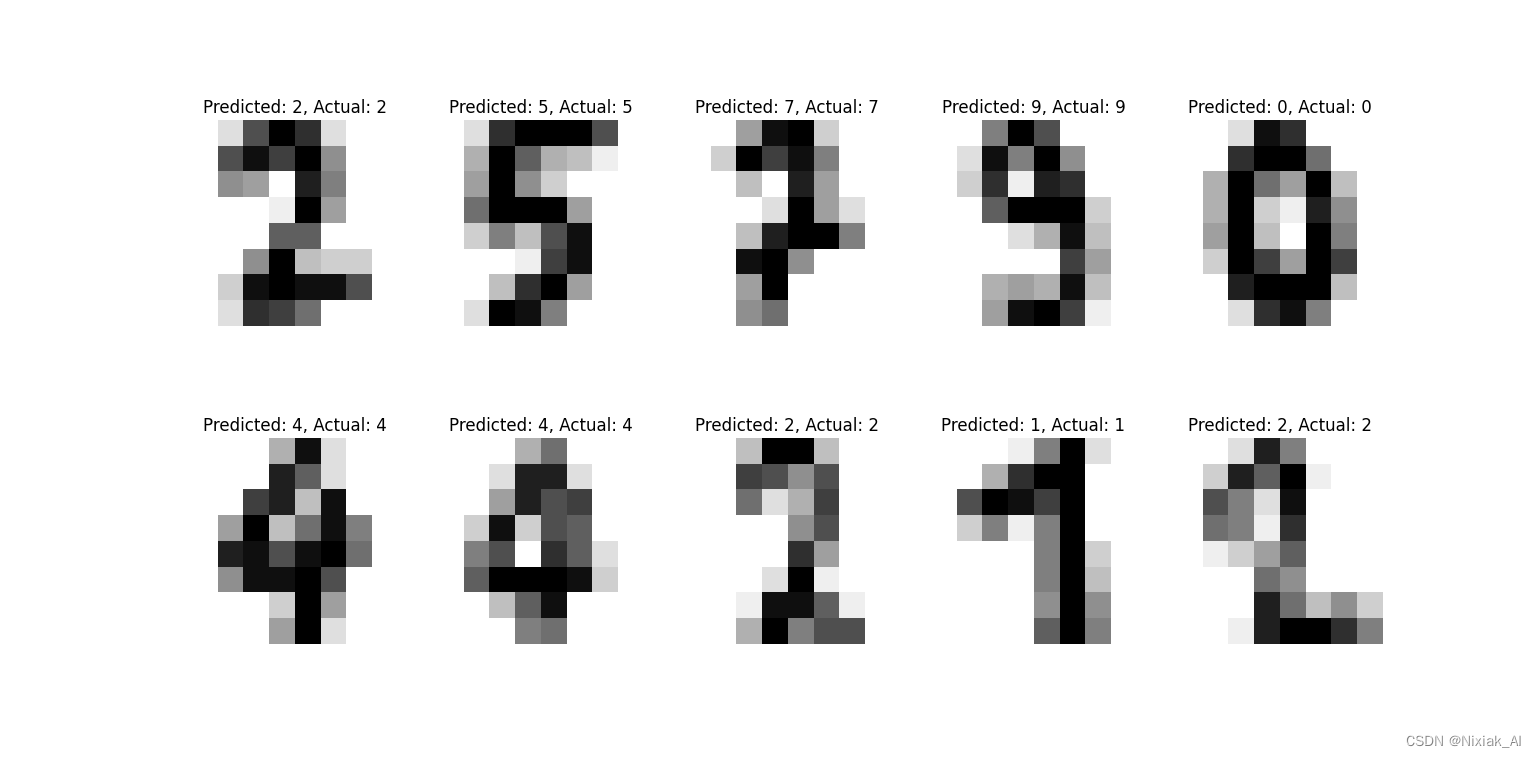
# 随机选择一些样本并展示预测结果
plt.figure(figsize=(10, 8))
for i in range(10):
    idx = np.random.randint(0, len(X_test))
    image = X_test[idx].reshape(8, 8)
    plt.subplot(2, 5, i+1)
    plt.imshow(image, cmap='binary')
    plt.title(f'Predicted: {y_pred[idx]}, Actual: {y_test[idx]}')
    plt.axis('off')
plt.show()
五、支持向量机(SVM)
支持向量机的基本原理如下:
对于二分类问题,支持向量机试图找到一个超平面,将两个不同类别的样本点分隔开来。
SVM选择的超平面是使得两个不同类别的样本点到该超平面的距离(间隔)最大化的平面。
支持向量机还引入了核函数的概念,可以将非线性问题转化为线性问题,从而在更高维的特征空间中进行分类或回归。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, confusion_matrix

# 加载手写数字数据集
digits = load_digits()
X = digits.data
y = digits.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 构建支持向量机模型
svm = SVC(kernel='rbf', gamma='scale')
svm.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = svm.predict(X_test)

# 计算准确率
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)

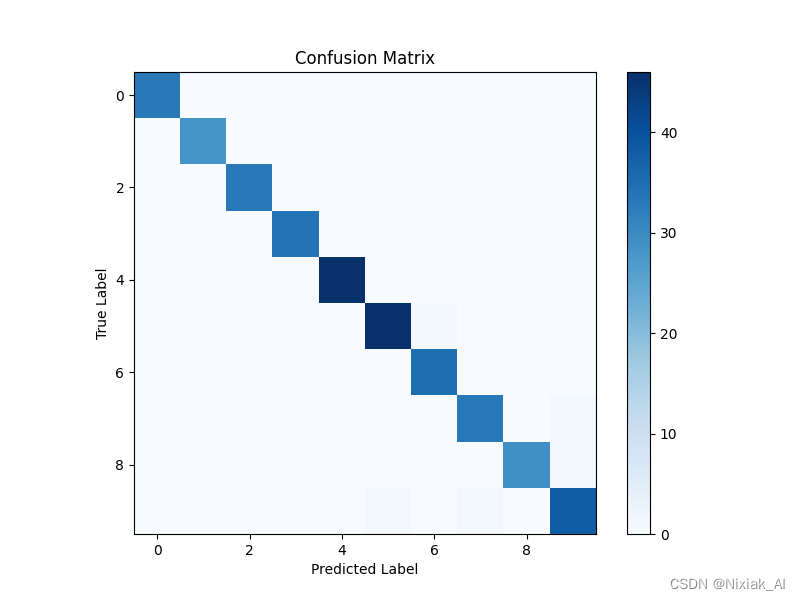
# 绘制混淆矩阵
conf_matrix = confusion_matrix(y_test, y_pred)
plt.figure(figsize=(8, 6))
plt.imshow(conf_matrix, cmap='Blues')
plt.colorbar()
plt.xlabel('Predicted Label')
plt.ylabel('True Label')
plt.title('Confusion Matrix')
plt.show()

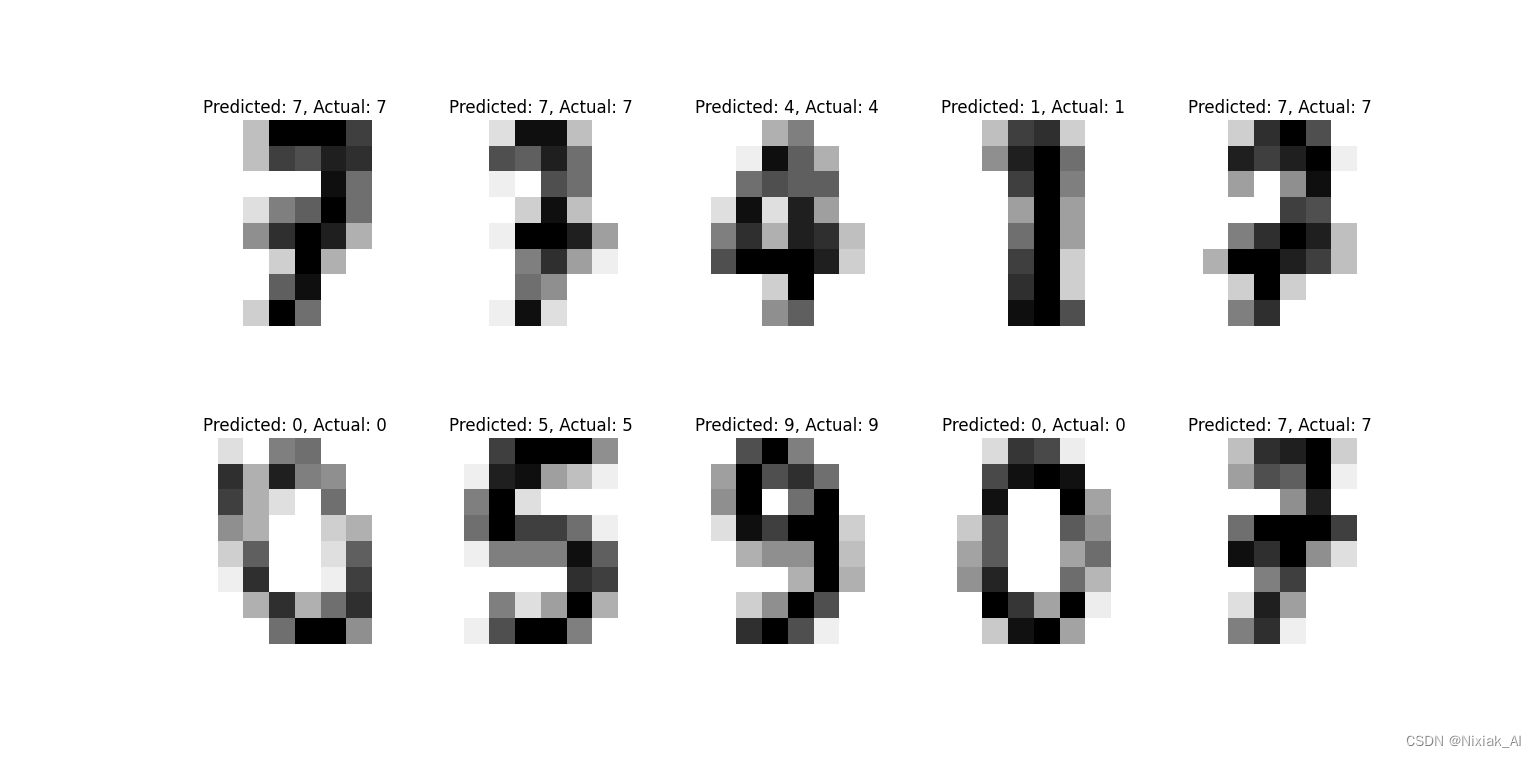
# 随机选择一些样本并展示预测结果
plt.figure(figsize=(10, 8))
for i in range(10):
    idx = np.random.randint(0, len(X_test))
    image = X_test[idx].reshape(8, 8)
    plt.subplot(2, 5, i+1)
    plt.imshow(image, cmap='binary')
    plt.title(f'Predicted: {y_pred[idx]}, Actual: {y_test[idx]}')
    plt.axis('off')
plt.show()
六、朴素贝叶斯
朴素贝叶斯的基本原理如下:
根据训练数据计算每个类别的先验概率和每个特征在各个类别下的条件概率。
对于给定的输入样本,计算其在各个类别下的后验概率。
根据后验概率选择最可能的类别作为样本的分类结果。
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.metrics import accuracy_score, confusion_matrix
import seaborn as sns

# 加载鸢尾花数据集
iris = load_iris()
X = iris.data
y = iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 构建朴素贝叶斯模型
nb = GaussianNB()
nb.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = nb.predict(X_test)

# 计算准确率
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)

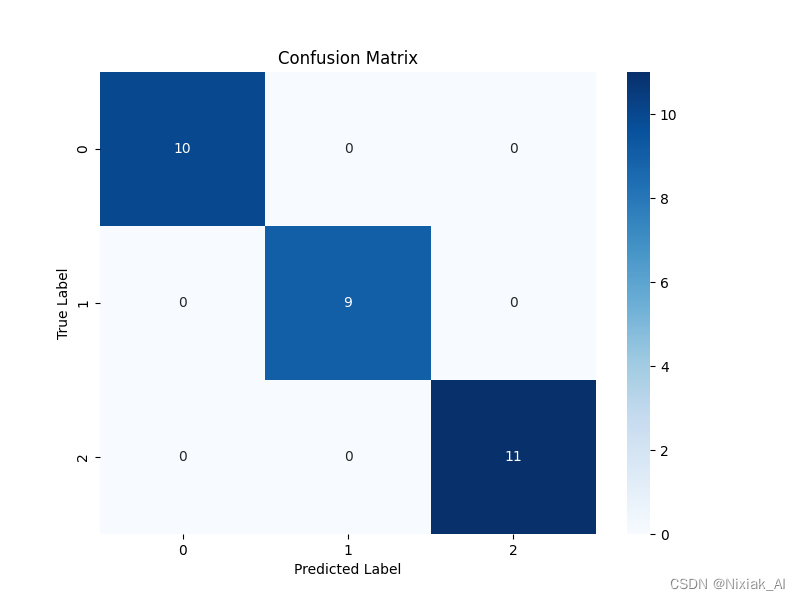
# 绘制混淆矩阵
conf_matrix = confusion_matrix(y_test, y_pred)
plt.figure(figsize=(8, 6))
sns.heatmap(conf_matrix, annot=True, cmap='Blues', fmt='d')
plt.xlabel('Predicted Label')
plt.ylabel('True Label')
plt.title('Confusion Matrix')
plt.show()

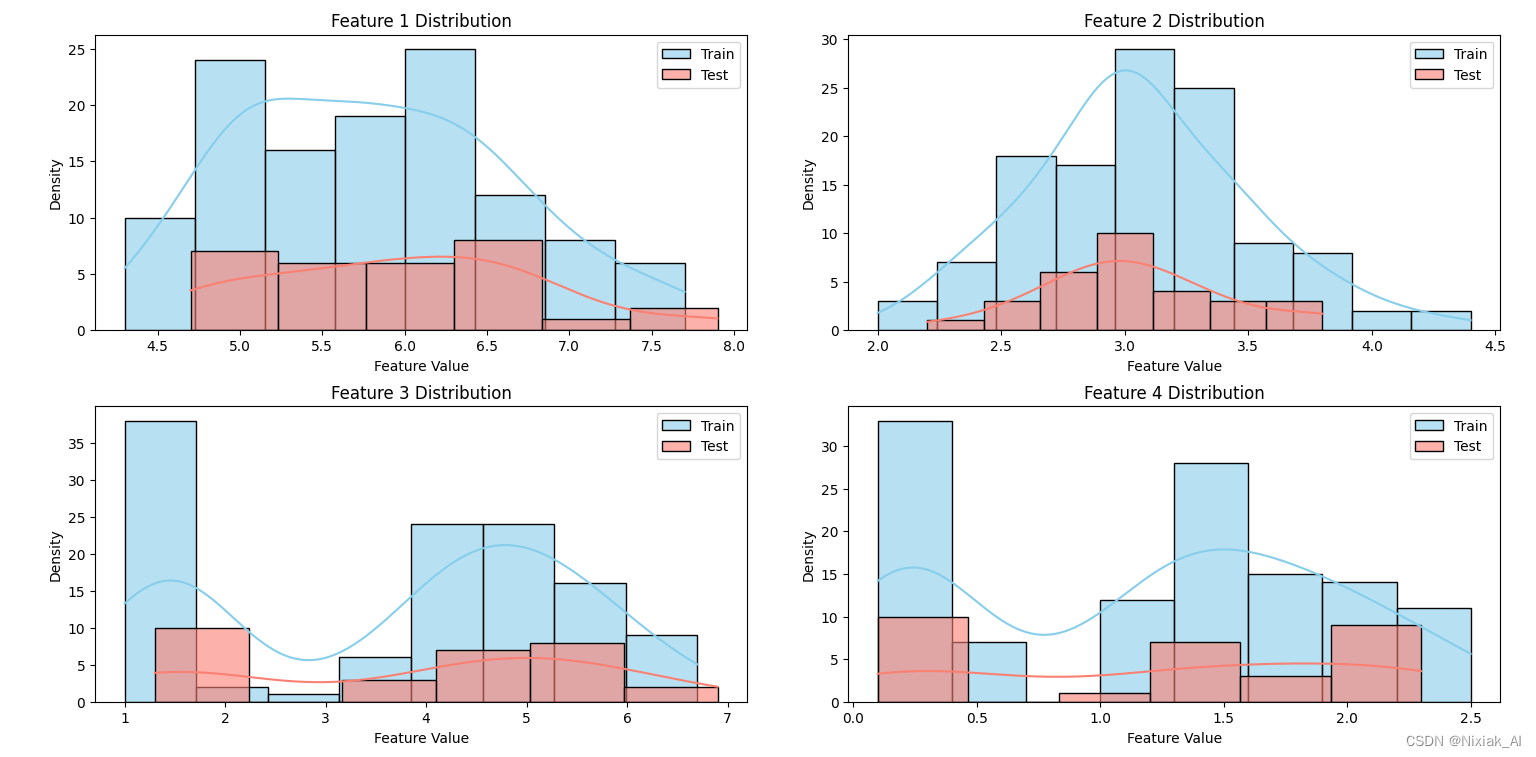
# 绘制特征的概率密度估计图
plt.figure(figsize=(10, 8))
for i in range(4):
    plt.subplot(2, 2, i+1)
    sns.histplot(X_train[:, i], kde=True, color='skyblue', label='Train', alpha=0.6)
    sns.histplot(X_test[:, i], kde=True, color='salmon', label='Test', alpha=0.6)
    plt.title(f'Feature {i+1} Distribution')
    plt.xlabel('Feature Value')
    plt.ylabel('Density')
    plt.legend()
plt.tight_layout()
plt.show()
七、K均值聚类
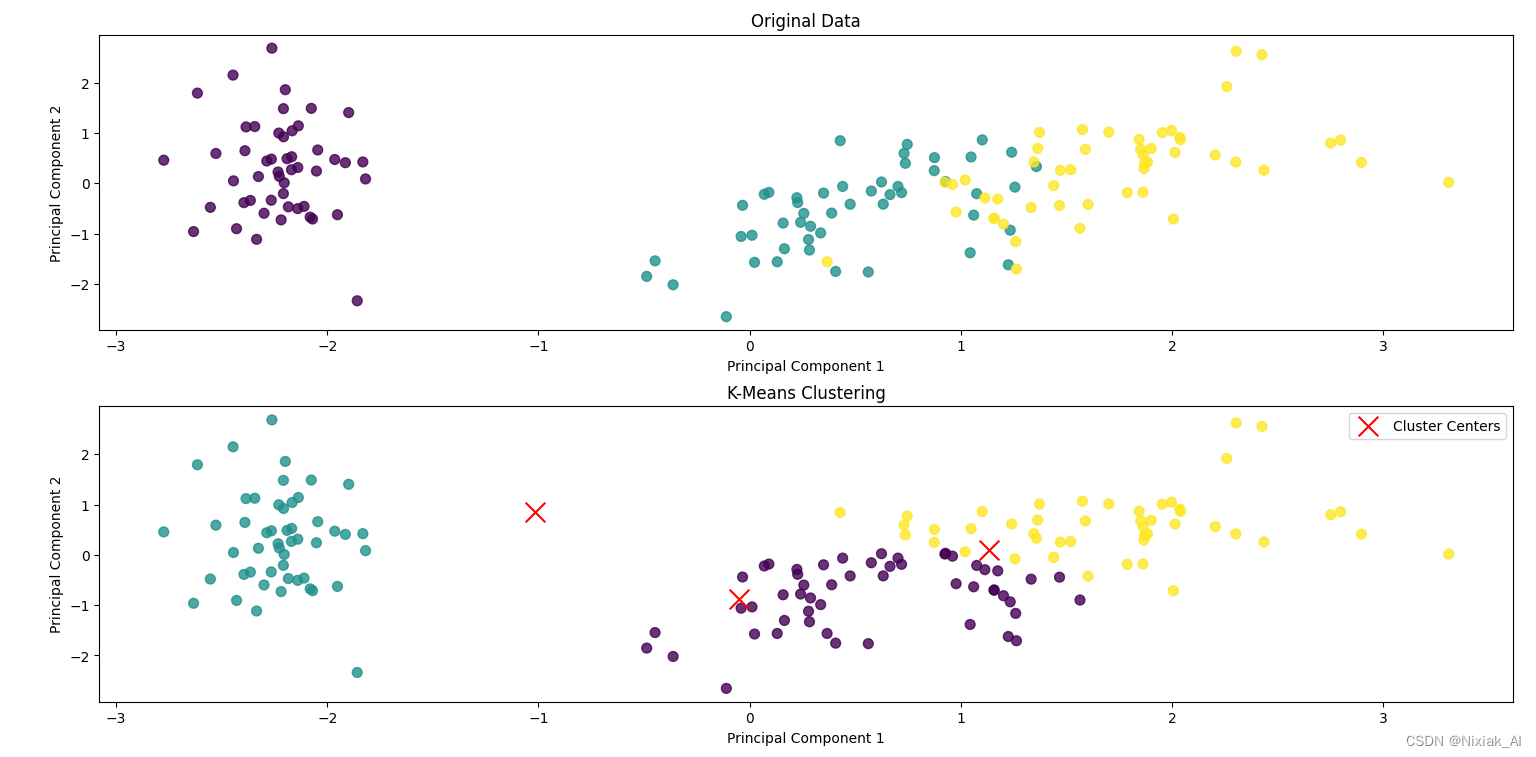
K均值聚类的基本原理如下:
首先随机选择 K 个点作为初始的聚类中心。
对于每个样本点,计算其到每个聚类中心的距离,并将其归类到距离最近的聚类中心所属的类别。
更新每个类别的聚类中心,使得每个类别内的样本点到其聚类中心的距离最小化。
重复步骤2和步骤3,直到聚类中心不再发生变化或达到最大迭代次数。
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

# 加载鸢尾花数据集
iris = load_iris()
X = iris.data
y = iris.target

# 特征标准化
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 使用PCA进行降维
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_scaled)

# 构建K均值聚类模型
kmeans = KMeans(n_clusters=3, random_state=42)
kmeans.fit(X_scaled)

# 获取聚类中心和预测类别
cluster_centers = kmeans.cluster_centers_
y_pred = kmeans.labels_

# 可视化聚类结果
plt.figure(figsize=(10, 8))

# 绘制原始数据的散点图
plt.subplot(2, 1, 1)
plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='viridis', s=50, alpha=0.8)
plt.title('Original Data')
plt.xlabel('Principal Component 1')
plt.ylabel('Principal Component 2')

# 绘制聚类结果的散点图
plt.subplot(2, 1, 2)
plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_pred, cmap='viridis', s=50, alpha=0.8)
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], c='red', marker='x', s=200, label='Cluster Centers')
plt.title('K-Means Clustering')
plt.xlabel('Principal Component 1')
plt.ylabel('Principal Component 2')
plt.legend()

plt.tight_layout()
plt.show()
 八、主成分分析
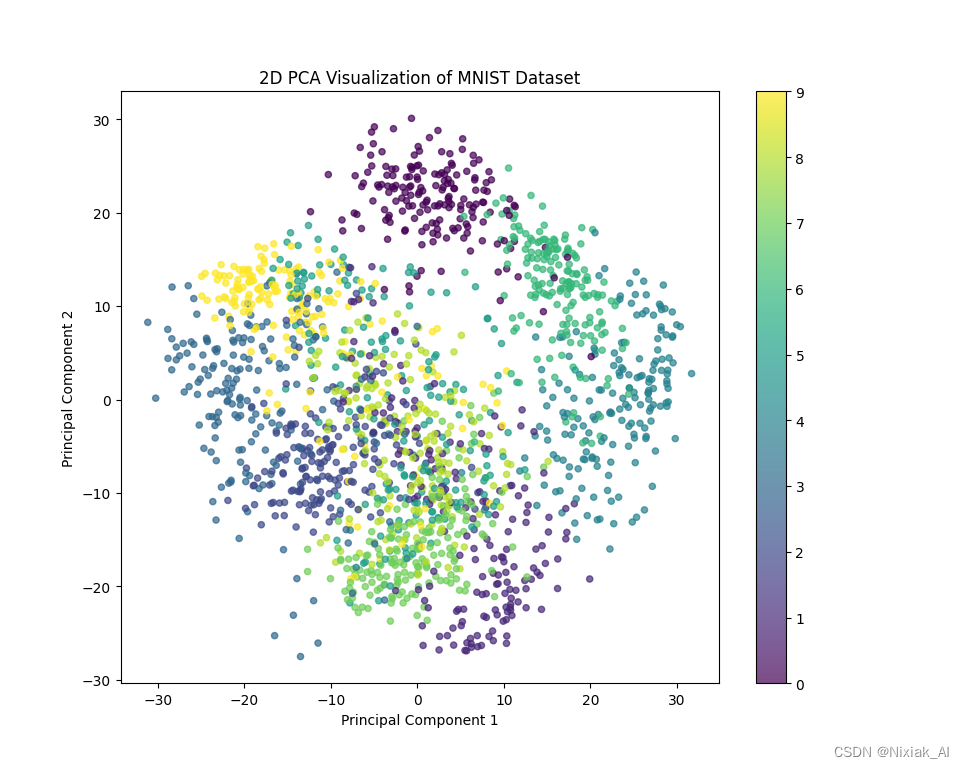
主成分分析的基本原理如下:
寻找数据集中最重要的方向(主成分),即数据集中方差最大的方向。
将数据投影到主成分所构成的低维空间中,实现数据的降维。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA

# 加载手写数字识别数据集
digits = load_digits()
X = digits.data
y = digits.target

# 构建PCA模型并拟合数据
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

# 可视化降维后的数据
plt.figure(figsize=(10, 8))
scatter = plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='viridis', s=20, alpha=0.7)
plt.colorbar(scatter)
plt.title('2D PCA Visualization of MNIST Dataset')
plt.xlabel('Principal Component 1')
plt.ylabel('Principal Component 2')
plt.show()
九、随机森林
随机森林的基本原理如下:
从训练集中随机抽取一定数量的样本(有放回抽样),构建一个决策树(称为自助采样法或bootstrap采样)。
在每个决策树的节点上,随机选择一部分特征进行划分。
对每棵树进行训练,直到达到指定的树的数量。
对于分类问题,采用投票法来确定最终的分类结果;对于回归问题,采用平均法来确定最终的回归结果。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
from matplotlib.colors import ListedColormap

# 加载鸢尾花数据集
iris = load_iris()
X = iris.data[:, [2, 3]]  # 取特征的后两个维度
y = iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# 构建随机森林模型
rf_clf = RandomForestClassifier(n_estimators=100, random_state=42)
rf_clf.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = rf_clf.predict(X_test)

# 计算模型准确率
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)

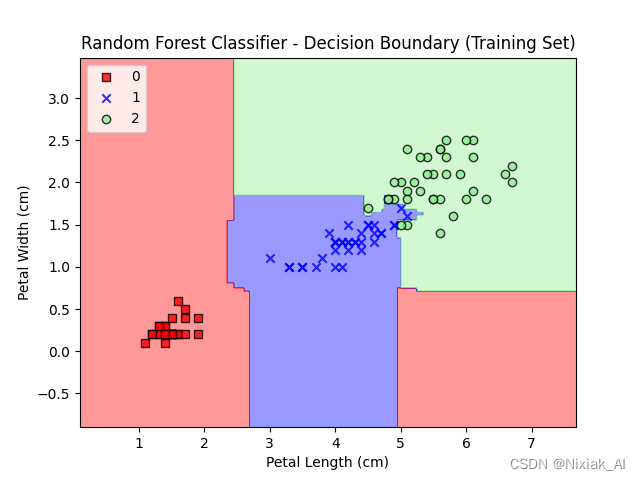
# 可视化决策边界
def plot_decision_regions(X, y, classifier, test_idx=None, resolution=0.02):
    markers = ('s', 'x', 'o', '^', 'v')
    colors = ('red', 'blue', 'lightgreen', 'gray', 'cyan')
    cmap = ListedColormap(colors[:len(np.unique(y))])

    x1_min, x1_max = X[:, 0].min() - 1, X[:, 0].max() + 1
    x2_min, x2_max = X[:, 1].min() - 1, X[:, 1].max() + 1
    xx1, xx2 = np.meshgrid(np.arange(x1_min, x1_max, resolution), np.arange(x2_min, x2_max, resolution))
    Z = classifier.predict(np.array([xx1.ravel(), xx2.ravel()]).T)
    Z = Z.reshape(xx1.shape)
    plt.contourf(xx1, xx2, Z, alpha=0.4, cmap=cmap)
    plt.xlim(xx1.min(), xx1.max())
    plt.ylim(xx2.min(), xx2.max())

    for idx, cl in enumerate(np.unique(y)):
        plt.scatter(x=X[y == cl, 0], y=X[y == cl, 1], alpha=0.8, c=[cmap(idx)], marker=markers[idx], label=cl, edgecolor='black')

    if test_idx:
        X_test, y_test = X[test_idx, :], y[test_idx]
        plt.scatter(X_test[:, 0], X_test[:, 1], c='', edgecolor='black', alpha=1.0, linewidth=1, marker='o', s=100, label='Test Set')

plot_decision_regions(X_train, y_train, classifier=rf_clf)
plt.title('Random Forest Classifier - Decision Boundary (Training Set)')
plt.xlabel('Petal Length (cm)')
plt.ylabel('Petal Width (cm)')
plt.legend(loc='upper left')
plt.show()
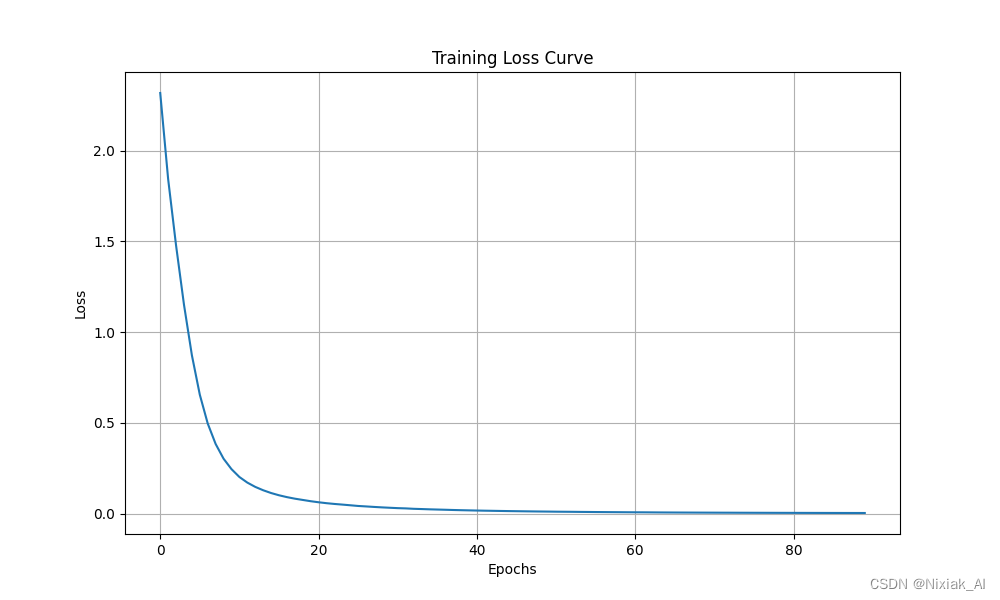
十、神经网络
神经网络的基本原理如下:
前向传播(Forward Propagation):从输入层开始,通过每一层的权重和激活函数,计算得到输出值。
反向传播(Backward Propagation):根据输出值和真实标签之间的误差,通过梯度下降算法,更新每一层的权重,使得误差最小化。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.neural_network import MLPClassifier
from sklearn.metrics import accuracy_score

# 加载手写数字识别数据集
digits = load_digits()
X = digits.data
y = digits.target

# 数据标准化
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2, random_state=42)

# 构建神经网络模型
mlp = MLPClassifier(hidden_layer_sizes=(100, 50), activation='relu', solver='adam', max_iter=500, random_state=42)

# 训练模型
history = mlp.fit(X_train, y_train)

# 预测并计算准确率
y_pred = mlp.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)

# 绘制训练过程中的损失曲线
plt.figure(figsize=(10, 6))
plt.plot(history.loss_curve_)
plt.title('Training Loss Curve')
plt.xlabel('Epochs')
plt.ylabel('Loss')
plt.grid(True)
plt.show()

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 19
 0
- 0


 已为社区贡献1条内容

所有评论(0)