从零开始讲LLM(大语言模型)原理-2.1注意力机制
1.关于注意力机制
1.1核心思想
核心思想:模拟人类的“注意力”
想象在阅读一段文字时,不会平均对待每一个词,而是会聚焦在那些最重要、最相关的关键词上,忽略不重要的部分。例如,在句子“猫坐在垫子上”中,“猫”和“垫子”通常比“在”和“上”更重要。注意力机制的核心思想就是让模型学会这种“聚焦”的能力。
1.2注意力机制
它是现代人工智能(尤其是深度学习)领域的一个重要内容,特别是在自然语言处理(NLP)、计算机视觉(CV)等领域取得了巨大成功。
注意力机制如同为神经网络(下文会讲~)装上“可调焦镜头”,使其从“均匀处理所有输入”进化到“智能聚焦关键信息”。两者结合催生了当今强大的AI模型(如ChatGPT)。
2.神经网络
神经网络的灵感来源于人脑(生物神经元)处理信息的方式:每个神经元通过树突接收其他神经元的信号。
从 计算机视觉(Computer Vision,CV)为起源发展起来的神经网络,其核心架构有三种:
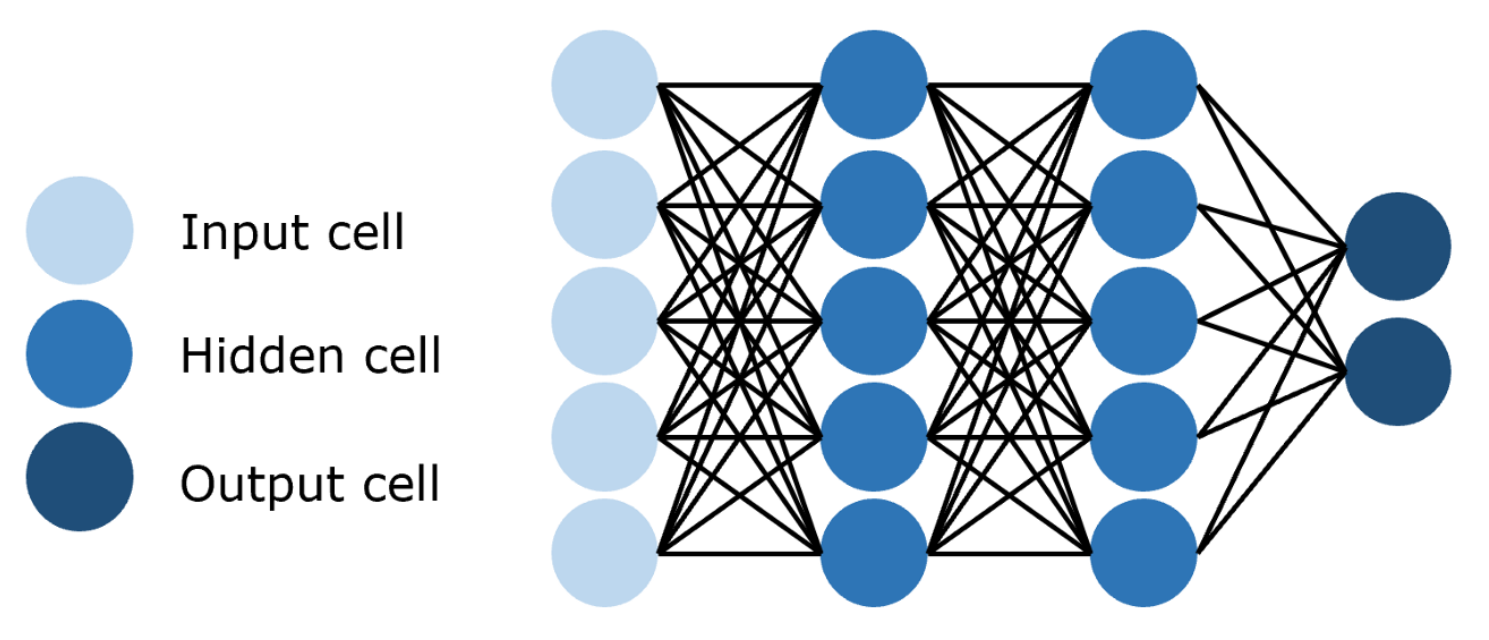
1)前馈神经网络
前馈神经网络(FNN,Feedforward Neural Network),即每一层的神经元都和上下两层的每一个神经元完全连接,如图:
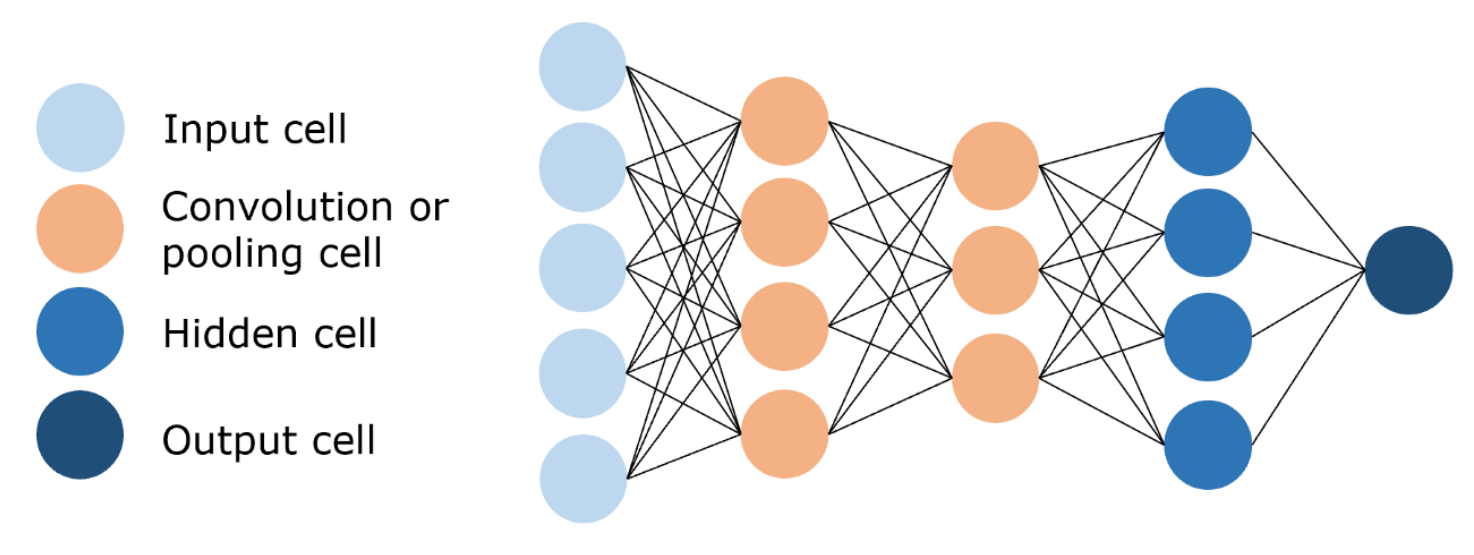
2)卷积神经网络
卷积神经网络(CNN,Convolutional Neural Network),即训练参数量远小于前馈神经网络的卷积层来进行特征提取和学习,如图:
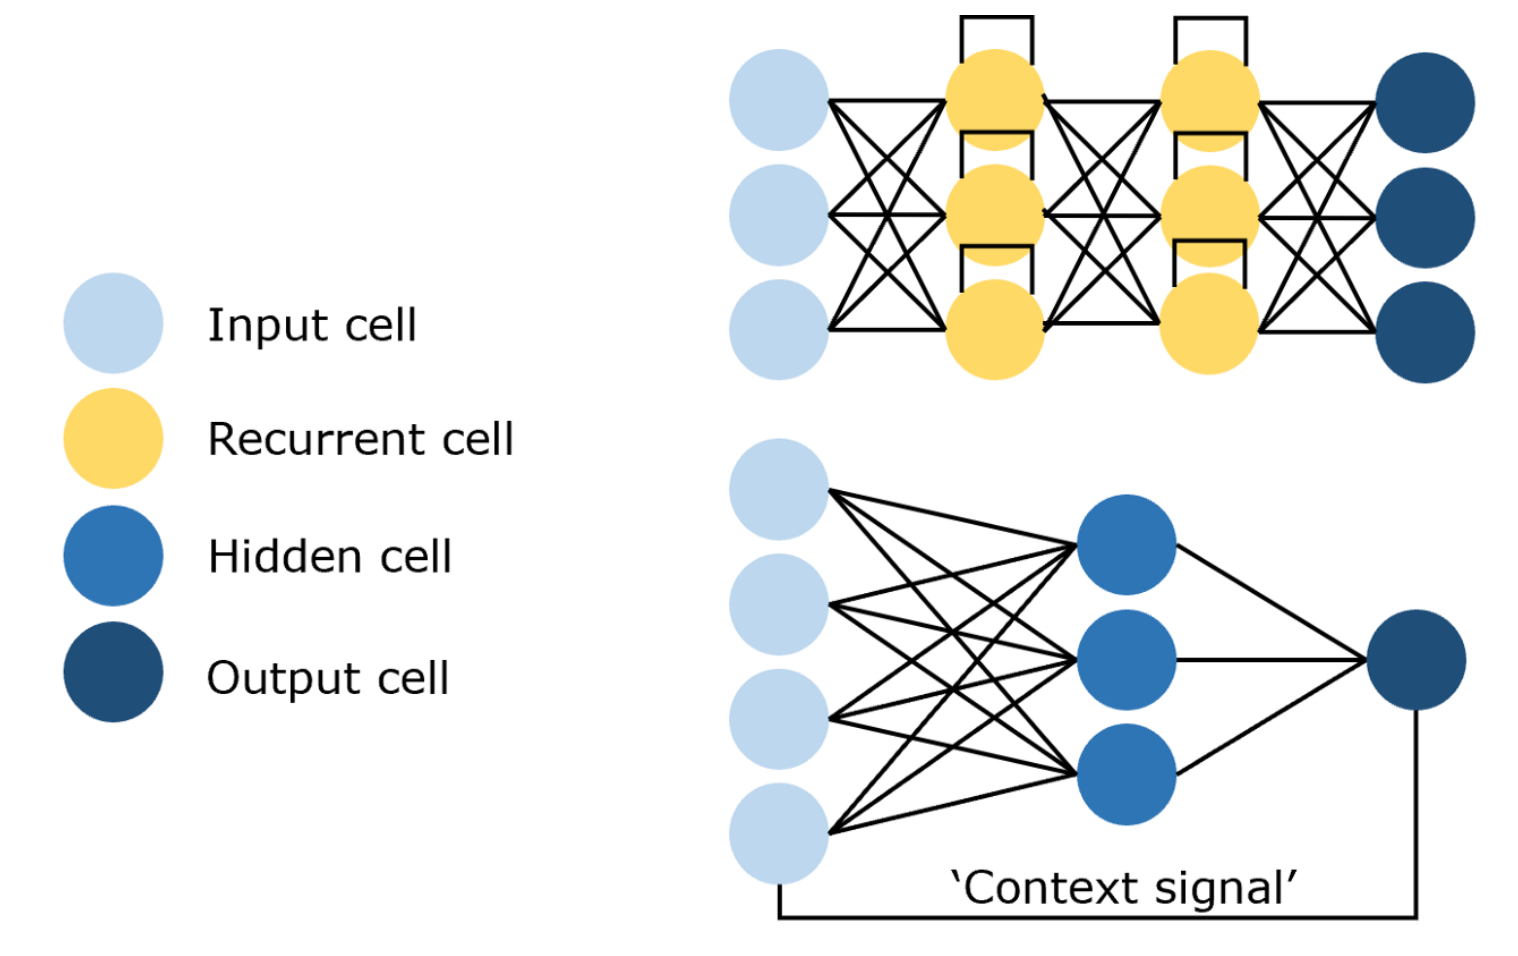
3)循环神经网络
循环神经网络(RNN,Recurrent Neural Network),能够使用历史信息作为输入、包含环和自重复的网络,如图:
4)长短期记忆网络
长短期记忆网络(LSTM)是循环神经网络(RNN)的一种特殊架构,通过引入门控机制和细胞状态解决了RNN在处理长序列时的梯度消失问题。
在注意力机制横空出世之前,RNN 以及 RNN 的衍生架构 LSTM 是 NLP 领域当之无愧的霸主。
但 RNN 及 LSTM 虽然具有捕捉时序信息、适合序列生成的优点,却有两个难以弥补的缺陷:
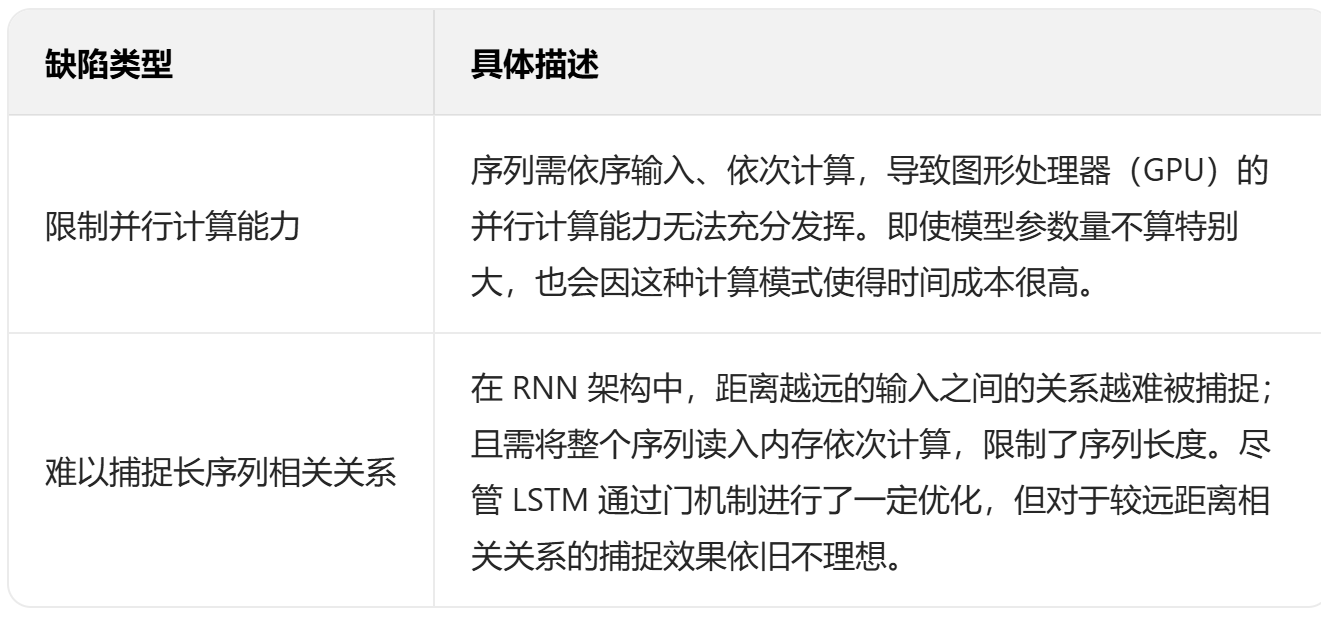
针对这样的问题,Vaswani 等学者参考了在 CV 领域被提出、被经常融入到 RNN 中使用的注意力机制(Attention)创新性地搭建了完全由注意力机制构成的神经网络——Transformer,也就是大语言模型(LLM)的鼻祖及核心架构,从而让注意力机制一跃成为深度学习最核心的架构之一。
3.深入理解注意力机制
注意力机制最先源于计算机视觉领域,其核心思想为当我们关注一张图片,我们往往无需看清楚全部内容而仅将注意力集中在重点部分即可。而在自然语言处理领域,我们往往也可以通过将重点注意力集中在一个或几个 token,从而取得更高效高质的计算效果。
注意力机制有三个核心变量:Query(查询值)、Key(键值)和 Value(真值)。
具体而言,注意力机制的特点是通过计算 Query 与Key的相关性为真值加权求和,从而拟合序列中每个词同其他词的相关关系。
用 “图书馆查资料”的场景来类比:
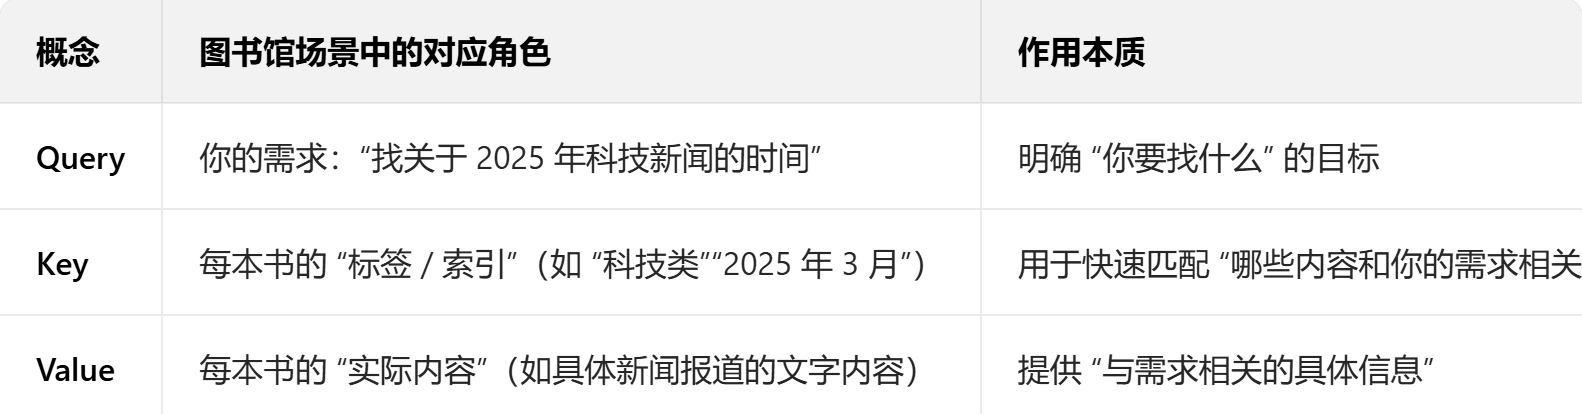
注意力机制中:
- Key 的作用是 “快速筛选”:通过计算 Query(你的需求)和 Key(内容标签)的相似度,判断哪些文本片段和需求相关;
- Value 的作用是 “提供细节”:只把筛选出的相关片段(Value)拿出来计算,忽略无关内容,最终得到精准结果。
3.1自注意力
注意力机制的本质是对两段序列的元素依次进行相似度计算,寻找出一个序列的每个元素对另一个序列的每个元素的相关度,然后基于相关度进行加权,即分配注意力。而这两段序列即是我们计算过程中 Q、K、V 的来源。
在 Transformer 的 Encoder 结构中,使用的是 注意力机制的变种 —— 自注意力(self-attention,自注意力)机制。所谓自注意力,即是计算本身序列中每个元素对其他元素的注意力分布,即在计算过程中,Q、K、V 都由同一个输入通过不同的参数矩阵计算得到。在 Encoder 中,Q、K、V 分别是输入对参数矩阵 Wq、Wk、WvWq、Wk、Wv 做积得到,从而拟合输入语句中每一个 token 对其他所有 token 的关系。
3.2掩码注意力
掩码自注意力,即 Mask Self-Attention,是自注意力机制(Self-Attention)的一种重要变体,核心作用是在计算注意力权重时通过 “掩码”(Mask)限制某些位置之间的信息交互,确保模型在训练或推理过程中遵循特定的逻辑约束。
自注意力的核心是 “自由关注所有信息”,但有些任务中这种 “自由” 会出问题:(以“我爱你”为例)
- 比如生成句子时(从 “我”→“我爱”→“我爱你”),不能让模型提前看到还没生成的 “你”,否则就是 “作弊”;
- 比如做完形填空时(“我__你”),不能让模型直接看到答案 “爱”,否则就失去了预测意义。
掩码会确保模型像人一样 “顺着说”,不会乱看乱关联~
3.3多头注意力
多头注意力是自注意力的 “增强版”,核心思路是:用多个 “注意力头” 从不同角度捕捉句子中字与字的关联,就像多个人从不同视角分析同一句话。
多头注意力就像 “多个分析师同时解读一句话”:有人关注谁做了动作,有人关注动作指向谁,有人关注整体逻辑…… 最后把所有人的分析汇总,得到更全面、更准确的理解~ 用 “我爱你” 举例的话,就是同时抓住 “我→爱” 和 “爱→你” 这两层关键关联啦!
本帖内容参考资料:《从零开始的大语言模型原理与实践教程》

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)