一亿数据写入 ES :耗时 512 秒
因公众号更改推送规则,请点“在看”并加“星标”第一时间获取精彩技术分享
点击关注#互联网架构师公众号,领取架构师全套资料 都在这里
上一篇:2T架构师学习资料干货分享
清华出的DeepSeek使用手册,104页,真的是太厉害了!(免费领取)
完整的671B DeepSeek R1本地部署,详尽教程来了
大家好,我是互联网架构师!
前言
❝本文目的: 实践亿级数据集群规划。
心路历程:百万数据压测 -> 优化参数 -> 推测亿级数据容量 -> 规划集群规模。
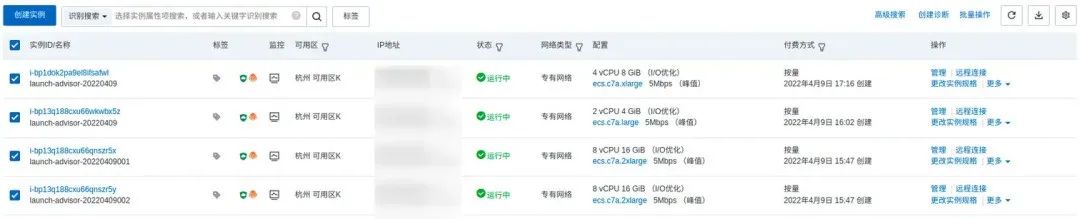
先来了解下,**ES 集群规划:** 3 个节点,ES 内存 -Xms8g -Xmx8g,剩下内存要预留给 PageCache
集群名 | 节点名称 | 端口 | 机器配置 |
|---|---|---|---|
escluster | esnode-1 | 9300 9800 | 8C16G |
escluster | esnode-2 | 9300 9800 | 8C16G |
escluster | esnode-3 | 9300 9800 | 8C16G |
kibana | 9000 | 2C4G | |
es-service | 8080 | 4C8G |
磁盘容量规划
根据前文压测 100W 数据结果可知: 主分片总共占用了 200MB 的磁盘空间。
这样,我们可以计算出每个文档占用的磁盘空间大概是:
0.2048 KB然后可以推算出 1 亿个文档占用的磁盘空间大概是:
20000 MB ≈ 19.5 GB如果每个分片 1 个副本, 那么就是
19.5 * 2 = 39GB(大概值)
有三个实例,每个实例磁盘 40GB,总共 120GB,对于 1亿 数据量的场景完全够用。
ES 写入优化
根据官网文档(https://www.elastic.co/guide/en/elasticsearch/reference/7.9/tune-for-indexing-speed.html#tune-for-indexing-speed写入优化有:
Use bulk requests:使用批量bulk上传。Use multiple workers/threads to send data to Elasticsearch:使用多线程。Unset or increase the refresh interval:设置refresh_interval值,默认 1s。❝
ES的近实时搜索: 写入后 1s 就能搜索到。即默认每秒刷新一下。为了优化写入速度,可提高该值,从而减少频繁的
refresh和lucene段合并。配置项
默认值
优化
index.refresh_interval1s
30s(官方推荐),120s
Disable replicas fo initial loads:初始时将副本数改为 0,数据写入完成后再改回来。 (提升巨大),此配置可以 动态调整 。配置项
默认值
优化
number_of_replicas1
0
Disable swapping:关闭交换区。Give memory to the filesystem cache:给PageCache足够的内存。 (写入数据和读取数据都需要)Use auto-generated ids:使用自动生成的id。Use faster hardware:云主机有限制,当前云盘是性能最低的PL0性能级别的ESSD云盘。Indexing buffer size:索引缓冲大小 ,默认 10%,即JVM10GB、索引缓冲区 1GB。配置项
默认值
优化
indices.memory.index_buffer_size10%
30%
indices.memory.min_index_buffer_size48MB
128MB
indices.memory.max_index_buffer_size无限制
无限制
其他优化点:
translog:来记录两次flush(fsync) 之间所有的操作,当机器从故障中恢复或者重启,可以根据此还原
对应官方文档
https://www.elastic.co/guide/en/elasticsearch/reference/7.9/index-modules-translog.html
translog是文件,存在于内存中,如果掉电一样会丢失。配置项
默认值
优化
index.translog.durabilityrequest
async
index.translog.sync_interval5s
120s
index.translog.flush_threshold_size512MB
2048MB
默认每隔 5s 刷一次到磁盘中
亿级数据写入
写入步骤如下:
创建索引 (优化后)
PUT /sku_index
{
    "settings":{
        "number_of_shards":3,
        "number_of_replicas":0,
        "index.refresh_interval": "120s",
        "index.translog.durability": "async",
        "index.translog.sync_interval": "120s",
        "index.translog.flush_threshold_size": "2048mb"
    },
    "mappings":{
        "properties":{
            "skuId":{
                "type":"keyword"
            },
            "skuName":{
                "type":"text",
                "analyzer":"ik_max_word",
                "search_analyzer":"ik_smart"
            },
            "category":{
                "type":"keyword"
            },
            "basePrice":{
                "type":"integer"
            },
            "vipPrice":{
                "type":"integer"
            },
            "saleCount":{
                "type":"integer"
            },
            "commentCount":{
                "type":"integer"
            },
            "skuImgUrl":{
                "type":"keyword",
                "index":false
            },
            "createTime":{
                "type":"date",
                "format":"yyyy-MM-dd HH:mm:ss"
            },
            "updateTime":{
                "type":"date",
                "format":"yyyy-MM-dd HH:mm:ss"
            }
        }
    }
}
可以使用
Kibana来创建:{ "acknowledged" : true, "shards_acknowledged" : true, "index" : "sku_index" }接口请求
操作索引:
sku_index索引每次批量插入 1000 条商品
一共执行 100000 次批量插入
60 个线程
POST http://47.99.221.206:8080/api/mockData/mockData2
{
    "indexName": "sku_index",
    "batchSize": 1000,
    "batchTimes": 100000,
    "threadCount": 60
}

响应内容:
{
    "success": true,
    "data": {
        "startTime": "2022-04-09 18:17:07",
        "endTime": "2022-04-09 18:25:39",
        "totalCount": 100000000,
        "elapsedSeconds": 512,
        "perSecond": 195312
    },
    "errorCode": null,
    "errorMessage": null
}
查看索引信息
# 查看索引下文档的个数
GET /_cat/count/sku_index?v&h=count

count
100000000

# 查看索引下文档的个数,索引占用的磁盘空间等
GET /_cat/indices/sku_index?v
health status index     uuid                   pri rep docs.count docs.deleted store.size pri.store.size
green  open   sku_index Wv9u23BLQueI7R0dYQjv5w   3   0  100000000            0     27.3gb         27.3gb
服务端日志:
2022-04-09 18:25:40.077  INFO 1650 --- [nio-8080-exec-7] c.c.e.controller.MockDataController      : 此次共导入[100000000]条商品数据,耗时[512]秒,平均每秒导入[195312]条数据

此次共导入[100000000]条商品数据,耗时[512]秒,平均每秒导入[195312]条数据
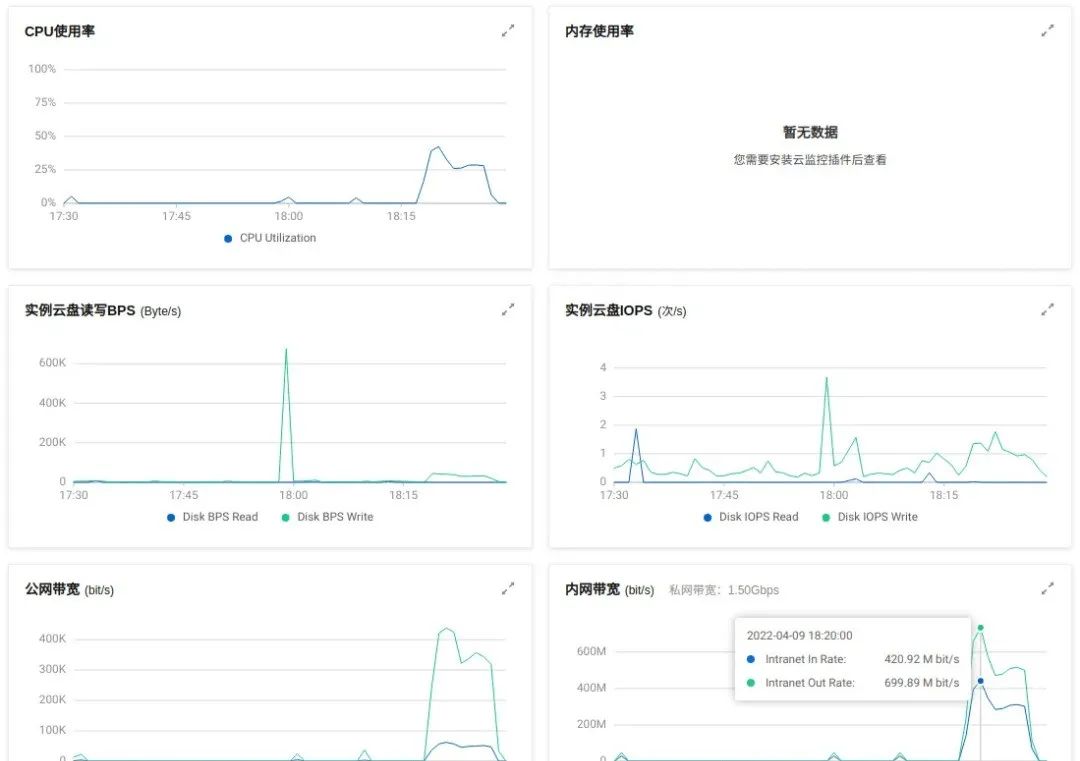
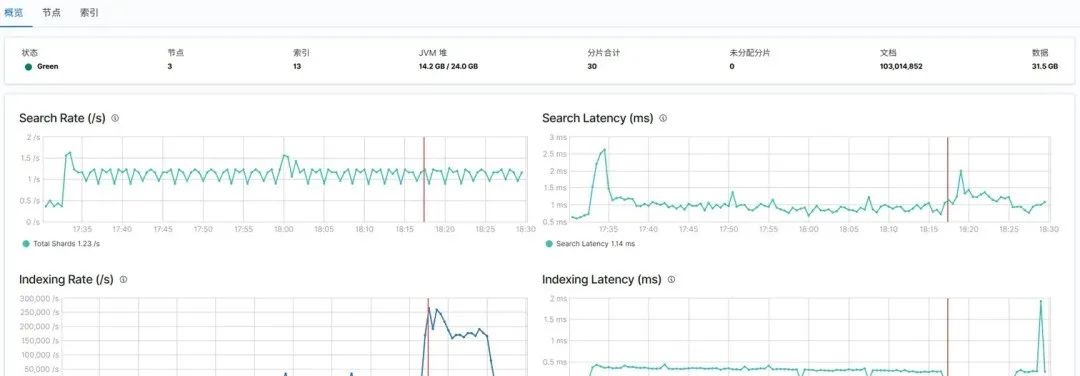
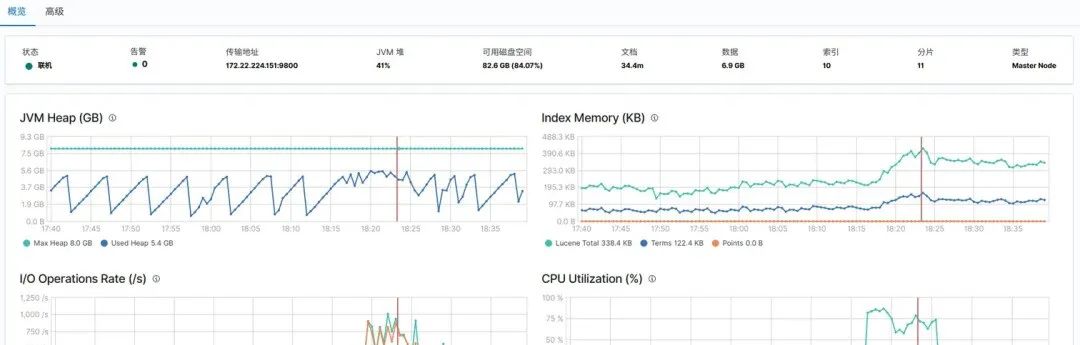
机器监控
线程数
导入数据量
耗时
QPS
CPU使用率
网络带宽使用率
云盘带宽使用率
1
100000000
512S
195312条/s
42.52%
699.89 Mbit/s
12.12 次/s
把副本数从 0 设置为 1
修改方式,参考文档:官方文档
https://www.elastic.co/guide/en/elasticsearch/reference/7.9/indices-update-settings.htmlPUT /sku_index/_settings { "settings": { "number_of_replicas": 1 } } 响应: { "acknowledged" : true }此时,索引状态变为
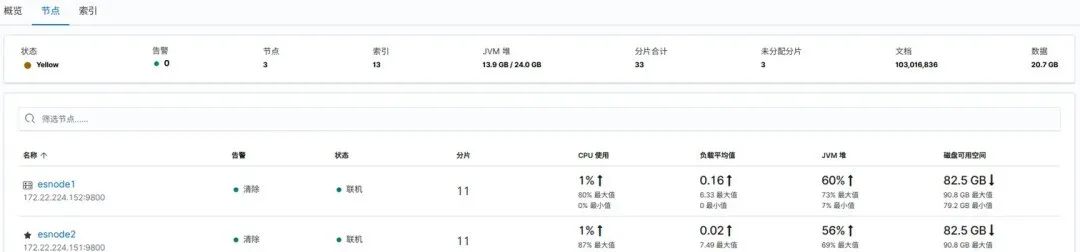
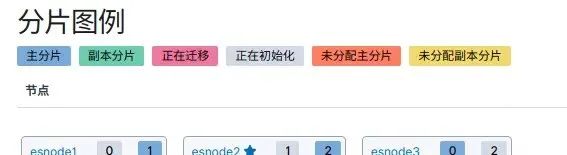
yellow状态。通过
Kibana查看:堆栈检测 -> 索引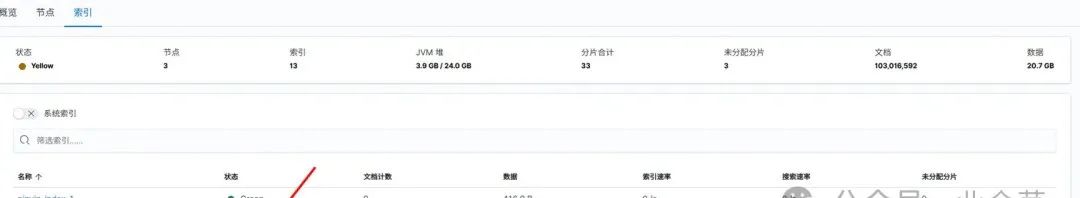
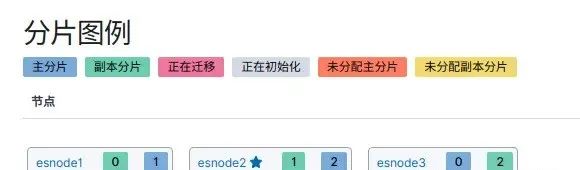
分配完后:
来源:juejin.cn/post/7158480013396819982
En如喜欢本文,请点击右上角,把文章分享到朋友圈
· END ·
最后,关注公众号互联网架构师,在后台回复:2T,可以获取我整理的 Java 系列面试题和答案,非常齐全。
如果这篇文章对您有所帮助,或者有所启发的话,帮忙扫描上方二维码关注一下,您的支持是我坚持写作最大的动力。求一键三连点赞、转发、在看
👇👇戳 “阅读原文” 直接下载资料


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 0
 0
- 0


 已为社区贡献25条内容

所有评论(0)