基于OpenCV和Pytroch框架实现视频中人脸识别
·
前言
博主研究生复试后被老师给了个题目:用一周时间 用Pytroch框架训练一个人脸识别的模型,要求在视频中识别人脸并标记.
思路及代码实现
在阅读一些博客和初步学习了Pytroh框架干什么用的之后,确定了实现思路如下:
1. 数据采集: 通过OpenCV的Haar级联检测器收集人脸
2. 模型训练: 对数据预处理, 基于Pytroch框架训练模型,保存模型
3. 使用模型识别: 加载模型对测试视频中人脸进行识别
目前已经完成这个小项目的全部工作, 参考代码如下(博主对Python和Pytroch框架也是初学,绝大部分代码是通过deepseek实现)
数据采集
核心步骤:
- 创建保存图像的文件夹
- 加载haarcascade_frontalface_default检测器
- 处理视频文件:
①灰度转换
②视频中人脸区域检
③控制间隔保存人脸图像
④人脸图像大小调整,清晰度判断
⑤保存到文件夹中
效果
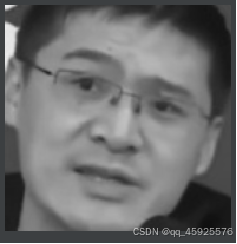
得到5个人脸分类的数据集,每个分类包含1000张128x128的灰度图.

代码
import os
import cv2
import time


def video_face_extractor():
    # 保持原始目录结构
    dataset_dir = "dataset"
    os.makedirs(dataset_dir, exist_ok=True)

    # 用户信息输入
    user_id = input("输入用户ID: ")
    user_name = input("输入用户姓名: ")
    video_path = "C:\\Users\\xxx\\Pictures\\Camera Roll\\WIN_20250331_20_00_47_Pro.mp4"

    # 创建用户目录
    user_dir = os.path.join(dataset_dir, f"user_{user_id}_{user_name}")
    os.makedirs(user_dir, exist_ok=True)

    # 初始化检测器
    face_cascade = cv2.CascadeClassifier(cv2.data.haarcascades + 'haarcascade_frontalface_default.xml')

    # 视频处理
    cap = cv2.VideoCapture(video_path)
    last_save_time = 0
    count = len(os.listdir(user_dir)) + 1 if os.path.exists(user_dir) else 0

    while cap.isOpened():
        ret, frame = cap.read()
        if not ret:
            break

        # 灰度转换
        gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)

        # 单人脸检测
        faces = face_cascade.detectMultiScale(
            gray,
            scaleFactor=1.1,
            minNeighbors=5,
            minSize=(100, 100)
        )

        # 修正点:正确解包坐标
        # 修正点:正确解包坐标
        if len(faces) > 0:
            # 提取第一个检测到的人脸的坐标
            (x, y, w, h) = faces[0]  # 关键修改:使用faces[0]获取第一个矩形

            # 保存间隔控制
            if time.time() - last_save_time > 0.5:
                face_img = gray[y:y + h, x:x + w]
                face_resized = cv2.resize(face_img, (128, 128))

                if cv2.Laplacian(face_resized, cv2.CV_64F).var() > 50:
                    cv2.imwrite(f"{user_dir}/face_{count}.jpg", face_resized)
                    print(f"已保存: {count}", end='\r')
                    count += 1
                    last_save_time = time.time()

        # 退出条件
        if cv2.waitKey(1) == 27 or count >= 1000:
            break

    cap.release()
    cv2.destroyAllWindows()
    print(f"\n完成!保存至:{user_dir}")


if __name__ == "__main__":
    video_face_extractor()
    quit()
数据训练
核心步骤:
- 图片预处理:灰度化,张量化
- 划分数据集: 80%训练,20%验证.
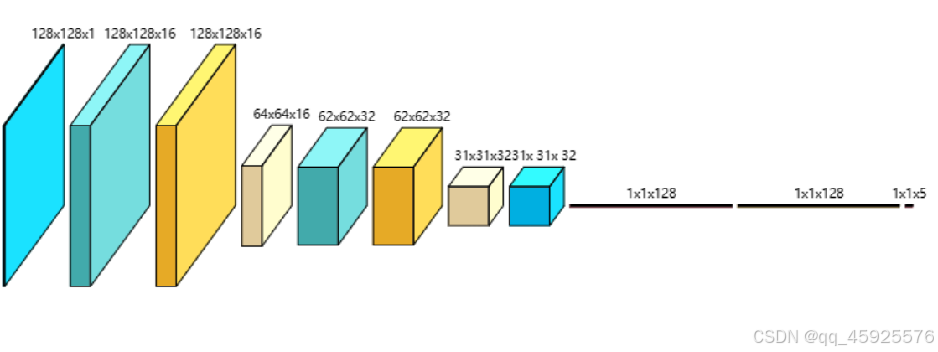
- 初始化模型:两层卷积层一层全连接层
- 损失函数:交叉熵损失,梯度函数:SGD
- 循环10次epoch训练
①将训练样本与标签加载到CPU上训练
②梯度清零
③前向传播
④计算损失
⑤反向传播
⑥更新权值
⑦保存模型
模型结构:
代码
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import transforms, datasets
from torch.utils.data import DataLoader, random_split

# 图片预处理
transform = transforms.Compose([
    transforms.Grayscale(),  # PyTorch的灰度化操作
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

dataset = datasets.ImageFolder(root='dataset', transform=transform)

# 划分数据集
train_size = int(0.8 * len(dataset))
val_size = len(dataset) - train_size
train_dataset, val_dataset = random_split(dataset, [train_size, val_size])

# 设置CPU并行计算线程(添加在代码开头)
torch.set_num_threads(8)  # 使用8个核心


# 初始化模型(使用更轻量级的结构)
class LightweightFaceCNN(nn.Module):
    def __init__(self, num_classes):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 16, kernel_size=3, padding=1),  # 16x128x128
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(16, 32, kernel_size=3), # 32×62×62
            nn.ReLU(),
            nn.MaxPool2d(2), # 32×31×31
            nn.Dropout(0.3)
        )
        self.classifier = nn.Sequential(
            nn.Linear(32 * 31 * 31, 128), # 32×31×31 = 30752
            nn.ReLU(),
            nn.Linear(128, num_classes)
        )

    def forward(self, x):
        x = self.features(x)
        x = x.view(x.size(0), -1)
        return self.classifier(x)


# ====== 修改后的模型训练函数 ======
def cpu_train_model():
    # 确认设备类型
    device = torch.device("cpu")
    print(f"Using device: {device}")
    criterion = nn.CrossEntropyLoss()
    # 数据加载优化
    train_loader = DataLoader(
        train_dataset,
        batch_size=4,  # 减小batch_size以适应内存
        shuffle=True,
        num_workers=2,  # 使用10个数据加载进程
        pin_memory=False,  # 加速CPU到内存的数据传输
        persistent_workers=False  # 保持worker进程存活
    )

    val_loader = DataLoader(
        val_dataset,
        batch_size=4,
        num_workers=1,
    )

    model = LightweightFaceCNN(num_classes=len(dataset.classes)).to(device)

    # 优化器调整(使用SGD更适合CPU)
    optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9, weight_decay=1e-4)

    # 学习率调度器
    scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=5, gamma=0.1)

    # 训练循环优化
    for epoch in range(10):
        model.train()
        running_loss = 0.0
        for images, labels in train_loader:
            # 确保数据在CPU
            images = images.to(device, non_blocking=True)
            labels = labels.to(device, non_blocking=True)

            optimizer.zero_grad()
            outputs = model(images)
            loss = criterion(outputs, labels)
            loss.backward()

            # 梯度裁剪防止数值不稳定
            torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=2.0)

            optimizer.step()
            running_loss += loss.item()

        scheduler.step()

        # 验证(每2个epoch验证一次)
        if (epoch + 1) % 2 == 0:
            model.eval()
            correct = 0
            total = 0
            with torch.no_grad():
                for images, labels in val_loader:
                    images = images.to(device)
                    labels = labels.to(device)
                    outputs = model(images)
                    _, predicted = torch.max(outputs.data, 1)
                    total += labels.size(0)
                    correct += (predicted == labels).sum().item()

            val_acc = 100 * correct / total
            print(f"Epoch [{epoch + 1}/10] Loss: {running_loss / len(train_loader):.4f} Acc: {val_acc:.2f}%")
    print('训练结束')
    torch.save(model.state_dict(), "cpu_trained_model.pth")


# 在所有函数定义之后添加以下代码
if __name__ == '__main__':
    # Windows多进程支持
    import multiprocessing

    multiprocessing.freeze_support()  # 添加这行代码

    # 执行训练函数
    cpu_train_model()
    quit()
模型使用测试
核心步骤:
- 定义模型结构:与训练模型相同
- 加载模型
- 处理视频
①使用级联检测器检测人脸
②截取人脸部分预测
③框出人脸部分并给定预测标签
代码:
import cv2
import torch
import numpy as np
from PIL import Image, ImageDraw, ImageFont
import torch.nn as nn
from torchvision import transforms
import torch.nn.functional as F


# 1. 定义模型结构(必须与训练时完全一致)
class LightweightFaceCNN(nn.Module):
    def __init__(self, num_classes):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 16, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),  # 第一次池化后尺寸减半
            nn.Conv2d(16, 32, kernel_size=3),
            nn.ReLU(),
            nn.MaxPool2d(2),  # 第二次池化后尺寸再减半
            nn.Dropout(0.3)
        )
        self.classifier = nn.Sequential(
            nn.Linear(32 * 31 * 31, 128),
            nn.ReLU(),
            nn.Linear(128, num_classes)
        )

    def forward(self, x):
        x = self.features(x)
        x = x.view(x.size(0), -1)
        return self.classifier(x)


# 2. 加载训练好的模型
def load_model(model_path):
    # 动态获取类别数量
    state_dict = torch.load(model_path, map_location='cpu')
    num_classes = state_dict['classifier.2.weight'].shape[0]

    # 初始化模型
    model = LightweightFaceCNN(num_classes=num_classes)
    model.load_state_dict(state_dict)
    model.eval()
    return model


# 3. 视频处理函数
def process_video(input_video, model, class_names):
    # 初始化人脸检测器
    face_cascade = cv2.CascadeClassifier(cv2.data.haarcascades + 'haarcascade_frontalface_default.xml')
    font = ImageFont.truetype("C:/Windows/Fonts/simhei.ttf", 20)  # Windows系统路径
    # 定义图像预处理
    transform = transforms.Compose([
        transforms.Grayscale(num_output_channels=1),
        transforms.Resize((128, 128)),  # 重要!必须与训练尺寸一致
        transforms.ToTensor(),
        transforms.Normalize((0.5,), (0.5,))
    ])

    # 打开视频文件
    cap = cv2.VideoCapture(input_video)

    while cap.isOpened():
        ret, frame = cap.read()
        if not ret:
            break

        # 转换为灰度图用于检测
        gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)

        # 人脸检测
        faces = face_cascade.detectMultiScale(
            gray,
            scaleFactor=1.1,
            minNeighbors=5,
            minSize=(40, 40)
        )
        # 转换为PIL格式进行中文绘制(核心修改)
        img_pil = Image.fromarray(cv2.cvtColor(frame, cv2.COLOR_BGR2RGB))
        draw = ImageDraw.Draw(img_pil)

        for (x, y, w, h) in faces:
            try:
                # 截取人脸区域(保留彩色信息)
                face_roi = frame[y:y + h, x:x + w]

                # 转换为PIL Image并进行预处理
                face_pil = Image.fromarray(cv2.cvtColor(face_roi, cv2.COLOR_BGR2RGB))
                input_tensor = transform(face_pil).unsqueeze(0)  # 添加batch维度

                # 预测
                with torch.no_grad():
                    output = model(input_tensor)
                    prob = F.softmax(output, dim=1)[0] * 100
                    _, pred = torch.max(output, 1)

                # 获取标签名称
                label = f"{class_names[pred.item()]} {prob[pred.item()]:.1f}%"
                # 绘制结果
                # 使用Pillow绘制(修改部分)
                draw.rectangle([x, y, x + w, y + h], outline=(0, 255, 0), width=2)
                draw.text((x, y - 25), label, font=font, fill=(0, 255, 0))  # 调整y坐标偏移量

            except Exception as e:
                print(f"处理人脸时出错: {str(e)}")
                continue

        # 显示实时结果
        frame = cv2.cvtColor(np.array(img_pil), cv2.COLOR_RGB2BGR)
        cv2.imshow('Face Recognition', frame)
        if cv2.waitKey(1) & 0xFF == ord('q'):
            break

    cap.release()
    cv2.destroyAllWindows()


if __name__ == "__main__":
    # 配置参数
    MODEL_PATH = "cpu_trained_model.pth"
    INPUT_VIDEO = "C:\\Users\\XXX\\Pictures\\Camera Roll\\test\\zxf_02.mp4"  # 替换为你的视频路径

    # 必须手动指定类别名称(按训练时的顺序)
    class_names = ['XXX', '罗翔', '张宇', '张雪峰', '雷军']  # 替换为你的实际类别名称

    # 加载模型
    model = load_model(MODEL_PATH)

    # 开始处理视频
    process_video(INPUT_VIDEO, model, class_names)
    quit()
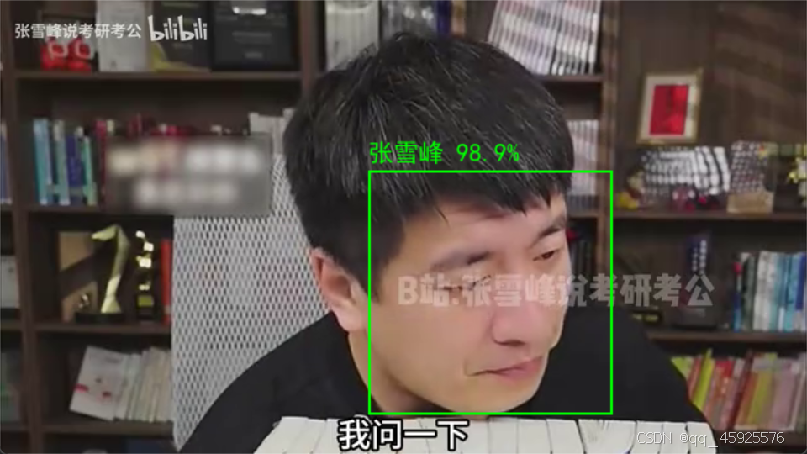
效果
问题
- 泛化性较低,受光线,角度,训练样本容量等影响, 进行数据增强可能效果更好
- 只能识别有限人数.
- 对人脸采集没有具体算法实现
- 使用的是CPU训练,批次设置较小,训练较慢.
参考博客
[1] https://blog.csdn.net/Rebacca122222/article/details/124335426?spm=1001.2014.3001.5506
[2] https://www.bilibili.com/video/BV1Y7411d7Ys/?spm_id_from=333.337.search-card.all.click&vd_source=2968a33342eff003267cf0d592c4ab2a

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 17
 0
- 0


 已为社区贡献1条内容

所有评论(0)