登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了多轮对话(Multi-turn Chat)的核心机制,揭示了AI理解上下文的关键在于历史聊天记录的传递。由于OpenAI API每次请求独立,模型无法自动记住之前内容,因此需通过SQLite保存聊天记录,并在每次请求时将历史(history)与系统提示(system)合并为messages发送给模型。这一过程使AI能理解“它”指代前文内容,实现真正意义上的上下文理解。流程闭环:读取历史
摘要: WorkBuddy会话丢失问题源于其依赖绝对路径存储项目位置。当项目文件夹被移动或重命名后,数据库中的路径记录未同步更新,导致无法关联工作目录。解决方案是通过SQLite工具修改workbuddy.db数据库:1)备份数据库;2)使用UPDATE语句替换sessions表的cwd字段中的旧路径;3)检查并更新workspaces表。进阶方案包括处理跨设备迁移、使用junction链接或专用
q1 = np.quantile(data, 0.25) 和 q3 = np.quantile(data, 0.75) 是标准写法,别混用 percentile(后者默认 method='linear' 但旧版本行为不一)数据长度 n时,<code>quantile 仍会返回数值,但 Q1/Q3 估计极不可靠——此时 IQR 法本身失效,应跳过或加警告遇到全相同值(如 [5,5,5,5]),IQR
C++依然是高性能核心系统不可替代的语言,通过合理的微内核架构设计、异步事件驱动、多线程优化和工程化实践,可以打造高吞吐、低延迟、可扩展的互联网服务。系统性能的提升不仅依赖于语言特性,更依赖于对架构、并发模型、内存管理、网络IO和工程化规范的整体把控。通过持续优化与实践,C++可以支撑大规模、高并发的核心业务场景,实现稳定、可扩展的互联网服务体系。
是 LangChain 的“链式操作符”(pipe operator),类似于 Unix 的管道(pipe)。它将 prompt 的输出“管道”到 llm 的输入,形成一个“链”。:输入字典中,用户消息的键名(匹配提示模板中的 {question})。RunnableWithMessageHistory 是 LangChain 的高级 Runnable 类,用于包装普通链(chain),添加历史管
百万级数据Excel导出方案 针对百万级数据导出Excel的痛点,本文提出"分批次并行查询+单线程写入"的解决方案。通过线程池并行查询数据(每批5万条),利用BlockingQueue安全传递数据,CountDownLatch同步线程,EasyExcel轻量级写入。核心优势包括: 查询效率提升8-10倍(8线程并发) 避免内存溢出(分批处理) 线程安全(单线程写入) 异常隔离(
作为一名有着八年 Java 后端开发经验的技术人员,我参与过多个大型 SaaS 系统的架构设计。在这篇博客中,我将分享如何设计一个支持多租户的 SaaS 系统,重点探讨租户数据隔离(数据库级别 / 表级别)和资源配额控制的实现方案。
存储膨胀:对话历史可能以文本/结构化数据(如JSON)形式保存在本地数据库或文件中,数据体积快速累积。读写延迟:每次打开AI应用时,系统需加载全部历史记录(例如渲染聊天界面、索引内容),引发I/O瓶颈。触发频繁垃圾回收(GC),导致界面冻结(尤其在Java/Kotlin环境中)。清除应用缓存(设置 → 应用管理 → 找到AI应用 → 清除缓存/数据)。内存泄漏:如果对话记录未被正确释放(如全局静态
一、界面与数据库连接,使用QSqlTableModel对数据处理。二、创建弹窗控件,可以添加内容。与确认按钮链接槽函数。
在上面的示例中,我们创建了两个Date对象,一个表示当前时间,另一个表示当前时间加上100000毫秒(即100秒)。然后,我们获取每个Date对象的时间戳,并计算它们之间的差值。最后,我们将差值转换为秒,分钟和小时,并将它们输出到控制台。总结:在Java中,我们可以使用Date类来表示日期和时间。如果我们想要计算两个日期之间的时间差,我们可以使用getTime()方法获取每个Date对象的时间戳,
三种方法用GUI编程来写一个简易的两数计算器
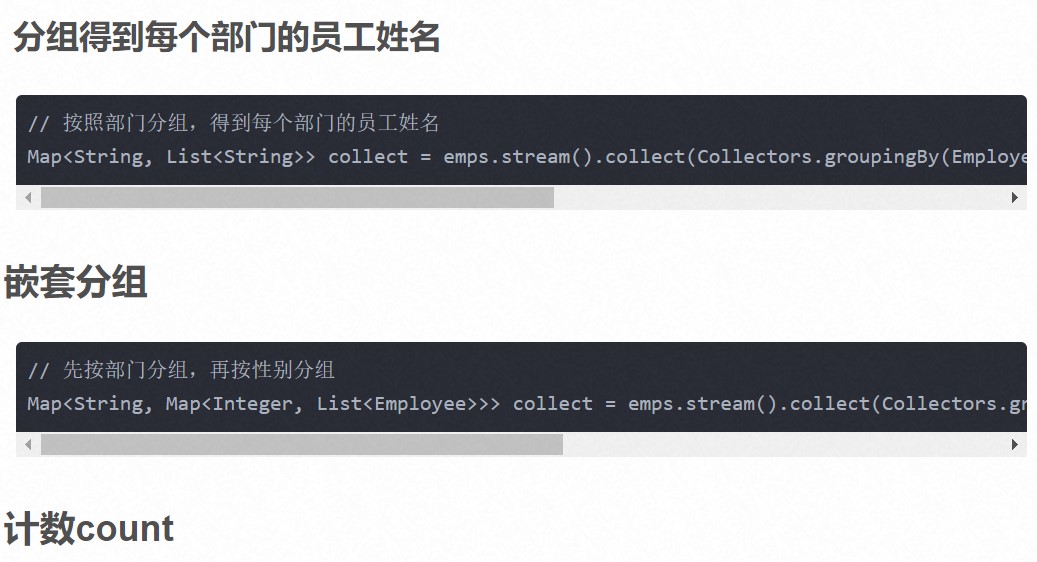
groupingBy()是Stream API中最强大的收集器Collector之一,提供与SQL的GROUP BY子句类似的功能。使用stream流通过传递lambda表达式,可以让代码看上去很简洁。此外,还可以用Java Stream和Collectors轻松完成字段的聚合。比如:相加,取平均数,或最大/最小值。更好的帮助我们分析数据。
ACL是一种访问控制机制,包含三个关键要素:用户(User)、资源(Resource)和操作(Operate),当用户请求操作资源时,检查资源的权限列表,如果资源的权限列表中存在该用户的操作权限则允许,否则拒绝。RBAC模型,三个基础组成部分:用户(User)、角色(Role)和权限(Privilege),通过定义角色的权限,授予用户某个角色从而来控制用户的权限,实现了用户和权限的逻辑分离(区别于
英特尔 至强 单核计算性能介绍我不得不承认我很震惊。 确实,当我意识到这个出现的日历帖子将涉及垃圾收集时,我感到非常震惊。 GC的主题引起了Java倡导者和那些认为内存管理应该是手动的人的热情。 撰写了许多文章,内容涉及看起来奇怪的命令行参数中的细微变化,这些变化对Java应用程序的性能影响很小。 我该如何增加这项庞大的身体工作?我希望这篇文章不会增加GC的热度,而是让您呼吸新鲜空气...
HardwareRag是一个轻量的本地RAG索引,HardwareRag是适用于外设场景的实用离线RAG层,用于把硬件datasheet(.md/.txt,带可选PDF支持)切片、解析pin别名,并基于关键字把相关片段与别名注入到agent/LLM的上下文中,能显著提高L LM在硬件控制与解释上的可靠性。这种设计完美体现了ZeroClaw"零开销、零妥协“的核心理念,既保持了AI助手的强大能力,又
规则引擎的优势是确定可控,比大模型的"模糊理解"更适合业务指令场景——用户说什么就执行什么,不会跑偏。Eyun API 负责把用户的话传过来,规则引擎负责"听懂"——两者组合起来就是一个能干活的微信机器人。:Eyun 管消息接入和发回,规则引擎管"听懂"意图,业务执行器管真正干活。把微信消息翻译成规则引擎能读懂的格式。纯大模型不稳,今天用户说"查订单"可能返回对的结果,明天换个说法可能就跑偏了。—
具身智能产业链上游的技术标准化,本质上是在为数据基础设施的规模化建设铺路。关节模组标准化降低了多构型适配成本,使采集方案的硬件复用成为可能;触觉传感器填补了接触模态的数据空白,拓展了训练数据的维度;灵巧操作全栈方案实现了"操作即采集"的数据闭环范式;消费级场景的爆发则为数据多样性提供了指数级增长的来源。从技术演进的角度看,具身智能的竞争焦点正在从"谁的硬件性能更好"转向"谁的数据获取效率更高、成本
在 C/C++ 编程中,程序的内存主要分为以下几个区域:栈区(stack):存放局部变量、函数参数等,由编译器自动分配和释放。静态区(static):存放全局变量、静态变量,程序结束时释放。堆区(heap):由程序员手动分配和释放,也就是动态内存分配的核心区域。静态分配和自动分配的局限性:大小固定,缺乏灵活性数组长度必须在编译时确定(C99 之前),或者即便支持变长数组(VLA),其大小也受限于栈
SQLite是一款轻量级嵌入式数据库,广泛应用于Linux服务器、嵌入式设备、小型应用中,其核心优势是无需独立服务器,直接以文件形式存储数据。但正因为其文件式存储特性,在特定情况下容易出现数据库损坏,最常见的报错就是“Error: database disk image is malformed”(数据库磁盘映像格式错误)。结合实际案例,SQLite数据库损坏多由以下原因导致:磁盘空间满(如根分区
SHOW SLAVE STATUS 显示 Seconds_Behind_Master 为 NULL 或 IO/SQL 线程为 No这说明复制链路已断,不是延迟高,而是彻底停了。常见现象是 Slave_IO_Running 和/或 Slave_SQL_Running 显示 No,Seconds_Behind_Master 为 NULL,同时 Last_IO_Error 或 Last_SQL_Erro
"密码长度影响加密强度:SQLCipher 要求至少 1 字节,但推荐 16 字节以上;SEE 对密码长度更敏感,过短可能静默降级为弱加密创建成功后,该文件即被 AES-256 加密,用普通 SQLite 工具(如DB Browser)打开会直接报错,必须输入相同密码打开已加密数据库:Password 必须完全一致,且不能漏掉任何空格密码比对是字节级的,"abc123" 和 "abc123 " 是
前端:Vue、Vue.js、ElementUI、HTML5、BootStrap、CSS3、JavaScript、jQuery、LayUI后端:SpringBoot、Mybatis,Maven构建项目jar包,内置Tomcat运行Web环境,后端语言Java数据库:MySQL、SQLServer开发工具:IDEA、Eclipse、Navicat等✌关于毕设项目技术实现问题讲解也可以给我留言咨询!!!
python# 创建基类# 定义一对多关系# 定义多对一关系# 定义多对多关系(通过关联表)# 关联表(用于多对多关系)SQLAlchemy ORM提供了强大而灵活的数据库操作方式,通过本文的介绍,您应该能够:安装和配置SQLAlchemy定义数据模型和关系执行基本的CRUD操作构建复杂查询管理数据库事务遵循最佳实践SQLAlchemy还有更多高级特性,如混合属性、事件监听、自定义查询等,值得进一
修改后须sysctl -p生效、验证ipcs -lm、重启listener与数据库。查当前值:cat /proc/sys/kernel/shmmaxOracle 推荐下限:取 sga_max_size(单位字节)向上取整到 4KB 边界,但实际建议留 10% 余量别盲目设成物理内存一半——64GB 内存设 32GB shmmax 可能导致其他进程共享内存失败常见错误:把 shmmax 设成 4G(
PD快充诱骗芯片是一种用于受电设备端的协议转换芯片,核心作用是与 PD 充电器完成协议握手,主动请求并 “诱骗” 其输出预设的高压档位(如 9V/12V/15V/20V,PD3.1 可达 48V),从而获取超出默认5V的供电能力。用电器电路中使用这种Type-C sink IC后,可以自适应市面上PD充电器,使其输出快充电压给产品供电。
解决办法在project层级的build.gradle中的allprojects模块加入配置。目前发现使用的开发工具是MAC M3芯片的配置会出现这个问题。M1就应该有这个问题。其中3.46.1.3版本可自行查看版本。
简洁性与现代语法Kotlin 大幅减少了样板代码,让开发者更专注于业务逻辑。数据类:自动生成equals()hashCode()toString()copy()等方法。智能转换:在is检查后,无需显式类型转换。字符串模板:直接在字符串中嵌入变量和表达式。代码简洁性的体现:从以下样板代码可以看出来,和传统项目相比,Kotlin语言语法明显更加简洁。// 1. 数据类 (Java 需要大量样板代码)
缓存是一种用于临时存储数据以加快访问速度的技术。降低成本:减少对LLM提供者的API调用。提高速度:减少API调用的等待时间。LangChain为LLM提供了可选的缓存机制,使开发者可以方便地为应用添加缓存功能。
数学建模比赛中四类常见问题的算法总结
文章首发于个人博客,欢迎访问关注:https://www.lin2j.tech问题M1 芯片运行 apm-agent-attach 依赖包发生虚拟机错误 java.lang.UnsatisfiedLinkError 。本地 idea 配置的 jdk 时 zulu 1.8 的版本。Caused by: java.lang.UnsatisfiedLinkError: /Users/jay/Librar