把 Agent 黑话翻译成人话:Model、Tool、Skill、Harness 到底指什么
为什么你需要一台「名词翻译器」
打开任何一篇 Agent 文章,你会看到这些词轮番出现:Model、Tool、Skill、Harness、Runtime、Agent Loop。
问题是,很多作者默认你已经懂了,直接开始画架构图。结果就是:图看完了,词还是没懂。
这篇文章做一件事:把这九个高频词逐个翻译成人话,并且告诉你它们之间谁包着谁。看完你再读任何 Agent 资料,都不会被名词卡住。
先给一张总览表,后面逐个展开。
| 术语 | 一句话人话 | 类比 |
|---|---|---|
| Model | 会说话会推理的大脑 | 引擎 |
| Tool | 大脑能调用的外部能力 | 车轮 |
| Skill | 一套打包好的操作手册 | 驾驶技巧 |
| Harness | 把上面全部装起来的驾驶舱 | 整车 |
| Agent Loop | 干活的基本节拍 | 挂挡起步 |
Model:大脑,但只有大脑
Model 就是大语言模型本身,比如 GPT、Claude、DeepSeek。
它能力很强:理解指令、推理、写代码、生成文本。但它有一个致命限制:它只能说话,不能做事。
你让它「帮我订一张明天去上海的票」,它会很有礼貌地告诉你订不了——它没有手。没有网络访问、没有文件系统、没有账号体系。
所以 Model 是 Agent 的核心,但只有 Model 的产品叫聊天机器人,不叫 Agent。
Tool:给大脑装上手
Tool 是最容易被低估的概念,因为它听起来太朴素了。
一个 Tool 就是一个外部能力:一个搜索接口、一个数据库查询、一段可执行代码、一个发邮件的函数。模型在推理过程中,可以决定「这一步我需要调用某个工具」,把参数发过去,拿到结果,继续推理。
这里有一个关键认知:模型不是被编程去用工具,而是自己决定用不用、怎么用。
这就是 Agent 和传统自动化的分水岭。传统自动化里,人写死了每一步调什么接口;Agent 系统里,模型根据上下文动态决定。代价是不确定性,收益是灵活性——遇到没预设过的情况,它自己想办法。
Skill:把「会用」升级成「用得好」
Tool 解决了「能不能」,Skill 解决「好不好」。
同一个搜索工具,一个裸的模型调用,可能搜一次就下结论;而一个封装好的 Skill,会规定:先搜什么关键词、结果不够换什么关键词、来源要交叉验证、最后输出什么格式。
你可以把 Skill 理解成给模型的一段操作手册:工具还是那些工具,但打法被沉淀下来了。经验丰富的 Agent 和裸 Agent 的差距,大部分就在 Skill 的积累上。
这也是为什么很多团队把内部流程写成 Skill 库——人走了,经验留在系统里。
Harness:真正决定上限的部分
Harness 是这两年才被明确叫出来的词,指的是包裹模型的那一层软件骨架。
它负责所有模型不管的事:
- 收集上下文:把用户输入、历史对话、工具结果、文件内容组织成模型能读的输入;
- 执行工具调用:模型说「我要查数据库」,是 Harness 去真的查;
- 管理循环:模型一次推理不够就再来一轮,直到任务完成或触发终止条件;
- 控制权限:哪些工具能调、哪些文件能读、最多花多少 token,全在这里把关。
一句话总结:Model 决定聪明程度,Harness 决定能不能把聪明兑现成结果。
同一个模型,配不同的 Harness,产出质量可能差出一个档次。各家 Agent 产品的差异,表面看是模型差异,底层往往是 Harness 功力差异。
Agent Loop:一切的基本节拍
最后把运转方式讲清楚。Agent 干活遵循一个固定循环:
接收任务 → 推理 → 决定动作 → 执行 → 观察结果 → 再推理 → …… → 判断完成,输出。
注意两个容易翻车的点:
一是观察结果必须真实。如果工具调用失败但系统假装成功,模型会基于假反馈继续推理,越走越偏。反馈造假是 Agent 系统最隐蔽的 bug。
二是终止条件必须明确。没有明确完成标准,模型可能一直「再做一轮」,表现为很忙但没有结论。好的 Agent 系统,终止条件和任务目标是一起定义的。
怎么验证你真的懂了
拿一个问题自测:为什么同一个模型,ChatGPT 网页版答不了的联网问题,装了浏览器的 Claude 能答?
答案是:模型没变,Harness 变了。后者给模型接上了浏览工具,并在循环里允许它先查再答。
你能用 Model、Tool、Harness 这三个词把这个问题讲清楚,这套术语就算过关了。
收个尾
这五个词的关系,一句话版本:
Model 是大脑,Tool 是手,Skill 是肌肉记忆,Harness 是全身骨架加神经系统,Agent Loop 是心跳。
少任何一个,都不是一个能持续干活的 Agent。下次再看到新名词,先问自己它属于哪一层——大部分新词都是这五层里某一层的具体实现,换个名字而已。
这波 AI 大模型的机会,你接得住吗?
又到了一年中最受期待的 “金九银十”招聘季。每年这两个月,各家大厂都会集中释放大量岗位:既有补录名额,也有核心业务扩招,对应届生来说是冲刺上岸的最后窗口,对在职的朋友而言,同样是全年最值得把握的跳槽时机。
我最近梳理了一遍大厂的招聘需求,发现今年的市场格局和往年明显不同
机会确实在,但门槛也在抬高。
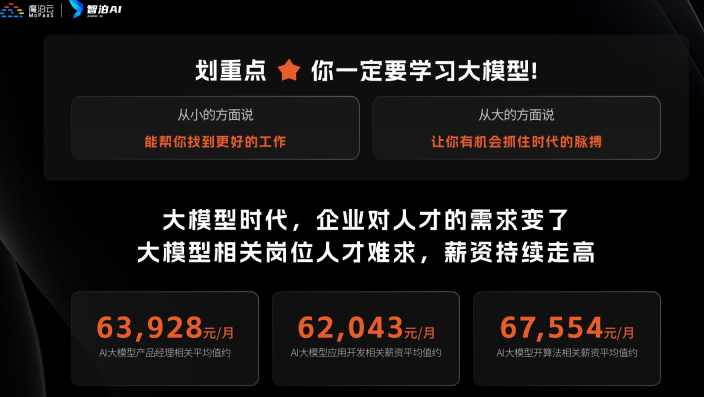
先看机会端。在大模型、生成式 AI 这条赛道上,各家公司的诚意给得很足:岗位数量大幅增加,薪资水涨船高。目前中大厂的大模型相关岗位,年薪普遍能到 50W+,顶尖人才拿到百万年薪并不稀奇,不少岗位的薪酬比去年上调了 40% 左右。更难得的是,这条赛道对年龄也宽容得多——对深陷“35 岁焦虑”的程序员来说,这几乎是目前为数不多的高薪避风港。
但高薪的另一面是残酷的现实:缺人的领域,同样缺不了找不到工作的人。
原因不复杂——想进大模型领域的人非常多,可真正具备胜任能力的极少。大多数求职者的技能储备,和一线企业核心 AI 岗位的要求之间,隔着一道不小的鸿沟。
怎么补上这道鸿沟?
为了帮大家真正达到国内一线大模型岗位的用人标准,我整理了一套 【2026 最新版】AI 大模型免费学习资源,从零基础入门到项目实战、从理论体系到大厂面试,一路进阶全覆盖。所有资料已分类归档,没有杂乱内容,无套路免费分享给每一位想入局 AI 赛道的程序员和零基础小白。
1、大模型系统化学习路线
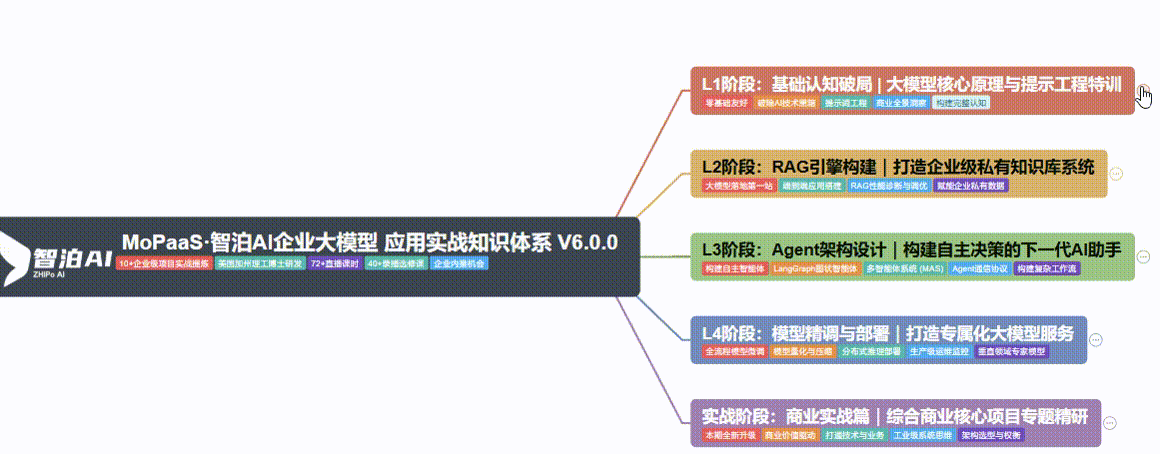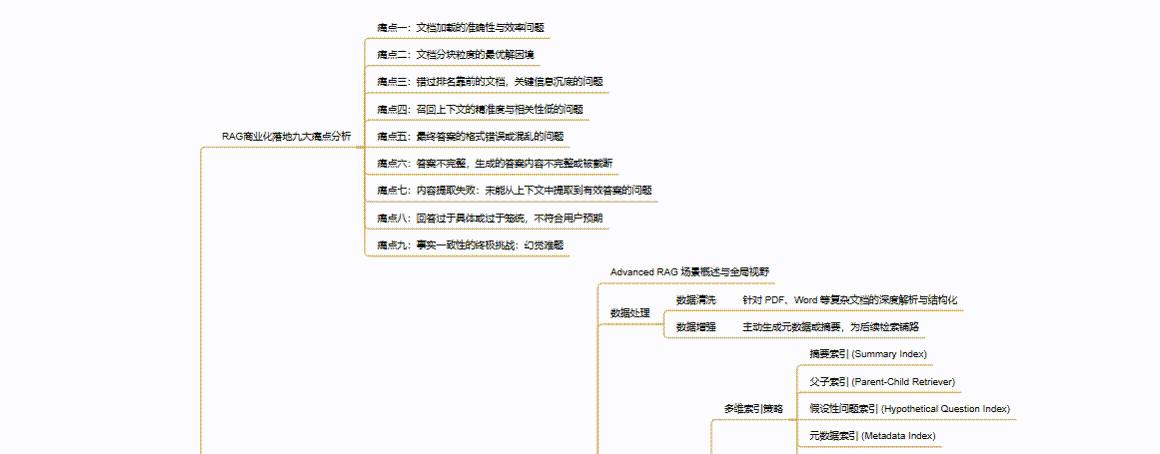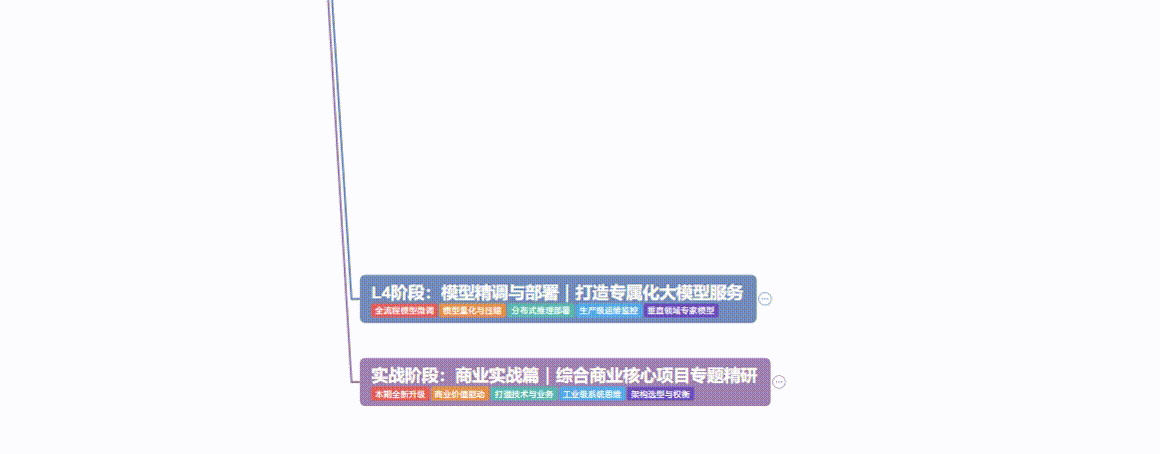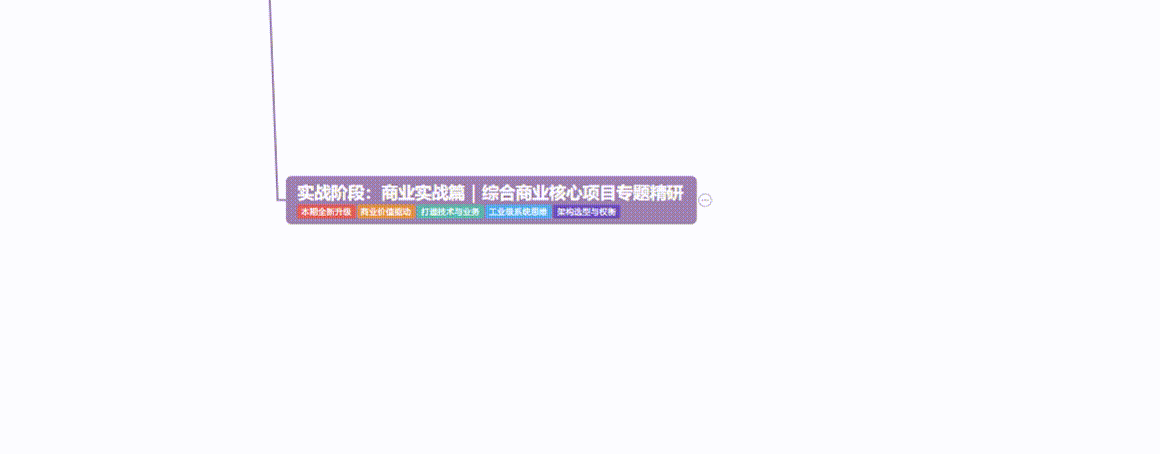
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
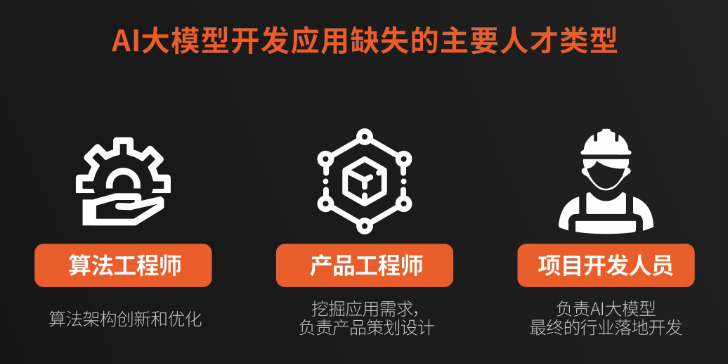
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、这些资料真的有用吗?
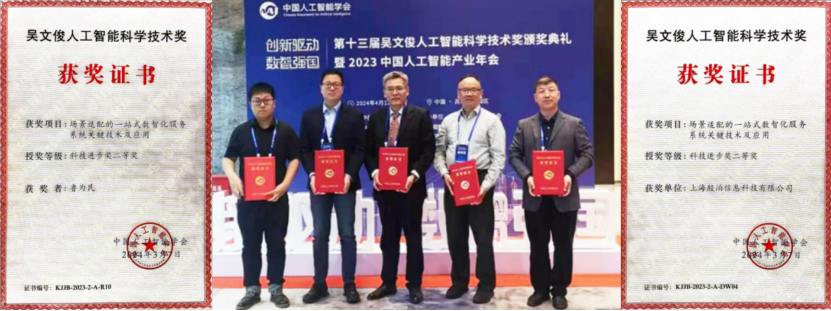
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 2
 0
- 0


 已为社区贡献30条内容

所有评论(0)