text-to-BIM 的成功率 86%~95%,从哪来的
上个月末,慕尼黑工业大学建筑 AI 中心主任 André Borrmann 在首尔参加 Hanmi Global 三十周年举办的 Global PM Summit 2026,主讲 BIM、AI 和机器人的融合。韩国经济日报随后报道了他的说法:多智能体 AI 靠文字命令生成 BIM 模型,墙体生成、开洞插入这类建模测试成功率 86%~95%;现场照片结合 BIM,把模板等结构的识别精度最多提高了 50%;预训练让机械臂作业成功率超过 70%。
数字很亮眼,传播也快。看到的人多半会想:文字转 BIM 已经这么能打了?
这篇把 86%~95% 拆开看一遍。
数字的出处
Borrmann 用的这组数字,来自他课题组 Changyu Du 等人的论文。同一项工作有两个版本:2024 年 8 月的 arXiv 预印本,和 2026 年 3 月正式刊登在 ASCE《Journal of Computing in Civil Engineering》第 40 卷第 2 期的版本,论文标题就叫 Text2BIM。
做法是四个 LLM agent 各司其职。Instruction Enhancer 把用户一句话扩写成需求文档,Architect 生成带坐标和尺寸的平面方案,Programmer 挑出封装好的建模 API 写成代码,规则检查器(rule-based model checker)再按工程常识挑错,迭代几轮直到模型过关。模型直接在 Vectorworks 里生成,能继续手动编辑,也能接碰撞检测、能耗分析这类下游任务。

Text2BIM 的多智能体框架
图注:Text2BIM 的框架。四个 LLM agent 协作,把自然语言转成调用建模 API 的代码,在 BIM 软件里生成可继续编辑的模型。来源:Du et al.,arXiv:2408.08054。
论文对比了 GPT-4o、Gemini 和 Mistral 三个模型,结论是能生成结构合理、语义对齐的模型。但评测主要靠人工打分和规则检查,没有端到端成功率这个指标。
86%~95% 具体对应哪组数字,要到同课题组的另一篇论文里找。BIMgent(arXiv:2506.07217)做的是把 agent 直接接到 BIM 软件界面上,看截屏、点界面、按快捷键自主建模,相当于教 AI 自己用建模软件。25 个建模任务,端到端成功率 32%。把任务拆成子步骤,画墙、插门洞这类反复出现的简单操作,成功率 86.58% 和 92.68%,论文摘要里开洞一处又写 95.12%。
Borrmann 演讲里那组 86%~95%,指的就是后一类数字。

BIMgent 的总体框架
图注:BIMgent 的框架,让计算机操作型 agent(computer-use agent)自主完成建筑建模。来源:arXiv:2506.07217。

BIMgent 的分层结构
图注:BIMgent 的分层结构。设计层把需求转成经过整理的平面方案,动作规划层把建模流程分层组织,执行层通过 GUI grounding 落到具体操作。来源:arXiv:2506.07217。
两个数字之间差了什么
一眼能看出差别:86%~95% 是单步建模动作的成功率,32% 是从一句话到一栋说得过去的房子的端到端成功率。前者测 agent 执行"画一面 240 墙""在指定位置插一个门洞"这类单一操作有多稳,后者才代表整套流程能不能走完。
两个口径差了近三倍,也正好说明一个工程常识:每一步都合格,不等于整条链路能通。步骤一多,规划出错的概率就叠上来。BIMgent 论文里有个数据,动态 GUI grounding 机制让整体成功率提高了 18.67 个百分点——只解决"agent 看错界面弹窗"这一个问题,就能差出一大截。
别急着下结论
把这组数字当成 text-to-BIM 已经成熟,会误判;当成纯宣传,也误判。关键是对评测口径保持敏感。
2026 年 6 月新发的 BIM-Edit(arXiv:2606.20146)是 IFC 编辑基准,324 个编辑任务,要求模型先读懂已有建筑再动手改。结果:最好的模型平均分 49.5%,完整解出的任务不足 3.4%。生成一个正确的模型是一回事,在不动周边语义的前提下改对一个模型是另一回事,后者目前离解决还很远。
TUM 自己的另一篇(arXiv:2601.00809)评测基于 MCP 的 agentic BIM 交互,不同测试用例下模型成功率从 40% 到 95% 浮动——换个软件、换一组命令,同一个 agent 的表现会有很大出入。BIMgent 内部的子任务差距也不小:墙 86.58%,屋顶 60%,图层处理 46.34%,"看似简单"和"真的简单"之间的边界,论文自己都没完全摸清。
现场照片识别精度提高 50%、机械臂成功率超过 70% 同理。它们是同一课题组在不同子项目里的受控实验结论,带明确前提(特定工程场景、预先训练好的模型),不适合直接外推到"工地全面自动化"。
值得关注的变化
从两篇论文能看出这条研究线的转向:TUM 已经不只做"能不能生成模型",开始做"怎么评测、怎么让它可信"。Text2BIM 用规则检查器做质量闭环,BIMgent 设计了 Mini Building Benchmark 和消融实验,BIM-Edit 把评测拆成几何、语义、拓扑三个维度。评测先行,是技术从论文走向工程的第一步。
对普通从业者,信号不在 90% 这个数字上,而在尝试路径上。对话式建模最可能先从低风险、重复性高的单步操作进入工具——拉一排墙、插标准门洞、生成标准层——而不是一次对话拿出一栋可交付的房子。设计院离"量产"还隔着工作流、数据、责任归属这一串没理顺的事。
Borrmann 自己也没把话说过头,原话是"通过 AI 应用,在墙体生成、开洞插入等建模测试中取得 86% 到 95% 的成功率"。数字真实,口径要看清。text-to-BIM 的方向是实打实的,只是从 32% 的端到端到设计院量产,中间还差着小步迭代和一套新的评测标准。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
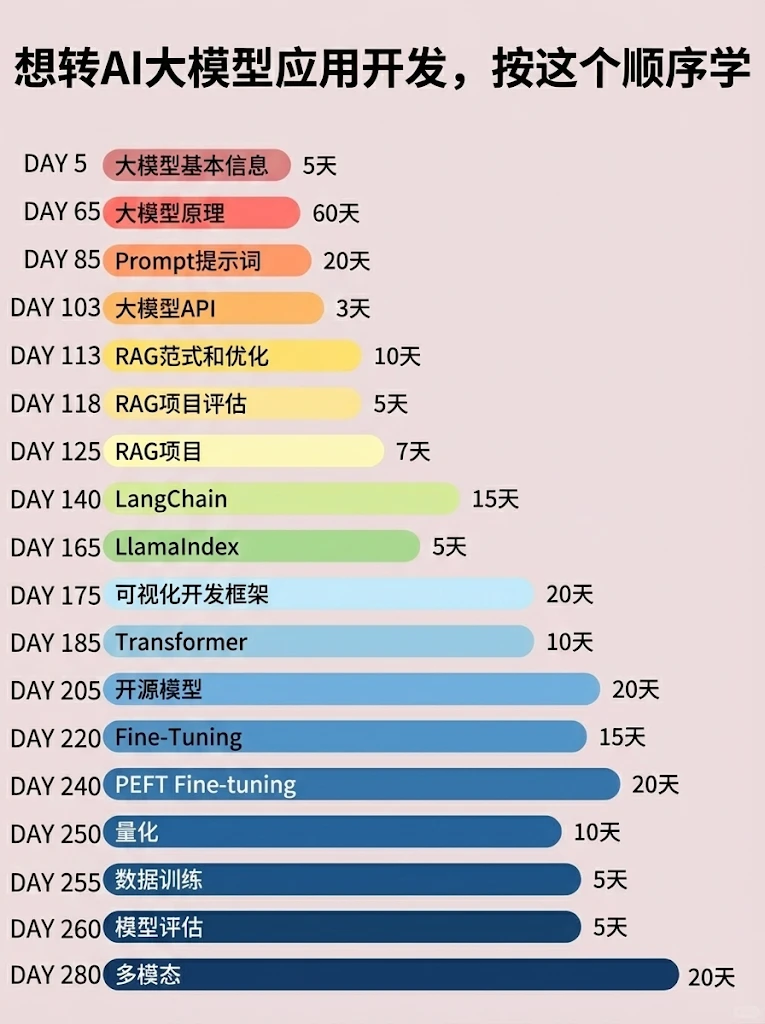
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 1
 0
- 0


 已为社区贡献119条内容

所有评论(0)