Python日志监控实战:关键词告警、钉钉机器人、systemd自启与远程SSH处理
Python日志监控实战:关键词告警、钉钉机器人、systemd自启与远程SSH处理
前言
服务器出问题最麻烦的,不一定是故障本身,而是故障发生以后没人第一时间知道。磁盘写满、服务报错、进程异常,如果只能靠人工登录服务器翻日志,往往等真正发现时,问题已经持续了一段时间。相比上来就搭一整套监控平台,有些场景其实只需要先把最关键的一步解决:日志里一出现特定错误,手机马上收到提醒。
这次用 Python 写一个轻量日志监控脚本,持续读取指定日志文件,并通过 ERROR、failed、no space left on device 等关键词判断异常;命中以后,再调用钉钉机器人把主机、时间、日志路径和错误内容推送到群里。
脚本跑通后,再补上虚拟环境、systemd 开机自启,让它能长期留在服务器后台运行。
最后继续配置 SSH 的远程 TCP 入口。这样整套链路就从“日志异常被发现”延伸到“收到告警后远程登录处理”,形成一套适合小型服务器、NAS和测试机使用的轻量运维流程。
这套方法的价值在于,它把“发现问题”和“处理问题”分成两步:Python脚本负责盯日志、钉钉负责把异常送到手机,SSH则留作后续远程处置。每一层都很轻,组合起来却能覆盖很多家庭服务器、测试机和小型业务环境里最常见的运维需求。
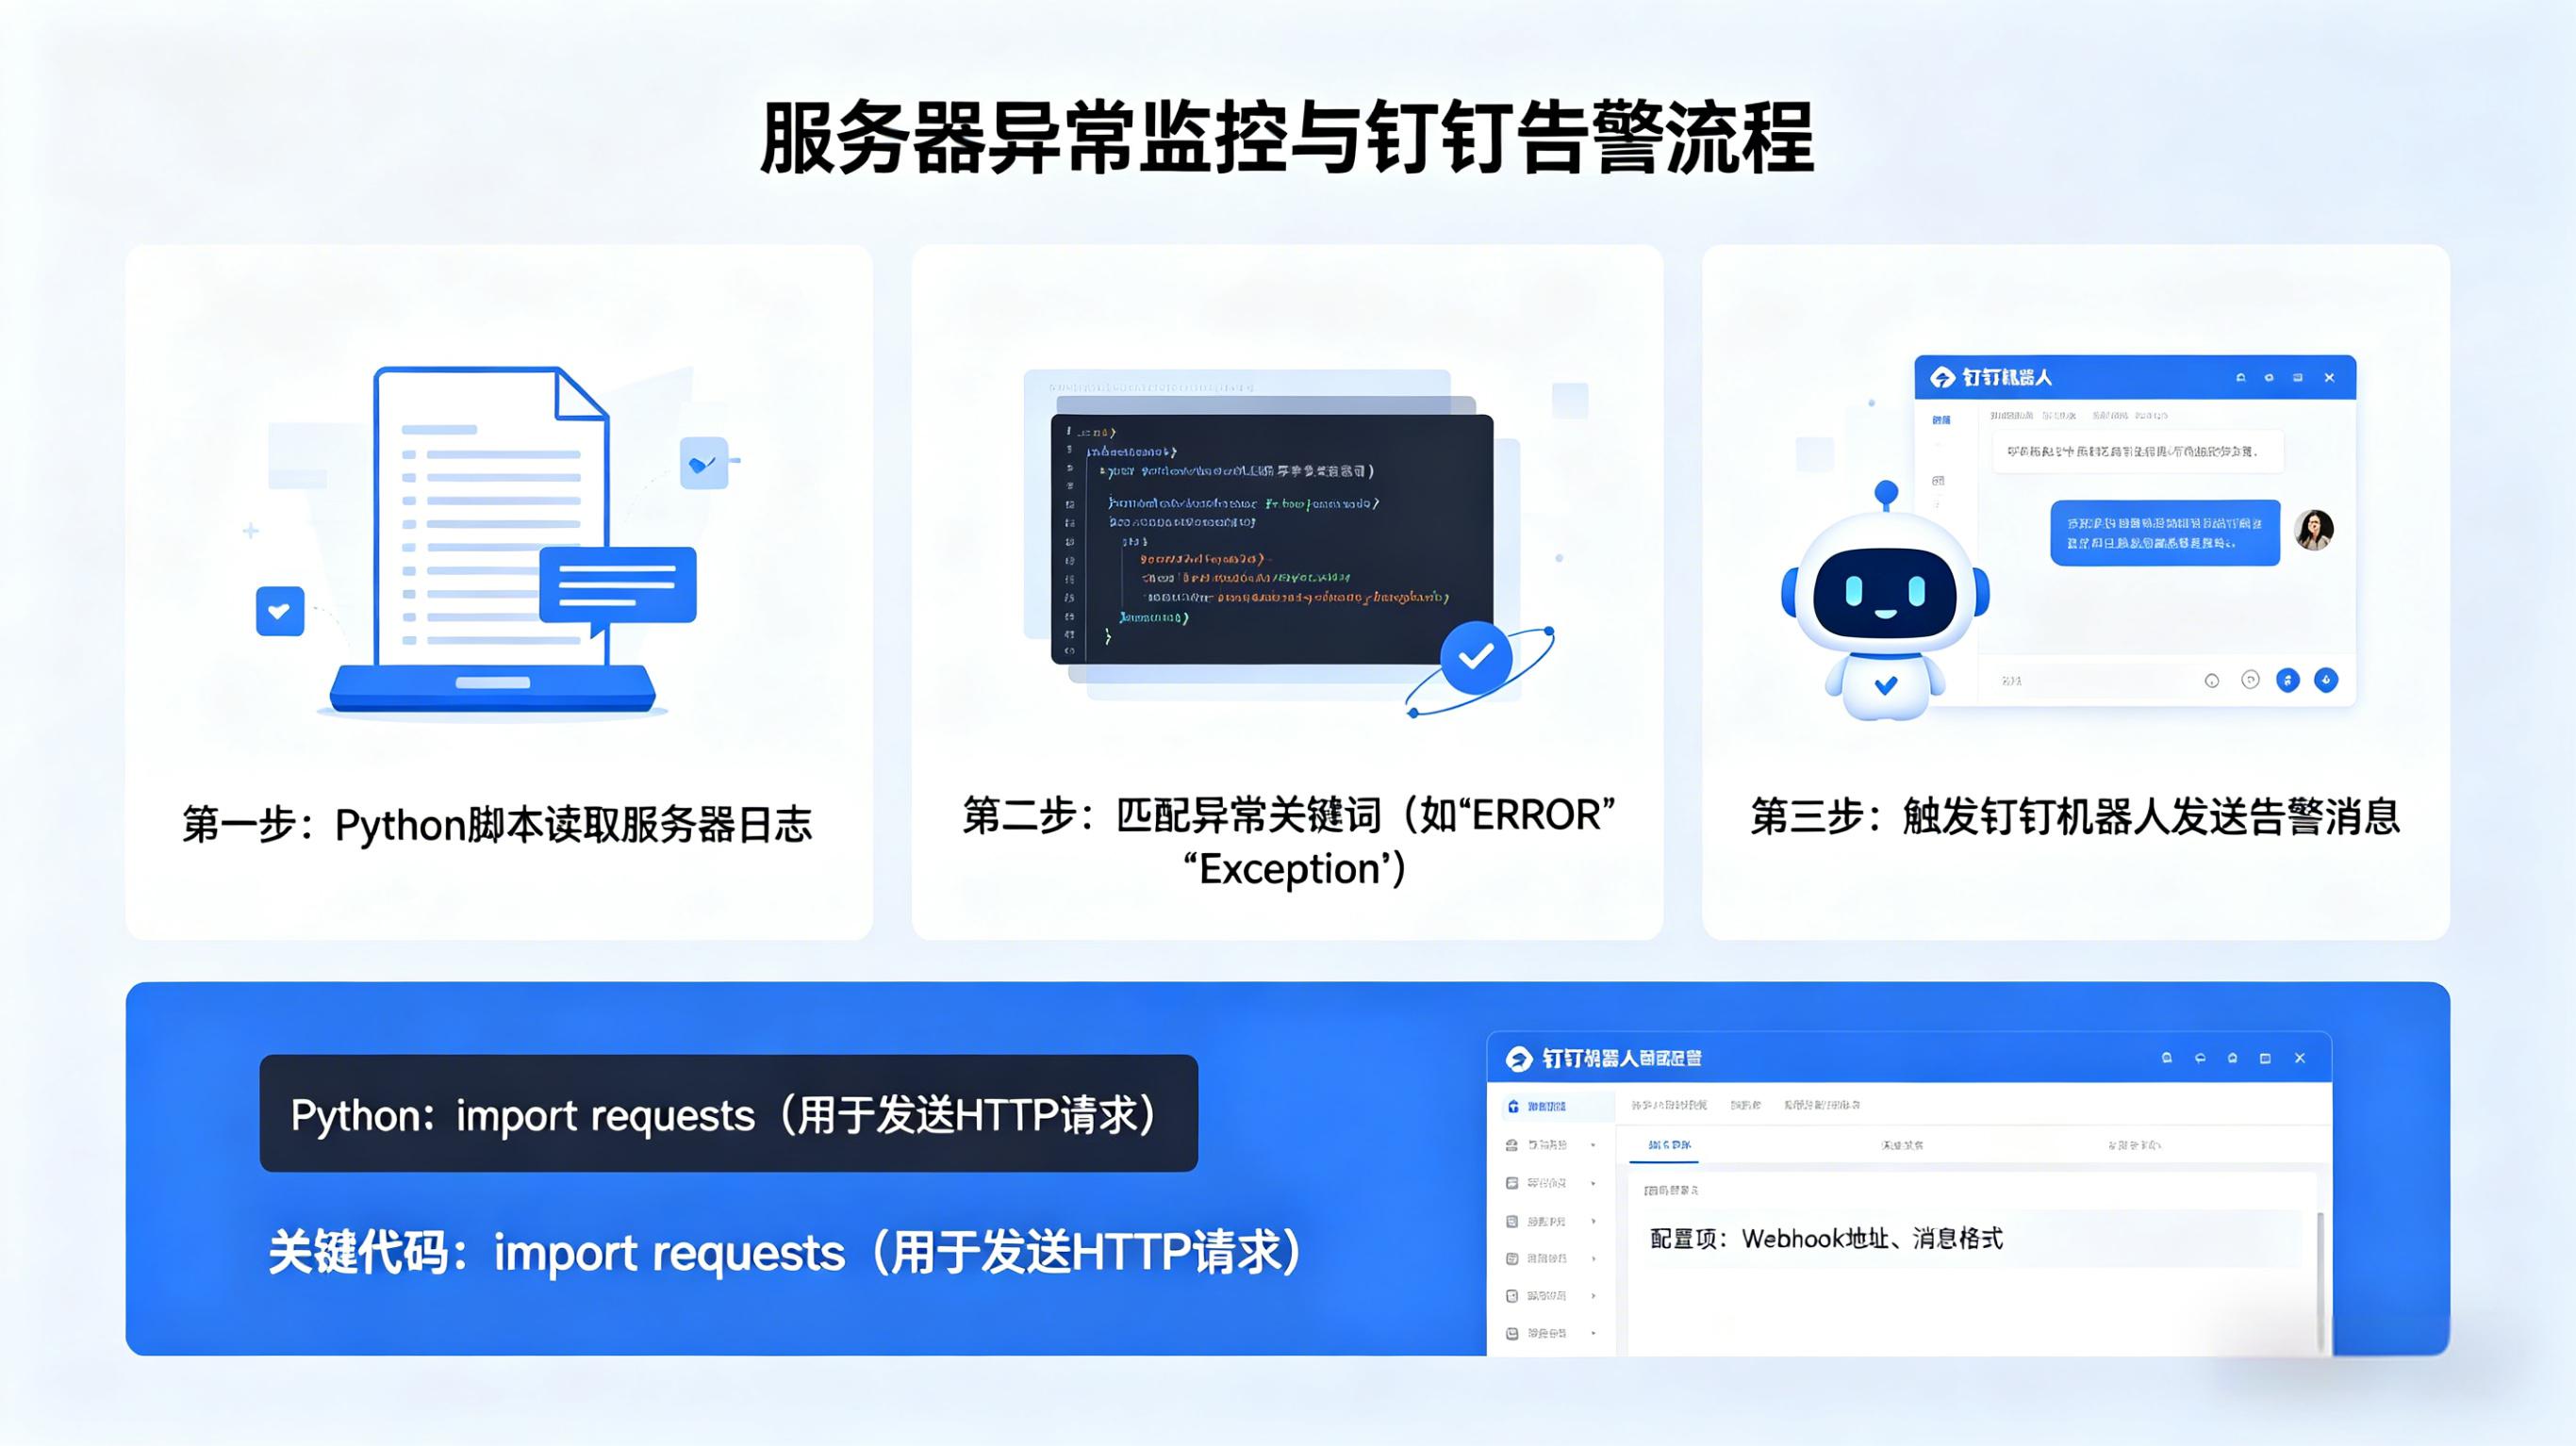
1 先看这套方案最终要实现什么
假设日志里出现:
May 08 15:30:01 server cpolar[1234]: Failed to write log: no space left on device
脚本检测到关键词以后,钉钉群会收到一条告警,其中包含:
- 主机名;
- 时间;
- 日志路径;
- 具体错误内容;
- 命中的异常关键词。
这套方案的核心并不复杂:
日志文件 → Python脚本 → 关键词判断 → 钉钉机器人。
后面再加一层远程SSH入口,就能继续处理告警后的问题。
2 这种方式适合什么场景
比较适合:
- 家庭服务器;
- NAS;
- 测试机;
- 小型Linux主机;
- 没有完整监控平台的开发环境;
- 只需要盯几个关键日志的服务。
它的优势是结构简单。
只要日志本身会记录异常,就可以先用关键词把最重要的问题抓出来。
比如:
errorfailedexceptionno space left on devicedisk full
如果以后要扩展,也可以继续加入Nginx、数据库、Docker或其他应用日志。
3 第一步先准备钉钉机器人
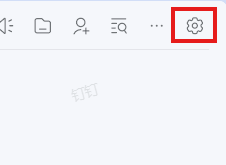
打开钉钉群设置:
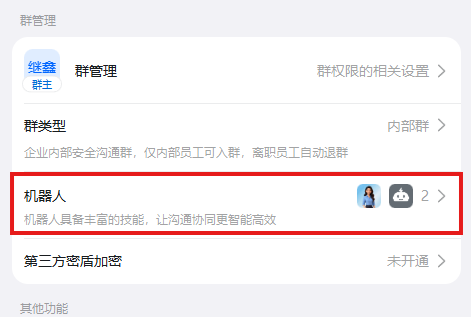
进入智能群助手:
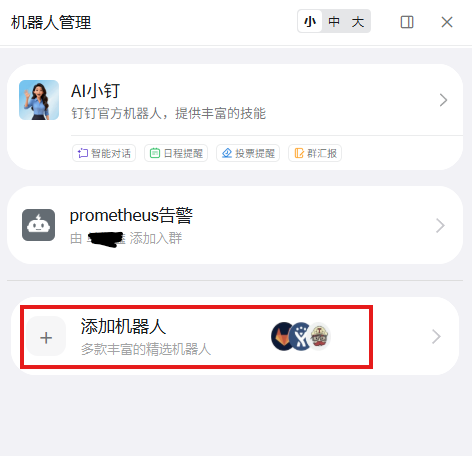
继续添加机器人:
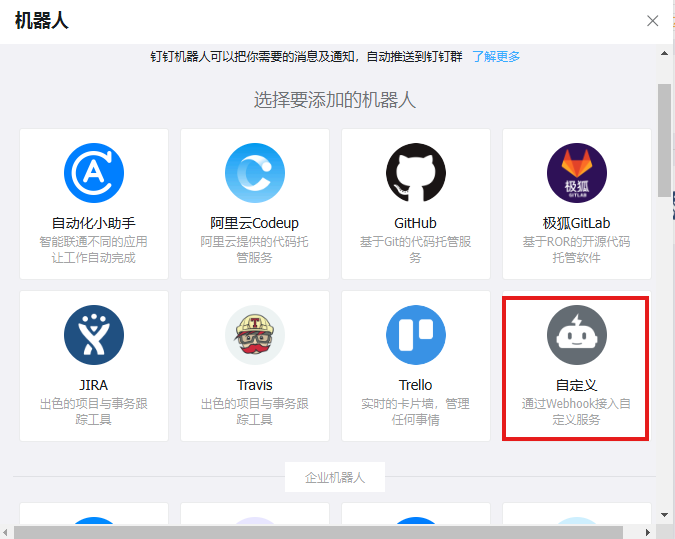
选择自定义机器人:
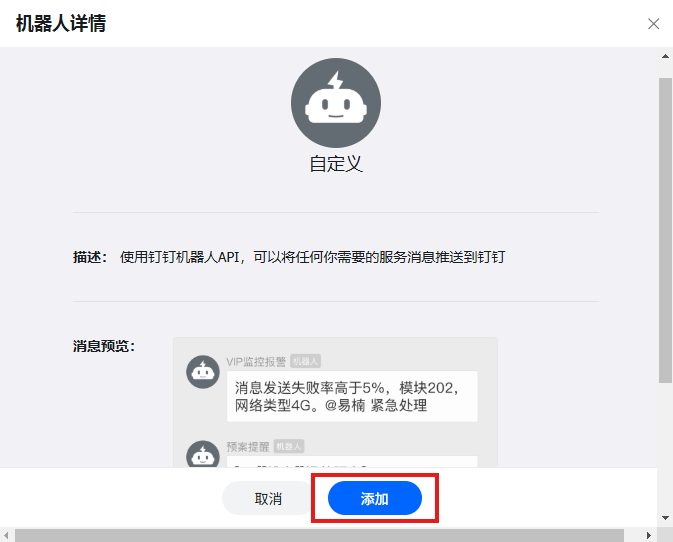
点击添加:
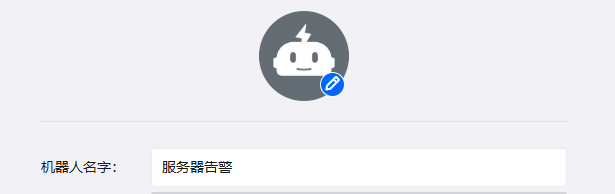
然后给机器人设置名称。
这次使用的是:
服务器告警
4 配置机器人的消息安全方式
继续设置机器人消息限制:
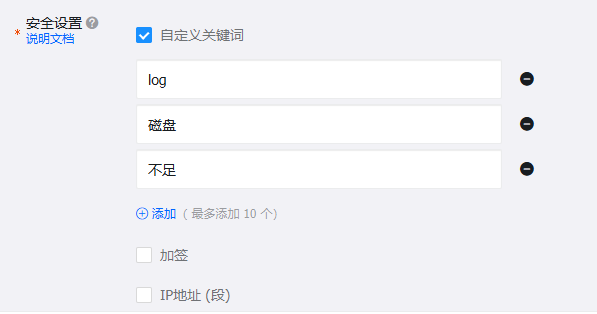
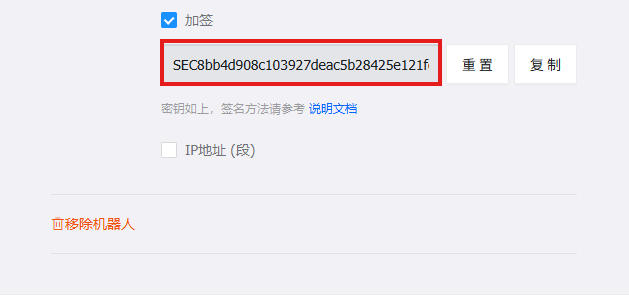
这里可以配置关键词、加签或IP地址。
这次继续使用加签方式。
点击加签以后,复制生成的Secret:
保存好后,再复制机器人Webhook:
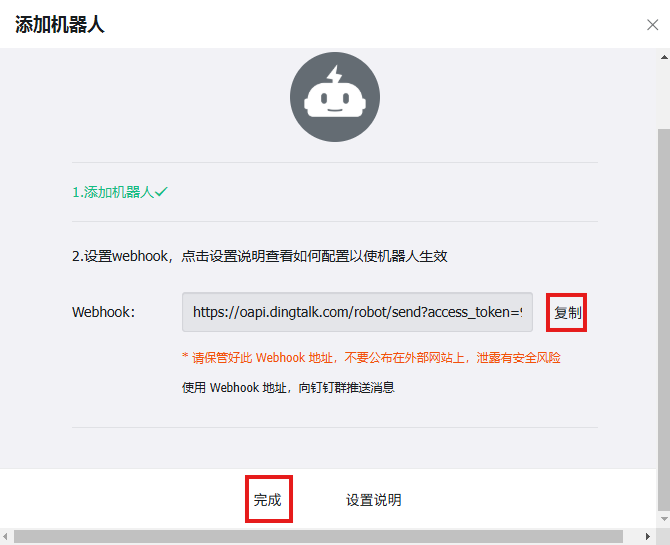
后面的Python脚本会用到:
- Webhook;
- Secret。
这两个值用于把告警消息发送到指定钉钉群。
5 准备一个测试日志文件
先创建测试目录和日志文件:
mkdir /var/log/ceshi/
touch /var/log/ceshi/access.log.20260508
这次监控文件是:
/var/log/ceshi/access.log.20260508
后面所有测试都围绕这个文件进行。
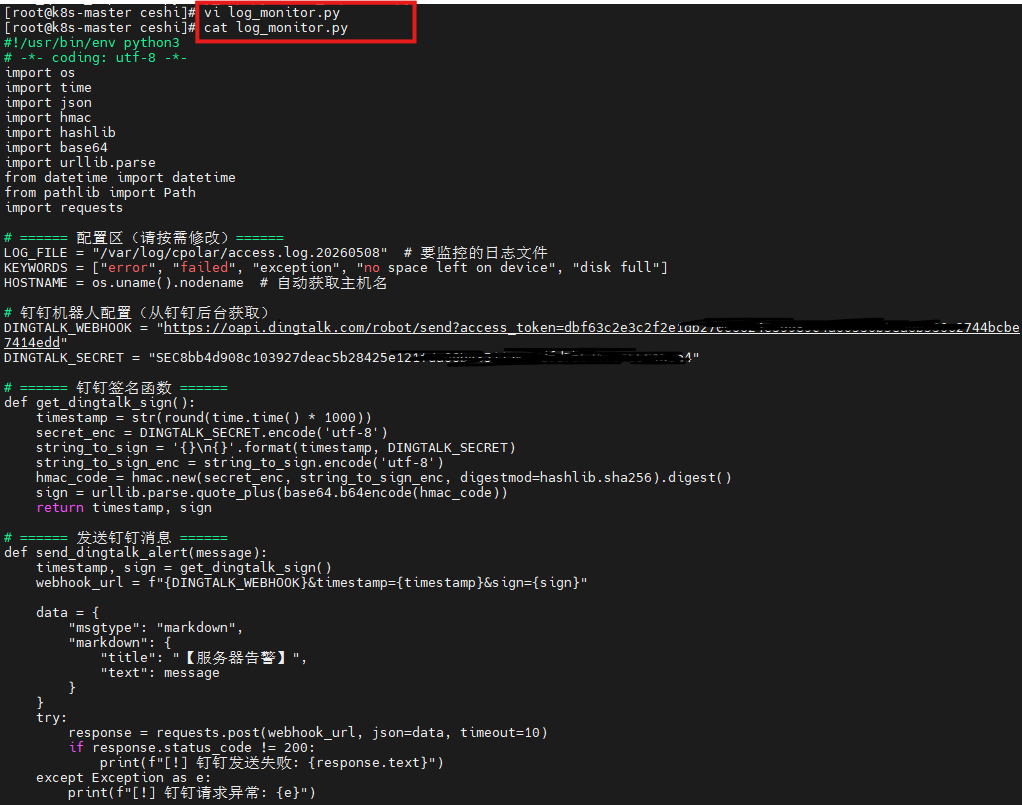
6 编写Python日志监控脚本
创建:
log_monitor.py
脚本内容如下:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
import os
import time
import json
import hmac
import hashlib
import base64
import urllib.parse
from datetime import datetime
from pathlib import Path
import requests

# ====== 配置区(请按需修改)======
LOG_FILE = "/var/log/ceshi/access.log.20260508"  # 要监控的日志文件
KEYWORDS = ["error", "failed", "exception", "no space left on device", "disk full"]
HOSTNAME = os.uname().nodename  # 自动获取主机名

# 钉钉机器人配置(从钉钉后台获取)
DINGTALK_WEBHOOK = "https://oapi.dingtalk.com/robot/send?access_token=dbf63c2e3c2f2dd"
DINGTALK_SECRET = "SEC8bb4d908c1039a4"

# ====== 钉钉签名函数 ======
def get_dingtalk_sign():
    timestamp = str(round(time.time() * 1000))
    secret_enc = DINGTALK_SECRET.encode('utf-8')
    string_to_sign = '{}\n{}'.format(timestamp, DINGTALK_SECRET)
    string_to_sign_enc = string_to_sign.encode('utf-8')
    hmac_code = hmac.new(secret_enc, string_to_sign_enc, digestmod=hashlib.sha256).digest()
    sign = urllib.parse.quote_plus(base64.b64encode(hmac_code))
    return timestamp, sign

# ====== 发送钉钉消息 ======
def send_dingtalk_alert(message):
    timestamp, sign = get_dingtalk_sign()
    webhook_url = f"{DINGTALK_WEBHOOK}×tamp={timestamp}&sign={sign}"

    data = {
        "msgtype": "markdown",
        "markdown": {
            "title": "【服务器告警】",
            "text": message
        }
    }
    try:
        response = requests.post(webhook_url, json=data, timeout=10)
        if response.status_code != 200:
            print(f"[!] 钉钉发送失败: {response.text}")
    except Exception as e:
        print(f"[!] 钉钉请求异常: {e}")

# ====== 监控日志主函数 ======
def monitor_log():
    log_path = Path(LOG_FILE)
    if not log_path.exists():
        print(f"[!] 日志文件不存在: {LOG_FILE}")
        return

    # 获取文件初始大小(用于断点续读)
    file_size = log_path.stat().st_size
    print(f"[+] 开始监控日志: {LOG_FILE} (初始大小: {file_size} bytes)")

    while True:
        try:
            current_size = log_path.stat().st_size
            if current_size < file_size:
                # 日志被轮转(如 logrotate),重置位置
                print("[+] 检测到日志轮转,重新开始读取")
                file_size = 0

            if current_size > file_size:
                with open(LOG_FILE, 'r', encoding='utf-8', errors='ignore') as f:
                    f.seek(file_size)  # 从上次位置读起
                    lines = f.readlines()
                    file_size = current_size  # 更新已读位置

                    for line in lines:
                        line_lower = line.lower()
                        for keyword in KEYWORDS:
                            if keyword in line_lower:
                                # 构建告警消息
                                now = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
                                msg = (
                                    f"## 🔴 **【服务器告警】**\n\n"
                                    f"- **主机**: `{HOSTNAME}`\n"
                                    f"- **时间**: `{now}`\n"
                                    f"- **日志路径**: `{LOG_FILE}`\n"
                                    f"- **内容**: `{line.strip()}`\n\n"
                                    f"> ⚠️ **检测到关键词: `{keyword}`**"
                                )
                                print(f"[ALERT] {line.strip()}")
                                send_dingtalk_alert(msg)
                                break  # 避免重复告警同一行
            time.sleep(1)  # 每秒检查一次
        except KeyboardInterrupt:
            print("\n[+] 监控已停止")
            break
        except Exception as e:
            print(f"[!] 监控异常: {e}")
            time.sleep(5)

if __name__ == "__main__":
    monitor_log()
这段脚本主要完成四件事:
- 记录当前已经读取到日志文件的哪个位置;
- 每秒检查一次文件是否有新增内容;
- 对新增日志逐行匹配关键词;
- 命中以后调用钉钉机器人发送Markdown告警。
脚本页面:
7 关键词检测是整套逻辑的核心
配置区里已经定义:
errorfailedexceptionno space left on devicedisk full
日志新增加一行以后,脚本会统一转成小写再匹配。
只要一行里命中任意关键词,就会构造告警消息。
这种方式很直接,也方便按自己的服务继续增加关键词。
8 脚本会保存上次读取的位置
这段脚本不是每秒把整个日志重新扫描一遍。
启动时先记录文件大小,后面只读取新增部分。
也就是:
第一次位置 → 新日志追加 → 从上次位置继续读。
这样更适合持续运行。
如果检测到文件变小,还会把读取位置重新归零,用来处理日志轮转后的情况。
9 告警消息里保留了现场信息
命中关键词以后,脚本会把这些内容一起发出去:
HOSTNAME- 当前时间
LOG_FILE- 触发告警的日志行
- 命中的关键词
因此收到钉钉消息时,不需要先登录服务器才能知道是哪台机器、哪个日志、出现了什么内容。
这也是日志告警真正有用的地方:
先把故障现场带到手机上。
10 准备Python运行环境
进入项目目录:
cd /root/ceshi
创建虚拟环境:
python3 -m venv venv
激活:
source venv/bin/activate
然后安装requests:
pip install requests
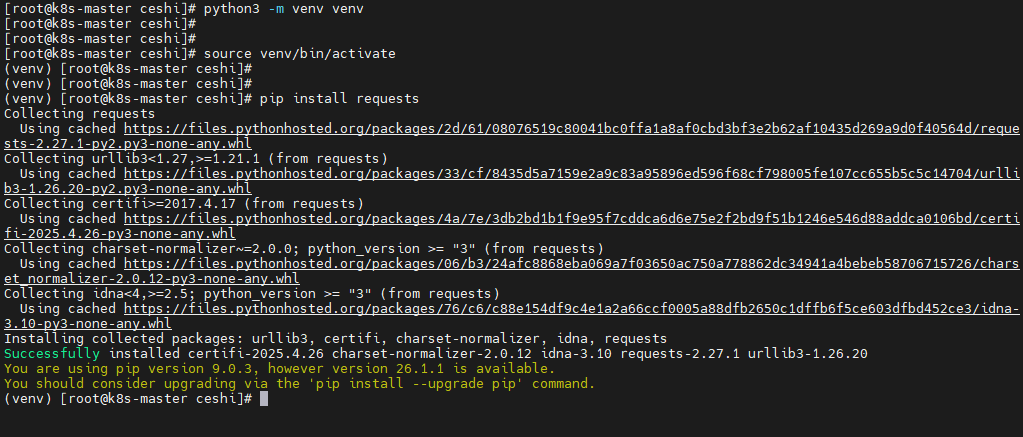
做到这里,脚本需要的Python环境已经准备完成。
11 手动启动脚本
执行:
python log_monitor.py

正常启动后,脚本会开始持续等待日志新增内容。
这时先不要急着配置开机自启。
先手动验证一次完整告警链路更容易排错。
12 往日志里写一条模拟异常
编辑测试日志:
vi access.log.20260508
写入:
May 08 15:30:01 server cpolar[1234]: Failed to write log: no space left on device

这一行同时包含:
Failed
和:
no space left on device
因此会命中脚本里的关键词。
13 查看钉钉是否真正收到消息
测试成功:
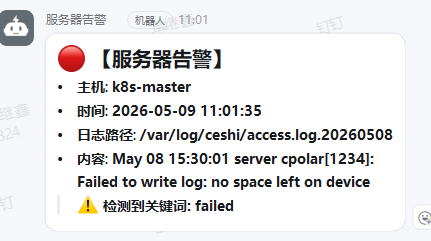
做到这里,可以确认整条告警链:
测试日志 → Python → 关键词 → 钉钉机器人
已经跑通。
比单纯看到Python脚本没有报错更有意义。
14 手动运行验证后,再考虑后台常驻
如果只是临时测试,可以使用nohup:
nohup python3 /path/to/log_monitor.py > /var/log/log_monitor.log 2>&1 &
这种方式简单,适合先把脚本挂在后台。
如果希望机器重启以后自动恢复,更适合继续做systemd服务。
15 创建systemd服务
创建服务文件:
sudo vim /etc/systemd/system/log-monitor.service
配置内容:
[Unit]
Description=Log Monitor for Server Alerts
After=network.target

[Service]
Type=simple
User=root
ExecStart=/usr/bin/python3 /ceshi/log_monitor.py
Restart=always
RestartSec=10

[Install]
WantedBy=multi-user.target
这里指定:
- 服务类型:simple;
- 运行用户:root;
- Python脚本路径;
- 自动Restart;
- RestartSec为10秒。
这样脚本退出以后,systemd可以继续拉起它。
16 启用并启动log-monitor
执行:
sudo systemctl daemon-reload
sudo systemctl enable --now log-monitor.service
sudo systemctl status log-monitor
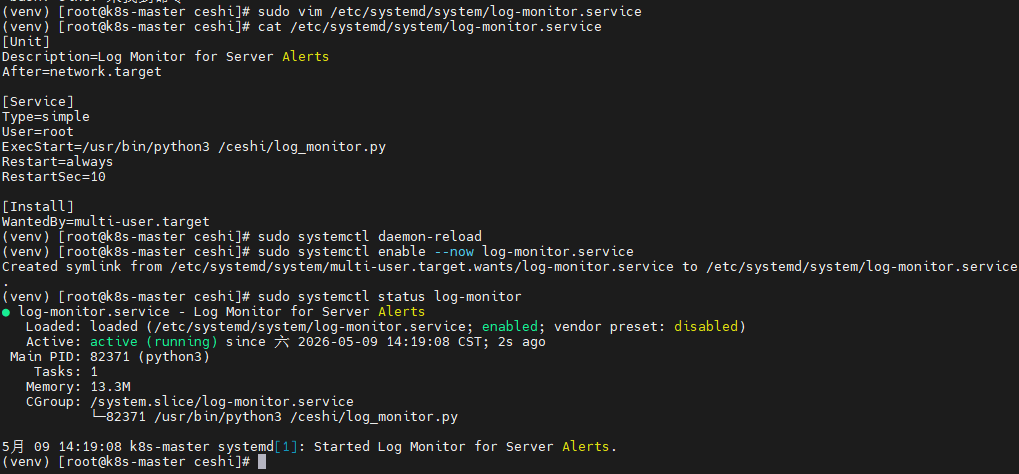
做到这里,日志监控脚本已经从:
手动运行
变成:
系统后台服务。
服务器重启以后,也可以继续由systemd管理。
17 到这里已经完成“异常发现”和“即时通知”
目前已经跑通:
日志新增 → 关键词命中 → 钉钉告警。
但收到告警以后,还会有下一步问题:
如果人不在局域网,怎么马上登录服务器处理?
所以后半段继续把SSH远程入口接上。
18 告警和远程处理应该分成两条链
第一条:
Python监控 → 钉钉通知
解决:
什么时候知道出问题。
第二条:
外部终端 → SSH → 服务器
解决:
知道以后怎么进去处理。
把两件事分开以后,整个运维逻辑更清楚。
19 安装cpolar
执行:
sudo curl https://get.cpolar.sh | sh
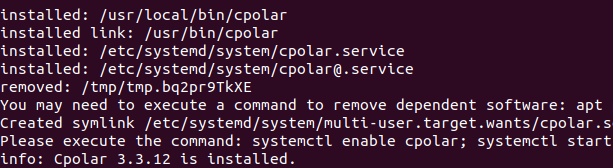
安装以后查看服务:
sudo systemctl status cpolar
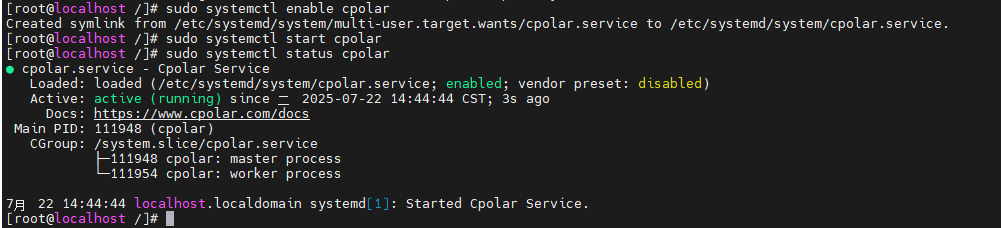
确认cpolar运行正常后,进入Web管理页面:
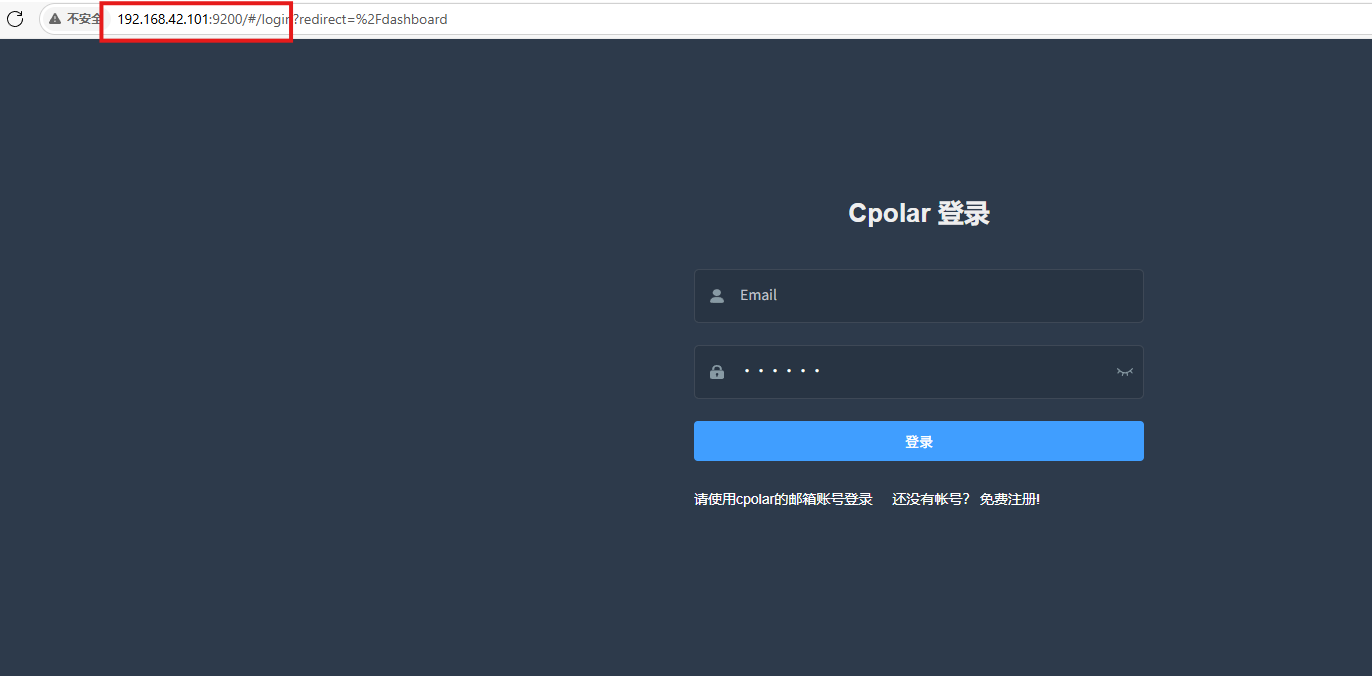
20 给SSH的22端口创建TCP入口
这次配置:
- 隧道名称:
ssh - 协议:TCP
- 本地地址:
22 - 端口类型:随机临时TCP端口
- 地区:
China Top
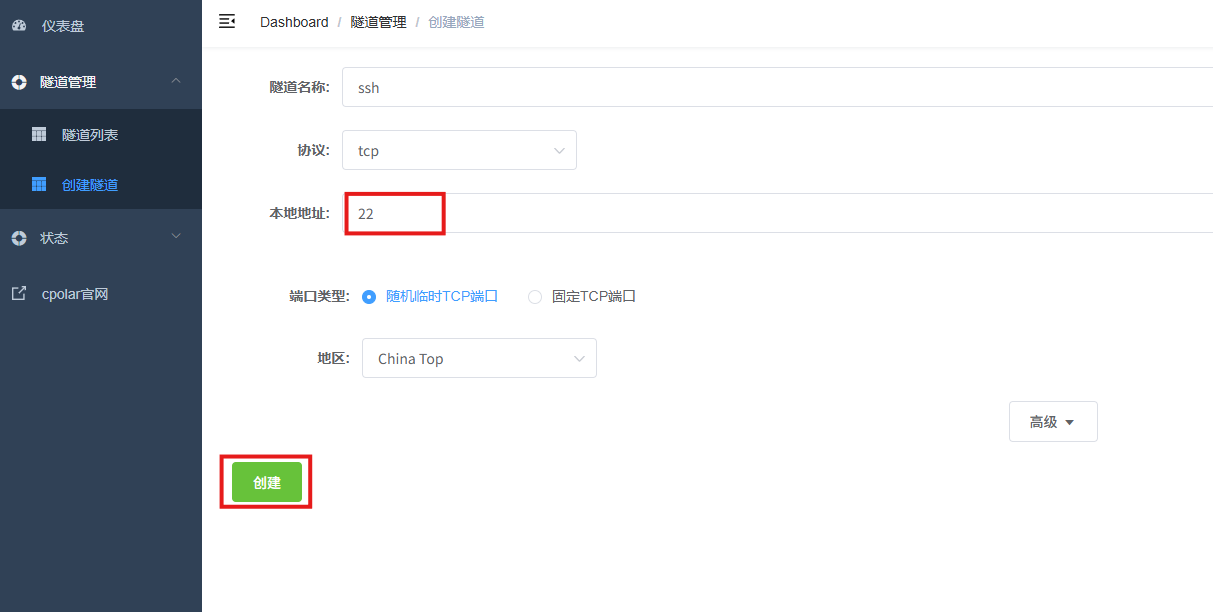
创建以后查看在线隧道:
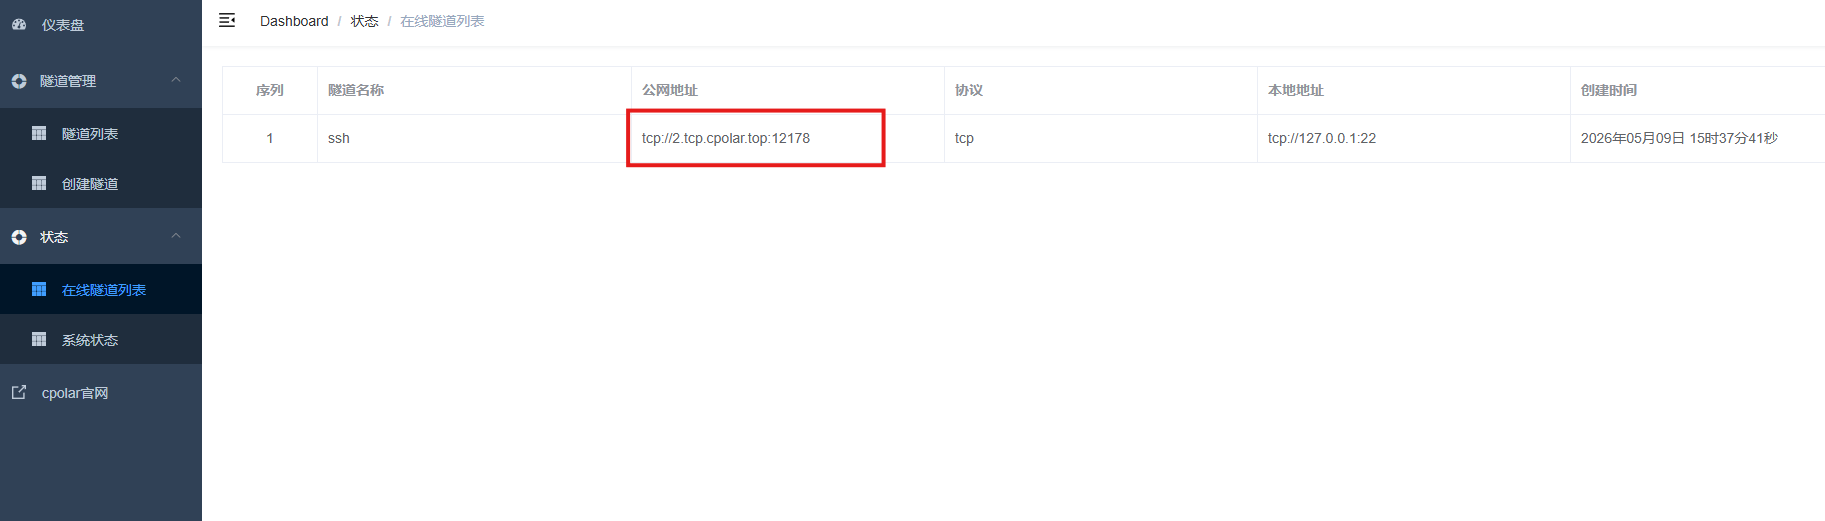
示例生成:
- 地址:
2.tcp.cpolar.top - 端口:
12178
21 从外部终端实际连接服务器
执行:
ssh -p 12178 root@2.tcp.cpolar.top
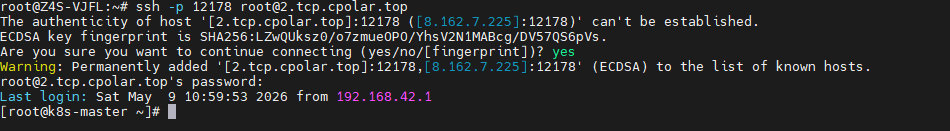
能够进入服务器以后,可以确认:
外部终端 → TCP公网地址 → SSH 22端口
这条远程处理链也已经跑通。
22 这时才真正形成告警后的处理闭环
现在故障发生以后,流程可以变成:
日志出现异常
↓
Python检测关键词
↓
钉钉收到消息
↓
查看主机、日志和错误内容
↓
SSH远程登录
↓
继续排查和处理
这比单独“监控日志”或者单独“做SSH远程访问”更完整。
23 随机TCP先验证,长期使用再考虑固定TCP
随机TCP适合先确认:
SSH能不能真正从外部连进来。
如果以后经常远程维护,再继续配置固定TCP地址。
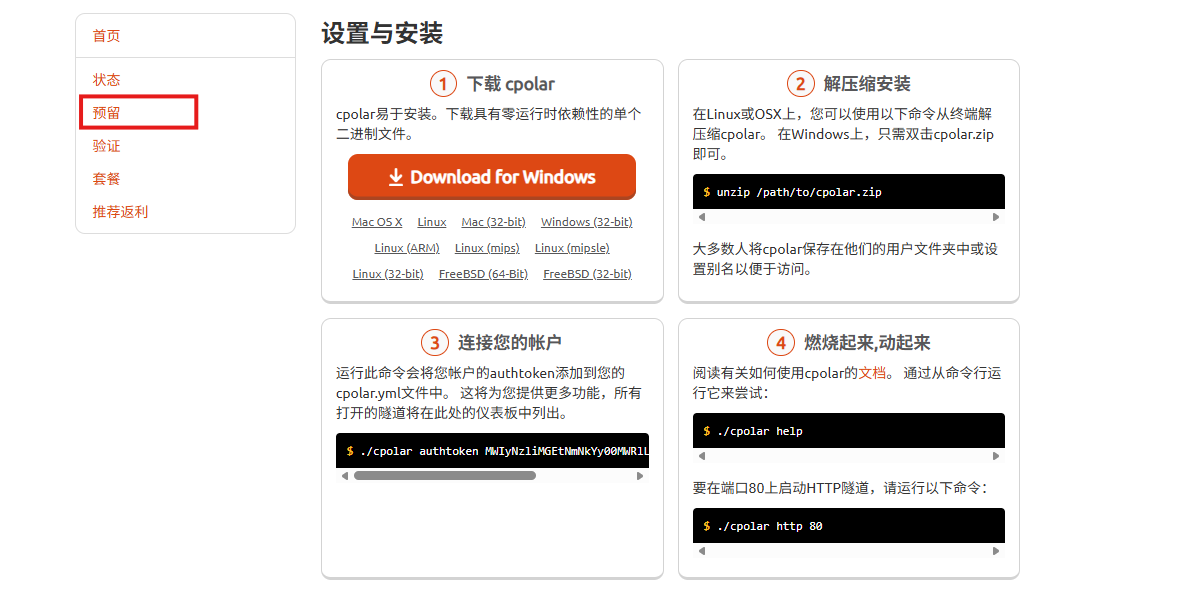
进入预留页面:
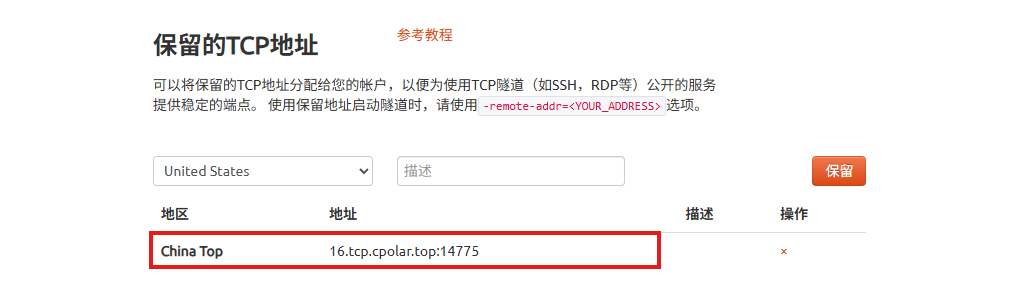
这次保留的示例地址:
16.tcp.cpolar.top:14775
24 把SSH隧道改成固定TCP
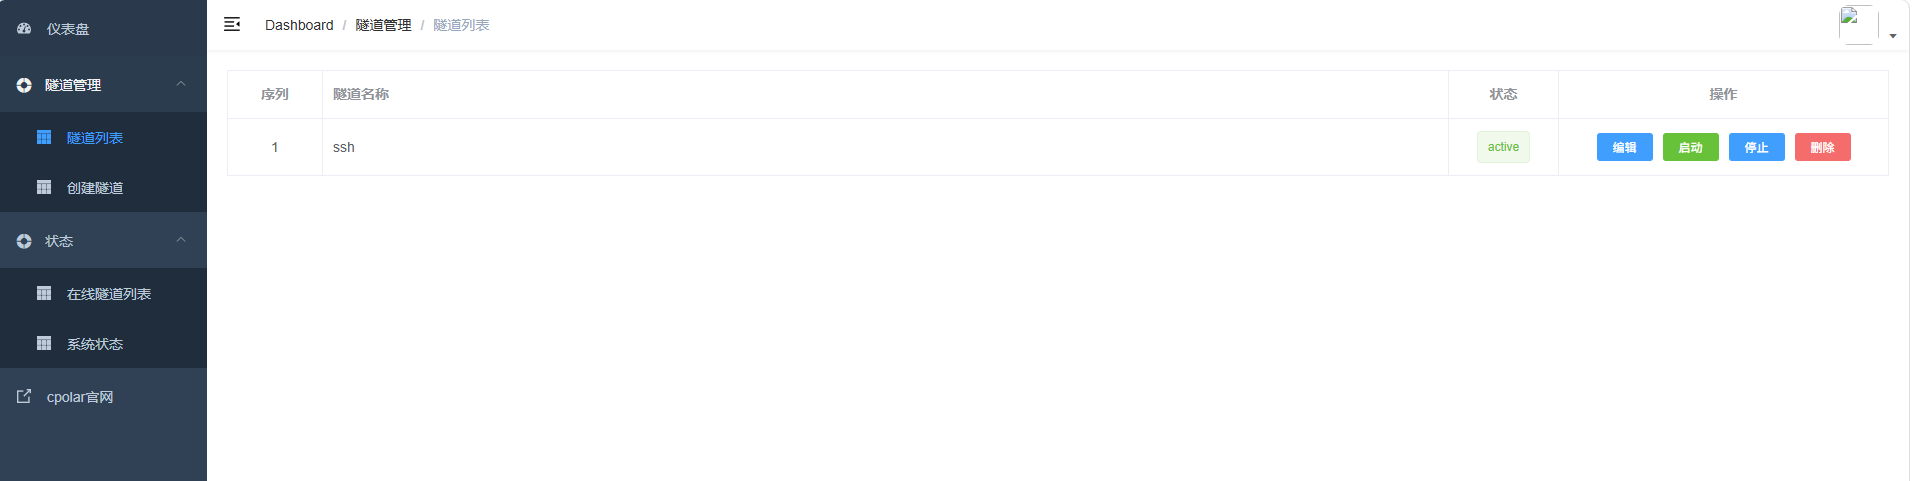
回到隧道列表:
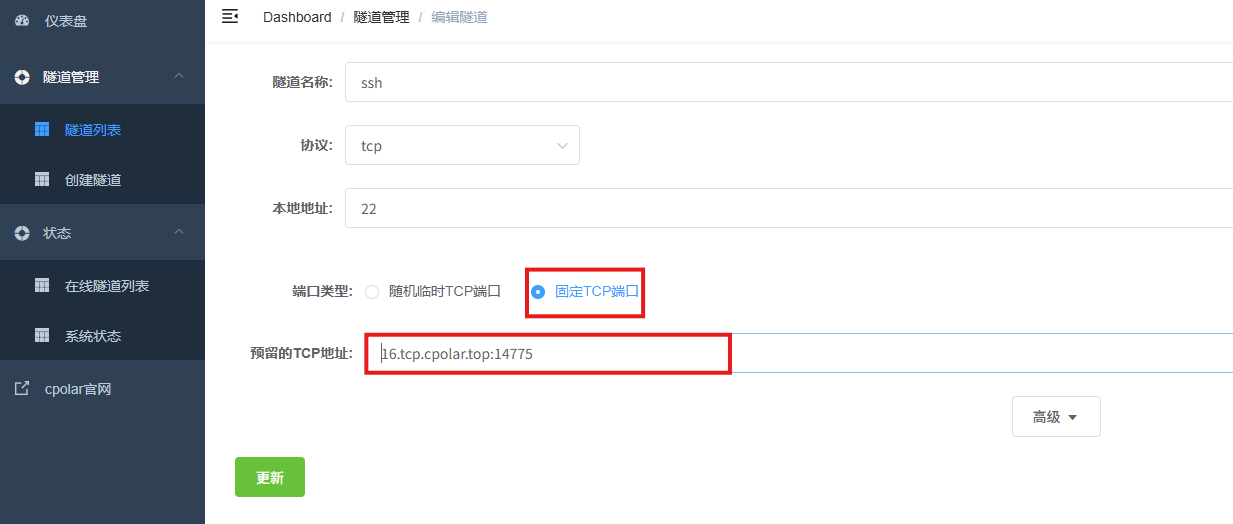
编辑SSH隧道。
修改:
- 端口类型:固定TCP端口;
- 预留TCP地址:填写已经保留的地址。
更新:
25 确认固定TCP已经生效
进入在线隧道列表:
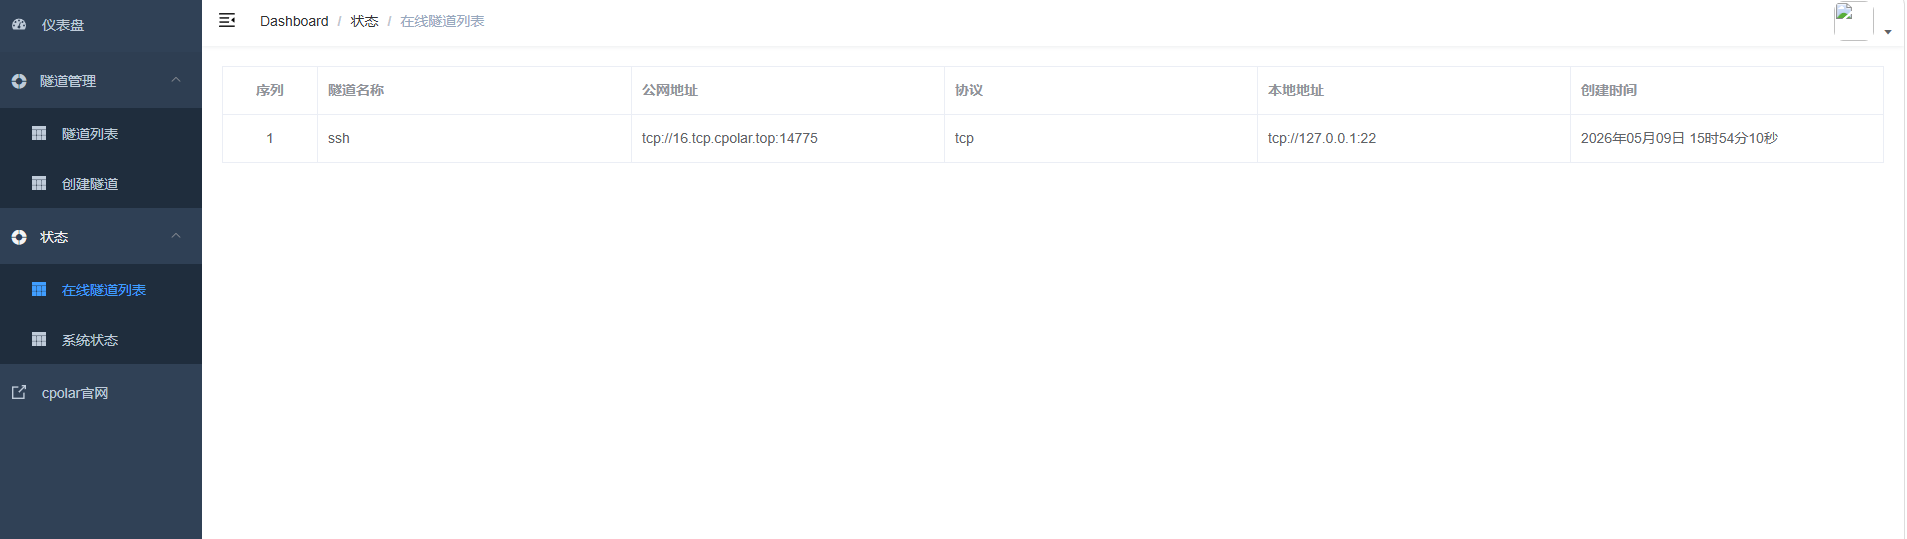
此时原来的随机地址已经切换为固定TCP入口。
以后远程处理告警时,就不需要每次重新查看随机端口。
26 这套方案真正适合的不是“大而全”,而是够轻
如果已经有完整Prometheus、Alertmanager、Zabbix或其他监控体系,就不一定需要再用脚本重复做一套。
但对于:
- 只有一两台机器;
- 只关心几个关键日志;
- 家庭实验室;
- 测试环境;
- NAS;
- 边缘设备;
Python关键词监控会更容易落地。
它解决的是:
先把最重要的异常送到手机。
27 关键词监控也有自己的边界
关键词模式很直观,但它依赖日志内容。
如果异常没有写入被监控的文件,脚本就不会知道。
如果某个正常日志里也出现相同关键词,也可能触发消息。
所以长期使用时,更适合逐步优化:
- 监控文件;
- 关键词;
- 告警内容;
- 不同服务的规则。
而不是把所有日志、所有错误都塞进一个列表。
28 最后把整条技术链重新看一遍
日志部分:
日志文件 → Python → KEYWORDS → 钉钉
运行部分:
venv → requests → systemd → log-monitor
远程部分:
外部终端 → TCP地址 → SSH 22端口
实际完成:
- 钉钉机器人;
- Webhook和Secret;
- 测试日志;
- Python日志监控脚本;
- 关键词匹配;
- 钉钉Markdown告警;
- 虚拟环境;
- requests;
- 手动运行测试;
- systemd开机自启;
- cpolar;
- SSH随机TCP;
- 固定TCP。
这样就形成了一套:
发现异常 → 收到通知 → 远程登录处理
的轻量运维链路。
总结
这次真正跑通的是一条完整的轻量告警链:Python只读取日志新增内容,匹配指定关键词以后,通过钉钉机器人把主机、时间、日志路径和错误内容直接推送出来。相比等人手动登录检查,至少先解决了“故障什么时候被发现”这个问题。
把脚本交给systemd以后,它又从一次性测试变成了可以长期留在后台运行的服务。日志监控、消息通知和进程自启三部分到这里已经完整。
后面的SSH远程入口解决的是另一件事:收到告警以后,人不在现场也能继续进入服务器处理。随机TCP先验证链路,固定TCP再解决长期入口的问题。
对于机器数量不多、监控需求比较明确的环境,这种方式不需要先搭一套很重的平台,就能把“异常发现—消息告警—远程处理”三个步骤接起来;以后需要扩展时,再继续增加日志文件和关键词即可。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 14
 0
- 0


 已为社区贡献20条内容

所有评论(0)