大模型之LangGraph多轮对话记忆
用 LangGraph 的 Reducer,轻松搞定多轮对话记忆
做聊天机器人最头疼的是什么?是记不住上文。今天分享一个 LangGraph 的小技巧:用 Reducer 机制优雅地管理对话历史。
核心只有一行代码:
messages: Annotated[Sequence[AnyMessage], operator.add]
这里的 operator.add 就是 Reducer(归约器)。它的妙处在于:节点函数只需返回新增的消息,LangGraph 会自动把旧历史和新消息拼接起来,不用手动维护完整列表,代码瞬间清爽。
另一个容易踩坑的点:图里定义的 END 只是本次流程的终点,不是程序终点。多轮对话要靠外层 while 循环驱动,每次 invoke 后用返回的 result 更新 state,再传回下一轮,历史就自然延续了。
最后附上一个小实践:调用模型时只取最近 6 条消息作为上下文,既保证连贯性,又控制了 token 成本。
Reducer + 截断窗口 + 外层循环,三件套齐活,一个专业级多轮对话系统就搭好了。
代码
# -*- coding: utf-8 -*-
"""
基于 LangGraph 构建的多轮对话系统示例
核心知识点:
1. 使用 Annotated + operator.add 作为 Reducer,实现消息历史的自动合并(累加)
2. 图的每次 invoke 是一次独立执行,END 只是本次流程的终点,外层 while 循环负责多轮对话
3. 通过不断用返回的 result 更新 state,实现跨轮次的消息历史保留
"""
from typing import TypedDict, Annotated, Sequence
from langchain_core.messages import HumanMessage, AIMessage, BaseMessage, SystemMessage, AnyMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, END
import operator
import os
from dotenv import load_dotenv
# 加载 .env 文件中的环境变量(如 API Key、Base URL)
load_dotenv()
# 初始化大语言模型客户端(兼容 OpenAI 接口协议,这里对接阿里云百炼的 deepseek-v3)
model = ChatOpenAI(
model_name="deepseek-v3",
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url=os.getenv("API_BASE_URL")
)
# ================== 类型定义 ==================
class ChatState(TypedDict):
"""
对话状态定义
Annotated[Sequence[AnyMessage], operator.add] 中的 operator.add 是 Reducer(归约器):
- 节点返回 {"messages": [新消息]} 时,LangGraph 不会覆盖旧消息,
而是自动执行 旧消息 + 新消息 的拼接,实现历史记录的累加
- 这就是为什么节点函数只需返回"增量"消息,而不用手动拼接完整历史
"""
messages: Annotated[Sequence[AnyMessage], operator.add]  # 自动合并消息的历史记录
# ================== 节点函数1 ==================
def handle_user_input(state: ChatState):
"""处理用户输入节点:从控制台读取用户输入,封装成 HumanMessage"""
try:
print(f"handle_user_input_node state:{state}")
user_input = input("\n用户输入(输入'退出'结束): ").strip()
# 用户输入'退出'时返回 END,提前终止本次图流程(跳过 ai_response 节点)
if user_input.lower() == "退出":
print("正在结束对话...")
return END
# 注意:借助 Reducer(operator.add),这里只需返回"新增"的消息即可,
# LangGraph 会自动将其与 state 中的历史消息合并。
# (若没有 Reducer,则需要手动写 state["messages"] + [HumanMessage(...)] 来覆盖整个列表)
return {"messages": [HumanMessage(content=user_input)]}
except KeyboardInterrupt:
# 用户按 Ctrl+C 中断时,同样优雅退出本次图流程
return END
# ================== 节点函数2 ==================
def generate_ai_response(state: ChatState):
"""生成AI响应节点:取最近几条消息作为上下文,调用模型生成回复"""
try:
print(f"generate_ai_response_node state:{state}")
# 只取最近 6 条消息作为上下文(截断窗口):
# 既保持对话连贯性,又控制 token 消耗、避免超出模型上下文长度
recent_history = state["messages"][-6:]
response = model.invoke(recent_history)  # 返回一个 AIMessage 对象
print("模型答复:",response)
# 返回"增量"消息,由 Reducer 自动追加到历史中
return {"messages": [response]}
except Exception as e:
# 调用失败(网络异常、鉴权失败等)时不中断程序,
# 而是生成一条兜底的错误提示消息,保证图流程能正常走完
error_msg = f"系统暂时无法响应,请稍后再试(错误代码:{str(e)[:30]})"
return {"messages": [AIMessage(content=error_msg)]}
# ================== 对话图构建 ==================
builder = StateGraph(ChatState)
# 节点注册:将节点函数挂载到图上,指定节点名称
builder.add_node("user_input", handle_user_input)
builder.add_node("ai_response", generate_ai_response)
# 流程设计:入口 -> 用户输入 -> AI响应 -> 结束
builder.set_entry_point("user_input")
builder.add_edge("user_input", "ai_response")
builder.add_edge("ai_response", END)
# 编译图:得到可执行(invoke / stream)的对话应用
conversation = builder.compile()
# ================== 运行逻辑 ==================
if __name__ == "__main__":
# 系统提示词:对话历史中的第一条消息,为模型设定角色
system_prompt = f""" 你是一个专业级中文智能助手!"""
# 初始状态只包含系统消息,后续历史由 Reducer 自动累加
state = ChatState(messages=[SystemMessage(content=system_prompt)])
print("===== 智能对话系统已启动 =====")
print("输入'退出'可随时结束对话\n")
"""
关键机制说明:
1、每次调用 conversation.invoke(state) 都是一次独立的调用,
虽然图流程定义了 END,但图本身不会阻止下一次调用。
2、状态 state 会持续更新:每次执行完 conversation.invoke(state) 后,
返回的 result 会更新 state,从而保留了对话历史。
当下次调用 invoke 时,传入的是更新后的 state,因此对话可以继续。
3、END 只是图流程的结束点,不是程序的终止点:
END 只是告诉 LangGraph 当前流程已结束,但并不会终止外部的 while 循环。
"""
# 外层 while 循环负责"多轮对话":每轮执行一次完整的图流程
while True:
try:
# 执行一次图流程(user_input -> ai_response),invoke 返回执行后的完整状态
result = conversation.invoke(state)
print("图执行一次后:",result)
# 异常防御:返回结果为空或缺少 messages 字段时退出循环
if result is None or "messages" not in result:
break
# 提取本轮新增的消息:
# 由于 Reducer 是"追加"语义,result 中前面部分就是调用前的旧历史,
# 从旧历史长度开始的切片即为本次流程新产生的消息(HumanMessage + AIMessage)
new_messages = result["messages"][len(state["messages"]):]
# 打印本轮 AI 响应(跳过用户新输入的 HumanMessage)
for msg in new_messages:
if isinstance(msg, AIMessage):
print(f"\n【AI响应】\n{msg.content}\n")
# 更新对话状态:用包含完整历史的 result 替换旧 state,
# 下一轮循环将其传回 invoke,实现跨轮次的历史延续
state = result
# 检查退出条件:历史中出现内容为'退出'的用户消息时结束循环
# (正常情况下输入'退出'时节点会直接返回 END 不会进入 ai_response,
#   这里是双保险)
if any(isinstance(m, HumanMessage) and m.content.lower() == "退出" for m in state["messages"]):
break
except Exception as e:
# 捕获图执行过程中的其他异常,打印后退出,避免程序崩溃
print(f"\n系统异常:{str(e)}")
break
# ===== 对话结束后的收尾:打印完整对话记录 =====
print("\n===== 对话已结束 =====")
print("\n【完整对话记录】")
# state["messages"][1:] 跳过第一条系统提示,只展示用户与 AI 的往来消息
for i, msg in enumerate(state["messages"][1:]):
prefix = "用户:" if isinstance(msg, HumanMessage) else "AI:"
print(f"{i + 1}. {prefix}{msg.content}")
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
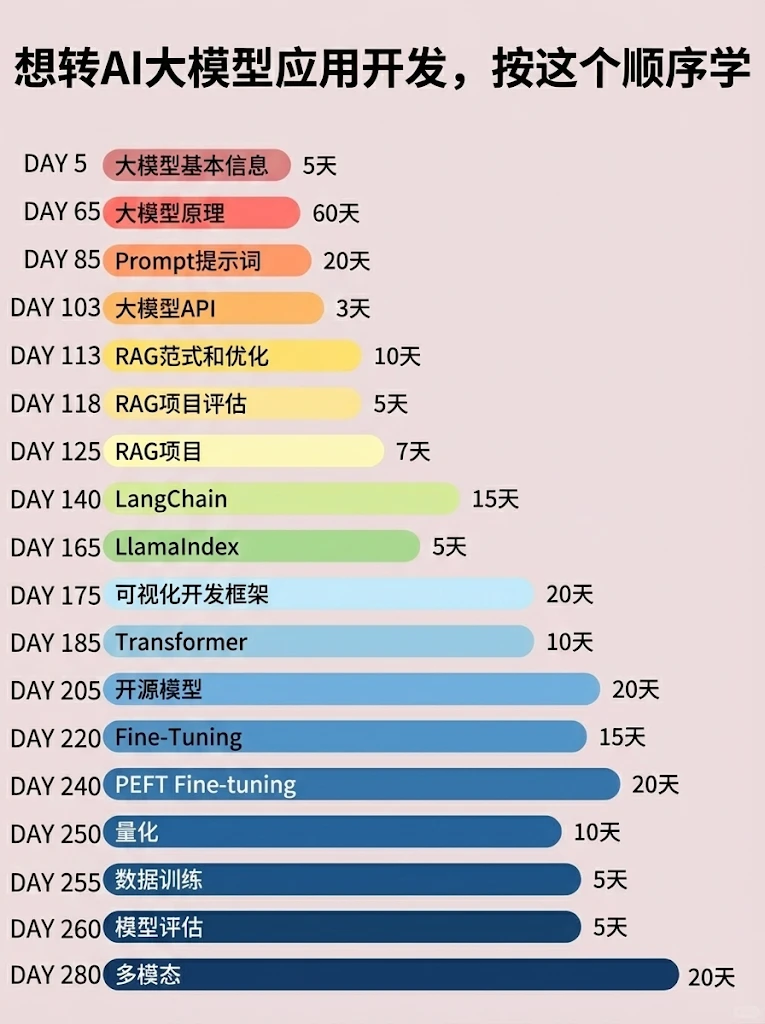
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献99条内容

所有评论(0)