VLA 系统学习第 20 课——Diffusion Policy 为什么要先给动作加噪,再学习把噪声去掉?
原论文:Diffusion Policy: Visuomotor Policy Learning via Action Diffusion;官方实现:real-stanford/diffusion_policy。论文提出将机器人动作策略建模为条件去噪扩散过程,并结合视觉条件与滚动时域控制。
前面 ACT 已经让我们理解:
\[ Observation\rightarrow Action\ Chunk \]
而 Diffusion Policy 仍然希望输出一段 Action Chunk。
它改变的不是“最终要输出什么”,而是“动作序列怎样生成”。
一、从一个具体问题开始:为什么要把好好的专家动作变成噪声?
假设机器人前面放着一个障碍物。
人类示范了两种合理轨迹:
普通确定性 BC 可能因为平均化,难以同时表达这两种模式。
ACT 使用 CVAE 潜变量来学习示范变化。
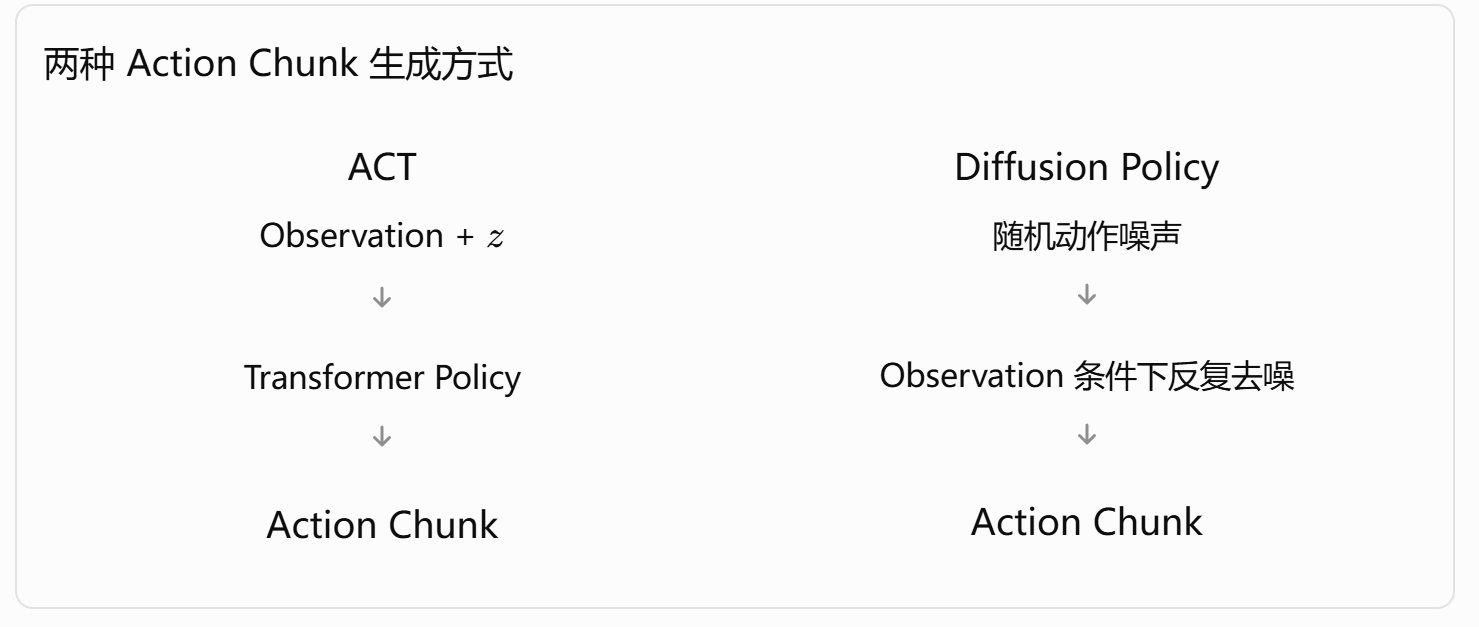
Diffusion Policy 则采用另一种思路:
不直接要求网络一次给出最终动作,而是让网络反复修正一段带噪声的候选动作,逐渐生成符合当前 Observation 条件的动作序列。
可以把它想象成雕塑。
ACT 更像依据 Observation,直接制作一段动作。
Diffusion Policy 更像先拿到一团毫无规则的材料,然后经过多轮加工,逐渐形成合理的动作轨迹。
但要强调,比喻中的“加工”在数学上是一个经过训练的、由噪声调度控制的逐步去噪过程,不是简单地反复把数值缩小。
这里有一个特别需要理解的区别:
Diffusion Policy 并不是说训练数据里本来就有噪声,或者真实机器人必须先执行随机动作。
训练时,我们人为给专家动作加噪;推理时,我们在计算机内部从随机数开始生成动作。真正发送给机器人的是去噪完成后的 Action,而不是中间的随机噪声。
二、第一件事:训练时,我们怎样给真实 Action 加噪?
现在用两个数字讲清楚。
假设一个专家 Action 是:
\[ A^{(0)}=[1,0] \]
为了避免与机器人实际时间 \(t\) 混淆,本课使用:
\[ s \]
表示 Diffusion Step(扩散步)。
这与真实机器人的控制时间不是一回事。
我们人为生成一组噪声:
\[ \epsilon=[0,1] \]
然后按照某个噪声强度,将动作与噪声混合。
例如:
\[ A^{(s)} = 0.8A^{(0)} + 0.6\epsilon \]
得到:
\[ A^{(s)} = 0.8[1,0]+0.6[0,1] \]
因此:
\[ \boxed{A^{(s)}=[0.8,0.6]} \]
原来干净的动作是:
\[ [1,0] \]
现在变成:
\[ [0.8,0.6] \]
这就是一个简单的加噪示例。
1. 正式公式是什么?
在常见 DDPM 形式的扩散模型中:
\[ \boxed{ A^{(s)} = \sqrt{\bar\alpha_s}\,A^{(0)} + \sqrt{1-\bar\alpha_s}\,\epsilon } \]
其中:
-
\(A^{(0)}\):真实专家 Action Chunk;
-
\(A^{(s)}\):加入第 \(s\) 级噪声后的 Action Chunk;
-
\(\epsilon\sim\mathcal N(0,I)\):随机高斯噪声;
-
\(\bar\alpha_s\):决定当前保留多少原始信号的系数。
如果:
\[ \bar\alpha_s=0.64 \]
那么:
\[ \sqrt{\bar\alpha_s}=0.8 \]
\[ \sqrt{1-\bar\alpha_s}=0.6 \]
恰好就得到刚才的数字例子。
当 \(\bar\alpha_s\) 接近 1 时,动作比较干净。
当 \(\bar\alpha_s\) 接近 0 时,原始动作信息很少,剩下的主要是噪声。
2. 代码里长什么样?
import torchclean_action = torch.tensor([ [1.0, 0.0]])noise = torch.tensor([ [0.0, 1.0]])alpha_bar = 0.64noisy_action = ( alpha_bar ** 0.5 * clean_action + (1 - alpha_bar) ** 0.5 * noise)print(noisy_action)输出:
tensor([[0.8000, 0.6000]])这段代码没有使用任何神经网络。
它只完成了一个确定的数学操作:
\[ Clean\ Action+\text{Random Noise} \rightarrow Noisy\ Action \]
因此你现在应该发现:
扩散模型的“加噪”本身不需要训练。真正需要训练的是如何利用带噪动作、噪声等级和 Observation,预测应该如何去噪。
三、模型究竟要学习什么?为什么预测噪声也能学会生成动作?
现在我们已经有三个东西:
\[ A^{(0)} \]
真实专家动作。
\[ \epsilon \]
人为生成的噪声。
\[ A^{(s)} \]
加噪后的动作。
我们可以训练一个神经网络:
\[ \boxed{ \hat\epsilon = \epsilon_\theta(A^{(s)},s,o) } \]
也就是让网络接收:
-
带噪动作 \(A^{(s)}\);
-
当前噪声步数 \(s\);
-
机器人 Observation \(o\)。
然后输出:
\[ \hat\epsilon \]
即模型认为混入了什么噪声。
由于训练时噪声是我们自己生成的,因此正确答案:
\[ \epsilon \]
是已知的。
于是可以使用熟悉的 MSE:
\[ \boxed{ L_{\mathrm{noise}} = \mathbb E \left[ \|\epsilon-\epsilon_\theta(A^{(s)},s,o)\|^2 \right] } \]
这就是一种常见的 Noise Prediction 训练目标。
需要注意,Diffusion Policy 的不同实现还可能采用直接预测干净样本等参数化方式。作者官方 U-Net Policy 就根据 Scheduler 的 prediction_type,选择以噪声 epsilon 或干净 sample 作为训练目标。
我们先采用 Noise Prediction,因为最容易建立直觉。
为什么预测噪声可以帮助恢复 Action?
从加噪公式出发:
\[ A^{(s)} = \sqrt{\bar\alpha_s}A^{(0)} + \sqrt{1-\bar\alpha_s}\epsilon \]
如果模型准确预测出:
\[ \hat\epsilon \]
我们就可以反过来估计原始动作:
\[ \boxed{ \hat A^{(0)} = \frac{ A^{(s)} - \sqrt{1-\bar\alpha_s}\hat\epsilon }{ \sqrt{\bar\alpha_s} } } \]
这只是普通的代数移项。
比如刚才:
\[ A^{(s)}=[0.8,0.6] \]
\[ \hat\epsilon=[0,1] \]
\[ \sqrt{\bar\alpha_s}=0.8 \]
\[ \sqrt{1-\bar\alpha_s}=0.6 \]
那么:
\[ \hat A^{(0)} = \frac{ [0.8,0.6]-0.6[0,1] }{0.8} \]
得到:
\[ \boxed{\hat A^{(0)}=[1,0]} \]
我们就把原始动作恢复出来了。
当然,实际网络预测的噪声可能存在误差;而真正的扩散采样通常会按照 Scheduler 分多步逐渐更新,不是仅靠这一次公式就完成全部采样。
四、把单个动作扩展成整个 Action Chunk
现在回到机器人任务。
假设:
\[ B=2,\quad K=4,\quad D_a=2 \]
那么真实专家 Action Chunk:
\[ A^{(0)}:[2,4,2] \]
表示:
-
2 个训练样本;
-
每个样本有 4 个未来 Action;
-
每个 Action 是 2 维。
假设 Observation:
\[ o:[2,3] \]
现在噪声也必须和 Action Chunk 一样大:
\[ \epsilon:[2,4,2] \]
加噪之后:
\[ A^{(s)}:[2,4,2] \]
我们希望网络输出:
\[ \hat\epsilon:[2,4,2] \]
这就意味着:
网络不是仅仅给一个动作去噪,而是给整段未来动作序列预测噪声。
这与我们学习 ACT 时的 Action Chunk Shape 完全衔接。
1. 为什么每个样本还需要一个 Diffusion Step?
因为训练时会随机选择不同的加噪强度。
例如:
\[ s=[10,75] \]
表示同一个 Batch 中:
-
第一个样本使用第 10 级噪声;
-
第二个样本使用第 75 级噪声。
所以:
\[ s:[B] \]
这里扩散步数并不是专家示范轨迹中的真实时间位置。
一个 Sample 可以来自机器人时刻 \(t=50\),但被随机加到扩散步 \(s=75\)。两者是两套完全不同的时间坐标。
2. 如何在 PyTorch 中完成整个 Batch 加噪?
下面是一段可以独立运行的教学代码。
import torchtorch.manual_seed(42)B = 2K = 4Da = 2num_diffusion_steps = 100# 教学示例中的干净Action Chunkactions = torch.randn(B, K, Da)# 定义噪声强度调度表betas = torch.linspace( 0.0001, 0.10, num_diffusion_steps)alphas = 1.0 - betasalpha_bars = torch.cumprod( alphas, dim=0)# 每个样本随机选择一个扩散步steps = torch.randint( 0, num_diffusion_steps, (B,))# 生成与Action同Shape的噪声noise = torch.randn_like(actions)# 根据每个样本的扩散步取系数alpha_bar = alpha_bars[steps].view(B, 1, 1)# 对整段Action Chunk加噪noisy_actions = ( torch.sqrt(alpha_bar) * actions + torch.sqrt(1 - alpha_bar) * noise)print("actions:", actions.shape)print("steps:", steps.shape)print("noise:", noise.shape)print("noisy_actions:", noisy_actions.shape)输出 Shape:
actions: torch.Size([2, 4, 2])
steps: torch.Size([2])
noise: torch.Size([2, 4, 2])
noisy_actions: torch.Size([2, 4, 2])
这里最需要理解的是:
alpha_bars = torch.cumprod(alphas, dim=0)cumprod 是累计连乘。
如果:
\[ \alpha_0=0.9,\quad \alpha_1=0.8,\quad \alpha_2=0.7 \]
那么:
\[ \bar\alpha_0=0.9 \]
\[ \bar\alpha_1=0.9\times0.8=0.72 \]
\[ \bar\alpha_2=0.9\times0.8\times0.7=0.504 \]
这些累计系数控制不同扩散步下的信号和噪声比例。
而:
alpha_bars[steps].view(B, 1, 1)将每个样本自己的噪声系数整理成:
\[ [B,1,1] \]
通过 Broadcasting,自动作用到:
\[ [B,K,D_a] \]
中的全部动作元素。
这也是为什么我们之前反复强调:Shape 不只是要打印出来,而是要真正理解每一维的用途。
五、训练一个最小 Noise Predictor:Observation 到底在哪里发挥作用?
现在我们已经准备好带噪动作了。
接下来需要一个小网络:
\[ \hat\epsilon = \epsilon_\theta(A^{(s)},s,o) \]
为了先理解训练机制,我们用一个 MLP 代替真实 Diffusion Policy 的 U-Net 或 Transformer。
这里的网络不是为了取得好的机器人效果,而是为了看懂如何把三类输入连接起来,并完成一次梯度更新。
import torch.nn as nnimport torch.nn.functional as Fclass TinyNoisePredictor(nn.Module): def __init__(self): super().__init__() # Action Chunk: 4*2 = 8 # Observation: 3 # Diffusion Step: 1 self.net = nn.Sequential( nn.Linear(8 + 3 + 1, 64), nn.ReLU(), nn.Linear(64, 8) ) def forward(self, noisy_actions, obs, steps): B = noisy_actions.shape[0] # [B,4,2] -> [B,8] action_features = noisy_actions.reshape(B, -1) # [B] -> [B,1],数值缩放到约[0,1] step_features = ( steps.float().view(B, 1) / 99.0 ) # [B,8] + [B,3] + [B,1] # -> [B,12] x = torch.cat( [action_features, obs, step_features], dim=-1 ) # [B,12] -> [B,8] pred_noise = self.net(x) # [B,8] -> [B,4,2] return pred_noise.reshape(B, 4, 2)model = TinyNoisePredictor()optimizer = torch.optim.Adam( model.parameters(), lr=1e-3)obs = torch.randn(B, 3)# 前面已经生成:# noisy_actions [B,4,2]# noise [B,4,2]# steps [B]optimizer.zero_grad()pred_noise = model( noisy_actions, obs, steps)loss = F.mse_loss(pred_noise, noise)loss.backward()optimizer.step()print("Predicted noise:", pred_noise.shape)print("Loss:", loss.item())这里最值得注意的是,我们的训练监督目标不再是直接预测专家动作:
loss = F.mse_loss(pred_actions, expert_actions)而是:
loss = F.mse_loss(pred_noise, noise)因为模型的任务已经发生变化。
| 项目 | 普通 Action 回归 | Noise Prediction Diffusion |
|---|---|---|
| 输入 | Observation | 带噪 Action、Observation、扩散步 |
| 模型输出 | Action | 预测噪声 |
| 训练 Target | Expert Action | 人为加入的真实噪声 |
| 常见 Loss | L1 / MSE | Noise MSE |
| 推理 | 一次 Forward 输出动作 | 多次去噪得到动作 |
观察这里的 obs:
x = torch.cat( [action_features, obs, step_features], dim=-1)它让去噪网络知道:
我当前面对的是怎样的机器人观察条件?
如果没有 Observation,网络只能尝试学习无条件的动作序列分布。
而加入 Observation 后,我们希望它学会:
同样是一段随机动作噪声,在不同的视觉和机器人状态下,应该朝着不同的合理动作分布进行去噪。
这就是 Conditional Diffusion(条件扩散) 的核心。
教学代码采用直接拼接;真实 Diffusion Policy 的视觉条件往往先经过特征编码,并根据架构以其他方式注入去噪网络。
六、最关键的区别:训练时加噪一次,推理时为什么要反复去噪?
前面我们已经实现了训练:
\[ A^{(0)} \rightarrow A^{(s)} \rightarrow \hat\epsilon \rightarrow Loss \]
这里有一个初学者很容易误解的地方。
训练时不需要每个 Batch 都从扩散步 0 一直加噪到最后一步,再逐步去噪回来。
在常见 Noise Prediction 训练方式中,我们可以直接随机选择一个扩散步 \(s\),利用公式一步构造出该等级的带噪样本,训练网络预测噪声。
而推理时情况不同。
推理时,我们根本没有真实 Action:
\[ A^{(0)} \]
所以不能从专家动作加噪开始。
我们只能先创建一段随机噪声:
\[ A^{(S)}\sim\mathcal N(0,I) \]
然后不断调用已经训练好的网络:
\[ A^{(S)} \rightarrow A^{(S-1)} \rightarrow \cdots \rightarrow A^{(1)} \rightarrow \hat A^{(0)} \]
可以把它理解成:训练阶段,我们给老师一张被人为弄脏的正确答案,让他学会辨认噪声;推理阶段,我们只有一张几乎全部是噪声的纸,需要老师连续修正多轮。
当然,实际扩散采样并不是简单擦掉噪声,还需要 Scheduler 根据扩散步计算正确的更新幅度,有些采样器还会加入随机项。
代码中真实的去噪循环是什么样的?
作者官方仓库的 diffusion_unet_lowdim_policy.py 中,conditional_sample() 会:
-
创建随机轨迹 Tensor;
-
设置采样步;
-
在每个采样步调用模型;
-
利用 Scheduler 将当前轨迹更新到下一步;
-
最后返回生成的轨迹。
其核心结构可以简化成:
trajectory = torch.randn( B, K, Da)for s in scheduler.timesteps: pred_noise = model( trajectory, s, observation ) trajectory = scheduler.step( pred_noise, s, trajectory ).prev_sample这是解释官方计算逻辑的伪代码;Scheduler 对象的初始化、模型接口和观测编码需要匹配具体实现,并非独立可运行的完整程序。
真正理解这段代码以后,你会发现 Diffusion Policy 多出来的计算代价在哪里:
ACT 可以一次 Policy Forward 直接生成一个 Action Chunk;Diffusion Policy 通常需要调用多次去噪网络,逐步构造出最终 Action Chunk。
这是两种方法很重要的工程差异。
一个数字例子:模型怎样从加噪动作估计干净动作?
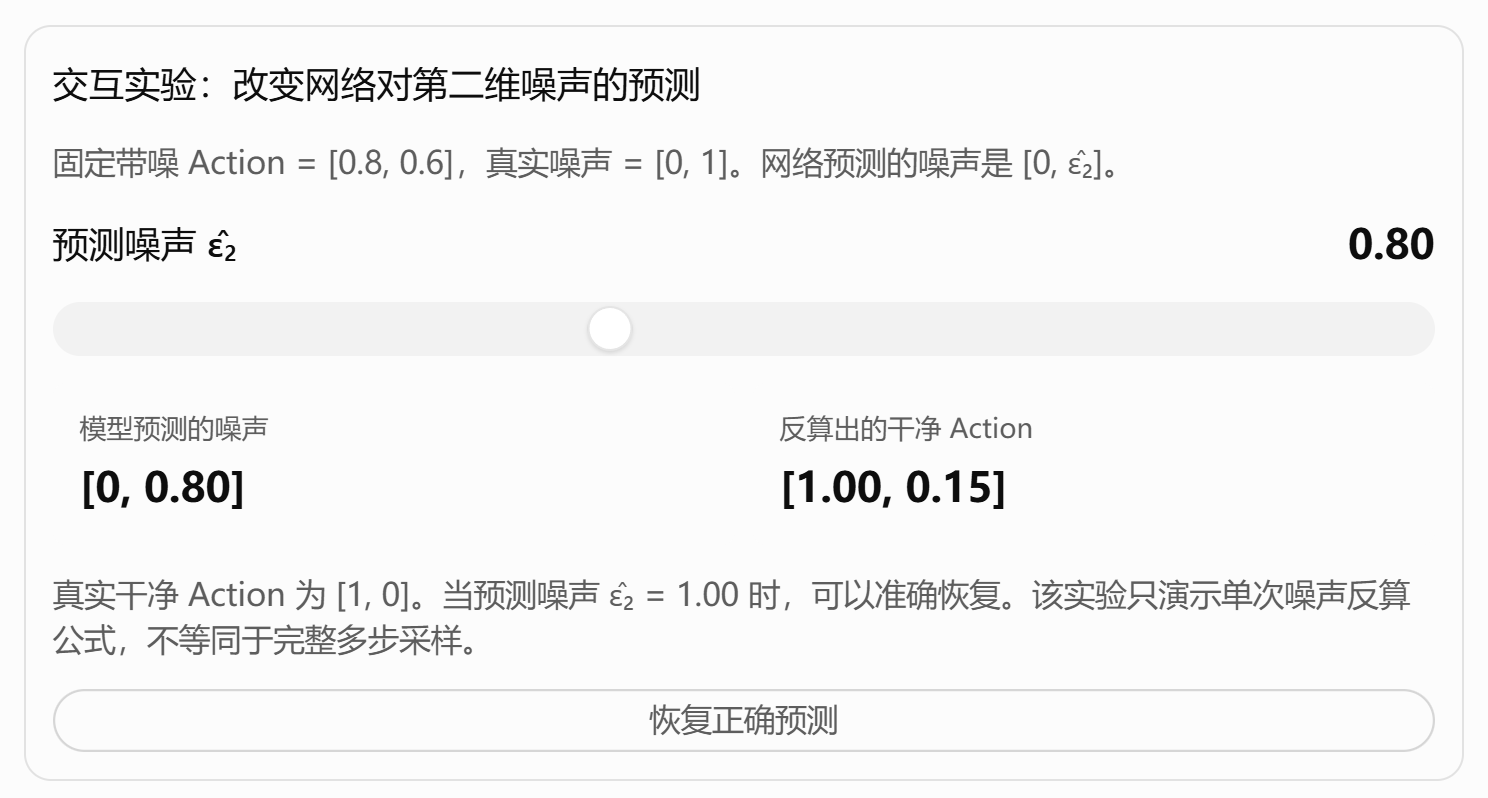
这段计算最重要的启示是:
\[ \boxed{ 去噪预测是否准确 \rightarrow 直接影响最终恢复出的动作 } \]
而模型为什么能学会预测噪声?因为训练阶段我们人为生成过大量不同强度的带噪动作,并且知道各自加入的真实噪声。
七、Diffusion Policy 为什么适合多模态动作分布?又要付出什么代价?
现在回到课程开头的左右绕行问题。
对于相同的 Observation:
\[ o \]
合理的动作可能不止一个:
\[ A^{(1)},A^{(2)},\ldots \]
我们希望学习的是:
\[ p(A\mid o) \]
也就是:
在给定 Observation 条件下,不同 Action Sequence 的概率分布。
Diffusion Policy 从不同的随机初始噪声出发,经过训练好的条件去噪过程,能够产生不同的候选 Action Sequence。
这为表达多峰动作分布提供了灵活的生成机制,但不意味着随便训练一个扩散模型,就一定能稳定生成所有合理模式,也不意味着生成的每条动作都安全。
相较 ACT,它还有明显的工程取舍。
| 维度 | ACT | Diffusion Policy |
|---|---|---|
| 动作生成 | 一次预测 Action Chunk | 多步去噪生成 Action Chunk |
| 核心生成机制 | CVAE 潜变量 + Transformer | 条件扩散过程 |
| 训练目标 | 动作重建 + KL 正则 | 常见为噪声预测 MSE,也有其他参数化 |
| 推理计算 | 通常较少的模型调用 | 多次去噪模型调用 |
| 多模态表示 | 通过潜变量学习变化因素 | 通过条件生成分布建模 |
| 执行控制 | 可使用 Temporal Ensembling | 常与 Receding Horizon 配合 |
两者不是“新模型一定全面替代旧模型”的关系。
模型效果还受到数据规模、计算资源、动作表示、控制频率、任务难度和部署限制等因素影响。
官方 Diffusion Policy 代码明确区分了三个 Horizon:Observation Horizon、Prediction Horizon 和 Action Horizon,并提供 U-Net 与 Transformer 风格的扩散策略实现。
这恰好和第 12 课接起来:
\[ T_o=\text{看过去多少Observation} \]
\[ T_p=\text{预测多长Action Sequence} \]
\[ T_a=\text{真正执行多少步后重新预测} \]
我们下一阶段就要把扩散模型的噪声时间 \(s\),与机器人动作时间 \(t\)、Action Horizon 严格区分,避免把几套时间维度混在一起。
第 20 课知识链回看
到这里,我们已经从 ACT 自然走进 Diffusion Policy。
ACT:
\[ o_t,z \rightarrow \pi_\theta \rightarrow \hat A_t \]
Diffusion Policy 的常见 Noise Prediction 训练:
\[ \boxed{ A^{(0)} \xrightarrow{\text{Add Noise}} A^{(s)} \xrightarrow{\epsilon_\theta(A^{(s)},s,o)} \hat\epsilon \xrightarrow{\text{MSE}} L } \]
推理时:
\[ \boxed{ \text{Random Noise} \rightarrow \text{Repeated Conditional Denoising} \rightarrow \text{Action Chunk} \rightarrow \text{Execution} } \]
尤其要记住以下三个区别:
第一,机器人真实时间 \(t\) 不等于扩散步 \(s\)。 一个 Action Chunk 表示真实未来动作;扩散步只是生成这段动作时,内部去噪过程的索引。
第二,训练时目标噪声是我们自己生成的,因此有监督信号。 不需要依赖额外人工标注噪声。
第三,真正执行的是去噪完成的动作,而不是某一次去噪网络直接输出的 Noise Tensor。
第 20 课自测
1. ACT 和 Diffusion Policy 都可以输出 Action Chunk,它们的主要区别发生在输入模态、动作表示,还是动作生成方式?
2. 为什么扩散训练要人为给专家 Action 加噪?模型真正要学习的是什么?
3. 对:
\[ A^{(0)}=[1,0],\quad \epsilon=[0,1],\quad\bar\alpha_s=0.64 \]
求 \(A^{(s)}\)。
4. 为什么 Diffusion Step \(s\) 不能直接理解成机器人正在执行的时间 \(t\)?
5. 如果:
\[ B=16,\quad K=10,\quad D_a=7 \]
干净 Action、随机噪声、带噪 Action 和预测噪声的 Shape 分别是什么?
6. torch.randn_like(actions) 在扩散训练中是什么作用?
7. torch.cumprod(alphas, dim=0) 为什么能生成累计保留信号的系数?
8. 为什么 Noise Predictor 除了接收带噪 Action,还要接收 Observation 和 Diffusion Step?
9. 训练时为什么可以随机选择某个扩散步直接构造带噪样本,而推理时却通常需要多次去噪?
10. Diffusion Policy 的 Noise Prediction Loss 与 ACT 的 Reconstruction Loss,在监督目标上有什么区别?
11. 如果模型能完美预测:
\[ \hat\epsilon=\epsilon \]
怎样根据带噪动作反算干净动作?
12. 为什么 Diffusion Policy 的多步采样有利于表达复杂动作分布,但同时也带来了推理速度方面的压力?

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 2
 0
- 0


 已为社区贡献29条内容

所有评论(0)