VLA 系统学习第 18 课:ACT 完整架构与官方代码调用链——从 RGB 图像到 Action Chunk,再到 Temporal Ensembling
第十七课标准答案
上一课我们正式进入 ACT,学习了 Action Chunking、CVAE、Latent Variable、Reparameterization Trick、KL Loss,以及训练和推理为什么采用不同的数据流。
这一课的 10 道题全部围绕同一个问题:
ACT 为什么不能只做普通的 Action 回归,而要增加一个学习动作序列潜在表示的分支?
1. 为什么相同 Observation 对应多条合理轨迹时,MSE 可能出现平均化?
假设同一个观察状态下,专家有两种合理动作:
\[ a^{(1)}=-1,\qquad a^{(2)}=+1 \]
而普通确定性 BC 只能预测一个数值 \(\hat a\)。
它的 MSE 为:
\[ L=\frac12[(\hat a+1)^2+(\hat a-1)^2] \]
展开:
\[ L=\hat a^2+1 \]
最小值出现在:
\[ \boxed{\hat a=0} \]
但 0 可能既不属于第一种合理动作,也不属于第二种。
对于整段 Action Chunk,这种逐点平均还有可能形成一条不连贯的轨迹。
因此,普通 MSE 回归面对多种合理动作模式时,可能无法忠实表达这些不同模式。
这是一种可能出现的现象,不代表所有 BC 模型都必然失败。
2. ACT 中的 \(z\) 是机器人真实状态吗?
不是。
\[ z \]
是模型内部的 Latent Variable(潜变量),用于帮助模型表达示范动作序列中的变化因素。
例如:
\[ z:[B,D_z] \]
它不直接表示关节角、关节速度、末端位置或电机控制命令。
我们可以将其理解为对动作执行方式的一种潜在编码,但不能直接规定某个维度就表示“向左”或者“向右”。
3. 如果 \(D_z=32\),为什么 latent_proj 输出 64 维?
因为 CVAE Encoder 需要同时预测:
\[ \mu:[B,32] \]
和:
\[ logvar:[B,32] \]
两者合计:
\[ 32+32=64 \]
因此:
latent_proj = nn.Linear(hidden_dim, 64)随后可以将输出沿最后一维拆分:
latent_info = latent_proj(features)mu, logvar = torch.chunk( latent_info, 2, dim=-1)得到两组 32 维参数。
4. \(\mu\)、\(\sigma\)、logvar 分别是什么?
对于高斯分布:
\[ q_\phi(z\mid q,A)= \mathcal N(\mu,\operatorname{diag}(\sigma^2)) \]
其中:
-
\(\mu\):均值,控制分布的中心。
-
\(\sigma\):标准差,描述随机变量的离散程度。
-
logvar:方差的自然对数,即 \(\log(\sigma^2)\)。
因为:
\[ logvar=\log(\sigma^2) \]
所以:
\[ \frac{logvar}{2}=\log\sigma \]
两边取指数:
\[ \boxed{\sigma=\exp(0.5\,logvar)} \]
对应代码:
std = torch.exp(0.5 * logvar)5. 为什么使用 Reparameterization Trick?
我们希望从:
\[ \mathcal N(\mu,\sigma^2) \]
中采样,又希望重建损失的梯度可以传回生成 \(\mu,\sigma\) 的 Encoder。
因此写成:
\[ \boxed{z=\mu+\sigma\odot\epsilon} \]
其中:
\[ \epsilon\sim\mathcal N(0,I) \]
代码:
eps = torch.randn_like(std)z = mu + std * eps这里随机性由 \(\epsilon\) 提供,而 \(\mu\)、\(\sigma\) 到 \(z\) 的计算仍然是可微运算。
因此模型可以通过 Backward 学习潜变量分布参数。
6. Reconstruction Loss 和 KL Loss 分别有什么作用?
Reconstruction Loss 负责:
让预测的 Action Chunk 接近专家 Action Chunk。
例如:
\[ L_{\mathrm{recon}}=L_1(\hat A,A) \]
KL Loss 负责:
约束 Encoder 学到的潜变量分布,使它不要任意偏离预设的先验分布。
原始 ACT 使用标准正态先验:
\[ p(z)=\mathcal N(0,I) \]
因此总目标为:
\[ \boxed{ L=L_{\mathrm{recon}}+\beta L_{\mathrm{KL}} } \]
其中 \(\beta\) 控制两项损失之间的权重。
7. 为什么训练时 CVAE Encoder 可以读取专家 Action Chunk,推理时不能?
因为训练时我们已经拥有 Demonstration Dataset,其中包括未来专家动作:
\[ A_t=[a_t,\ldots,a_{t+K-1}] \]
所以可以用:
\[ (q_t,A_t) \]
产生潜变量分布。
但真正部署时,未来的专家 Action 并不存在,恰恰是模型自己要预测未来动作。
因此:
\[ \boxed{\text{推理阶段不能依赖未来专家Action}} \]
CVAE Encoder 主要用于训练阶段的潜变量学习。
8. 原始 ACT 推理时 \(z\) 设置为多少?是否随机选择动作风格?
原始 ACT 推理时使用:
\[ \boxed{z=0} \]
即标准正态先验的均值。
因此,原始 ACT 并不是在每次推理时随机采样一个 \(z\),以随机选择不同动作风格。
它利用 CVAE 机制训练潜变量表示,但原始推理采用确定的潜变量输入。
9. ACT 为什么有两种不同意义上的 Encoder?
因为它们负责处理不同的信息。
CVAE Encoder 在训练时读取专家 Action Sequence 和当前关节状态,生成:
\[ \mu,\quad logvar \]
进而采样:
\[ z \]
Policy Transformer Encoder 则负责对 Observation 相关特征进行上下文编码,为后续预测 Action Chunk 提供条件信息。
它们虽然都叫 Encoder,但输入、目的和训练/推理参与方式不同。
不能把两个 Encoder 当成同一个模块。
10. 三种 Tensor 的 Shape 分别是什么?
已知:
\[ B=32,\quad K=8,\quad D_a=7,\quad D_z=4 \]
专家 Action Chunk:
\[ \boxed{A:[32,8,7]} \]
潜变量:
\[ \boxed{z:[32,4]} \]
预测 Action Chunk:
\[ \boxed{\hat A:[32,8,7]} \]
注意,\(z\) 没有 8 个时间位置,它是本次动作块预测使用的一个潜在向量;而最终预测需要覆盖未来 8 个 Action Position。
到这里,我们已经完成了 ACT 的两个核心理论部分:
\[ \boxed{ \text{Action Chunking} + \text{CVAE} } \]
现在进入第 18 课。接下来不再单独讲一种数学组件,而是把这些组件装进真实 ACT 架构,并且逐层对应官方代码。
VLA 系统学习第 18 课:ACT 完整架构与官方代码调用链——从 RGB 图像到 Action Chunk,再到 Temporal Ensembling
本课依据作者官方仓库 tonyzhaozh/act 的实际代码组织。重点核对 imitate_episodes.py、utils.py、policy.py、detr/models/detr_vae.py 和 detr/models/transformer.py。
前几课我们分别解决了三件事情:为什么需要 Action Chunk、Transformer 怎样利用 Query 读取信息,以及 CVAE 怎样从专家示范中学习潜变量。
现在要回答更工程化的问题:
一张 RGB 图像和一个机器人状态,究竟怎样经过 ACT,最终变成可以执行的一段动作?
另外,我们之前使用了 [B,8,7] 等教学 Shape。本课开始接触真实代码,因此必须将“教学示例”与“作者实现”分开,不能把两者混为一谈。
一、先建立完整架构:ACT 实际上有两条训练分支
ACT 原始方法有一个很值得注意的特点:
训练时,CVAE Encoder 和用于预测动作的 Transformer Policy 同时参与;推理时,只保留后者需要的计算路径。
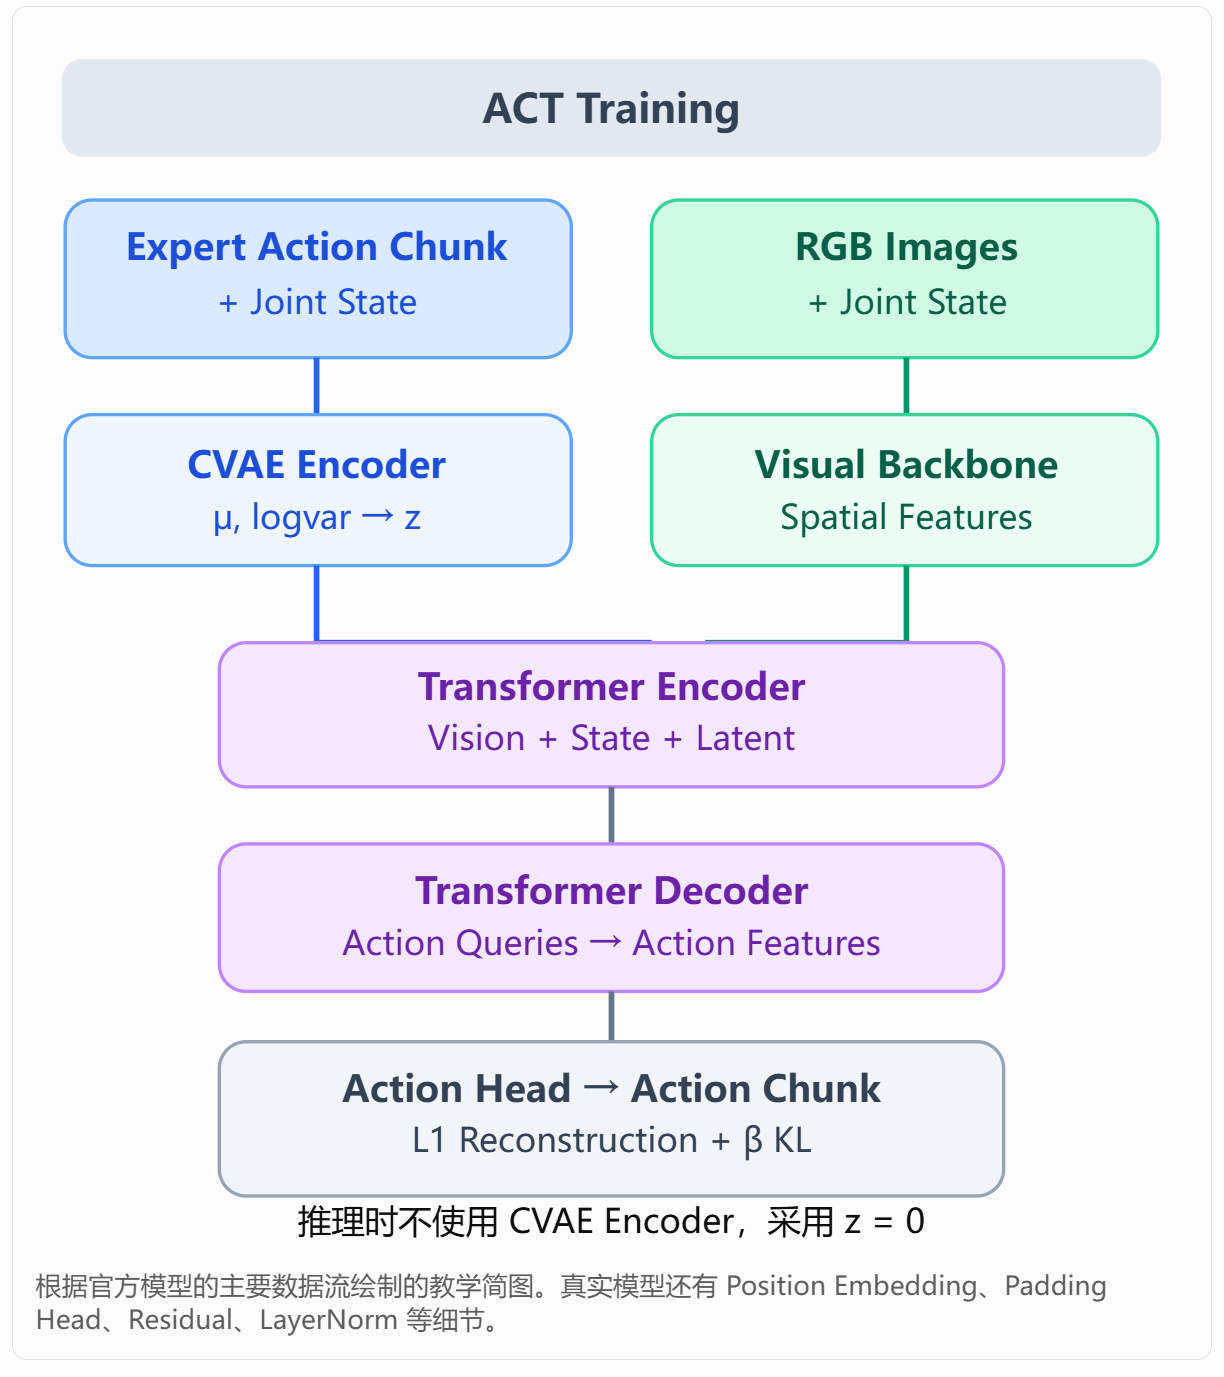
这里有一个需要纠正的常见误解:原始 ACT 并不是把图像和关节状态全部直接拼成一个普通的一维向量,然后交给 MLP。
作者使用视觉 Backbone 提取空间特征,再通过 Transformer 进行信息处理。原始 ACT 也不是一个带语言理解模块的完整 VLA;它主要是视觉和机器人本体状态条件下的模仿学习方法
下面按照真正的执行顺序,追踪 Tensor 的变化。
二、从 Dataset 开始:一个 ACT Sample 实际长什么样?
作者仓库中,数据读取入口位于:
里面有我们之前学过的:
class EpisodicDataset(torch.utils.data.Dataset):核心方法:
def __getitem__(self, index):会读取一个 HDF5 Episode,并从中选择当前时间点。
官方代码的关键逻辑可以简化为:
start_ts = np.random.choice(episode_len)qpos = root["/observations/qpos"][start_ts]image = root[ f"/observations/images/{cam_name}"][start_ts]action = root["/action"][start_ts:]这里的 start_ts 就是随机选出的当前时间位置。
因此一个训练样本的直觉是:
\[ \boxed{ \text{当前Observation} + \text{从当前开始的未来Action Sequence} } \]
请注意,它不是把一个 Episode 的所有图像一次性送进模型。
原始仓库这条数据路径使用当前时刻的多相机图像和当前关节状态,而监督目标是一段未来动作。 对真实数据,代码还存在一个 start_ts - 1 的动作对齐处理。
为了与官方实现对应,下面采用:
\[ B=2,\quad N=3,\quad D_s=D_a=14,\quad K=8,\quad D=64 \]
这里的 \(N=3,K=8,D=64\) 是教学取值;原始代码的关节及动作维度使用 14,而官方 README 示例命令的 chunk_size 是 100、hidden_dim 是 512。
那么 Batch 中可能有:
| Tensor | 教学 Shape | 含义 |
|---|---|---|
|
|
| 2 个样本、3 台相机、RGB |
|
|
| 当前关节状态 |
|
|
| 未来 8 个专家 Action |
|
|
| 哪些 Action 是 Padding |
最后,训练入口调用:
image_data, qpos_data, action_data, is_pad = datareturn policy( qpos_data, image_data, action_data, is_pad)这段对应 imitate_episodes.py 的 forward_pass()。
因此我们终于知道:
policy(...)的输入来自 Dataset,不是模型内部凭空生成的。
这也和最初的:
\[ Dataset \rightarrow DataLoader \rightarrow Batch \rightarrow Policy \]
完全连接起来。
三、RGB Images 怎样真正进入 Transformer?
假设输入:
\[ Images:[B,N,3,H,W] \]
这里 \(N\) 是相机数量。
原始 ACT 使用视觉 Backbone 提取每台相机的 Feature Map。
在作者示例训练配置中,Backbone 是:
backbone = "resnet18"它不是直接把整个原始图像展开成一个巨大的像素向量。
视觉 Backbone 会把每张图像变成空间特征,例如:
\[ F_i:[B,C_f,h,w] \]
其中 \(C_f,h,w\) 的具体值取决于 Backbone 和输入尺寸,本课不把它们写死。
随后,ACT 使用一个 1×1 Conv2d 将 Backbone 输出通道映射到 Transformer 的 Hidden Dimension:
self.input_proj = nn.Conv2d( backbone_channels, hidden_dim, kernel_size=1)这对应 detr_vae.py 中的 input_proj。
所以:
\[ [B,C_f,h,w] \rightarrow [B,D,h,w] \]
现在不同相机的特征具有相同的 Channel Dimension:
\[ D \]
多台相机的特征怎么合并?
官方代码中有:
src = torch.cat(all_cam_features, axis=3)为什么是:
axis=3?
因为单个 Feature Map 是:
\[ [B,D,h,w] \]
第 3 维就是 Width。
因此 3 台相机的:
\[ [B,D,h,w] \]
沿宽度方向拼接后:
\[ \boxed{[B,D,h,3w]} \]
一般情况下:
\[ \boxed{[B,D,h,Nw]} \]
这是作者代码中确实采用的拼接方式,而不是我们随意选择的融合方法。
我们现在可以用最小代码直接验证:
import torchB = 2N = 3D = 64h = 4w = 5features = [ torch.randn(B, D, h, w) for _ in range(N)]src = torch.cat(features, dim=3)print(src.shape)输出:
torch.Size([2, 64, 4, 15])这里:
\[ 15=3\times5 \]
也就是说,3 台相机的 Feature Map 沿宽度方向放在一起。
为什么又要 flatten 和 permute?
因为 Transformer 希望处理 Token Sequence。
原始视觉特征是:
\[ [B,D,h,Nw] \]
要把空间位置展开成一串 Token:
\[ S_v=h\times Nw \]
官方 transformer.py 中出现:
src = src.flatten(2).permute(2, 0, 1)先:
\[ [B,D,h,Nw] \rightarrow [B,D,S_v] \]
再:
\[ [B,D,S_v] \rightarrow [S_v,B,D] \]
注意,这个原始实现使用的是 Sequence First:
\[ [S,B,D] \]
而我们之前讲 PyTorch 教学代码时,经常使用:
\[ [B,S,D] \]
两种排列都可以,关键在于实际 API 的约定。
所以刚才的数据:
\[ [2,64,4,15] \]
变成:
\[ [60,2,64] \]
因为:
\[ 60=4\times15 \]
代码可以继续:
src = src.flatten(2)src = src.permute(2, 0, 1)print(src.shape)输出:
torch.Size([60, 2, 64])到这里,RGB 图像终于变成了 Transformer 可以处理的 Visual Token Sequence。
四、关节状态和 CVAE 潜变量又在哪里进入?
现在我们已经有:
\[ VisualTokens:[S_v,B,D] \]
但机器人执行动作时,除了图像,还需要当前的关节状态。
上一课已经知道:
\[ q_t:[B,14] \]
可以用 Linear:
proprio_input = self.input_proj_robot_state(qpos)映射成:
\[ [B,D] \]
这里的 proprio_input 表示经过投影的机器人本体状态特征。
同时,上一课的 CVAE 分支得到:
\[ z:[B,D_z] \]
再经过:
latent_input = self.latent_out_proj(latent_sample)也得到:
\[ [B,D] \]
因此此时我们有三类条件信息:
\[ VisualTokens:[S_v,B,D] \]
\[ ProprioToken:[B,D] \]
\[ LatentToken:[B,D] \]
作者代码的处理方式非常直接:
addition_input = torch.stack( [latent_input, proprio_input], axis=0)src = torch.cat( [addition_input, src], axis=0)第一步:
\[ [B,D]+[B,D] \]
通过 stack 得到:
\[ [2,B,D] \]
第二步再把这两个 Token 加到视觉序列前面:
\[ [2,B,D]+[S_v,B,D] \]
得到:
\[ \boxed{[S_v+2,B,D]} \]
这里的 +2 就来自:
\[ \boxed{\text{Latent Token + Proprioception Token}} \]
官方 transformer.py 也同步为它们拼接了额外的位置编码。
这一步值得特别记住:ACT 不是在 Transformer 末尾才把 \(z\) 和关节状态随便加进 Action Head,而是将它们作为条件信息并入 Transformer Encoder 的输入序列。
用代码验证完整 Shape
B = 2D = 64S_v = 60visual_tokens = torch.randn(S_v, B, D)latent_input = torch.randn(B, D)proprio_input = torch.randn(B, D)extra_tokens = torch.stack( [latent_input, proprio_input], dim=0)encoder_src = torch.cat( [extra_tokens, visual_tokens], dim=0)print(encoder_src.shape)结果:
torch.Size([62, 2, 64])因为:
\[ 62=60+2 \]
现在真正送给 Policy Transformer Encoder 的输入就已经准备好了。
五、Encoder–Decoder 怎么一次输出 \(K\) 个 Action?
这里终于进入原始 ACT 的 Transformer 主干。
我们当前有:
\[ EncoderInput:[S_v+2,B,D] \]
Encoder 对它进行 Self-Attention 和 FFN 处理,生成:
\[ Memory:[S_v+2,B,D] \]
现在想输出:
\[ K=8 \]
个未来动作。
就需要:
\[ ActionQueries:[K,D] \]
在 detr_vae.py 中确实存在:
self.query_embed = nn.Embedding( num_queries, hidden_dim)其中:
\[ num\_queries=K \]
所以:
\[ query\_embed.weight:[K,D] \]
但这里有一个与你第 16 课教学代码不同的重要细节。
真实 ACT 的 Decoder 输入 tgt 被初始化成全零,而 Action Query Embedding 作为 query_pos 单独传入。
官方 transformer.py 的核心代码为:
query_embed = query_embed.unsqueeze(1).repeat( 1, bs, 1)tgt = torch.zeros_like(query_embed)memory = self.encoder( src, src_key_padding_mask=mask, pos=pos_embed)hs = self.decoder( tgt, memory, memory_key_padding_mask=mask, pos=pos_embed, query_pos=query_embed)这段代码说明两件事。
第一,Decoder 有 \(K\) 个目标位置,但它们起始的内容特征是零向量;各位置的可学习查询信息通过 query_pos 注入 Attention。
第二,Decoder 不需要事先知道未来专家 Action 的数值,它可以利用 Action Query 从 Encoder Memory 中读取条件信息。
从 Shape 看:
\[ query\_embed:[K,B,D] \]
\[ tgt:[K,B,D] \]
而:
\[ memory:[S_v+2,B,D] \]
Cross-Attention 中的 Query 数量是 \(K\),Key 数量是 \(S_v+2\)。
因此注意力关系矩阵在不展开 Head 时可表示为:
\[ \boxed{[B,K,S_v+2]} \]
最终 Decoder 输出仍然包含 \(K\) 个位置。
然后 Action Head:
a_hat = self.action_head(hs)把每个位置的 Hidden Feature 映射成 Action。
例如教学配置:
\[ [B,8,64]\rightarrow[B,8,14] \]
最后得到:
\[ \boxed{\hat A:[B,K,D_a]} \]
这就是完整的 Action Chunk。
一个很容易混淆的细节
官方模型除了 action_head,还有:
self.is_pad_head = nn.Linear(hidden_dim, 1)它用于产生 Padding 相关预测:
is_pad_hat = self.is_pad_head(hs)但当前作者 policy.py 中的训练总损失实际采用 L1 和 KL,没有把 is_pad_hat 单独加入所展示的 Loss。
因此不能仅凭模型定义了一个 Head,就断言这个 Head 一定参与了最终训练损失。
六、现在追踪一遍官方代码的实际调用链
经过前面几课,你已经不必从头到尾阅读整个 GitHub 仓库,而是应该沿着入口函数和数据流追踪。
ACT 作者仓库的关键执行路径
-
启动训练或评估、创建 Policy、组织 Epoch、保存 Checkpoint
-
load_data()、EpisodicDataset.__getitem__(),读取 HDF5 示范与 Action Chunk -
ACTPolicy,完成模型调用、输入归一化和 L1 + KL Loss -
build_ACT_model_and_optimizer(),创建模型与优化器 -
DETRVAE.forward(),连接 CVAE、视觉特征、Action Queries 和 Action Head -
实际的 Transformer Encoder、Decoder、Self-Attention、Cross-Attention
上述文件路径和关键函数均已在作者仓库中核实。
真实的运行并不是简单地从一个 Python 文件顺序执行到另一个文件,而是通过构造函数、模块属性和方法调用逐层连接。
例如训练时,imitate_episodes.py 的:
forward_pass(data, policy)最终调用:
policy( qpos_data, image_data, action_data, is_pad)随后进入 ACTPolicy.__call__(),再调用内部模型:
a_hat, is_pad_hat, (mu, logvar) = self.model( qpos, image, env_state, actions, is_pad)这个 self.model 就是构建出来的 DETRVAE 实例。
最后 ACTPolicy 计算:
loss = l1 + kl * kl_weight外层训练循环再读取:
loss = forward_dict["loss"]loss.backward()optimizer.step()因此整个 Backward 可以一路经过 Action Head、Transformer、视觉 Backbone,以及训练时参与的 CVAE 分支,更新相关可训练参数。
这时候你应该发现,我们最早学习的:
\[ Forward \rightarrow Loss \rightarrow Backward \rightarrow Optimizer \]
一点都没有消失。
只是 Forward 内部从一个简单 Linear,成长为了完整的 ACT 模型。
七、Temporal Ensembling:为什么多个 Action Chunk 会预测同一个未来时刻?
前面我们学习过,Action Chunk 的基本思想是:
\[ o_t\rightarrow [\hat a_{t|t},\hat a_{t+1|t},\ldots,\hat a_{t+K-1|t}] \]
这里我采用更明确的下标:
\[ \hat a_{u|t} \]
表示:
在时间 \(t\) 做预测时,模型给未来时间 \(u\) 的动作预测。
这比简单写:
\[ a_t,a_{t+1},\ldots \]
更加清楚,因为不同时间做出的预测可能不一致。
例如:
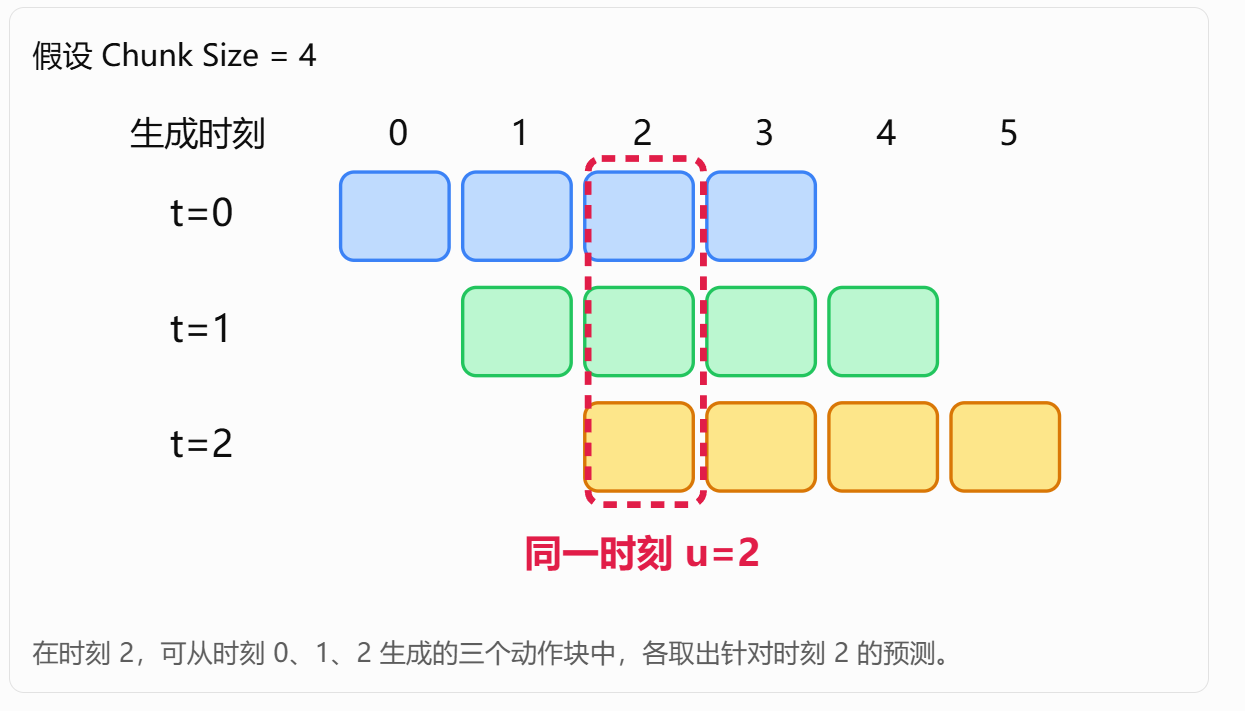
比如现在要执行:
\[ u=2 \]
这个时刻的 Action。
那么可能存在三个预测:
\[ \hat a_{2|0} \]
表示时刻 0 预测的未来第 3 个 Action。
\[ \hat a_{2|1} \]
表示时刻 1 预测的未来第 2 个 Action。
\[ \hat a_{2|2} \]
表示时刻 2 预测的第 1 个 Action。
虽然它们都是预测:
\[ u=2 \]
的动作,但模型当时使用的 Observation 不同,所以预测结果可能不同。
问题就来了:
到底执行哪一个?
第一种策略:整个 Chunk 执行完再预测
如果:
\[ K=4 \]
可以在 \(t=0\) 预测:
\[ [\hat a_{0|0},\hat a_{1|0},\hat a_{2|0},\hat a_{3|0}] \]
然后直接执行这 4 步,再重新预测。
这种策略简单,但相邻 Chunk 之间的切换可能出现动作不连续。
第二种策略:每一步重新预测,并融合重叠 Chunk
另一种思路是:
每个时刻都预测一个新 Chunk。
对于当前时刻 \(u\),把所有仍然覆盖该时刻的历史预测取出来:
\[ \hat a_{u|t_1}, \hat a_{u|t_2}, \ldots, \hat a_{u|t_n} \]
然后加权平均:
\[ \boxed{ a_u= \frac{ \sum_{i=1}^{n}w_i\hat a_{u|t_i} }{ \sum_{i=1}^{n}w_i } } \]
这就是:
Temporal Ensembling,时间集成。
它的目的不是直接改变 ACT 的训练目标,而是在推理执行期间融合对同一时刻的多次预测,从而减少 Chunk 切换带来的不连续问题。
一个特别容易讲错的细节:旧预测还是新预测权重更大?
我核对了作者 imitate_episodes.py 中的实际实现:
k = 0.01exp_weights = np.exp( -k * np.arange(len(actions_for_curr_step)))exp_weights = exp_weights / exp_weights.sum()该代码先按照生成时刻保存 Chunk,然后按顺序读取对当前时刻的预测;有效预测排列为从旧到新,因此:
\[ w_0=1 \]
对应较早的预测。
之后:
\[ w_1=e^{-0.01} \]
\[ w_2=e^{-0.02} \]
所以 原始仓库中较旧的预测获得略大的权重,而不是较新的预测权重更大。
这个细节在一些二次介绍中容易被说反,我们以后应该以实际代码的索引顺序为准。
八、Temporal Ensembling 的最小可运行代码
现在用一个 2 维 Action 来演示。
假设在同一个当前时刻,存在三次预测:
\[ \hat a^{(0)}=[0.10,0.20] \]
\[ \hat a^{(1)}=[0.12,0.19] \]
\[ \hat a^{(2)}=[0.11,0.18] \]
并且按照生成时间由旧到新排列。
import torch# 三个不同Chunk对同一时刻的预测predictions = torch.tensor([ [0.10, 0.20], [0.12, 0.19], [0.11, 0.18]])decay = 0.01# 每个预测分配一个指数权重weights = torch.exp( -decay * torch.arange( len(predictions), dtype=predictions.dtype ))# 权重归一化weights = weights / weights.sum()# 每个预测向量按权重相加action = ( predictions * weights.unsqueeze(-1)).sum(dim=0)print(weights)print(action)这一段代码出现两个需要真正理解的 Shape。
首先:
\[ predictions:[3,2] \]
表示 3 次预测,每次 2 维。
而:
\[ weights:[3] \]
只有 3 个数字。
为了让每个权重同时作用到一个 2 维 Action:
weights.unsqueeze(-1)把:
\[ [3]\rightarrow[3,1] \]
于是:
\[ [3,2]\times[3,1] \]
通过 Broadcasting 得到:
\[ [3,2] \]
最后:
.sum(dim=0)把三次加权预测聚合:
\[ [3,2]\rightarrow[2] \]
得到当前时刻实际选择的一个 Action Vector。
你可以看到,Temporal Ensembling 是对 Action 进行融合,而不是对 Transformer 的 Attention Matrix 进行融合。
尽管名字都涉及“权重”,它和 Attention 是完全不同的操作。
官方执行代码再往下一层
作者实现中的:
all_time_actions[[t], t:t+num_queries] = all_actions可以理解成:
把时间 \(t\) 预测出的未来 Chunk,按对应的未来执行时间保存起来。
然后:
actions_for_curr_step = all_time_actions[:, t]是:
找出所有历史 Chunk 中,针对当前时刻 \(t\) 的预测。
随后通过指数权重平均出:
raw_action最后进行:
action = post_process(raw_action)反归一化,再交给环境执行:
ts = env.step(target_qpos)这就把:
\[ \boxed{ Action\ Chunk \rightarrow Temporal\ Ensembling \rightarrow Denormalization \rightarrow Execution } \]
真正连接起来了。
需要额外指出,原始代码利用全零 Tensor 保存尚未填充的动作,再用 actions_for_curr_step != 0 判断有效位置。这种办法可能误判包含合法零值的动作,因此若重新实现,应优先维护显式有效性 Mask,而不是盲目照搬这一判断方式。
九、为什么 Temporal Ensembling 不等于 Receding Horizon Control?
这两个概念在上一课已经埋下伏笔,现在可以正式区分。
假设:
\[ K=16 \]
模型每次预测未来 16 个 Action。
Receding Horizon(滚动时域) 的一种做法是每次执行前 4 个,再重新预测:
\[ Predict\ 16 \rightarrow Execute\ 4 \rightarrow Reobserve \]
其核心是:
不执行整个预测序列,而是滚动更新计划。
但 Temporal Ensembling 是:
\[ Predict\ Chunk\ at\ t \]
\[ Predict\ Chunk\ at\ t+1 \]
\[ Predict\ Chunk\ at\ t+2 \]
然后对于同一个将要执行的 Action,融合多个 Chunk 中的预测。
它的核心是:
重叠动作预测之间如何集成。
因此,二者虽然都涉及频繁重新预测,但解决问题的侧重点不同:
| 对比 | 滚动时域执行 | Temporal Ensembling |
|---|---|---|
| 主要目的 | 根据新观察反复更新计划 | 融合重叠 Chunk 的动作预测 |
| 必须多个预测覆盖同一时刻吗? | 不必须 | 必须 |
| 是否需要动作加权平均? | 不必须 | 是 |
| 执行方式 | 通常只执行当前计划的一部分 | 每步选取当前动作的多个预测并融合 |
在 ACT 官方评估代码中,关闭 temporal_agg 时,默认每隔 num_queries 步重新查询 Policy;开启后则将 query_frequency 设置为 1,每个时间步都生成新的 Chunk,进而执行时间集成。
这也说明 Temporal Ensembling 会增加推理调用频率,因此并不是没有执行代价。
十、第十八课完整数据流回看
现在你终于可以从 HDF5 Dataset 一直追到机器人动作执行,而不是只知道 model(obs)。
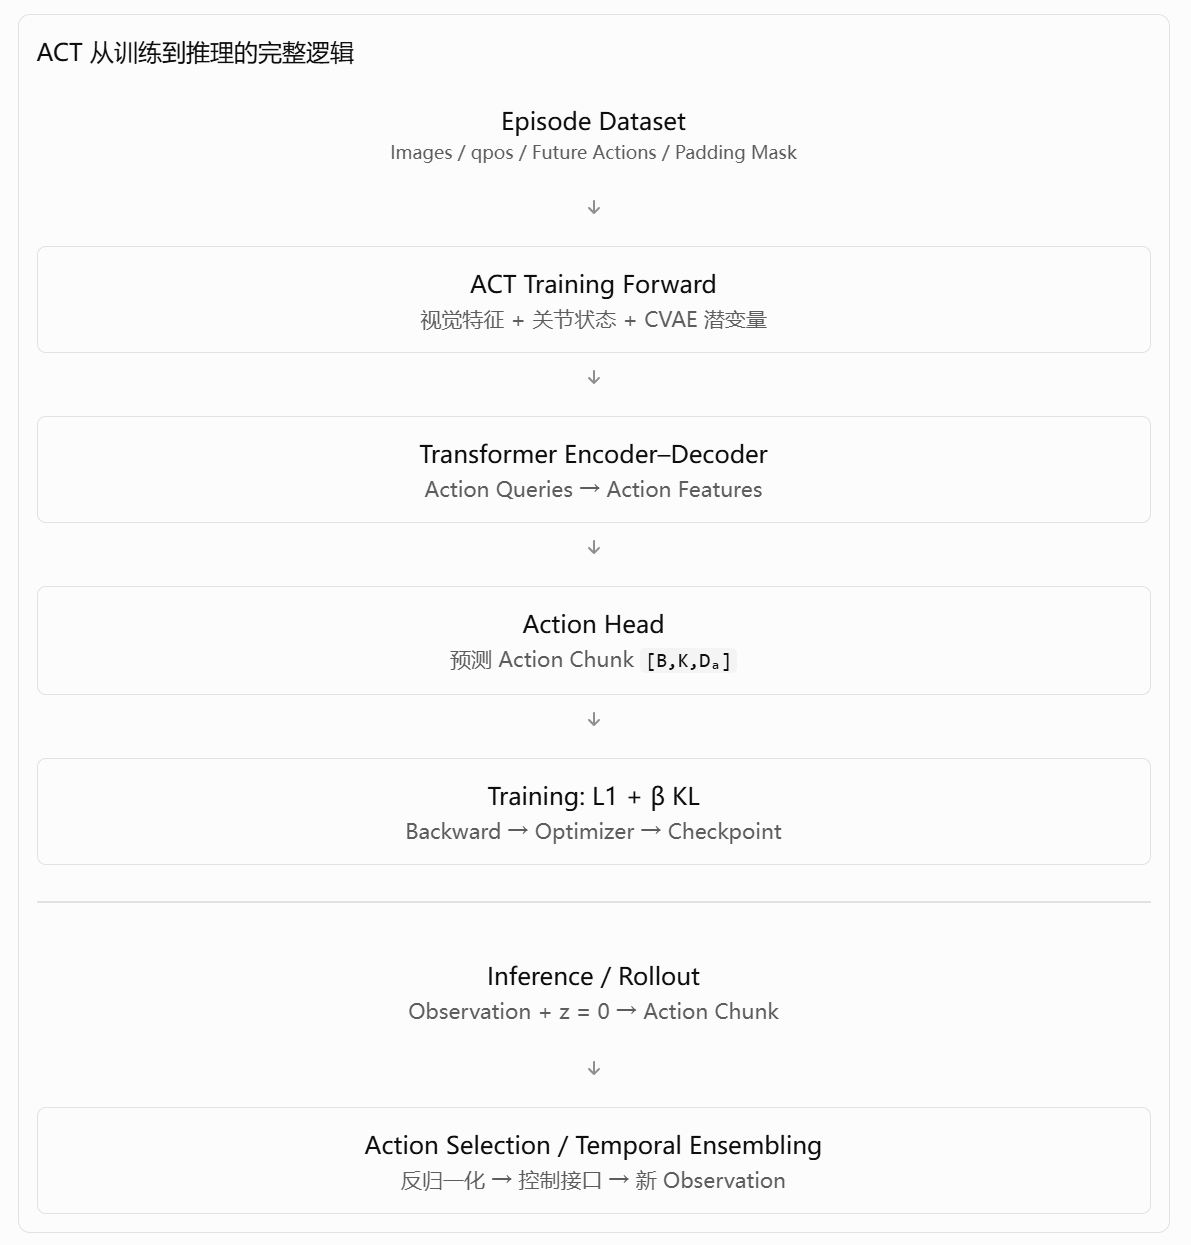
这里还有一个模型定位上的重要结论:
ACT 是面向机器人操作的模仿学习策略,不是完整的视觉—语言—动作大模型。
它帮助我们掌握了后来 VLA 系统依然经常需要面对的一系列核心问题:视觉编码、状态条件化、动作表示、序列预测、训练损失,以及闭环执行。
掌握 ACT 以后,再研究如何加入语言条件、使用预训练视觉语言模型,或者把连续 Action 交给不同的生成式 Head,才会有清楚的工程基础。
第十八课自测
-
原始 ACT 训练时最主要的两条分支分别是什么?推理时哪一条不再需要运行?
-
为什么 ACT 当前时刻只使用一组图像与关节状态,仍然可以预测未来 \(K\) 步 Action?
-
如果有 3 台相机,每台 Backbone 输出:
\[ [B,64,4,5] \]
沿 Width 拼接之后得到什么 Shape?
-
为什么还需要:
src.flatten(2).permute(2, 0, 1)?最终 Sequence Length 是多少?
-
如果视觉 Token 有 \(S_v=60\) 个,为什么官方 ACT Transformer Encoder 的输入 Token 数通常变成:
\[ S_v+2=62 \]
?这两个额外 Token 分别是什么?
-
官方 ACT 的
tgt为什么可以初始化成全零?Action Query Embedding 在哪里发挥作用? -
如果 Decoder 有 8 个 Action Query,而 Encoder Memory 有 62 个 Token,Cross-Attention 的 Score Matrix 不展开 Head 时是什么 Shape?
-
ACTPolicy的训练 Forward 和推理 Forward,为什么参数actions是否存在会直接影响内部执行路径? -
假设:
\[ K=4 \]
在时刻 \(t=2\) 执行动作时,哪些先前预测的 Chunk 可能包含这个时刻的 Action?
-
Temporal Ensembling 和直接执行整个 Action Chunk,有什么根本区别?
-
为什么需要把 Policy 输出的归一化 Action 反归一化以后再交给执行环境?
-
如果让你从训练入口追踪 ACT 真正生成动作的过程,你会依次打开哪些官方代码文件?其中哪个函数负责读取 Batch,哪个类负责模型的核心 Forward,哪个文件负责 Transformer 的 Self/Cross-Attention?

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献29条内容

所有评论(0)