【LeRobot SO101 实战】(二):ACT 真机抓放成功!从源码解析到 2 万步训练实录
前言
- 最近组内购入一台 LeRobot SO101,本系列就此展开,我们将在 LeRobot SO101 实机上部署若干经典算法与应用
- 往期内容:
- 我们曾经在【玩转VLA具身智能机械臂】(七):ACT——从单步动作到 Action Chunking 的机器人模仿学习 讲解过ACT的原理和代码分析,当时没有进行仿真训练。
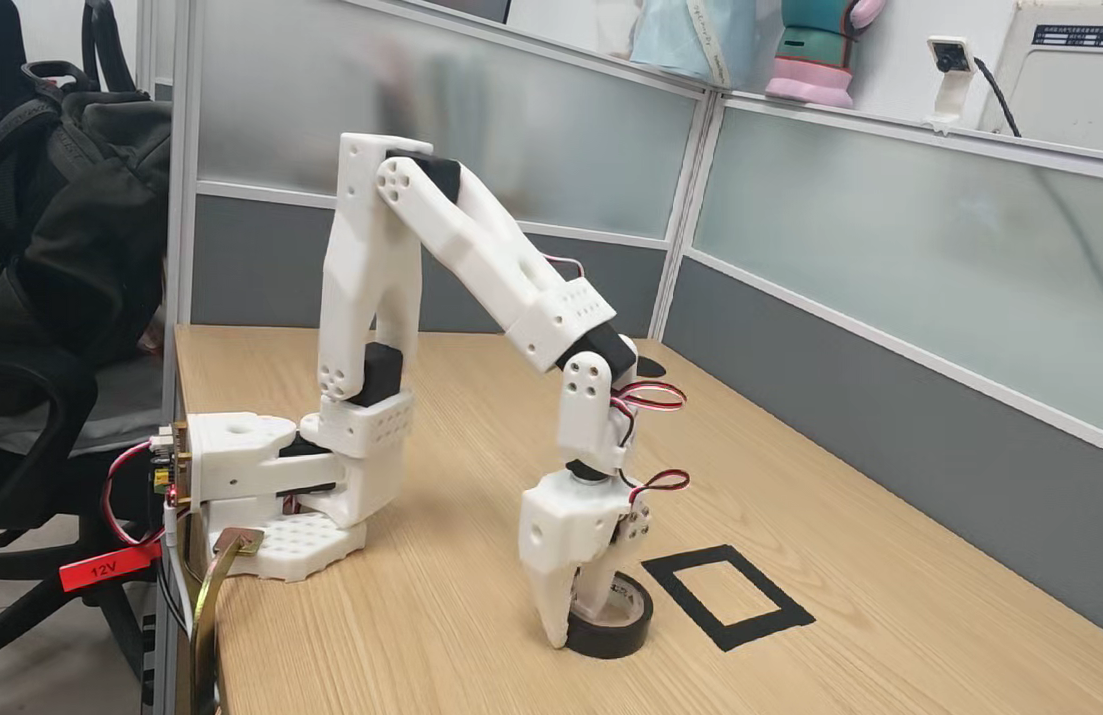
- 本期我们将基于 LeRobot 框架,使用 ACT 算法训练一个基于单摄像头的简单 Pick and Place(抓取与放置)任务,完成从视觉观测到机械臂自主执行抓放动作的完整流程,实验效果如下。
1 LeRobot 训练架构
1-1 介绍
- LeRobot 是 Hugging Face 推出的机器人学习框架,提供了从机器人数据采集、数据集管理、策略训练到真实机器人推理的一套工程流程。本期以 ACT 为例,结合 SO-101 机械臂,拆解这套流程是如何运转的。
- 在前面的 VLA 系列第七期中,我们已经推导过 ACT(Action Chunking Transformer,动作分块 Transformer)的网络结构与动作分块原理,因此本期不再重复介绍模型本身,而是把重点放在 LeRobot 的工程实现上。
- 从一份遥操作录制的数据集,到训练完成的模型,再到真实机械臂执行动作,中间涉及数据加载、批次构建、模型初始化、训练循环、权重保存、观测预处理与动作下发等多个环节。本章将沿着这条链路,梳理 LeRobot 的整体训练架构。
- 本章主要回答三个问题:
- 数据层: 录制好的 LeRobotDataset 是如何被加载、采样,并转换成模型所需的训练批次的?
- 训练层:
lerobot-train一条命令背后,如何完成策略初始化、前向计算、损失计算、反向传播与模型保存? - 推理层: 训练得到的模型权重、配置文件和归一化参数分别有什么作用?推理时又是如何将相机图像与关节状态转换成机械臂能够执行的动作?
说人话:LeRobot 不只是用来训练 ACT 的工具,而是把机器人数据、模型训练和真实硬件连接起来的一套框架。本期我们以 ACT 为例,看看一份数据是怎样经过 LeRobot 的处理,最终变成机械臂能够执行的动作的。
1-2 lerobot框架
1-2-1 总览
- LeRobot 的源码可以按"一层管一件事"来读,
src/lerobot/下的目录职责如下:
| 目录 | 职责 | 本期主要看 |
|---|---|---|
scripts/ | 命令行的入口,一个文件对应一条命令 | lerobot_train.py |
configs/ | 用 dataclass 描述的全部配置项 | TrainPipelineConfig、PreTrainedConfig |
datasets/ | 数据集的读写与时间对齐 | LeRobotDataset、LeRobotDatasetMetadata |
policies/ | 每个策略一个子目录 | act/ |
processor/ | 观测与动作的变换流水线 | 归一化与反归一化 |
optim/ | 优化器与学习率调度器的配置封装 | AdamWConfig |
robots/、teleoperators/、cameras/ | 硬件抽象层 | so_follower、so_leader、opencv |
utils/ | 通用工具 | 特征表的转换 |
- 其中配置层有一个贯穿全篇的设计:所有参数都是 dataclass 的字段,命令行参数就是字段的路径
- 也就是说
--a.b=c里的点号表示"往下钻一层",配置树的形状与命令行的形状是一一对应的:
--policy.type=act           # 对应 TrainPipelineConfig.policy 的类型选择
--policy.chunk_size=100     # 对应 ACTConfig 的 chunk_size 字段
--dataset.repo_id=...       # 对应 TrainPipelineConfig.dataset 里的 repo_id
--output_dir=...            # 对应 TrainPipelineConfig 自己的 output_dir
- 这个约定的好处很直接:想知道某条命令到底改了哪个值,去对应的 dataclass 里找同名字段就行,不用翻文档
说人话:命令行不是一堆散装的开关,而是那棵配置树上每条路径的坐标,想改哪个值就沿着树把路径写出来
- 另一处值得先记住的机制是"注册":策略、机器人、相机都靠装饰器把自己登记到基类上,而不是在工厂函数里写 if-else 分支
@PreTrainedConfig.register_subclass("act")
@dataclass
class ACTConfig(PreTrainedConfig):
    ...
- 这几行就是
--policy.type=act能生效的全部原因:字符串act被登记成ACTConfig,命令行写什么,就实例化哪个配置类 - 于是新增一个策略只需要写好自己的目录并注册,不必改动训练脚本
1-2-2 配置如何真正影响训练
- 上面两条机制(dataclass 即命令行、装饰器即注册)最终要落到一条具体的执行链上,而
lerobot-train的全部入口就是一个被装饰过的函数:
@parser.wrap()
def train(cfg: TrainPipelineConfig):
    ...
parser.wrap()负责按TrainPipelineConfig这棵配置树解析命令行,把--a.b=c逐条填进字段;函数体一开始拿到的已经是一个填好的配置对象- 之后的执行顺序基本就是"配置一路往下传":
| 顺序 | 做的事 | 配置里对应的字段 |
|---|---|---|
| 1 | 解析命令行,填出 TrainPipelineConfig | 全部字段 |
| 2 | cfg.validate() 集中做合法性检查 | policy、dataset、optimizer |
| 3 | make_train_eval_datasets(cfg) 建数据集 | dataset.* 与策略的 *_delta_indices |
| 4 | make_policy(cfg.policy, ds_meta=...) 建策略 | policy.type 与其余 policy.* |
| 5 | make_pre_post_processors(policy_cfg=...) 建前后处理流水线 | policy.normalization_mapping |
| 6 | make_optimizer_and_scheduler(cfg, policy) 建优化器与调度器 | 策略的 optimizer_lr 等预设 |
| 7 | 进入训练循环,逐步取数据、算损失、反传、记录 | batch_size、steps、log_freq、save_freq |
- 第 4 步就是注册机制兑现的地方,
make_policy内部取类只有一句:
policy_cls = get_policy_class(cfg.type)
cfg.type是配置类自己登记进去的名字:--policy.type=act解析出ACTConfig,它的type就是act,工厂按这个名字找到ACTPolicy并实例化。命令行上那个字符串就是这么变成类的- 这条链还解释了两个容易混的点:
--policy.type改的是"用哪个策略类",不是某个超参数;同一个字段名(比如chunk_size)写在哪个策略的配置类里,就只对那个策略生效- 第 3 步里数据集不是按"原始帧长什么样"发放的,而是按策略配置声明的
*_delta_indices组装样本。策略要看多长的历史、多长的未来由策略配置决定,数据集照着取——这是第 1-4 节那条"动作分块在数据层就已完成"的根据
- 第 2 步的
cfg.validate()是训练启动前的一次集中检查:output_dir会不会覆盖已有目录、有没有指定策略、rename_map配没配对,都在这里报错;它同时还会把策略自带的优化器与调度器预设搬进训练配置(use_policy_training_preset默认为真,第 6 步用的就是这一份) - 策略自身的约束比它更早生效:像
n_action_steps不能大于chunk_size这类检查写在配置类的__post_init__里,命令行解析成对象的那一刻就抛错,函数体还没开始执行
说人话:命令行是坐标,dataclass 是地图,注册表是门牌号。
lerobot-train干的事就是照着坐标填好地图,再按门牌号把数据集、策略、优化器一个个建出来
1-3 对接ACT
- LeRobot 将 ACT 封装为两层:对外的策略类
ACTPolicy,以及它内部真正的那张网络ACT- 这一层封装是有必要的,它把训练与推理都要用到的公共动作收在了一起:动作队列、损失计算、权重保存
1-3-1 网络构建
- 真正的网络只在
__init__里创建一次,其余方法都是围着它转:
class ACTPolicy(PreTrainedPolicy):
    config_class = ACTConfig
    name = "act"

    def __init__(self, config: ACTConfig, **kwargs):
        super().__init__(config)
        config.validate_features()   # 至少要有一路图像或环境状态,否则直接报错
        self.config = config

        self.model = ACT(config)     # 真正的网络在这一层里面

        self.reset()
- 于是职责被切成两半:
ACT只管张量进出,输入观测批、输出一串动作;ACTPolicy管"动作怎么攒、怎么发、损失怎么算"
1-3-2 损失计算
- 训练用的损失也在这一层算,就是 ACT 论文里的两项,代码在
ACTPolicy.forward里 L = 1 B ⋅ k ⋅ D ∑ b = 1 B ∑ t = 1 k ∑ d = 1 D ( 1 − p b , t ) ∣ a ^ b , t , d − a b , t , d ∣ ⏟ L reconst + β D K L ( q ϕ ( z ∣ a t : t + k , o ˉ t ) ∥ N ( 0 , I ) ) ⏟ L reg \mathcal{L}=\underbrace{\frac{1}{B\cdot k\cdot D}\sum_{b=1}^{B}\sum_{t=1}^{k}\sum_{d=1}^{D}(1-p_{b,t})\,\big|\hat{a}_{b,t,d}-a_{b,t,d}\big|}_{\mathcal{L}_{\text{reconst}}}+\beta\underbrace{D_{KL}\big(q_\phi(z\,|\,a_{t:t+k},\bar{o}_t)\,\|\,\mathcal{N}(0,I)\big)}_{\mathcal{L}_{\text{reg}}} L=Lreconst B⋅k⋅D1b=1∑Bt=1∑kd=1∑D(1−pb,t) a^b,t,d−ab,t,d +βLreg DKL(qϕ(z∣at:t+k,oˉt)∥N(0,I)) - 符号含义:
- B B B:batch size
- k k k:chunk size
- D D D:单步动作的维度,重建误差对动作的每一维一起累加。本次 SO101 的动作是 6 维,即 D = 6 D=6 D=6;ACT 论文中的 ALOHA 平台是 14 维
-
p
b
,
t
p_{b,t}
pb,t:
is_pad,第 b b b 条样本第 t t t 步是否为填充位(为 1 1 1 表示填充,不参与重建) - d d d:动作维度的下标,取 1 1 1 到 D D D
- a ^ \hat{a} a^、 a a a:预测动作与专家动作,都是归一化后的 D D D 维
-
β
\beta
β:KL 项权重,论文与官方命令都取
10
- 第一项是预测动作与示教动作的平均绝对误差(L1)
- 第二项是 VAE(Variational AutoEncoder,变分自编码器)潜在分布与标准正态之间的 KL(Kullback-Leibler,相对熵)散度,乘上
kl_weight后与 L1 相加,本次训练这个权重是库默认的 10.0
def forward(self, batch: dict[str, Tensor]) -> tuple[Tensor, dict]:
    """Run the batch through the model and compute the loss for training or validation."""
    if self.config.image_features:
        batch = dict(batch)  # 浅拷贝,避免往原始 batch 里塞键
        batch[OBS_IMAGES] = [batch[key] for key in self.config.image_features]

    actions_hat, (mu_hat, log_sigma_x2_hat) = self.model(batch)

    abs_err = F.l1_loss(batch[ACTION], actions_hat, reduction="none")
    # 每个 episode 结尾凑不满 chunk_size,补出来的帧不参与损失
    valid_mask = ~batch["action_is_pad"].unsqueeze(-1)
    num_valid = valid_mask.sum() * abs_err.shape[-1]
    l1_loss = (abs_err * valid_mask).sum() / num_valid.clamp_min(1)

    loss_dict = {"l1_loss": l1_loss.item()}
    if self.config.use_vae and log_sigma_x2_hat is not None:
        # Dₖₗ(latent_pdf || standard_normal):先在潜维上求和,再对 batch 取平均
        mean_kld = (
            (-0.5 * (1 + log_sigma_x2_hat - mu_hat.pow(2) - (log_sigma_x2_hat).exp())).sum(-1).mean()
        )
        loss_dict["kld_loss"] = mean_kld.item()
        loss = l1_loss + mean_kld * self.config.kl_weight
    else:
        loss = l1_loss

    return loss, loss_dict
- KL 项被
use_vae与log_sigma_x2_hat is not None两道条件守着- 关掉 VAE 或模型没吐潜分布时,总损失就等于 L1 项
- 本次训练的
use_vae取的库默认值True,所以两项都在 - 注意
action_is_pad这一路掩码:动作分块要求每个样本都带chunk_size个未来动作,而 episode 收尾那段不够长,LeRobot 会把末帧的动作复制过来顶上,同时把这些位置标成 pad,损失里必须剔掉,否则模型会被要求去拟合一段并不存在的未来动作(这一步具体在哪里做,见第 1-4-1 节)
- 还要注意返回的那个字典:
l1_loss与kld_loss会被日志原样打出来,第 3 章看曲线时我们对得上号 - 那这几百行代码具体该读哪些文件?下面这张表是本章的地图:
| 内容 | LeRobot 中重点看哪里 |
|---|---|
| ACT 网络结构 | src/lerobot/policies/act/modeling_act.py |
| ACT 超参数配置 | src/lerobot/policies/act/configuration_act.py |
| 归一化与后处理 | src/lerobot/policies/act/processor_act.py |
| 数据集加载与时间对齐 | src/lerobot/datasets/ |
| 完整训练流程 | examples/tutorial/act/act_training_example.py |
| 真实机械臂推理 | examples/tutorial/act/act_using_example.py |
| 统一训练命令 | lerobot-train |
| 真实机器人评估 | lerobot-rollout(本版跑策略与评估的统一入口) |
- 还有一件最容易被忽略的事:推理要用的归一化统计量并不在权重文件里
policy_preprocessor.json与policy_preprocessor_step_3_normalizer_processor.safetensors记的是输入该怎么归一化policy_postprocessor.json与policy_postprocessor_step_0_unnormalizer_processor.safetensors记的是输出该怎么反归一化- 它们与
model.safetensors一起放在 checkpoint 目录里,加载时必须一起加载,少一个动作尺度就不对
- 这也是为什么第 1-4 节保存模型时要连着保存三个对象,而不是只保存权重
1-4 训练流程
1-4-1 整体流程
- 训练流程先从一份最小可跑的脚本看起,源码在
examples/tutorial/act/act_training_example.py,数据集、优化器、训练循环、模型保存四件事都在里面 - 它只有一百行,下面这份代码就是按它整理的,把数据集换成本次录制的
tape-3.0-pick-and-place,其余流程完全一致:
"""ACT 最小训练流程:数据集、优化器、训练循环、模型保存。"""

from pathlib import Path

import torch

from lerobot.configs import FeatureType
from lerobot.datasets import LeRobotDataset, LeRobotDatasetMetadata
from lerobot.policies import make_pre_post_processors
from lerobot.policies.act import ACTConfig, ACTPolicy
from lerobot.utils.feature_utils import dataset_to_policy_features

def make_delta_timestamps(delta_indices: list[int] | None, fps: int) -> list[float]:
    # delta_indices 给的是"往后取第几帧",数据集按秒索引,所以这里换算成时间
    if delta_indices is None:
        return [0]

    return [i / fps for i in delta_indices]

def main():
    output_directory = Path("outputs/robot_learning_tutorial/act")
    output_directory.mkdir(parents=True, exist_ok=True)

    device = torch.device("cuda")  # 没有显卡就换成 "cpu"
    dataset_id = "local/tape-3.0-pick-and-place"
    dataset_root = "<数据集目录>"

    # 1. 读元数据,把特征表切成"模型吃什么"与"模型吐什么"
    dataset_metadata = LeRobotDatasetMetadata(dataset_id, root=dataset_root)
    features = dataset_to_policy_features(dataset_metadata.features)

    output_features = {key: ft for key, ft in features.items() if ft.type is FeatureType.ACTION}
    input_features = {key: ft for key, ft in features.items() if key not in output_features}

    # 2. 建策略,再建前后处理器;两者的归一化统计量都取自数据集的 stats.json
    cfg = ACTConfig(input_features=input_features, output_features=output_features)
    policy = ACTPolicy(cfg)
    preprocessor, postprocessor = make_pre_post_processors(cfg, dataset_stats=dataset_metadata.stats)

    policy.train()
    policy.to(device)

    # 3. 关键一步:告诉数据集"动作要往后取 chunk_size 帧",动作分块就靠它
    delta_timestamps = {
        "action": make_delta_timestamps(cfg.action_delta_indices, dataset_metadata.fps),
    }

    # 图像观测也要按同样的方式声明,只是 ACT 只看当前帧,换算出来就是 [0.0]
    delta_timestamps |= {
        k: make_delta_timestamps(cfg.observation_delta_indices, dataset_metadata.fps)
        for k in cfg.image_features
    }

    dataset = LeRobotDataset(dataset_id, root=dataset_root, delta_timestamps=delta_timestamps)

    # 4. 优化器来自策略自带的预设,无需另行构造
    optimizer = cfg.get_optimizer_preset().build(policy.parameters())
    batch_size = 8
    dataloader = torch.utils.data.DataLoader(
        dataset,
        batch_size=batch_size,
        shuffle=True,
        pin_memory=device.type != "cpu",
        drop_last=True,
    )

    # 5. 训练循环:取批、算损失、反传、更新
    training_steps = 30000
    log_freq = 100
    step = 0
    done = False
    while not done:
        for batch in dataloader:
            batch = preprocessor(batch)
            loss, loss_dict = policy.forward(batch)
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()

            if step % log_freq == 0:
                print(f"step: {step} loss: {loss.item():.3f}")
            step += 1
            if step >= training_steps:
                done = True
                break

    # 6. 权重与前后处理器一起保存,少存任何一个,推理时都对不上尺度
    policy.save_pretrained(output_directory)
    preprocessor.save_pretrained(output_directory)
    postprocessor.save_pretrained(output_directory)

if __name__ == "__main__":
    main()
- 六步里,第 1 步与第 3 步是 LeRobot 特有的
- 第 1 步:
dataset_to_policy_features把数据集的原始特征表翻译成策略特征表,再按FeatureType一分为二,action归到输出,其余归到输入。- 本次数据集的输入是
observation.state(6 维关节角)与observation.images.front(3 通道 480x640 图像),输出是 6 维action
- 本次数据集的输入是
- 第 3 步:
delta_timestamps是"一条样本要取哪些时刻的数据"。- ACT 的
action_delta_indices返回的是list(range(chunk_size)),也就是训练帧往后的 100 帧,换算成时间就是 100 个时间戳
- ACT 的
- 第 1 步:
- 所以动作分块并不是模型内部凭空多出来的机制,它在数据层就已经把一条样本变成了"当前观测 + 未来 100 步动作"的配对,模型要学的就是这段对应关系
说人话:
delta_timestamps相当于在数据集上开了个小窗口,取一条样本时顺手把往后 3.33 秒的动作一起捞出来当答案
- 对照
lerobot-train的实际实现,正式训练循环比上面多四件事,都在scripts/lerobot_train.py里:
with accelerator.accumulate(policy):
    with accelerator.autocast():
        loss, output_dict = policy(batch)

    accelerator.backward(loss)

    grad_norm = accelerator.clip_grad_norm_(policy.parameters(), grad_clip_norm)
    optimizer.step()
    optimizer.zero_grad()
- 多出来的四件事分别是:用
accelerator接管混合精度与多卡、用policy(batch)而不是policy.forward(batch)(前者才会触发 FSDP 的参数聚合钩子)、按grad_clip_norm裁剪梯度、以及把梯度范数记进日志- 注意
clip_grad_norm_返回的是裁剪前的范数,所以日志里的grdn能反映裁剪是否被触发,第 3 章分析曲线时要用到这个性质
- 注意
- 另外,
policy.train()与optimizer.zero_grad()的位置也值得留意:后者在每次更新之后立刻调用,不是在下一次反传之前,两种写法等价,但看日志时容易数错步
1-4-2 一条样本是怎么变成 batch 的
- 上一节说
delta_timestamps是"一条样本要取哪些时刻的数据",这一节把它拆到函数级:一条样本到底长什么样,action_is_pad又是在哪一步写进去的 - 从索引到 batch 只有五步:
| 顺序 | 做的事 | 代码位置 |
|---|---|---|
| 1 | DataLoader 按帧序号取一条样本 | LeRobotDataset.__getitem__ |
| 2 | 按该帧所属 episode 的边界,算出要取哪些帧 | DatasetReader._get_query_indices |
| 3 | 读当前帧的状态与图像,按算出的一串下标取出未来动作块 | _query_hf_dataset、_query_videos |
| 4 | 给动作块打上 pad 标记 | 与第 2 步在同一个函数里 |
| 5 | DataLoader 把 batch_size 条样本堆成一个 batch | torch.utils.data.DataLoader |
- 第 2 步是动作分块在数据层的全部秘密,源码就是两个字典推导式:
query_indices = {
    key: [max(ep_start, min(ep_end - 1, abs_idx + delta)) for delta in delta_idx]
    for key, delta_idx in self.delta_indices.items()
}
padding = {
    f"{key}_is_pad": torch.BoolTensor(
        [(abs_idx + delta < ep_start) | (abs_idx + delta >= ep_end) for delta in delta_idx]
    )
    for key, delta_idx in self.delta_indices.items()
}
- 下标被夹在
[ep_start, ep_end - 1]之间:abs_idx + delta越过 episode 末尾时取到的是最后一帧,不是零值- 这处细节容易记反,在本地数据集上验证过:episode 收尾处被标记成 pad 的动作,与最后一帧的动作逐维相等
- 所以"补零"在标准数据集这条路径上并不成立,真正发生的是"复制末帧";pad 标记仍然必要,因为这些位置并非真实的未来动作,损失里要剔掉
- 从数据集里取一条样本(本次加
chunk_size=100),得到的键是:
['action', 'action_is_pad', 'episode_index', 'frame_index', 'index',
 'observation.images.front', 'observation.state', 'task', 'task_index', 'timestamp']
- 与训练相关的只有四组,形状分别是:
observation.images.front:(3, 480, 640),当前帧图像observation.state:(6,),当前帧关节角action:(100, 6),往后 100 帧动作action_is_pad:(100,),与上面那 100 帧逐帧对齐
- 过一趟 DataLoader(本次
batch_size=8)后,一整批数据的形状是:
observation.images.front    # Tensor (8, 3, 480, 640)
observation.state           # Tensor (8, 6)
action                      # Tensor (8, 100, 6)
action_is_pad               # Tensor (8, 100)
timestamp / frame_index / episode_index / index / task_index   # Tensor (8,)
task                        # list  长度 8
- 前四行正好对上 1-3-2 里损失公式的
B
B
B 与
k
k
k:
8是 B B B,100是 k k k;action_is_pad与action逐帧对齐,forward里那句valid_mask = ~batch["action_is_pad"].unsqueeze(-1)做的就是把它对齐到 6 维动作上- 只有
task不是张量:它是字符串,堆出来的是长度为batch_size的列表,训练时不参与计算。堆叠本身用的是 PyTorch 默认的default_collate;数据集带语言标注列时,入口脚本才会换成lerobot_collate_fn特殊处理字符串字段,本次数据集没有这类列
- 只有
- 顺带说明另外两个
delta_indices:ACT 的observation_delta_indices返回None,所以图像与状态只取当前帧;action_delta_indices返回list(range(100)),才有上面这个(100, 6)的动作块
1-4-2 checkpoint 里到底存了什么
- 六步走完,磁盘上的结构是这样的(本次训练的真实目录):
checkpoints/
├── 005000/ 010000/ 015000/ 020000/                   # 每 5000 步存一次
│   └── pretrained_model/
│       ├── config.json                                     # 策略自身的超参数
│       ├── model.safetensors                  198 MB       # 网络权重
│       ├── policy_preprocessor.json                        # 输入流水线的结构
│       ├── policy_preprocessor_step_3_normalizer_processor.safetensors    # 输入归一化统计量
│       ├── policy_postprocessor.json                       # 输出流水线的结构
│       ├── policy_postprocessor_step_0_unnormalizer_processor.safetensors # 输出反归一化统计量
│       └── train_config.json                               # 整条训练命令的配置快照
└── last -> 015000                                          # 软链接,指向最新一次
- 按用途分成三类:
- 权重:只有
model.safetensors一个文件,198 MB,占了目录体积的绝大部分 - 配置:
config.json是策略自己的超参数;train_config.json是整个训练侧配置的快照,数据集、优化器、log_freq、save_freq都在里面,断点续训读的就是它 - 统计量:两个
.safetensors存归一化与反归一化要用的均值方差,两个.json记录流水线里有哪些步骤、按什么顺序串起来
- 权重:只有
- 统计量为什么必须单独存:它和权重是两件事。权重决定"网络算什么",统计量决定"喂进去的数值在什么尺度上"。
- ACT 的图像、状态、动作三路都取均值方差标准化(
MEAN_STD),训练时用本次数据集的关节角与图像统计量把输入压到网络习惯的范围,推理时若换了另一套统计量,或者干脆不做归一化,权重再准,动作也是偏的
- ACT 的图像、状态、动作三路都取均值方差标准化(
- 这也正是加载时要连流水线一起加载的原因:
policy_preprocessor_step_3_...里的均值方差与训练时逐位相同,模型看到的数值分布才与训练时一致 - 文件名里的编号(
step_0、step_3)是这一步在流水线里的位置,不是版本号;顺序变了,含义就变了 - 最后注意
last是软链接而不是副本:它始终指向最新那次保存,所以想固定某个中间结果去评测,得用具体步数的目录,或者先把软链接指向的那份拷出来
1-5 推理流程
- 推理的源码在
examples/tutorial/act/act_using_example.py,官方示例原文如下(面向 SO100、设备写死mps、模型与数据集都从 Hub 拉取):
import torch

from lerobot.cameras.opencv import OpenCVCameraConfig
from lerobot.datasets import LeRobotDatasetMetadata
from lerobot.policies import make_pre_post_processors
from lerobot.policies.act import ACTPolicy
from lerobot.policies.utils import build_inference_frame, make_robot_action
from lerobot.robots.so_follower import SO100Follower, SO100FollowerConfig

MAX_EPISODES = 5
MAX_STEPS_PER_EPISODE = 20


def main():
    device = torch.device("mps")  # or "cuda" or "cpu"
    model_id = "<user>/robot_learning_tutorial_act"
    model = ACTPolicy.from_pretrained(model_id)

    dataset_id = "lerobot/svla_so101_pickplace"
    # This only downloads the metadata for the dataset, ~10s of MB even for large-scale datasets
    dataset_metadata = LeRobotDatasetMetadata(dataset_id)
    preprocess, postprocess = make_pre_post_processors(model.config, dataset_stats=dataset_metadata.stats)

    # # find ports using lerobot-find-port
    follower_port = ...  # something like "/dev/tty.usbmodem58760431631"

    # # the robot ids are used the load the right calibration files
    follower_id = ...  # something like "follower_so100"

    # Robot and environment configuration
    # Camera keys must match the name and resolutions of the ones used for training!
    # You can check the camera keys expected by a model in the info.json card on the model card on the Hub
    camera_config = {
        "side": OpenCVCameraConfig(index_or_path=0, width=640, height=480, fps=30),
        "up": OpenCVCameraConfig(index_or_path=1, width=640, height=480, fps=30),
    }

    robot_cfg = SO100FollowerConfig(port=follower_port, id=follower_id, cameras=camera_config)
    robot = SO100Follower(robot_cfg)
    robot.connect()

    for _ in range(MAX_EPISODES):
        for _ in range(MAX_STEPS_PER_EPISODE):
            obs = robot.get_observation()
            obs_frame = build_inference_frame(
                observation=obs, ds_features=dataset_metadata.features, device=device
            )

            obs = preprocess(obs_frame)

            action = model.select_action(obs)
            action = postprocess(action)

            action = make_robot_action(action, dataset_metadata.features)

            robot.send_action(action)

        print("Episode finished! Starting new episode...")


if __name__ == "__main__":
    main()
-
从这份示例到本次真机部署,只差四处,闭环的骨架一模一样:
- 设备:示例写死
mps,本次换成cuda - 机器人:示例是
SO100Follower,本次换成SO101Follower,端口与id填自己标定文件对应的那套 - 摄像头:示例是
side与up两路,本次训练只用了front一路,所以相机字典只留front;名字必须等于训练时观测键的后缀 - 模型来源:示例从 Hub 拉模型,再用数据集的
stats建前后处理器;本次直接指向本地 checkpoint,归一化统计量随 checkpoint 一起读走(第 1-4-2 节那几个 processor 文件就是干这个的),不必再传数据集统计量
- 设备:示例写死
-
还有一处是教程为了能自动跑完留下的:示例用"5 集 × 每集 20 步"限定退出。本次部署改用
lerobot-rollout,按时间与Ctrl+C控制,见第 3-5 节 -
这份循环里,
build_inference_frame与make_robot_action是 LeRobot 加进来的"翻译层",也是把策略接到任意一台机器人上必须过的两道关口build_inference_frame:机器人给出的观测是front图像加一堆shoulder_pan.pos这样的关节键,而模型要的是observation.images.front与observation.state。这一步负责按特征表挑键、改名,再补上 batch 维并搬到设备上make_robot_action是它的逆操作:把策略输出的 6 维张量按action特征的names还原成{"shoulder_pan.pos": ...}这样的命名字典,驱动层才认得
-
夹在两者之间的
preprocess与postprocess是一对:前者的流水线里装着NormalizerProcessorStep(用训练时的统计量归一化)与DeviceProcessorStep(搬设备),后者是UnnormalizerProcessorStep加DeviceProcessorStep,正好是训练侧变换的逆序- 也就是说,训练时数据怎么进网络,推理时就必须怎么进网络,这两条流水线是由同一个
config生成的一对
- 也就是说,训练时数据怎么进网络,推理时就必须怎么进网络,这两条流水线是由同一个
说人话:
build_inference_frame与make_robot_action就是策略和机器人之间的两个翻译,一个负责把机器人的话翻译给模型,一个负责把模型的话翻译给机器人
- 还有一处关键细节:
select_action并不是每一步都跑一次网络,它的内部是一个动作队列
def reset(self):
    """每次环境重置时调用。"""
    if self.config.temporal_ensemble_coeff is not None:
        self.temporal_ensembler.reset()
    else:
        self._action_queue = deque([], maxlen=self.config.n_action_steps)

@torch.no_grad()
def select_action(self, batch: dict[str, Tensor]) -> Tensor:
    self.eval()  # 队列消费期间策略可能被切到 train 模式,这里强制回 eval

    if self.config.temporal_ensemble_coeff is not None:
        actions = self.predict_action_chunk(batch)
        action = self.temporal_ensembler.update(actions)
        return action

    # n_action_steps > 1 时的队列逻辑:队列空了才去问策略要下一批
    if len(self._action_queue) == 0:
        actions = self.predict_action_chunk(batch)[:, : self.config.n_action_steps]

        # 网络返回 (batch_size, n_action_steps, action_dim),队列按 (n_action_steps, batch_size, *) 存
        self._action_queue.extend(actions.transpose(0, 1))
    return self._action_queue.popleft()

@torch.no_grad()
def predict_action_chunk(self, batch: dict[str, Tensor]) -> Tensor:
    """预测一段动作块。"""
    self.eval()

    if self.config.image_features:
        batch = dict(batch)
        batch[OBS_IMAGES] = [batch[key] for key in self.config.image_features]

    actions = self.model(batch)[0]
    return actions
- 这段是源码原样:
reset与时序集成走的是两套状态,一个重置加权用的temporal_ensembler,一个重置动作队列- 队列空时才真正做一次前向,之后的一串控制步都只是出队;但"一次预测管多少步"由
chunk_size与n_action_steps两个字段共同决定,下一小节单独说
- 队列空时才真正做一次前向,之后的一串控制步都只是出队;但"一次预测管多少步"由
- 另外,这个
while True循环没有退出条件,工程上要配合Ctrl+C、退出时把臂平滑送回原位、以及限速等保护;这些属于部署脚本要处理的事,放到第 3-5 节
1-5-1 chunk_size 与 n_action_steps
- 上面代码里出现了两个长度:
chunk_size是网络一次吐出的动作块长度n_action_steps是每次预测后最多从队列里取走多少个。- 它们是两个独立字段,库默认都给 100,但含义不同
- 约束只有一条:
n_action_steps不能大于chunk_size(大于就没有动作可取,配置类在实例化时就会报错);反过来n_action_steps小于chunk_size完全合法,只是预测出来的动作块只取前一段用,剩下的丢掉,队列一空就重新预测 - 三种配置对应的行为:
| 配置 | 一次前向后连续执行 | 前向频率 |
|---|---|---|
n_action_steps = chunk_size = 100 | 100 步 | 每 100 个控制步一次 |
n_action_steps = 50、chunk_size = 100 | 50 步 | 每 50 个控制步一次,后 50 个动作被丢弃 |
temporal_ensemble_coeff 非空 | 1 步 | 每个控制步一次,并强制 n_action_steps = 1 |
- 最后一行是源码中的硬约束:
- 启用时序集成后,每个控制步都要重新预测,再把多个动作块按指数权重加权平均,队列逻辑用不上,所以配置里直接要求
n_action_steps必须为 1
- 启用时序集成后,每个控制步都要重新预测,再把多个动作块按指数权重加权平均,队列逻辑用不上,所以配置里直接要求
- 回到本次配置:
- 本次
chunk_size取库默认的 100,n_action_steps取 50,且没启用时序集成:一次前向仍然吐出 100 个动作,但只取前 50 个连续出队,30 fps 下等于 1.67 秒之后重新前向一次
- 本次
- 但"推理开销只有控制频率的五十分之一"这个说法要限定在前向次数上:
- 真机每个控制步的耗时还包含相机采集、观测整理、预处理、后处理与串口下发,控制步的实际节拍由这些环节共同决定,网络只是其中一段
- 能确定的只是前向次数被摊薄到 1/50
- 由此反推"整体提速 50 倍"是不成立的,前向省下的时间只是给其余环节留出了余量
- 要落到真实节拍上,还得把控制循环、相机取帧、预处理与网络前向各自的耗时分开测:只有这几段都量出来,才知道被摊薄的那段前向时间在整步里占多大比例,也才知道瓶颈在哪
2 Pick and Place
2-1 任务介绍
- 第一章讲的是框架怎么把策略与数据接起来,接下来该给它一个真实任务
- Pick and Place(抓取与放置)是机器人操作领域最经典的基础任务之一,要求机械臂根据视觉观测与自身状态,控制末端执行器完成目标物体的抓取、搬运与放置。
- 对于 ACT 这类模仿学习策略,我们通过遥操作记录人类示范,将相机图像、关节状态与对应动作组成训练数据集,让模型学习从当前观测到连续动作序列的映射,最终使机械臂能够自主完成物体抓取与放置。
- 该任务流程直观、便于评估,是验证 LeRobot 数据采集、策略训练与真机部署全流程的理想入门案例。
- 这一章我们先把任务与场景说清楚,然后看数据集是怎么录出来的
2-2 本文任务说明
-
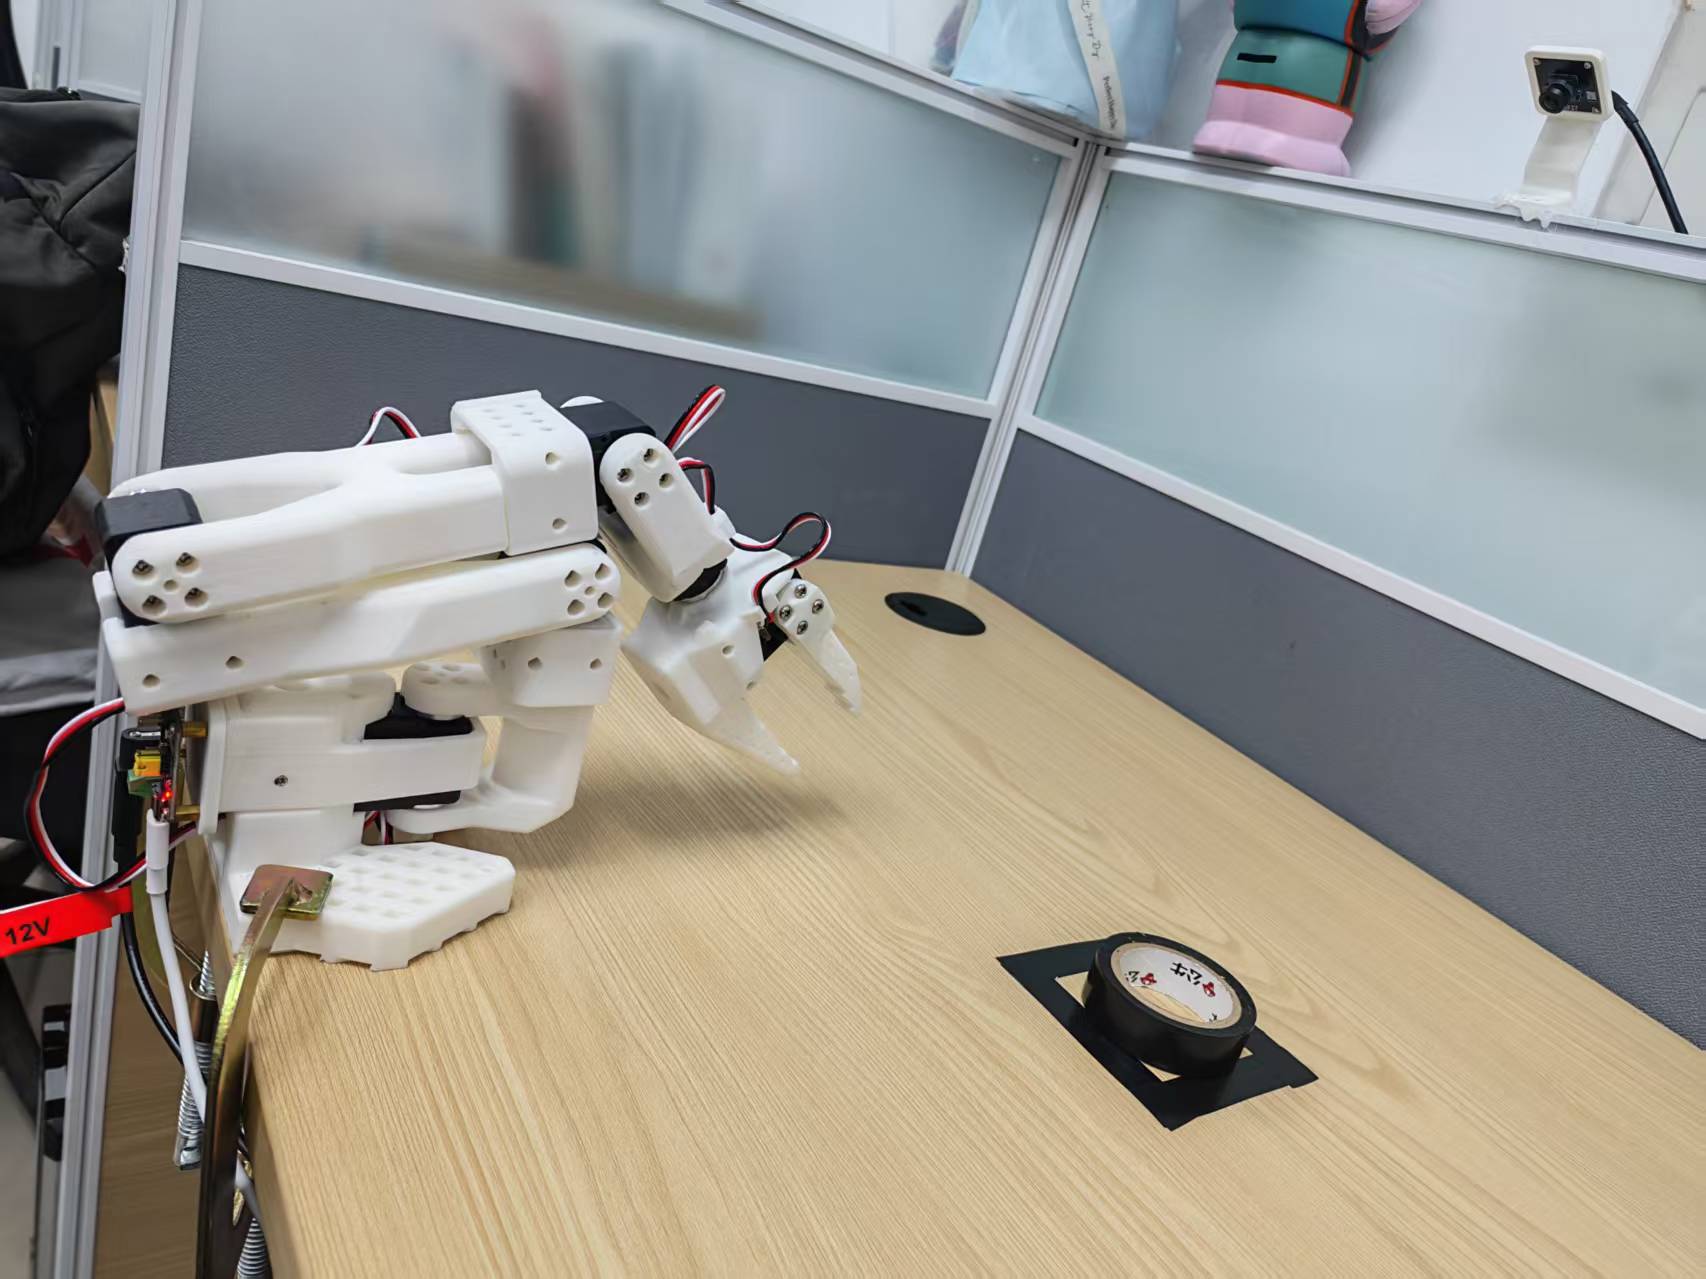
场景由一台俯视摄像头、一个固定目标框与若干个起始点位构成:目标框由黑色胶带缠绕而成,抓取对象为圆柱形黑色胶带卷,起始位置从数个机械臂可达的固定点位中选取
-
任务即标准的 Pick and Place(抓取与放置):把胶带卷从起始点位抓起,搬运并放入目标框内
-
这一场景提供给策略的线索有两条:目标框的位置固定不动,胶带卷只出现在若干已知点位
- 抓取只是前半程,后半程还要把胶带卷放进那个固定的目标框,因此一次完整的抓放要求末端先对准物体、再对准框
-
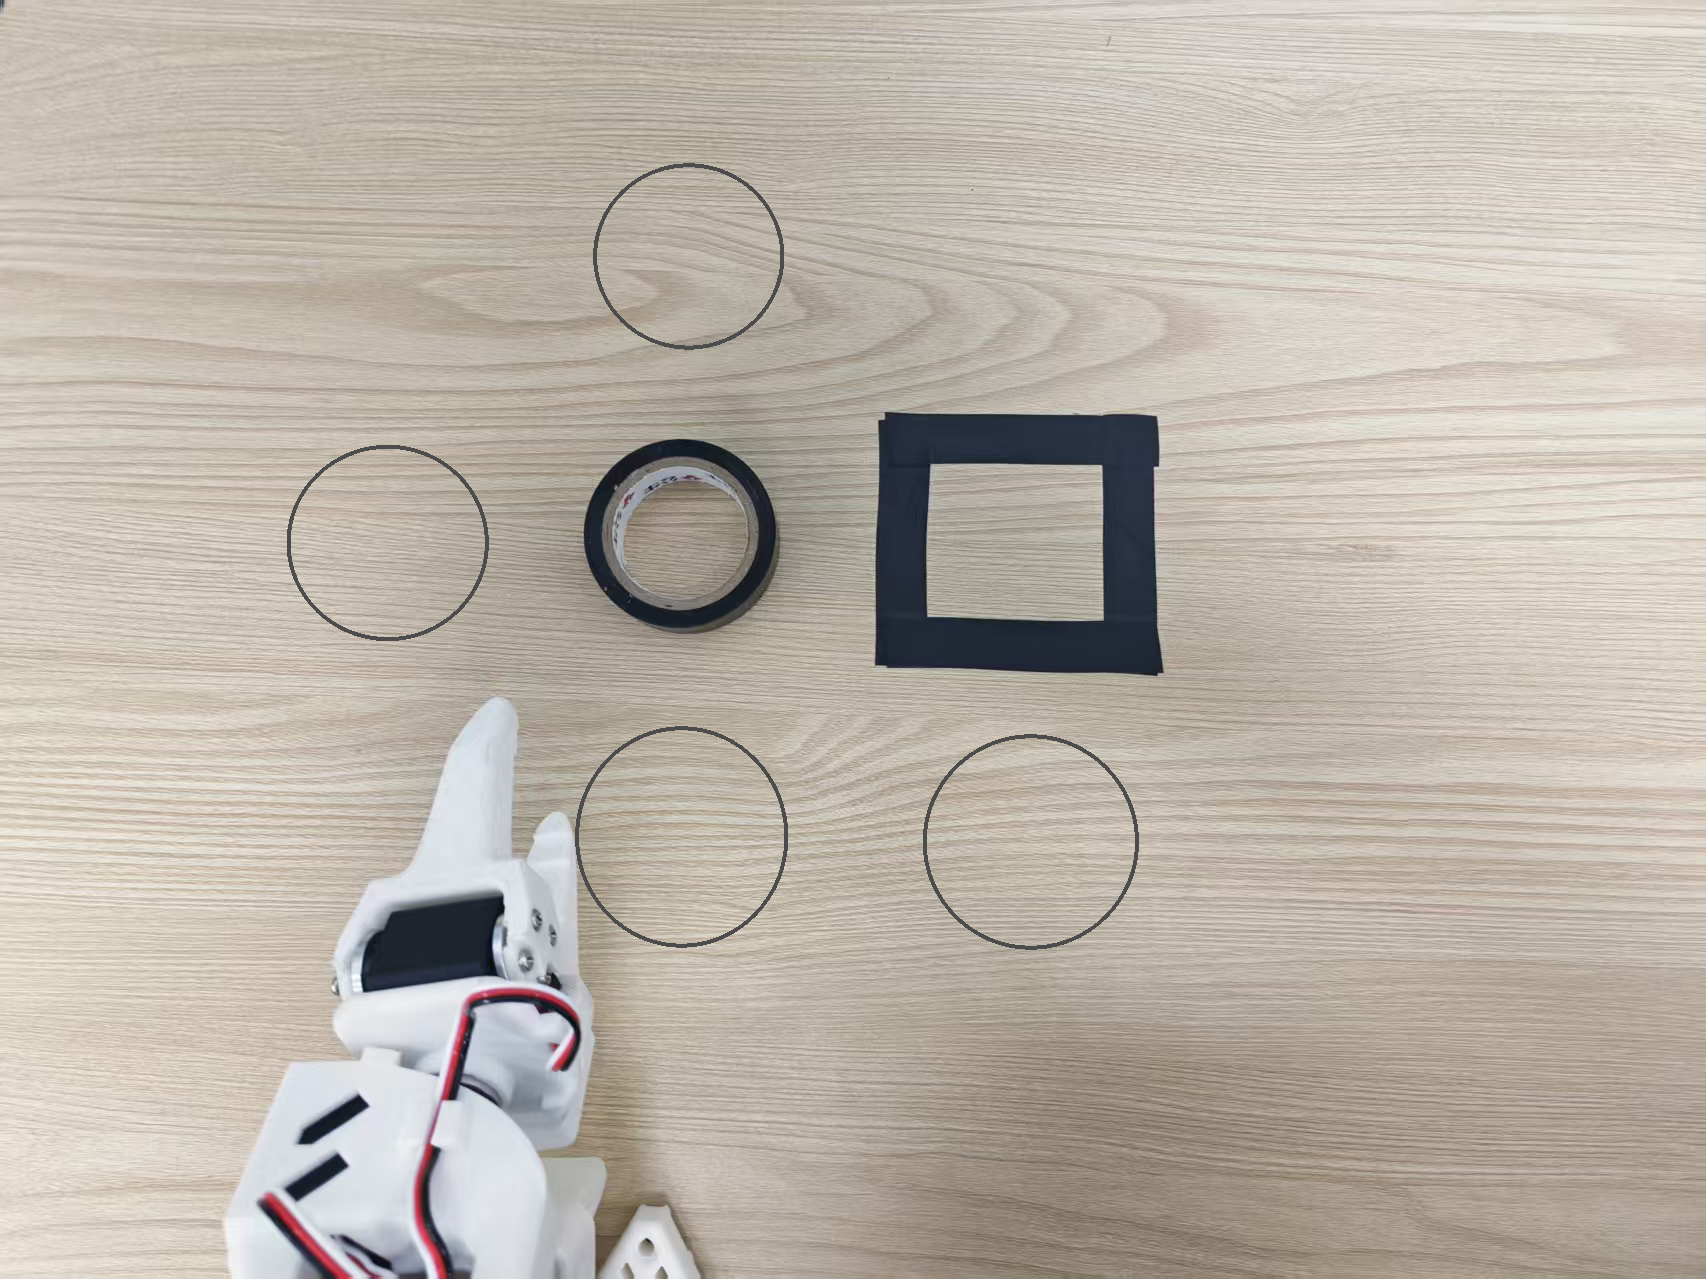
五个固定点位如下图所示:
-
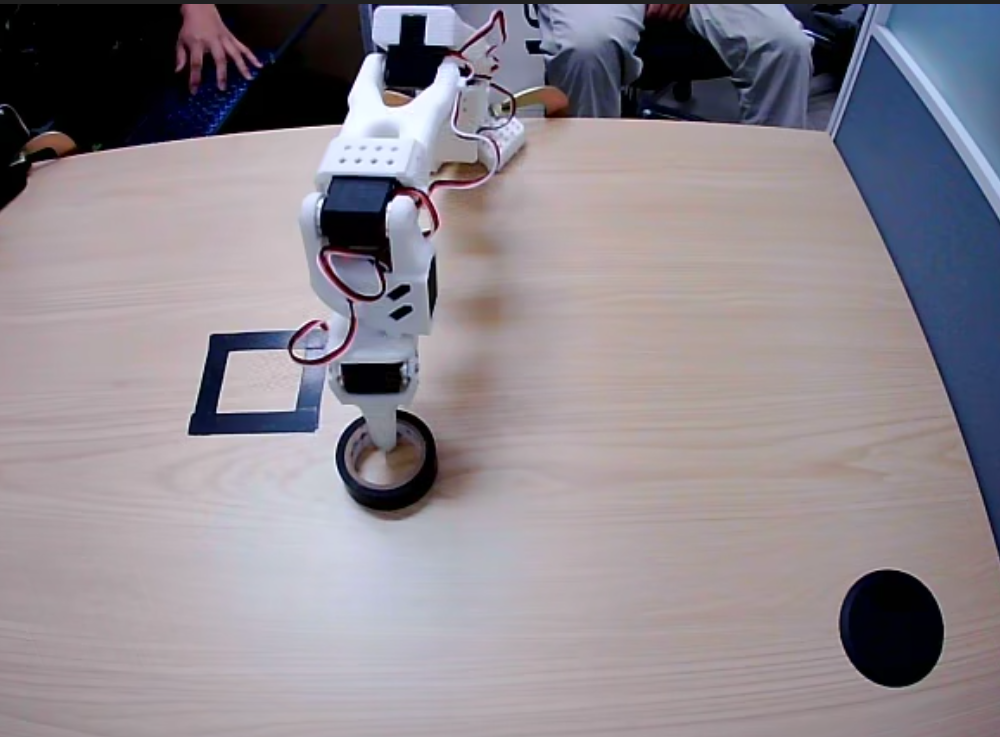
摄像头拍摄到的画面如下:(下图为数据集)
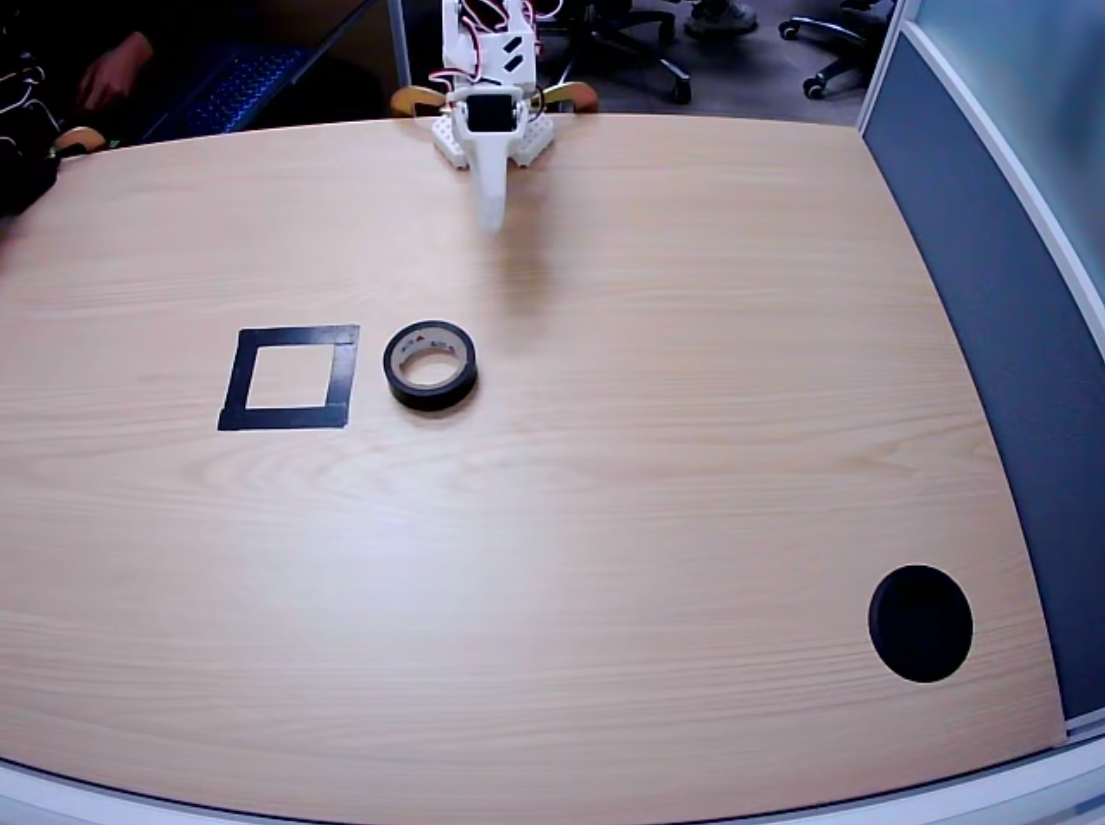
-
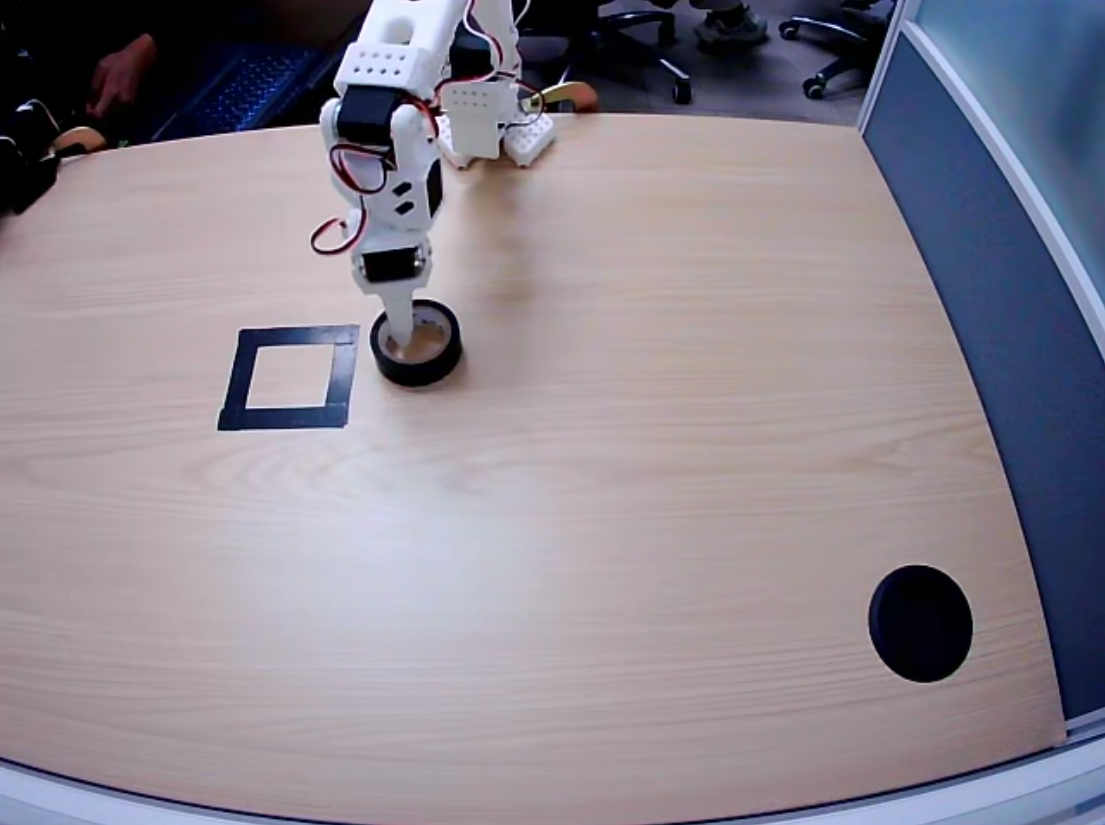
-
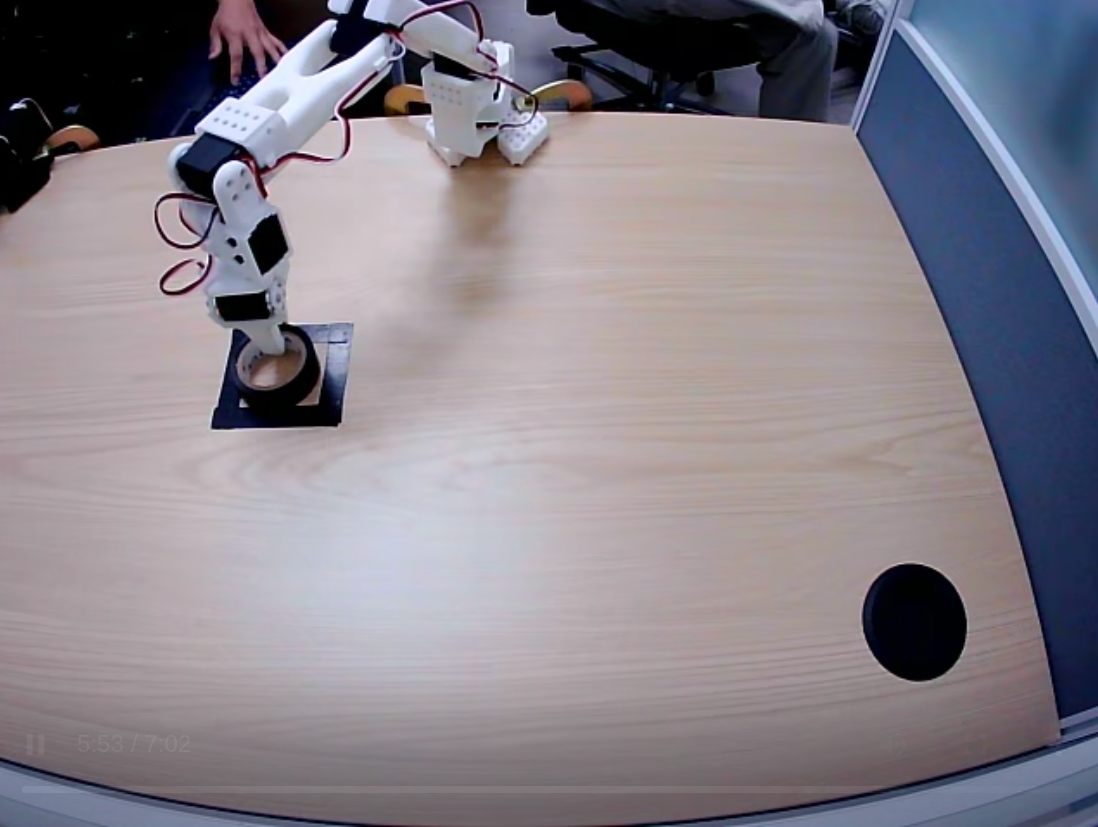
2-3 专家数据采集与任务设计注意事项
需要注意的是,ACT 的内核是模仿学习,CVAE(Conditional Variational AutoEncoder,条件变分自编码器)学到的是给定数据下的策略估计,因此专家数据的选择、观测的构造以及数据的采集方式对最终效果影响极大,本文的实验也充分证明了这一点
- 本文前后共测试了 6 组实验,各组的数据采集方式与专家策略各不相同,在其余超参数完全一致的前提下,只有最后一种配置训练成功,因此这里需要单独说明
- 各组实验的设置与结果如下:
| 实验 | 待抓取物品 | 起点分布 | 夹取方式 | 数据集规模(集) | 训练步数 | 效果 |
|---|---|---|---|---|---|---|
| 1 | 红色长方体橡皮 | 位置与朝向均固定 | 横向夹取 | 50 | 30000 | 可以完成基本任务,起点或终点一变就失效,泛化能力为零 |
| 2 | 透明胶带 | 随机 | 外围夹取 | 50 | 30000 | 成功率不足 5%,无法完成基本任务 |
| 3 | 透明胶带 | 随机 | 外围夹取 | 100 | 80000 | 成功率略有上升,但不超过 10%,且部分位置出现夹空现象 |
| 4 | 透明胶带 | 随机 | 内部随机夹取 | 50 | 30000 | 成功率约 20%,部分位置仍出现夹空现象 |
| 5 | 透明胶带 | 随机(范围收窄) | 内部随机夹取 | 50(单集内多次抓放) | 30000 | 成功率不足 20%;单集录制多次抓放还导致部署时无法判断任务是否完成,即使抓取成功也会持续空抓 |
| 6 | 黑色胶带 | 固定若干点位 | 内部固定朝向夹取 | 50 | 30000 | 各点位成功率约 90%,点位之间的中间位置亦可完成抓取,泛化能力明显提升 |
-
这 6 组实验的差别集中在三件事上:专家数据的起点覆盖范围、夹取时目标是否被末端遮挡、以及单集内是否混入多次抓放
- 实验 6 把前两项分别固定为"若干已知点位"与"不遮挡",并做到单集单次抓放,才得到可用的成功率;这也是 2-4 节录制方案的全部依据
-
实验一:红色橡皮测试
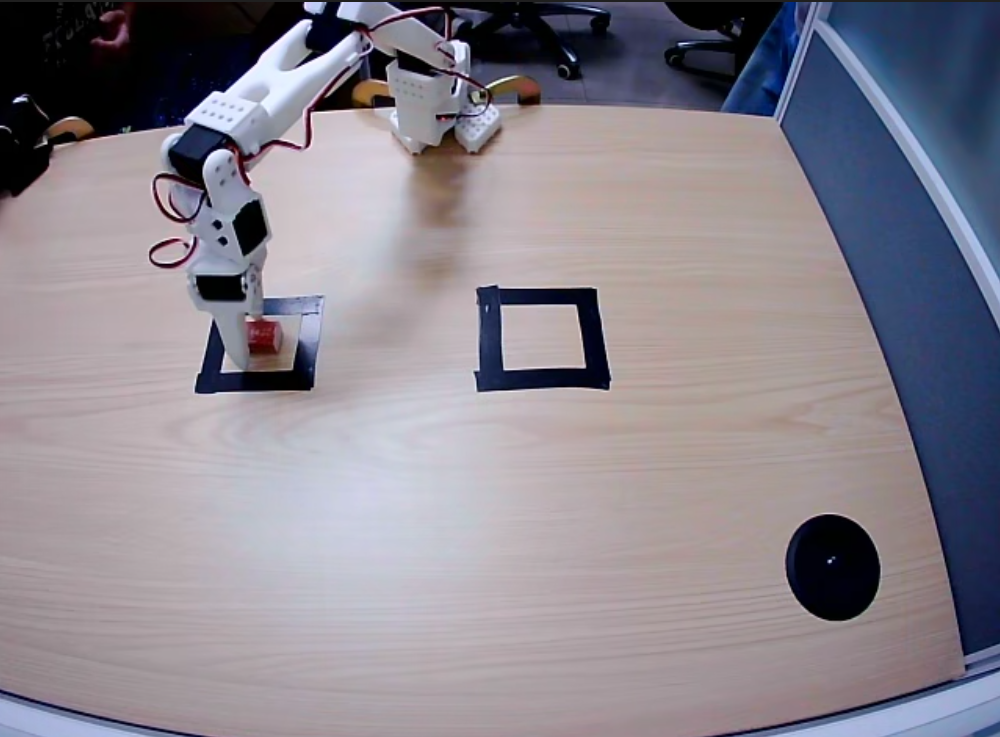
-
实验二:起点随机的透明胶带配合外围夹取策略,抓取时透明胶带几乎被夹爪挡住
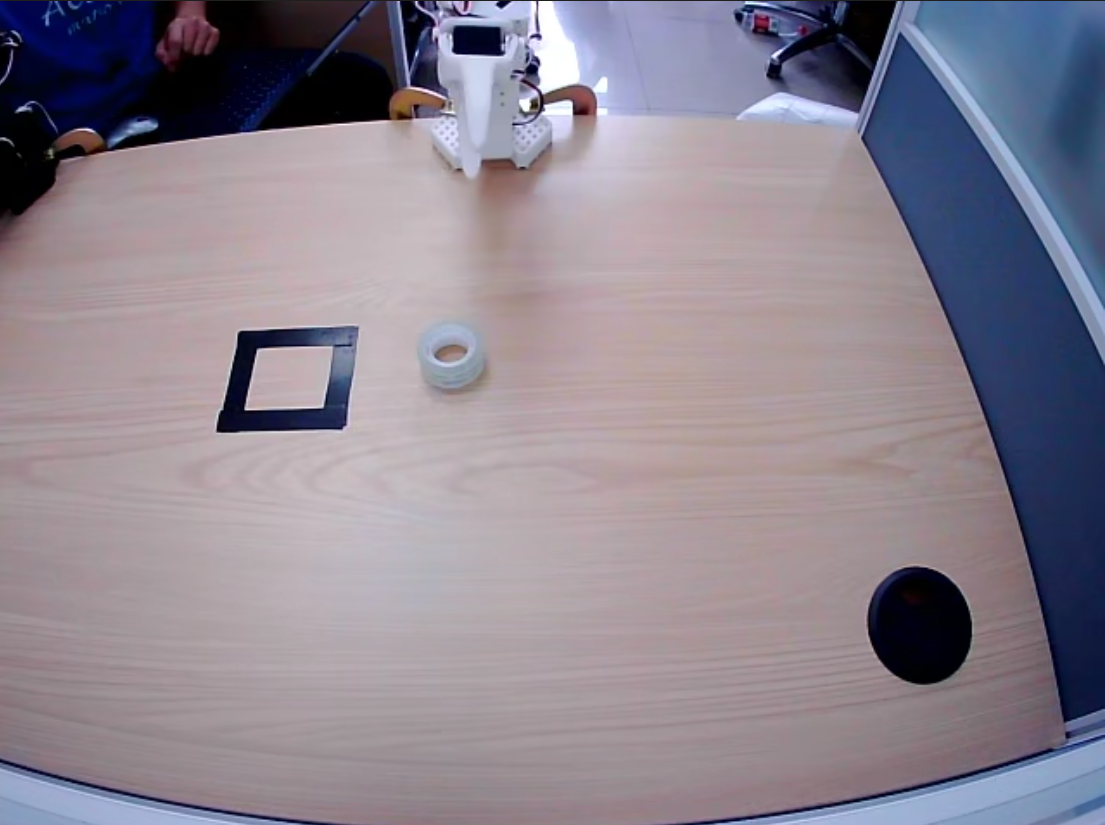
-
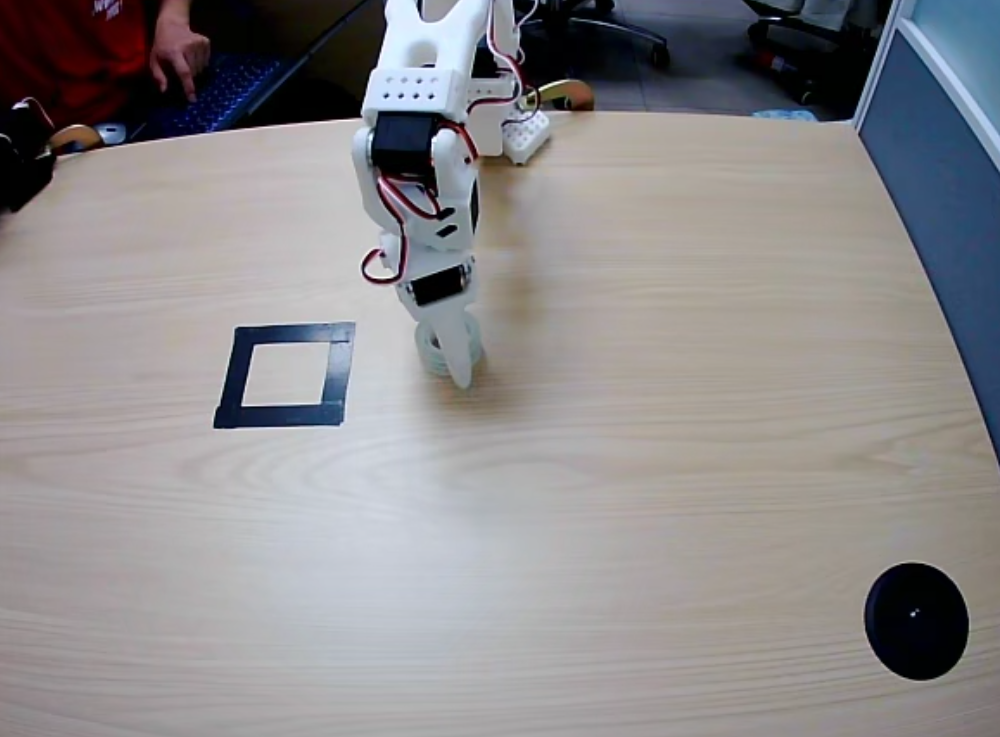
-
实验六:起点固定点位配合黑色胶带,夹取过程不再被遮挡
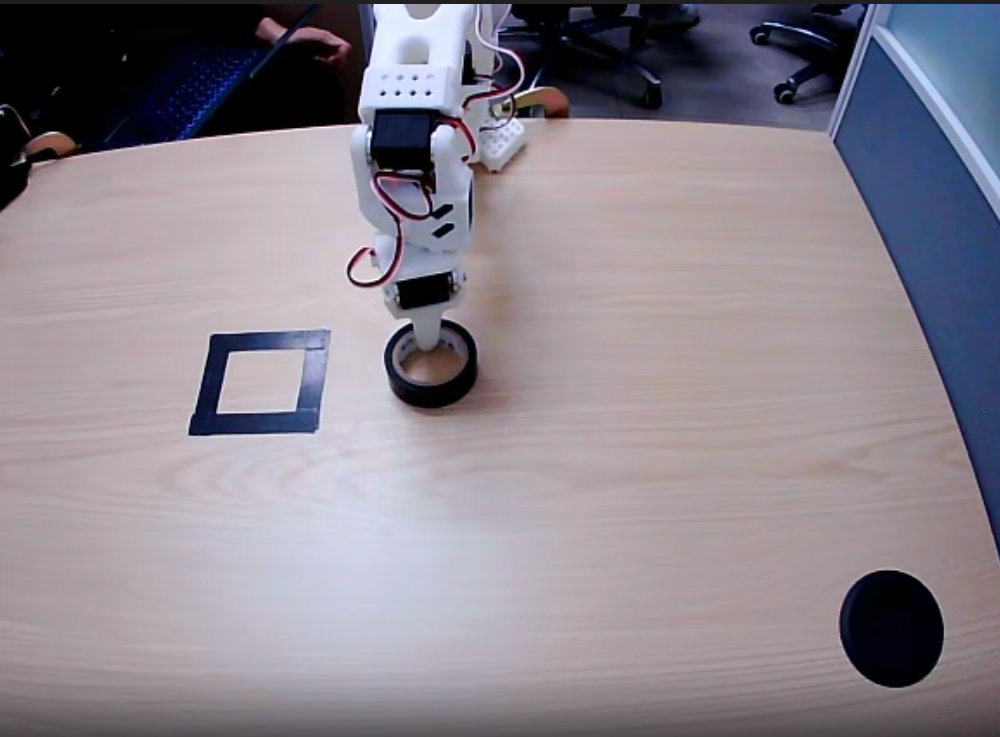
从上述实验不难看出,在不改变网络和观测的前提下,真正影响到最终结果的就是任务的设计和专家的数据采集
2-4 数据集录制
-
使用 Leader 主臂进行遥操作,由操作者控制 Leader 主臂,引导 SO101 Follower 从臂完成胶带卷的抓取与放置任务,并将遥操作过程记录为 ACT 的专家示范数据。
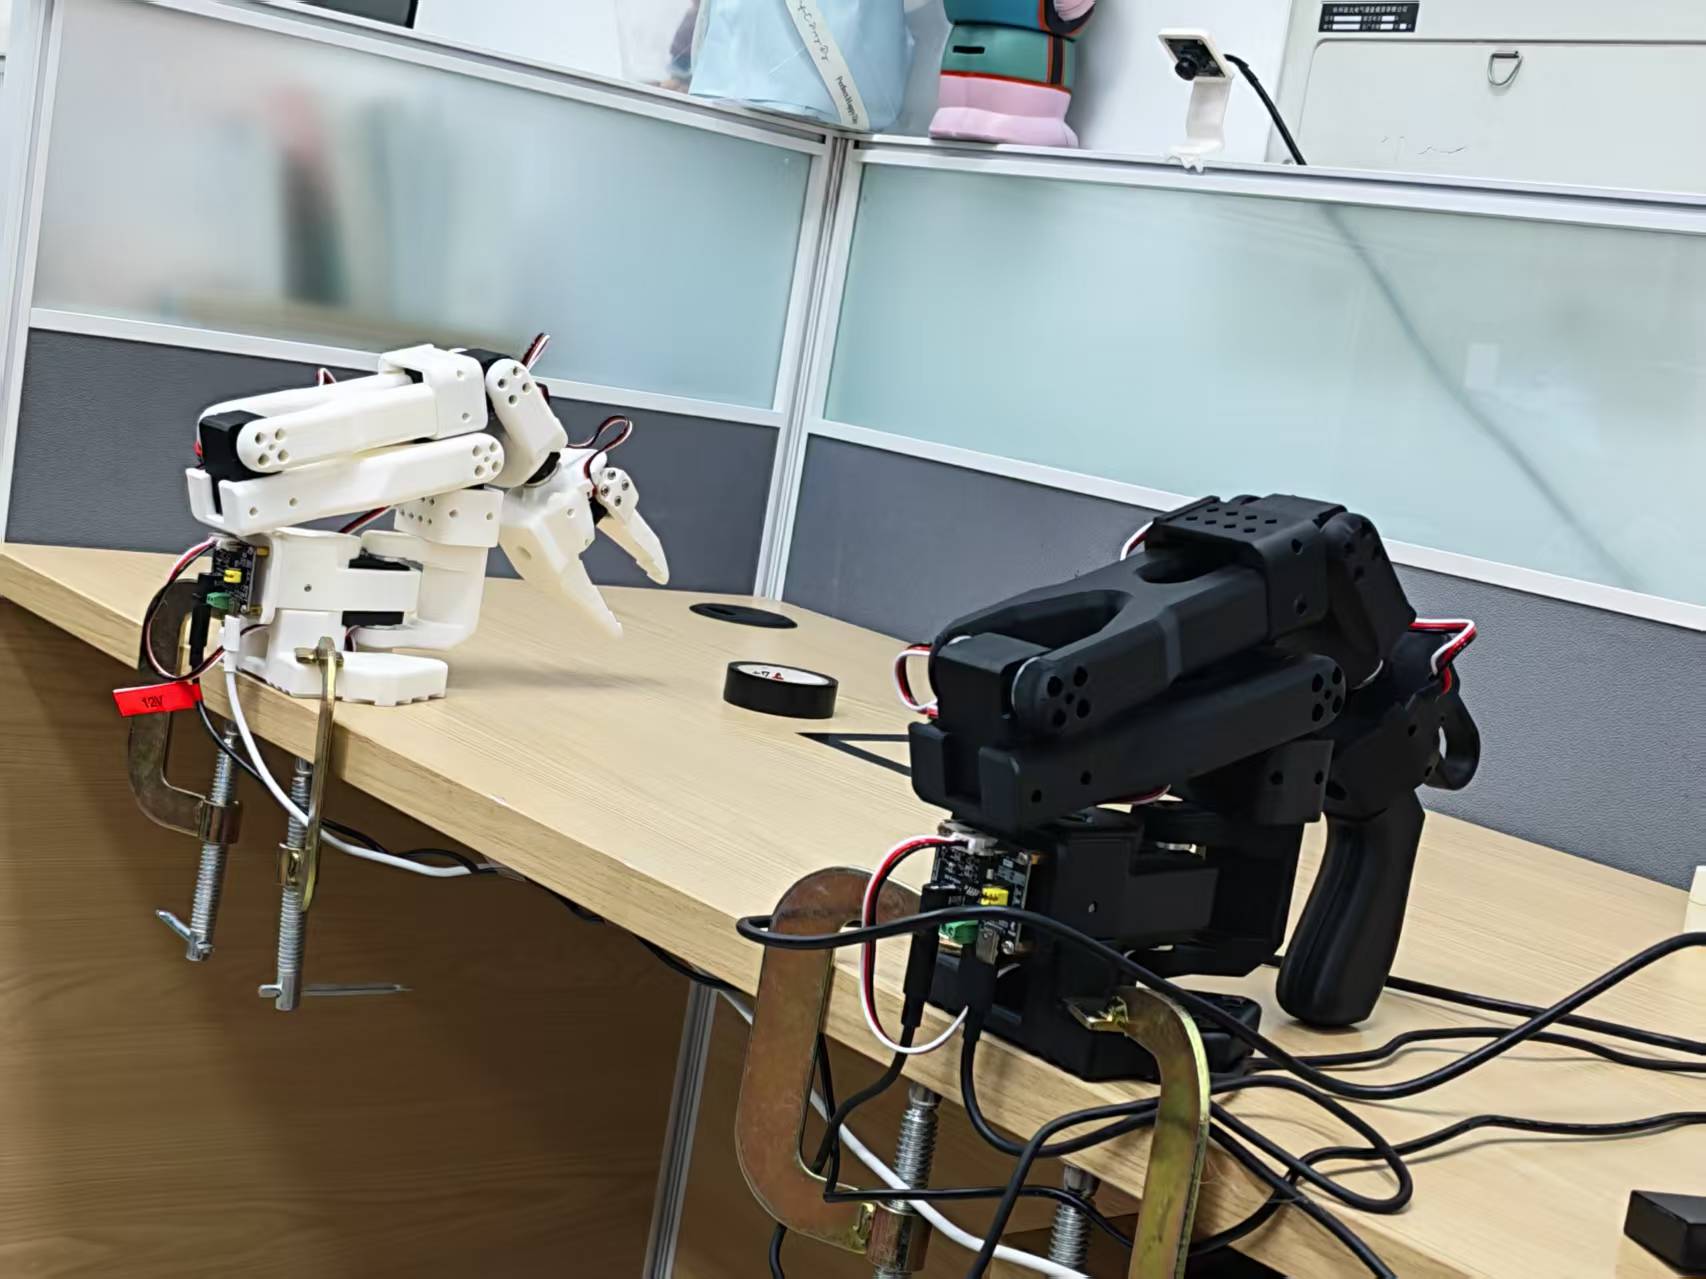
-
在黑色目标框旁固定若干起始点位,每个点位录制 10 条数据;夹取时的姿态需保证图像中能完整看到胶带卷
-
每条数据的起点保持一致,结束时回到初始点位
-
单个 episode 内只录制一次抓放,否则可能导致策略无法判断任务是否结束(参考实验 5)
2-5 训练准备
- 训练前需要把数据集侧的三项信息对齐:集数、总帧数与帧率,它们共同决定训练的规模与节奏;策略侧则确认动作分块相关的两个长度字段
- 数据集侧的字段直接读
meta/info.json即可,与本次训练有关的是以下几项:
| 字段 | 本次取值 | 说明 |
|---|---|---|
total_episodes | 49 | 集数,决定数据的覆盖范围 |
total_frames | 12611 | 总帧数,与批大小共同决定每个 epoch 有多少步 |
fps | 30 | 录制与控制频率,真机推理必须一致 |
| 输入特征 | observation.state(6 维)、observation.images.front(3 通道 480x640) | 六路关节角加一路俯视图像 |
| 输出特征 | action(6 维) | 六路关节目标位置 |
需要注意的是,本次
chunk_size取库默认的100,n_action_steps取50(库默认为100)。后者决定一次前向之后能连续执行多少个控制步,取值受chunk_size约束,两者的关系见 1-5-1 节
3 训练与验证
3-1 介绍
- 前两章把数据与框架都准备好了,这一章是真正的训练与验证
- 训练本身只有一条命令,麻烦的地方在于"参数改了哪个、日志里的数字是什么意思、曲线说明模型在往哪个方向走"
- 所以这一章分四步走:先给出完整命令与参数表,再看训练日志与可视化曲线,然后逐项分析曲线反映的现象,最后把策略部署回真机,用实物结果作为最终判据
- 需要先说明的是,LeRobot 0.6.2 没有 TensorBoard,训练日志只往终端打,想看曲线要走
wandb(Weights & Biases,实验记录平台),下面 3-3 节会具体说
3-2 训练
- 训练入口是
lerobot-train,本次实际执行的完整命令如下:
lerobot-train \
	--dataset.repo_id=local/tape-3.0-pick-and-place \
	--dataset.root=<数据集目录> \
	--policy.type=act \
	--policy.device=cuda \
	--policy.push_to_hub=false \
	--output_dir=<输出目录> \
	--job_name=act_tape-3.0-pick-and-place \
	--steps=30000 \
	--batch_size=8 \
	--num_workers=4 \
	--save_freq=5000 \
	--log_freq=100 \
	--seed=1000 \
	--wandb.enable=true
- 参数配置说明如下,本次一共显式传了 14 项,其余全部走库默认值:
| 参数 | 本次取值 | 含义 |
|---|---|---|
dataset.repo_id | local/tape-3.0-pick-and-place | 数据集的逻辑标识,本地数据集用 local/ 前缀即可 |
dataset.root | 数据集目录 | 数据集实际落在磁盘的哪里,给了它就不用联网拉取 |
policy.type | act | 策略类型,对应第 1-2 节讲过的注册机制 |
policy.device | cuda | 训练设备 |
policy.push_to_hub | false | 必须显式关掉,默认值是 true,不关训完会尝试往 Hugging Face 上传 |
output_dir | 输出目录 | 权重、日志、配置的落盘位置,目录已存在时训练会拒绝启动 |
job_name | act_tape-3.0-pick-and-place | 任务名,只影响日志与记录 |
steps | 30000(实际到 20000) | 总训练步数,一步是一次前向加反向 |
batch_size | 8 | 批大小,同时决定显存占用与每轮步数 |
num_workers | 4 | 数据加载子进程数,这个数据集的瓶颈在视频解码,靠它并行 |
save_freq | 5000 | 每 5000 步存一次 checkpoint |
log_freq | 100 | 每 100 步往终端打一行日志 |
seed | 1000 | 随机种子 |
wandb.enable | true | 把训练曲线同步到 wandb,终端日志照常打;项目名走默认的 lerobot |
- 本次命令里写的是
--steps=30000,实际训练到第 20000 步(因为我磁盘满了绷不住了);按save_freq=5000一共存下 4 个存档,耗时约 60 分钟,平均约 5.5 步/秒 - 这里顺带区分两个容易混用的说法:训练步数(
--steps)指的是每完成一次前向加一次反向算一步,本文所有数量都以步计;训练轮数(epoch)指的是数据集被完整遍历一遍的次数。本次数据集 12611 帧、批大小 8,一个 epoch 约 1577 步,20000 步约等于 12.7 个 epoch,只有比较"数据被看了几遍"时才用 epoch
3-3 forge可视化曲线说明
-
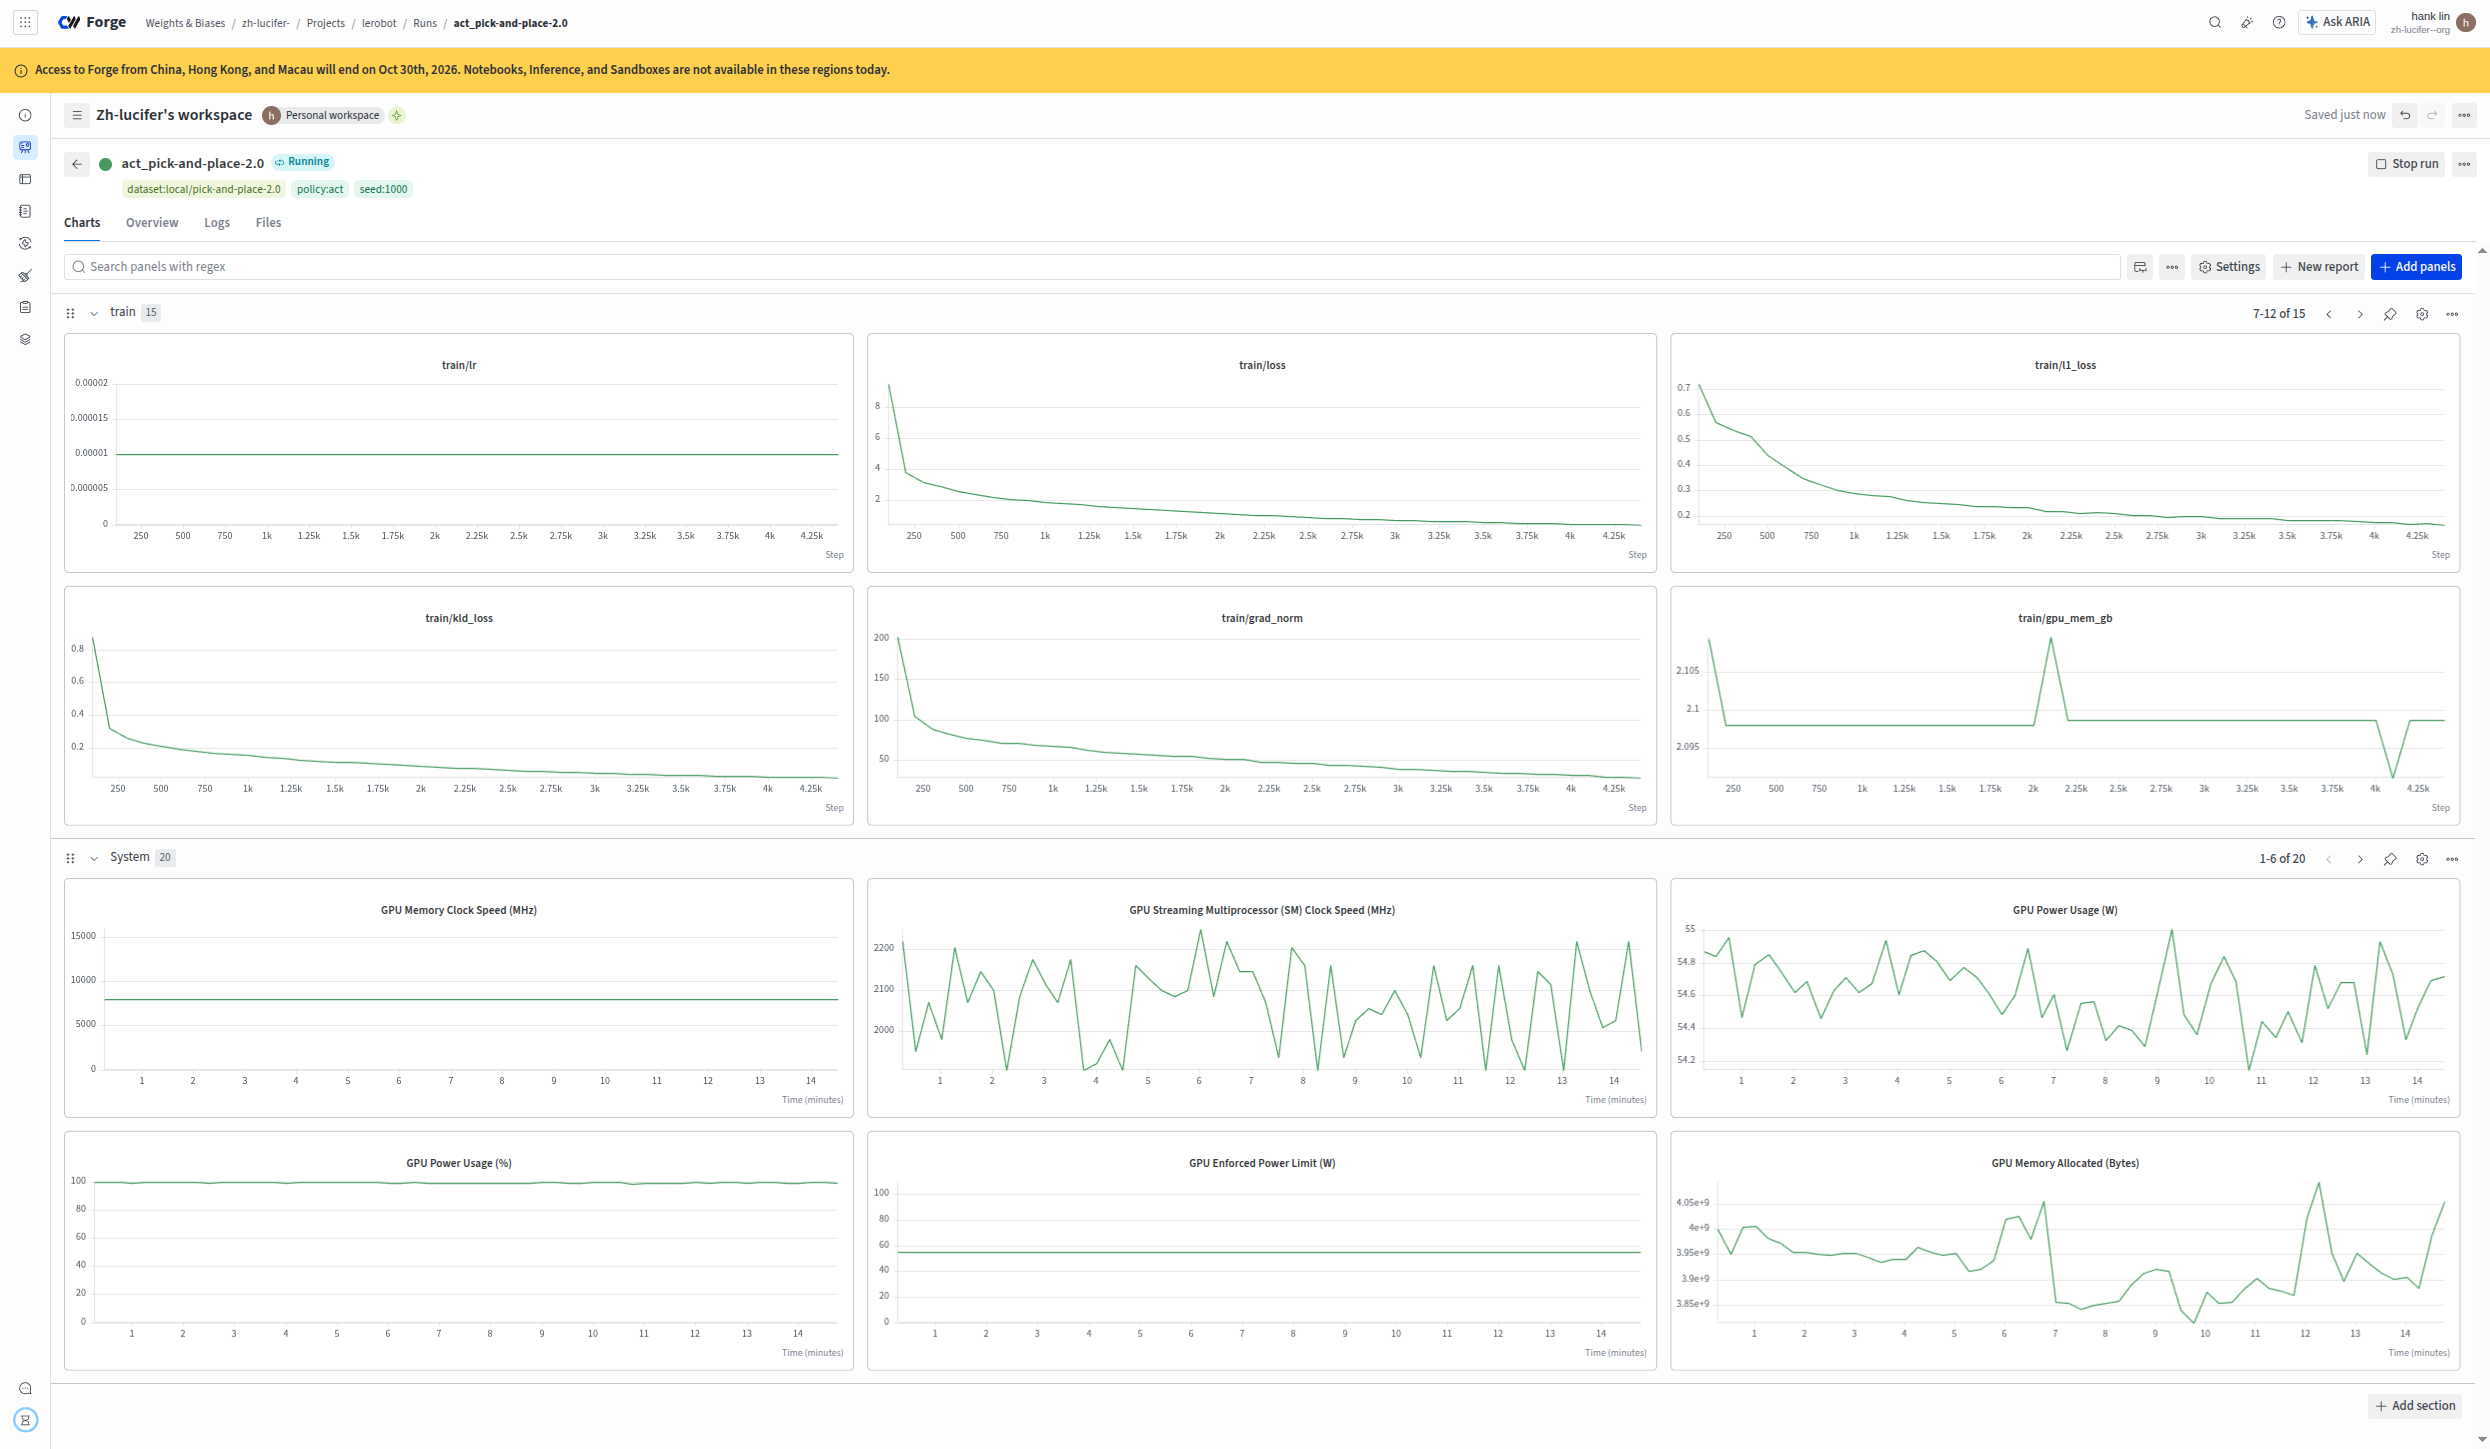
LeRobot 0.6.2 默认将训练日志输出到终端,不提供 TensorBoard 曲线面板。若想可视化训练过程,可通过
--wandb.enable=true启用 W&B(Weights & Biases)记录,本次训练的曲线均来自该次运行。 -
网页端使用 Forge 查看实验记录。首次使用需执行
wandb login,并粘贴授权页面提供的 API Key;登录凭据保存至本地,后续无需重复登录。 -
若不需要上传实验记录,将
--wandb.enable=false即可,仅在终端查看日志。 -
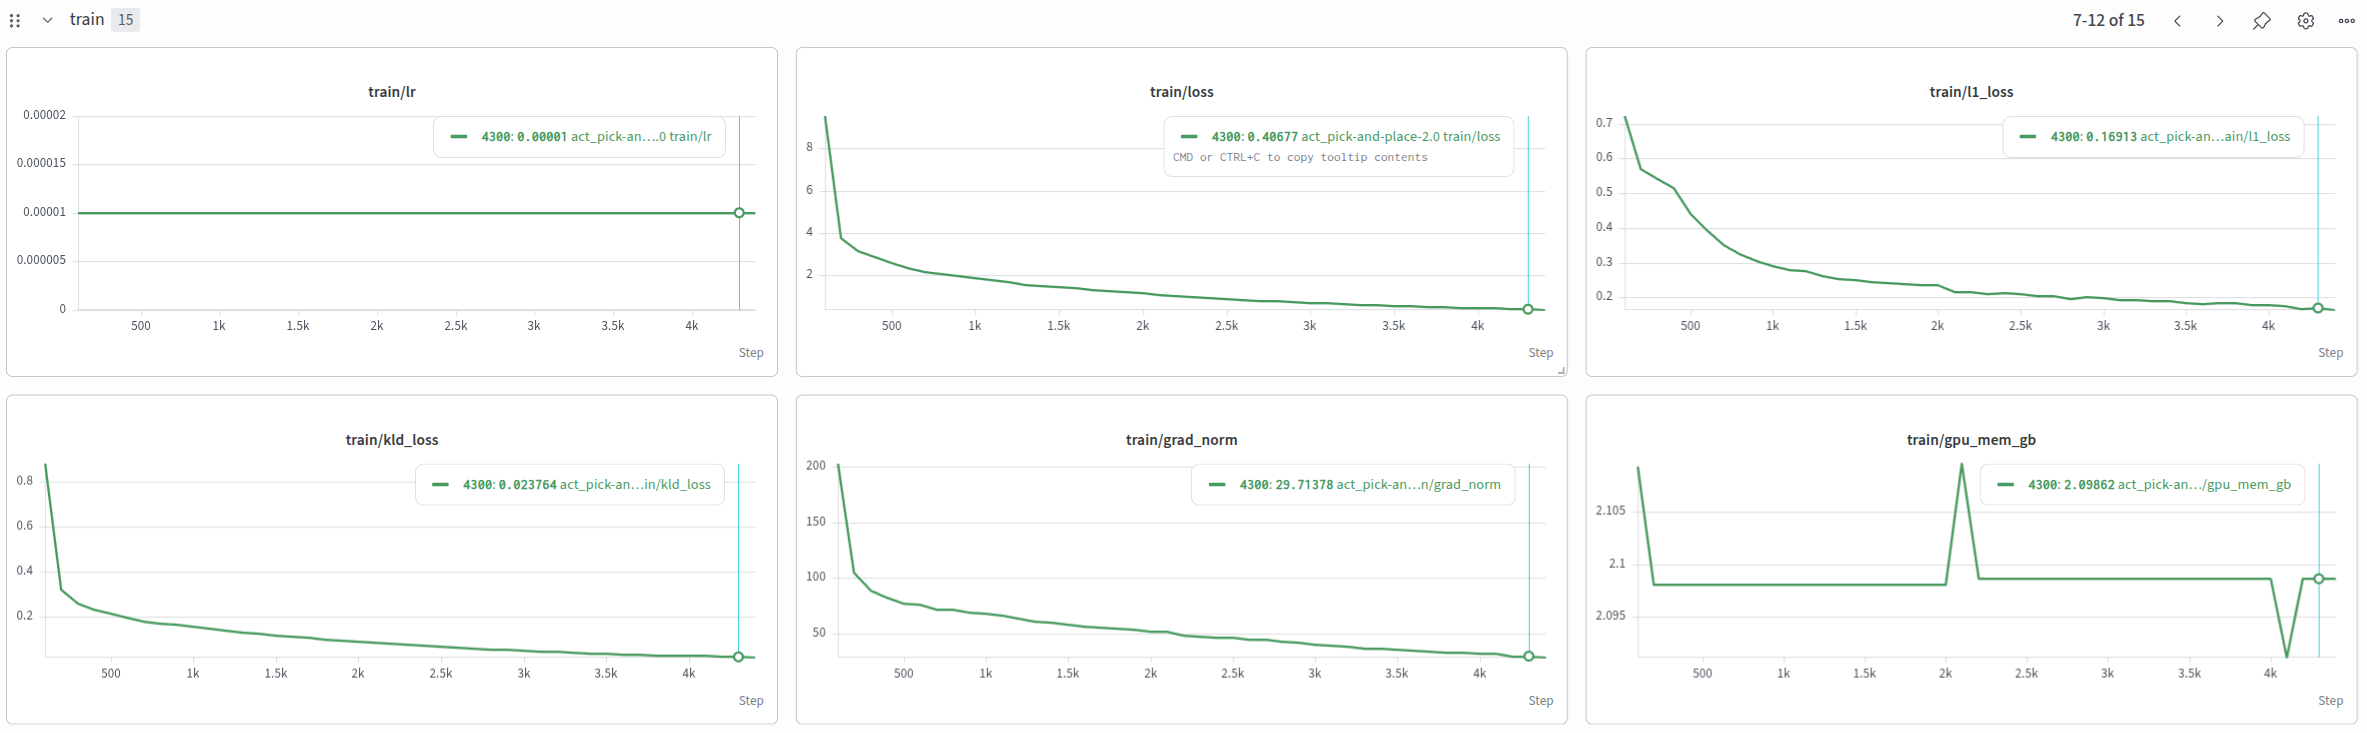
这里主要介绍几条重要的曲线:
-
分别如下:
train/loss:总损失,等于 L1 项加上kl_weight与 KL 项的乘积,是判断"模型还在不在学"的主指标train/l1_loss:预测动作与示教动作的平均绝对误差,它在四项里和真机效果最相关train/kld_loss:VAE 潜在分布与标准正态之间的 KL 散度,用来观察潜在变量有没有被用起来train/grad_norm:梯度范数。本次的裁剪阈值是 10.0,这条曲线如果长期贴着 10 走,说明梯度裁剪几乎每一步都在生效
一般来说在下降就是对的,但是实际训练效果还是得看部署的效果
- 除这四条之外,面板上还有
smp/s、mem_gb这类工程指标,看训练速度与显存占用时会用到 - 下面我们按训练结束后的完整日志,把这四条曲线逐项分析一遍
3-3-1 四条曲线逐项分析
- 下表是几个节点上的读数,取的都是每 5000 步存档的那一步,第一行取第 100 步,因为那时总损失的形状最能说明问题:
| 训练步数 | 总损失 | L1 损失 | KL 损失 | 梯度范数 |
|---|---|---|---|---|
| 100 | 9.186 | 0.721 | 0.847 | 198.96 |
| 5000 | 0.331 | 0.170 | 0.016 | 26.46 |
| 10000 | 0.168 | 0.122 | 0.005 | 17.38 |
| 15000 | 0.125 | 0.101 | 0.002 | 14.01 |
| 20000 | 0.099 | 0.086 | 0.001 | 11.56 |
- 总损失从 9.186 降到 0.099,但降幅分布很不均匀:前 5000 步就走完了 9.186 到 0.331 这一大段,此后每 5000 步的绝对降幅依次为 0.163、0.043、0.026,越往后越小
- L1 损失从 0.721 降到 0.086,是四项里唯一全程单调下降的指标;第 15000 步到第 20000 步这 5000 步只降了 0.015,已经趋于平缓
- KL 损失从 0.847 降到 0.001,下降得比 L1 更早也更彻底,到第 5000 步时只剩 0.016
- 前期总损失掉得快,主要就是 KL 项贡献的:它乘上
kl_weight=10之后,在第 100 步是 8.47,到第 5000 步只剩 0.16,而同期 L1 项才从 0.721 降到 0.170,两项相加正好对上总损失的 9.186 与 0.331 - 也就是说,前 5000 步总损失的下降里 KL 正则项变小占了大头;真正"把动作预测准"这件事,是其后才慢慢磨出来的
- 前期总损失掉得快,主要就是 KL 项贡献的:它乘上
- 梯度范数从 198.96 降到 11.56,全程高于裁剪阈值 10.0,说明梯度裁剪几乎每一步都在生效,只是越到后面越贴近阈值
- 关于 KL 损失,这里需要克制一点:
kld_loss收敛到 0.001,能确定的是潜在分布已经很接近标准正态,KL 正则项在总损失里几乎不再起作用- 但仅凭这一个标量不足以断定后验塌缩(posterior collapse)。要判断塌缩,还要看潜变量的均值是否整体趋近 0、方差是否整体趋近 1,以及各维度的 KL 是否被同时压到接近 0;某一维被压到 0 与整体塌缩是两件事
- 本文只看了终端与面板上的四条总曲线,没有逐维展开,所以这里只表述为"KL 项的贡献已经很小",不下后验塌缩的结论
- 综合起来,本次训练的收益主要集中在前 5000 步,第 15000 步之后 L1 的变化已经有限
- 这是本次任务在这份数据集上的观察,不能推广成"这类任务只需要两万步":第 2 章的表里,实验三用了 80000 步,成功率仍不足 10%,说明步数堆多并不能替代任务设计与数据采集
3-4 实物部署
- 训练只交出权重,最终判据还是真机上能不能把黑色胶带卷抓起来放进黑框里
- LeRobot 0.6.2 里跑策略的唯一入口是
lerobot-rollout,它把第 1-5 节那段闭环整个包好了,需要我们自己填的只有模型、机器人、摄像头三组参数:
lerobot-rollout \
	--strategy.type=base \
	--policy.path=<输出目录>/checkpoints/last/pretrained_model \
	--policy.n_action_steps=50 \
	--robot.type=so101_follower \
	--robot.port=/dev/so_arm_follower \
	--robot.id=my_follower \
	--robot.cameras='{ front: {"type": "opencv", "index_or_path": 2, "width": 640, "height": 480, "fps": 30} }' \
	--fps=30 \
	--duration=30 \
	--task=黑色胶带测试 \
	--display_data=true
- 部署参数有四处需要特别注意:
- 模型路径:
--policy.path应指向checkpoints/<步号>/pretrained_model,即包含config.json的目录。该目录还包含归一化统计量及相关 processor 文件,正确加载后无需单独指定数据集统计量。 - 动作队列长度:
--policy.n_action_steps=50覆盖库默认的100。一次前向仍然预测 100 步动作,但只连续执行前 50 步,队列空了再重新观察、重新预测。取小了跟踪更紧、反应更快,取大了动作更连贯但遇到局面变化时反应更迟;它与chunk_size的关系见 1-5-1 节。 - 摄像头名称:必须与训练时的观测键后缀一致。本次使用
observation.images.front,因此部署时应使用front,不能随意改成camera或cam0。 - 运行策略:
--strategy.type=base表示自主运行,不录制轨迹;episodic则支持记录执行过程,需额外配置数据集参数。
- 模型路径:
说人话:
base是"让它自己干,我们只看",episodic是"让它自己干,顺手把过程录下来"
- 与
lerobot-replay不同,策略部署属于闭环执行:- 机械臂根据实时图像和关节状态持续预测动作,不会自动移动到示范数据的起始姿态。
- 因此,开跑前应将机械臂、目标物体和摄像头摆放在与训练场景相近的位置。
- 安全注意事项:
- 开跑前确保急停和电源触手可及;使用
--robot.max_relative_target限制单步关节目标变化; - 退出时注意默认的回位行为,桌面存在障碍物时应根据实际版本配置关闭自动回位。执行期间可按
Ctrl+C中断。
- 开跑前确保急停和电源触手可及;使用
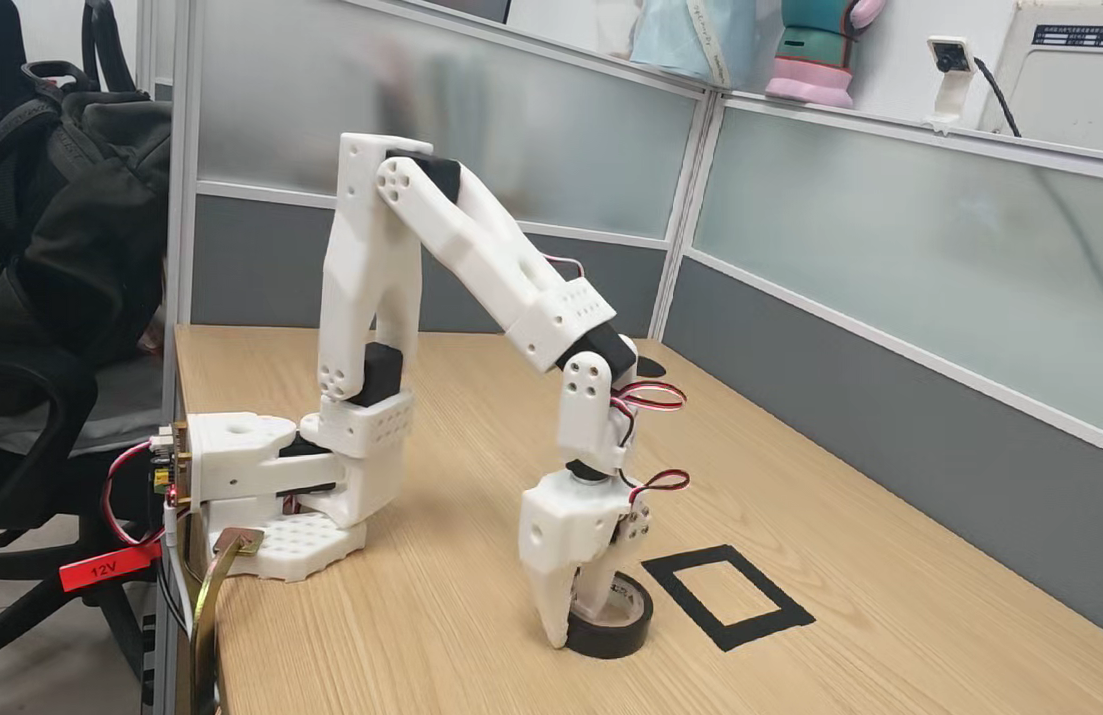
- 效果如下,在几个固定点位下对于黑色胶带的夹取都十分成功:
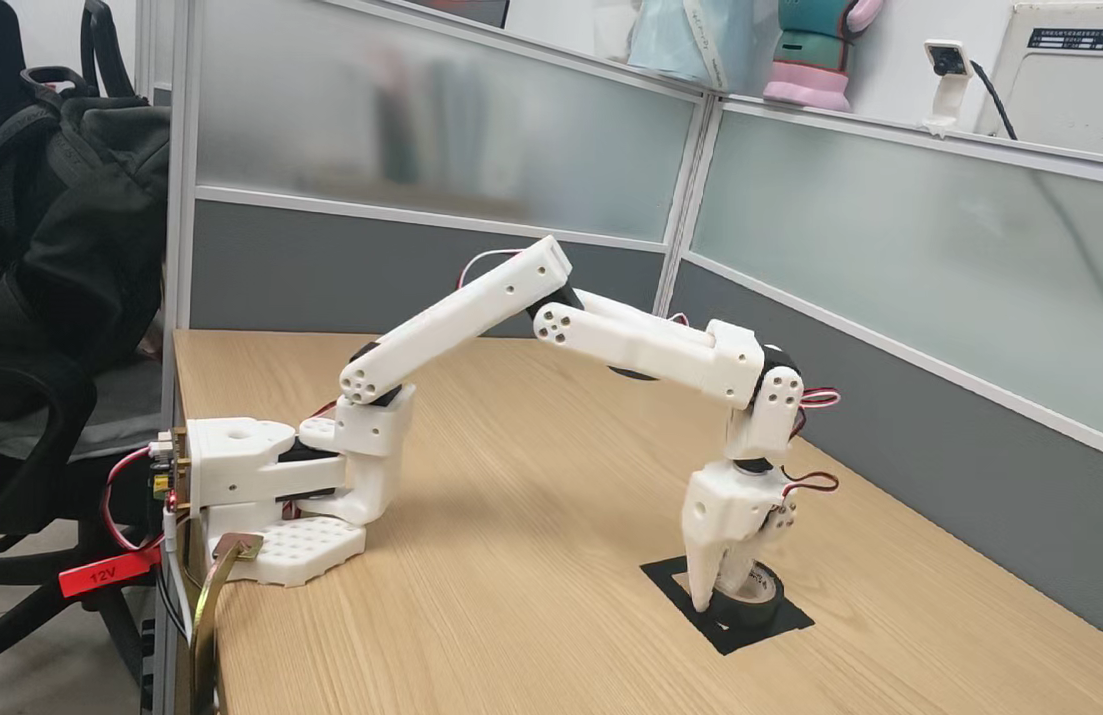
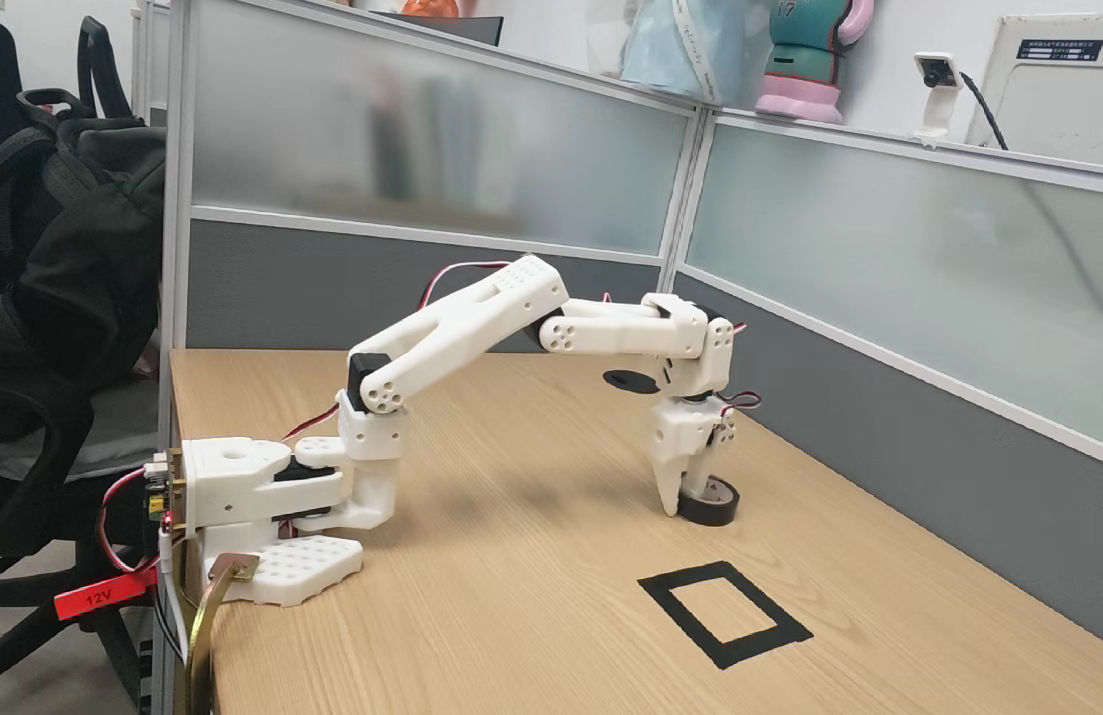
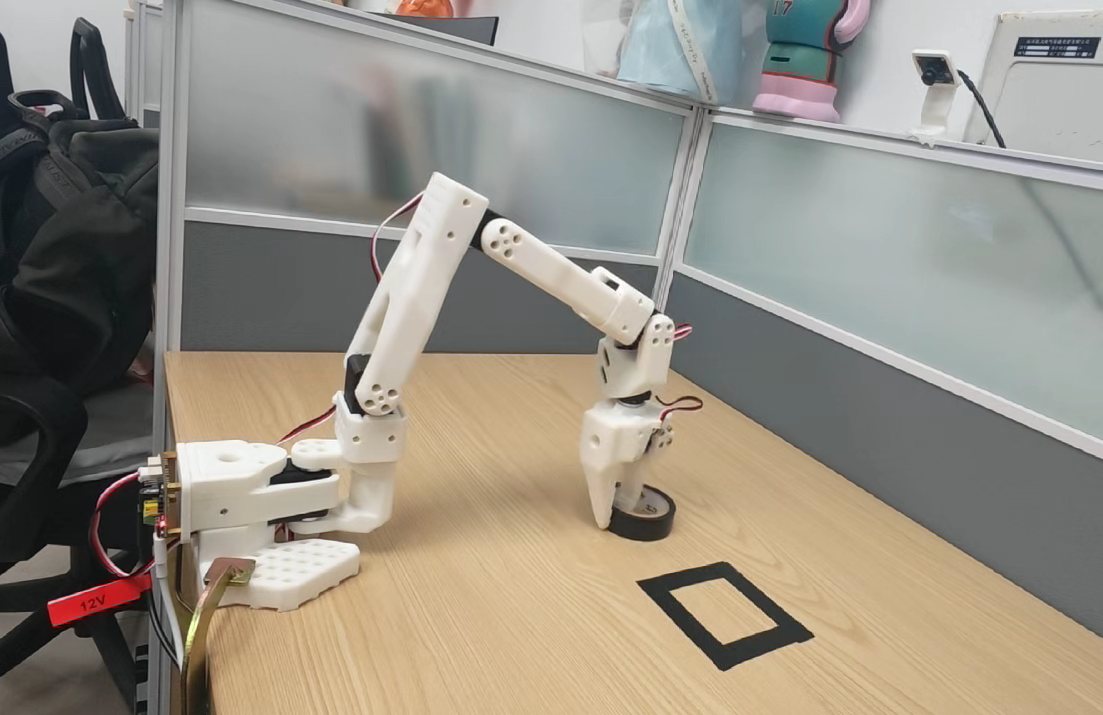
- 下图是 Rerun 可视化界面,启动命令添加
--display_data=true即可显示。界面实时展示策略接收到的摄像头画面,以及机械臂关节状态与策略输出动作。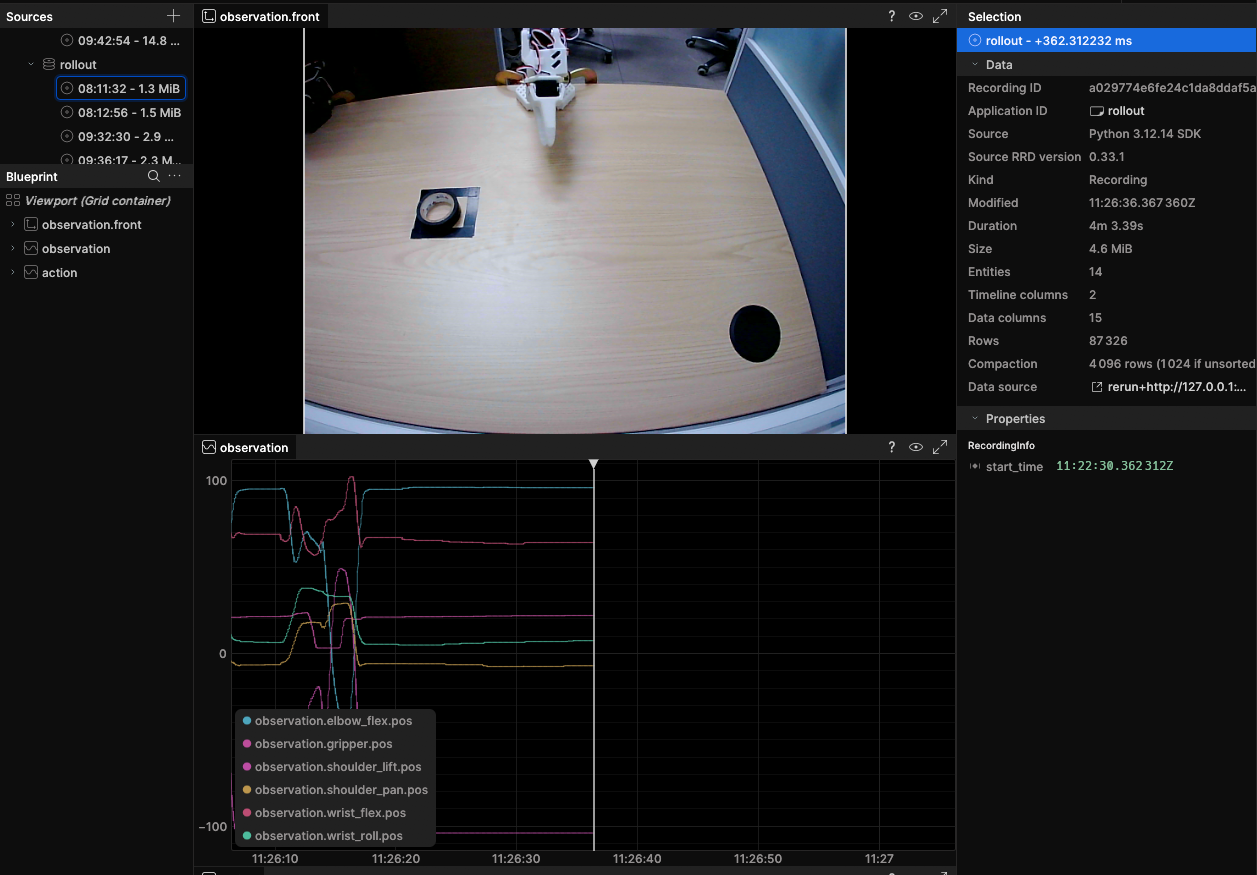
3-5 调试总结
- 任务设计与数据采集至关重要。 透明胶带的视觉特征不明显,单路俯视摄像头也容易因机械臂遮挡而丢失目标信息;若起始位置、物体姿态等变化过于分散,有限的示范数据便难以覆盖任务所需的状态分布,影响策略学习效果。
n_action_steps最终取50(chunk_size取库默认的100)。该参数决定每次策略推理后连续执行的动作步数,需要结合动作连续性与实时反馈需求进行调整。- 动作曲线的锯齿与突跳要分头排查。 现象看着都是"不平滑",来源却可能完全不同,至少包括这几条:相机取帧延迟或掉帧让观测本身在抖;策略一次预测一整段
chunk_size=100的动作,块与块衔接处会出现步进;n_action_steps=50意味着每 50 个控制步才用新观测重规划一次,间隔越长越跟不上局面变化;控制频率与录制频率是否一致;以及关节在低速、小位移下的执行抖动。把这些逐项对照过,再决定是改损失、改队列长度还是改采集方式,而不是一上来就归因于摄像头延迟或掉帧——它们只是可能原因之一。 - 动作平滑度优化:
- 修改损失函数:在原有 ACT 损失函数中加入动作平滑度约束,惩罚相邻时刻动作的剧烈变化,提升执行连续性。
- 优化专家示范数据:遥操作采集时尽量保持动作连贯,减少关节目标突变与不必要的停顿,让模型学习更平滑的动作模式。
总结
- 本文基于 LeRobot 框架的源码结构,系统梳理了其核心模块与训练流程,并结合 ACT 算法在 SO101 机械臂上的实际应用,完整介绍了从策略原理与源码实现、专家示范数据采集、模型训练到真实机器人部署与实验验证的全过程。
- 核心要点回顾:
- LeRobot 把 ACT 分成
ACTPolicy与ACT两层,前者管动作队列、损失与保存,后者只管张量进出,训练损失就是 L1 项加kl_weight乘 KL 项 - 动作分块不是模型内部的额外机制,它在数据层靠
delta_timestamps实现,action_delta_indices返回的 100 帧未来动作就是"答案" - 推理循环里,
build_inference_frame与make_robot_action是策略与机器人之间的两个翻译层,它们与训练侧的归一化流水线必须成对使用 select_action内部是长度为n_action_steps的动作队列,本次取 50,网络大约每 50 个控制步才真正前向一次,被摊薄的是前向次数;端到端节拍还要看相机取帧与串口那几段- 本次训练 20000 步约 12.7 个 epoch,总损失从 9.186 降到 0.099,其中前期下降主要来自 KL 项
kld_loss收敛到 0.001,能确定的是 KL 正则项的贡献已经很小;仅凭这一个标量不足以判定后验塌缩,还要结合潜变量的均值、方差以及各维度 KL 的分布来看。grad_norm全程高于裁剪阈值 10.0,说明梯度裁剪一直在生效- 第 15000 步到第 20000 步之间 L1 只从 0.101 降到 0.086,收益已趋于有限;这只是本次任务在这份数据上的观察,不能推广为其他任务也只需要两万步
- 本次没有验证集,训练损失只能说明模型在拟合这 49 集,真机结果才是最终判据
- 部署要记住三点:
--policy.path指向pretrained_model那一层、摄像头名字等于观测键后缀、base策略不能同时带--dataset.*参数
- LeRobot 把 ACT 分成
- 如有错误,欢迎指出!感谢观看!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献28条内容

所有评论(0)