告别参数内卷,具身智能的下半场拼实景闭环
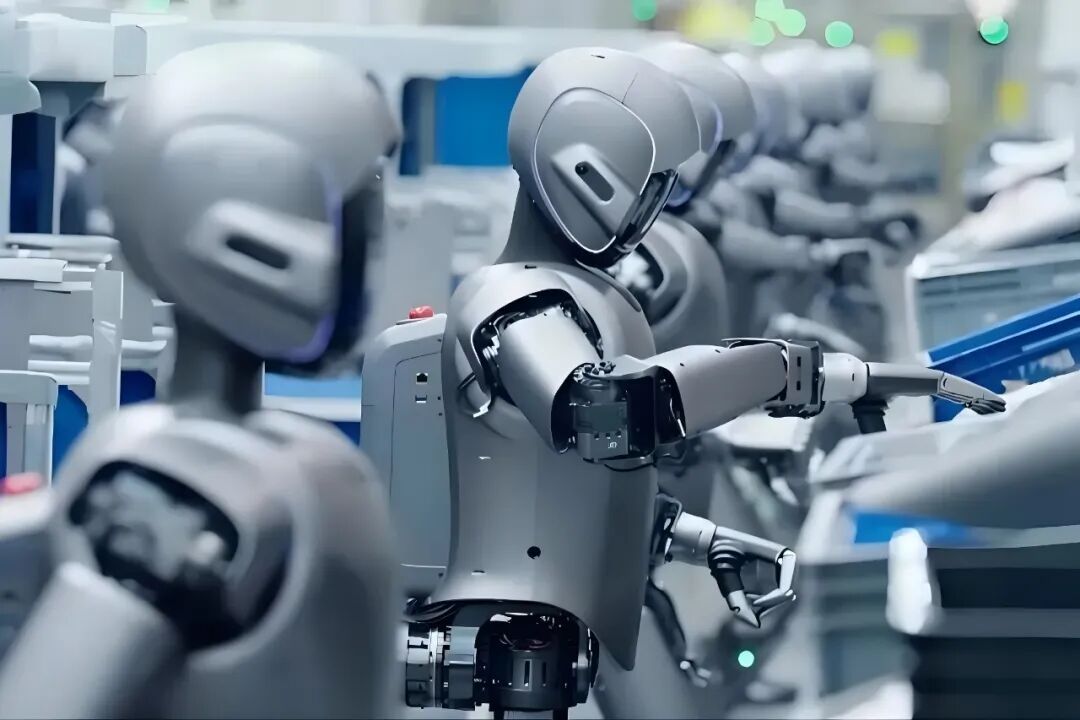
过去几年,具身智能最容易被看见的进步,几乎都发生在“动作”上。灵活的肢体动作、流畅的动态平衡、花样百出的功能演示,让机器人一次次站上舆论和融资的风口。很长一段时间里,行业默认的成功逻辑非常简单:视觉效果足够惊艳,就能获得市场的掌声。
但进入2026年,这套光鲜的叙事彻底失灵。市场的关注点已经完全转移,不再迷恋一次性的技术秀,而是开始关注:换一个环境还能不能做?连续执行几十次之后,成功率是否还能保持?遇到没有训练过的物体,系统会如何反应?一旦模型出现失误,下一轮优化究竟该从哪里开始?
这不是行业降温,而是具身智能正式从实验室时代,迈入产业落地时代。行业竞争的重点,正在从“做出一个能力”,转向“能否持续生产新的能力”。而这背后,需要解决的已经不只是模型问题。
行业最大误区:有数据不代表有能力
实验室里的成功,与商业场景里的可用,中间往往隔着很长一段距离。
如今很多数据依旧诞生于虚拟仿真环境,由算法批量生成,逻辑完美却脱离物理世界的复杂变量;很多数据来自受控实验室场景,环境干净、干扰可控,只能适配标准化演示,无法应对真实作业的不确定性;还有大量数据来自零星试点,覆盖场景有限、样本结构单一,完全不具备通用迭代价值。
这类数据可以撑起一场漂亮的技术展示,却撑不起一次稳定的商业交付。根本原因在于:它们都是静态的、孤立的、终止于采集环节的样本,没有形成产业级的迭代闭环。
真正支撑具身智能持续进化的核心能力,是一套完整的正向循环链路:从真实产业场景获取原生作业数据,依托实景样本完成模型迭代,将优化后的设备重新投入一线使用,再用落地过程中的真实反馈,反哺下一轮技术升级。
脱离这套循环,所有数据都只是无效存量。只有跑通闭环,数据才能变成持续驱动产品进化、适配产业、降低成本、提升稳定性的核心竞争力。
落地难点在哪?直面这三道产业壁垒
所有人都清楚,真实场景数据是赛道决胜的关键。但为何全行业能真正落地实景闭环的企业屈指可数?因为实验室理想化迭代,是低成本、高可控的捷径;而真实产业落地,要直面三道无法规避的硬核壁垒。
首先是人机适配壁垒。一线产业场景的核心诉求是效率与实用,不接受任何形式的“实验性妥协”。传统数据采集设备笨重、繁琐、成本高昂,既增加工人作业负担,也提升企业落地成本。无法被一线人员接纳的设备,注定无法走进真实场景,从源头失去了获取有效数据的资格。
其次是规模化壁垒。技术落地的价值,永远藏在规模化里。如果采集方案无法轻量化、无法普及、无法融入现有作业流程,数据积累就只能停留在小范围测试阶段。样本厚度不足、场景覆盖不全,模型永远跳不出“演示水平”,无法适配复杂多变的全域产业场景。
最后是工程化壁垒。这是2026年行业最清醒的现实:实验室环境打磨出的模型,天生带着“场景滤镜”。脱离理想化环境后,面对现场干扰、人工差异、突发工况,稳定性和容错率会大幅下滑。没有实景持续迭代的模型,参数再先进,也只是不接地气的空中楼阁。
核心认知鸿沟:具身智能无法复制大模型的成功路径
行业长期存在一个致命认知误区:将具身智能等同于多模态大模型的延伸,试图复刻语言大模型的迭代模式。但二者的底层生长逻辑,完全截然不同。
语言大模型的训练底座,是人类数千年沉淀的标准化数字文明成果。文字、文档、代码、资料天然可存储、可复制、可批量训练,能够低成本实现海量数据积累与模型跃迁。
而具身智能学习的,是人类物理世界的实操经验。流水线的操作节奏、仓储分拣的动作逻辑、物业环卫的作业规范,这些藏在产业一线的实操经验,碎片化、场景化、经验化,没有统一数字格式,无法自动沉淀、无法直接复用。产业现场是生产载体,而非数据工坊,不会主动产出适配机器人训练的标准化样本。
这就决定了具身智能赛道的核心刚需:行业需要一套成熟的转化体系,把人类无形的作业经验、有形的肢体动作、动态的场景判断,统一转化为机器人可感知、可学习、可迭代的标准化数据资产。
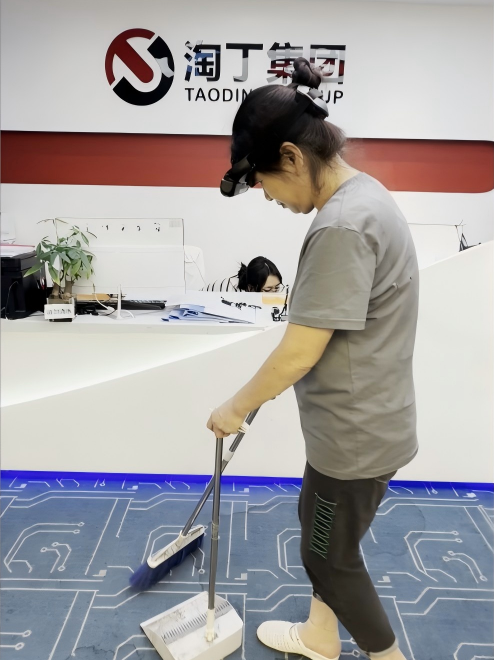
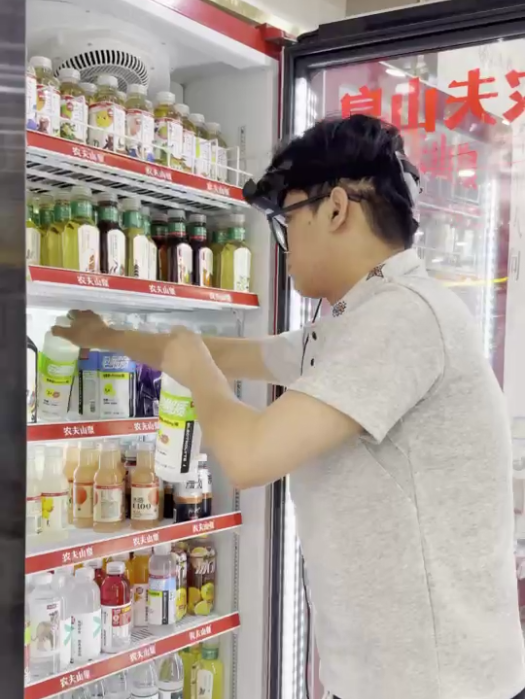
在行业普遍走捷径、依赖仿真数据与实验室演示的当下,淘丁数科扎根真实作业现场,摒弃表演式采集和虚拟数据堆砌,依托轻量化、高适配的落地方案,才能让数据积累融入常态化作业,实现真实场景的规模化、持续性数据迭代,为具身智能夯实底座。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献10条内容

所有评论(0)