基于LeRobot的SmolVLA训练与LIBERO仿真评测
SmolVLA
SmolVLA主要是由一种紧凑的视觉语言模型(VLM)组成,丢弃最后L-N层,剩余层嵌入三种输入:语言指令、RGB图像以及机器人感知运动状态。合并后的token输入到动作专家模块中(Action Expert),该模块主要由交叉注意力和自注意力组成,并使用流匹配的方式进行训练,以输出低级动作块。SmolVLA在公共社区数据集LeRobot上预训练,低成本机器人上进行评估。
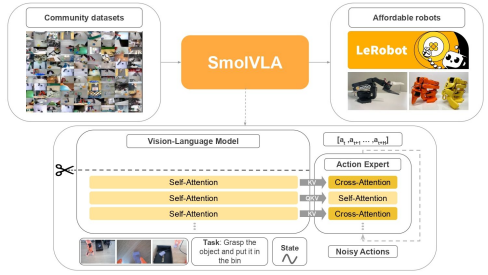
图1 SmolVLA模型架构
模型的主要特征:
- 轻量化模型架构:SmolVLA的轻量化模型架构体现在VLM跳过了中间层,使用少量的视觉token,并利用小型预训练VLM,以自注意力层与轻量的交叉注意力层交错排列;
- 社区驱动数据集的预训练:基于完全公开可用的社区贡献数据集,在不到3万条回合数据上进行端到端训练,在数据量上比现有技术少一个数量级的情况下展现出强劲性能;
- 异步推理:优化后的异步推理栈,将动作执行与观测处理和动作预测解耦,从而减低延迟并实现快速、资源高效的推理。
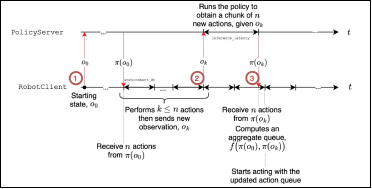
图2 SmolVLA的异步推理机制
LeRobot
VLA模型的最新进展是使得机器人能够实现多种任务,旨在实现泛化:能够在新颖的环境、未见物体和不同条件下执行任务,但是往往受限于系统多样化数据的可用性。通用的核心理念是在异构数据上进行共训练,通过让VLA模型接触各种环境、任务和机器人具象,教会模型如何行动,如何解读场景、理解目标以及跨情境调整技能。
LeRobot致力于让机器人数据收集更加便捷:简化录音流程、简化上传到Hugging Face Hub,促进社区分享,降低硬件成本。
按照机器人类型细分上传数据集,大多来自S0100和Koch,机械臂和操作任务是目前LeRobot数据集的主要关注点。自动驾驶、辅助机器人和移动导航等领域同样在共享数据中获益较多。低数据质量会导致下游性能差、输出偏颇,以及模型无法推广。因此,高效且高质量的数据收集在推动通用机器人策略中发挥着至关重要的作用。虽然视觉和语言的基础模型在庞大的网络规模数据集中蓬勃发展,但是缺乏“机器人互联网”——一种庞大、多样化的现实世界互动体系。相反,机器人数据被分散在不同的实体、传感器配置和控制模式中,形成数据孤岛。
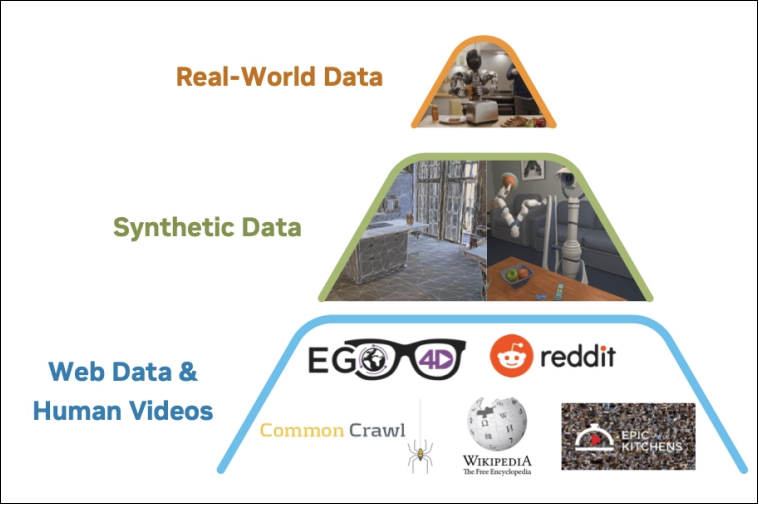
图3 数据组织金字塔
- 底层:大规模的网络和视频数据构成基础;
- 中层:合成数据增加模拟多样性;
- 顶层:显示机器人交互在顶端位模型提供了物理执行的基础。
通过扩大现实世界数据集的数量和多样性,LeRobot减少了异构数据源之间的碎片化,当数据集在环境、身体或者任务分布上不相连时,模型难以跨越传递知识。
SmolVLA_LIBERO评测
本文记录了在SmolVLA在LeRobot框架下的LIBERO数据训练及闭环成功率评测。本次训练使用的是单张消费级GPU显卡,模型采用预训练SmolVLM2视觉语言骨干,以有效的batch size=4完成100,000次参数更新;其中模型的总参数量为450,046,176,可训练参数量为99,880,992。评测采用100,000步checkpoint,在LIBERO-Spatial、LIBERO-Object、LIBERO-Goal和LIBERO-Long四个套件的40个任务上,各运行10回合,共计400回合。评测记录四套成功率分别为48%、57%、65%和31%,整体成功率50.25%,计时4718.362秒。结果表明,本次实验已经形成了可运行的训练、checkpoint保存、仿真执行以及视频记录的流程,并获得了当前配置下的初步性能基线。VLM初始化方向和每任务评测回合数与论文相符,明确的训练预算差异是有效的batch size为4,而论文为64。实际动作执行步数尚需核对,因此当前结果不应表述为同等配置下的论文性能复现。
1. 实验目标
本实验的目标是验证消费级硬件是否能够完成SmolVLA的LIBERO数据训练,并获得可追溯的任务成功率,为后续的轻量化VLA与外部规划模型协作的研究建立底座。本次复现主要包含两个层面:工程层面关注依赖、数据加载、训练和仿真是否能够运行,性能层面关注特定训练预算与评测协议下的任务完成率。
2. 硬件、环境与版本
| 项目 | 实验记录 |
| 操作系统 | Ubuntu 20.04.6 LTS |
| GPU | NVIDIA GeForce RTX 4090 D |
| NVIDIA驱动 | 570.133.07 |
| CUDA版本 | 12.8 |
| Conda环境 | smolvla |
| Python | 3.12 |
| PyTorch | 2.9.1+cu128 |
| torchvision | 0.24.1 |
| LeRobot | 0.6.2,editableUb 安装 |
| LeRobot 源码提交 | 3f2c29ef7e44b1dd ccbcda3b6a63939e53639e9e |
| LIBERO 包 | 0.1.4 |
| robosuite | 1.4.0 |
| MuJoCo | 3.8.1 |
| 视频解码后端 | PyAV |
| 离屏渲染 | NVIDIA EGL |
3. 数据与模型初始化
3.1 LIBERO数据
训练采用的是lerobot/libero数据集,本地数据目录为/home/用户/smolvla/datasets/libero。预处理数据包含四个标准套件的40个任务、两路256×256RGB相机、8维本体状态和7维动作,其schema与LeRobot文档一致。
数据的episode数和帧数描述训练演示规模,不是评测回合数。训练样本还涉及到动作块抽取,因此“训练过100,000步”也不能直接解释为完整遍历了数据100,000次。
3.2 模型与初始化范围
模型加载日志显示骨干为HuggingFaceTB/SmolVLM2-500M-Video-Instruct,并将视觉语言骨干层数剪枝为16层,训练日志报告:
| 参数统计 | 数量 |
| 总参数 | 450,046,176 |
| 可训练参数 | 99,880,992 |
训练Policy主要为加载预训练VLM权重、冻结视觉编码器、训练动作专家及状态投影。LIBERO正式训练使用的路径是policy.type=smolvla初始化流程;原论文明确说明仿真实验的SmolVLA只从VLM初始化方向与论文相符,精确骨干权重revision、模块训练范围等细节仍以保存配置核对。本次源码版本默认chunk_size与n_action_steps均为50,已展示的评测命令没有显式覆盖后者,因此报告暂时沿用保存配置描述,实际值需要以100,000步checkpoint的config.json核对。
4. 训练过程
4.1 SmolVLA checkpoint
1). 验证数据加载、模型训练和权重保存流程。该checkpoint对应SO系列机械臂任务,尚不能作为标准LIBERO评测权重,200步算短步测试,不能据此判断任务能力。
初始化权重:lerobot/smolvla_base
数据集:lerobot/svla_so101_pickplace
batch_size:2
训练部署:200
2). 根据现有环境补装LIBERO,初始化并验证导入。生成文件,随后确认MuJoCo 3.8.1、LIBERO任务套件均可导入,pip check通过。
配置文件:
/home/User/用户名/.libero/config.yaml

当前配置的数据目录:
/home/data/用户名/smolvla/lerobot/datasets
3). 下载仿真资源。场景创建系统发现不存在NVIDIA EGL库,因此下载现有驱动一致的570.133.07官方安装包,并使用extract-only解包,提取图形库到本地目录,创建本地EGL配置并设置环境变量。
/home/User/用户名/.cache/libero/assets
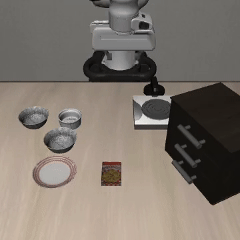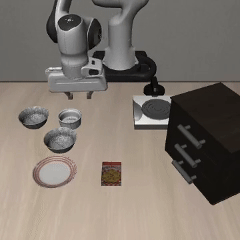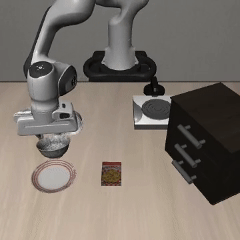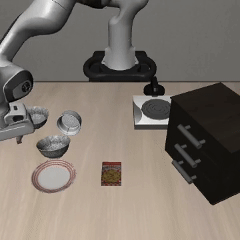
4). 验证场景、仿真步进和相机图像。使用libero_spatial第一个任务,创建场景、设置初始状态并执行零动作,保存相机图像。输出目录:
/home/data/用户/smolvla/libero_smoke_test/
5). 登录服务器,运行LIBERO前执行环境命令。
conda activate smolvla
cd /home/data/用户/smolvla/lerobot

export HF_ENDPOINT=https://hf-mirror.com
export MUJOCO_GL=egl
export PYOPENGL_PLATFORM=egl
export MUJOCO_EGL_DEVICE_ID=0

export LD_LIBRARY_PATH=/home/data/feiyang/smolvla/nvidia_graphics/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}
export __EGL_VENDOR_LIBRARY_FILENAMES=/home/data/feiyang/smolvla/nvidia_graphics/nvidia_egl.json
6). libero_smoke_test初始状态图
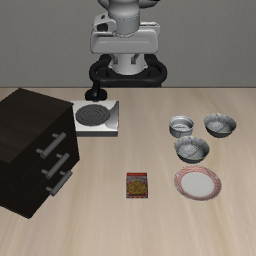
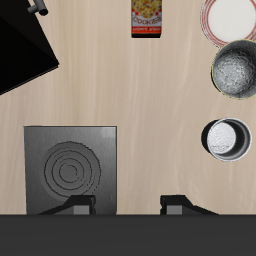
7). SmolVLA LIBERO数据训练200步:下载示范数据→检查数据读取→跑通200步训练。采用官方的SmolVLA LIBERO训练入口:首先加载预训练视觉语言骨干,在LIBERO示范上学习动作策略,与之前的SO-101 checkpoint不同,本次建立新的模型训练。
## 进入环境
conda activate smolvla
cd /home/data/用户/smolvla/lerobot

export HF_ENDPOINT=https://hf-mirror.com
export CUDA_VISIBLE_DEVICES=0

export MUJOCO_GL=egl
export PYOPENGL_PLATFORM=egl
export MUJOCO_EGL_DEVICE_ID=0  # GPU选卡第0张

export LD_LIBRARY_PATH=/home/data/feiyang/smolvla/nvidia_graphics/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}
export __EGL_VENDOR_LIBRARY_FILENAMES=/home/data/feiyang/smolvla/nvidia_graphics/nvidia_egl.json


## 下载LeRobot格式的LIBERO示范数据
python -u -c "
from pathlib import Path
from huggingface_hub import HfApi, snapshot_download

base = Path('/home/data/feiyang/smolvla')
root = base / 'datasets' / 'libero'
revision_file = base / 'libero_dataset_revision.txt'

if revision_file.exists():
    revision = revision_file.read_text().strip()
else:
    revision = HfApi().dataset_info('lerobot/libero').sha
    revision_file.write_text(revision + '\n')

print('数据集 revision:', revision, flush=True)
print('下载目录:', root, flush=True)

snapshot_download(
    repo_id='lerobot/libero',
    repo_type='dataset',
    revision=revision,
    local_dir=str(root),
    max_workers=1,
)

print('数据集下载完成', flush=True)
"
下载需要包含图像、状态、语言指令和动作的示范数据,使用lerobot/libero的元数据,大概包含40个任务、两路相机、8维状态和7维动作。上述命令仅用于记录数据集revision。
## 检查视频解码和数据维度
python -u -c "
from pathlib import Path
from lerobot.datasets.lerobot_dataset import LeRobotDataset

revision = Path(
    '/home/data/feiyang/smolvla/libero_dataset_revision.txt'
).read_text().strip()

dataset = LeRobotDataset(
    repo_id='lerobot/libero',
    root='/home/data/feiyang/smolvla/datasets/libero',
    revision=revision,
    video_backend='pyav',
)

sample = dataset[0]

print('数据帧数:', len(dataset))
for key in (
    'observation.images.image',
    'observation.images.image2',
    'observation.state',
    'action',
):
    value = sample[key]
    print(key, tuple(value.shape), value.dtype)

print('语言指令:', sample.get('task'))
print('数据读取检查通过')
"
预期维度:
- 主相机——
observation.images.image:(3, 256, 256) - 腕部相机——
observation.images.image2:(3, 256, 256) -
状态:(8,)
-
动作:(7,)
## 200步训练检查
export LIBERO_REVISION="$(cat /home/data/feiyang/smolvla/libero_dataset_revision.txt)"

lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --policy.device=cuda \
  --dataset.repo_id=lerobot/libero \
  --dataset.root=/home/data/feiyang/smolvla/datasets/libero \
  --dataset.revision="$LIBERO_REVISION" \
  --dataset.video_backend=pyav \
  --batch_size=2 \
  --num_workers=2 \
  --steps=200 \
  --log_freq=20 \
  --save_freq=200 \
  --env_eval_freq=0 \
  --seed=42 \
  --output_dir=/home/data/feiyang/smolvla/lerobot/outputs/train/smolvla_libero_smoke \
  --job_name=smolvla_libero_smoke \
  --wandb.enable=false

  # check
  ls -R /home/data/用户/smolvla/lerobot/outputs/train/smolvla_libero_smoke/checkpoints
训练视频:
4.2 SmolVLA扩展训练
用于加载预训练视觉语言骨干,对LIBERO四件套的40个任务联合训练。模型总参数约为450M,主要用于更新动作专家和状态投影,约100M参数参与训练。
## 运行环境
conda activate smolvla

export SMOLVLA_BASE=/home/data/用户/smolvla
cd "$SMOLVLA_BASE/lerobot"

# 使用已经验证可用的镜像直连
unset HTTP_PROXY HTTPS_PROXY ALL_PROXY
unset http_proxy https_proxy all_proxy

export HF_ENDPOINT=https://hf-mirror.com
export HF_HUB_DISABLE_XET=1
export HF_HUB_ETAG_TIMEOUT=30
export HF_HUB_DOWNLOAD_TIMEOUT=60

# 本次采用单卡训练
export CUDA_VISIBLE_DEVICES=0

# LIBERO 无显示器渲染
export MUJOCO_GL=egl
export PYOPENGL_PLATFORM=egl
export MUJOCO_EGL_DEVICE_ID=0

export LD_LIBRARY_PATH="$SMOLVLA_BASE/nvidia_graphics/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
export __EGL_VENDOR_LIBRARY_FILENAMES="$SMOLVLA_BASE/nvidia_graphics/nvidia_egl.json"

# 固定数据集版本
export LIBERO_REVISION="$(cat "$SMOLVLA_BASE/libero_dataset_revision.txt)"

## 设置统一训练参数
SMOLVLA_TRAIN_ARGS=(
  --policy.type=smolvla
  --policy.load_vlm_weights=true
  --policy.push_to_hub=false
  --policy.device=cuda

  --policy.freeze_vision_encoder=true
  --policy.train_expert_only=true
  --policy.train_state_proj=true

  --policy.optimizer_lr=1e-4
  --policy.scheduler_warmup_steps=1000
  --policy.scheduler_decay_steps=100000

  --dataset.repo_id=lerobot/libero
  --dataset.root="$SMOLVLA_BASE/datasets/libero"
  --dataset.revision="$LIBERO_REVISION"
  --dataset.video_backend=pyav

  --batch_size=4
  --num_workers=2
  --accelerator.gradient_accumulation.steps=1

  --env_eval_freq=0
  --seed=42
  --wandb.enable=false
)
batch size=4短测:100步
export SMOLVLA_PROBE_DIR="$SMOLVLA_BASE/lerobot/outputs/train/libero_b4_probe_$(date +%Y%m%d_%H%M%S)"

lerobot-train "${SMOLVLA_TRAIN_ARGS[@]}" \
  --steps=100 \
  --log_freq=20 \
  --save_freq=100 \
  --output_dir="$SMOLVLA_PROBE_DIR" \
  --job_name=libero_b4_probe
用于检查显存、计算速度和模型保存,短测结果:
| 指标 | 结果 |
| 完成步数 | 100 |
| loss |
2.511 → 1.819 |
| PyTorch峰值已分配显存 | 约1.95GB |
| 稳定阶段每步耗时 | 约0.28~0.36秒 |
| checkpoint | 成功保存 |
4.3 SmolVLA正式训练
export SMOLVLA_RUN_DIR="$SMOLVLA_BASE/lerobot/outputs/train/smolvla_libero_s42_b4_20261006_025457"

if [ -e "$SMOLVLA_RUN_DIR" ]; then
  echo "训练目录已存在,保留已有结果,不重复启动:$SMOLVLA_RUN_DIR"
else
  mkdir -p "$SMOLVLA_BASE/lerobot/outputs/train"

  printf '%s\n' "$SMOLVLA_RUN_DIR" \
    > "$SMOLVLA_BASE/libero_formal_run.txt"

  python -m pip freeze > "${SMOLVLA_RUN_DIR}.environment.txt"
  git rev-parse HEAD > "${SMOLVLA_RUN_DIR}.commit.txt"

  nohup lerobot-train "${SMOLVLA_TRAIN_ARGS[@]}" \
    --steps=100000 \
    --log_freq=100 \
    --save_freq=10000 \
    --output_dir="$SMOLVLA_RUN_DIR" \
    --job_name=smolvla_libero_formal \
    > "${SMOLVLA_RUN_DIR}.log" 2>&1 &

  echo $! > "${SMOLVLA_RUN_DIR}.pid"
fi

## 查看日志
export SMOLVLA_RUN_DIR="$(cat "$SMOLVLA_BASE/libero_formal_run.txt)"

tail -n 40 -f "${SMOLVLA_RUN_DIR}.log"

## 查看checkpoint
ls "$SMOLVLA_RUN_DIR/checkpoints"

## 每10000步保存一次,最终模型位置为
/home/data/用户/smolvla/lerobot/outputs/train/smolvla_libero_s42_b4_20261006_025457/checkpoints/100000/pretrained_model
成功率评测:
export SMOLVLA_RUN_DIR="$(cat "$SMOLVLA_BASE/libero_formal_run.txt)"

export SMOLVLA_EVAL_DIR="${SMOLVLA_RUN_DIR}_eval_100000_n10_s42_$(date +%Y%m%d_%H%M%S)"

printf '%s\n' "$SMOLVLA_EVAL_DIR" \
  > "$SMOLVLA_BASE/libero_latest_eval.txt"

nohup lerobot-eval \
  --policy.path="$SMOLVLA_RUN_DIR/checkpoints/100000/pretrained_model" \
  --policy.device=cuda \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --env.init_states=true \
  --env.hard_reset=true \
  --env.control_mode=relative \
  --env.max_parallel_tasks=1 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --seed=42 \
  --output_dir="$SMOLVLA_EVAL_DIR" \
  > "${SMOLVLA_EVAL_DIR}.log" 2>&1 &

echo $! > "${SMOLVLA_EVAL_DIR}.pid"

##查看进度
tail -n 40 -f "${SMOLVLA_EVAL_DIR}.log"

## 重新登录查看已有结果
export SMOLVLA_EVAL_DIR="$(cat "$SMOLVLA_BASE/libero_latest_eval.txt)"

tail -n 100 "${SMOLVLA_EVAL_DIR}.log"
ls -lh "$SMOLVLA_EVAL_DIR"
5. 实测结果
5.1 套件成功率
| 套件 | 任务数 | 回合数 | 成功回合数 | 成功率 |
| LIBERO-Spatial | 10 | 100 | 48 | 48% |
| LIBERO-Object | 10 | 100 | 57 | 57% |
|
LIBERO- Goal | 10 | 100 | 65 | 65% |
|
LIBERO- Long | 10 | 100 | 31 | 31% |
| 整体 | 40 | 400 | 201 | 50.25% |
本次配置在Goal上成功率最高,在Long上最低。二者相差34个百分点,该差异描述了不同套件中的观测结果,但不能独立证明语言理解、动作精度或长程规划中的某一项是主要瓶颈。不同套件的任务组成也不同,需要任务级记录及失败视频才能定位原因。
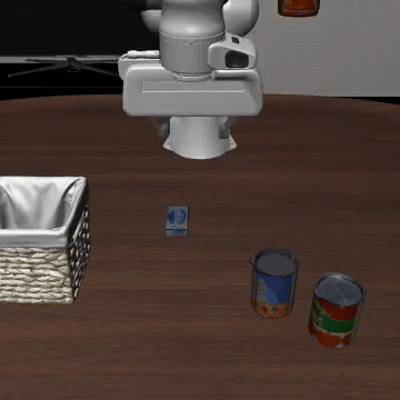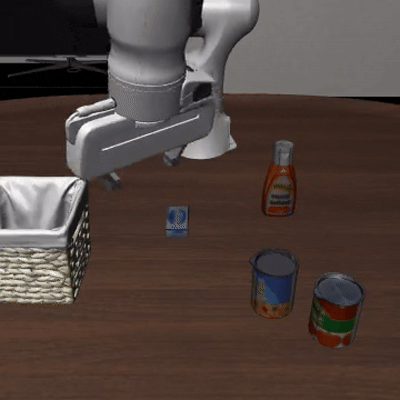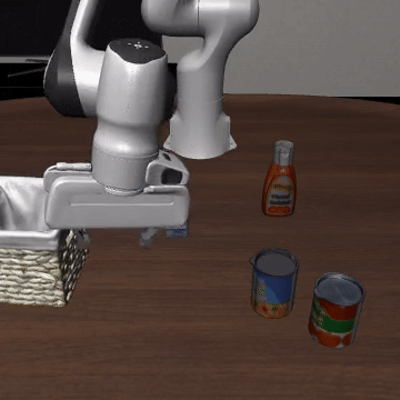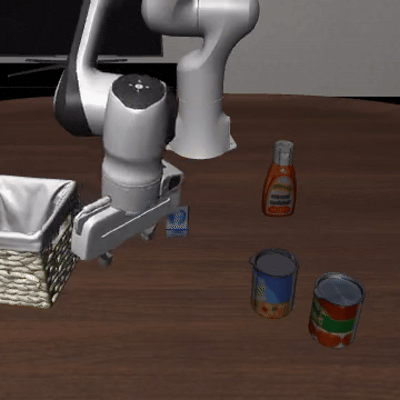
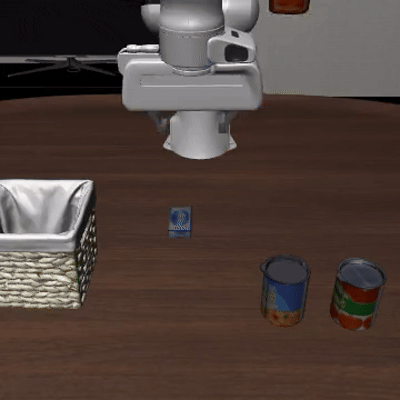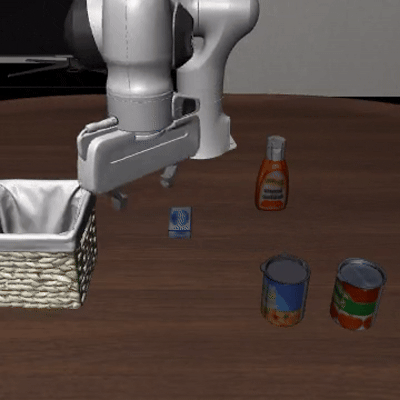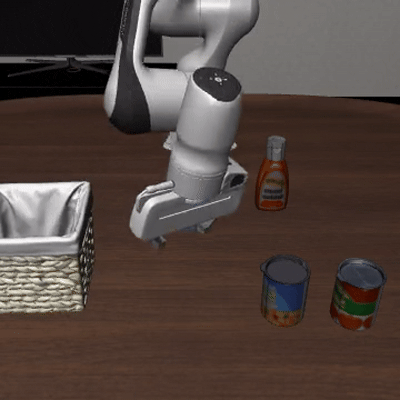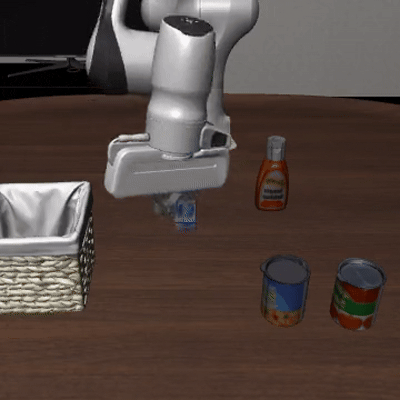
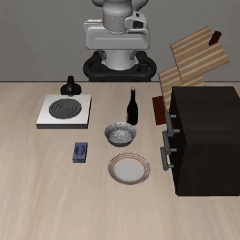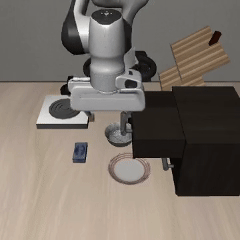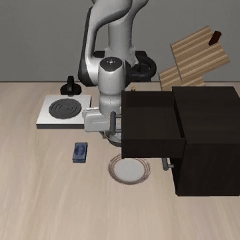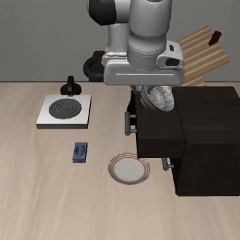
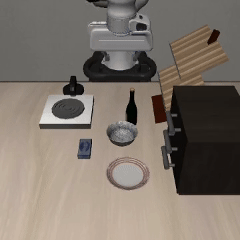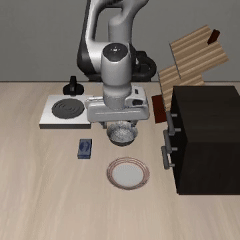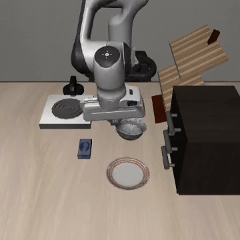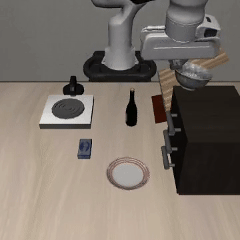
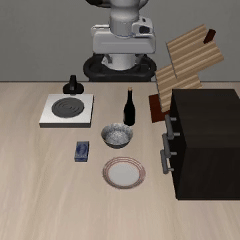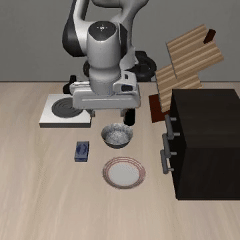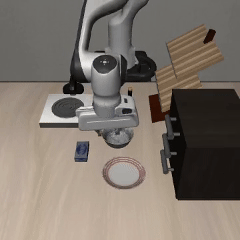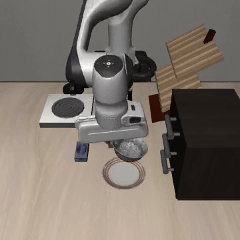
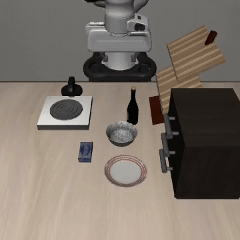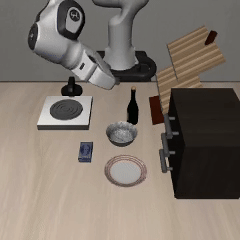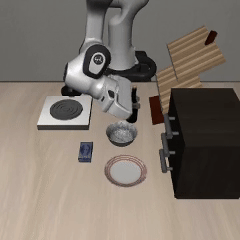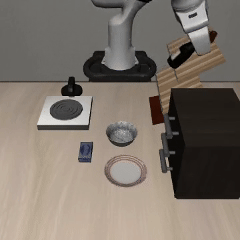
5.2 视频记录
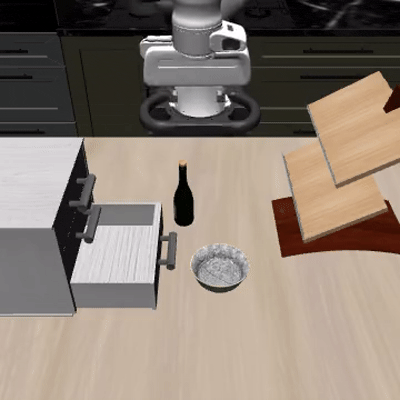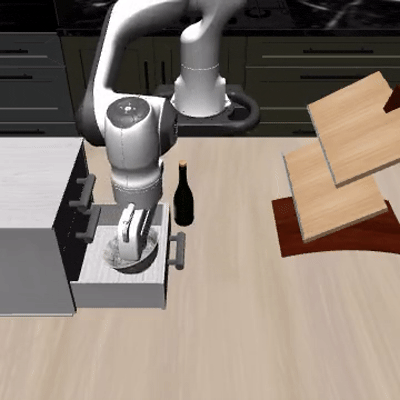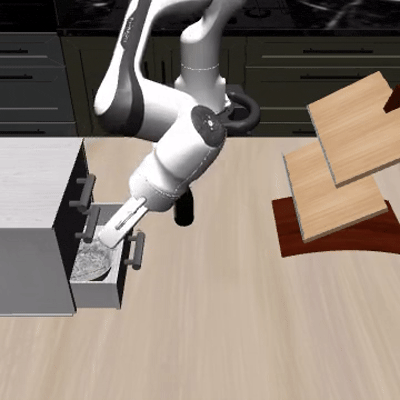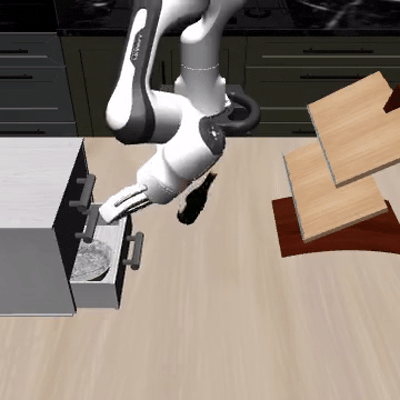
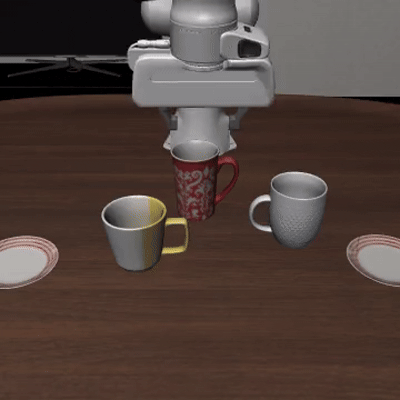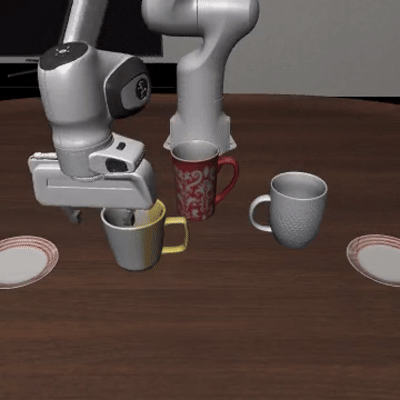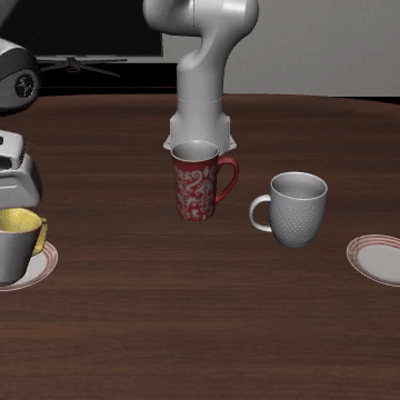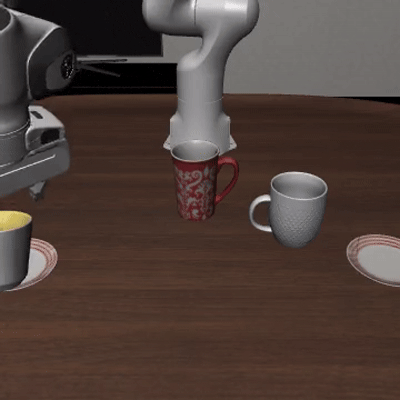
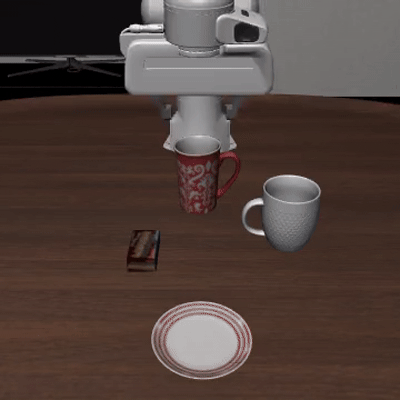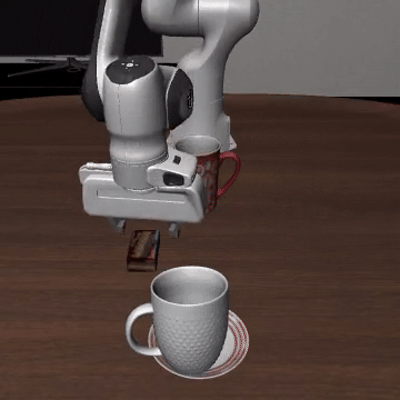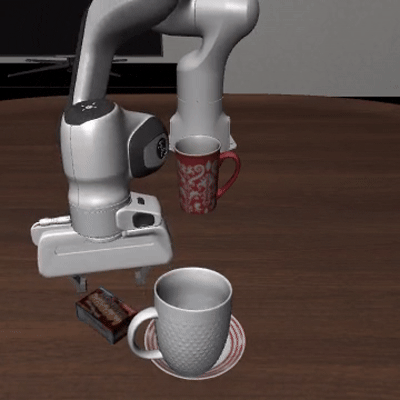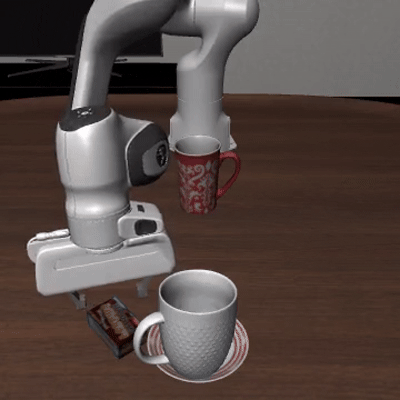
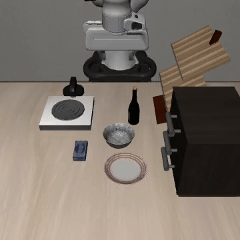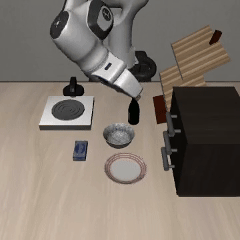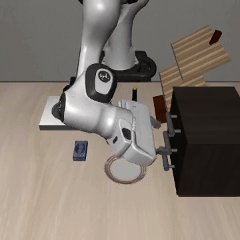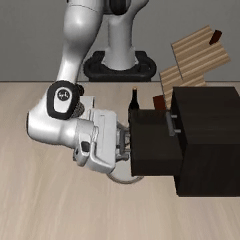
1). Long任务套件:需要连续完成多个操作的长程任务,平均成功率为31%
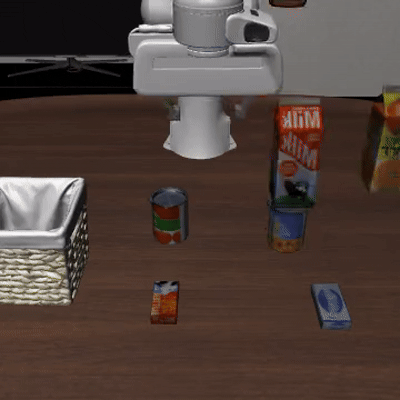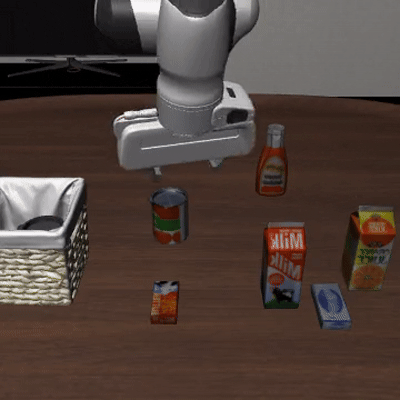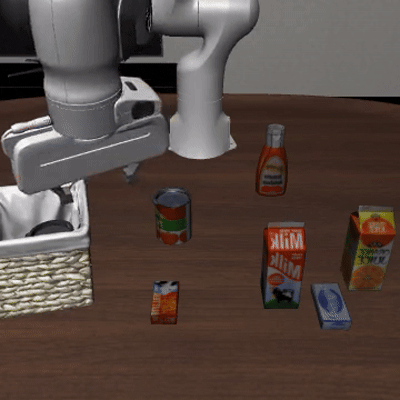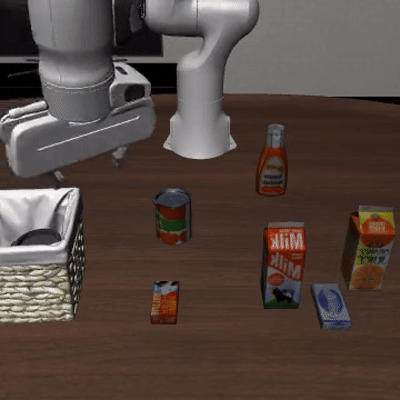
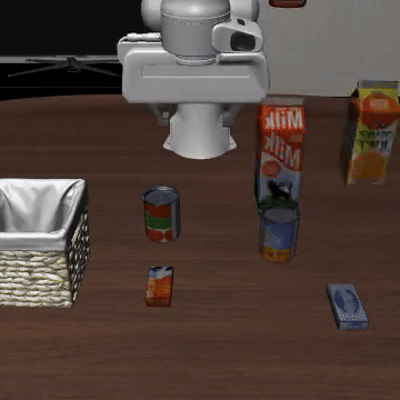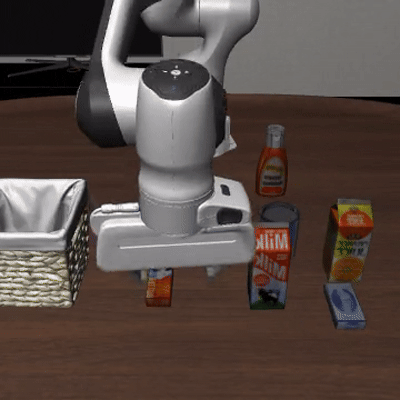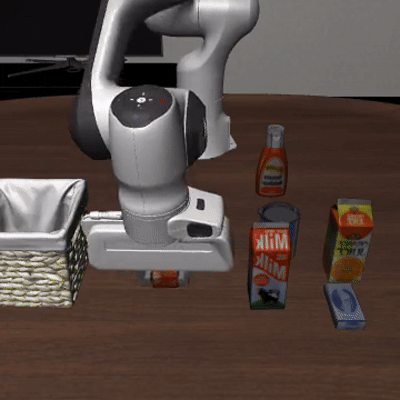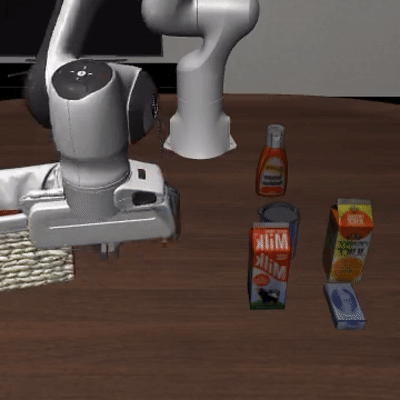
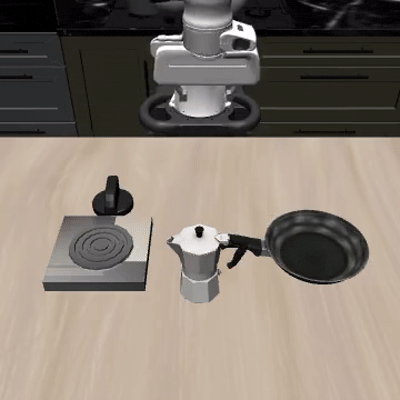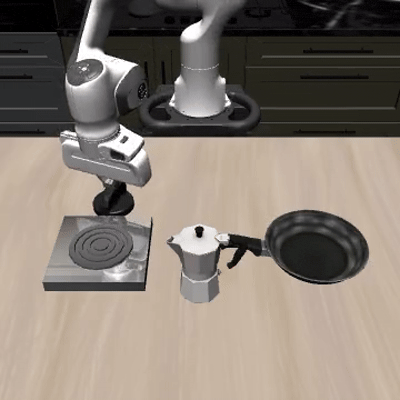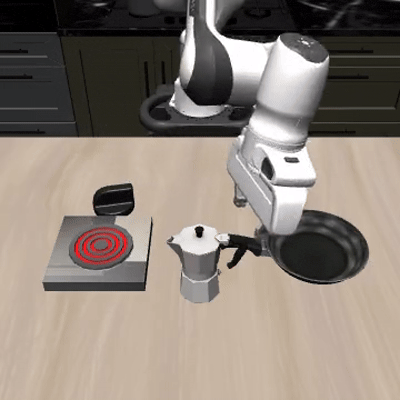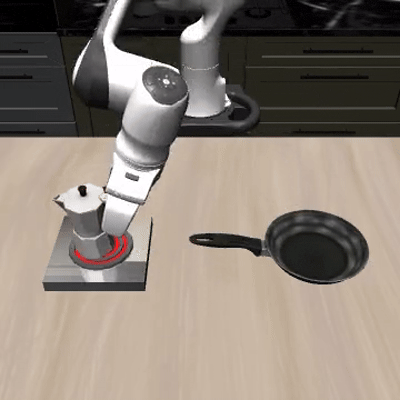
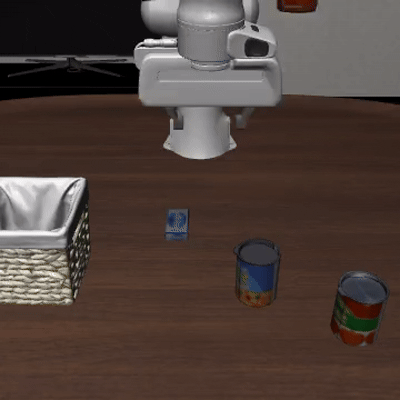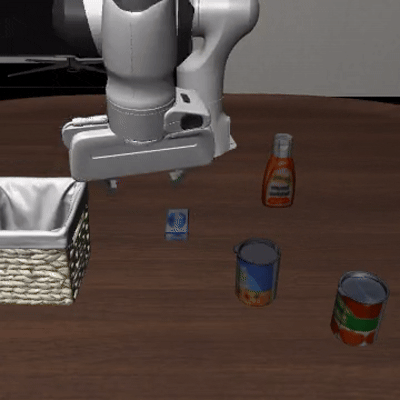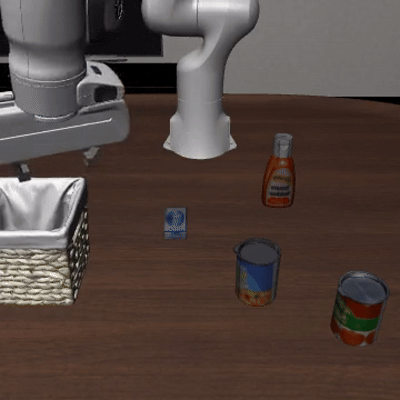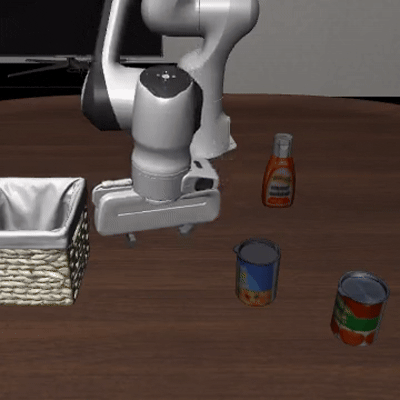
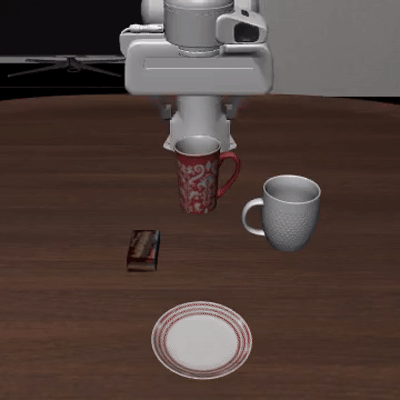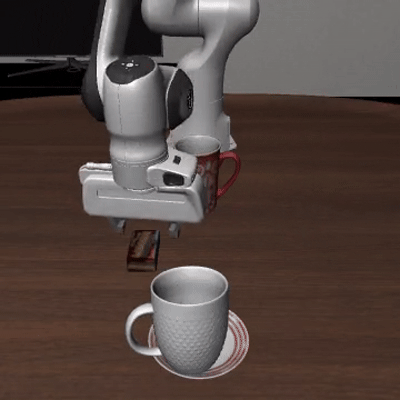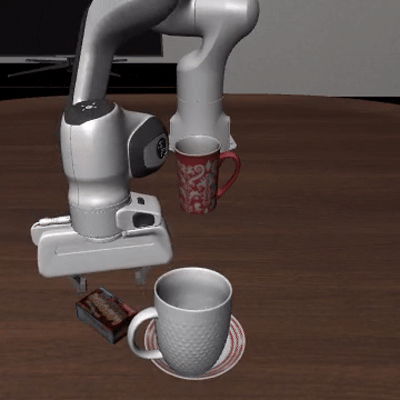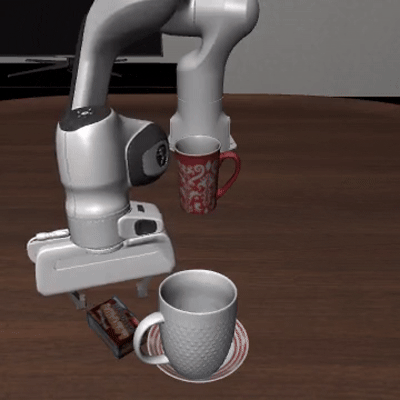
2). Spatial任务套件:根据空间关系操作物体,平均成功率为48%
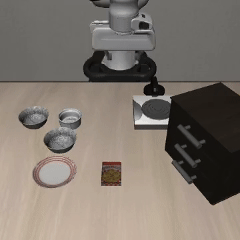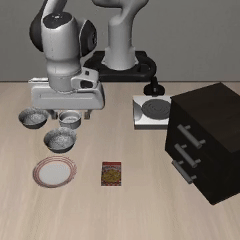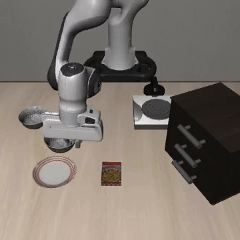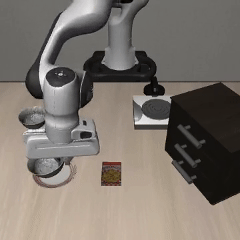
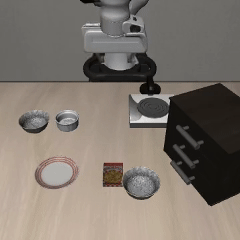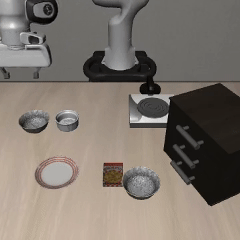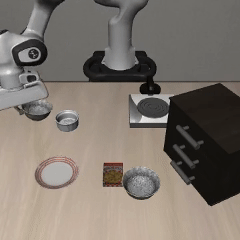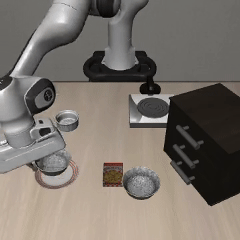
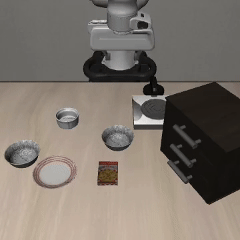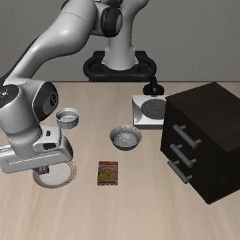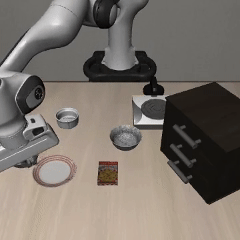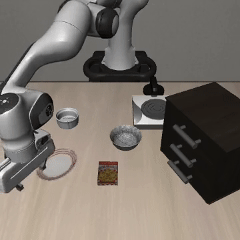
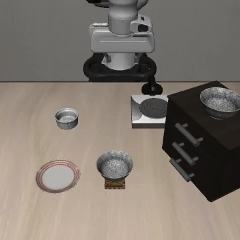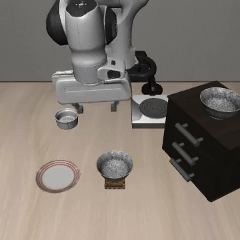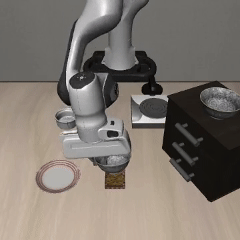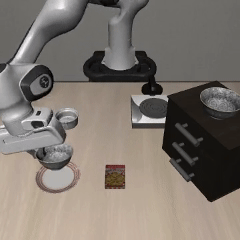
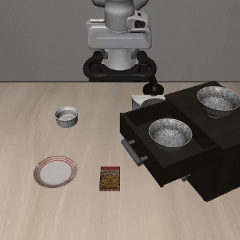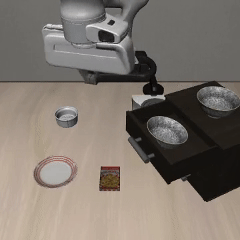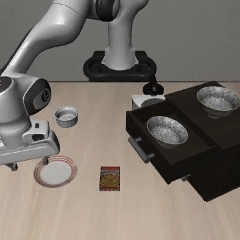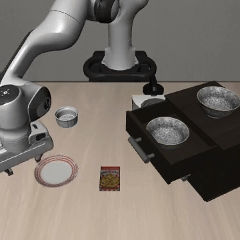
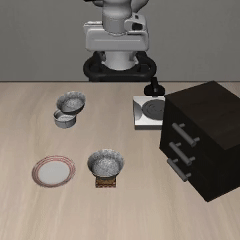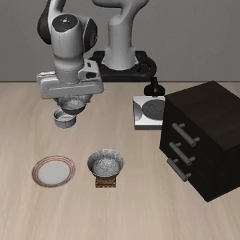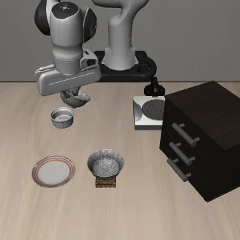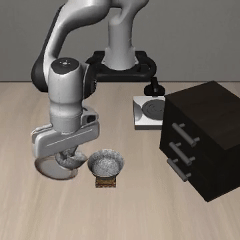
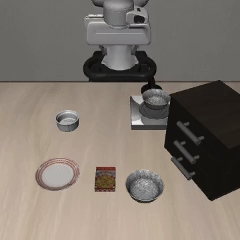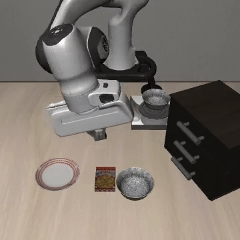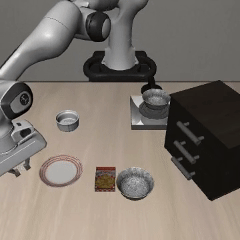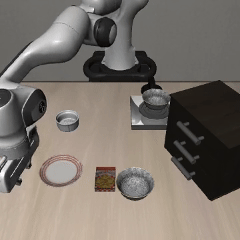
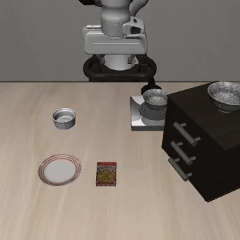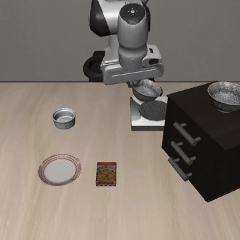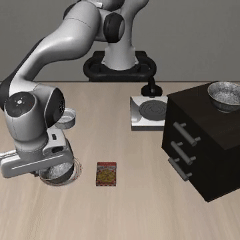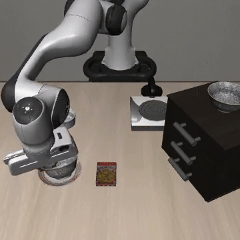
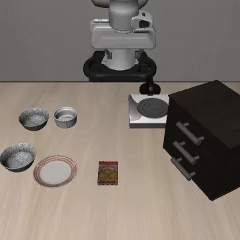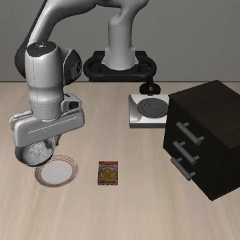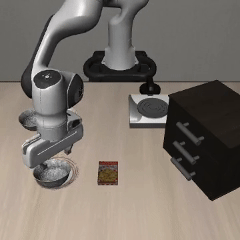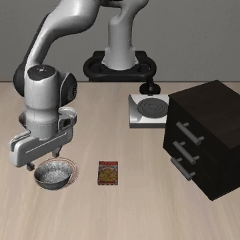
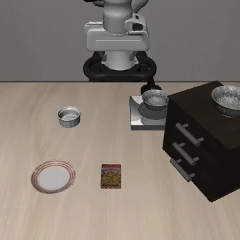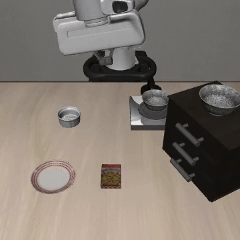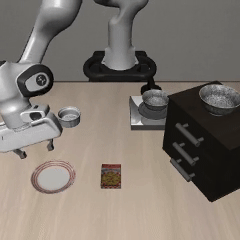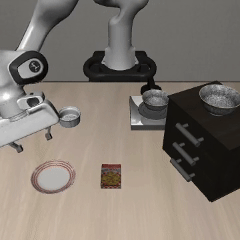
3). Object任务套件:操作不同类别或外观的物体,平均成功率为57%
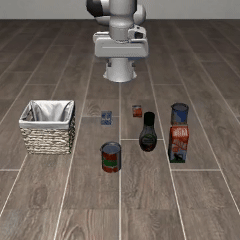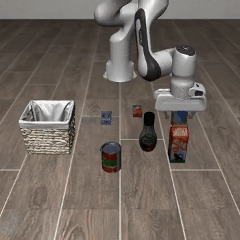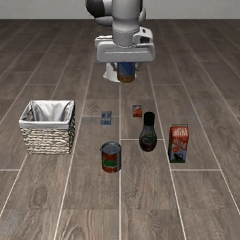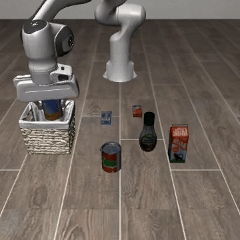
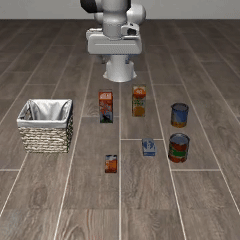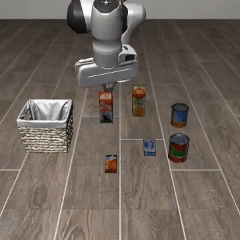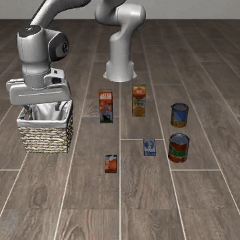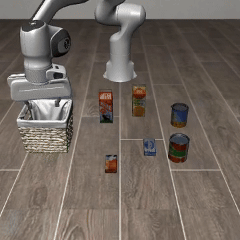
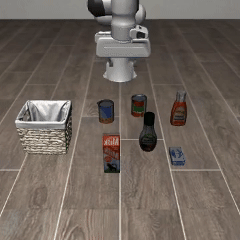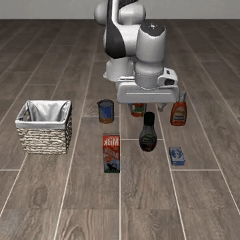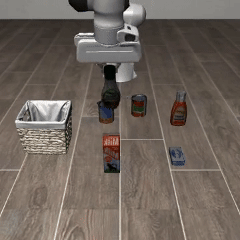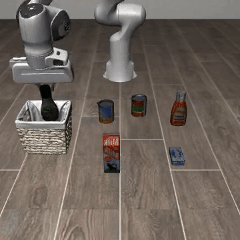
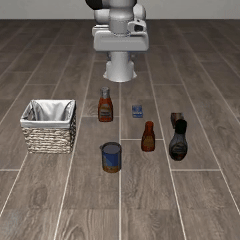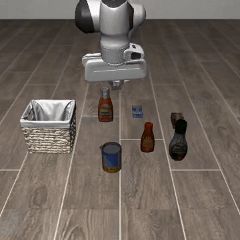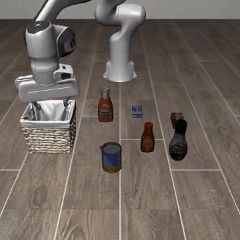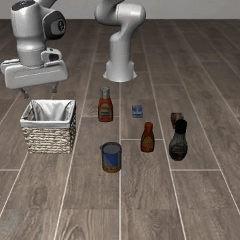
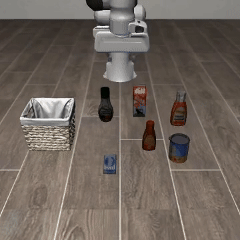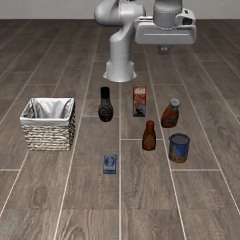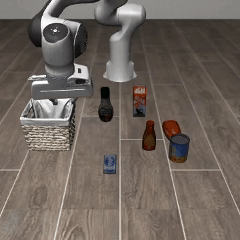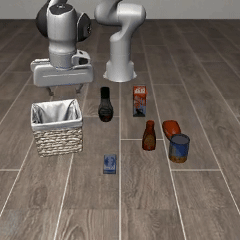
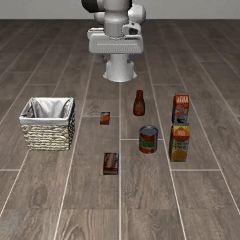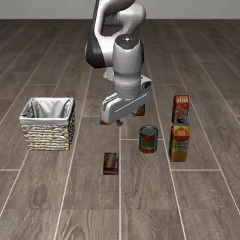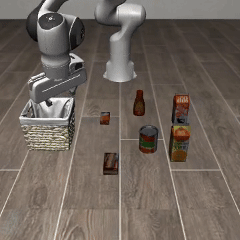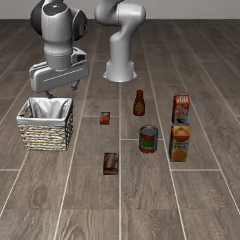
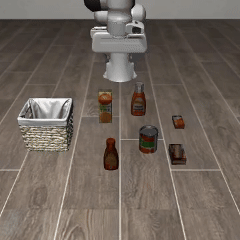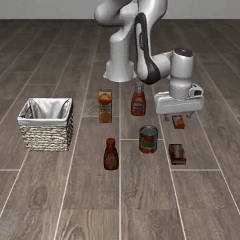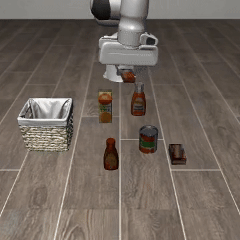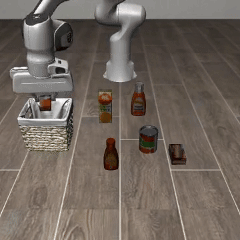
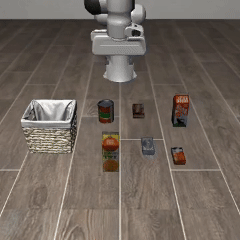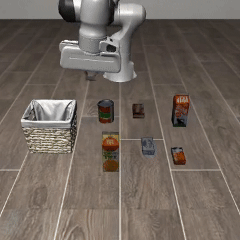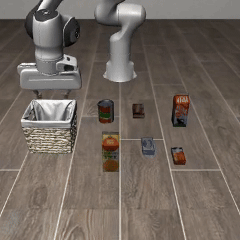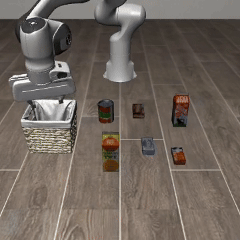
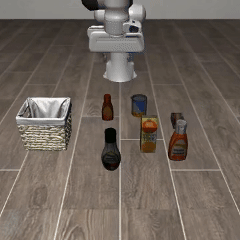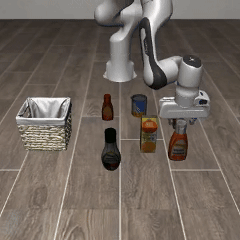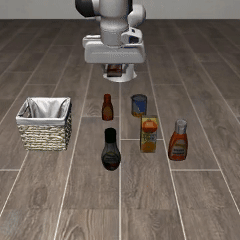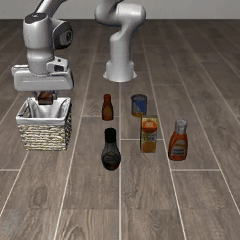
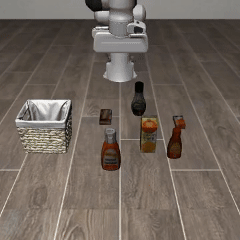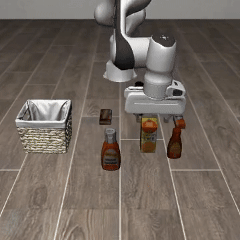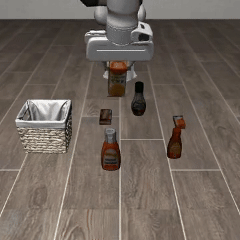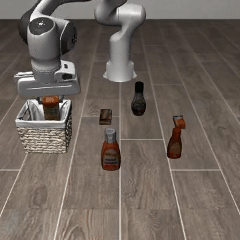
4). Goal任务套件:根据任务指令完成不同目标,平均成功率为65%
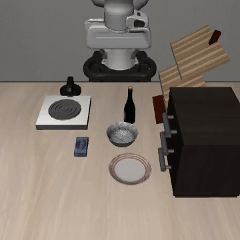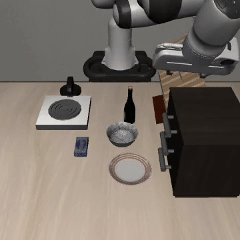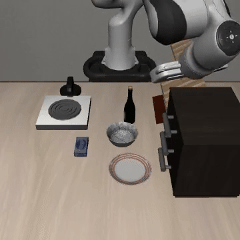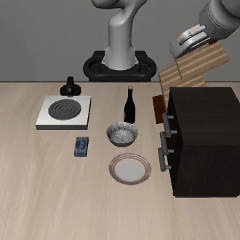
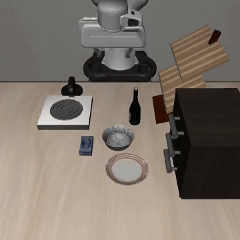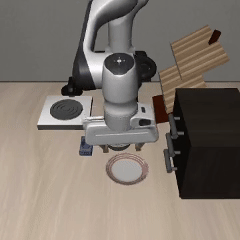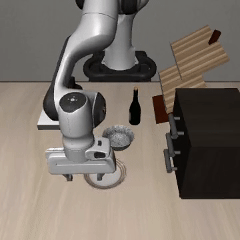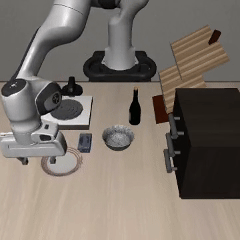
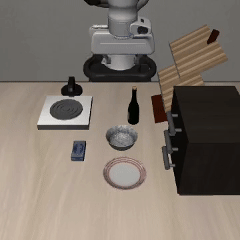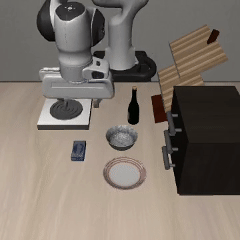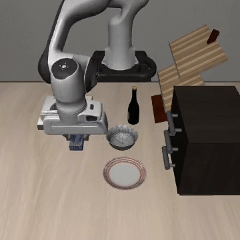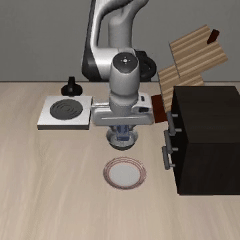
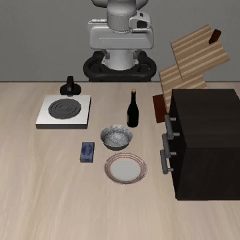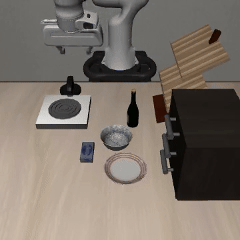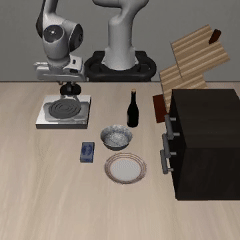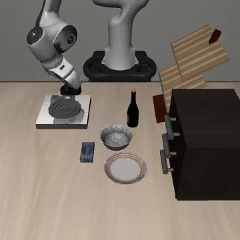
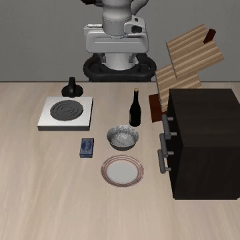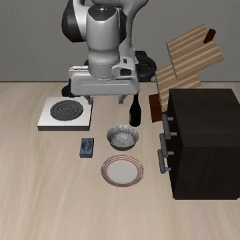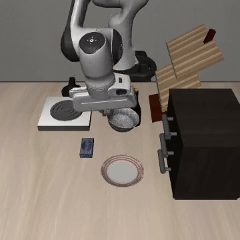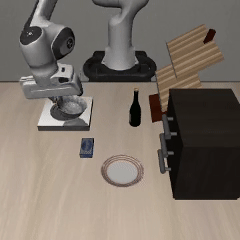
6. 总结
本次实验建立了SmolVLA在消费级显卡训练及LIBERO闭环评测流程。第100,000步checkpoint在四个套件上共400个回合中取得了201次成功,构成了当前训练预算和评测配置下的初步基线。该记录可以支持后续模型协作实验的可追溯对照,但尚不足以证明已达到原论文的性能。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)