【WM】OSCAR: Omni-Embodiment Action-Conditioned World Model for Robotics
note
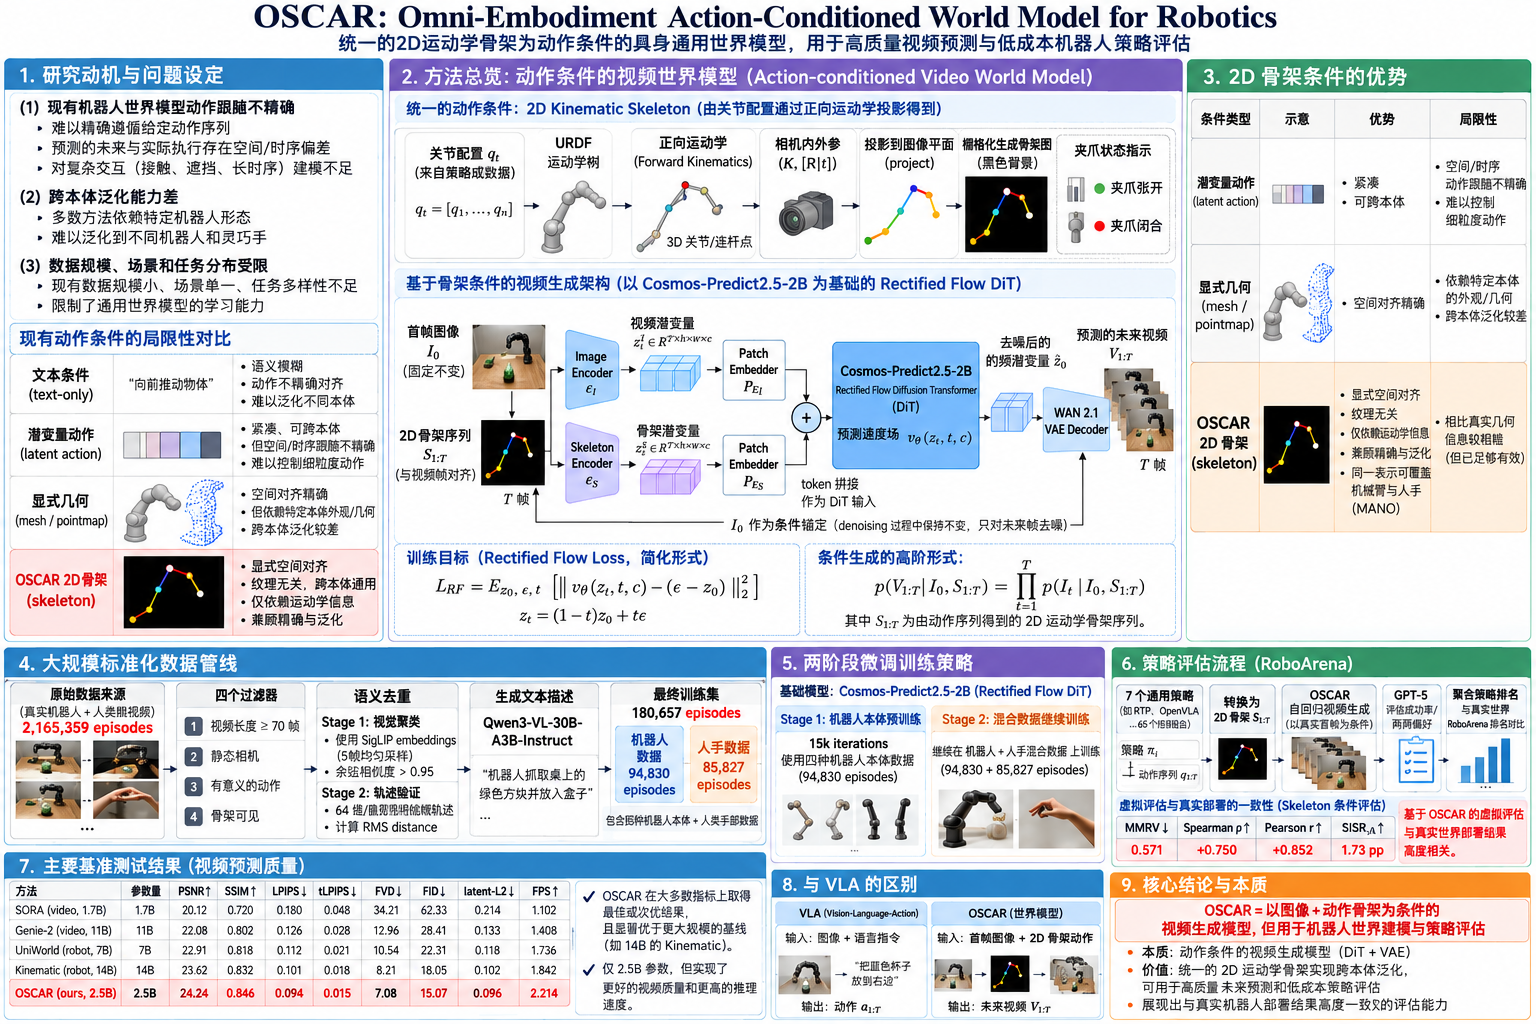
- 输入 = 当前场景首帧图片 + 未来一段机器人的 2D 运动学骨架序列;输出 = 按这段骨架动作发展出来的未来机器人视频。
- OSCAR 不是又一款追求“画面像不像”的视频生成器,而是把动作条件视频预测改造为策略筛选器:给定一个真实首帧和给定策略的动作轨迹,模型自回归生成未来视频,再由 GPT-5 判读成功率,以此预测 RoboArena 真实排名。它的核心设计是 2D 运动学骨架:把不同机械臂或人手的关节链投影成无纹理线条,使条件既显式地约束“何时、在哪里动”,又不必把模型绑死在特定机器人外观上。
- 论文最强的结果在视频质量:在六个数据集、四类机器人本体组成的 200 条片段测试集上,OSCAR 相对七个基线取得四项第一、三项第二;FVD 为 7.08、FID 为 15.07,均优于
14
B
14B
14B 的 Kinema4D,而基础模型只有
2
B
2B
2B 参数,单张 GH200 训练。
- 其跨本体泛化也不是“七个机器人一起训练”这样简单:216.5 万条原始片段经长度、静态相机、有效动作、骨架可见性过滤,再由视觉相似度和轨迹相似度两级去重,只保留 18.07 万条;在机器人与人类数据共同训练时,先以纯机器人训练 15k 步再热启动,PSNR 提升 0.76 dB。
- 但“虚拟评测接近真机”目前仍是相关性的成立,而非测试环境的等价。OSCAR 在七策略、65 个 RoboArena 场景的排名评测中,骨架条件的 MMRV 为 0.571、Spearman ρ 为 0.750、Pearson r 为 0.852;然而策略成功率由 VLM 判读,校准集上 100 个样本只与人工标签一致 78 例,且对成功样本召回率只有 0.66,因此当前系统偏向低估成功。它的适用场景更适合“淘汰明显失败者、缩小真机候选集”,尚不足以替代安全性、接触力、长时序任务和高变化相机条件下的真机验证。[1]
文章目录
一、研究动机:策略迭代的主要成本不在生成,而在真机验证
OSCAR:用统一骨架条件把视频世界模型推进到机器人策略虚拟评测
OSCAR: Omni-Embodiment Action-Conditioned World Model for Robotics
世界模型要想评策略,就必须同时解决动作精度、场景泛化和跨本体迁移
机器人策略研发的常见瓶颈不是没有候选模型,而是每个候选都需要进入真实环境反复执行。真机评测昂贵、速度慢,而且受设备、任务场景、动作安全和批次调度限制;如果生成模型能可靠地代替部分 rollout,策略筛选就可以先在“虚拟世界”中完成。论文把动作条件视频世界模型定义为:输入当前视频或首帧,以及策略给出的动作序列,输出未来视频或状态。它不仅能服务策略评估,还可能进入强化学习、规划与动作模型的预训练。
问题在于,原先的模型往往只解决其中一部分。文本条件足以描述“把物体放进盘子”,却很难精确指定机械臂在每一帧、每个像素位置如何移动;隐式潜动作把位姿变化压缩成一个向量,训练时可以覆盖多本体,却容易在生成端丢失细粒度空间与时间对应关系;点云图、三维占据或带纹理网格虽然“信息更密”,又容易把某一机器人外观、相机和场景细节固化到模型中,离开训练分布后反而变差。DROID、RH20T、AgiBot World 等公开数据也不天然适合做世界模型:任务、环境和本体高度重复,许多片段短、相机移动、动作静止或手臂出画。
OSCAR 因此把目标定为三项同时成立:第一,动作条件必须可定位,即精确到“第几帧发生、在图像何处发生”;第二,模型应跨越不同任务、环境和动作分布,而不是记住几个录制场景;第三,同一条件接口要能跨机器人本体,最好还能从人类视频迁移。骨架正是作者对这三项目标做工程折中的答案:它比文本具体、比潜动作可视觉对齐,又比点图或网格更少绑定具体外观。[1]
“视频相似”与“策略成功”是两个不同证据层
论文最值得注意的动机,是将视频世界模型从生成任务推进到评测代理。但二者证据性质并不相同。像素重建指标高,只能说明模型能预测给定动作后图像怎样变化;策略评估则要求生成视频还能反映任务是否完成。前者可由 PSNR、SSIM、LPIPS、FVD 等直接量化,后者却涉及接触、物体状态、任务语义和结果判读。
因此,OSCAR 的实验实际上包含两条证据链。第一条是条件视频生成:模型是否能把骨架条件转成正确、连贯且视觉合理的未来帧。第二条是虚拟评测:生成视频里的成功,能否与 RoboArena 的人类评测和官方排名一致。第二条链条中的 VLM 判官不是附带组件,而是系统误差的一部分。论文用 100 条真实片段对 GPT-5 做校准,结果是 78% 与人工标签一致;其中对失败判为失败的特异性为 0.90,对成功判为成功的召回率仅 0.66。换言之,系统更可能把“完成”判成“未完成”,而不是把失败误报为成功。[1]
这意味着 OSCAR 当前更适合作为保守筛选器:当多个策略在世界模型中反复失败时,它们大概率不值得优先上机;但世界模型给出成功,不能直接等同于真机成功。报告不能把图 1 右上的世界模型柱状成功率与真机柱状成功率画在一起,就宣称两者数值接近;真正的承重指标是排名顺序、相关系数及平均排名违规。
二、核心:骨架把异构动作转成统一视觉条件
模型沿用了视频扩散主干,关键创新在于条件的几何表达与数据治理
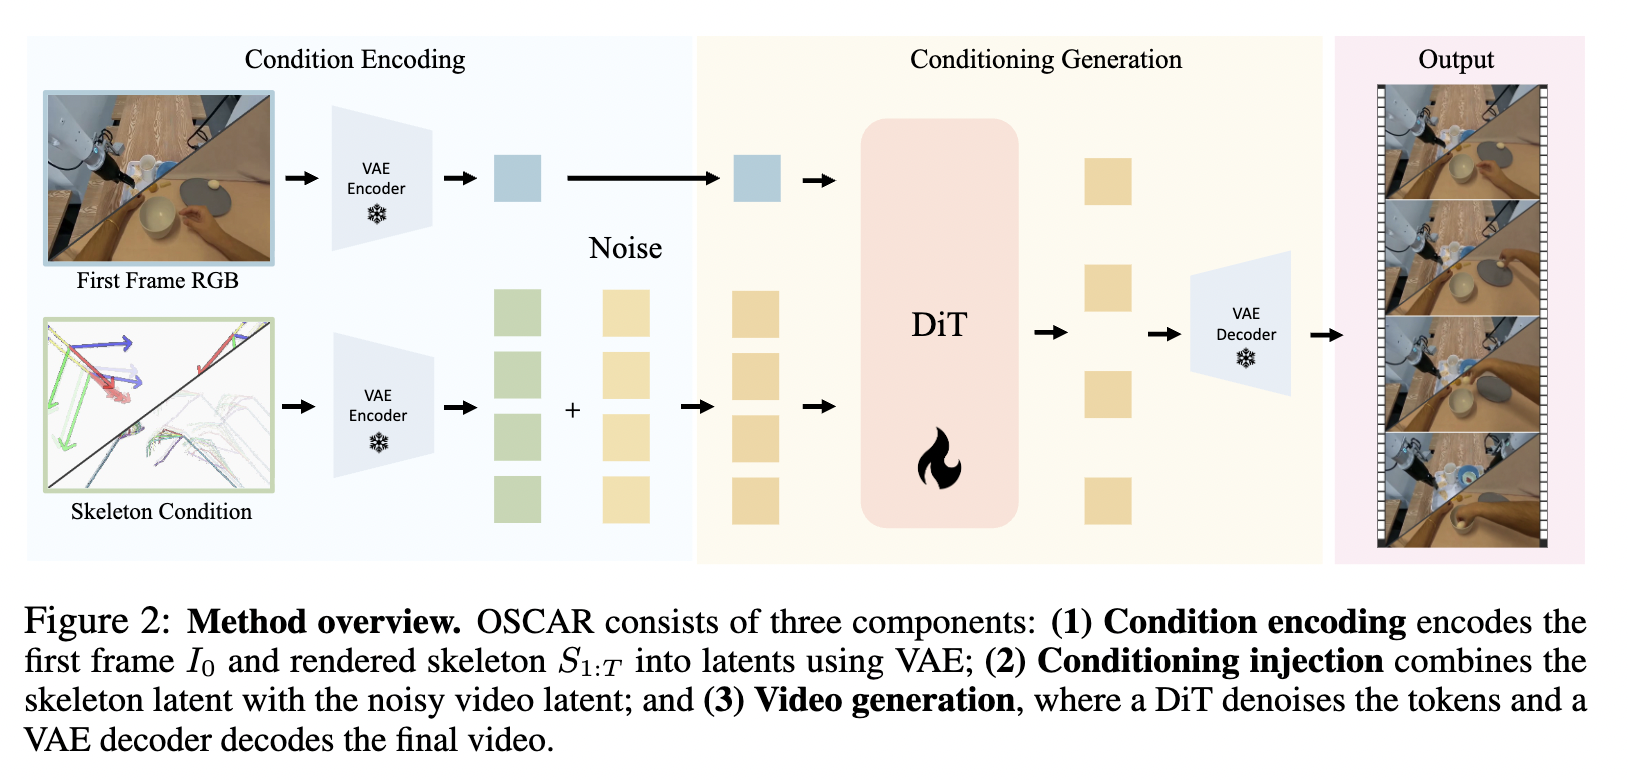
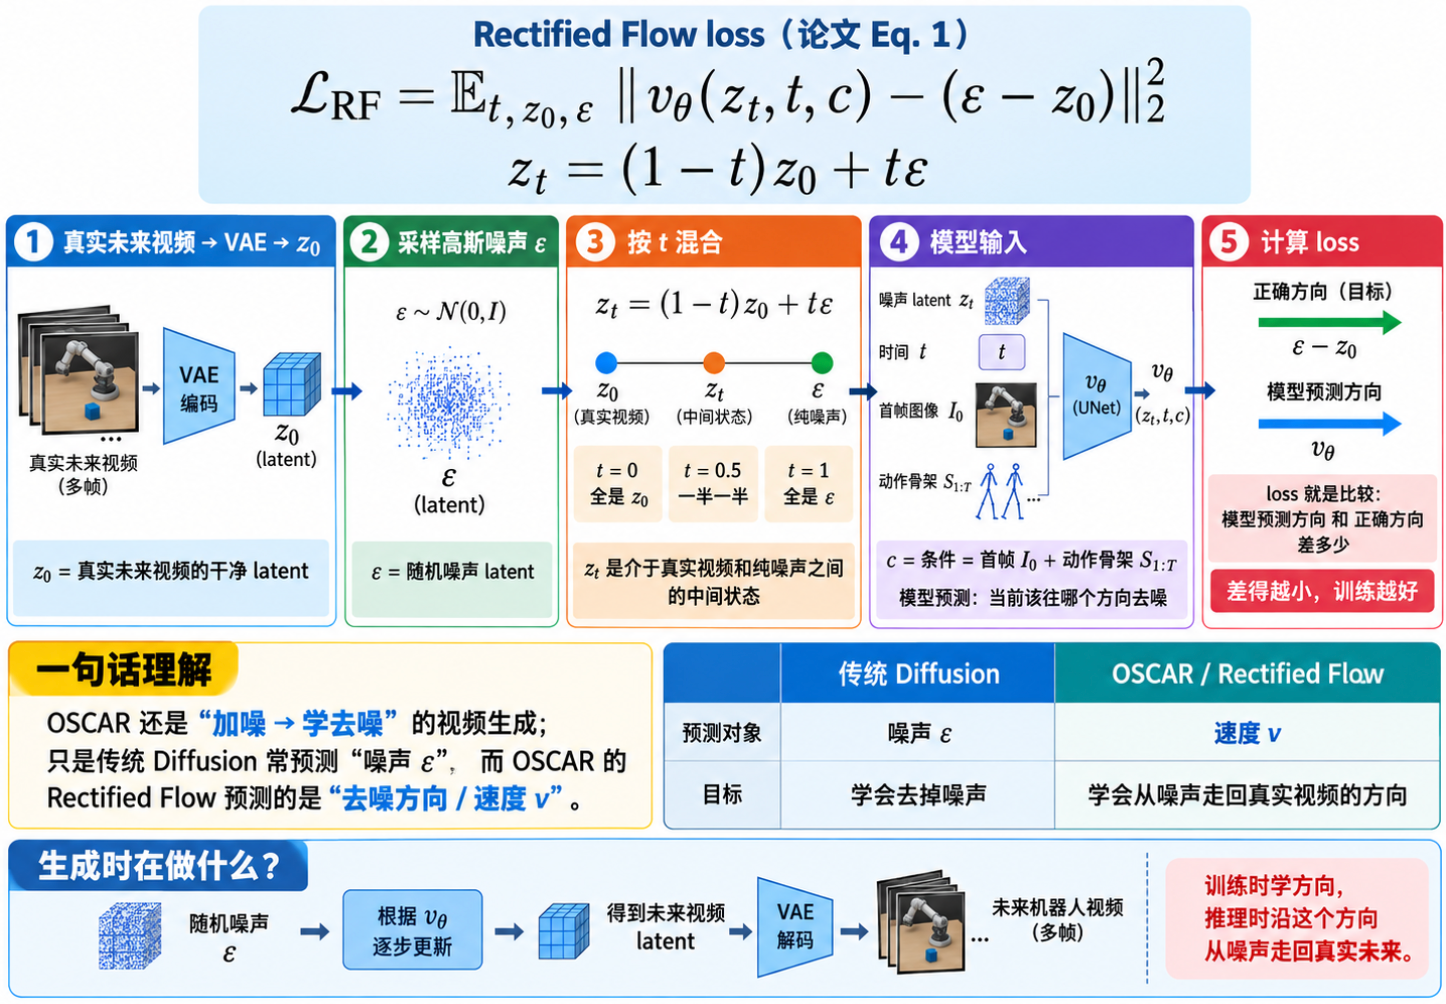
OSCAR 建立在 Cosmos-Predict2.5-2B 视频扩散 Transformer 上。视频先由 WAN 2.1 VAE 编码为时空潜变量,DiT 将潜变量分块成 token 并去噪。训练目标是 rectified-flow 速度场预测:
L R F = E t , z 0 , ϵ ∥ v θ ( z t , t , c ) − ( ϵ − z 0 ) ∥ 2 2 , z t = ( 1 − t ) z 0 + t ϵ . \mathcal L_{\mathrm{RF}} = \mathbb E_{t,z_0,\epsilon} \left\|v_\theta(z_t,t,c)-(\epsilon-z_0)\right\|_2^2, \quad z_t=(1-t)z_0+t\epsilon . LRF=Et,z0,ϵ∥vθ(zt,t,c)−(ϵ−z0)∥22,zt=(1−t)z0+tϵ.
通俗地说,模型不是直接把“噪声视频”一步变成“未来视频”,而是在不同噪声时间步预测一个速度方向,使噪声潜变量沿连续路径回到干净潜变量。条件
c
c
c 通常由文本或图像承担;OSCAR 则把机器人动作转化为与 RGB 帧逐帧对齐的视觉骨架。生成时,第一帧保持干净编码,模型只去噪后续帧,以避免退化成无条件修补。[1]
骨架条件并非简单叠加关键点,而是可微渲染意义上的显式几何信号。设 M M M 是 URDF 的连杆集合和父子边集合,某一时刻关节状态 q t q_t qt 经正向运动学得到每个连杆的 SE(3) 位姿;再选连杆原点 o k o_k ok,利用相机内参 K c a m K_{\mathrm{cam}} Kcam 和外参 T c a m w o r l d T_{\mathrm{cam}}^{\mathrm{world}} Tcamworld 投影:
( u k , t , v k , t ) = π ( K c a m , T c a m w o r l d T k , t o k ) . (u_{k,t},v_{k,t}) = \pi\left( K_{\mathrm{cam}}, T_{\mathrm{cam}}^{\mathrm{world}}T_{k,t}o_k \right). (uk,t,vk,t)=π(Kcam,TcamworldTk,tok).
渲染器把投影后的关节顶点和边画成黑色画布上的线条与圆点:
S t = R a s t e r i s e ( { ( u k , t , v k , t ) } k = 1 K , E ( M ) ) . S_t = \mathrm{Rasterise} \left( \{(u_{k,t},v_{k,t})\}_{k=1}^{K}, E(M) \right). St=Rasterise({(uk,t,vk,t)}k=1K,E(M)).
它对每个投影连杆端点画线段、在顶点画小圆点,其他像素保持黑色。没有纹理、没有机器人外壳,因此不会替模型“看图猜动作”。对机械臂而言,夹持器的开合还以视觉状态显示;对人手,则把 URDF 替换为 MANO 拓扑、姿态参数和关节原点。机械臂与五指手的自由度不同,但都被压成同一类 2D 线画,骨架约束粗粒度运动,预训练视频先验补足细粒度视觉。[1]
条件注入方式刻意保持简单,真正的差异来自骨架而非复杂融合模块
骨架 S 1 : T S_{1:T} S1:T 与首帧 I 0 I_0 I0 不是通过大模型拼接再经独立交叉注意力,而是先各自通过同一 WAN 2.1 VAE,得到形状相同的骨架潜变量 z s z^s zs 与目标视频潜变量 z v z^v zv。它们分别经 patch embedder P E v P_E^v PEv 和 P E s P_E^s PEs 映射后直接相加,再进入 DiT。首帧条件沿用 Cosmos 的设计:每一步把第一时序位置的潜变量覆盖为 I 0 I_0 I0 的干净 VAE 编码。
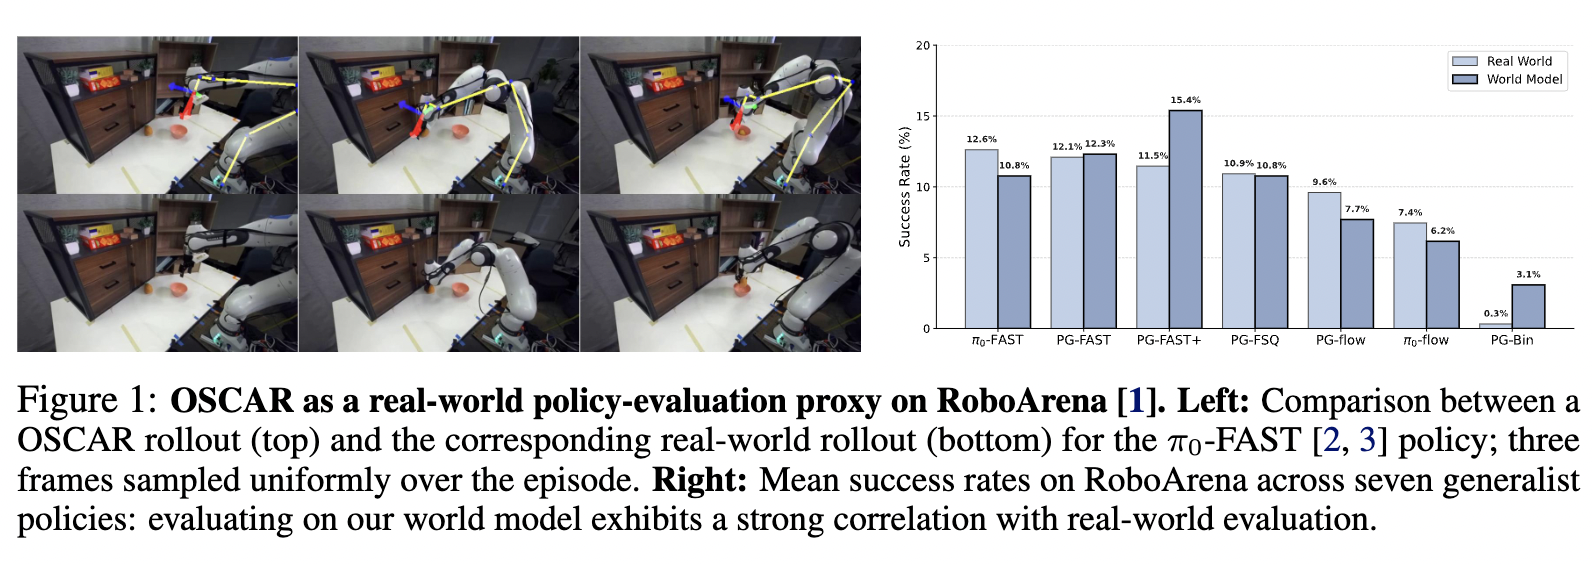
图 1:在全部七项视频生成指标中,OSCAR 均达到最优或次优。左列“次优基线”因指标而异,多数为 GenieEnvisioner;各指标方向不同,不能据此跨指标比较数值大小。数据来源:论文表 2 [1]
这种设计的价值不在架构复杂,而在接口兼容性。传统隐式动作常将每个机械臂编码成固定维度向量:单臂机器人把 7 维末端位姿与夹持器值放入前 7 维、后 7 维置零,双臂机器人则拼接两条 7 维手臂状态,形成 14 维动作接口。OSCAR 则不需要为不同本体设计不同的条件 token 头;只要给出 URDF 或 MANO 拓扑、关节状态、连杆原点和相机标定,即可生成同样的 2D 骨架。改变本体,只是更换运动学规格,而非重新设计模型接口。
训练设置同样体现出资源约束下的工程取舍。模型用 AdamW、学习率 3 × 10 − 5 3\times10^{-5} 3×10⁻⁵、全局 batch size 16;时间步按 logit-normal 分布并采用 shift 参数 5 重加权;训练窗口 81 帧。为避免某类本体占优,采样权重按 w i ∝ n i 1 / T w_i\propto n_i^{1/T} wi∝ni1/T、 T = 3 T=3 T=3 做频率调温;窗口起始帧则偏向夹爪开合跨越的抓取与释放事件。条件 dropout 概率为 0.2,推理时 classifier-free guidance 尺度 w = 6 w=6 w=6。所有模型在同一 GH200 上计时,表 2 显示 OSCAR 为 2.214 FPS。[1]
数据质量由“四道过滤+两级去重+机器字幕”共同决定
OSCAR 的数据并非原始公开数据直接拼合,而是标准化后的结果。来源覆盖五个机器人数据集和两个人视频数据集:RH20T-cfg5、InternData-A1、DROID、AgiBot-Beta、AIROA-MoMa、EgoDex、EPIC-Kitchens。原始量约 216.5 万条,机器人约 174 万条、人类约 42.8 万条;过滤后分别为 9.48 万条和 8.58 万条,总计 18.07 万条。
| 数据源 | 本体或动作来源 | 原始片段 | 过滤后片段 | 保留率 |
|---|---|---|---|---|
| RH20T-cfg5 | Franka Panda | 2,241 | 1,261 | 56.3% |
| RH20T-cfg7 | KUKA iiwa | 未完整披露 | 未完整披露 | — |
| InternData-A1 | Franka Panda(合成) | 630,000 | 2,233 | 0.4% |
| DROID | Franka Panda | 76,000 | 21,904 | 28.8% |
| AgiBot-Beta | AgiBot G1 | 1,003,672 | 65,720 | 6.5% |
| AIROA-MoMa | Toyota HSR | 25,469 | 3,712 | 14.6% |
| EgoDex | 人手 | 338,000 | 78,273 | 23.2% |
| EPIC-Kitchens | 人手 | 89,977 | 7,554 | 8.4% |
| 合计 | 四类机器人+人手 | 2,165,359 | 180,657 | 8.3% |
四道过滤依次要求:片段至少 70 帧,保证有足够 rollout;相机静态,作者明确把移动相机问题留给未来;动作具有非平凡操纵幅度,排除静止视频;骨架可见比例高于阈值。去重不是简单按画面相似删片:先用五帧 SigLIP 嵌入计算余弦相似度,高于 0.95 的候选进入第二级;再按 64 步重采样的操作轨迹计算逐步 RMS 距离,只有视觉相似且轨迹也相近的片段才删除。这样的设计保留了“同场景不同动作”的多样性,去掉的是“同场景重复录制”。
保留后的片段统一用 Qwen3-VL-30B-A3B-Instruct 生成 80–100 词英文字幕:机器人数据和人类数据使用同一提示词,取 15 fps 输入帧;DROID 通常长 5 倍,因此降为 1–2 fps。字幕提供文本先验,骨架则承担帧级空间条件,两者互补而非竞争。
训练分两阶段,热启动使人类视频成为扩充器而非污染源
第一阶段在四种机器人本体上训练 15k 次迭代;第二阶段在全量机器人+人类数据上继续。这里的“继续”不是从零混入,而是以第一阶段权重热启动。消融显示,纯机器人骨架配置为 PSNR 23.48、SSIM 0.832、LPIPS 0.106、FVD 7.69、FID 16.37、latent L2 0.117;从一开始就混入人类数据后变为 23.87、0.842、0.097、7.65、15.72、0.100;机器人模型热启动再提升到 24.24、0.846、0.094、7.08、15.07、0.096。
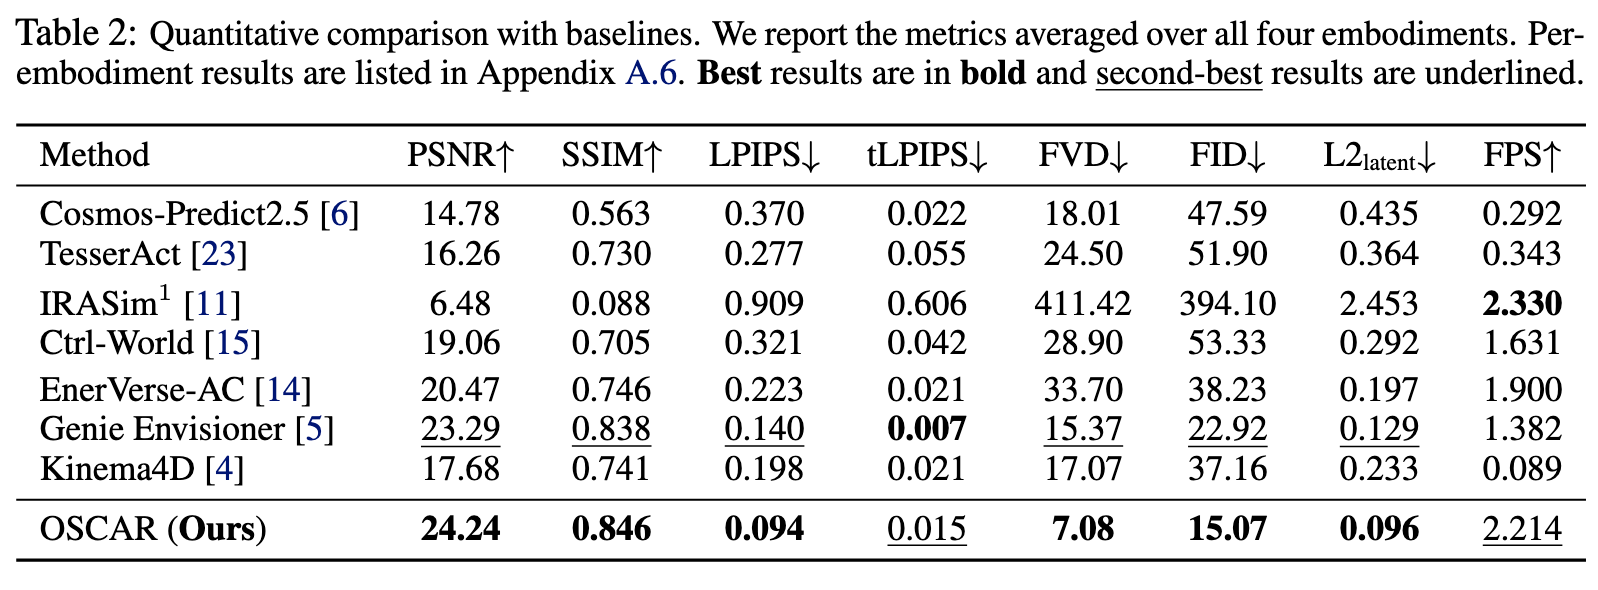
图 2:人类数据与热启动共同带来约 0.76 dB 的 PSNR 提升。数据为同一骨架条件下不同训练数据策略,论文表 3 [1]
这说明人类视频并非无条件的“万能扩充”。从零混入大量人类数据,可能因分布差异干扰机器人运动先验;先稳定机器人基础能力,再让人类视频补充场景、任务、手部动作和视觉多样性,效果更优。它验证了“人类→机器人正迁移”的假设,但尚不能证明 OSCAR 已学会把人类演示的动作语义直接映射到机器人控制。骨架仍只提供可观察的 2D 投影,不直接包含力、抓取约束或人类意图。
三、实验结果:生成质量整体领先,但优势随本体显著分化
七个基线中,OSCAR 取得四项最优、三项次优,而非全项第一
测试集由六个数据集、四类本体中的 200 条机器人片段组成。为保证覆盖,作者先按字幕嵌入与末端执行器运动幅度做聚类去重,再要求末端在完整评价窗口内保持可见,并按各来源片段数的平方根配额平衡长尾。评价统一取前 49 帧,比较 PSNR、SSIM、LPIPS、tLPIPS、FVD、FID、latent L2 和速度。
| 方法 | 规模 | 条件类型 | PSNR↑ | SSIM↑ | LPIPS↓ | FVD↓ | FID↓ | latent L2↓ |
|---|---|---|---|---|---|---|---|---|
| Cosmos-Predict2.5 | 2B | 文本 | 14.78 | 0.563 | 0.370 | 18.01 | 47.59 | 0.435 |
| TesserAct | 5B | 文本 | 16.26 | 0.730 | 0.277 | 24.50 | 51.90 | 0.364 |
| IRASim | 0.7B | 隐式动作 | 6.48 | 0.088 | 0.909 | 411.42 | 394.10 | 2.453 |
| Ctrl-World | 1.5B | 隐式动作 | 19.06 | 0.705 | 0.321 | 28.90 | 53.33 | 0.292 |
| EnerVerse-AC | 约1.5B | 夹爪渲染+隐式动作 | 20.47 | 0.746 | 0.223 | 33.70 | 38.23 | 0.197 |
| GenieEnvisioner | 2B | 夹爪渲染 | 23.29 | 0.838 | 0.140 | 15.37 | 22.92 | 0.129 |
| Kinema4D | 14B | 点图 | 17.68 | 0.741 | 198 | 17.07 | 37.16 | 0.233 |
| OSCAR(ours) | 2B | 2D 骨架 | 24.24 | 0.846 | 0.094 | 7.08 | 15.07 | 0.096 |
表中 Kinema4D 的规模约为 OSCAR 的七倍,参数量从一开始就是不对等的优势。论文强调自己以更小模型和单 GH200 训练胜过 Kinema4D,是合理的工程贡献,但不能据此证明“骨架必然优于点图”。消融中,同骨架条件对网格渲染的差距极小:骨架为 PSNR 23.48、FVD 7.69,网格为 PSNR 23.11、FVD 7.89;网格更依赖具体机器人 URDF 资产,所以论文选择跨本体更方便的骨架,而不是因为网格在生成质量上显著失败。[1]
文本条件整体最弱,说明自然语言不足以替代逐帧空间控制。隐式动作的问题则具有方向性:它并不是“没有动作信号”,而是信号在压缩和映射过程中损失了像素级对应关系。IRASim 甚至采用单 7 自由度动作接口,与双臂 AgiBot G1 和移动底座 AIROA-MoMa 不兼容,因而未列入这两类结果。由此看,OSCAR 的真正优势是条件表达更可迁移,而非单纯网络更深或训练更久。
四项形态上 OSCAR 领先,但 AIROA-MoMa 和 DROID 暴露了分布外短板
跨本体评价不能只用一个平均分数概括。AgiBot G1 测试 75 条,OSCAR 为 PSNR 23.70、SSIM 0.852、LPIPS 0.079、tLPIPS 0.013、latent L2 0.076,五项均优于所有基线;InternData 测试 30 条,OSCAR 为 27.65、0.864、0.061、0.008、0.042,同样五项第一。RH20T-cfg5 与 cfg7 分别测试 23、21 条,OSCAR 的 PSNR 为 26.92 和 25.85,SSIM 为 0.906 和 0.892,也是两项最强。
AIROA-MoMa 的 23 条测试却出现不同结果:OSCAR 为 PSNR 20.77、SSIM 0.715、LPIPS 0.254、tLPIPS 0.035、latent L2 0.312;GenieEnvisioner 的 LPIPS 0.195、latent L2 0.208 均更优。DROID 的 29 条片段中,OSCAR 为 PSNR 21.60、SSIM 0.834,仍是第一;但 LPIPS 0.102 低于 GenieEnvisioner 的 0.154,tLPIPS 0.020 也低于后者的 0.005。FVD、FID 因跨形态需要统一统计而被放在总表中,因此这里不能把单个形态的 PSNR 与总体 FVD 混成一张“综合分”。
这些差异揭示了生成指标的互补性。PSNR、SSIM 偏向像素级重建;LPIPS、tLPIPS 更强调感知与时间一致性;FVD、FID 描述生成分布。OSCAR 强于像素重建,并不保证在每类形态上都同样擅长细节感知或长期时间一致性。AIROA-MoMa 包含移动操作、场景跨越房间,数据保留量仅 3,712 条;DROID 虽来自真实环境,但数据规模、相机与任务结构均不同。由此可见,“四类本体联合训练”并不意味着四类本体已达到同等级可靠性。
骨架条件给出最强的真实排名相关性,但没有消除幻觉风险
论文从 RoboArena 保留 65 个场景,每个场景对七个 DROID 通用策略生成 rollout,形成 65×7=455 个(场景、策略)单元。策略包括 π0-flow、π0-FAST、PG-flow、PG-FSQ、PG-FAST、PG-FAST+ 和 PG-Bin。由于公开数据不含逐场景相机标定,作者先用 MoGe-v2 估计内参,再用 CtRNet-X 估计静态相机到基座外参,并人工检查左相机骨架叠加质量后才保留样本。
评价协议采用开放循环:从真实首帧和给定动作自回归展开,而不是直接让策略在生成环境中闭环交互。GPT-5 从生成视频中均匀取 32 帧,仅见任务指令和帧,按时间顺序输出二元成功、0–100 部分进度与一句理由。七个策略的成对视频比较共形成 1,365 个偏好对,再计算 Bradley–Terry 成功率,与 RoboArena 官方 BT/Elo 排名比较。
| 条件 | MMRV↓ | Spearman ρ↑ | Pearson r↑ | SISRΔ(百分点)↓ |
|---|---|---|---|---|
| 隐式动作 | 1.429 | +0.643 | +0.867 | 1.98 |
| 带纹理网格 | 0.714 | +0.679 | +0.781 | 3.04 |
| 2D 骨架 | 0.571 | +0.750 | +0.852 | 1.73 |
MMRV 越低越好,表示平均最大排名违规越少;Spearman ρ 衡量策略排名顺序关系;Pearson r 衡量平均二元成功率之间的线性关系;SISRΔ 是预测与真实平均成功率的绝对误差。骨架条件在这四项中取得三项最优、一项次优。图 1 右上的世界模型柱状成功率与真机成功率数值接近,是这一排名协议支持的结论,不是“逐场景成功率预测无误差”。
更有解释力的失败证据来自 VLM 校准。100 个平衡样本里,真实成功与失败各 50 个;GPT-5 与人工二元标签一致 78 例,特异性 0.90,成功召回率仅 0.66,与人工标签相关 r=0.58、p<1e-7。论文的定性案例也显示,模型可能把“手臂已接近并移动目标、人类评价者认可部分进展”的任务判为失败。因此,OSCAR 更适合稳定地排除失败者,而不是以绝对成功率宣称“已经等于真机”。[1]
四、分析:OSCAR 贡献的是一套可复现条件与评测栈,而不是世界模型泛化的终局
骨架的价值在于把“控制接口差异”从视觉预测中剥离
OSCAR 最有说服力的贡献,是找到了一个在表达力、跨本体性和数据可得性之间较稳定的动作表征。隐式动作轻量但模糊,点图准确却绑定几何,夹爪渲染跨本体性较强却无法描述整臂运动;骨架保留了关节层级、连杆关系和可见末端状态,同时不渲染机器人涂装与纹理。它的可迁移性来自表示形式统一,而不是训练数据已经覆盖所有本体。只要能标定相机并获得 URDF/MANO 状态,新机器人即可进入同一接口。
这一设计还把工程边界说得很清楚:标定正确时,骨架和 RGB 首帧保持对齐;标定错误时,骨架本身不能修复错位。论文也把相机移动留作未来工作,并对静态相机场景进行严格过滤。因此,骨架不是“动作表征问题的最终答案”,而是当前数据、标定和生成模型约束下的一套有效协议。它更适合桌面操纵、固定视角、可见机械臂或人手的场景,不能直接外推到自由移动相机、严重遮挡、柔性物体、双手复杂协同和力控任务。
数据流水线同样值得借鉴。去重不是简单删相似帧,而是把“视觉重复”和“轨迹重复”分开;数据配比也不采用静态比例,而是按样本量频率调温,避免小本体被大本体淹没。人类数据的正迁移则提示:以人为中心视频的价值不只是增加帧数,更在于补充机器人录制不易覆盖的日常任务、场景和手部运动。但报告必须指出,这个证据来自固定训练阶段与固定评测集,不能推广为“任意人类视频越多越好”。
单 GPU 的吸引力在于微调成本,不意味着完整数据准备成本很低
论文反复强调在单张 GH200 上微调 2B 模型,相对于 14B Kinema4D 或其他多 GPU 基线有明显成本优势。这是事实,但不能把它误解为整条链路只有一张卡。数据准备仍需要关节状态、URDF、相机内参、相机到基座外参、手部模型姿态、SigLIP 特征、轨迹重采样与字幕生成。论文也承认,当前数据规模受每个数据集相机标定和运动学标注的可得性与质量限制:相机内外参错误会直接破坏骨架与 RGB 的对齐,从而降低可用数据量。[1]
因此,OSCAR 降低的是“在已有高质量运动学数据上微调世界模型”的门槛,没有消除“获得高质量运动学数据”本身的门槛。若要扩展到新机器人平台,工作量可能集中在标定、状态采集和骨架渲染,而不是扩散模型参数。反过来,这也为工程落地提供了清晰路线:优先建设标定与运动学基础设施,再扩大生成模型规模,比只训练更大的视频模型更可能解决数据对齐问题。
排名相关性是进展,但开放循环、VLM 判官和短视界限制了外推
第一个局限是评测循环本身。RoboArena 实验给定的是真实动作轨迹,OSCAR 只预测“如果执行这些动作,视频会怎样”,没有让策略根据生成视频持续决定下一步动作。它验证的是动作条件预测与任务结果之间的关联,尚未验证生成环境是否可作为闭环训练或强化学习环境。若用于策略改进,累积误差、物体状态偏差和错误奖励会通过闭环反馈放大。
第二个局限是时间范围。测试主要围绕较短视频窗口,AIROA-MoMa 则表明移动操作仍是明显难点。世界模型即使短期帧级动作跟随准确,也不能保证长任务中的物体状态、接触关系、遮挡和工具使用长期正确。作者也明确把更大模型、移动相机和未来改进列为开放问题。
第三个局限是评测口径的不可还原性。论文没有披露所有基线在相同数据、相同微调步数、相同推理步数和完全相同硬件调度下的成本,且不同基线的训练数据集并不一致。表 5 显示,Kinema4D 使用 Robo4D-200k,EnerVerse-AC 和 GenieEnvisioner 使用 AgiBot World,而 OSCAR 使用跨来源混合数据。因此,“2B 胜过 14B”是论文设置下的结果,不能直接归纳为参数效率定律。
第四个局限是视频指标不能直接代表策略安全。PSNR 高不代表接触力合理,FVD 低不代表物体摆放达到语义成功。VLM 会漏判真实成功,也会受到视频清晰度、采样帧、提示词和自身偏见影响。OSCAR 可以提供可复核的视觉轨迹,但接触安全、破坏性动作和长期任务成功仍需要真机或其他物理验证。
对研究与实践最可迁移的启示是“先筛后验”,而非“以假代真”
OSCAR 给出的实践路线是分层筛选:先用动作条件世界模型在多个任务、场景和初始状态下生成 rollout,由 VLM 给出连续偏好或成功率代理;再对排名靠前、状态分布稳定的候选策略进行有限真机验证。这个流程能把大量明显失败的方案挡在真机之外,却不能省掉最终安全验证。若直接使用 OSCAR 输出替代真机,必须针对每个新任务重新校准 VLM,至少报告成功召回、失败特异性、真实成功率偏差和排名违规。
未来工作最有价值的三个方向分别是:其一,把静态相机限制扩展到 ego-motion 与主动视角,真正覆盖移动操作;其二,让世界模型进入闭环,报告策略改进收益、累积误差和 reward hacking,而不只报告生成指标;其三,把二维骨架升级为包含接触、三维遮挡和物理状态的显式表示。后一方向若成功,可以提高对复杂任务的保真度;但也会增加标注和渲染成本,重新面对 OSCAR 当前刻意避开的外观绑定问题。
OSCAR 的位置应被理解为“可信虚拟筛选器的早期可复现原型”,而不是“通用机器人模拟器”。它的进步在于把数据治理、运动学条件、生成质量和排名评测串成一条可验证链条;它的边界也同样清晰:数据依赖标定,评测依赖 VLM,短视界和开放循环决定它尚不能独立承担安全关键决策。对于研发团队,最合理的策略不是等待模型达到百分之百一致,而是在目标平台上建立小规模、有人类标签的校准集,把 OSCAR 用于候选排序,再保留真机验证作为最终闸门。
Reference
[1] From World Models to World Action Models: A Concise Tutorial for Robotics
[2] https://arxiv.org/html/2606.04463v2

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献25条内容

所有评论(0)