PRISM——用4段真人搬运视频,让机器人学会搬运各种东西:以真实视频为“种子”,生成“换个物体人会怎么搬”的反事实交互视频,再重建并重定向为符合物理规则的轨迹,最后通过师生蒸馏出策略
前言
近期,我司除了场景落地开发外(即基于自研的具身垂直大脑做批量交付,如上下料、搬运分拣、插拔装配),还不断强化了硬件服务,涵盖:
- 产品采购
针对市面上主流的30家本体,都有远低于市面价的渠道代理价
且1 费用更低,2 能给原厂商因为精力限制 而给不了的科研指导 - ODM
帮30天打造自有品牌/IP的机器人,如帮造1.1m/1.4m/1.6m的双足人形,涵盖“硬件、软件、外观”三大模块 - 手搓人形有两高校让我们手搓1.2人形
软硬件全开放的1.2m人形 + 机器狗双平台,把图纸、代码、BOM 全部交给学校,构建从仿真训练到真机行走的完整闭环
我们也将最快26年10月份之内,在深圳建立办公室,如果你在深圳,之前组装过人形,欢迎私我(相当于我司软硬人才都需要,硬件人才base深圳居多,软件人才还可base长沙)
当然,除了手搓硬件之外,我们更会不断提升“让机器人干活”的水平和能力,过程中,自然不可避免的关注到一系列让机器人干活的成果,比如本文要介绍的PRISM,而这个PRISM的作者们也算是大家的老朋友了,本博客中也解读过相关作者的不少作品
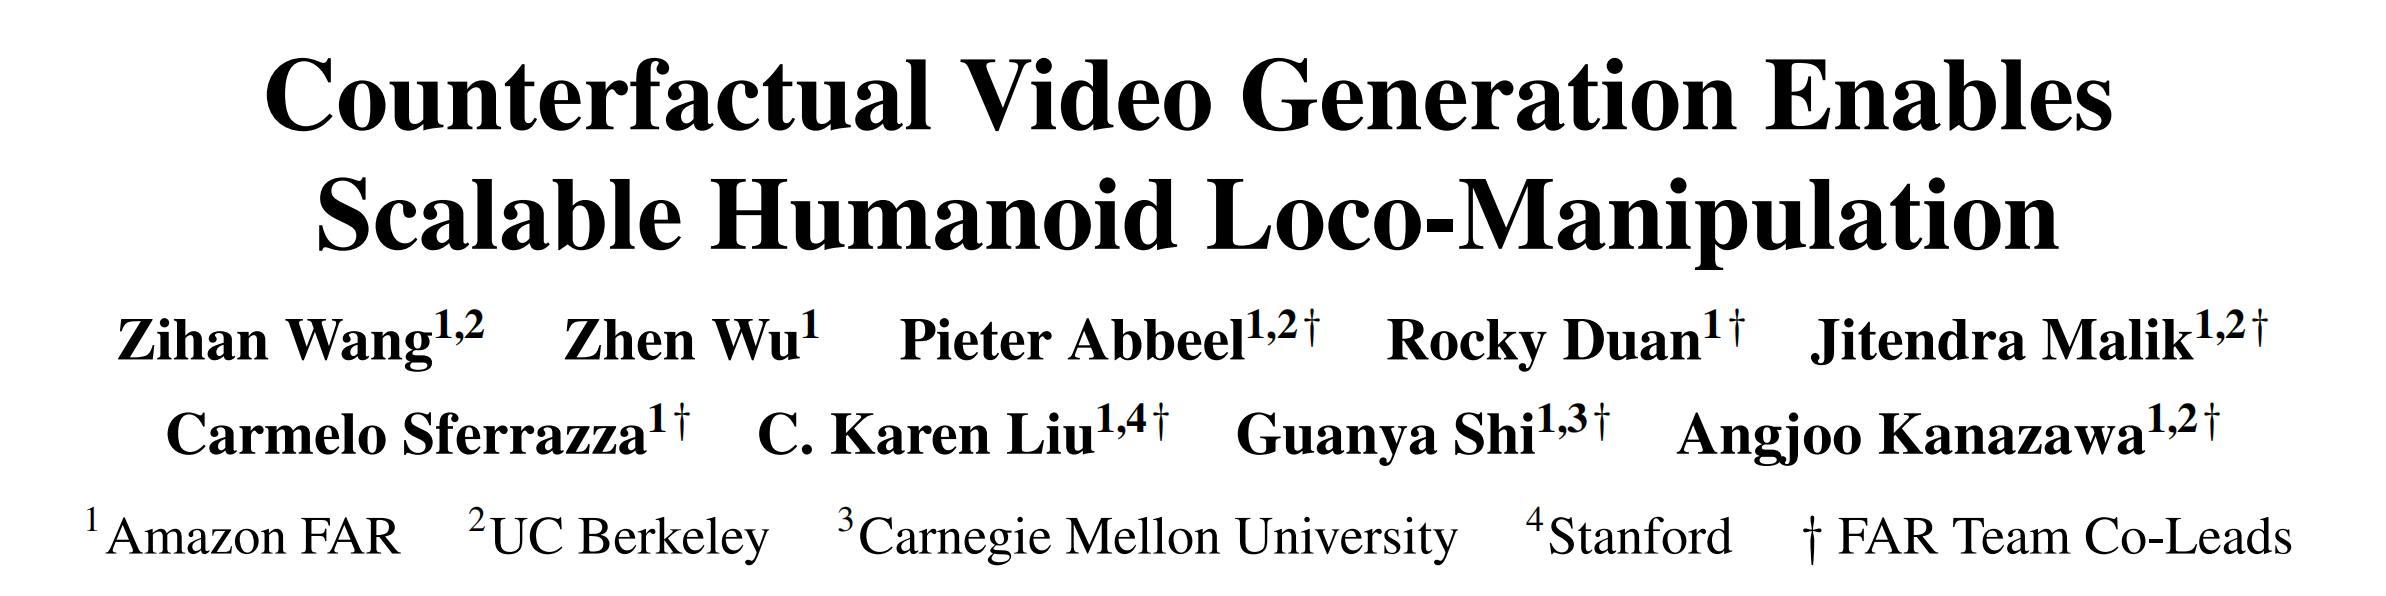
- 如PRISM原论文所述,通过视觉模仿来教会人形机器人行走-操作(loco-manipulation)技能,例如在移动过程中搬运各种各样的物体,是通往通用型机器人的一条极具前景的路径
- 然而,要采集多样且高质量的人机交互视频——例如那些能够清晰展示一个人的完整身体以及其与物体的不被遮挡的交互,构成了扩大这一方法规模的实际障碍
对此,作者提出 PRISM,这是一种“真实到仿真再到真实”(real-to-sim-to-real)的框架,通过将少量真实视频扩增为大规模且多样化的训练集,从而克服这一限制
- 具体而言,PRISM 首先通过从少数示例性真实视频进行视频到视频(V2V)生成,合成数百段多样化的“反事实”人–物体交互视频
- 随后,作者基于接触锚定的 real-to-sim 流水线同时重建人体和物体的运动,并将这些不完美的视频数据重定向为物理上合理的轨迹
这些反事实视频内部类别间的多样性使得能够训练出一个单一策略,在每个物体类别内对未见过的对象实现良好的泛化
通过在真实机器人上部署该策略、且无需任何真实世界微调,来展示这一完整流水线
且仅利用机载深度观测,人形机器人即可抓取、搬运和放置物体——包括箱子、桶、料箱以及球体——并适应全新实例、不同尺寸以及多种初始配置
第一部分 Counterfactual Video Generation EnablesScalable Humanoid Loco-Manipulation
1.1 引言与相关工作
1.1.1 引言
类人机器人如何才能学会与日常生活中遇到的各类多样物体进行交互?视觉模仿学习提供了一条很有前景的途径:通过人类示范,给出协调的全身运动示例,使机器人能够接近、举起、搬运和放下不同的物体
- 近期的“现实到仿真再回现实”(real-to-sim-to-real)流程 [1],已经使类人机器人能够直接从人类视频中习得具备情景上下文的全身运动技能
这些进展表明了一条可行道路:面向通用型类人机器人,使其能够从互联网规模的视频数据中学习到广泛的运动与操作技能库 - 然而,获取多样且高质量的人–物体交互视频,仍然是扩展视觉模仿学习的一个实际瓶颈
互联网上的视频数量极其丰富,但其内容与构图往往是由人类的观看偏好所塑造的
要从互联网视频中筛选出既能清楚展示人物全身、又能清晰呈现其与物体交互过程的示范视频,因此代价高昂,且在大规模场景下难以实施
不过,这类交互数据在现代视频生成模型中却是“隐式”存在的 [2],这些模型对人体运动和交互的先验表征可以被用来合成多样化的训练视频
为了解决这一数据瓶颈,来自1 Amazon FAR、2 UC Berkeley、3 Carnegie Mellon University 、4 Stanford † FAR Team Co-Leads的研究者提出了 PRISM,一种 real-to-sim-to-real(现实到仿真再到现实)的框架
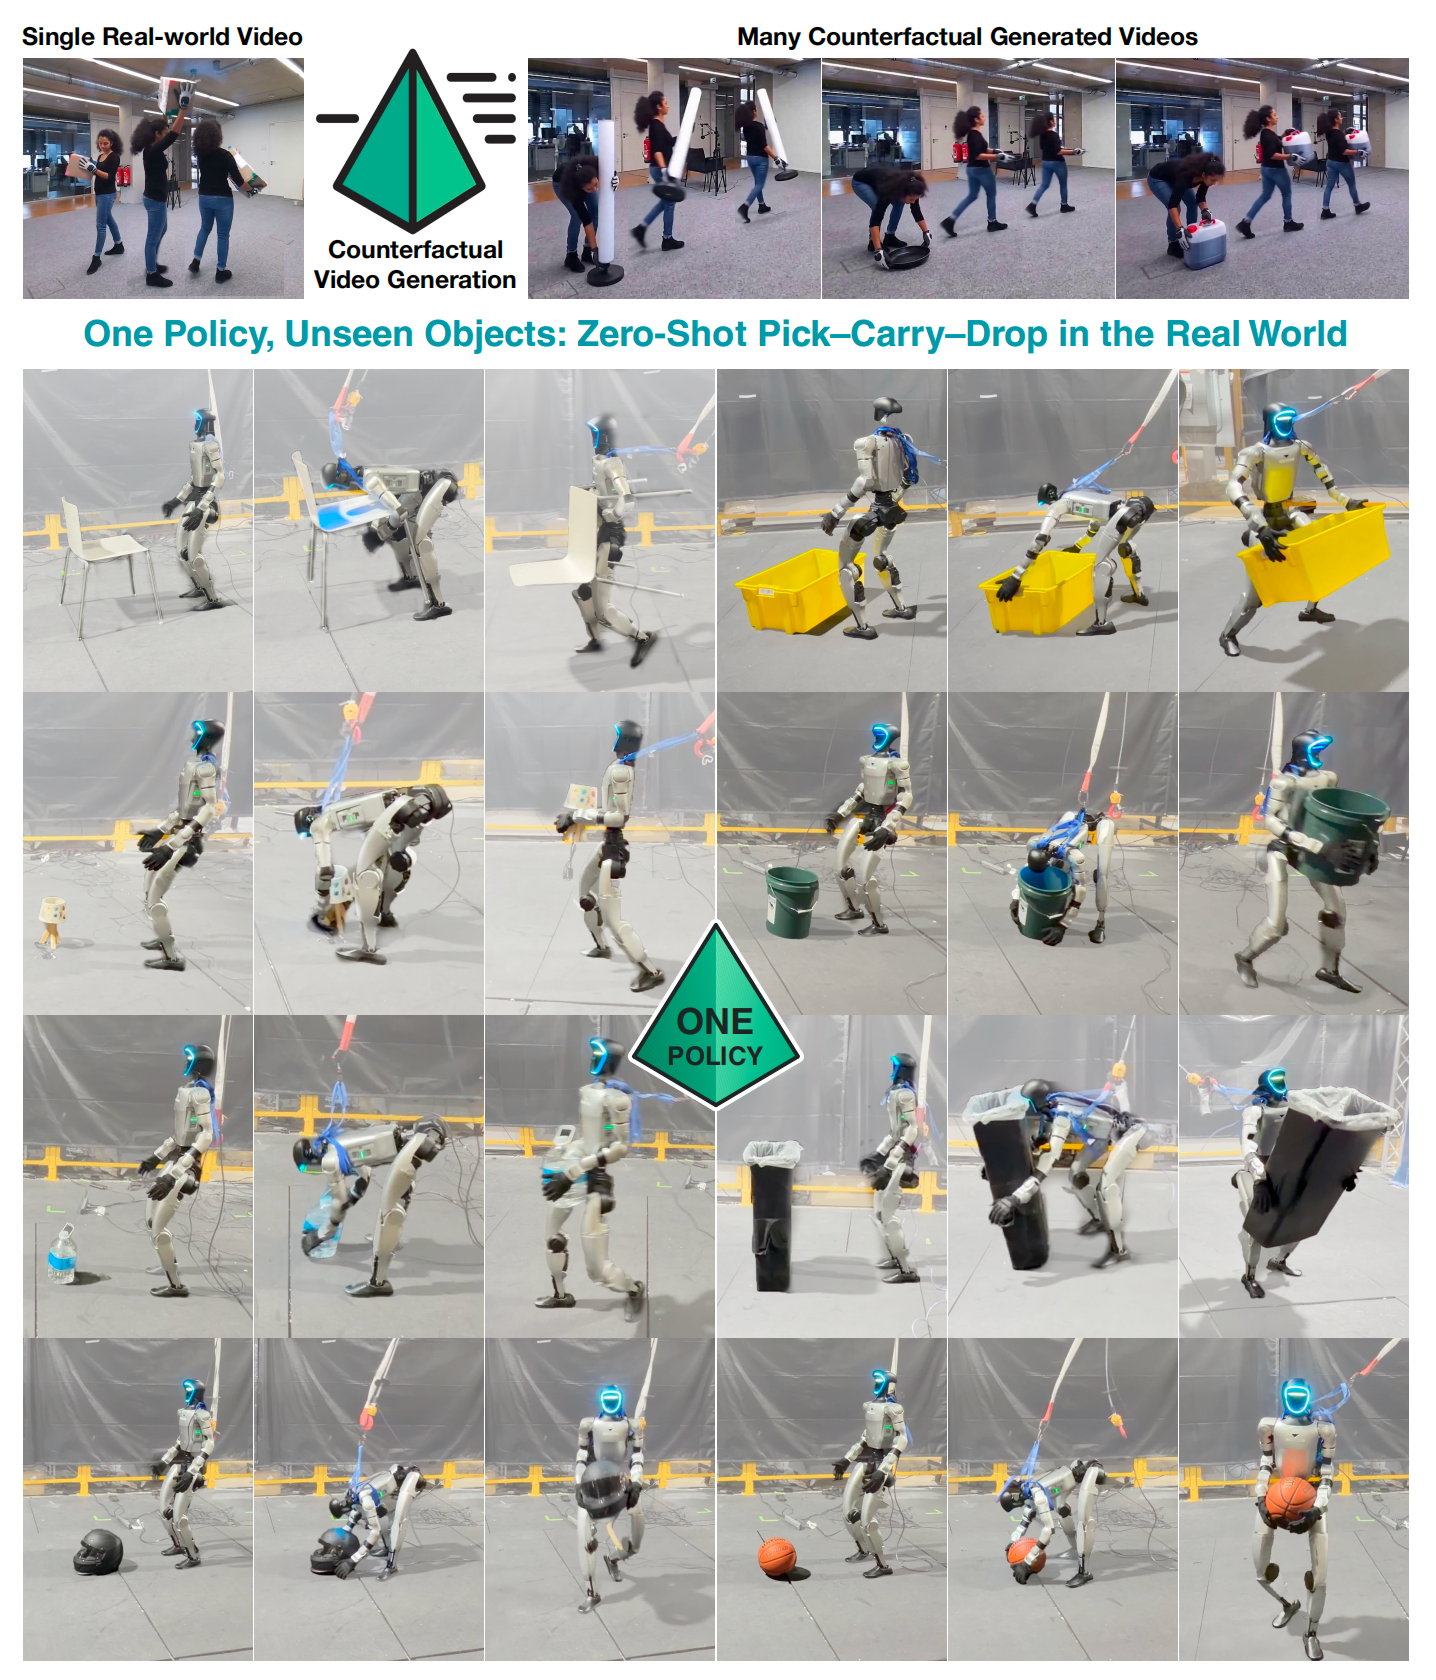
- 其利用视频到视频(video-to-video,V2V)生成技术,将少量真实视频扩展为多样化的人—物体交互
作者将这些生成的片段称为“反事实视频”(counterfactual videos):它们展示的是在源视频中并未发生、但在更换物体后本可以发生的交互情形
仅基于 4 段现实世界的人搬运箱子的视频,作者就生成了 256 段反事实视频,这些视频在相同任务场景下,展示了箱子、球、垃圾桶和桶等类别在不同几何形状和不同初始配置下的交互过程 - 然后作者以接触为锚点的 real-to-sim 流水线在统一的世界坐标系中重建人体运动、静态场景,以及动态物体的几何与运动,然后将这些不完美的重建、并重定向为物理上合理的人形体—物体轨迹
- 基于这些轨迹,作者训练出一个单一的、基于深度信息的策略,使其能够在真实世界中以零样本方式拾取、搬运和放下这些类别中从未见过的具体实例,从而验证了整个流水线的有效性。且该策略还能泛化到在生成视频中从未出现过的类别(如图 1 所示)
进一步而言,该工作的核心技术挑战在于:在反事实视频生成和单目重建都会引入误差的前提下,仍然获得物理上合理的机器人示范
- 作者的关键洞见是,将接触信号作为贯穿重建、重定靶与策略学习各阶段的共享约束
在第一阶段的重建过程中,人–物体接触将两种运动耦合起来:人体运动为物体轨迹提供引导,而物体接触则有助于纠正重建人体姿态中的误差 - 在重定靶阶段,稀疏的接触锚点用于指定机器人末端执行器应在物体上的接触位置,从而在兼容形态差异的同时,引导将嘈杂的重建结果优化为物理上合理的机器人–物体轨迹
- 在策略学习阶段,这些锚点为“特权教师策略”定义接触奖励,该教师策略同时跟踪机器人和物体的运动
随后,将其蒸馏为一个基于深度信息、带有摇杆控制的策略,以实现零样本的从仿真到真实部署
1.1.2 相关工作
首先,对于人形机器人行走-操作一体化
- 人形机器人行走-操作(loco-manipulation)在计算机图形学领域 [3,4] 和机器人领域 [5,6,7] 中都得到了广泛研究,其目标是在全身运动过程中,同时协调躯体行走与物体交互
一些人形机器人系统 [5] 通过跟踪人类动作参考来学习交互技能,但在推理阶段需要密集的人体参考动作或物体轨迹,这限制了其对未见物体和新交互配置的泛化能力 - 较新的方法 [8,9,10] 通过从稀疏目标或以交互为中心的表示中学习更加自主的交互策略,从而降低了这种依赖性
同样地,PRISM训练了一个统一的全身人形机器人策略,使其能够在无需参考或动作捕捉系统支持的部署条件下,仅凭机载深度观测,实现零样本的摇杆控制拾取、搬运和放置行为
其次,对于从人类视频中学习
- 近期工作从人类视频中学习仿人技能 [5,11],包括通过联合的人体–场景重建实现具备地形感知的行走 [1],以及动态物体交互 [5,12]
然而,在大规模条件下采集或整理多样且高质量的交互视频仍然具有挑战性 - PRISM 通过视频到视频生成,将少量真实视频扩展为多样的人–物体交互,从而应对这一互补性的挑战
利用这些数据,作者训练了一个单一策略,在现实世界中即可零样本拾取、搬运和放下多种不同的物体
最后,对于将视频模型视为 Data++
近期工作在机器人学习的视频生成方面主要探索了两大范式
- 一类方法在推理阶段将视频模型用作规划器或动作生成器,通过合成未来的视觉 rollout 来指导闭环操作控制 [13,14,2]
此类方法虽然具备灵活的视觉推理能力,但需要在测试时进行高成本的视频生成,而且在“看起来合理的视频”与“物理上可执行的机器人动作”之间,可能存在可执行性鸿沟 - 另一类方法则在离线阶段使用视频模型,在策略学习之前合成机器人示范或扩充机器人数据集 [15,16]
PRISM 采用的是离线生成范式,但有所不同的是,它通过有语义对齐约束的 V2V(video-to-video)生成,产生反事实的人类交互视频,而不是直接从文本或图像生成机器人视频
通过以真实示范为条件输入,V2V 能够保留逼真的运动、光照以及考虑可供性(affordance)的接触模式;同时,一个简单统一的提示可以通过多次采样,将单个示例扩展到多种物体类别、姿态以及类内变化
1.2 真实到仿真数据采集
给定一段单目视频,其中展示了一名人类在一个静态场景中与一个动态物体交互,作者的目标是恢复相机参数,一个静态场景网格
,以及一个具有其度量网格
及其逐帧位姿
,以及 4D SMPL-X [17] 动作,全部统一在同一个世界坐标系中坐标系中
随后,作者将恢复出的数据重定向为人形体–物体轨迹,用于策略学习
具体而言,如下图所示,PRISM 将反事实(counterfactual)的人体–物体视频转换为可部署的人形机器人行走-操作一体化技能
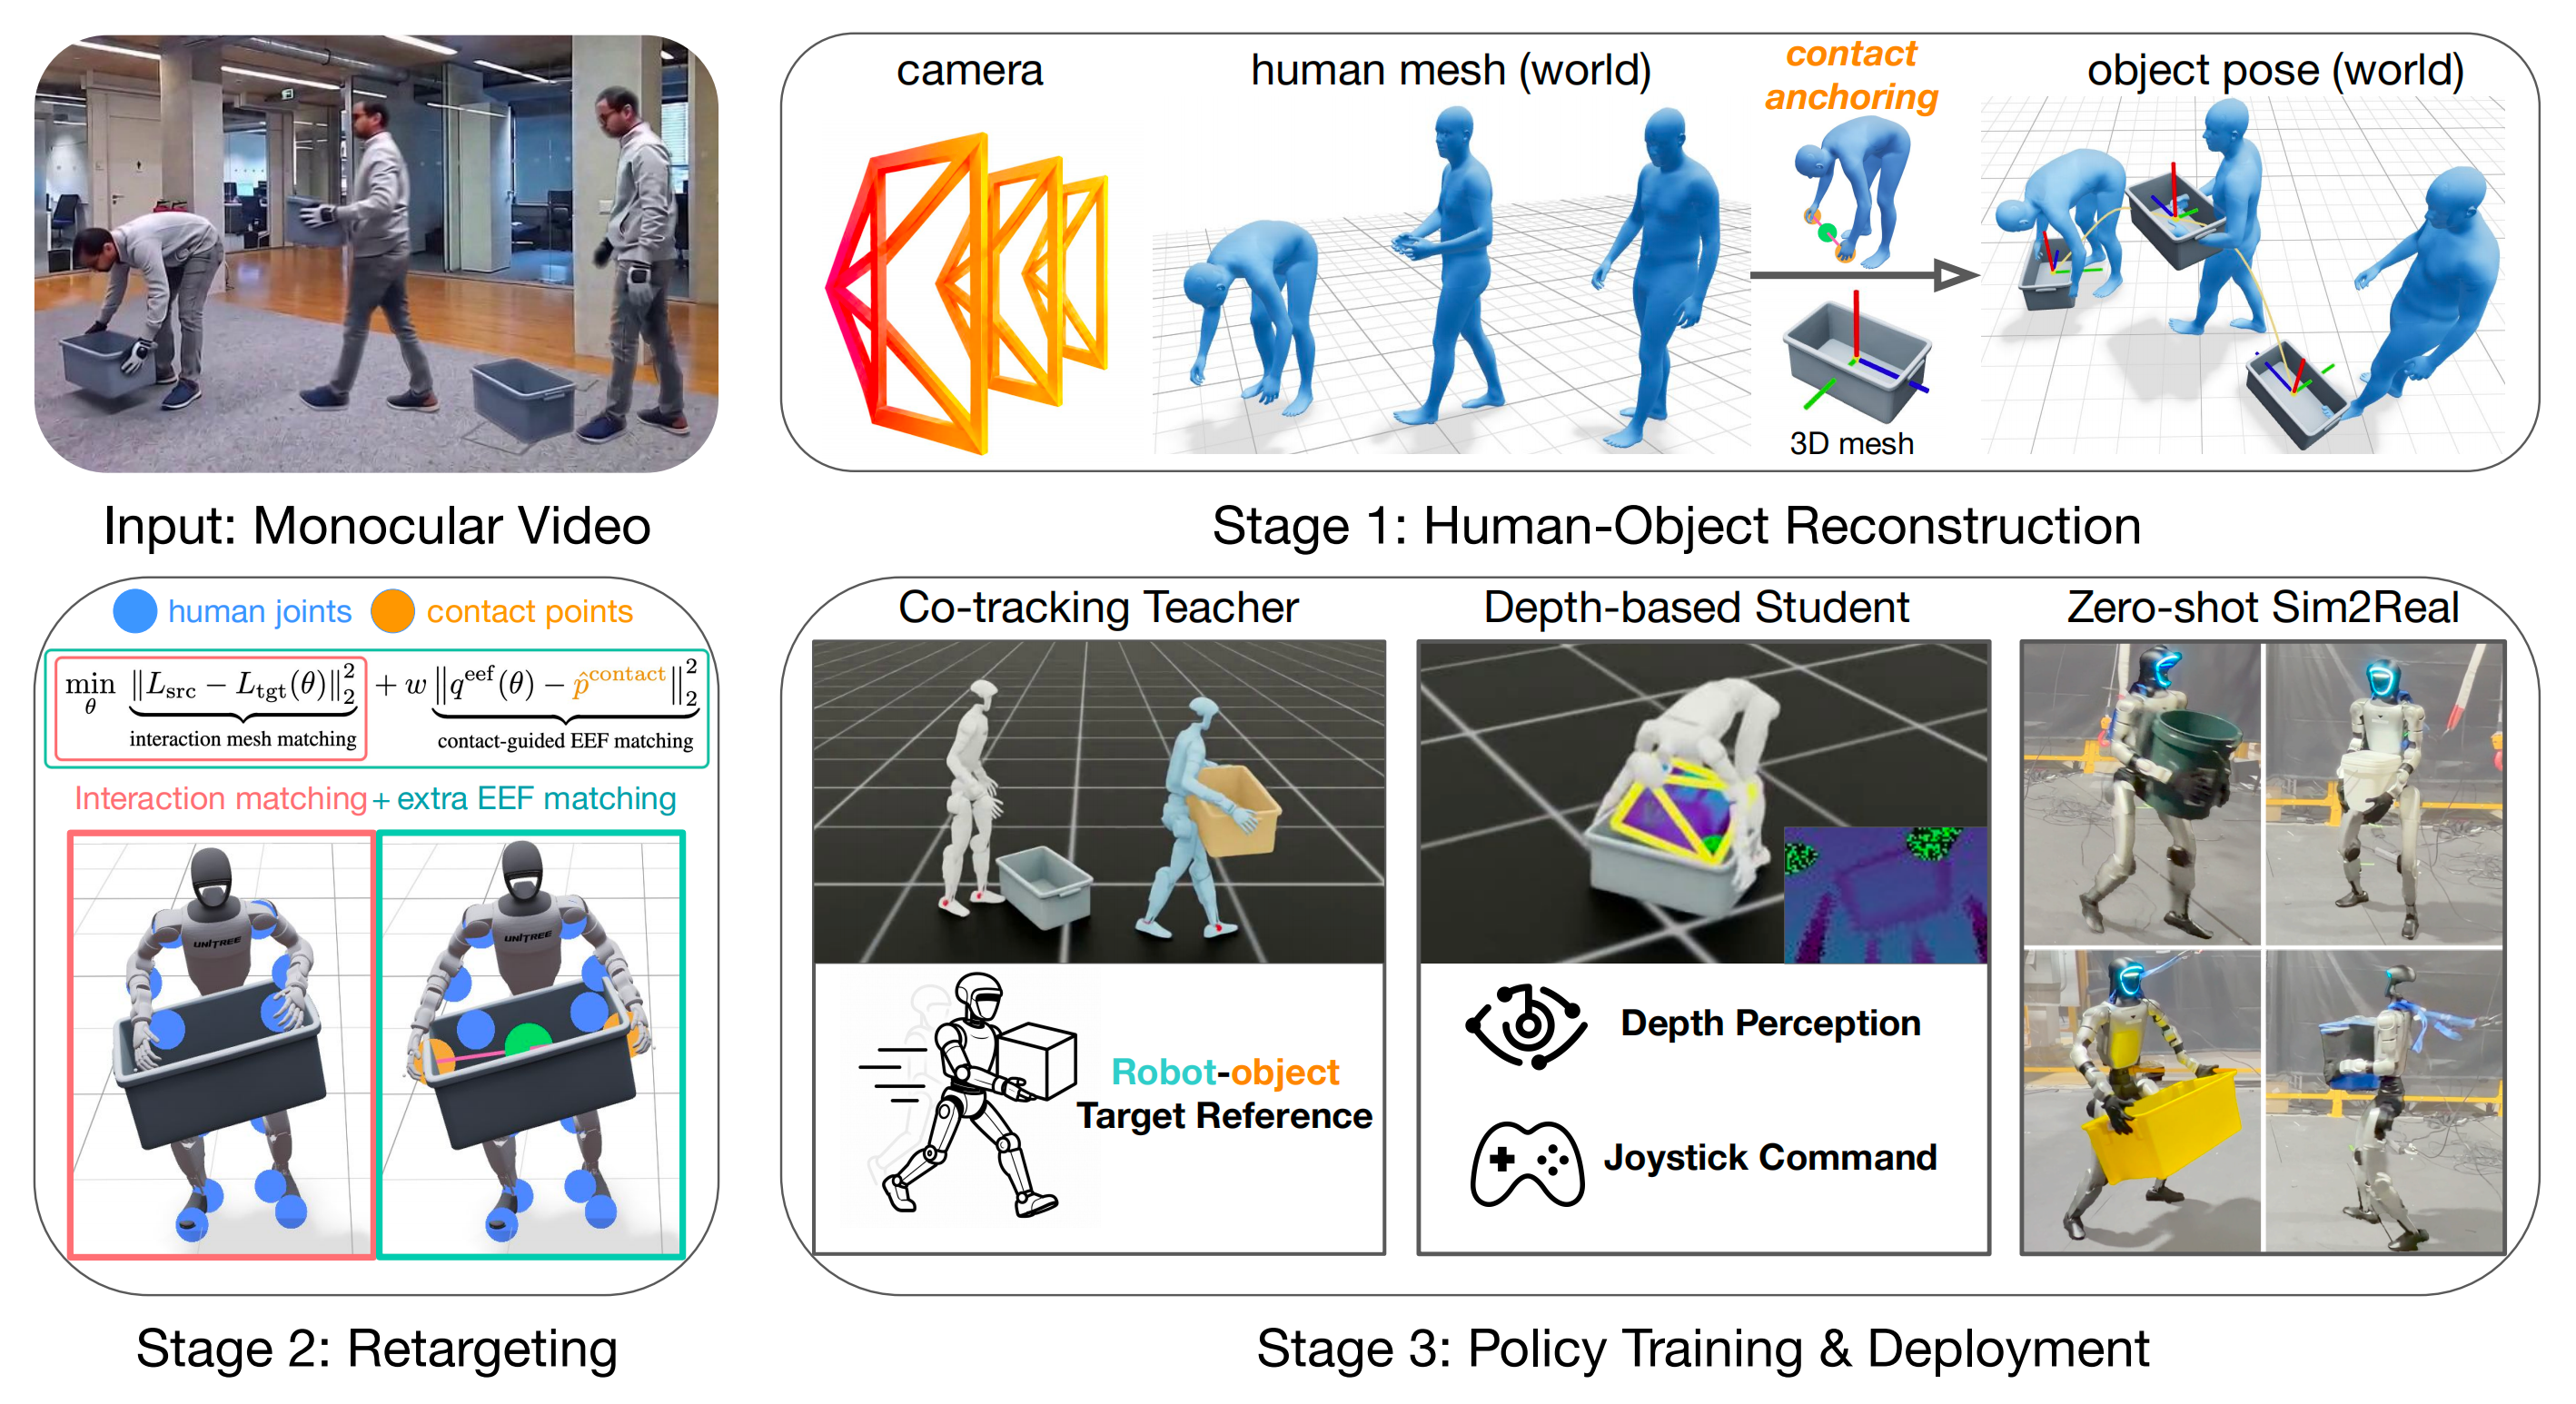
- 它在共享的世界坐标系中重建相机、人类运动、物体几何以及物体的 6D 运动,并利用接触点在单目歧义下对物体位姿优化施加约束
- 相同的锚点也用于重定向过程,以保持交互阶段一致,并将机器人末端执行器与预期的接触点对齐
- 重定向后的示范用于训练具备特权信息的协同跟踪教师模型,然后将其蒸馏为基于深度的学生策略,该策略以机载深度信息和摇杆指令为条件,实现零样本的仿真到现实部署
1.2.1 反事实交互视频生成
利用在线视频扩展从真实世界到仿真环境(real-to-sim)的学习仍然充满挑战。尽管互联网上的视频极为丰富,但其内容与构图往往受人类观看偏好所驱动。因而,要在大规模条件下筛选出既具有多样性、又具备清晰的全身视角、可见的人–物交互以及稳定视角的片段,成本高昂且不切实际
- 因此,作者采用视频到视频(video-to-video, V2V)生成,将一小部分合适的真实视频扩展为多样化的“反事实”交互视频——即在源视频中实际并未发生、但本可以通过更换不同物体而发生的人–物交互
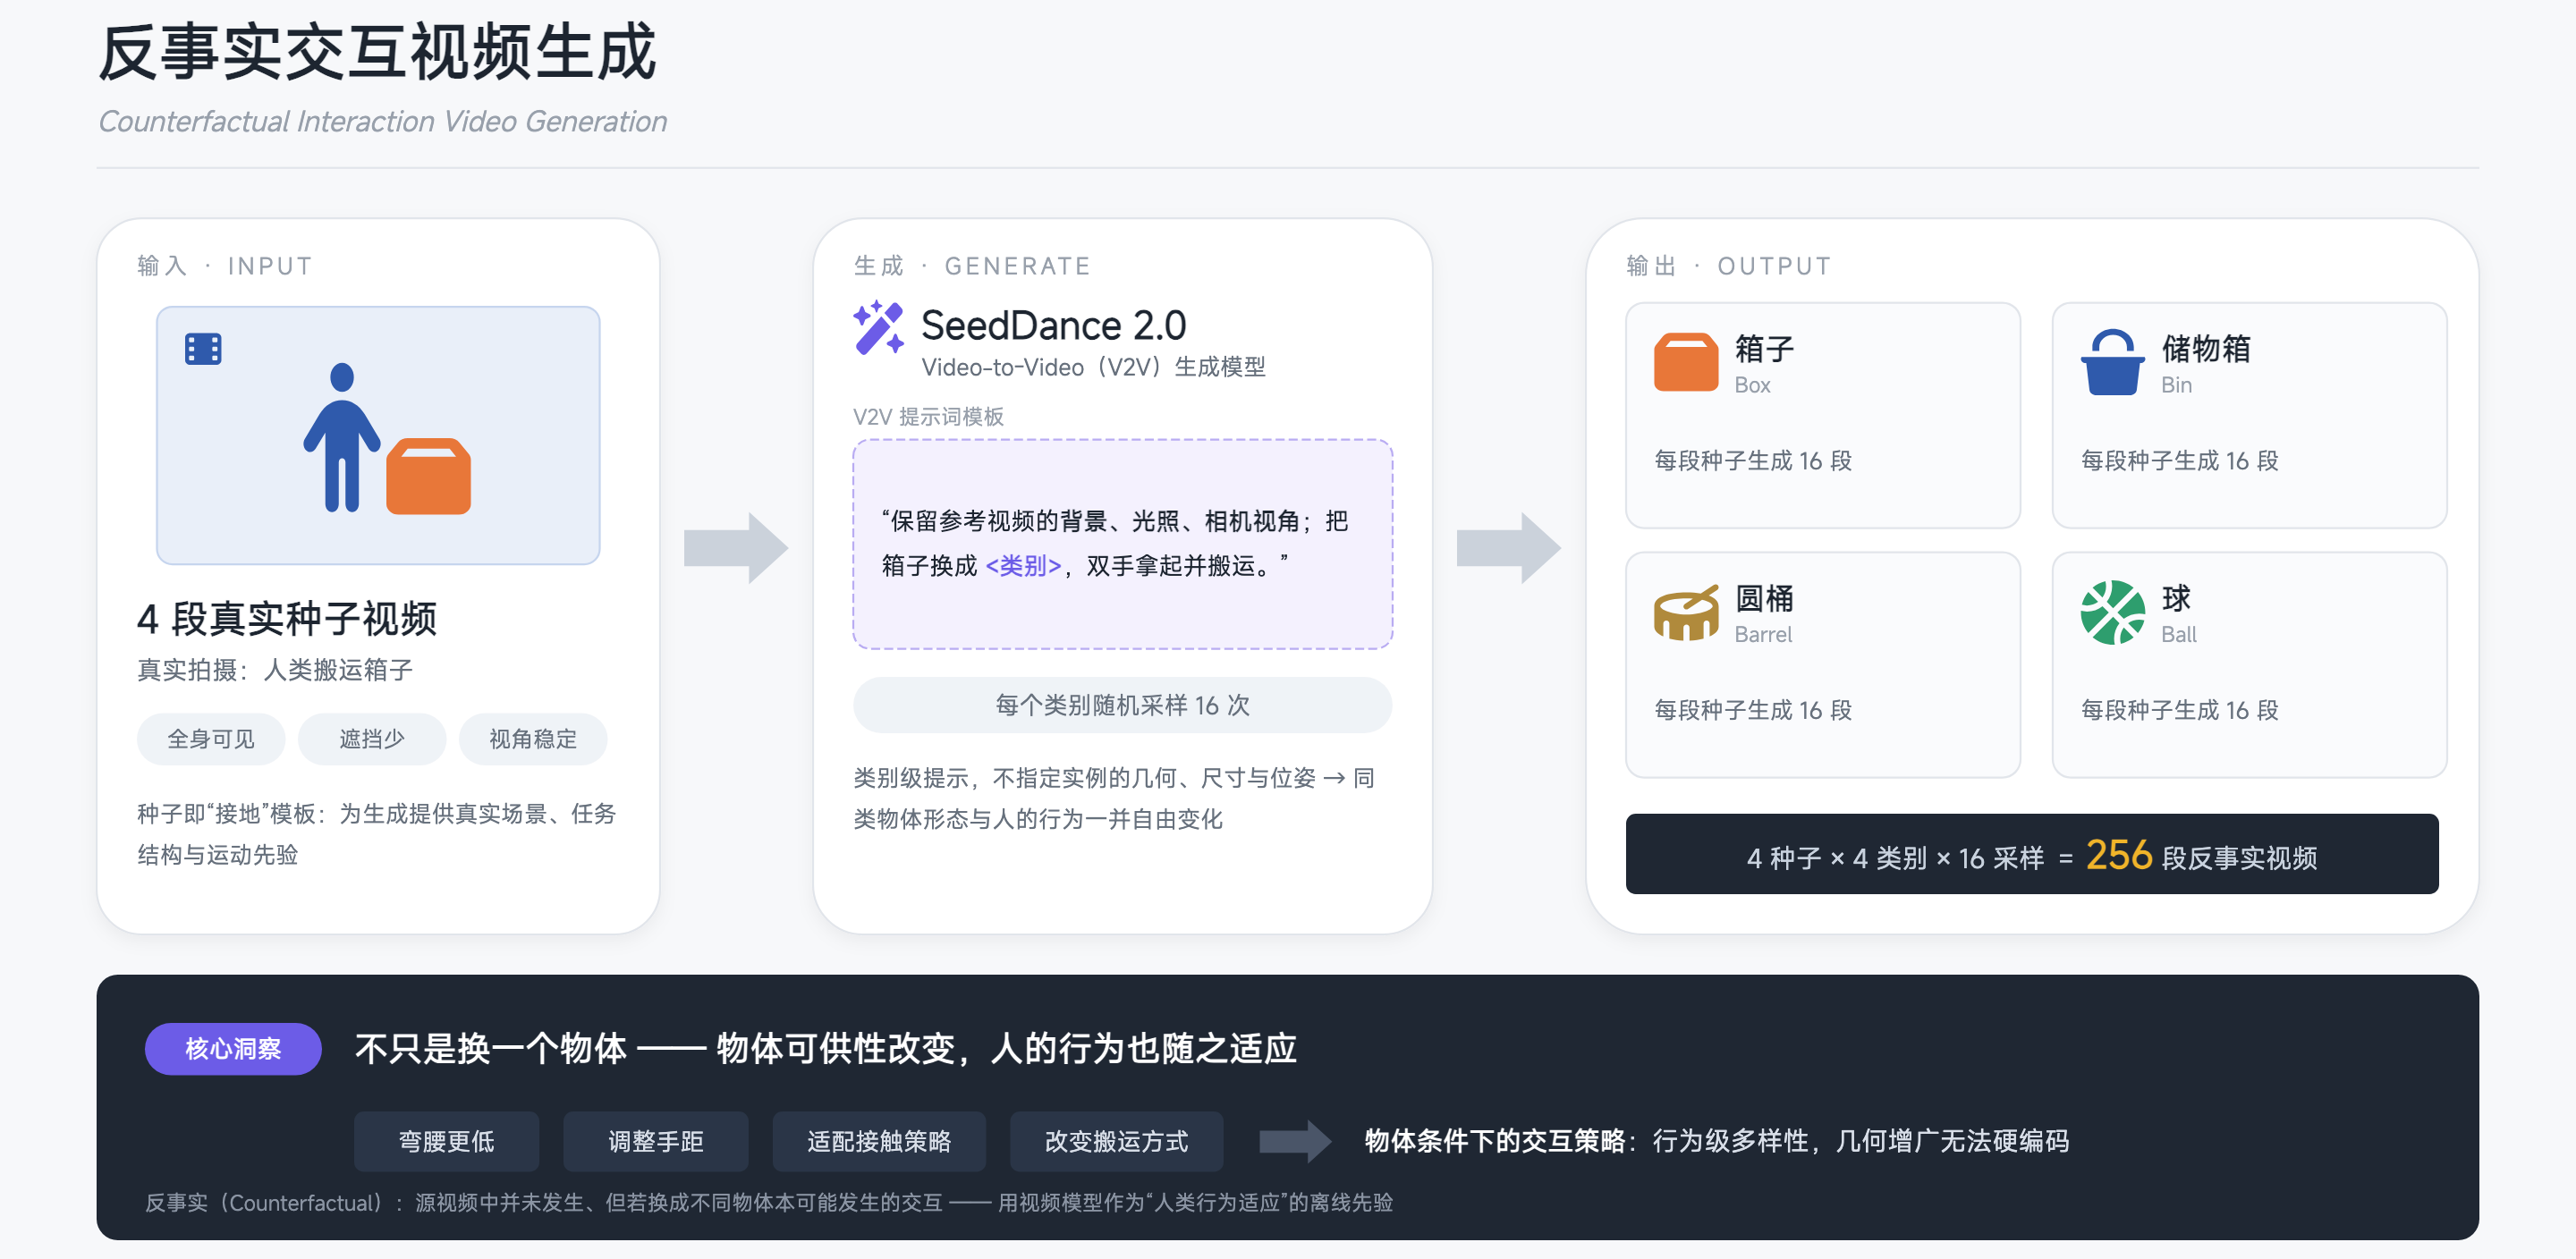
- 给定一段种子视频和一段类别级文本提示,作者要求模型在保留原始背景、光照、摄像机视角和粗粒度任务结构的前提下,仅替换被操控的物体
这样的视频条件生成既将合成过程锚定在真实场景和真实任务之上,又允许物体和人类行为在此基础上产生变化
重要的是,反事实式的变化不仅局限于物体的几何形状或外观
- 当物体的类别、尺寸、姿态或放置位置发生变化时,其可操作性(manipulation affordances)也会随之改变,人类行为也会相应适应:生成的人可能会弯得更低、调整手部间距、根据物体的可供性调整接触策略,或者以不同方式搬运物体
- 因此,每个生成的视频片段都提供了一种基于物体条件的交互策略,而不仅仅是将相同的人体动作简单地与一个新物体进行配对。这使得PRISM 能够在交互数据中获得行为层面的多样性,而这仅通过几何层面的增强是很难以硬编码的
毕竟,若要从零开始学习此类适应行为,将需要穷尽式、针对具体任务的强化学习奖励设计;而 PRISM 则利用视频模型作为一种离线先验,来刻画合理的人类适应方式
在实践中,作者录制了四段真实世界的种子视频,并将每一段视频作为 V2V 生成的具身模板。作者通过提示 SeedDance 2.0 [18],在保持原始背景、光照、摄像机视角和时间连续性不变的前提下,将被操作的物体替换为盒子、垃圾桶、桶或球(见附录 A)
这种类别级别的提示使模型能够在改变物体几何形状、外观和姿态的同时,相应地调整人体行为。对于每个类别生成 16 个样本,每个种子视频可产生 64 段反事实视频,从而将 4 段真实录制扩展为 256 段视频,供 real-to-sim 流水线使用
1.2.2 基于接触锚定的Real-to-Sim:包含重建、重定向
为了从单目视频中模仿人类动作,作者必须将其与由相机引起的图像运动解耦,并在一致的世界坐标系中进行恢复
- CRISP [19] 将人体网格恢复(HMR)网络与视觉 SLAM 集成,从单目视频重建在度量尺度上一致的人体–场景–相机表示,其中包括
相机内参
逐帧相机位姿
度量尺度的场景点云,以及
在统一世界坐标系下时间对齐的 4D 人体运动 - 作者将其作为后端,并扩展其能力以重建动态物体的几何与运动
尽管 CRISP [20] 主要关注人体运动及其周围环境,但要模仿人–物体交互,还需要进一步将动态物体的运动与相机运动解耦
因此,作者将其作为后端,并在同一世界坐标系下扩展恢复动态物体的几何和运动
首先,对于物体几何与运动重建
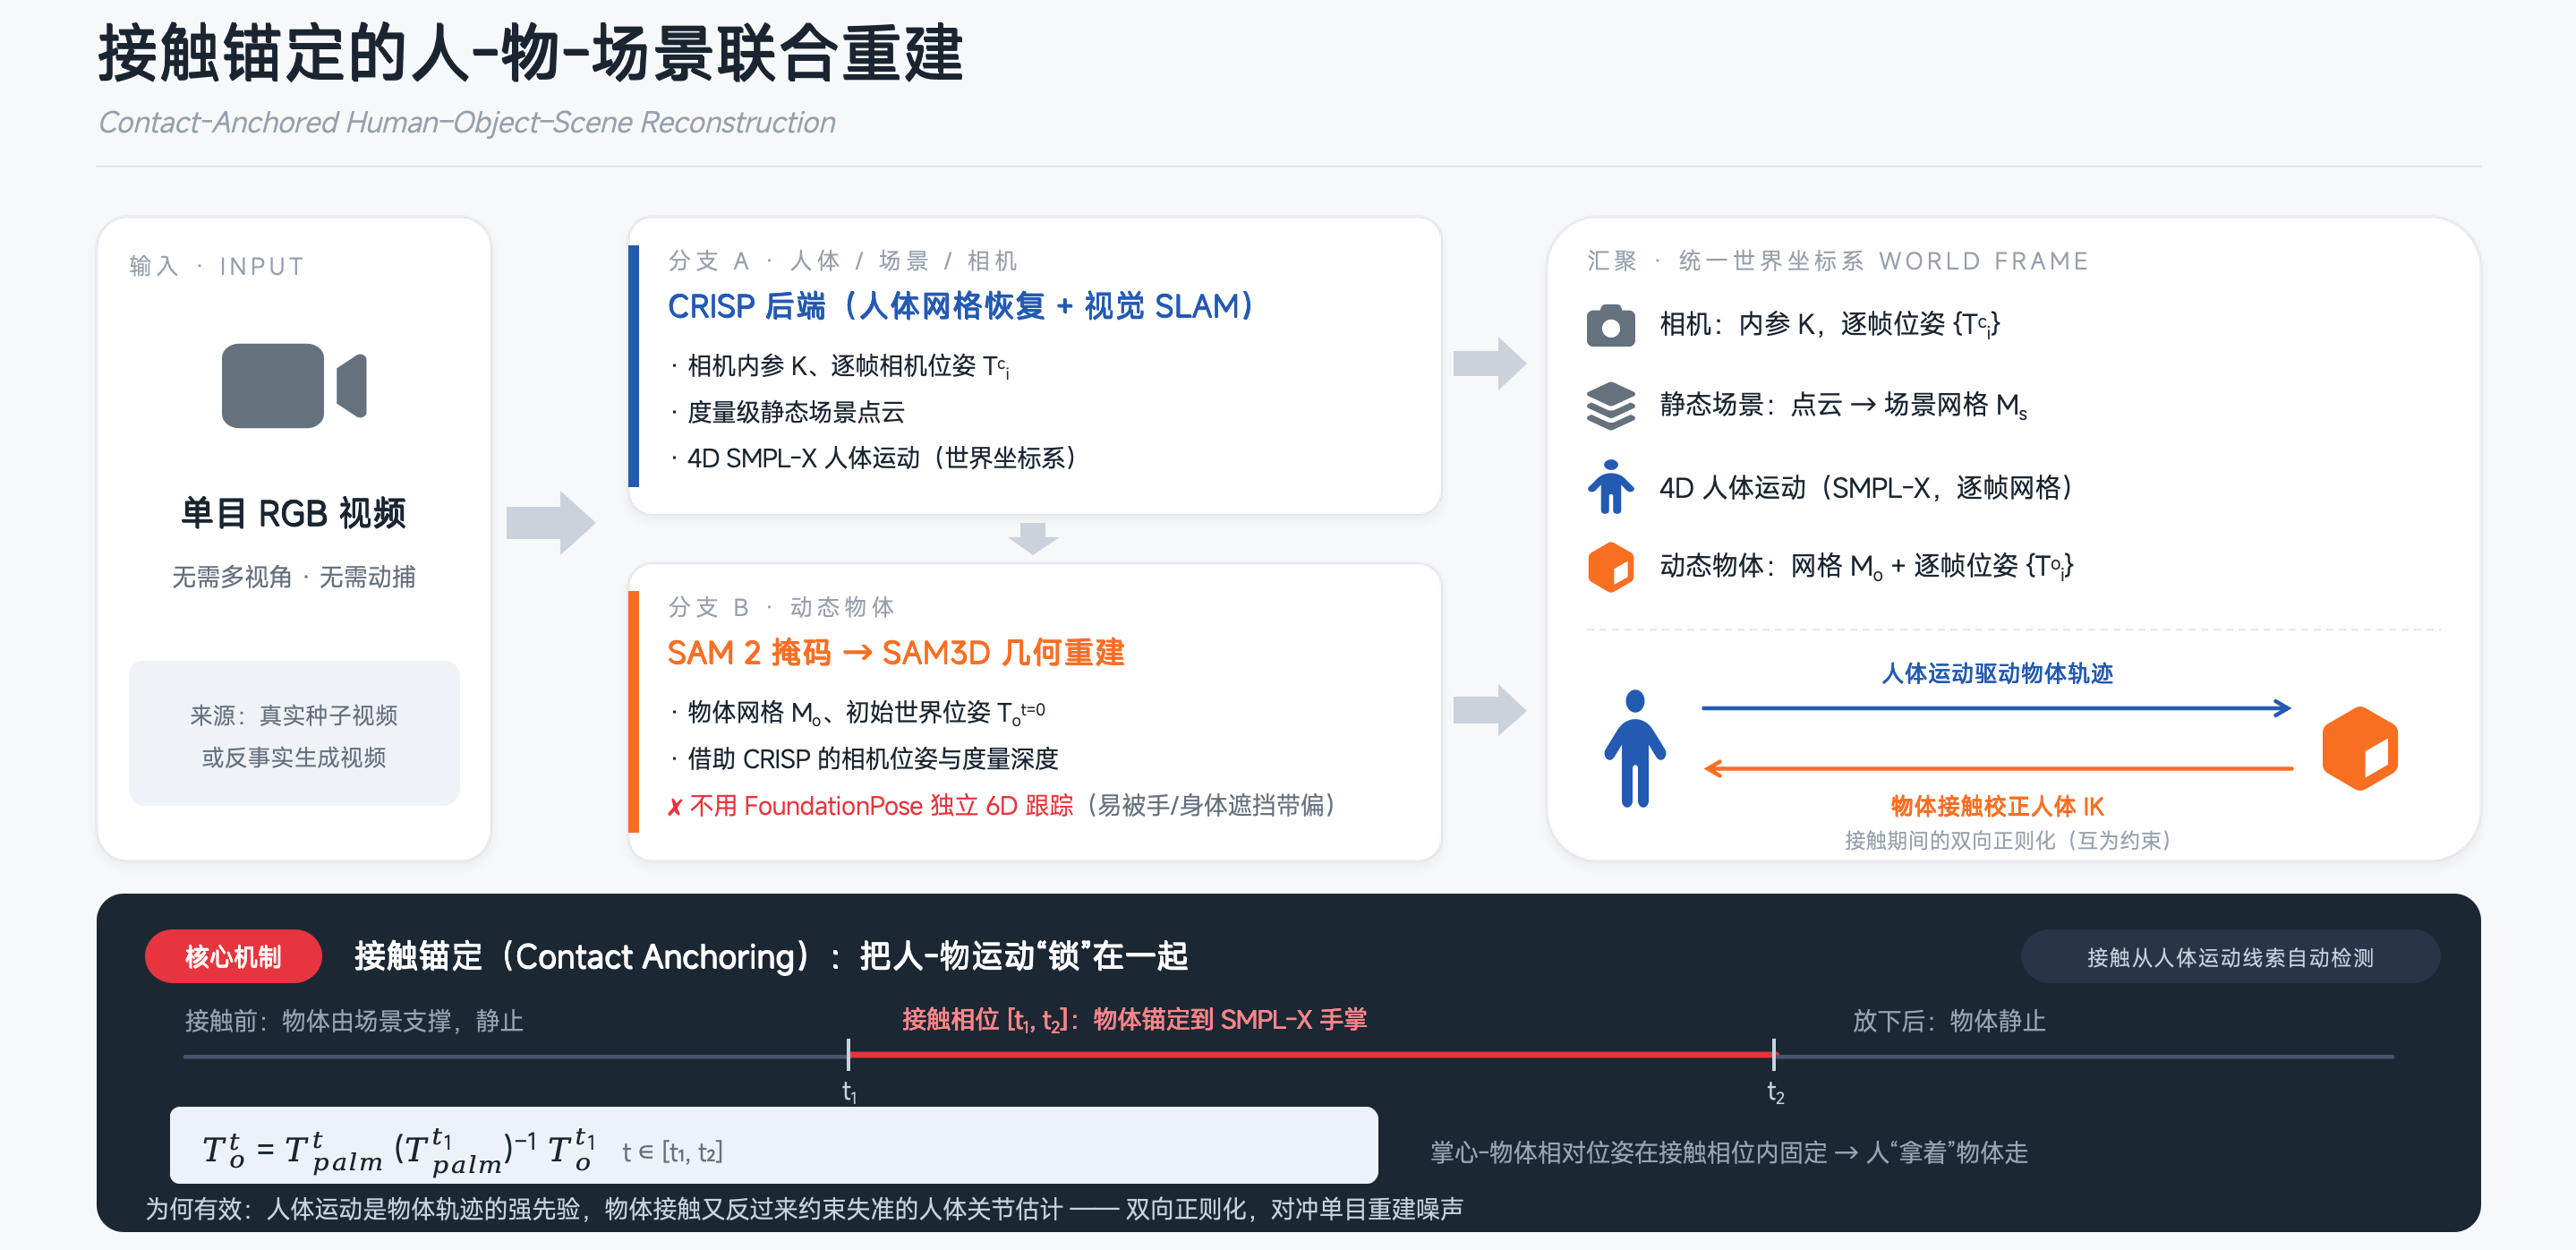
- 在给定来自 SAM 2 [21] 的动态物体掩码,作者利用 SAM3D [22] 重建物体几何,同时估计相机位姿并获得度量尺度信息
即,利用SAM 2 [21]提供的动态物体掩码,作者结合CRISP提供的相机位姿和度量深度,通过SAM3D [22]重建物体几何结构,从而得到物体网格,以及初始世界位姿
- 而不是使用诸如 FoundationPose [23] 这样的视觉 6D 追踪器对物体进行独立追踪(该方法在单目视频中对手部和身体遮挡较为敏感,见表 3)
总之,作者利用人–物体接触来对两者的运动进行联合正则化:人体运动为物体轨迹提供了强先验,而物体反过来又对不准确的人体关节估计起到约束作用。对于“拾取–搬运–放下”这类交互,物体在非接触阶段由场景支撑,在稳定接触期间则跟随人体运动
进一步而言,从人体运动线索中自动检测接触点,从而避免了手动标注接触信息[5,12]。检测得到的接触点还通过用与接触一致的约束替换不准确的关节目标,在逆向运动学(IK)过程中对人体动作起到正则化作用
在每个接触阶段 [t1, t2] 内,作者将物体锚定到 SMPL-X 手掌上,使用手掌相对变换 at ,并在整个阶段保持该变换不变:
因此,在接触期间,人类动作会驱动物体轨迹的传播;而物体接触又反过来提供几何约束,用于修正重建的人体动作中的误差
其次,对于基于接触锚点的再定向
以往的再定向方法 [6] 会保持人与物体之间的关系,但前提是假设输入是干净且物理可行的。单目重建往往违背这一假设(如图 2 中的粉色示例),导致再定向过程会一并保留这些重建误差
因此,作者提出基于接触锚点的再定向方法:
- 它将重建出的全身人体运动视为运动学参考,同时使用物体坐标系中的接触锚点作为可靠的交互接口
这些锚点明确指定机器人末端执行器应在物体上的作用位置,从而允许再定向求解器将含噪的重建结果纠正为物理上合理的机器人–物体交互运 - 对于每一个接触阶段,作者我们从第一阶段重建得到的人体–物体几何中提取接触锚点
具体而言,作者将连接 SMPL-X 左右手掌中心的线段与物体网格求交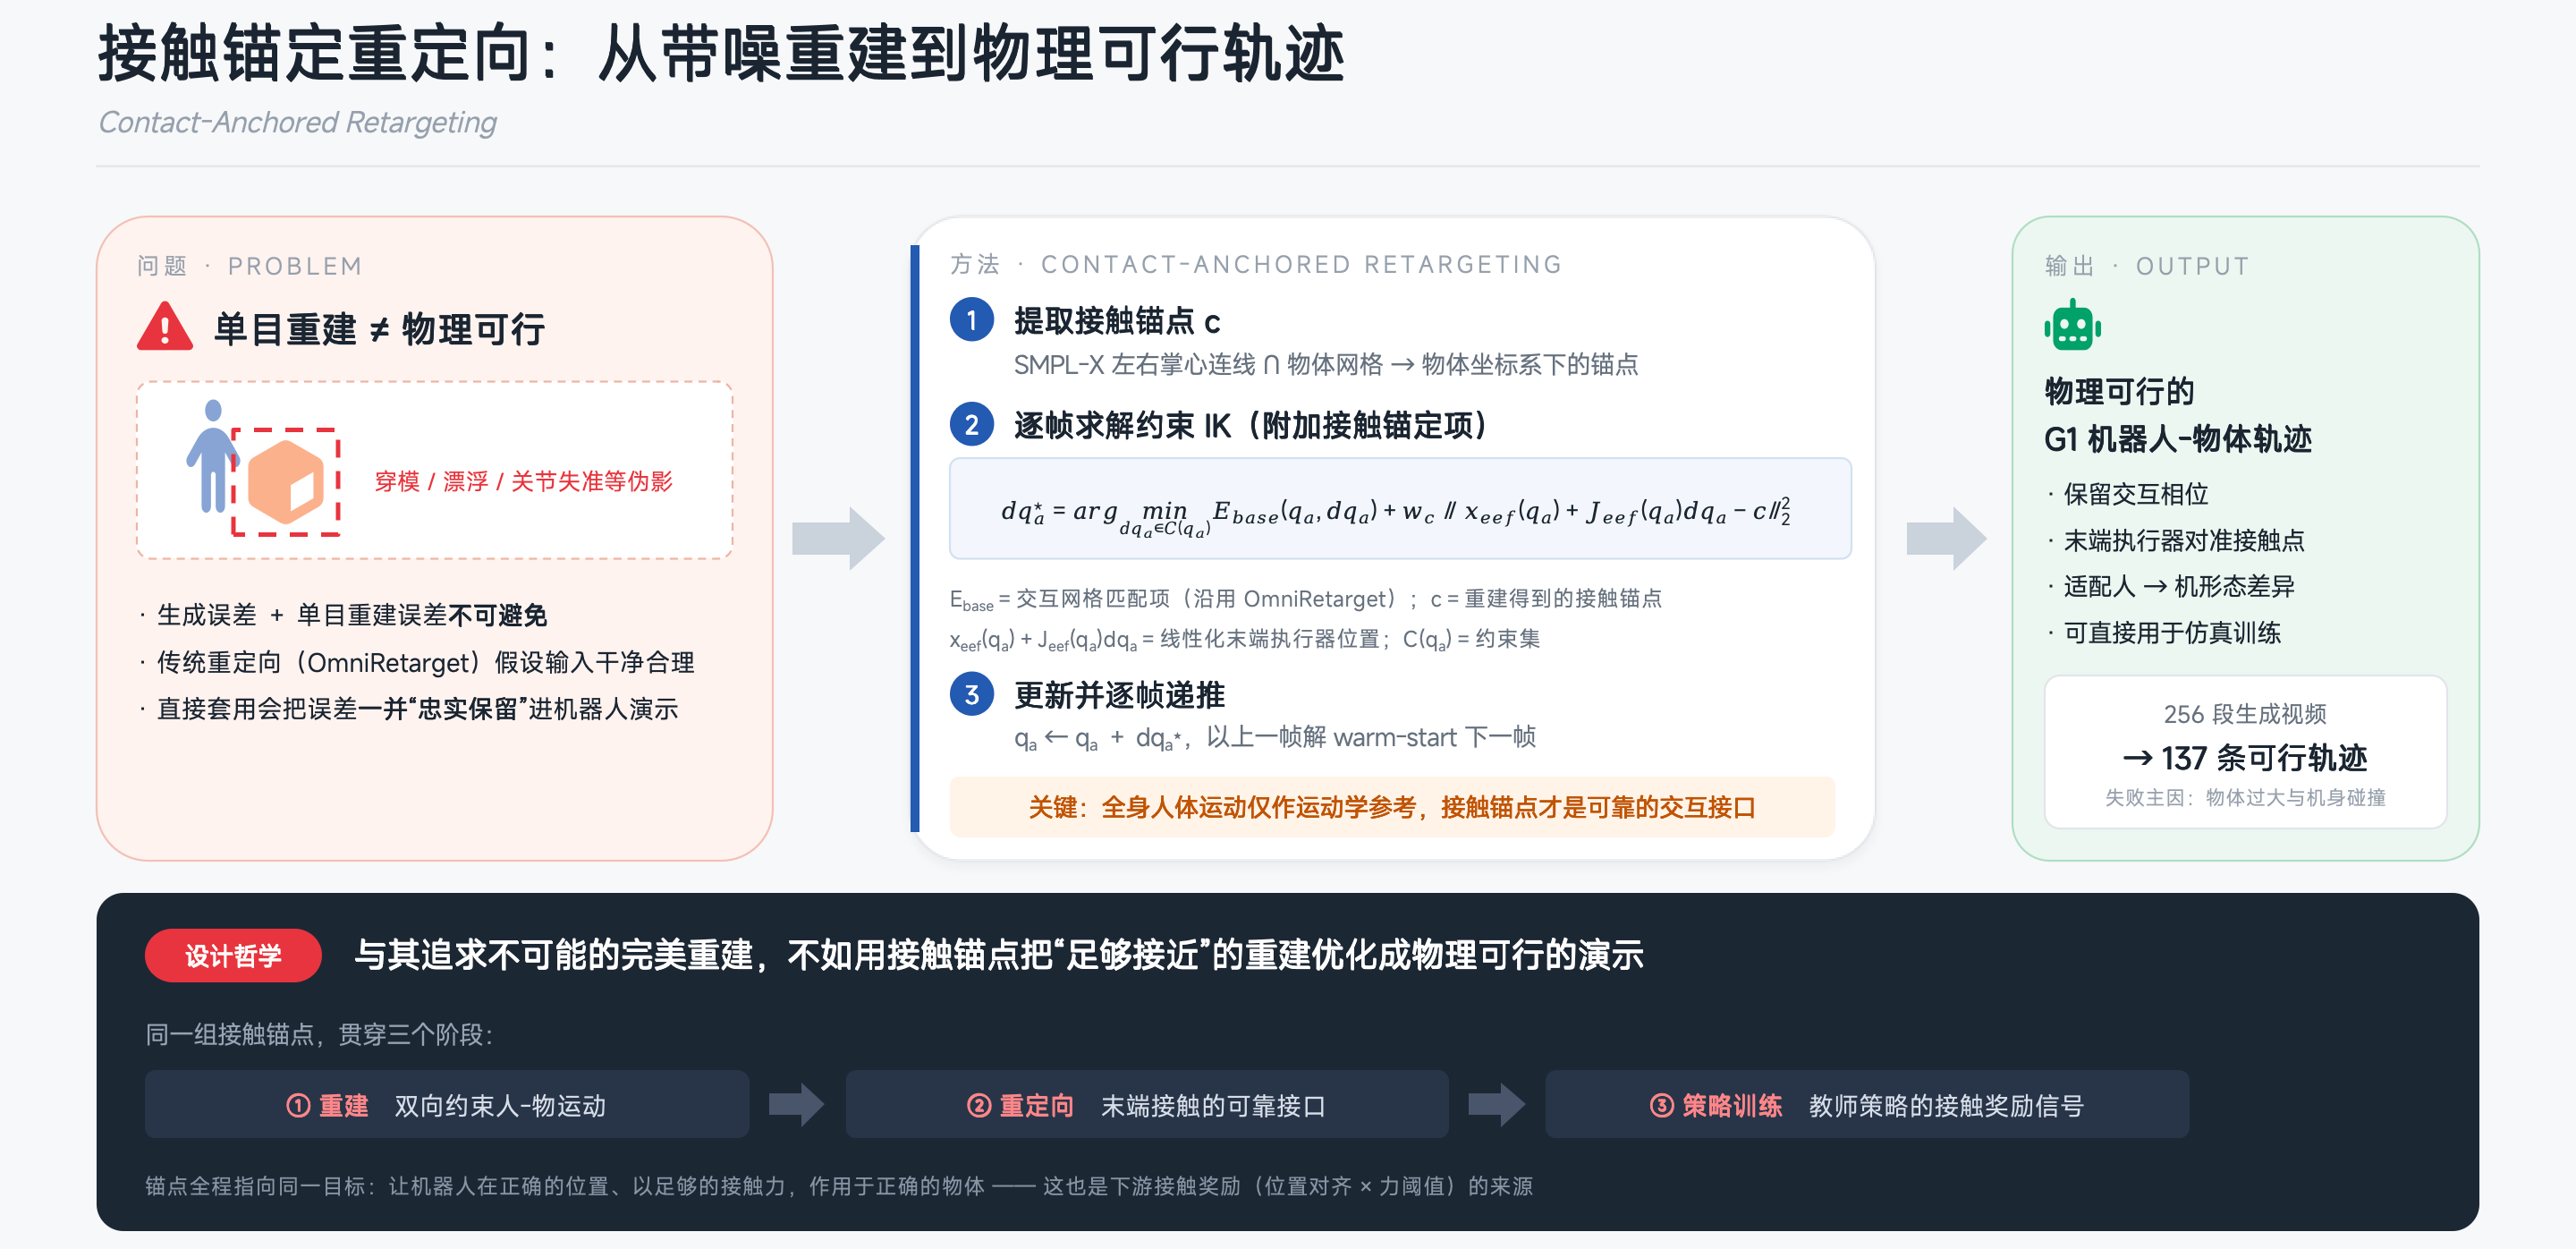 遵循保持交互的重定向方法 [6],作者保留受约束的逆运动学(IK),并在原始目标函数中加入一个接触锚点项
在每一帧中,求解:
此处,表示来自文献[6]的交互网格匹配
是从图2中的人-物重建估计出的目标接触点,
为末端执行器位置的线性化表达式
- 作者针对每帧更新
并用其对下一帧进行预热启动
人们可能会将这些伪影归因于重建流水线。作者持不同观点:在单目图像的 real-to-sim 阶段,不完美的重建是不可避免的,因为现有的任何流水线都无法还原物理上合理的人—物体运动
作者认为,他们的基于接触锚定的 real-to-sim 系统通过将足够接近的重建结果优化为物理上合理的机器人示教,从而弥合这一差距
1.3 统一视觉-运动交互策略的学习
利用重建得到的机器人-物体轨迹(细节见附录 C),作者的目标是训练一个统一的人形机器人策略,使其能够在各类不同物体上执行拾取、搬运和放置等行为
该策略接收机载深度观测和手柄(摇杆)指令,并根据感知到的物体几何形状和摆放位置,自动执行相应的物体交互行为。类似于以往的视觉-运动系统 [24,25],作者采用两阶段训练框架
- 首先,在仿真中利用全状态观测训练一个具有特权信息的联合跟踪教师策略
- 随后,结合 DAgger [26] 与强化学习,将该教师策略蒸馏为一个统一的、基于深度输入的学生策略,从而实现零样本的仿真到真实部署。整体流程如图 2 所示
1.3.1 训练协同跟踪的教师策略
将仿真人与物体的交互建模为一个协同跟踪问题,其中策略需要同时跟踪从单目视频重建得到的仿人动作以及动态物体轨迹。关于的运动跟踪训练细节,读者可参考该项目的代码库
- 观测
教师端的观测包括参考运动、机器人本体感知、前一时刻的动作,以及当前与目标物体状态。物体状态由物体位姿和三维包围盒尺寸来表示,从而使策略能够显式感知期望的机器人运动以及物体的状态 - 奖励与终止条件
奖励主要由机器人位姿跟踪、物体位姿跟踪、动作频率约束、关节范围限制以及碰撞惩罚组成
另外,作者利用上文1.2节(对应于原论文第 3.2 节)中定义的接触锚点,引入了一个与接触相关的交互奖励。具体而言,我们鼓励机器人末端执行器到达期望的接触位置,并且其接触力超过一个预先设定的阈值:
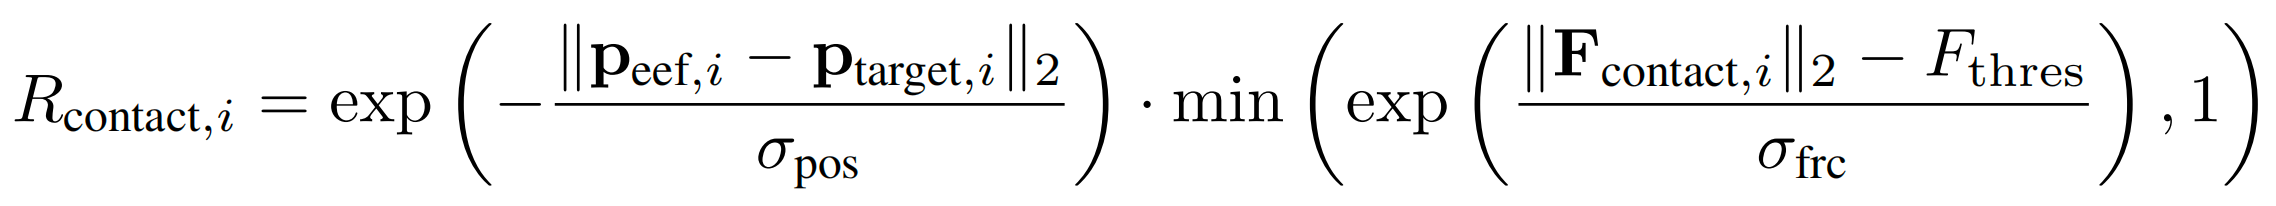
其中,表示末端执行器的位置,
是重建得到的目标接触点,而
是接触力向量。这个感知接触的奖励在有噪声的单目重建条件下,可以稳定抓取和搬运行为,并在策略学习过程中显著提升交互质量。作者还按照文献 [6] 采用了提前终止和域随机化策略
1.3.2 蒸馏统一的基于深度信息的学生策略
特权教师在仿真中学习到稳定的物体交互方式,但它依赖于真实硬件上不可获得的信息。因此,作者将其蒸馏为一个可部署的、基于深度信息的学生策略,该策略仅使用机载感知和摇杆指令,而不依赖运动捕捉(MOCAP)系统或参考动作
- 蒸馏
作者使用结合了 DAgger 和 PPO 目标的方式对教师策略进行蒸馏:
其中表示 DAgger 模仿损失,
是强化学习(RL)目标
根据文献 [24],作者我们采用一个在训练过程中逐渐增加 λ 的课程策略,并在最后 20K 次迭代中保持 λ = 0.9 - 观测
学生接收本体感知、摇杆指令以及机载深度信息
在部署阶段,作者使用Fast-FoundationStereo [27] 从双目图像在机外估计深度。作者发现,这在深度观测上显著缩小了从仿真到真实(sim-to-real)的差距
本体感知包括角速度、关节状态以及上一时刻的动作。摇杆指令由相对机体根部的指令 $c_{js}$ 构成。t = [∆x_t, ∆y_t, ∆yaw_t] 和一个二值投放指令 b_drop^t ∈ {0,1},其是在训练过程中根据参考轨迹和抓取结束时间推导得到(附录 D)
在仿真中,作者使用标称 37° 的相机俯仰角,对相机位姿进行随机化,并注入深度噪声、丢失、空洞、边缘伪影和偏移
且,评价器(critic)在没有历史信息的情况下,只使用当前的机器人、物体和参考状态 - 热启动
作者从一个使用相同方法在仅包含框标注的数据上训练了 23K 次迭代所得的检查点进行热启动,在对所有类别进行训练之前,仅恢复 actor 的权重。直接从头训练也可以成功;但热启动可以加速收敛,因此被用于我们公开发布的检查点 - 训练细节
作者分别对 3 层 MLP 的教师策略和学生策略进行训练,教师训练 40K 次迭代,学生训练 28K 次迭代,在 8 块 NVIDIA L40S GPU 上,每块 GPU 使用 4096 个环境。知识蒸馏使用教师的 rollout 作为运动参考,而不是原始的运动学轨迹。详见附录 D
// 待更

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献122条内容

所有评论(0)