从生成到进入:AI视频如何从Sora神话沦为0.05元/秒的大宗商品,又成为82亿美元的世界门票
一篇关于 AI 视频生成如何从"惊艳 demo"变成"大宗商品"、又如何从"生成世界"走向"进入世界"的长篇记录。文中所有数据均标注了口径与取数时间。
开篇:82 亿美元
2026 年 9 月 28 日(美国当地时间),AMD 宣布与 World Labs 签署最终收购协议:约 82 亿美元,全股票交易,预计 2026 年底前完成交割,尚需监管批准。
几个基本事实:
- World Labs 由李飞飞于 2024 年 9 月创立,成立仅两年,员工约 70 人;2024 年 9 月获 2.3 亿美元种子轮融资(AMD、英伟达、Adobe、Geoffrey Hinton 参投),2026 年 2 月完成 10 亿美元融资、投后估值约 50—54 亿美元。AMD 的收购价较五个月前的估值溢价约 62%。
- 这是 AMD 史上第二大收购,仅次于 2022 年约 500 亿美元收购赛灵思(Xilinx)。
- 交易完成后,李飞飞将出任 AMD 执行副总裁兼首席科学家,直接向董事长兼 CEO 苏姿丰汇报;World Labs 团队继续从事世界模型研究,其交互式 3D 世界生成产品 Marble、9 月初刚发布的多模态世界模型 Atlas,将融入 AMD 的芯片路线图。
- 官宣当日,AMD 股价收跌约 3.6%。
- 市场公开信息中,World Labs 尚无显著营收。
一家芯片公司,用仅次于收购赛灵思的价格,买下一家成立两年、没有规模收入的世界模型实验室——而且是它自己的被投公司。这笔交易的所有解读,都指向同一个问题:当"生成视频"这件事本身变得越来越便宜、越来越可替换,这个行业真正值钱的东西还剩下什么?
要回答这个问题,需要回到这一切开始的地方。
上篇
第一章 惊雷之年(2024)
1.1 Sora:一场精心管理的预期
2024 年 2 月 15 日(美国时间),OpenAI 毫无预兆地放出一批视频:一名女子在东京街头走过,湿漉的地面反射着霓虹;两艘海盗船在咖啡杯中缠斗;一只金毛幼犬在雪地里打滚。最长 60 秒,命名为 Sora。
这是一次"预览式发布"(preview release):没有产品、没有 API、没有开放日期,只有一段技术报告和几十个精心挑选的样片。OpenAI 在报告中使用了那个后来反复被引用的表述——视频生成模型是"世界模拟器"(world simulator)的雏形。
从事后看,Sora 在 2024 年完成的真正杰作不是模型,而是预期管理。一个不存在的产品,占据了整整十个月的行业心智:所有人都在等它,所有竞品都被拿来与它比较,所有融资故事都要回答"Sora 来了你怎么办"。直到 2024 年 12 月,Sora 才向美加付费用户小规模开放,此时它早已不再是最强的视频模型——但这不重要,名字已经赢了。
这个细节值得记住,因为三年后我们会发现:命名权本身就是这个行业最持久的护城河之一。
1.2 为什么是中国
2024 年的第二个事实,比 Sora 本身更深远:OpenAI 用预告片统治了叙事,但真正把视频生成做成流水线生意的,是中国公司。Vidu(生数科技,4 月)、可灵(快手,6 月)、CogVideoX(智谱,8 月开源)、海螺视频(MiniMax,9 月)、PixelDance 与 Seaweed(字节,9 月)——Sora 的十个月真空期,被中国厂商填成了产品日历。
这不是运气,而是三种结构性能力的叠加:
其一,工程化流水线。 视频生成的难点从来不只在算法,而在"从模型到可用素材"的漫长管线:数据清洗、标注、超分、插帧、审核、成本控制。中国厂商在短视频时代打磨出的推荐系统与内容审核工程体系,恰好可以平移到生成端。当 Sora 还在用研究员手工挑选样片时,快手可灵的迭代周期已经以"周"为单位。
其二,数据闭环。 全球短视频时长最长的内容生态在中国,这意味着真实用户的偏好数据、海量现成视频语料、以及生成内容的即时分发渠道(抖音、快手、红果)同属于少数几家公司。模型生成的视频当天就能被投放、被点击、被复盘——这个闭环,硅谷没有对应物。
其三,产品化速度。 可灵发布两个月后向全球开放,即梦直接长在抖音的创作链路上。对比 Sora"发布即巅峰、十个月后才有产品"的节奏,中国路线的假设完全不同:视频生成不是一篇论文,是一门要先开张的生意。
在这三个因素之下,还压着一层更深的结构性差异——资本结构。中国头部视频模型几乎没有一个走"创业公司融资→研发→产品化"的路径:可灵长在快手内部,即梦和 Seedance 长在字节内部,混元长在腾讯内部,万相长在阿里内部。它们从一开始就不是创业项目,而是平台基础设施——投入逻辑不是"模型公司估值故事",而是"给自家内容生态降本增效,顺手对外输出"。这意味着三点:研发投入可以不计短期回报,模型发布天然附带分发渠道,用户反馈数据以内部闭环的方式回流。美国厂商里只有谷歌的 Veo 具备同构条件,而 OpenAI 的 Sora 恰好最不擅长这个——它既没有内容生态可以寄生,也没有成熟的低成本分发通道。Sora 预期管理的成功与商业化的失败,是同一种组织基因的两面。"为什么是美国先做出 Sora、中国先做成产品"的完整答案,一半在工程能力,一半在资本结构。
1.3 《千秋诗颂》
2024 年 2 月 26 日,比 Sora 引爆全球晚十一天,中央广播电视总台的《千秋诗颂》在 CCTV-1 开播——中国首部"文生视频"AI 系列动画片,依托总台"央视听媒体大模型"把中小学语文教材中的诗词转化为国风动画。首集《别董大》首播收视份额 4.22%,在上星频道动画片中排名第一;一个月后,其德语、意大利语、葡萄牙语版经 CGTN 在十余家欧洲拉美主流媒体播出。
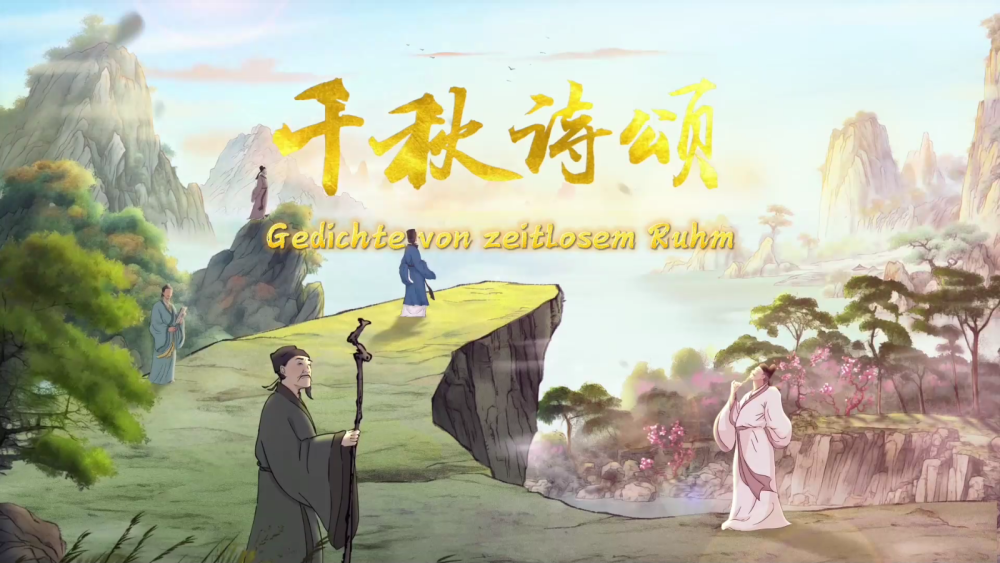
在当时,这像一则单纯的文化科技新闻。但请注意其中的关键词:"首部文生视频""总台大模型""国家教材内容"。当国家级媒体亲自下场,把生成式视频用于主流内容生产,监管者与被监管对象之间的传统边界就开始松动——两年多后,当 AI 微短剧以每年数十万部的规模涌现时,第一个站出来立规矩的正是这条线上的人。这是后话,此处按下不表。
1.4 HunyuanVideo:开源侧的惊雷
2024 年 12 月 3 日,腾讯混元开源 HunyuanVideo:130 亿参数 DiT 架构,是彼时最大的开源视频生成模型,同步放出推理代码与完整权重。技术上它带来三样东西:用多模态大语言模型做文本编码器(MLLM as text encoder)、自研 3D VAE、以及"图文双模态 Scaling Law"的方法论宣示——视频模型也可以像语言模型一样,靠加大算力与数据可预测地变强。
拆开看,这套架构的每个部件都针对视频生成的特有痛点:3D VAE 以 4(时间)×8×8(空间)的压缩比把像素搬进潜空间——压缩不够则 token 爆炸、算力撑不住,压缩过度则细节全损,这是所有视频模型第一道、也是最致命的权衡;MLLM 文本编码器直接复用语言模型的指令理解能力,解决传统 CLIP/T5 编码器"读不懂复杂提示词"的老毛病;主干是 3D 全注意力 DiT,对所有视觉 token 一视同仁地计算注意力,代价是序列长度爆炸,这也是为什么后续的 FP8 量化与序列并行(xDiT)不是锦上添花,而是架构成立的必要条件。
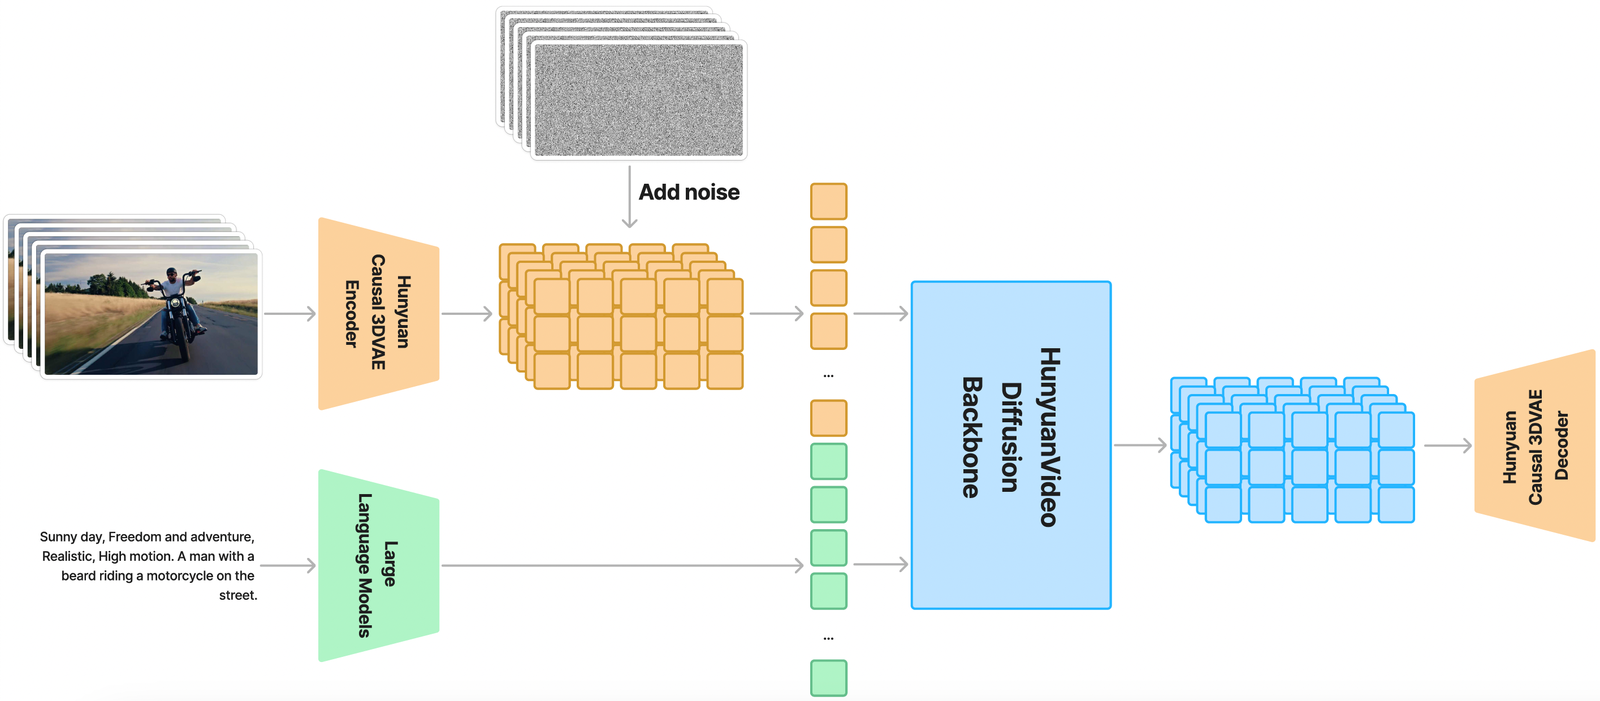
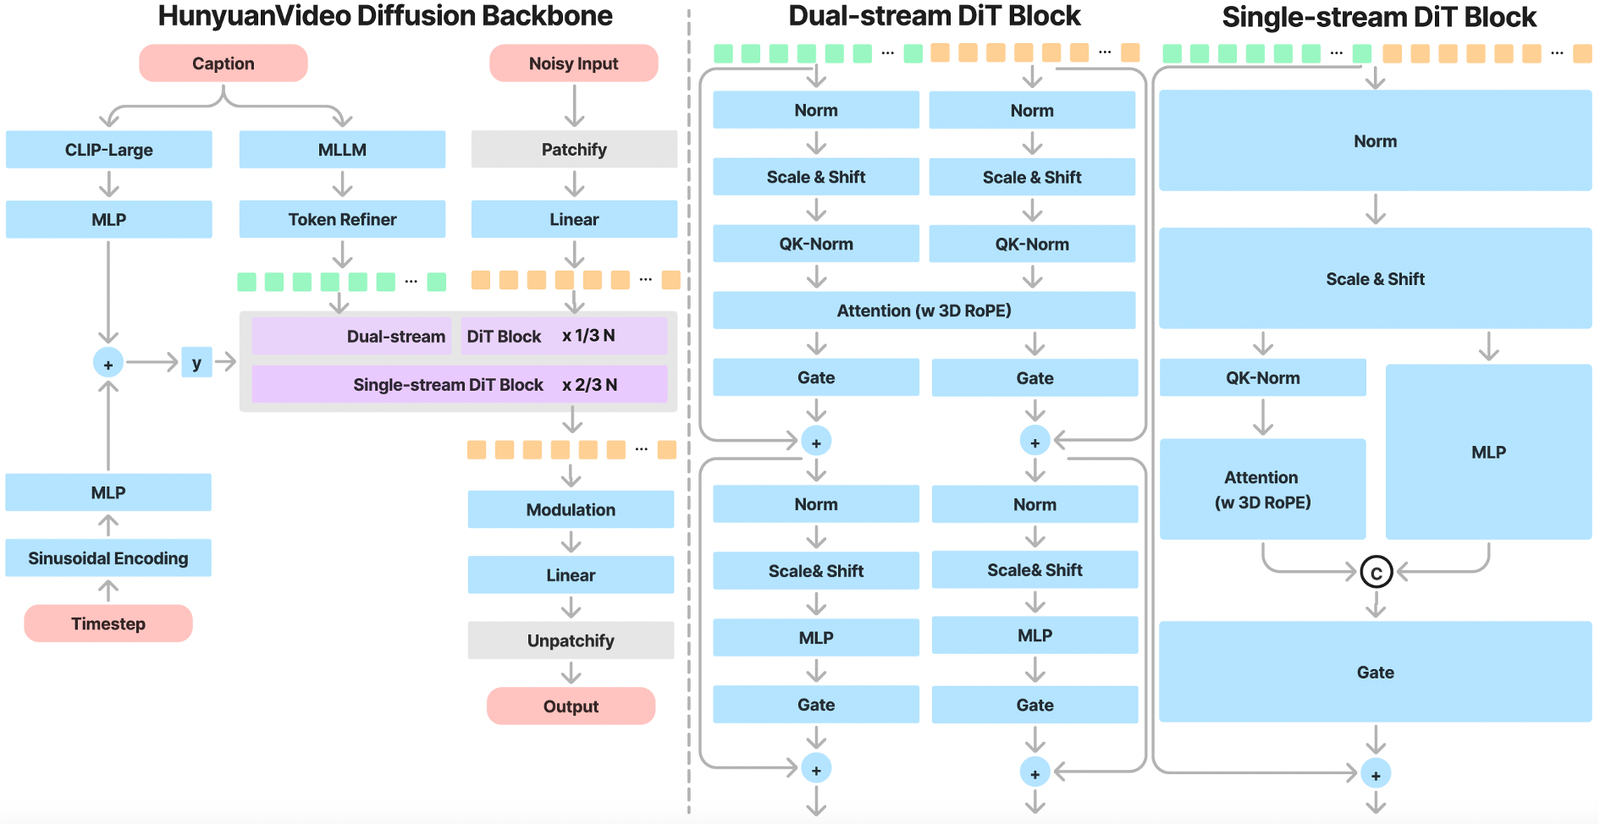
与 Sora 的"只给看"相反,HunyuanVideo 选择了"全给":权重、代码、基准测试集(Penguin Video)陆续放出,随后是 FP8 量化版(12 月 18 日)、Diffusers 集成(12 月 17 日)、xDiT 多卡并行(12 月 3 日)。开源社区第一次拥有了一个可以魔改、可以蒸馏、可以私有部署的旗舰级视频模型。
闭源侧用预期统治了 2024 年,开源侧用权重打响了年末的最后一枪。两条路线的分野,将在 2025 年同时接受商业的检验。
第二章 商业化元年(2025)
2.1 闭源路线:Veo 3 与"有声"的起点
2025 年 5 月 21 日,Google I/O 大会,Veo 3 登场。它的划时代之处不在画质,而在原生音频:环境音、角色对白、声景设计与画面同步生成,唇形对齐,声画一体——音频不是生成之后的配音工序,而是与画面在同一模型中联合采样的输出通道。AI 视频从此告别"默片时代"。
用本文的坐标系来说,Veo 3 完成了音频能力"从 0 到 1"——"有"的起点。在此之前,所有视频模型的默认输出都是无声的;在此之后,"没有声音"开始成为一种残缺。谷歌同时把它接进 Flow 创作工具与 Vertex AI 企业管线,走的是典型的谷歌路线:模型即云服务,能力即基础设施。
在叙事意义上,Veo 3 也是谷歌对 Sora 议程的正面回应——你用"世界模拟器"定义了物理真实的标准,我就补上你缺席的那个感官维度。Sora 设定议程、对手逐条兑现的格局,是理解整个 2025 年的钥匙。
闭源阵营在 2025 年的整体叙事是:多模态大一统(Gemini 驱动 Veo)、企业与创作者工具链(Flow、Vertex)、以及用生态位压制单点模型公司。这条路线成本极高,但对手只有一个——OpenAI。
2.2 Sora 2:技术高点与商业低点
2025 年 9 月 30 日,OpenAI 发布 Sora 2,并同步推出独立的社交应用 Sora App。Sam Altman 称之为"视频生成的 GPT-3.5 时刻"。技术上确实如此:物理准确性大幅改善,首次实现音视频同步生成,人物一致性显著增强,单次生成可达 16—20 秒。
但 Sora 2 真正出圈的不是技术,而是产品形态与传播机制:Cameo(上传一段自己的音视频,即可把自己或朋友"放进"任何生成的视频里)叠加"1 换 4"邀请码机制,让 Sora App 上线不到 24 小时冲上美区 App Store 免费榜第三,邀请码在 eBay 上被炒到最高 175 美元,Altman 本人亲自"献祭"自己的脸制造传播。
这是一切技术指标之外的另一个高点:Sora 2 证明了 AI 视频可以是消费级社交产品。OpenAI 研究员 John Hallman"基于 AI 的信息流令人恐惧"的内部担忧,与 420 个赞的"两周后再也没打开过它"的用户评论,共同预示了它的结局。
结局来得比所有人预想的快。2026 年 3 月 24—25 日,OpenAI 宣布全面关停 Sora:独立 App、开发者 API、ChatGPT 内置视频功能,三线全停,团队转向 AGI、机器人与世界模型研究。事后披露的账目是残酷的:
- 日均运营成本约 1000 万—1500 万美元,年化约 54 亿美元(《福布斯》估算口径);
- 上线以来应用内总收入仅约 210 万美元(Appfigures 估算口径);
- 30 天用户留存率约 1%,生成内容可用率仅 5%—10%,每产出 1 条合格视频背后有数十倍算力被浪费;
- 2025 年 12 月与迪士尼达成的 10 亿美元 IP 授权合作从未完成资金交割,随关停告吹。
技术高点(GPT-3.5 时刻)与商业低点(一年半生命周期)落在同一个产品上。Sora 之死(如果可以用这个词)不是视频生成技术的失败,而是一个清晰的分界:为"惊艳"付费的时代结束了,为"可用"付费的时代开始计价。而"可用"的计价单位,恰恰是中国厂商最擅长的那个战场——成本。
还要补一句:Sora 退场了,但它设定的议程没有随它一起退场。"物理真实"的标准被 Seedance 们量产(第四章),"世界模拟器"的愿景由世界模型公司接棒(第十一章)——行业用了三年时间,把 Sora 的叙事兑现成了别人的产品。这正是第一章所说的命名权的另一面:定义议程的人不一定活到最后,但活到最后的人都绕不开他定的问题。
2.3 开源路线:Wan 的加速度
2025 年开源阵营的主旋律属于阿里通义万相。2 月 25 日,Wan 2.1 开源:14B 旗舰版之外,特意放出 1.3B 轻量版——仅需约 8GB 显存即可在消费级显卡上运行,5 秒 480P 视频生成约 4 分钟;VBench 总分 86.22%,超越当时已知的 Sora 与 Luma。这一手把"开源"从论文复现变成了生产力工具:AI 短剧小团队第一次可以在自己的显卡上无限次试错。
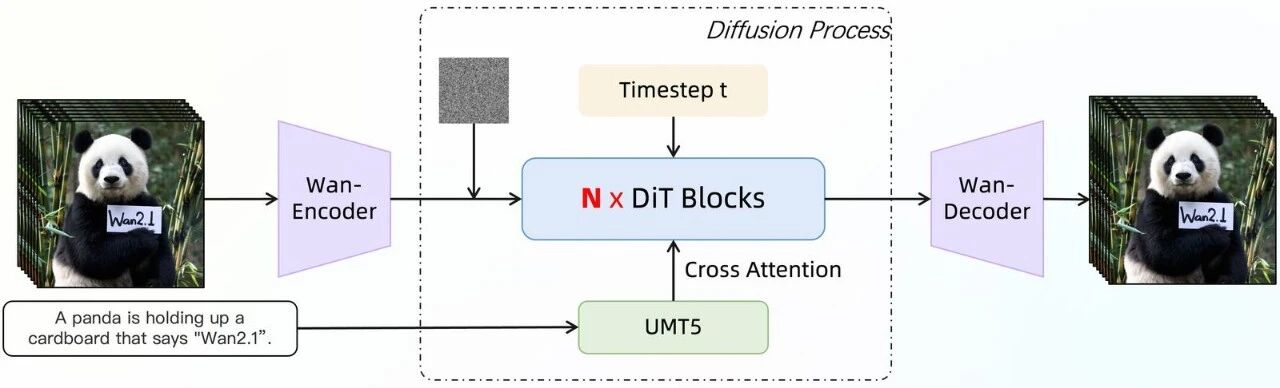
技术上,Wan 2.1 的组合拳在当时是开源侧最完整的一套:3D 因果 VAE 做 4×8×8 时空压缩;DiT 主干以交叉注意力注入文本条件,首帧、首尾帧、运动幅度等控制项被扩展为可插拔的条件分支;推理侧配套 TeaCache(按时间步嵌入的变化率缓存并跳过冗余计算)、USP 统一序列并行与分块 VAE 解码。旗舰 14B 之外放出 1.3B 轻量版不是慈善,而是一步精算过的棋:它把"开源"从论文复现现场变成了生产力工具,顺便为阿里云的 API 生意预热了用户习惯。
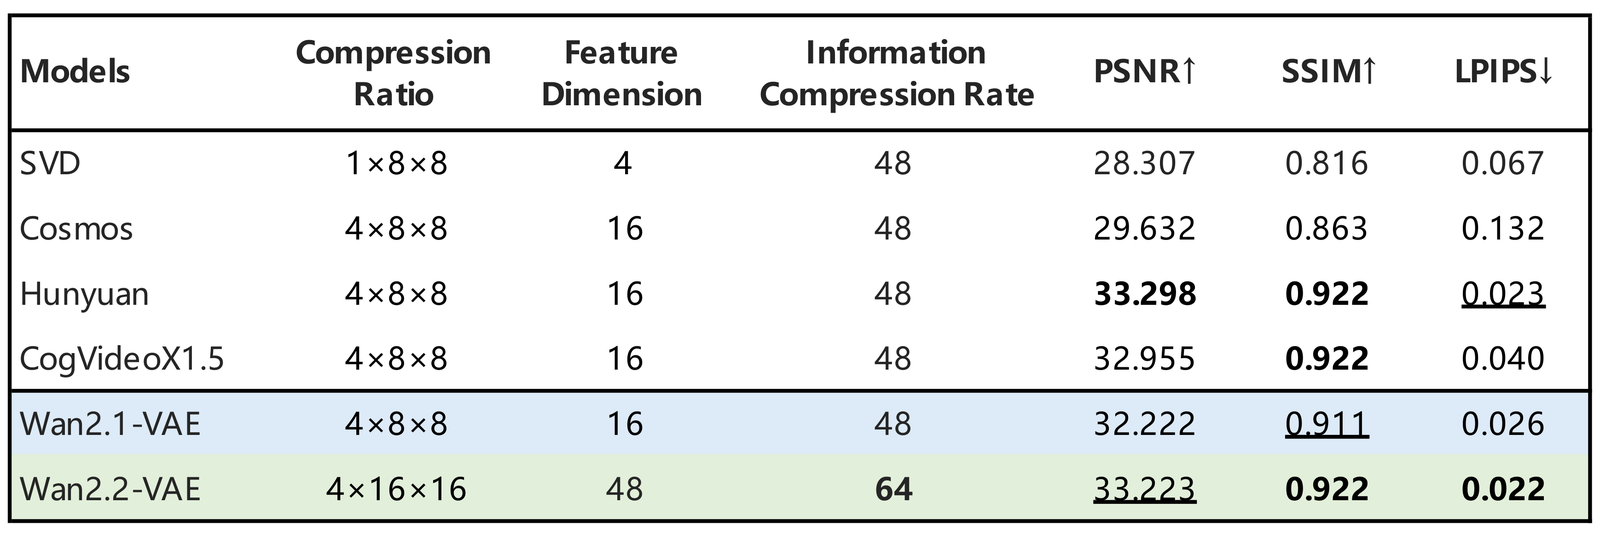
2026 年 7 月,Wan 2.2 接棒,开源基于 Wan2.2-VAE 的混合 TI2V 模型(50 亿参数,压缩比 16×16×4),文本生成视频与图像生成视频统一在同一架构下处理。
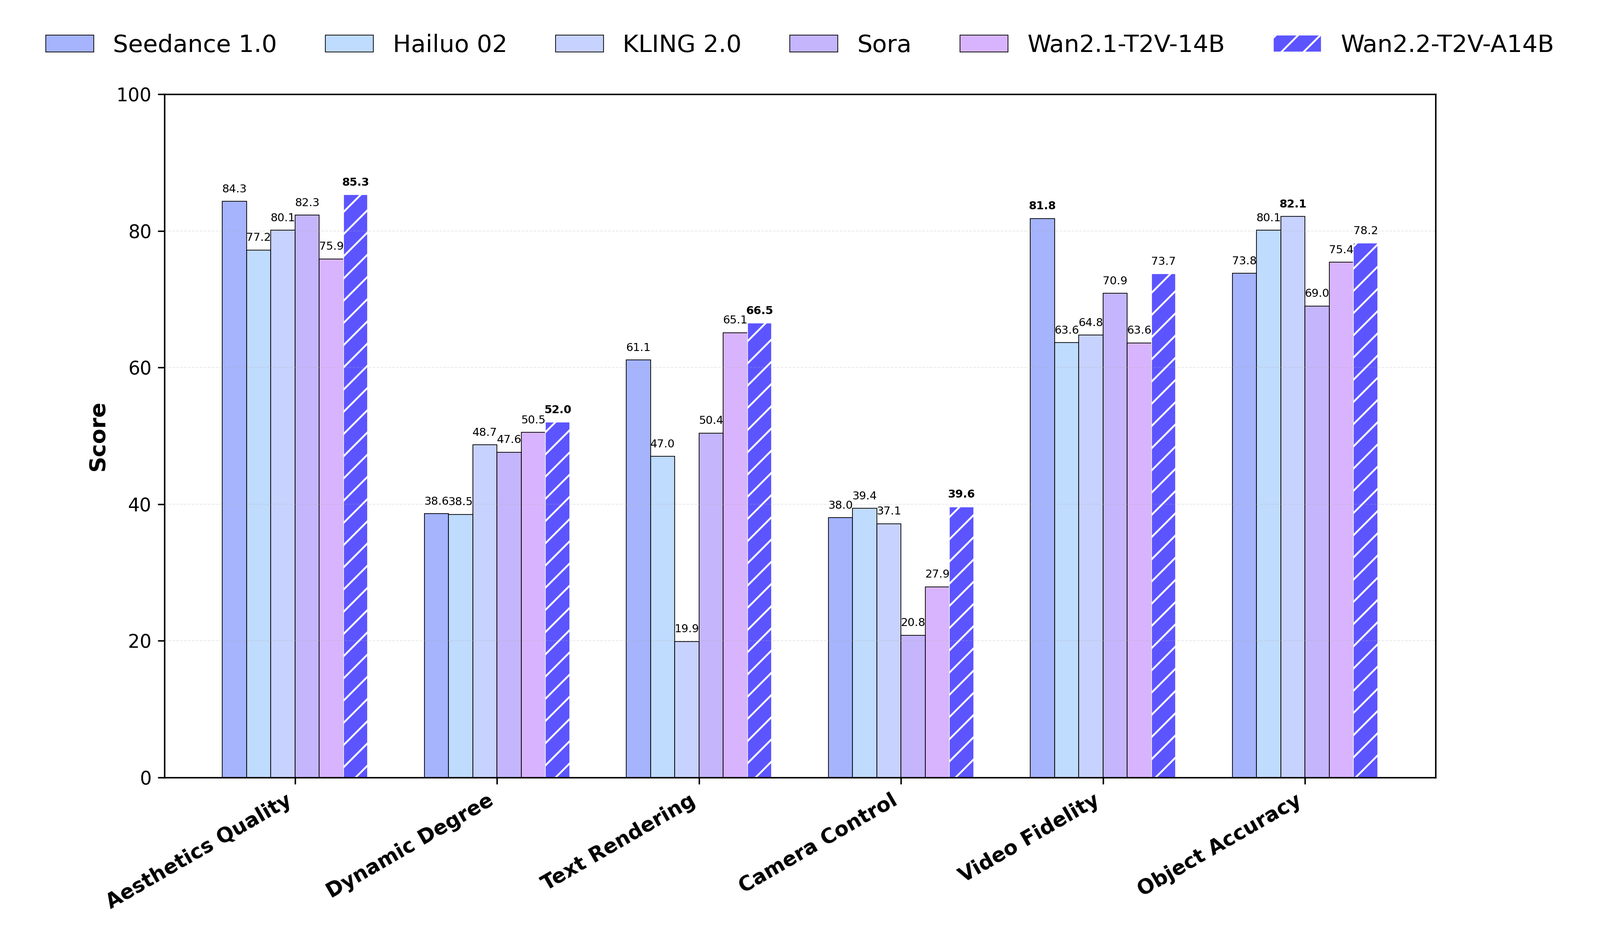
开源序列的另一条线是腾讯:HunyuanVideo-I2V(2025 年 3 月)、HunyuanCustom(5 月,一致性生成)、HunyuanVideo-Avatar(5 月,语音数字人)、端到端音效模型 HunyuanVideo-Foley(8 月),再到 2025 年 11 月 21 日的 HunyuanVideo 1.5——8.3B 参数、14GB 显存可跑,把旗舰体验压到了单卡部署门槛之下。
开源路线的战略意义在 2025 年底已经清晰:它不负责赚钱,负责摊平对手的利润。当一个 14B 模型可以免费下载时,闭源 API 的定价天花板就被焊死了。
2.4 价格战前置
2025 年的价格战还没有 2026 年那样血腥,但所有动作都已就位:
- 可灵在 2025 年内多次下调 API 价格,用"足够便宜"换开发者生态;
- 即梦(字节)在国内 C 端长期采取近乎免费的积分策略,把生成成本埋进抖音创作链路里;
- Veo 3 以 API 形式入场,把"每秒价格"变成公开报价单上的常规条目;
- 开源侧的 FP8 量化、单卡推理、VAE 压缩(Wan-VAE 支持任意长度 1080P),把推理成本每个季度往下拧一圈。
有一个数字可以概括 2025 年的全部铺垫:Wan 2.1 的 1.3B 版本让一条 5 秒视频的成本从"云API几美元"降到"自有显卡几分钱"。当成本曲线以这个斜率下降时,价格战不是会不会来的问题,而是谁在什么时候扣动扳机的问题。
2026 年 4 月 8 日,即梦宣布全面调价,15 秒视频生成成本从 0.65 元涨到 5.03 元、涨幅近八倍——扣动扳机的居然是涨价的那个。这声枪响,以及随之而来的"冰火两重天",属于中篇的故事。
在这里,需要提前给全文的关键词之一下一个操作性定义。所谓"进入",不是比喻意义上的"沉浸"——不是戴头显、建化身的那种进入。它的技术定义是:用户的操作成为生成模型的输入条件之一。 当用户按下键盘、移动鼠标、发出文本指令,模型的下一帧输出因此改变——在这个反馈回路建立的那一刻,生成物就从"内容"变成了"环境",用户就从"观众"变成了"进入者"。记住这个定义,下篇的每一章都是它的展开。
中篇:2026,五大战场
2026 年的视频生成行业,已经没有"发布会时刻"了。模型像炮弹一样落下,榜单像股市一样波动。我们把这一年拆成五个战场来看:榜单、时长、声音、输入、面孔。在每个战场上,我们都会问同一个问题:优势还能保持多久?
第三章 匿名屠榜现场
2026 年 4 月 7 日前后,一个名叫 HappyHorse-1.0 的模型出现在 Artificial Analysis 视频竞技场(Video Arena)。没有发布会,没有技术报告,模型名称旁边只有四个字:"即将推出"。
所谓"匿名",指它在榜单上的上架状态——以代号参赛、无公司署名;但这并不等于身份成谜,行业猜测几乎在第一时间就指向阿里巴巴,四天后猜测得到证实。匿名上架本身就是一种发布策略:让作品先说话,让身份后置,把一次模型发布变成一场持续数天的悬念营销。
然后就是屠榜。以下是截至 2026 年 4 月 9 日中午(榜单取数时间)的 Artificial Analysis Elo 盲测数据:
|
赛道 |
HappyHorse-1.0 |
第二名(Seedance 2.0) |
分差 |
|---|---|---|---|
|
文生视频(无音频) |
1378 |
1273 |
+105 |
|
图生视频(无音频) |
1411(平台历史最高) |
— |
+50 以上 |
|
文生/图生视频(带音频) |
与 Seedance 2.0 几乎并驾 |
— |
仅 1—2 分 |
(口径说明:Elo 是国际象棋沿用至今的等级分体系,分差 Δ 对应的期望胜率约为 1/(1+10^(−Δ/400))——领先 105 分约等于六成四的期望胜率,领先 50 分以内肉眼基本无法分辨。Artificial Analysis 的盲测机制下,投票者不知模型身份、仅凭观感二选一。还需注意,Elo 是动态量,数天内可波动 20 分以上,不同赛道、不同取数时间会出现 1333、1357、1375、1379 等不同读数;本文以 4 月 9 日中午、文生无音频赛道为准。)
同样的数据,读出两个完全不同的结论:
结论一:画质竞争的终局已经到来。 105 分的领先意味着在"纯视觉观感"这个维度上,头部模型之间已经不存在代差式差距,取而代之的是一个模型对另一个模型的稳定压制——而这种压制不需要品牌背书,匿名就够了。
结论二:音频是另一场战争。 一旦把音频放进盲测,105 分蒸发成 1—2 分。画质的王座刚坐上去,就发现自己统治的只是半个王国。
这里先埋一个方法论上的悬念:这 1—2 分到底意味着什么,取决于盲测机制对音频维度是否足够敏感——这个问题第五章再展开。
4 月 10 日,阿里巴巴 ATH(Alibaba Token Hub)事业群正式认领。按公开报道口径,HappyHorse 是一个约 150 亿参数的统一 Transformer 架构模型,1080p 直出,支持 7 种语言的口型同步,团队并承诺后续开源——参数规模本身也说明不了胜负,但它解释了为什么阿里敢让它匿名参赛:底座够厚,不需要名字背书。这里有一个值得记录的归属花絮:媒体报道一度出现两个版本——早期说法指向"淘天未来生活实验室、前可灵负责人张迪领衔";官方认领版本则表述为"ATH 旗下 AI 创新事业部郑波团队,核心成员包括前快手副总裁、可灵技术负责人张迪"。两个版本不必然矛盾(一个团队,两种叙事重心),但它们并存的本身就说明:在"谁是负责人"这个问题上,公司内部的站位与外部的声望,都需要被仔细经营。负责带出一支屠榜团队的人,自己也是行业稀缺资产。
还有一个更宏观的背景:ATH 事业群成立于 2026 年 3 月 16 日,由 CEO 吴泳铭亲自挂帅,整合通义实验室、MaaS、千问、悟空与 AI 创新事业部,目标逻辑九个字:"创造 Token、输送 Token、应用 Token。" HappyHorse 是这套新架构的第一个战果——它不是一次孤立的技术胜利,而是一次组织改革的亮剑。
HappyHorse 后续的动作是价格:4 月 27 日灰度开放,6 月 22 日发布 1.1 版,1080P 每秒 1.2 元(优惠后 0.72 元),比 1.0 版降价 25%。屠榜之后立刻降价——这个顺序本身就是 2026 年的行业语法。
第四章 时长战争
如果 2025 年比的是"画质天花板",2026 年上半年比的就是时长。
主角是字节跳动的 Seedance。2 月 12 日发布的 2.0 版本在上半年形成了业界公认的代差优势,吃掉 OpenAI 关停 Sora 后留下的份额,直接推动中国短剧行业从真人实拍大规模转向 AI 制作。按官方资料与开发者社区拆解的口径,2.0 以统一的多模态扩散 Transformer(Multimodal Diffusion Transformer)取代了旧版"文本/图像分管道"的处理方式,把文本、图像、音频、视频编码进同一个共享表示空间;提示词支持 @ 语法(@image1、@video1……)为每个参考素材精确指派位置,6 秒以上的片段支持时间线提示词(timeline prompting),由模型自动规划多镜头序列——"写分镜"这个导演职能,也被收编进了提示词工程;据字节披露,截至 6 月底,Seedance 2.0 海外调用占比已从 1/3 增长到 1/2。梁汝波在 8 月字节全员会上给了它一个评价:"一个模型改变了一个行业。"
2.5 版本的发布过程,则成为本年度最值得玩味的发布节奏样本:
|
阶段 |
时间 |
事件 |
|---|---|---|
|
公布 |
2026 年 6 月 23 日 |
火山引擎 FORCE 原动力大会,总裁谭待正式公布 Seedance 2.5,称内测收尾、"7 月初正式发布" |
|
跳票 |
7 月 9 日 |
向用户发出发布取消邮件,未说明理由 |
|
落空 |
7 月 14 日、7 月 20 日 |
两个流传的目标日期先后悄然过去 |
|
上线 |
7 月 31 日 |
正式发布,登陆即梦 AI、豆包专业版 |
|
API |
8 月 7 日 |
火山引擎上线 API,同步公布定价:含视频输入 42 元/百万 tokens,不含视频输入 70 元/百万 tokens |
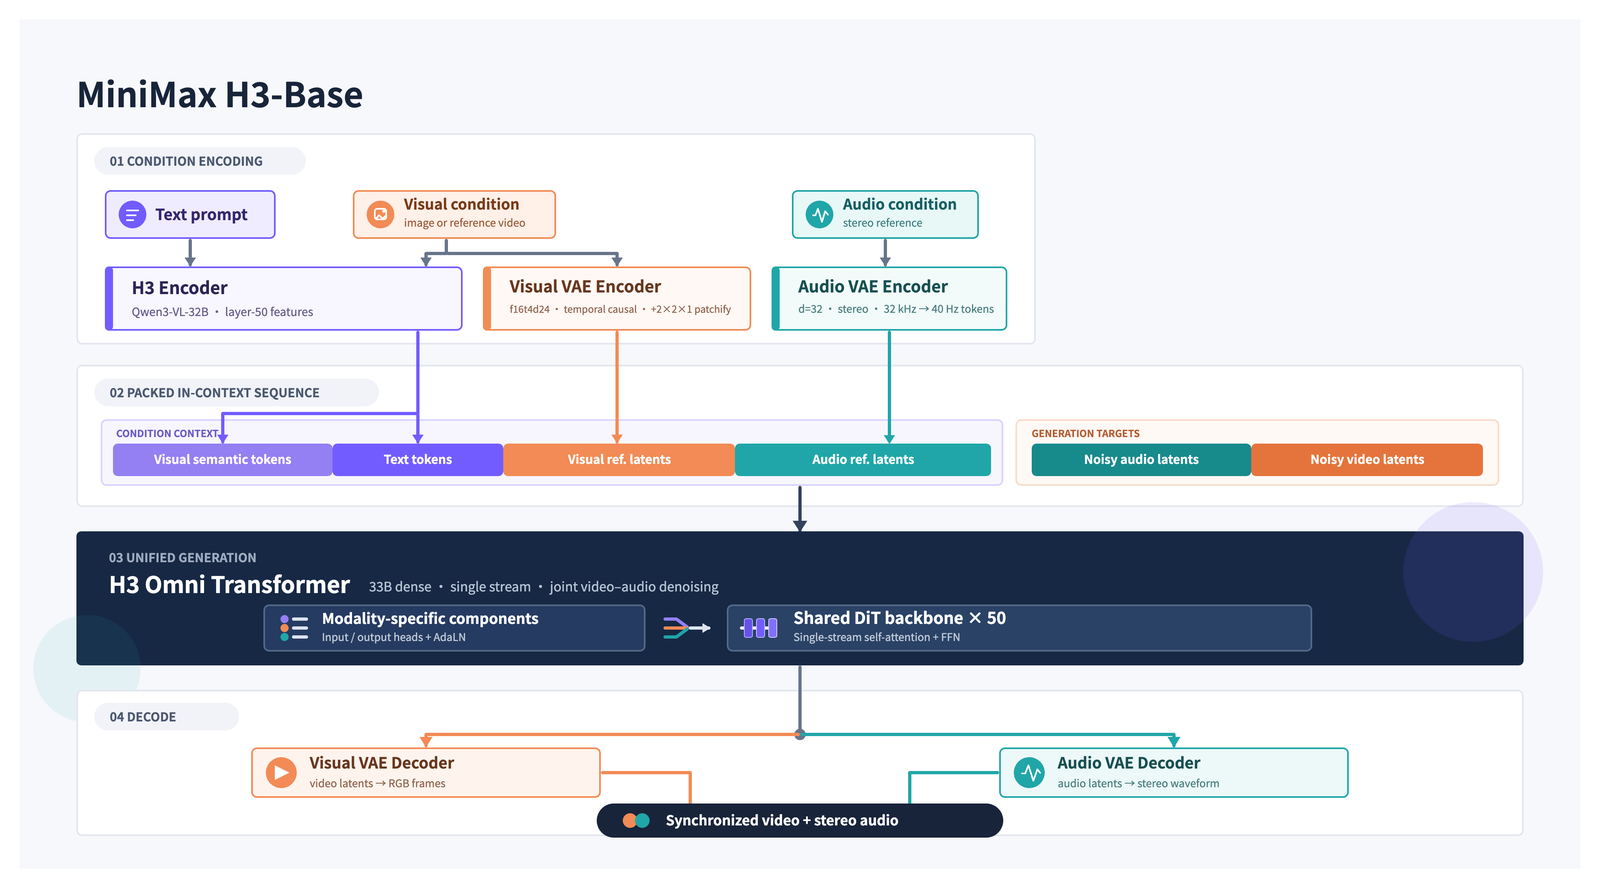
(上图:与 Seedance 2.5 同一天入局的开源选手 MiniMax H3 的模型架构——详见本章下文。)
三阶段后移——公布→上线→API,每一阶段都比承诺晚了几周。官方从未解释原因,但社区证据勾勒出一个合理的图景:期间出现新一轮针对 Seedance 2.0 的"削弱"报告(用户普遍感知生成质量波动,字节未证实);按 2.0 的 token 公式估算,一个原生 30 秒 4K 片段的计算量约为典型 10 秒 720P 任务的 27 倍。当成本以平方级增长时,"发布时间"就不再是营销决策,而是算力供给的函数。 视频模型发布的每一次延期,本质上都是一份未经审计的算力资产负债表。
能力本身值得记下:单次生成 30 秒、多轮延长可至数分钟;单次最多接受 30 张图片 + 10 段视频 + 10 段音频共 50 个参考素材;时间戳级精准编辑;弱化"油腻感"。发布当天,徐工集团、小鹏汽车、智元机器人等十余家企业确认接入——它同时是给 C 端创作者和长视频/工业客户的双向交付。
同一天的另一条战线:MiniMax 于 7 月 31 日发布新一代多模态生成模型 H3,宣布开源,8 月 3 日开放权重——视频生成领域罕见的旗舰级开源动作,正面对撞的意味不言而喻。H3 支持文本、图片、音频、视频全模态输入,2K 分辨率直出,最长 15 秒音画内容,2K 档定价 0.8 元/秒,自称"仅为业内同类旗舰的三分之一"。
30 秒对 15 秒、闭源对开源——时长战争的两侧,站着两种商业信念:字节赌"长内容的生产力溢价",MiniMax 赌"便宜、开放、可私有部署的规模市场"。两家的价格,在第十一章还会再见面。
第五章 声音现场:从"有声"到"可控"
现在可以展开第三章埋下的那个悬念了:为什么 105 分的画质优势,在音频赛道会蒸发成 1—2 分?
这不是 HappyHorse 一家的窘境,而是整个行业的音频悖论:
- 2025 年 5 月,Veo 3 把"原生音频"带入旗舰标配,完成从 0 到 1;
- 2025 年 9 月,Sora 2 实现音视频同步生成,把它推向消费级产品;
- 2025 年 8 月,腾讯混元开源 HunyuanVideo-Foley,端到端视频音效生成成为公共资源;
- 2026 年上半年,Seedance 2.0/2.5 采用统一的多模态音视频联合生成架构——音画在同一个模型里一起长出来;
- 2026 年 7—8 月,MiniMax H3 支持原生双声道,Sand.ai 的 MAGI-2 用统一单流架构让声音、口型、表情、动作从生成开始就被共同建模。
用一年时间走完的路线是:"没有声音"→"有声音"→"声音与画面同步"→"声音、口型、动作共同建模"。当所有人都在同一条联合建模的路线上时,音频就从"差异化优势"降格为"入场券"——这正是 HappyHorse 盲测数据的深层含义:它的画面领先 105 分,但音频维度立刻被拉回同一条起跑线,因为音频能力不再依附于任何单一模型。
这里需要一个技术锚点来说明"联合建模"到底意味着什么。以 2026 年 2 月 12 日发布的 Seedance 2.0 为例,官方与券商研报口径的架构是"视频+音频双分支扩散 Transformer"(DB-DiT):视觉与音频在去噪过程中同步生成,两个分支共享统一的多模态理解编码器,并以跨分支校准模块实时对齐节奏、情绪与场景匹配度——音画同步从"生成后的对齐工序"变成"生成中的内禀约束"。对比一下:Sora 2 与 Veo 3 仍属"单分支生成+后期对齐"思路。架构差异直接决定了第五章开头那个榜单数据的性质。
也需要诚实地标注一处方法论存疑:上述"蒸发"还有第二种解释——盲测机制对音频维度的敏感度问题。人类投票者在快速对比两段视频时,注意力天然向画面倾斜,音频差异需要更专业的耳朵才能分辨;若评测工具本身低估了音频权重,"105 分蒸发成 1—2 分"度量的可能是评测的盲区而非能力的事实。这个问题在 AI 视频评测界已被反复讨论,目前没有干净解法。因此本文的表述留有余地:可以确证的是"音频没有成为新的胜负手";不能确证的是"各家的音频能力已经拉平"。这是第三章那个悬念的完整答案——悬念不在于音频能力谁强谁弱,而在于我们用来裁决胜负的尺子,本身可能量不准声音。
而"有声"之后的那道门,叫可控。2026 年的音频竞争已经不是"能不能出声",而是:口型能否按七种语言精准对齐(HappyHorse 宣称支持 7 语言口型同步)?音色能否被参考素材锁定(Seedance 2.5 的 10 段音频参考、H3 的配音参考)?环境声、对白、配乐能否分层、分时间戳地编辑(Seedance 2.5 的时间戳级编辑)?
一句话概括这个战场:2025 年解决"有声",2026 年解决"可控",而每一段声学能力的保鲜期,正在以季度为单位缩短。 优势的蒸发速度,本身就是这个行业最重要的技术指标。
第六章 "文生"的退场——当一切输入都成为条件
有一个缓慢发生、但从未被正式承认的变化:"文生视频"这个品类正在消失。
这个判断如果只放在视频领域,说服力是有限的——它是视频生成的特殊现象,还是整个生成式 AI 的普遍趋势?答案是后者,而且"文生"的退场并非始于视频。在图像领域,文生图在 2022—2023 年走过了与视频几乎相同的轨迹(惊艳 demo→产品化→价格战→能力趋同),到 2024—2025 年,主流用法已经转向图文生图与图像编辑:用户上传参考图、用文字局部修改,文本从唯一指令退化为辅助指令。ControlNet、IP-Adapter、SeedEdit、FLUX.1 Kontext、Qwen-Image-Edit,这条工具链的核心逻辑都是"图像锁定内容,文本描述变化"。视频只是把这一逻辑推到了多模态、时序化的极端。当图像领域早已完成"文生"的祛魅,视频领域的"文生"退场就不是意外,而是同一范式的延迟复刻——大约晚了一年半,叠加了时序与音频两个新维度。
证据不在发布会上,而在输入框里:
- Seedance 2.5:单次最多 30 张图片 + 10 段视频 + 10 段音频作为参考素材;
- MiniMax H3:FL2VA 模式支持 0—2 张图像(无图纯文生、单图首帧/尾帧、双图首尾帧补间),Ref2VA 模式支持最多 9 图 + 3 视频 + 3 音频共 12 个文件锁定角色、动作、风格与配音;指令编辑模式支持自然语言局部改图;
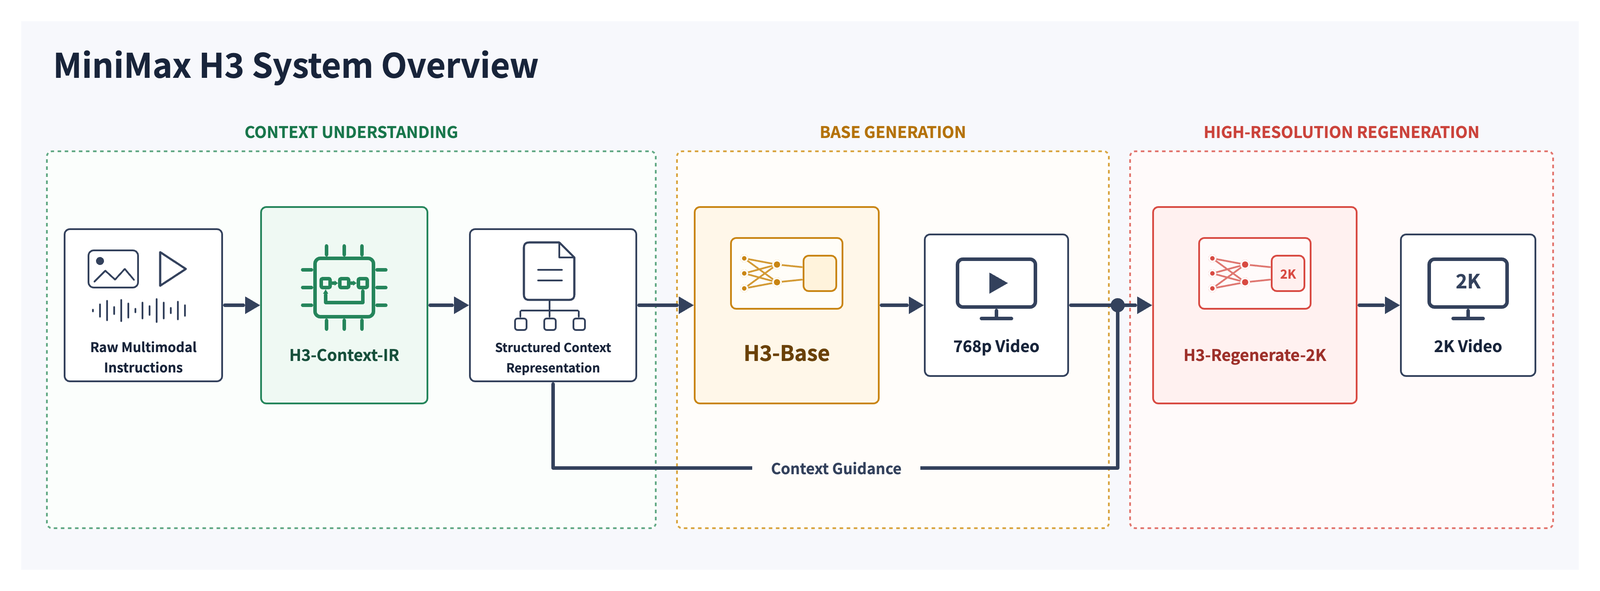
- Wan 3.0(经 SkyProduction 接入):最多 10 图 + 5 视频 + 5 音频参考,并能读取 Word、Excel、PPT、PDF、Markdown 和网页内容作为生成条件。
看出规律了吗?文本正在从"唯一的输入"退化为"众多条件之一",而且是信息密度最低的那个。角色长什么样由图片锁定,动作由视频参考迁移,声音由音频参考给定,剧情由剧本文档输入——文本只剩两个职能:描述那些无法提供素材的部分,以及串联所有条件之间的逻辑。最有说服力的证据来自产品语言本身:阿里云官方的视频生成 Prompt 指南给出的公式是"提示词 = 参考指代(图n/视频n)+ 动作 + 场景 + 台词 + 背景音乐"——文本在这个公式里已经不是创作指令,而是对一组条件文件的批注语法。当一切输入都成为条件,"文生"作为一个技术范式已经退场,留下来的是一个更古老的东西的数字化复刻:导演工作。
但这里必须安放一段反方论证。 既然"文生"在退场,为什么 Seedance 2.5 和 Kling 4.0 仍把它作为核心宣传点?
可灵 4.0 于 2026 年 9 月 29 日开启内测、10 月正式上线,官方话术是"单次原生生成最长 30 秒""最多 10 张关键帧输入"——前缀仍然是"视频生成模型",榜单上的赛道仍然叫"文生视频"。似乎整个行业都在一边实操"全模态条件生成",一边嘴上继续说着"文生"。
这个矛盾有一个冷峻的解释:产品命名滞后于技术现实,而命名权本身是竞争资源。
三个理由:其一,用户心智是有惯性的,"文生视频"是过去三年教育出来的搜索词、预算科目和媒体版面,谁主动放弃这个词条,谁就白白让出获客入口;其二,榜单与评测体系按"文生/图生"分赛道,命名即赛道,赛道即排名,排名即融资故事;其三,"全模态条件生成"对中小客户是认知负担,"文字就能出片"才是能写进标书的承诺。
所以准确的说法是:"文生"作为技术已经退场,作为词汇还将继续营业。 这并不虚伪——这是产业竞争中稀松平常的认知套利。
还要把一个更尖锐的问题留在台面上:输入框的丰富不等于使用模式的迁移。一个用户面前摆着 50 个参考素材的上限,实际可能只用了 1 句文字 prompt——本文没有用户侧行为数据来排除这种可能,因此本章的判断是能力侧的观察,而非需求侧的证实。中小客户愿意为"文字就能出片"买单,恰恰可能说明:对大多数买家而言,prompt 不是"信息密度最低的输入",而是"学习成本最低的条件"。技术现实的变迁是一回事,用户习惯的迁移是另一回事,前者以季度计,后者以年计。
第七章 数字人现场
视频生成的另一条暗线,是"让特定的人,在视频里稳定地存在"。这条线的 2026 年里程碑,几乎全部与"编辑"有关。
起点要回看到 2025 年:OpenAI 的 Cameo 功能(上传自己的音视频即可入画)证明了需求的存在,但也把肖像权、深度伪造的雷一起埋进了 C 端产品——后来 Sora 收到的下架请愿与合规压力,一半来自这里。腾讯混元则在 2025 年 5 月 28 日开源了 HunyuanVideo-Avatar,一条语音驱动照片级数字人的开源路线。
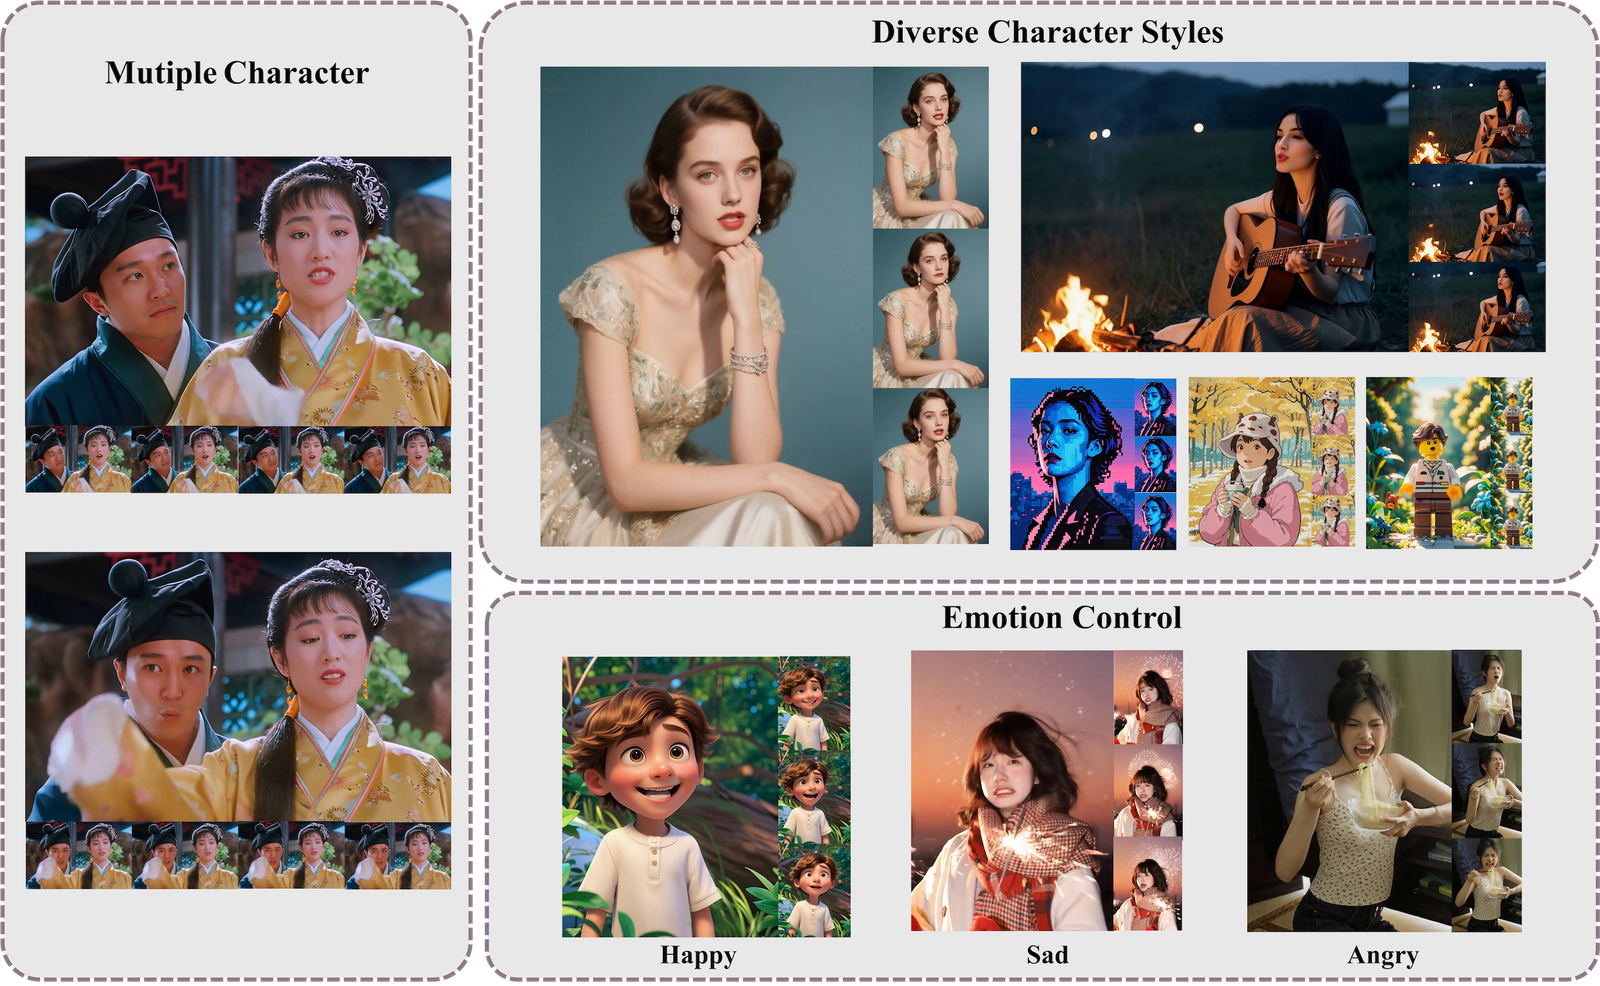
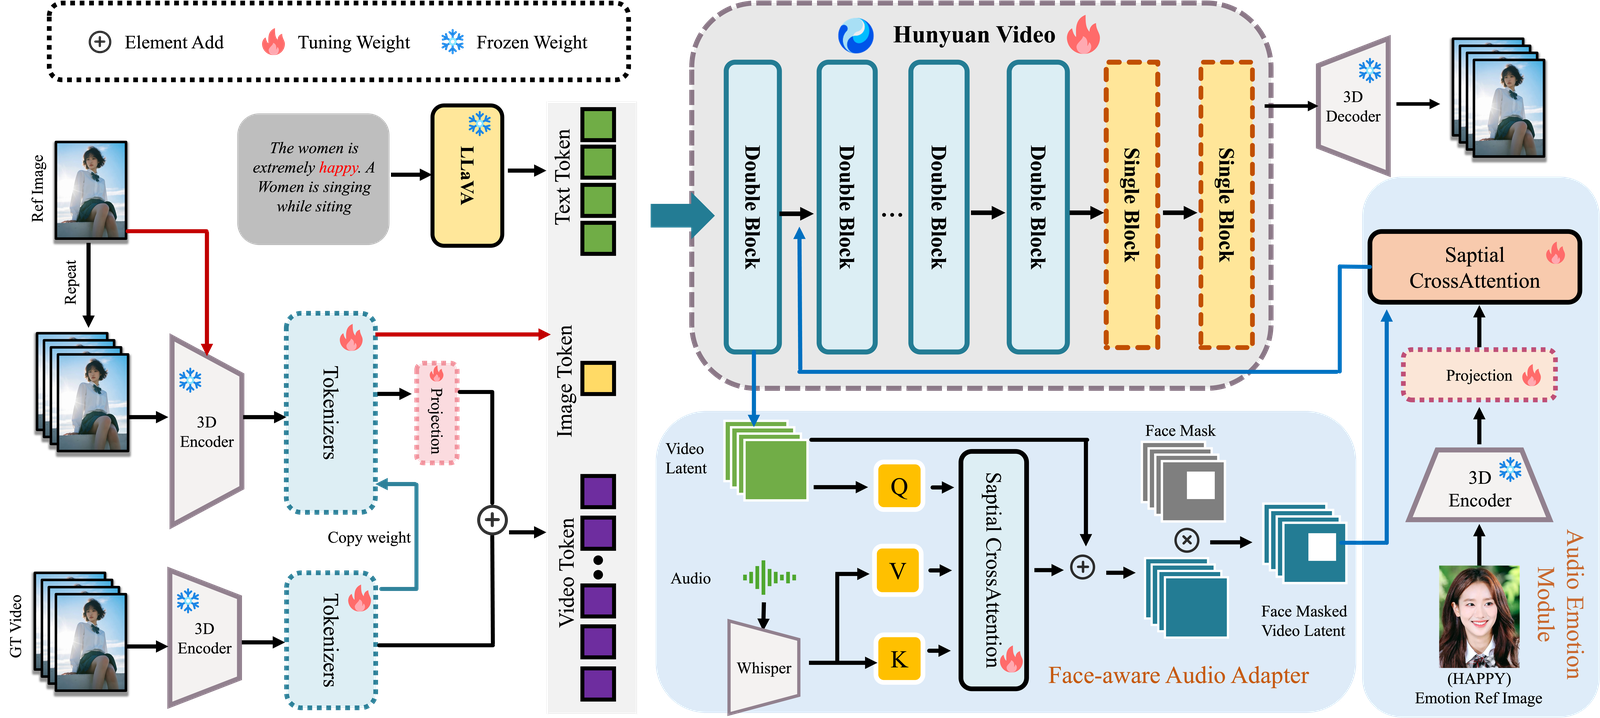
2026 年的关键一跃来自 MiniMax H3(8 月 3 日开源):它的 V2V Motion Transfer(视频到视频动作迁移)可以把参考视频中的动作迁移到目标角色,配合自然语言指令编辑——换背景、换物体、改动作——无需整段重绘。从条件工程的角度看,这相当于把数字人的三要素拆成三条独立可控的通道:身份由参考图像锁定,表演由参考视频迁移,环境由文字指令改写——三条通道可以分别迭代,互不重采。这实际上把数字人从"一次生成"解放出来,进入了"持续修改"的工作流:形象锁定靠参考,表演靠迁移,微调靠指令。
再叠加 Seedance 2.5 的时间戳级精准编辑与绿幕/视角/参考编辑,"数字人 + 可编辑"的组合意味着:真人演员不再被替代于"生成"环节,而是被替代于"修改"环节——不需要重拍,只需要一句话。对影视工业的杀伤力,这比任何画质指标都大。
第八章 输家与规则
输家
先把聚光灯移开。2024 年站在舞台中央的欧美明星创业公司,此刻在哪里?
- Runway:从 Gen-3 时代的"电影工业 AI"叙事,转向自我定位"通用世界模型"(General World Models)公司,押注影视工作流与世界模型研究,2025 年 4 月以约 30 亿美元估值完成 3.08 亿美元融资。它不再争夺"最强视频模型"的头衔——那个战场它打不起。
- Pika:退回 C 端消费特效与娱乐玩法,用爆款特效而非模型参数竞争。
- Luma:聚焦 Dream Machine 与 3D/空间智能能力,在电影制作流程中寻找纵深位置。
三家的共同选择是:退出通用模型的军备竞赛,把有限的算力烧在自己能守住的纵深里。这不是失败者的狼狈,而是理性——当对手是拥有短视频生态、云基础设施和自有 GPU 集群的字节、阿里、谷歌时,"独立模型公司"这个物种在通用赛道上已无胜率。Sora 的关停(2026 年 3 月)是这一判断最昂贵的注脚:连 OpenAI 都烧不起,何况创业公司。
同样被大宗商品化挤压的还有中国中腰部模型。昆仑万维的 SkyReels 走"模型 + 出海短剧分发"的闭环路线(第十二章 DramaWave 的流水即出自这条链);生数 Vidu 从通用旗舰竞争退守垂类场景与参考生视频;智谱 CogVideoX 系列在开源中腰部维持存在感,但已不在旗舰榜单的牌桌上。它们的处境比 Runway 们更微妙:既没有平台可以退回,也没有资本继续烧通用旗舰——大宗商品化对它们的含义是:当"够用"的开源底座触手可及,"自研旗舰"的理由越来越难向董事会解释。至此,第一章 1.2 节提出的资本结构差异完成了它的闭环:平台系厂商用生态内部消化成本,欧美明星公司用纵深换取存活,而中腰部独立公司两头不占——同一个行业剧变,三种资本结构的三种死法或活法。
它们的退场,构成了本文枢纽判断的第一块基石:模型层正在大宗商品化,胜负手移出了模型本身。
规则
第二块基石来自监管与版权——规则正在成为比参数更深的护城河。
版权线。 2025 年 9 月 16 日,迪士尼、环球影业、华纳兄弟在加州联合起诉 MiniMax,指控其海螺 AI 在训练、生成与推广三个环节构成侵权。此后 Midjourney 也被迪士尼、环球起诉,华纳兄弟数月后加入战团;2026 年 7 月,Midjourney 反诉,要求制片厂披露自身使用 AI 的情况——这场互揭底牌的诉讼战,把"好莱坞是否也在偷偷用 AI"变成了公开议题。2026 年 2 月 14 日,迪士尼又正式指控字节 Seedance 2.0 侵权,美国电影协会声援;而耐人寻味的是,就在三个月前,迪士尼还与 OpenAI 达成了价值 10 亿美元的 200 个 IP 授权合作(随 Sora 关停而告吹)。起诉一个、授权另一个、失去全部——好莱坞对 AI 的态度从来不是技术判断,而是议价能力问题。字节方面的应对是紧急限制版权角色与真人肖像生成,业内普遍预期"版权素材分成机制"将被迫落地。
监管线(中国)。 还记得第一章的伏笔吗?《千秋诗颂》开播两年后,监管链条完整收束:2025 年 11 月,广电总局启动专项治理,首次将 AIGC 类、漫画类动画微短剧纳入分类分层审核体系;2026 年 4 月 1 日起,AI 微短剧"先备案、后上线",未备案存量作品强制下架;6 月 25 日发布《管理提示(AI 微短剧分类分层标准)》(7 月 1 日施行),按投资额 80 万/30 万两档分三级管理;7 月 30 日《微短剧发展管理办法》审议通过,9 月 1 日起施行,明确要求 AI 生成内容每集添加显著提示标识。数字可以说明为什么要管:2026 年第一季度全行业上线微短剧约 12.8 万部,其中 AI 短剧占比超过 95%,市场规模约 240 亿元,用户规模突破 2.8 亿。
最后需要补一个立场上的限定:把监管读作护城河,是竞争分析的视角,不是价值判断的终点。"先备案、后上线"在重塑格局的同时,也在压缩创作实验的空间——95% 的 AI 占比的另一面,是题材、风格与表达方式的趋同风险。规则保护了秩序,也定义了边界,而边界总是由最先进的那批创作者率先撞上的。
规则的两个侧面——版权与监管——看起来是束缚,实际上在重新定义竞争资源:合规能力、授权资产、备案通道,都成了别人短期无法复制的存量。当模型能力可替换时,这些东西不可替换。
第九章 枢纽:统一现场(Omni)
把五大战场合起来看,2026 年的行业地形可以用一组术语重新描述。
第一个术语:大宗商品化(commoditization)。 指的是模型层能力的商品化——像石油、像内存条一样,有公开报价、可批量采购、可无损替换。它的三个可观测条件是:榜首高频易手(Seedance 2.0 数月王座被一匹匿名马掀翻)、能力即插即用(同一工作流可以在 Seedance、可灵、Wan、H3、Veo 之间随时切换,第三方路由平台把"多模型接入"做成了标准产品)、开源权重常态化(HunyuanVideo、Wan、H3 把旗舰能力直接放进公域)。第八章输家的退场,正是这一判断的论证场。
第二个术语的区分:能力即插即用,不等于流程端到端锁定。 这是 2026 年最精妙的一层博弈。模型在商品化,但每家都在用"流程"把商品化的模型重新私有化:字节把 Seedance 缝进即梦—豆包—火山方舟的生产线,可灵长在快手的创作与分发链路里,Wan 挂在阿里云与通义家族上,H3 用开源换生态位。你可以随时换掉模型,但你很难换掉整条流水线——API 是开放的,流程是锁定的;能力在贬值,关系在升值。
而从技术演进的方向看,统一正在两个维度上同时发生。其一是模态的统一:文、图、视频、音频不再分属不同模型,而是同一个上下文里的不同条件(H3 的 Contextual Omni Representation、MAGI-2 的统一单流、Seedance 的音视频联合架构),模态之间的墙已经拆完。其二是时间的统一:从 5 秒到 15 秒、30 秒,再到多轮延长的数分钟——镜头内的时间被打通之后,下一个目标必然是无限的时间:可持续生成、可交互、永不结束的世界。
模态统一完成后,视频生成就只剩一个问题没解决了:它必须活起来。
这把我们带向下篇——Omni 之后的战场,不在银幕上,在世界里。
下篇:Omni 之后
第十章 交互现场:灵波
枢纽章回答了模态的统一,留下的是时间的统一:当视频可以无限生成,生成物就不再是"片段",而是"世界";用户也就不再是"观众",而是"进入者"。模态统一之后,视频生成的下一个战场不在"生成什么",而在"生成物能不能被进入"——2026 年把这件事做到最极致的,是蚂蚁集团旗下的具身智能公司——蚂蚁灵波。
1 月 29 日,灵波开源第一代世界模型 LingBot-World:针对视频生成中最顽固的"长时漂移"(生成时间一长物体变形、主体消失、结构崩坏),它把连续稳定生成推进到近 10 分钟;约 16 FPS 的生成吞吐、端到端交互延迟控制在 1 秒以内——用户可以用键盘鼠标实时控制角色与相机,可以用文本指令改变天气、触发世界事件;镜头移开 60 秒再回来,房子还在,车还是那辆车。更关键的是训练方式:混合采集网络视频 + 游戏引擎(UE)渲染层直接提取的无 UI 纯净画面,并同步记录操作指令与相机位姿——模型学习的是"动作如何改变世界"。
7 月 9 日,第二代接棒:LingBot-World 2.0(Infinity)支持小时级实时生成、720p/60fps,并首次把 Agent 机制引入世界模型——世界不再只是"可观看、可操控",而是"可持续互动、可动态变化"。
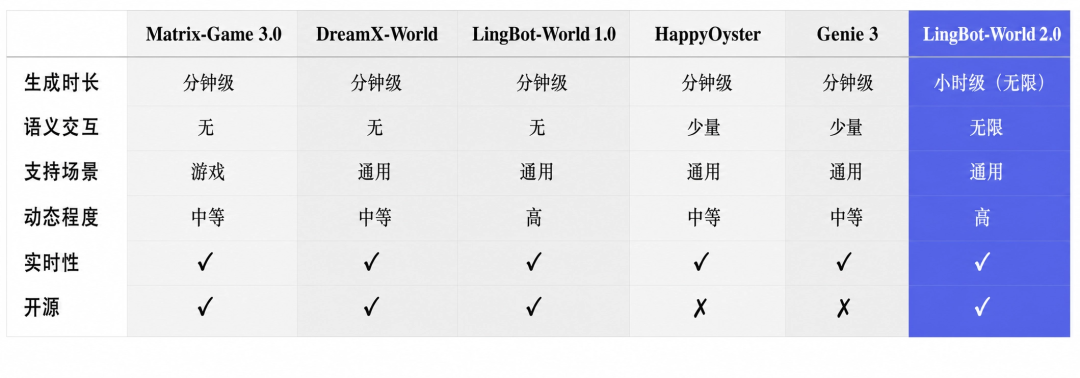
2.0 版的技术公报值得逐条拆开,因为它几乎是一份"世界模型工程化"的完整清单:
- 因果预训练范式(Causal Pretraining):模型在预测下一帧时只能访问已发生的画面、动作和截至当前时刻的用户输入,不许"偷看"未来——训练分布与推理分布一致,长程生成的复合误差从源头被抑制;
- MoBA(混合双向与自回归注意力掩码):在 Teacher Forcing 掩码中加入双向注意力组件,缓解纯自回归训练的过拟合与画质退化,配套的因果交叉注意力防止未来语义泄漏——一句话,用一点"双向"换画质,用"因果"保时间线;
- 蒸馏与部署:从因果预训练底座蒸馏出实时版本,结合一致性蒸馏与 DMD(分布匹配蒸馏)把多步扩散压缩为少步采样,再叠加编译器级注意力算子优化、混合并行推理、动态 KV 缓存调度与异步流式传输,才把"按键到画面"压进 1 秒以内;
- 双 Agent:Pilot Agent 规划执行角色行为,Director Agent 在场景推进中实时引入新事件——角色与剧情由两个智能体分管,世界因此"自己会演化";
- 规格与开放性:14B 模型 + 1.3B 官方蒸馏小模型,权重与代码以非商用协议开源,技术报告随 arXiv 公开(编号 2607.07534),支持多人同时进入同一个世界。
同步开源的 LingBot-Video 是全球首个面向具身智能的 MoE 架构开源视频生成基座模型,7 万小时具身数据训练,在北京大学与字节联合发布的 RBench 机器人操作视频基准上以 0.620 分超过 Wan2.6(0.607)、Seedance 1.5 Pro(0.584)与英伟达 Cosmos3 Super(0.581)。
请注意这个排名的意味:在"为机器人生成符合物理规律的操作视频"这件事上,专攻具身的开源模型击败了所有通用旗舰。当模型能力商品化之后,对单一维度(物理合理性、长时一致性、动作可执行性)的极致特化,成了开源阵营撕开闭源防线的新口子。
从 Sora 的 60 秒样片到 LingBot 的小时级可交互世界,只用了两年半。视频生成在这里完成了第一次身份转变:它不再是内容,而是环境。
还有一个被埋在规格清单里、但意义不亚于小时级生成的细节:LingBot-World 2.0 支持多人同时进入同一个世界。多人意味着生成物的属性发生了根本变化:它不再是"内容"(一个人创作、另一个人观看),而是"场所"(多个人同时在场、彼此可见)。 "进入"由此获得第二个维度:它不只是人机交互,也是人际交互——从"生成内容"到"生成场所",这是"进入"最具体的含义。
第十一章 物理现场:世界模型与机器人
如果说第十章是"人能进入视频",第十一章讲的则是"机器需要视频"——不是给人看,而是给机器人当训练场。
ABot-Earth:把地球变成可进入的世界。 6 月 8 日,高德发布 3D 原生城市世界模型 ABot-Earth 0.5;9 月 9—10 日,0.7 版发布。
它的技术路径与所有"2D 生成 3D"的方案都不同:直接用海量 3DGS(三维高斯泼溅)数据训练模型,端到端一次性生成 3DGS 格式的城市场景。输入一张卫星图或一段文字,一块消费级 GPU 上 10 分钟即可生成公里级 3D 城市,效率较传统模式提升约 1000 倍;单一模型完成从星球到城市到街景地标的全尺寸连续生成,覆盖 196 个以上国家和地区,已接入高德的飞行街景 2.0。其数据底气来自高德多年积累的时空数据资产。据 QuestMobile 口径的官方披露,高德月活约 10 亿量级,日调用北斗定位峰值近万亿次——需要审慎说明的是,这 10 亿月活并非 ABot-Earth 的直接数据入口,海量真实出行数据的存在性毋庸置疑,但"数据规模→模型能力"的因果链并非线性。而这个"数字地球"的第一批产业客户里,排在最前面的就是具身智能:0.5 版发布时即明确,它已支撑高德四足机器人"途途"的开放环境仿真训练——先为机器人生成一座城市,再让机器人进去学会走路。
World Labs:Real-to-Sim 的另一条路线。 李飞飞的路径同样指向机器人:少量真实照片或视频 → 重建三维空间 → 在模拟环境中批量生成不同动作、路径、视角的训练数据。9 月初发布的 Atlas 多模态世界模型已能利用图片、视频重建三维环境并生成机器人可用的模拟数据;商业产品 Marble 提供可漫游的交互式 3D 场景生成。
机器人的世界模型竞赛由此全面展开:阿里达摩院 2 月开源具身基座 RynnBrain,字节推出只需少量示范数据即可适应新任务的视觉—语言—动作模型 Seed GR-3,京东 8 月 5 日开源实时流式视频编辑模型 JoyAI-Video-Edit、同月开源可交互世界模型 JoyAI-Echo WM,宇树用世界—动作大模型让机器人完成全自主搏击。加上英伟达 Cosmos 与谷歌 Genie,世界模型在 2026 年 9 月突然拥挤。
现在可以回到开篇那笔交易了。AMD 以 82 亿美元收购 World Labs,表面是芯片公司买模型公司,实质是算力方收购"下一代算力需求的定义权":当视频生成在模型层商品化、利润率被开源与价格战压薄之后,算力增长的下一曲线只能来自新的工作负载——世界模拟、机器人训练、实时交互环境。这些负载的算力消耗方式(大规模并行模拟、实时推理、持续交互)与传统训练截然不同。想造出卖给未来的芯片,就要先拥有定义未来工作负载的团队——苏姿丰要的不是 World Labs 的收入,是"提前看到需求的那扇窗"。李飞飞入职 AMD、直接向苏姿丰汇报,正是这扇窗的价码。
第十二章 速度暗线
这篇长文里,画质、榜单、时长、声音、版权轮番登场,但真正决定战局的,是一条几乎没有上过头条的暗线:推理成本工程。
回看三年的技术公报,最激进的创新往往不写在标题里:
- 压缩:腾讯混元自研 3D VAE;Wan-VAE 支持任意长度 1080P;H3-VAE 带来约 4 倍序列长度收益——分辨率每上一个台阶,都是靠压榨 token 数量换来的;
- 量化与并行:HunyuanVideo 开源 FP8 权重版与 xDiT 多卡并行;HunyuanVideo 1.5 把旗舰体验压进 14GB 显存;Wan 2.1 的 1.3B 模型让 8GB 显卡成为视频工作站;
- 架构:MiniMax H3 用高压缩 Tokenizer 降低视频生成 token 数,异构训练与负载均衡压推理成本,才支撑起 0.8 元/秒的"旗舰三分之一价";Sand.ai 的 MAGI-2 用 Multi-Head MoE + Head Parallel 在千亿参数规模上控制单次推理开销;
- 计费:Seedance 2.5 按是否含视频输入分档(42/70 元每百万 tokens),把"条件越多越贵"的成本结构明码标价。
2026 年 8 月底,这条暗线浮出了水面。SkyProduction(剧厂)接入阿里 Wan 3.0,定价 0.05 元/秒——一条 30 秒视频最低约 1.5 元,创下全网视频模型最低价(8 月 28—30 日还限时免费)。这不是慈善,是一个标志:模型价格已经击穿"制作成本"的心理账户,开始向"流量成本"看齐。就在同一周,字节对 Seedance 2.0 mini 与 fast 打出 4 折与 75 折的限时优惠。
一条 30 秒视频 1.5 元意味着什么?意味着 AI 短剧的边际成本已经低于流量采买的边际成本——制约行业的天花板从"生成贵"变成了"获客贵"。价格战打到这个份上,竞争自然换场:如行业观察者所言,模型价格趋零之后,战场从模型转向生产流程与商业化闭环(SkyProduction 上已有剧集在 DramaWave 实现超 200 万美元流水,"生成→分发→营收"闭环被验证)。
三年前,Sora 用 60 秒样片让全世界惊叹"这得多少钱";三年后,1.5 元一条的价格把这个问题的答案变成了"不用想"。速度暗线才是所有明线竞争的底层约束:HappyHorse 敢在屠榜后降价 25%,H3 敢开出三分之一价,Wan 3.0 敢定 0.05 元/秒——底气全部来自这里。Sora 日均 1500 万美元的成本结构在这个世界里没有生存权,OpenAI 的退出在财务上不是选择,是必然。
结语:大宗商品化的三个条件,一次收束验证
回到开篇的 82 亿美元。
三年来我们追问了五个战场,现在可以把枢纽一章提出的“模型层大宗商品化”拆成三个可验证的条件,逐一收束:
条件一:能力趋同,榜首高频易手。 已验证。Seedance 2.0 的王座坐了不到半年,被一匹匿名马以 105 分优势掀翻;带音频赛道上,“领先”只剩 1—2 分。没有谁的代差能撑过两个季度。
条件二:能力即插即用,获取成本趋零。 已验证。开源权重(HunyuanVideo、Wan、H3、LingBot)让旗舰能力进入公域;API 价格战从三分之一价打到 0.05 元/秒;多模型路由成为标准产品。模型像大宗商品一样被采购、被替换、被套利。
条件三:差异化移出模型层,向流程、生态与规则迁移。 已验证。胜负手转移到端到端流水线(能力开放、流程锁定)、分发闭环(生成→投放→复盘)、合规与版权资产(备案通道、授权库存),以及其后的新大陆:交互与世界。
三个条件全部成立。而开篇那笔交易,正是这个收束的镜像:当模型本身成为大宗商品,最稀缺的能力变成了定义下一代负载的能力。
AMD 买下 World Labs,买的不是生成能力——那是大宗商品——而是生成能力的去向:世界模拟、机器人训练、实时交互环境。这些负载需要什么芯片、什么架构、什么算力分配方式,World Labs 的团队比任何人都更早看到。苏姿丰要的不是收入,是“提前看到需求的那扇窗”。李飞飞入职 AMD、直接向苏姿丰汇报,正是这扇窗的价码。
灵波开源 LingBot-World,证明的不是“蚂蚁做得好”,而是“可交互世界”这个品类在技术上成立;World Labs 的 Atlas 从另一条路径证明三维环境可以从少量真实数据中重建;ABot-Earth 把地球本身变成可进入的 3DGS 城市。三条路径,同一个方向:生成物不再是被观看的内容,而是可以被进入、被操作、被持续互动的环境。 当生成可以对操作做出回应,视频生成就不再是内容生产,而是环境生产——这是模型商品化之后,算力需求能找到的下一个出口。
回看 2024—2026,行业史由此分出清晰的两个阶段:2024—2026,是从“生成”到“可用”的战争,赢家用成本与流程决出了胜负;2026 年之后,是从“可用”到“在场”的战争——战场换成了世界模型、机器人与实时交互,评判标准不再是样片多惊艳,而是生成物能否承载一个走进去的人、一台学会行动的机器。
三年前的 Sora 样片里,那名女子走过东京街头,观众在屏幕外看她。
三年后的 LingBot 世界里,用户可以敲下键盘,自己走进那条街。
但真正的收束不在这个画面里,而在 AMD 的资产负债表上:82 亿美元定价的不是一个模型,而是一个判断——当生成能力持续贬值,定义生成物用途的能力永远稀缺。 从生成到进入,不是技术的更迭,而是价值锚点的迁移:
生成是商品,进入是溢价。
创作不易,禁止抄袭,转载请附上原文标题及其链接。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 6
 0
- 0


 已为社区贡献21条内容

所有评论(0)