【大模型强化学习后训练】强化学习后训练算力应投向何处?模型规模、搜索、学习与反馈
Where Should RL Post-Training Compute Go Model Size, Search, Learning, and Feedback
强化学习后训练算力应投向何处?模型规模、搜索、学习与反馈
摘要
摘要:强化学习(RL)后训练越来越多地被用于使基础模型适应推理、规划以及反馈驱动的机器人学习流水线,但受限的后训练资源往往由单一总 FLOP 预算来概括。我们研究这一实践背后的固定预算决策问题:在相同后训练预算下,应该使用更大的策略、将更小的策略训练更久、生成更多 rollout 搜索,还是将计算用于更强的奖励反馈?我们为 GRPO 后训练引入一个 FLOP 核算框架,将计算分解为 rollout/搜索、策略更新/学习以及奖励或反馈模型评估。在 LoRA 适配的 Qwen2.5 策略上,我们发现条件分配前沿:观测到的最佳分配随模型规模、计算预算、奖励系统和评估目标而变化。相同 FLOP 下的模型规模比较表明,模型选择与训练分配相互耦合,因为更大的策略消耗更多每 token 计算,从而在相同预算下换取的更新或 rollout 更少。奖励系统也会改变核算:基于规则的奖励将几乎所有非更新计算用于策略 rollout,而 PRM 风格的反馈则将预算中明显的一部分分配给奖励模型推理。我们将 RACE 作为一种诊断性试点网格协议提出,而非对留出集改进的保证,用于在昂贵的验证运行之前识别分配模式;我们的结果表明,RL 后训练论文应报告总 FLOPs 以及计算如何在模型规模、搜索、学习和反馈之间分配。关键词:强化学习、计算分配、基础模型
1.引言
机器人学习系统越来越多地使用基础模型进行语言条件规划、反馈生成、奖励建模、高层推理以及视觉-语言-动作策略 [1, 2, 3, 4, 5, 6, 7]。改进这些组件通常需要强化学习(RL)后训练,但当前的扩展分析通常以总 FLOPs 概括其成本。我们研究机器人学习系统中推理与反馈模块的 RL 后训练背后的计算分配问题。该问题提出一个核心的系统问题:在固定的后训练预算下,计算应花费在更大的策略、训练更久的小策略、更多 rollout 搜索、更多策略更新,还是更昂贵的奖励反馈上? 该问题不同于预训练扩展。预训练主要在参数与数据之间分配计算 [8, 9];RL 后训练还会生成轨迹、对其评分并更新策略。因此,两次具有相同总计算量的运行可能表现不同:如果一次将计算用于多样化的 rollout,而另一次将计算用于从更少轨迹中反复更新。同时,更大的策略消耗更多每 token 计算,因此相同的 FLOP 预算只能换取更少的 rollout 和更少的更新步数。当反馈来自 arXiv:2607.13389v1 [cs.LG] 15 Jul 2026 学习得到的验证器或过程奖励模型时,该问题会变得更加突出,因为其推理成本与策略 rollout 和更新计算相竞争。 这使得总计算报告界定不足。仅被描述为花费 XXX 后训练 FLOPs 的一次运行,留下三个机制上不同的问题未回答:XXX 中有多少生成了 rollout,有多少更新了策略,以及有多少评估了奖励或反馈模型?这些量并非记账细节。不同的奖励系统在总计算下可能看起来相当,却使用不同的机制;例如,基于 PRM 的训练将一部分预算花在一个额外模型上。如果忽略该成本,表观策略更新分配可能具有误导性。 我们研究在数学推理任务上对 LoRA 适配的语言模型策略进行 GRPO 后训练中的这一固定预算分配问题。这些并非具身控制实验;相反,它们隔离出一个计算分配问题,该问题针对机器人学习流水线中日益使用的基础模型组件。随着机器人学习系统越来越多地使用基础模型进行规划、反馈和奖励建模,RL 后训练计算不仅必须在 rollout 与更新之间分配,还必须在学习得到的反馈机制之间分配。受控设置使我们能够在显式 FLOP 核算下比较奖励系统、模型规模和下游评估目标。 这一定位对机器人学习很重要,因为改进推理或反馈模块的成本往往在部署前支付,而所得模块可能跨任务、具身实体或评估循环复用。计算受限的机器人学习设置常常需要决定是使用更大的模型、训练更久的小模型、更多 rollout 搜索,还是更强的反馈模型。将大部分计算花在奖励模型推理上的后训练配方,在一个目标下可能更可取,而在另一个目标下则可能造成浪费;同样,最大化原生训练奖励的配方未必能最大化最终答案迁移。因此,我们将分配本身视为研究对象,而不是将 RL 后训练计算视为一个无差别的标量。 我们的论点是,固定预算 RL 后训练是一个约束资源分配问题,涉及模型规模、rollout/搜索、策略更新以及奖励/反馈评估。由此产生的条件分配前沿取决于模型规模、计算预算、奖励系统和评估目标。
我们恰好做出四项贡献:
• 我们为固定预算 RL 后训练定义跨模型规模、rollout/搜索、策略更新/学习以及奖励评估计算的 FLOP 核算。
• 我们提供相同 FLOP 的模型规模比较,表明模型选择与训练分配相互耦合。
• 我们展示奖励与评估目标依赖性:原生奖励、pass@1 符号准确率和通用评判器过程分数可能选出不同的最佳观测分配。
• 我们引入 RACE,一种诊断性试点网格协议,用于在昂贵的验证运行之前识别分配模式。 实证信息有意并不在于表明某一配方以很大的下游优势击败所有基线。相反,我们表明“计算应该投向何处?”的答案取决于所衡量的对象。模型规模改变分配行为,奖励设计改变原生奖励分配,而评估目标可能对所选前沿产生分歧。
2.相关工作
缩放定律确立了模型质量可预测地取决于模型规模、数据和计算量,并且计算高效的训练需要平衡各缩放轴,而不是最大化其中某一轴 [8, 9]。近期的 RL 后训练缩放工作将这一视角扩展到偏好优化和数学推理,表明 RL 性能可随着额外计算量的增加而系统性地提升 [10, 11]。我们的关注点是正交的:我们不改变 RL 总计算量,而是将计算量大致固定,并研究应将其用于何处。诸如思维链提示、自洽性和树搜索等测试时推理方法表明,额外的推理计算量可以提高推理质量 [12, 13, 14]。相关机器人学工作将语言模型用作规划器、程序生成器和具身推理模块 [15, 16, 2]。RL 后训练将这一搜索过程与策略学习耦合起来:采样得到的 rollout 探索候选推理轨迹,梯度更新将反馈转化为参数变化。这使得 rollout 数量、rollout 长度、更新步数和可训练参数数量成为同一个分配问题的一部分。奖励质量也是一个缩放轴。稀疏结果奖励成本低但较弱;稠密的基于规则的奖励提供更频繁的信号;过程奖励模型和学习型验证器可以对中间推理进行评分,但会增加推理成本 [17, 18, 19, 20]。当学习型评论器、奖励模型或评估器被用于监督基础模型组件时,机器人学习流水线面临同样的权衡。我们明确考虑了这一奖励评估计算量,并检验奖励系统是否会移动观测到的最佳分配前沿。
3.方法:条件计算分配
我们将一次后训练运行建模为三个计算项之和:
Ctotal=Csearch+Clearning+Creward.(1)C_{\text{total}} = C_{\text{search}} + C_{\text{learning}} + C_{\text{reward}}. \tag{1}Ctotal=Csearch+Clearning+Creward.(1)
这里 CsearchC_{\text{search}}Csearch 是自回归 rollout 生成,ClearningC_{\text{learning}}Clearning 是策略优化,CrewardC_{\text{reward}}Creward 是奖励或验证器推理。我们使用参数–token FLOP 核算来估计这些项,并记录每次运行实际实现的 token 计数。对于 LoRA 训练,更新计算使用有效更新比例,该比例同时计入可训练适配器参数与冻结骨干的前向/激活成本;详见附录 B。
该分解刻意采用操作化定义。rollout FLOPs 随采样完成的数量和长度增加;学习 FLOPs 随更新步数、可训练秩和有效反向成本增加;奖励 FLOPs 对于基于规则的奖励可忽略不计,但对于基于 PRM 的反馈则相当可观。如果两次运行将这些 FLOPs 分配到不同通道,那么即使总 FLOPs 相当,也会产生有意义的差异。
这种核算还揭示了比较在机制上不公平的情形。基于规则奖励的运行几乎将所有非更新计算用于策略 rollout,而基于学习反馈的运行可能将相当一部分用于奖励模型推理。两者可以具有相同的 CtotalC_{\text{total}}Ctotal,但一个预算买到的是探索,另一个买到的是反馈。我们的目标是使这种权衡可见。我们的主要分配变量是总预算更新比例
ρ=ClearningCsearch+Clearning+Creward.(2)\rho = \frac{C_{\text{learning}}}{C_{\text{search}} + C_{\text{learning}} + C_{\text{reward}}}. \tag{2}ρ=Csearch+Clearning+CrewardClearning.(2)
较小的 ρ\rhoρ 偏重搜索或奖励;较大的 ρ\rhoρ 偏重更新。我们通篇使用“最佳观测 ρ\rhoρ”,因为实验估计的是条件前沿,而非证明全局最优分配。
RACE 诊断。奖励感知计算分配(RACE)是一种诊断协议,用于在有限试点预算下测量该前沿。对于每个模型、奖励系统和计算区间,RACE 运行一个小型 IsoFLOP 试点网格,估计局部奖励–分配响应,并在最佳观测或拟合模式附近选择验证分配。如果拟合不稳定或受边界主导,RACE 回退到试点最佳模式选择。我们将 RACE 作为诊断工具进行评估:它应能恢复有用的分配模式,并识别汇总规则何时失效,但并不声称能保证留出集上的奖励提升。
这一区分很重要。RACE 不是在所有可能后训练配方上进行搜索的算法;它是一种测量协议,用于询问某个局部计算区间是偏重搜索、偏重更新,还是偏重奖励计算。其输出是一种可指导验证的模式假设,而非证明所选运行将优于所有替代方案。
4.实验
所有实验均在 Polaris-53K 数学推理上使用 GRPO,其策略为经 LoRA 适配的 Qwen2.5 指令微调策略。除非另有说明,我们固定采样补全数 K=2K = 2K=2 和最大补全长度 L=2048L = 2048L=2048,并改变更新步数、LoRA 秩、模型规模和奖励系统,以在近似 IsoFLOP 带内扫描 ρ\rhoρ。阶段。阶段 A 研究跨 1.5B、3B 和 7B 策略的模型感知搜索–学习分配。阶段 B 固定 3B 策略,并比较稀疏、结构化、稠密和代理 PRM 奖励。阶段 D 用真实过程奖励模型 Qwen2.5-Math-PRM-7B 替代代理监督。探索性验证器容量运行被视为次要诊断,不构成主要证据的一部分。奖励系统的选择旨在覆盖一个实用的反馈谱系。稀疏奖励仅对最终答案正确性评分;结构化奖励增加格式和答案形状约束;稠密奖励增加有界部分得分;代理 PRM 奖励使用廉价的代理信号近似过程监督;真实 PRM 奖励使用专用的 7B 过程奖励模型。这种排序提高了反馈丰富度,但也改变了奖励评估成本,因此奖励计算量必须进入分配分母。指标。我们报告原生训练奖励、用于跨奖励比较的最小–最大归一化奖励,以及共同最终答案准确率。对于下游验证,我们在 GSM8K 和 MATH-500 上评估保存的适配器,使用精确最终答案准确率、符号等价准确率、pass@1,以及在可用时的较小 pass@3 设置。我们使用下游指标来检验以奖励为条件的前沿是否能迁移到训练奖励之外。下游评估有意与原生奖励选择分离。原生奖励回答的是:奖励系统在其自身反馈信号下是否偏好某种特定分配。下游最终答案准确率则询问这种偏好是否能迁移到留出的推理基准。共同评判器提出第三个问题:共享的过程质量评估器是否偏好同一前沿。这些目标之间的不一致具有信息性,而非失败模式。
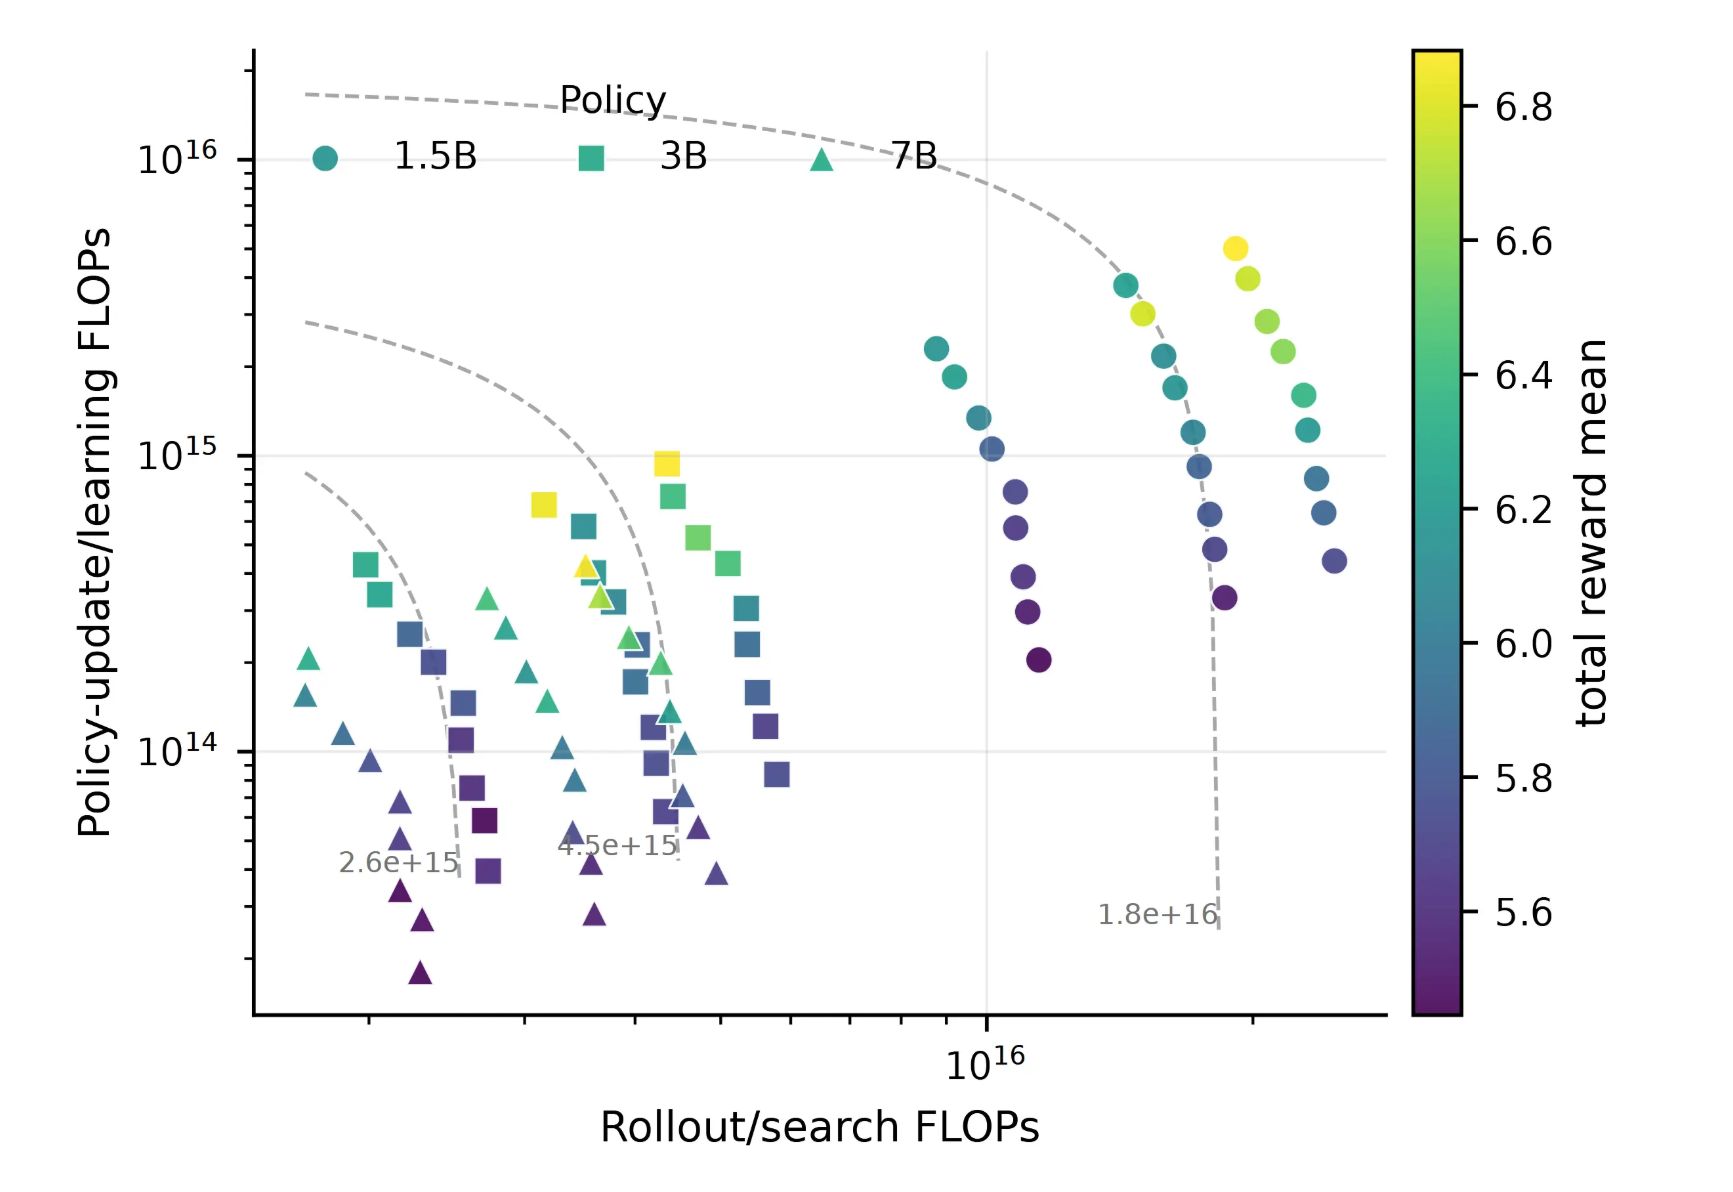
图 1:搜索–学习分配平面。在固定的 RL 后训练预算下,不同运行在用于 rollout 搜索、策略更新和奖励评估的计算量上有所不同。观察到的最佳分配是该条件资源分配平面上的一个点,而非仅仅是总计算量的函数。
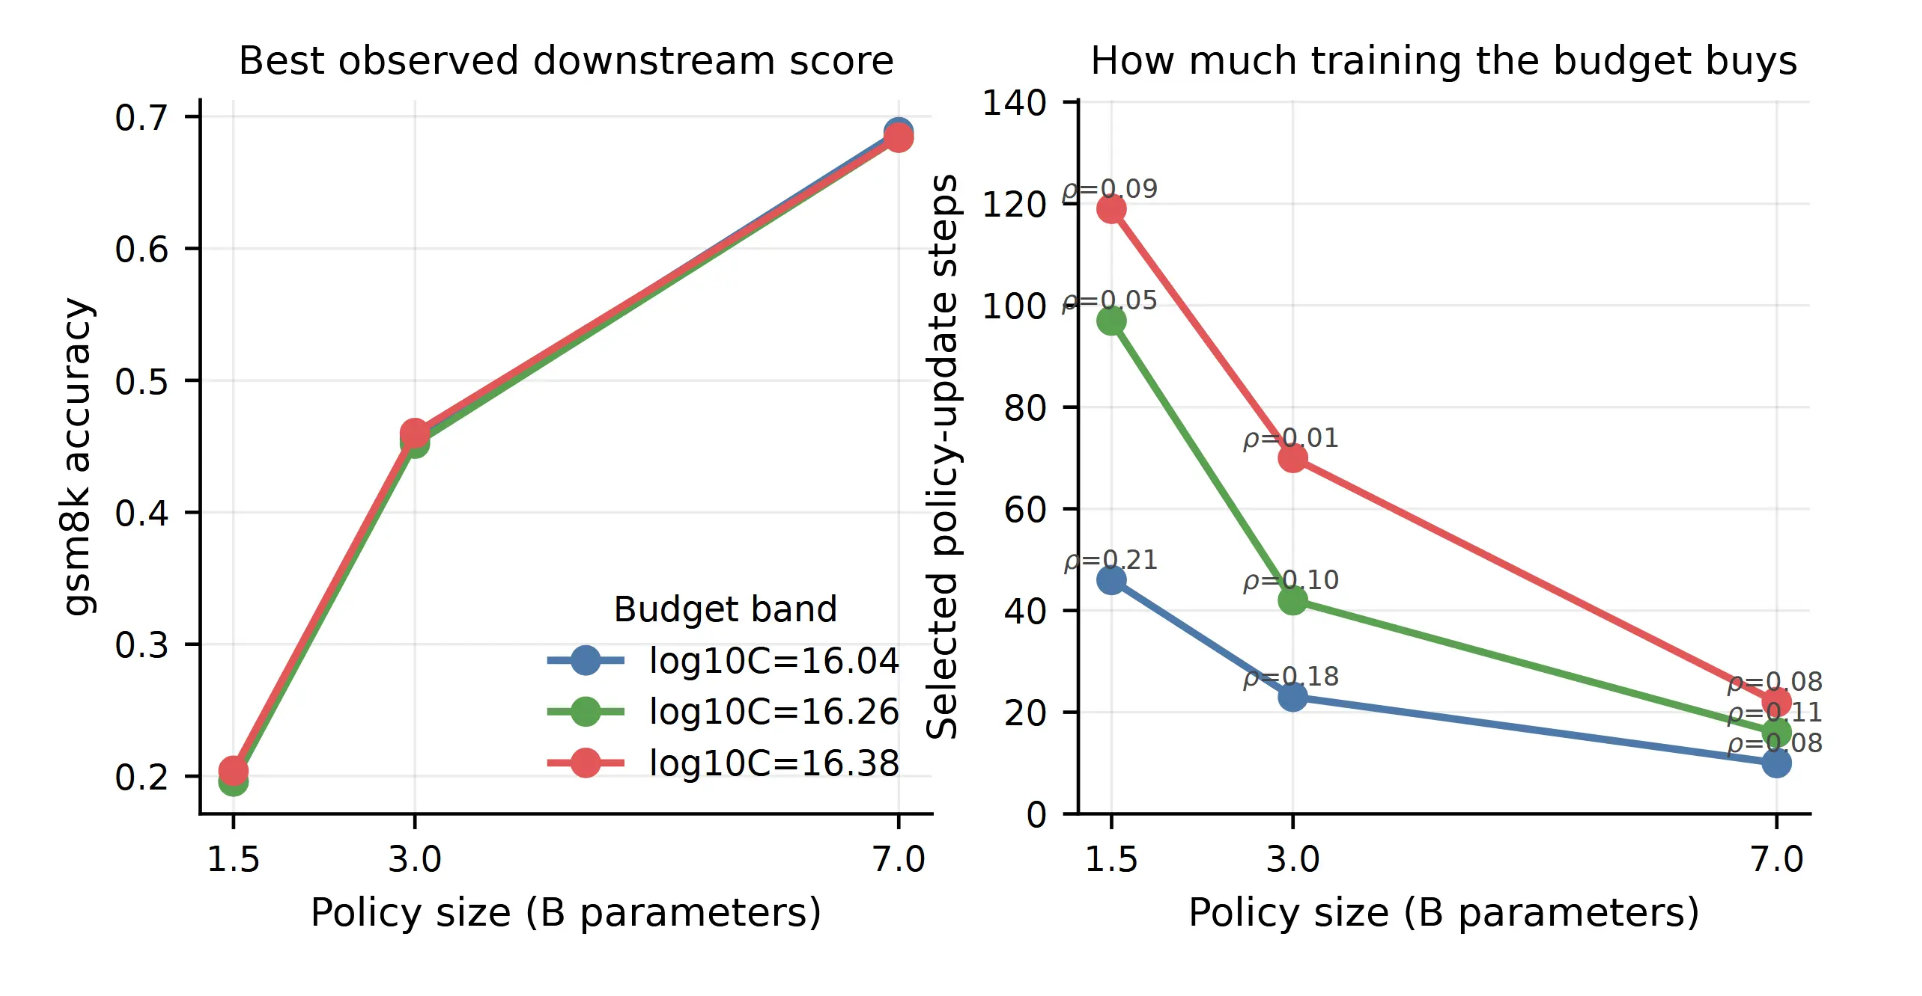
图 2:相同 FLOP 的模型规模权衡。在匹配的试点预算下,改变策略规模会改变预算所能购买的训练量。更大的策略每 token 消耗更多计算,因此相同的 FLOP 预算可能意味着更少的 rollout token 和更少的更新步数;故而观测到的最佳下游运行共同取决于模型规模和分配。
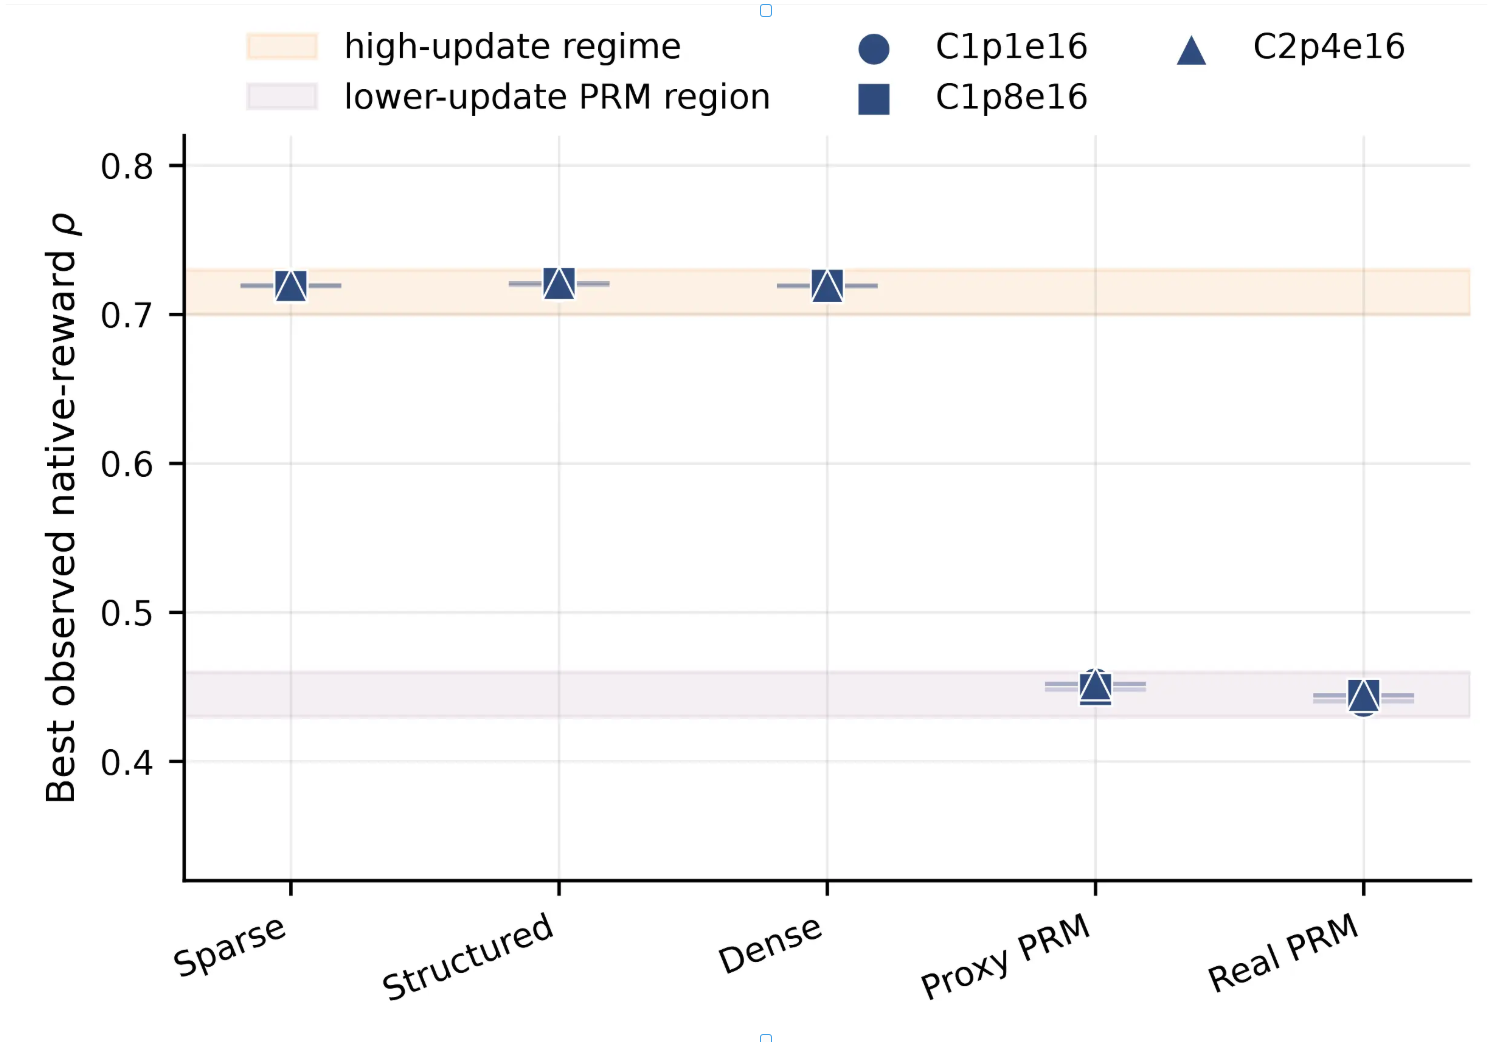
图3:反馈成本改变分配。对于匹配的 3B 设置中观察到的最佳原生奖励运行,基于规则的奖励将预算用于策略 rollout 与更新,而 PRM 风格的反馈则将可见的一部分分配给奖励模型评估。这正是仅报告总 FLOPs 所掩盖的机制。
表 1:匹配的 3B 设置下的下游目标依赖性。Pass@1 是在 GSM8K 和 MATH-500 上平均的符号等价准确率,每个数据集含 250 个样本。通用评判器是一个共享的过程质量分数,针对稠密奖励和 PRM 风格奖励进行评估。原生 ρ\rhoρ 报告了在匹配的 Stage B/D 网格中观察到的最佳原生奖励分配。
奖励 原生 ρ\rhoρ Pass@1 最佳 评判器 a40 评判器 a100 评判器 a180
稀疏 0.7190.7190.719 a180:0.7080.7080.708 – – –
结构化 0.7200.7200.720 a40/a180:0.6980.6980.698 – – –
密集 0.7190.7190.719 a180:0.7020.7020.702 0.7570.7570.757 0.7800.7800.780 0.7590.7590.759
代理 PRM 0.4480.4480.448–0.4520.4520.452 a180:0.7080.7080.708 0.7460.7460.746 0.7670.7670.767 0.7490.7490.749
真实 PRM 0.4400.4400.440–0.4440.4440.444 a180:0.7140.7140.714 0.7430.7430.743 0.7610.7610.761 0.7460.7460.746
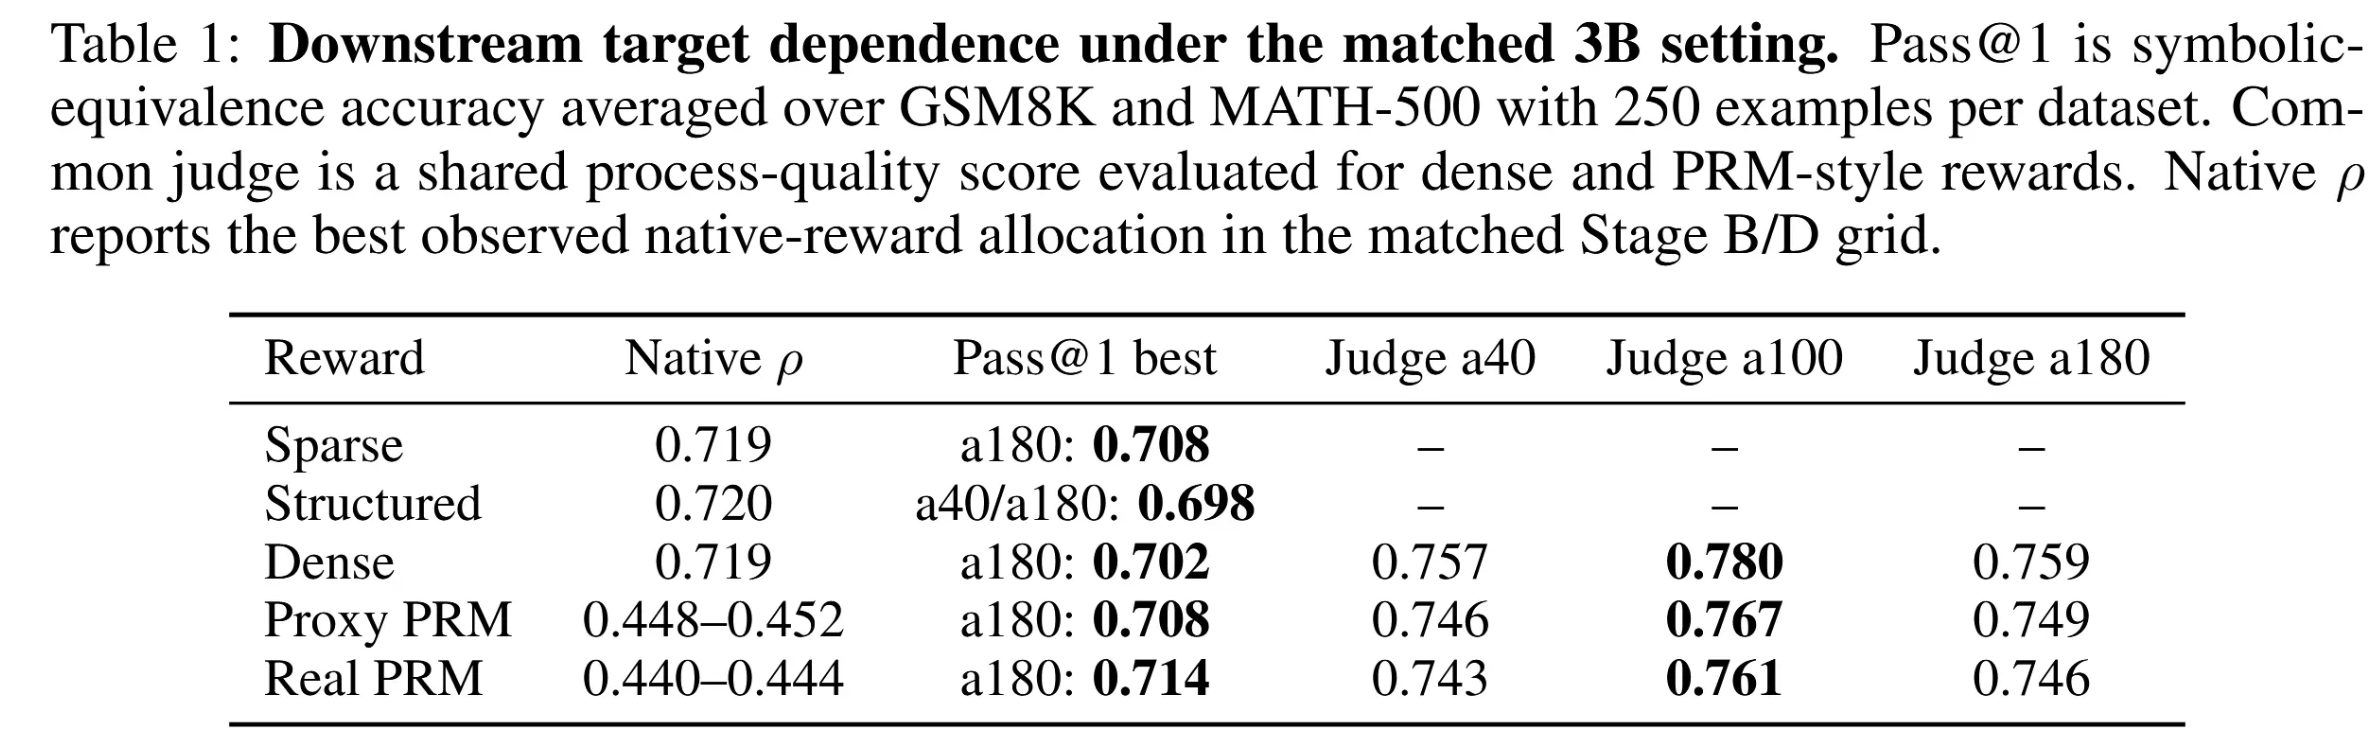
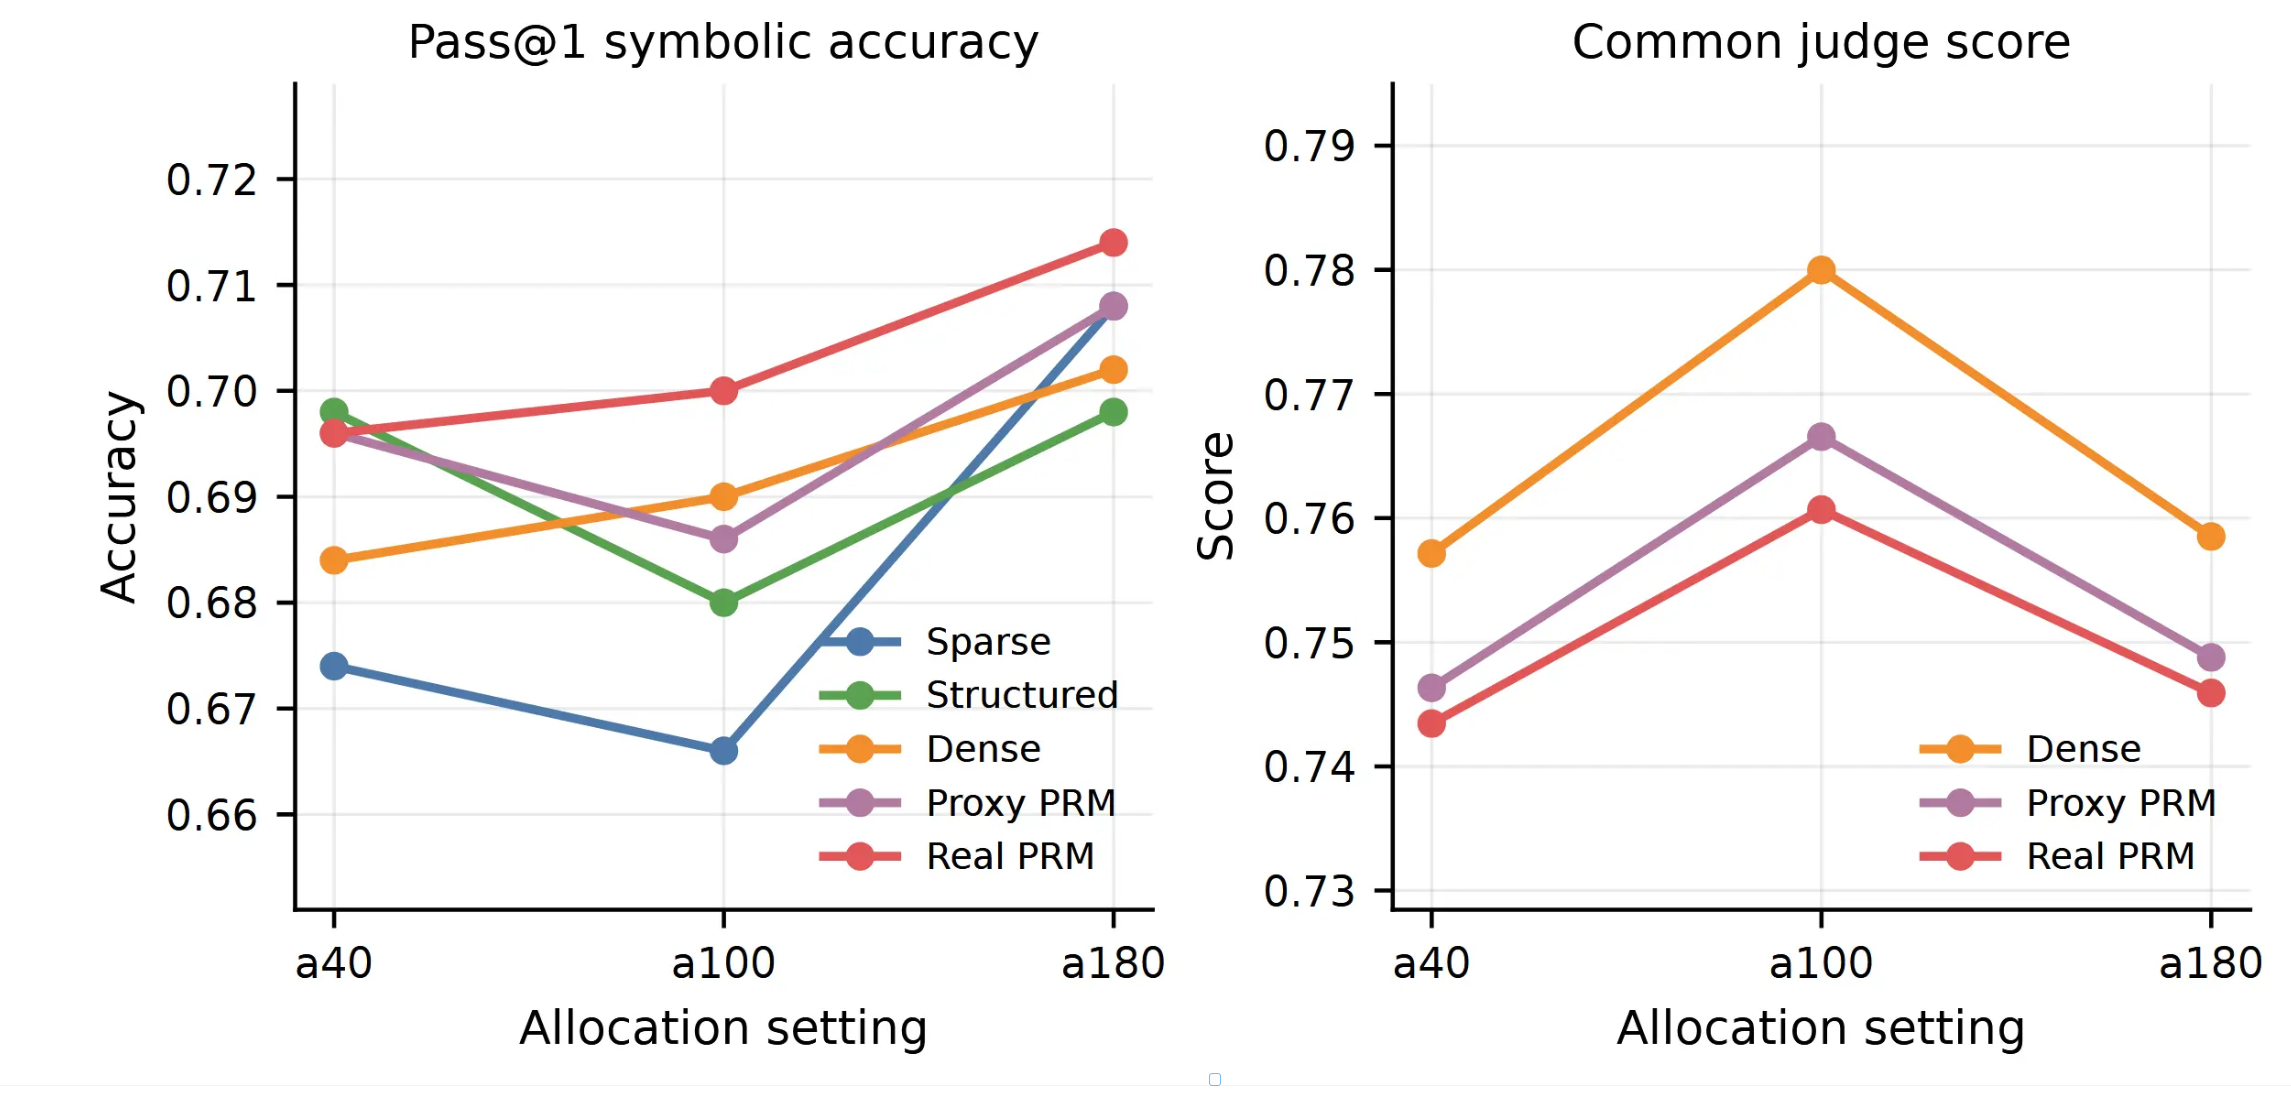
图 4:评估目标会改变分配。原生奖励、下游 pass@1\text{pass@1}pass@1 符号准确率以及常见的过程质量评分可能选择不同的分配机制。因此,计算资源应投向何处这一问题的答案取决于所测量的目标。
5.结论
RQ1:固定预算的 RL 后训练是否具有结构化分配行为?阶段 A 显示了在匹配的后训练预算下的结构化分配平面。搜索密集型设置会未充分利用可用学习容量,而更新密集型设置可能受限于探索。由此得到的前沿只有在展开、更新与奖励评估 FLOPs 被分开而非合并为一个总预算时才可见。图1直观地展示了这一点:具有可比总 FLOPs 的运行在搜索–学习平面中占据不同位置,且其奖励随该位置而变化。重要的观察结果不是单一最佳点,而是存在一个可测量的响应曲面。这是缩放曲线的分配类比:自变量不是更多计算量,而是固定预算如何划分。
RQ2:分配前沿是否以模型和奖励为条件?跨模型规模的汇总会掩盖分配响应:在相同 FLOPs 预算下,更大的策略每 token 消耗更多计算量,因此该预算能换取的展开次数和更新步数更少。图2明确呈现了这一固定资源权衡:模型选择与训练分配是耦合的,而不是可分离的决策。奖励设计也会移动前沿。在阶段 B/D 中,稀疏、结构化和稠密的基于规则的奖励往往选择约 ρ≈0.72\rho \approx 0.72ρ≈0.72 的高更新机制,而一旦计入奖励模型计算量,在匹配的 3B 设置中,代理 PRM 与真实 PRM 目标会将原生奖励前沿移向约 ρ≈0.44\rho \approx 0.44ρ≈0.44–0.450.450.45 的更低更新比例。我们并不将此解释为 PRM 的固定规则;PRM 前沿本身依赖于模型规模和目标。
这一结果是避免采用合并式分配方案的主要经验性理由。一个训练时间更长的小型策略、一个训练步数更少的大型策略、一个低成本的基于规则的奖励,以及一个高成本的学习型反馈模型,都可能消耗相同的总预算,同时需要在搜索与学习之间进行不同的权衡。在这个意义上,模型规模和奖励设计都是扩展问题的一部分:它们既改变了被优化的信号,也改变了用于获取该信号的计算路径。PRM 的结果应通过这一核算视角来解读。较低的原生奖励更新比例并不能证明 PRM 本质上需要更少的学习。它反映的是,学习型反馈消耗了固定预算的一部分,因此相同的总计算量数值对应于推演、更新和奖励评估工作的不同混合比例。
RQ3:下游评估目标是否会选择不同的分配方案?我们使用每个数据集 250 个样例,在 GSM8K 和 MATH-500 上评估保存的适配器。下游 pass@1 符号准确率通常倾向于高更新量的 a180 设置;real-PRM a180 运行具有所列最佳的平均 pass@1 准确率,在 GSM8K 和 MATH-500 上约为 0.7140.7140.714。相比之下,部分共同评判器评估通常倾向于中等更新量的 a100 设置。因此,优选的分配方案取决于评估目标:原生奖励、下游最终答案准确率和过程质量分数可能选择不同的前沿。表 1 明确了这种目标依赖性。原生奖励将基于规则的反馈和 PRM 风格的反馈划分为不同的分配模式。然而,pass@1 准确率在各类奖励系统中通常倾向于高更新量的 a180 设置。而在可用的地方,共同评判器则在稠密、代理 PRM 和真实 PRM 上均以 a100 达到峰值。这并不使某一指标比其他指标更有效;它表明分配决策必须指明其意图优化的目标。
RQ4:RACE 能否从小型试点网格中诊断分配机制?RACE 在网格内验证和留排名验证中恢复了正确的高更新与较低更新机制,在两种设置下同机制率均为 1.01.01.0。然而,奖励遗憾非零,且真实留出验证并未改进全局原生奖励基线。因此,我们将 RACE 呈现为一种用于选择分配机制并确定验证运行优先级的诊断协议,而不是一种保证留出改进的方法。这种混合的留出表现对论文的主张是有用的。它表明,小型试点网格可以识别某个设置属于高更新机制还是较低更新机制,但局部曲线拟合不足以证成某个配方在全局上更优。对于实际的 RL 后训练而言,这意味着应使用 RACE 来减少昂贵的验证运行次数并揭示条件结构,而最终主张仍应基于留出下游评估。
6 结论
固定预算下的 RL 后训练不能仅由总计算量来刻画。在不同模型规模和奖励系统中,我们观察到条件分配前沿:所观测到的最佳更新/搜索/奖励计算平衡取决于模型规模、奖励设计和评估目标。这表明,面向基础模型的实际后训练配方——包括机器人学习流水线中使用的组件——应报告并调节计算分配,而不是仅报告聚合 FLOPs。 在实践中,该框架有助于决定有限的后训练计算应花费在更大的策略、对较小策略进行更多更新、更多 rollout 搜索,还是更昂贵的反馈上。这是 RL 后训练流水线所面临的资源分配问题:相同的 FLOP 预算可以换取模型容量、采样经验、梯度更新和奖励模型推理的不同组合。 对于将基础模型用作规划器、反馈解释器、奖励模型或评估器的机器人学习系统而言,这具有一个具体含义:通过 RL 后训练改进某个模块本身就是一个资源分配问题。报告总后训练预算而不分解其 rollout、更新和反馈,可能掩盖某个配方为何在不同评估目标下迁移、失败或改变行为。因此,我们建议报告分配感知计算:总 FLOPs 连同 rollout FLOPs、更新 FLOPs、奖励评估 FLOPs,以及由此得到的更新比例 ρ\rhoρ。
7 局限性
我们的实验使用数学推理作为基础模型后训练的受控代理,而不是直接的具身机器人任务。因此,结果应被解释为关于机器人学习流水线中所使用的推理和反馈组件的 RL 后训练的证据,而不是关于具身策略学习的断言。我们使用一个模型系列、GRPO、LoRA 适配以及有限的随机种子。FLOP 估计旨在用于一致的相对比较,并未建模所有硬件效应。RACE 是一种机制选择诊断:它识别有用的分配区域,但不保证留出运行中的奖励改进。探索性的评判计算实验不属于主要证据。我们并不声称存在固定的最优 ρ\rhoρ,也不声称存在跨任务、模型和反馈系统的通用后训练规律。
A 实验细节
A.1 实验阶段概述
我们将实验组织为三个主要实证阶段。阶段 A 在 IsoFLOP 设计下研究核心搜索—学习分配前沿。阶段 B 将相同的计算分配协议扩展到奖励系统的比较。阶段 D 用专用的过程奖励模型(PRM)替代代理奖励监督。
阶段 A 使用原始 IsoFLOP 模型缩放设计。它涵盖多个模型规模、计算区间和 LoRA 秩。阶段 B 固定策略骨干,并在匹配计算下改变奖励系统。阶段 D 使用相同的固定策略骨干,但用基于专用 PRM 的奖励模型替代代理奖励。
A.2 阶段 A:模型感知的 IsoFLOP 设计
阶段 A 使用经过指令微调的 Qwen2.5 模型,规模为 N∈{1.5B,3B,7B}N \in \{1.5\mathrm{B}, 3\mathrm{B}, 7\mathrm{B}\}N∈{1.5B,3B,7B}。
对于所有阶段 A 运行,我们使用每个提示 K=2K = 2K=2 个采样补全,最大补全长度为 L=2048L = 2048L=2048。初始 LoRA 秩为
r∈{8,16,32,64,128},r \in \{8, 16, 32, 64, 128\},r∈{8,16,32,64,128},
并加入额外的中间秩
r∈{12,24,48,96}r \in \{12, 24, 48, 96\}r∈{12,24,48,96}
以加密 IsoFLOP 前沿。三个计算区间记为
C1p1e16\mathrm{C1p1e16}C1p1e16、C1p8e16\mathrm{C1p8e16}C1p8e16、C2p4e16\mathrm{C2p4e16}C2p4e16。
对于 1.5B1.5\mathrm{B}1.5B 参考模型,基础步数调度为:
C1p1e16:r8=65,r16=62,r32=59,r64=53,r128=46\mathrm{C1p1e16}: r_8 = 65, r_{16} = 62, r_{32} = 59, r_{64} = 53, r_{128} = 46C1p1e16:r8=65,r16=62,r32=59,r64=53,r128=46,
C1p8e16:r8=105,r16=100,r32=95,r64=85,r128=74\mathrm{C1p8e16}: r_8 = 105, r_{16} = 100, r_{32} = 95, r_{64} = 85, r_{128} = 74C1p8e16:r8=105,r16=100,r32=95,r64=85,r128=74,
C2p4e16:r8=140,r16=133,r32=127,r64=113,r128=99\mathrm{C2p4e16}: r_8 = 140, r_{16} = 133, r_{32} = 127, r_{64} = 113, r_{128} = 99C2p4e16:r8=140,r16=133,r32=127,r64=113,r128=99。
中间秩通过对数秩插值获得。对于其他模型规模,我们按如下方式缩放更新步数:
S(N)=round(S1.5B⋅1.5NB),S(N) = \mathrm{round}\left(S_{1.5\mathrm{B}} \cdot \frac{1.5}{N_{\mathrm{B}}}\right),S(N)=round(S1.5B⋅NB1.5),
其中 NBN_{\mathrm{B}}NB 是以十亿参数为单位的模型规模。
A.3 阶段 B:奖励条件化 DOE
阶段 B 研究奖励系统如何改变分配前沿。我们将策略骨干固定为
Qwen/Qwen2.5-3B-Instruct
并使用 K=2K = 2K=2、L=2048L = 2048L=2048,以及与阶段 A 相同的三个计算区间。完整的阶段 B 设计使用
r∈{8,12,16,24,32,48,64,96,128}r \in \{8, 12, 16, 24, 32, 48, 64, 96, 128\}r∈{8,12,16,24,32,48,64,96,128}
并比较四种奖励系统:
R∈{sparse,structured,dense,proxy PRM}.R \in \{\text{sparse}, \text{structured}, \text{dense}, \text{proxy PRM}\}.R∈{sparse,structured,dense,proxy PRM}.
因此,完整的阶段 B 设计包含
333 个计算区间 ×\times× 999 个秩 ×\times× 444 个奖励系统 =108= 108=108 次运行。
稀疏奖励使用二元最终答案正确性。结构化奖励将最终答案正确性与格式和答案形状项相结合。稠密奖励根据数值接近度和格式合规性提供有界部分得分。代理 PRM 奖励将结果监督与过程式奖励信号相结合。
A.4 阶段 D:真实 PRM 验证
阶段 D 评估专用过程奖励建模。我们再次将策略骨干固定为
Qwen/Qwen2.5-3B-Instruct,
使用 K=2K = 2K=2、L=2048L = 2048L=2048,以及与阶段 B 相同的三个计算区间和 LoRA 秩。奖励系统是基于
Qwen/Qwen2.5-Math-PRM-7B
的真实过程奖励模型。
完整的阶段 D 设计包含
333 个计算区间 ×\times× 999 个秩 =27= 27=27 次运行。
我们将该实验称为真实 PRM 验证,而非验证器容量缩放,因为 PRM 模型规模是固定的。
B 计算核算
我们将总后训练计算分解为 rollout/搜索计算、策略更新计算和奖励模型计算:
Ftotal=Frollout+Fupdate+Freward.F_{\text{total}} = F_{\text{rollout}} + F_{\text{update}} + F_{\text{reward}}.Ftotal=Frollout+Fupdate+Freward.
Rollout 计算估计为
Frollout=cfwd(N+R)Trollout,F_{\text{rollout}} = c_{\text{fwd}}(N + R)T_{\text{rollout}},Frollout=cfwd(N+R)Trollout,
其中 NNN 是策略骨干参数数量,RRR 是使用学习到的奖励模型时的奖励模型参数数量,TrolloutT_{\text{rollout}}Trollout 是 rollout token 数量。
更新计算估计为
Fupdate=cbwd(Nfeff)Tupdate,F_{\text{update}} = c_{\text{bwd}}(N f_{\text{eff}})T_{\text{update}},Fupdate=cbwd(Nfeff)Tupdate,
其中 TupdateT_{\text{update}}Tupdate 是用于学习的 token 数量。对于基于 LoRA 的训练,我们定义
fLoRA=NLoRANf_{\text{LoRA}} = \frac{N_{\text{LoRA}}}{N}fLoRA=NNLoRA
并使用有效更新比例 feff=a+(1−a)fLoRAf_{\mathrm{eff}} = a + (1 - a) f_{\mathrm{LoRA}}feff=a+(1−a)fLoRA。常数 aaa 考虑了依赖于冻结主干的更新侧成本,包括前向传播、激活以及共享计算。除非另有说明,我们使用 a=0.85a = 0.85a=0.85。我们使用更新比例 ρ=FupdateFtotal\rho = \frac{F_{\mathrm{update}}}{F_{\mathrm{total}}}ρ=FtotalFupdate 来概括计算分配。较小的 ρ\rhoρ 对应于搜索密集型或奖励密集型机制,而较大的 ρ\rhoρ 对应于更新密集型机制。
C 指标与奖励可比性
不同奖励系统使用不同的原生奖励尺度。因此,原始奖励值在稀疏、结构化、稠密、代理 PRM 和真实 PRM 条件下不可直接比较。我们报告三个互补的指标。第一,我们报告原生奖励 RnativeR_{\text{native}}Rnative,即由训练运行优化的标量奖励。第二,对于跨奖励比较,我们在每个奖励系统内计算归一化奖励并计算区间:Rnorm=R−minR,CRmaxR,CR−minR,CR.R_{\text{norm}} = \frac{R - \min_{R,C} R}{\max_{R,C} R - \min_{R,C} R}.Rnorm=maxR,CR−minR,CRR−minR,CR. 这在避免直接比较不兼容的原生奖励尺度的同时,保留了奖励内排序。第三,我们在可用时报告一个共同准确率指标。在我们的分析代码中,这存储为 accuracy main。当精确的留出验证准确率不可用时,该量应被解释为共同的正确性代理,而非校准后的基准分数。
D 奖励定义
稀疏奖励是二值的:rsparse=1[y^=y⋆],r_{\text{sparse}} = \mathbb{1}[\hat{y} = y^{\star}],rsparse=1[y^=y⋆], 其中 y^\hat{y}y^ 是提取出的模型答案,y⋆y^{\star}y⋆ 是经符号归一化后的目标答案。 结构化奖励将最终答案正确性与格式和答案形状约束相结合:rstructured=ranswer+λfmtrformat+λshapershape.r_{\text{structured}} = r_{\text{answer}} + \lambda_{\text{fmt}} r_{\text{format}} + \lambda_{\text{shape}} r_{\text{shape}}.rstructured=ranswer+λfmtrformat+λshapershape. 稠密奖励提供有界部分得分:rdense∈[−1,1],r_{\text{dense}} \in [-1, 1],rdense∈[−1,1], 结合符号正确性、数值接近度和输出格式约束。代理 PRM 奖励将过程式监督与结果正确性相结合:rproxy PRM=αrproc+(1−α)rout,r_{\text{proxy PRM}} = \alpha r_{\text{proc}} + (1 - \alpha) r_{\text{out}},rproxy PRM=αrproc+(1−α)rout, 其中 rprocr_{\text{proc}}rproc 是中间过程分数,routr_{\text{out}}rout 是最终答案正确性。 真实 PRM 奖励使用专门的过程奖励模型对中间推理步骤进行评分。在阶段 D 中,该模型是 Qwen/Qwen2.5-Math-PRM-7B。
E RACE:奖励感知计算分配
RACE 是一种诊断协议,用于从初始 IsoFLOP 试点网格中选择有针对性的后训练验证运行。给定固定的模型规模 NNN、奖励系统 RRR 和计算带 CCC,RACE 在更新比例 ρ\rhoρ 上拟合局部响应模型 R^N,R,C(ρ)\hat{R}_{N,R,C}(\rho)R^N,R,C(ρ)。默认响应模型是关于对数更新比例的二次函数:R^(ρ)=a(logρ)2+blogρ+c\hat{R}(\rho) = a(\log \rho)^2 + b \log \rho + cR^(ρ)=a(logρ)2+blogρ+c。RACE 仅将此拟合用作决策规则。如果拟合的最佳响应点稳定并位于观测范围内,RACE 建议在预测点附近进行验证运行。如果最佳响应点接近边界,RACE 建议在相应边界之外进行留出运行。如果拟合不稳定,RACE 退回到最佳观测试点运行附近的保守验证。重要的是,RACE 是条件性应用的。我们不会跨所有模型规模和奖励系统拟合一条合并曲线。相反,响应以模型规模、计算带和奖励系统为条件。我们将此条件性状态估计示意性地写为 ρ^RACE=ρ^RACE(N,C,R)\hat{\rho}_{\mathrm{RACE}} = \hat{\rho}_{\mathrm{RACE}}(N, C, R)ρ^RACE=ρ^RACE(N,C,R)。
F RACE 验证协议
阶段 A 的 RACE 验证使用计算带 C1p8e16C_{1p8e16}C1p8e16。初始网格包含秩 r∈{8,12,16,24,32,48,64,96,128}r \in \{8, 12, 16, 24, 32, 48, 64, 96, 128\}r∈{8,12,16,24,32,48,64,96,128}。留出验证使用秩 r∈{160,192,256}r \in \{160, 192, 256\}r∈{160,192,256}。验证网格包含模型规模 1.5B、3B 和 7B,所有均具有 K=2K = 2K=2 和 L=2048L = 2048L=2048。验证将最佳留出配置与同一计算带中的最佳网格内配置进行比较。在当前阶段 A 验证中,最佳留出配置改善了一些以模型为条件的子组,并提高了最佳 7B 验证运行的准确率,但它并未在主要原生奖励上超过最佳全局网格内基线。因此,我们将 RACE 报告为一种保守的诊断协议,而不是一种保证留出验证改进的方法。
G RACE 拟合模型消融
RACE 使用关于 logρ\log \rhologρ 的二次响应模型作为透明的决策模型,用于选择留出验证配置。为检验这一选择在阶段 A 试点网格上是否在统计上优选,我们消融若干低容量响应族:常数均值基线,关于 ρ\rhoρ 的线性与二次模型,关于 logρ\log \rhologρ 的线性与二次模型,以及关于 logρ\log \rhologρ 的三次模型。模型在每个计算带内独立拟合,并使用留一交叉验证 RMSE、平均绝对误差和 BIC 进行比较。在当前阶段 A 数据上,常数基线获得最低的平均 LOOCV RMSE,而线性 logρ\log \rhologρ 模型是最佳的非平凡、依赖分配的模型。这表明合并的阶段 A 响应存在噪声,并部分受到模型规模和秩变异的混杂影响。因此,我们不将二次 logρ\log \rhologρ 拟合解释为统计上优选的响应模型。相反,我们将其用作透明的边界诊断:它识别试点网格暗示的是内部最佳响应区域、边界最佳响应区域,还是不稳定拟合。当拟合不稳定或由边界主导时,RACE 退回到保守的留出验证,而不是信任外推点。这种保守行为是该方法的核心。
H RACE 实现细节
初始 Stage A 网格使用 LoRA 秩 r∈{8,12,16,24,32,48,64,96,128}r \in \{8, 12, 16, 24, 32, 48, 64, 96, 128\}r∈{8,12,16,24,32,48,64,96,128}。留出的 RACE 验证运行使用秩 r∈{160,192,256}r \in \{160, 192, 256\}r∈{160,192,256},这些秩被排除在试点拟合之外。初始计算区间为 C1p1e16、C1p8e16 和 C2p4e16。对于 1.5B 参考模型,基础步数调度为:C1p1e16:r8=65r_8 = 65r8=65,r16=62r_{16} = 62r16=62,r32=59r_{32} = 59r32=59,r64=53r_{64} = 53r64=53,r128=46r_{128} = 46r128=46,C1p8e16:r8=105r_8 = 105r8=105,r16=100r_{16} = 100r16=100,r32=95r_{32} = 95r32=95,r64=85r_{64} = 85r64=85,r128=74r_{128} = 74r128=74,C2p4e16:r8=140r_8 = 140r8=140,r16=133r_{16} = 133r16=133,r32=127r_{32} = 127r32=127,r64=113r_{64} = 113r64=113,r128=99r_{128} = 99r128=99。对于其他模型规模,步数按 S(N)=round(S1.5B⋅1.5/NB)S(N) = \mathrm{round}(S_{1.5\mathrm{B}} \cdot 1.5/N_B)S(N)=round(S1.5B⋅1.5/NB) 缩放,其中 NBN_BNB 是模型规模,以十亿参数计。验证秩通过对相同调度进行对数秩插值或外推来选择。如果运行的秩至少为 160160160,或其路径包含以下验证关键词之一:reuse、prefill、validation、val、extra、target、heldout 或 race,则将该运行标记为验证。
引用文献
[1] M. Ahn, A. Brohan, N. Brown, Y. Chebotar, O. Cortes, B. David, C. Finn, C. Fu, K. Gopalakrishnan, K. Hausman, et al. Do as i can, not as i say: Grounding language in robotic affordances. arXiv preprint arXiv:2204.01691, 2022.
[2] W. Huang, F. Xia, T. Xiao, H. Chan, J. Liang, P. Florence, A. Zeng, J. Tompson, I. Mordatch, Y. Chebotar, et al. Inner monologue: Embodied reasoning through planning with language models. In Proceedings of The 6th Conference on Robot Learning, pages 1769–1782, 2023.
[3] D. Driess, F. Xia, M. S. M. Sajjadi, C. Lynch, A. Chowdhery, B. Ichter, A. Wahid, J. Tompson, Q. Vuong, T. Yu, et al. Palm-e: An embodied multimodal language model. arXiv preprint arXiv:2303.03378, 2023.
[4] A. Brohan, N. Brown, J. Carbajal, Y. Chebotar, J. Dabis, C. Finn, K. Gopalakrishnan, K. Hausman, A. Herzog, J. Hsu, et al. Rt-1: Robotics transformer for real-world control at scale. arXiv preprint arXiv:2212.06817, 2022.
[5] A. Brohan, N. Brown, J. Carbajal, Y. Chebotar, X. Chen, K. Choromanski, T. Ding, D. Driess, A. Dubey, C. Finn, et al. Rt-2: Vision-language-action models transfer web knowledge to robotic control. In Proceedings of The 7th Conference on Robot Learning, 2023.
[6] Open X-Embodiment Collaboration. Open x-embodiment: Robotic learning datasets and rt-x models. In IEEE International Conference on Robotics and Automation, 2024.
[7] M. J. Kim, K. Pertsch, S. Karamcheti, T. Xiao, A. Balakrishna, S. Nair, R. Rafailov, E. Foster, G. Lam, P. Sanketi, et al. Openvla: An open-source vision-language-action model. arXiv preprint arXiv:2406.09246, 2024.
[8] J. Kaplan, S. McCandlish, T. Henighan, T. B. Brown, B. Chess, R. Child, S. Gray, A. Radford, J. Wu, and D. Amodei. Scaling laws for neural language models. arXiv preprint arXiv:2001.08361, 2020.
[9] J. Hoffmann, S. Borgeaud, A. Mensch, E. Buchatskaya, T. Cai, E. Rutherford, D. d. L. Casas, L. A. Hendricks, J. Welbl, A. Clark, et al. Training compute-optimal large language models. arXiv preprint arXiv:2203.15556, 2022.
[10] D. Khatri, L. Madaan, R. Tiwari, R. Bansal, S. S. Duvvuri, M. Zaheer, I. S. Dhillon, D. Brandfonbrener, and R. Agarwal. The art of scaling reinforcement learning compute for llms. arXiv preprint arXiv:2510.13786, 2025.
[11] Z. Tan et al. Scaling behaviors of llm reinforcement learning post-training: An empirical study in mathematical reasoning. arXiv preprint arXiv:2509.25300, 2025.
[12] J. Wei, X. Wang, D. Schuurmans, M. Bosma, B. Ichter, F. Xia, E. Chi, Q. V. Le, and D. Zhou. Chain-of-thought prompting elicits reasoning in large language models. In Advances in Neural Information Processing Systems, 2022.
[13] X. Wang, J. Wei, D. Schuurmans, Q. V. Le, E. H. Chi, and D. Zhou. Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations, 2023.
[14] S. Yao, D. Yu, J. Zhao, I. Shafran, T. L. Griffiths, Y. Cao, and K. Narasimhan. Tree of thoughts: Deliberate problem solving with large language models. arXiv preprint arXiv:2305.10601, 2023.
[15] W. Huang, P. Abbeel, D. Pathak, and I. Mordatch. Language models as zero-shot planners: Extracting actionable knowledge for embodied agents. In Proceedings of the 39th International Conference on Machine Learning, pages 9118–9147, 2022.
[16] J. Liang, W. Huang, F. Xia, P. Xu, K. Hausman, B. Ichter, P. Florence, and A. Zeng. Code as policies: Language model programs for embodied control. arXiv preprint arXiv:2209.07753, 2023.
[17] P. F. Christiano, J. Leike, T. B. Brown, M. Martic, S. Legg, and D. Amodei. Deep reinforcement learning from human preferences. In Advances in Neural Information Processing Systems, 2017.
[18] L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray, et al. Training language models to follow instructions with human feedback. In Advances in Neural Information Processing Systems, 2022.
[19] Y. Bai, A. Jones, K. Ndousse, A. Askell, A. Chen, N. DasSarma, D. Drain, S. Fort, D. Ganguli, T. Henighan, et al. Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862, 2022.
[20] A. Authors. Scaling laws for generative reward models. In OpenReview, 2025.

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献19条内容

所有评论(0)