感知型神经网络——深度学习中的传感信息处理方法
机器人与具身智能如何处理各类传感信息
一个需要在真实世界里行动的机器,怎么把各式各样的传感器信号,变成它的决策系统真正用得上的东西?在机器人和具身智能系统里,决策本身往往不是最脆弱的一环。路径规划、模型预测控制、强化学习策略、乃至用大语言模型做任务分解,这些方法都已经相当成熟。真正决定一个系统能不能在现实环境里稳定工作的,通常是它对世界的感知。
为什么感知是最难的那一环
1.1 决策想要什么,传感器给什么
设想一个非常普通的任务:让家用机器人把桌上的杯子放进水槽。
从决策的角度看,它需要知道的东西其实不多——杯子在哪、多大、是不是空的、桌子到水槽怎么走、路上有没有障碍、手抓住杯子之后有没有握稳。这些信息加起来也许几十个数字就能表达清楚,而且都是稳定的、有明确含义的量。
但传感器给出的东西完全是另一副样子。一台 1080p 相机以 30 帧每秒运行时,每秒产生接近两亿个数值(1920×1080 像素、三个颜色通道、30 帧),而每个数值只表示某个方向上光的强度;一台 64 线激光雷达每秒给出上百万个三维坐标,彼此之间没有任何顺序关系;力矩传感器给出几十路高频波动的数字,其中真正有用的变化可能只有百分之一秒那么长。这些数据高维、含噪、彼此异构,各自的时钟还不一定对得上。
这个过程中,感知型神经网络同时处理三种性质不同的问题:几何(东西在哪、多大、什么形状)、语义(那是什么、能不能拿、危不危险)、以及动力学(它在怎么动、接下来会到哪里)。不同的传感器在这三件事上的能力差异大,而现实任务往往三样都需要。
1.2 分析框架
无论处理哪种传感器,方法都可以拆成同样的五个环节。
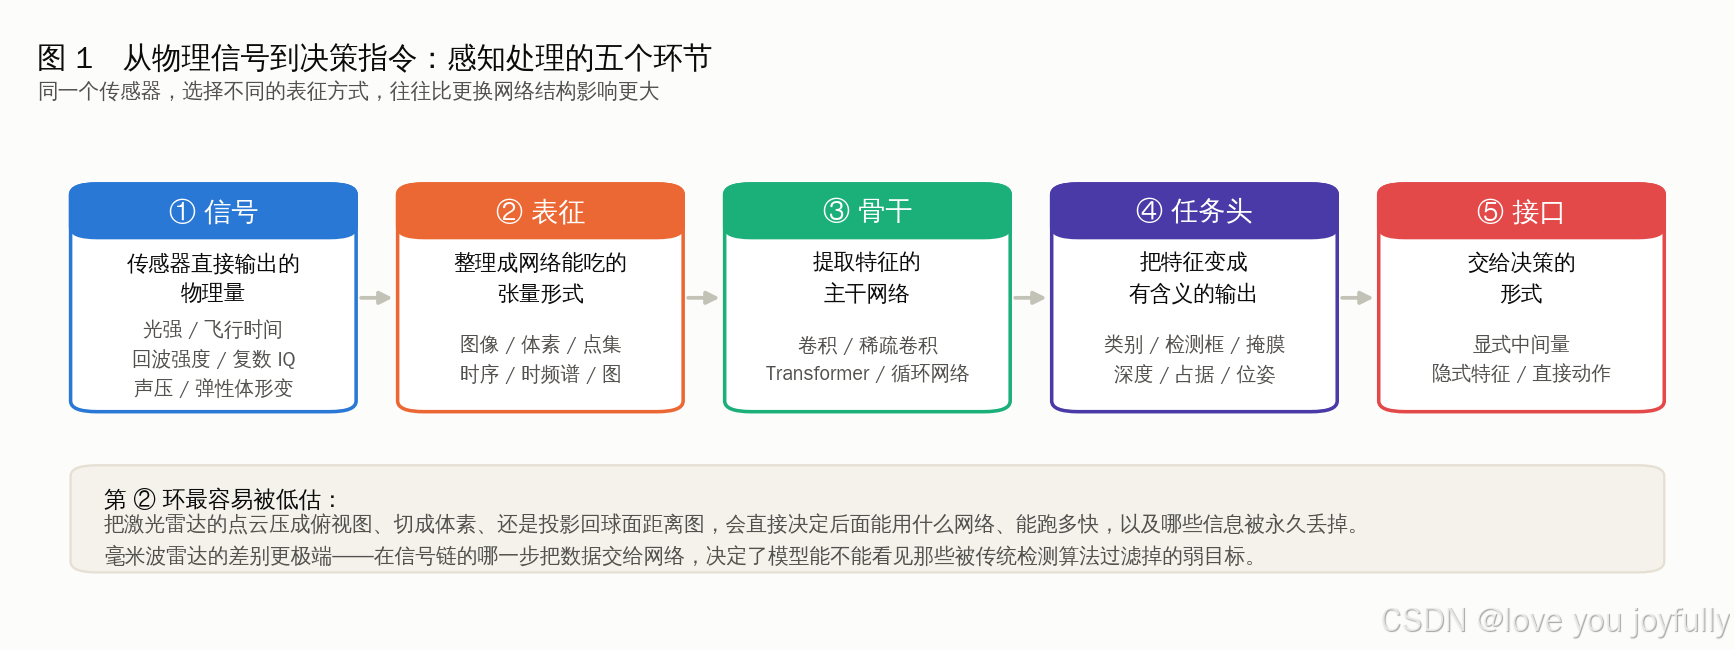
第一环是信号,也就是传感器直接输出的物理量。相机输出的是光强,激光雷达输出的是飞行时间和回波强度,雷达输出的是一串复数采样,触觉传感器输出的是弹性体的形变。搞清楚这一层,才能理解后面所有的取舍从何而来。
第二环是表征,指的是把原始信号整理成神经网络能够接受的张量形式。这一环看似只是数据格式转换,实际上是整条链路里最关键的设计决策。同一帧激光雷达数据,可以原样保留成一堆三维点,可以切成规则的小方格,可以在竖直方向压扁成"柱子",也可以还原成传感器扫描时的球面排布。这几种做法后面能接的网络、能跑到的速度、以及被永久丢掉的信息,都完全不同。
第三环是骨干网络,负责从表征里提取特征。这一层的选择往往是几个环节里最不需要纠结的——针对某种表征形式,业界通常已经收敛到两三个成熟选项。
第四环是任务头,把抽象特征变成有明确含义的输出:类别标签、检测框、分割掩膜、深度图、占据栅格、物体位姿。
第五环是接口,也就是把结果交给决策系统的方式。可以交出显式的中间量(“前方 3.2 米有一个 0.5 米宽的障碍”),也可以直接交出一段隐式特征向量,甚至跳过中间环节直接输出动作指令。这三种做法各有各的适用场合,第二十一章会专门讨论。
1.3 表征往往比网络结构更重要
这是过去十年里在多个模态上反复被验证的一条经验。
点云处理是最典型的例子。2017 年 PointNet 首次证明可以直接在无序点集上训练网络之后,学界在网络结构上做了大量文章。但真正让三维检测在自动驾驶上落地的,是 2019 年的 PointPillars——它的做法极其朴素,把三维空间在竖直方向整个压扁成一层二维网格,于是所有成熟的二维卷积加速手段立刻可用,速度提升了一个数量级。网络结构上它没有任何新意,赢在表征选择。
毫米波雷达上的差距更极端。传统雷达信号处理链会在中间某一步用一个叫 CFAR 的阈值算法把绝大部分回波过滤掉,只留下少数"确认是目标"的点。如果神经网络从这些点开始工作,无论用多好的结构,都不可能恢复出被扔掉的弱目标;而如果把接手位置往前挪到过滤之前,同样简单的网络就能看见那些原本看不见的东西。这不是网络能力的差别,是输入信息量的差别。
传感器的物理基础
在讨论具体算法之前,我们先花一点篇幅说清楚各类传感器在物理上的关系。
2.1 大部分传感器测的是同一样东西
可见光相机、红外热像仪、激光雷达、毫米波雷达,这四类看起来差别巨大的设备,测的其实都是电磁波,区别只在波长。
可见光的波长在 0.4 到 0.7 微米之间,这个波段的辐射能被人眼感知,日常物体表面的纹理、颜色、文字都在这个尺度上呈现,所以可见光图像的信息密度最高。长波红外在 8 到 14 微米,这个波段的辐射主要来自物体自身的热量,因此不依赖外部照明,但也几乎没有纹理可言。激光雷达常用的波长在 0.9 或 1.55 微米附近,属于近红外,它不是被动接收而是主动发射再接收反射,通过测量往返时间得到距离。毫米波雷达工作在 4 毫米左右(对应 77 GHz),波长比前面几种大了三到四个数量级。
波长决定了三件事,而这三件事几乎解释了所有的能力差异。
其一是角分辨率。同样口径的接收孔径,波长越短,能分辨的角度越细。这就是为什么相机和激光雷达能看清细节,而毫米波雷达即使做到"4D 成像"级别,角分辨率仍然远逊于前两者——它的波长实在太长了。
其二是穿透能力。雨滴、雾、烟尘、灰尘的典型尺度在微米到毫米之间。波长与颗粒尺度接近时散射最强,波长远大于颗粒时几乎可以绕过去。所以可见光和激光在雨雾中衰减严重,毫米波却基本不受影响。这条物理规律是雷达在恶劣天气下不可替代的根本原因,不是任何算法改进能够弥补的。
其三是能否直接测速。毫米波雷达通过多普勒效应可以直接测出目标沿视线方向的运动速度,而且精度很高。相机和激光雷达只能通过比较前后两帧来推算速度,既慢又不准。
2.2 主动与被动
另一个基本区分是传感器自己发不发射能量。相机和红外热像仪是被动的,只接收环境中已有的辐射,因此功耗低、不会互相干扰、也不会暴露自己。激光雷达、毫米波雷达、结构光深度相机是主动的,自己发射再接收,所以在黑暗中照样工作,但功耗高、多台设备同时工作时可能互相干扰、而且在某些场合会暴露位置。
主动传感器还有一个共性问题:目标表面的反射特性会直接影响测量。黑色吸光材质、玻璃、镜面、水面,对激光雷达和结构光深度相机来说常常是"看不见"的——发出去的光根本没有按预期返回。这类失效在实验室里很少遇到,在真实环境里却相当常见。
2.3 完全不同的另外几类
触觉、本体感觉、声学这三类不属于电磁波范畴,它们的性质需要单独理解。
触觉测的是接触时弹性体的形变或阵列的压力分布。它的空间范围极小(只有接触面那一点),但在那一点上的信息是其他任何传感器都给不出的:接触发生的精确时刻、接触力的大小和方向、有没有发生微小的滑移。
本体感觉指的是机器人对自己身体状态的感知——关节角度、关节力矩、惯性测量单元给出的加速度和角速度。它不看外界,只看自己,但通过"我用了多大力气、身体产生了多大响应"这条线索,它其实间接携带了大量关于外界的信息(地面软硬、负载轻重、是否碰到了东西)。
声学测的是空气或固体中的压力波动。麦克风便宜到可以忽略成本,采样率通常在几十千赫兹,比视觉快两个数量级,而且在遮挡情况下依然工作。
把上面这些性质汇总起来,可以得到下面这张图。
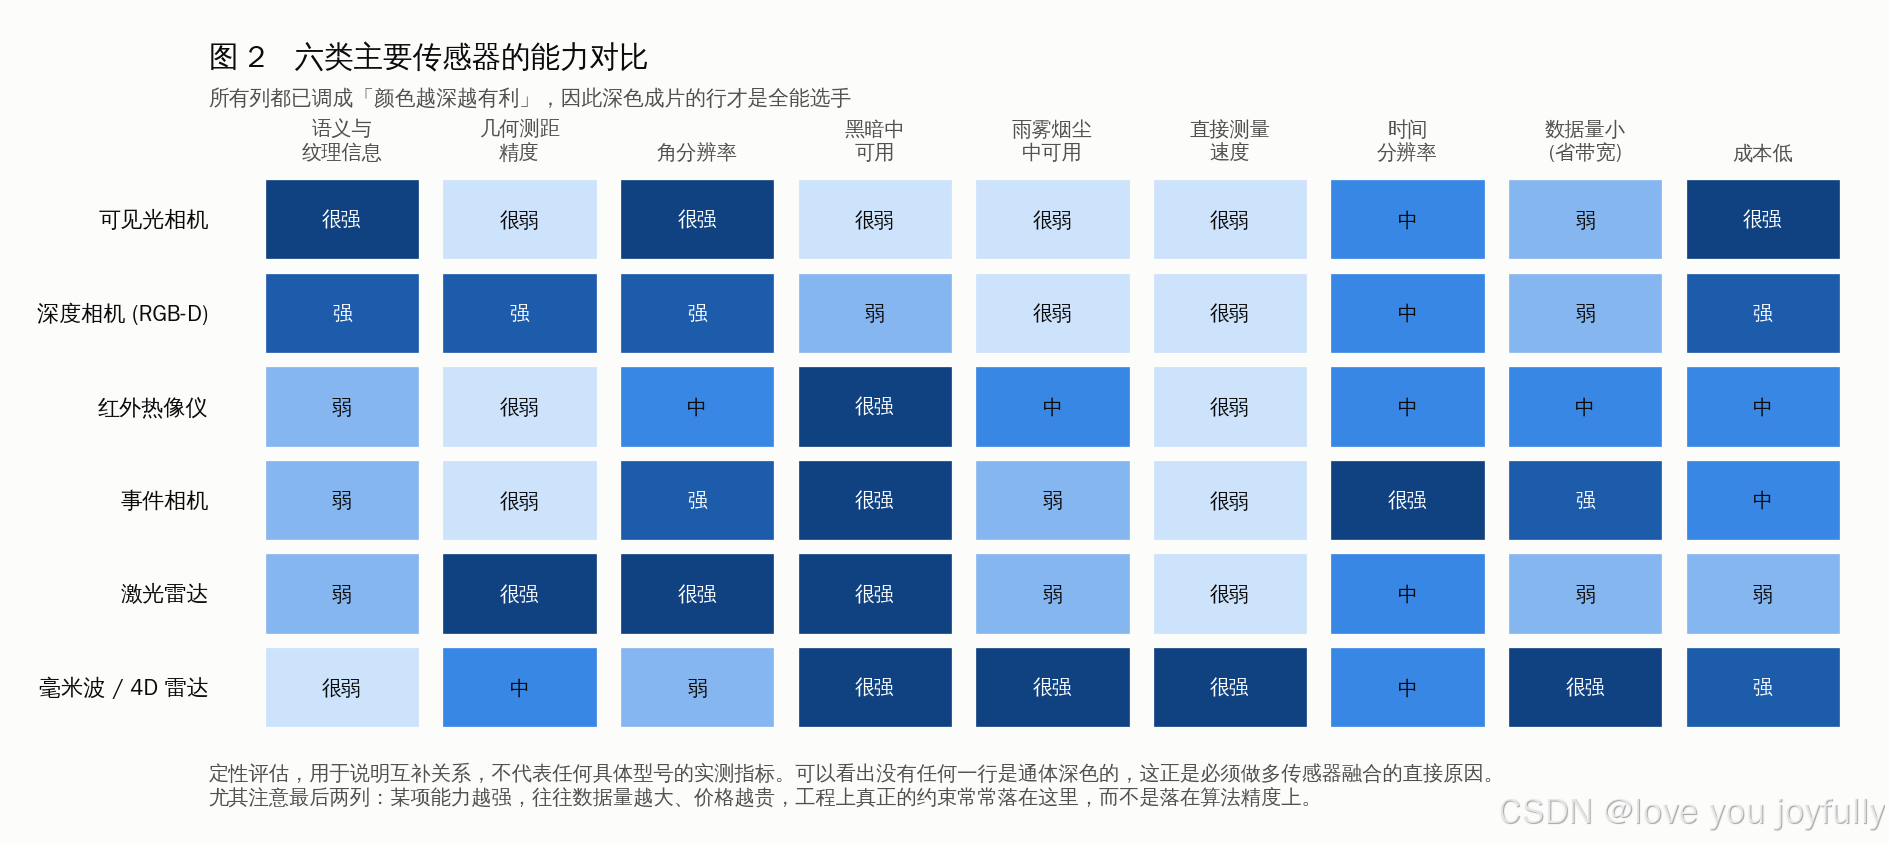
没有任何一行是通体深色的。每一类传感器都有它明确的短板,而且这些短板大多来自物理规律而非工程水平,短期内不会因为技术进步而消失。这正是必须做多传感器融合的直接原因——为了在某一路失效的时候还有别的路可走。
在实际项目里,真正卡住方案的常常不是精度不够,而是数据量太大传不过来、算力不够跑不动、或者成本超出预算。一个在论文里领先两个百分点的方法,如果需要四倍算力,在车载或机载平台上大概率是用不上的。
可见光相机
3.1 相机给出什么,又缺什么
相机是所有传感器里信息密度最高的。一帧图像同时包含了纹理、颜色、文字、光影关系,这些线索让人类可以在零点几秒内认出场景里的几乎所有物体。相机也是最便宜的——一个能用的工业相机成本可能只有激光雷达的百分之一。加上过去十几年计算机视觉领域积累的海量标注数据和成熟模型,几乎任何机器人项目都会从相机开始。
但相机有一个无法回避的本质缺陷:单目图像不包含尺度信息。一张照片里的杯子,可能是近处的小杯子,也可能是远处的大杯子,仅凭这一张图在数学上无法区分。人类之所以不觉得这是问题,是因为大脑用了大量先验知识(知道杯子通常多大、知道桌子多高)来补足。神经网络也能学会同样的先验,但那始终是"推断"而不是"测量",在没见过的场景里会失效。
相机的失效模式还包括低照度下的噪声、逆光时的过曝、快速运动造成的模糊、雨雾造成的能见度下降、以及玻璃和镜面带来的虚假图像。卷帘快门相机在剧烈运动时还会产生几何畸变。这些情况恰恰是引入红外、雷达、激光的理由。
3.2 卷积网络:让机器学会"找模式"
要理解现代视觉网络,得先理解卷积在做什么。
一个卷积核本质上是一个小小的模板,比如 3×3 的一块。网络拿着这个模板在整幅图像上滑过去,每到一个位置就计算"这里的局部图案跟模板有多像"。如果模板恰好是一条竖直边缘的形状,那么滑完之后得到的结果图就会在所有竖直边缘的位置亮起来。一层卷积同时用几十上百个不同的模板,就得到几十上百张这样的"响应图"。
关键在于把这个操作叠很多层。第一层的模板检测边缘和色块,第二层在第一层的输出上再找模式,于是能检测出角点和短线段的组合,第三层能检测出眼睛、轮子这样的部件,越往深层,能识别的东西越复杂、越抽象。这种"层级特征"的思想是 2012 年 AlexNet 在 ImageNet 图像分类竞赛上大幅领先的原因,也是深度学习在视觉领域全面铺开的起点。
卷积自带两个很有用的先验假设:一是局部性,认为有意义的图案是局部的,不需要一开始就看全局;二是平移等变,同一个模板在图像各处通用,猫出现在左上角还是右下角都用同一套参数识别。这两个假设非常符合图像的性质,所以卷积网络用相对少的参数就能达到不错的效果。
后续的重要改进包括 VGG(把网络做深、卷积核统一成 3×3)、ResNet(引入残差连接,让上百层的网络也能训练收敛,至今仍是最常用的轻量骨干)、MobileNet 与 EfficientNet(面向移动端做的效率优化)。2022 年的 ConvNeXt 用现代训练方法重新调教纯卷积网络,证明卷积在很多任务上并不落后于 Transformer——这提醒我们,架构之争的很多结论其实是训练方法之争。
在嵌入式部署上,卷积网络至今仍是首选,因为所有推理引擎和硬件加速器对卷积的支持都最成熟。
3.3 注意力机制与 Transformer
卷积的局部性假设在某些情况下会成为限制。判断"这个人是不是在过马路"需要同时看人和远处的斑马线,两者可能相隔半张图。卷积网络要靠很多层的堆叠才能把感受野扩大到那么远,效率不高。
注意力机制换了一种思路:把图像切成很多小块(称为 patch 或 token),让每一块都去"看"其他所有块,并根据内容相关性决定关注谁。这样任意两个位置之间的信息交流只需要一步,不管它们相隔多远。2020 年的 ViT(Vision Transformer)证明了这条路在足够大的数据量下可以超过卷积网络。
纯粹的全局注意力有个问题:计算量随图像块数量的平方增长,高分辨率图像会算不动。Swin Transformer 通过把注意力限制在局部窗口内、并让窗口在层与层之间移位来解决这个问题,恢复了线性复杂度和多尺度结构,成为密集预测任务(分割、检测)上的常用骨干。
3.4 自监督学习与视觉基础模型
这是近几年对机器人影响最大的一块变化。
传统的做法是:为每个任务准备一批带标注的数据,训练一个专用模型。这条路在机器人上很难走通,因为机器人场景的标注成本极高,而且场景一变模型就失效。
自监督学习换了个思路:不用人工标注,直接从海量无标注图像里学习。常见的做法有两大类。一类是掩码重建,把图像随机遮住一大半,让网络根据剩下的部分猜出被遮住的内容,代表工作是 2021 年的 MAE。另一类是自蒸馏,让同一张图的两种不同增强版本经过网络后得到相近的特征,代表工作是 DINO 系列。
DINO 系列(DINO → DINOv2 → 2025 年的 DINOv3)对机器人特别有价值,因为它学出来的特征本身就带有很强的语义和空间对应性。具体来说,把两张不同视角、不同光照下拍摄的同一个物体输入网络,对应部位的特征向量会很接近。这意味着不需要任何微调,就可以用这些特征做跨图像的稠密匹配、部件对应、以及开放词汇的分割。据 Meta 报告,DINOv3 的冻结特征在多项稠密预测任务上可以不经微调就超过许多专门训练的模型。对机器人系统来说,这意味着可以用一个骨干网络同时服务多个任务,而不必为每个任务各训一个。
另一条重要的线索是图文对齐。CLIP(2021)用四亿对图像-文字数据训练,让图像特征和文字特征落在同一个空间里,从而可以用自然语言去查询图像内容。SigLIP 及其后续改进了训练目标的效率。这条线索是所有"开放词汇感知"和视觉-语言-动作模型的语义地基——没有它,机器人就只能识别训练时枚举过的那些类别。
可提示分割是另一个对机器人直接有用的方向。SAM(Segment Anything Model,2023)可以根据一个点击或一个框,把对应的物体完整地分割出来,而且不需要知道那是什么。SAM 2(2024)加入了视频记忆机制,可以跨帧跟踪同一个目标。2025 年 11 月发布的 SAM 3 进一步支持"概念提示"——给一段文字或一张示例图指定一个概念,模型会在图像或视频里找出所有属于该概念的实例;此后还有 SAM 3.1 做实时化和全局推理的优化。对机器人来说,这类模型输出的实例级掩膜可以直接作为"这里有一个可以抓的东西"的候选,已经有一批工作(如 SAM-E、SAM2Act)把它们接进了操作策略。
3.5 常见任务与对应方法
目标检测要求给出物体的位置框和类别。这个方向经历了从两阶段(Faster R-CNN 先提候选框再分类)到单阶段(YOLO 系列直接回归)的演化,2020 年 DETR 又引入了一种新思路:用一组可学习的"查询向量"去图像特征上取信息,每个查询负责预测一个物体,从而彻底去掉了人工设计的锚框和非极大值抑制这两个繁琐环节。Deformable DETR、DINO-DETR、RT-DETR 是这条线上的重要改进。DETR 这种查询式的结构后来被大量借用到多模态融合中,因为查询天然可以同时去多个传感器的特征上采样。
分割要求给出像素级的归属。语义分割只区分类别,实例分割还要区分个体,全景分割两者都要。Mask2Former(2022)用统一的框架处理了这三种任务。
位姿估计要求给出物体的六自由度姿态,这是机器人抓取的直接前置条件。FoundationPose 一类的近期工作已经能处理没有 CAD 模型的新物体。
光流与点跟踪给出像素在帧间的运动。RAFT 是光流的标准方法,CoTracker、TAPIR 一类的稠密点跟踪近年来正在成为操作策略的重要中间量——因为"某个点怎么动"比"物体是什么"更接近操作任务真正需要的信息。
3.6 在机器人上怎么用这些模型
把通用视觉模型直接拿来当机器人策略的视觉编码器,效果并不总是理想。原因在于数据分布差异:互联网图像大多是第三人称、构图良好、物体完整;机器人看到的是第一人称、距离很近、手经常挡住关键区域。
因此出现了一批专门面向机器人的视觉表征工作。R3M(2022)在 Ego4D 这类人类第一人称视频上做预训练,用时序对比和语言对齐两个目标;VC-1 和 MVP 用掩码重建在机器人与第一人称数据上预训练;Theia(2024)把多个视觉基础模型(DINOv2、SAM、CLIP、深度模型)的能力蒸馏进一个小骨干,兼顾多种能力和推理速度。
一条比较稳妥的工程经验是:数据量不大的时候(比如几百到几千条演示轨迹),冻结一个强通用骨干、只训练轻量的策略头,通常好过端到端微调整个网络;数据量上到一定规模之后,微调骨干顶部的若干层开始占优。这个判断有旁证——英伟达的 GR00T N1.6 相比上一版的一个明确改动,正是去掉了视觉语言模型之后的适配器,改为在预训练阶段解冻该模型顶部的四层。
3.7 几个容易被忽略的工程细节
分辨率的影响常常大于骨干规模。在小目标检测或精细操作任务里,把输入从 224×224 提高到 448 或 896,收益通常比把 ViT-S 换成 ViT-L 更明显,代价也更可控。
相机内参和畸变标定的误差会被距离放大。任何需要把二维结果抬升到三维的环节,标定不准都会导致"模型本身没问题但结果不对",这是排查问题时应该优先怀疑的方向之一。
自动曝光在明暗剧烈变化的场景里(进出隧道、逆光开门)会造成图像统计特性突变。这种分布偏移带来的失败,比模型本身的能力不足更常见,通常需要在曝光策略上做工程处理,而不是指望模型学会适应。
深度与三维视觉
4.1 深度是怎么测出来的
"深度"指的是每个像素对应的物体离相机有多远。得到深度的方式有好几种,而具体用哪种方式测出来的,直接决定了数据里有什么样的噪声和空洞,进而决定了网络该怎么处理它。
结构光的原理是主动投射一组已知图案(通常是红外散斑),再根据图案在物体表面的变形反推距离。这类设备在近距离(一两米内)精度很好,但误差随距离的平方增长,而且在强日光下红外图案会被阳光淹没,室外基本不可用。黑色吸光表面、透明玻璃、镜面这三类物体几乎不返回有效信号。
飞行时间(Time of Flight)直接测量光往返所需的时间。它的全画幅一致性好,但存在多路径反射问题——墙角处的光可能先打到一面墙再反射到另一面墙才回来,导致测出的距离偏远。快速运动时还会产生运动伪影。
双目立体用两个相机从略微不同的位置观察同一场景,通过匹配对应像素的位置差异(视差)计算距离,原理和人的双眼一样。它是被动的,不怕日光,但完全依赖纹理——面对一堵纯白的墙或者一片重复的瓷砖,匹配算法找不到对应关系,深度就是空的。
单目推理不测量,靠网络从单张图像推断。它没有绝对尺度(除非用专门的度量深度模型),但对纹理和光照的鲁棒性反而更好,而且不需要额外硬件。
4.2 深度数据里常见的坑
深度图里的 0 或 NaN 不表示"距离为零",而表示"这里没测到"。这两者含义完全相反,但数值上无法自动区分。
如果不加处理直接把深度图当成图像喂给网络,网络会把所有无效区域理解成"非常近的东西",于是学出一个把玻璃门、黑色椅子、强光区域全都判成障碍的模型。这是 RGB-D 项目里最常见的错误之一,而且症状很隐蔽——训练指标正常,只在特定材质的物体上出错。
正确的做法是显式提供一张有效性掩膜,明确告诉网络哪些像素的深度值可信。多花几行代码,能省掉后面很多排查时间。
4.3 深度该怎么交给网络
大致有四条路线,取舍各不相同。
最简单的是把深度当成图像的第四个通道,和 RGB 一起送进同一个网络。实现最省事,但效果通常不理想,因为深度和颜色的数值分布完全不同,共享同一套卷积核效率很低。
历史上有过一种叫 HHA 编码的做法,把深度转换成"水平视差、离地高度、表面法向与重力方向的夹角"三个通道,这样就能直接复用在 RGB 上预训练好的网络。现在已经很少用了,但它体现的思路——把几何量变换成对预训练网络更友好的形式——至今仍然常见。
主流做法是双分支加跨模态交互:RGB 和深度各走一条网络分支,中间通过注意力或门控机制交换信息。ESANet 是面向实时 RGB-D 语义分割的高效实现;CMX 提出了跨模态特征整流与融合的通用结构,可以推广到 RGB 与热成像、事件、激光雷达等多种组合;CMNeXt 进一步支持任意数量的模态。
对操作类任务,最好的路线通常是把深度图用相机内参反投影成三维点云,再交给点云网络处理。简单说,三维输入在样本效率和视角泛化上有明显优势,同样的任务用点云输入所需的演示数据可以少一个数量级。
4.4 立体匹配网络
立体匹配的核心是为左图的每个像素在右图上找到对应点。传统方法靠手工设计的相似性度量加上全局优化,深度学习方法则经历了一条清晰的演化路径。
GC-Net 和 PSMNet 引入了"代价体"的概念:把左图特征和右图特征在各种可能的视差下对齐并拼接,形成一个三维张量,再用三维卷积在其中寻找最优匹配。这个思路精度高但计算量大。RAFT-Stereo(2021)改用迭代式的循环更新,从一个粗略估计出发反复细化,在精度和速度之间取得了更好的平衡。IGEV-Stereo 进一步改进了代价体的构造方式。2025 年的 FoundationStereo 则走了基础模型路线,追求在没见过的场景上直接可用。
这条演化路径和光流领域完全一致:从一次性回归转向"构造代价体加迭代细化"。这个模式在很多需要建立对应关系的任务上都成立。
4.5 单目深度基础模型
这是过去两年变化最大的方向之一。
MiDaS(2020)第一次证明了通过混合多个数据集训练,可以得到跨场景可用的单目深度模型。它输出的是相对深度(准确说是仿射不变的深度),也就是只保证深度的相对关系正确,绝对尺度未知。DPT 把 ViT 引入了这个任务。
对机器人而言,相对深度的用处有限——规划路径需要知道障碍到底是三米还是三十米。因此后来出现了一批度量深度模型,通过显式引入相机焦距等内参作为条件,让输出带有真实的米制尺度,代表工作包括 ZoeDepth、Metric3D 及其第二版、UniDepth。
Depth Anything 系列(2024)的核心思路是数据规模化:用大量无标注图像配合教师模型生成伪标签,把泛化能力做到很强,很快成为这个领域的事实标准。
2025 年 11 月发布的 Depth Anything 3(字节跳动 Seed 团队,已被 ICLR 2026 接收为口头报告)在设计上做了明显简化。据其论文和项目主页,它用一个普通的 Transformer(以 DINOv2 编码器为骨干)而非任何任务专用架构,把预测目标统一成单一的"深度-射线"表示,通过教师-学生训练完成,支持任意数量的输入视图并同时输出相机位姿。作者报告在他们提出的视觉几何基准上,相机位姿精度相比此前最好的 VGGT 平均提升 35.7%,几何精度提升 23.6%,且全部模型仅使用公开学术数据训练。
4.6 前馈式三维重建:把建图变成一次前向传播
这条线索值得单独说,因为它正在改变机器人领域"建图"这件事的性质。
传统的三维重建流程(运动恢复结构加多视图立体)是一个需要多帧输入、需要良好初始化、会累积漂移的优化问题。它精度高,但慢,而且不可微,很难嵌入到端到端的学习系统里。
DUSt3R(2024)提出了一个相当激进的做法:给两张没有任何标定信息的图像,直接用网络回归出两者在同一坐标系下的稠密点图。这一步隐式地同时解决了特征匹配、相对位姿估计和三角化三个传统上分开处理的问题。MASt3R 在此基础上加了稠密局部特征匹配头显著提升精度,MASt3R-SLAM 把它做成了实时系统。
VGGT(获 CVPR 2025 最佳论文)把这条路推得更远:单个大型 Transformer 一次前向传播,同时输出相机内外参、深度图、点图和点跟踪。前面提到的 Depth Anything 3 以及 π³ 等工作则在此基础上继续简化架构和训练目标。
对机器人的意义在于,几何重建从此可以被当作一个可微的、可批处理的前向网络来使用,直接嵌进策略网络或规划器里,而不必作为一个独立的、需要精心调参的预处理模块存在。这个转变的影响可能还没有被充分消化。
4.7 场景该用什么形式存下来
感知的结果需要以某种形式保存,供规划和决策查询。常见的选择有几种,各有各的适用场合。
占据栅格(以及它的八叉树变体 OctoMap)把空间切成小方格,每格记录"是否被占据"。它显式、易于查询、碰撞检测简单,是导航规划的传统主力。缺点是分辨率和内存的矛盾——想要厘米级精度,内存开销会很快变得不可接受。
TSDF(截断符号距离场)为每个体素记录到最近表面的带符号距离,表面精度比占据栅格高得多,而且很容易融合多帧观测。稠密重建和抓取面估计常用。
NeRF(神经辐射场)用一个神经网络隐式地表示整个场景,渲染质量极高。但训练慢、查询也慢,机器人在线使用受限较多。
三维高斯泼溅(3D Gaussian Splatting,2023)用大量三维高斯基元显式表示场景,可以实时渲染且支持增量更新。它对机器人的吸引力在于同时具备三种性质:可渲染(因此能做新视角合成,用于数据增广和仿真到现实的迁移)、显式几何(因此能做碰撞查询)、还能挂载语义特征场(因此能响应"去拿桌上那个红色杯子"这样的语言查询)。SplaTAM、Gaussian Splatting SLAM、语义版本的 SGS-SLAM、特征场版本的 GSFF-SLAM,以及多机协同的版本,构成了一个正在快速扩张的方向。
红外与热成像
5.1 它看到的是热,不是光
长波红外相机接收的是物体自身因温度而辐射出的电磁波。这个物理机制带来几个后果,值得逐一说清楚。
首先,它完全不依赖外部照明。彻底黑暗的房间里,热像仪看到的画面和白天没有本质区别。这一点对夜间巡检、消防、安防、以及夜间作业的机器人是决定性的。
其次,它对生命体和发热设备有天然的对比度。人体温度和大多数背景差异明显,所以在红外图像上人往往比在可见光图像上更容易分辨。设备过热、管道泄漏、电气故障这类问题也会直接在热图上表现出来。
第三,它在烟雾和部分遮挡下仍能成像。烟尘颗粒对长波红外的散射远弱于对可见光的散射,这是消防机器人依赖热像仪的原因。
但它的短板同样明显。红外图像没有颜色、纹理极少,一辆车在热图上就是一团模糊的热斑,很难判断型号甚至朝向。分辨率通常远低于可见光相机,640×512 已经算中高端配置。它还存在"热交叉"现象——当目标温度恰好与背景接近时,对比度会趋近于零,目标短暂消失。此外,非制冷热像仪需要周期性地用快门做非均匀性校正,这会造成图像流每隔一段时间中断几百毫秒,实时系统必须显式处理这段空窗。
短波和中波红外另有用途(透雾、气体检测),处理方法与长波红外基本同构,这里不单独展开。
5.2 三类任务
红外与可见光图像融合的目标是生成一张兼具两者优点的图像,供人观看或供下游检测器使用。这条技术线的演化很有代表性:最早用多尺度变换和稀疏表示等传统信号处理方法;深度学习时代先是自编码器路线(DenseFuse、RFN-Nest),随后是生成对抗网络路线(FusionGAN,以及把融合与检测联合优化的 TarDAL,后者还发布了 M3FD 数据集);U2Fusion 提出了统一的无监督框架;SwinFusion 引入了 Transformer;CDDFuse(CVPR 2023)用相关性驱动的方式把特征分解成模态共有的低频成分和模态特有的高频成分,是目前引用最广的强基线。
有一个在论文里常被简化、在工程上却极为关键的问题:红外镜头和可见光镜头之间有物理基线,因此存在视差,严格配准很困难,尤其在近距离。近两年出现了专门处理"未配准融合"的工作。在实际部署中,配准质量对最终效果的影响往往超过融合网络本身的选择。
RGB-T 目标检测指同时使用可见光和热成像做检测。基准数据集包括 KAIST 多光谱行人(2015)、FLIR ADAS、LLVIP。方法上,最早是简单地把两路图像在通道维拼接;随后是双分支中间融合,MBNet 专门处理了两个模态之间的差异;CFT 引入跨模态融合 Transformer;ProbEn(ECCV 2022)走了另一条路——让两个模态各自独立检测,最后在概率层面做集成,结构简单却是一个很强的基线。ProbEn 的结果值得琢磨:当标注本身存在不确定性、两个模态的可靠性又随场景变化时,后融合往往比精心设计的特征融合更稳。还有一类方法引入光照感知的动态加权,白天更信可见光,夜间更信红外。
RGB-T 语义分割方面,MFNet(2017,同时发布了同名数据集)是起点,RTFNet(2019)面向实时,CMX 和 CMNeXt 提供了通用跨模态框架,CRM 和 SegMiF 则探索了分割与融合互相促进的训练方式。
5.3 工程上真正难的地方
红外的域偏移问题比可见光严重得多。不同厂商的探测器响应曲线不同,环境温度会整体平移图像的灰度分布,非均匀性校正的状态也会影响画面。冬天训练的模型在夏天可能明显退化。因此训练集必须覆盖不同季节和不同环境温度,并且需要做温度归一化或统一的直方图处理策略。
另一个建议是尽量使用原始的 14 位辐射数据而不是厂商自动增益控制后输出的 8 位显示图。后者为了人眼观看做了非线性拉伸,丢掉了大量信息,而且拉伸参数随场景变化,会给模型引入额外的分布漂移。
由于红外标注成本高、标注人员也难以准确判断,实践中常用的做法是先做可见光标注,再通过配准迁移到红外,或者直接用可见光模型作为教师做跨模态蒸馏。
事件相机
6.1 一种完全不同的成像方式
普通相机按固定节拍工作,每隔比如 33 毫秒就把整个感光面的读数输出一次,无论画面有没有变化。事件相机(也叫动态视觉传感器,DVS)的每个像素是独立且异步的:只有当该像素接收到的光强对数变化超过某个阈值时,它才输出一条记录,内容是"哪个像素、什么时刻、变亮还是变暗"。
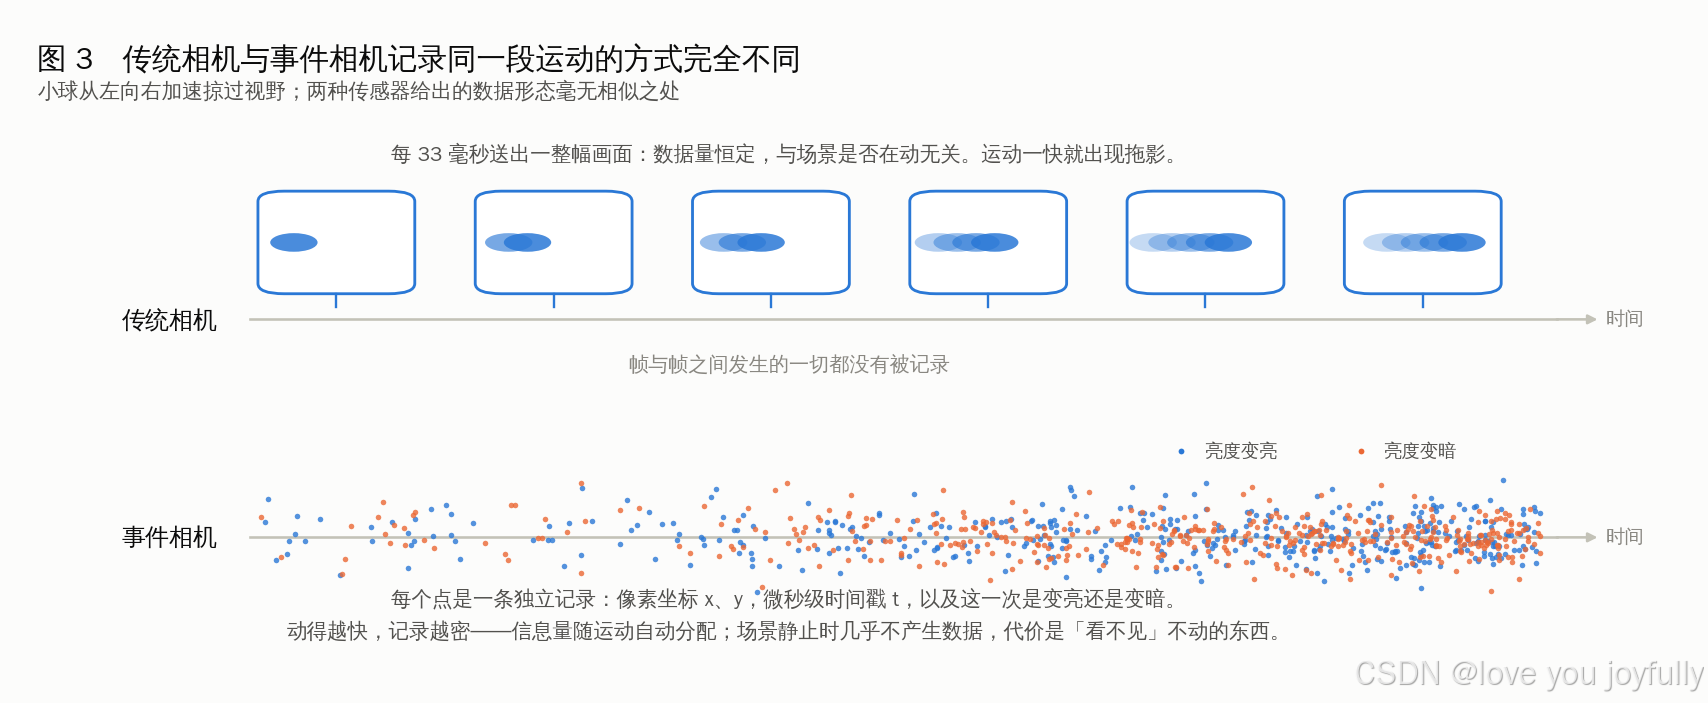
这种机制带来几个不同寻常的性质。时间分辨率达到微秒级,等效于每秒上万帧,因此高速运动完全不会产生拖影。动态范围超过 120 分贝(普通相机约 60 分贝),从隧道口的强光直接过渡到隧道内的昏暗,事件相机不会过曝也不会欠曝。数据量随场景动态自适应——静止的画面几乎不产生任何数据,功耗和带宽都很低。
代价也很直接。它没有绝对亮度信息,无法直接告诉你某处有多亮;没有纹理;最重要的是,静止的东西它看不见——一堵不动的墙对事件相机来说等同于不存在。此外噪声事件(没有真实亮度变化却触发的记录)相当多,需要专门滤除。
因此事件相机的适用场景非常明确:高速运动(无人机避障、击打运动物体、抓取空中飞行的东西)、极端光照变化、以及需要超低延迟触发的场合。把它当成通用相机的替代品是不合适的。
6.2 表征是这个领域最核心的问题
事件数据是稀疏、异步的时空点集,而现有的神经网络绝大多数需要规则的张量输入。因此必须先做"张量化",而这一步的选择很大程度上决定了性能上限。
最直白的做法是事件帧:在一个固定时间窗内把所有事件按极性累加,得到一张类似图像的东西。这样所有图像网络立刻可用,但时间信息被完全压掉了,同一个窗口内先后发生的事件变得不可区分。
时间面(Time Surface)为每个像素记录最近一次事件的时间戳并按指数衰减,这样"刚刚发生"和"很久以前发生"就能区分开,代价很小。HOTS 和 HATS 是这一路的代表。
体素网格是目前最通用的做法:把时间轴切成若干个(通常 5 到 10 个)区间,每个事件按时间位置双线性地投票到相邻两个区间。它在保留时序信息和保持规则结构之间取得了不错的平衡。
EST(Event Spike Tensor)更进一步,用可学习的核函数完成时空量化,让表征本身成为可训练的一部分。
也有工作把事件当作三维时空中的点云或图来处理,用点云网络或图网络直接消费。这条路保留了稀疏性,理论上最高效,但工程实现复杂、硬件加速困难,目前主要停留在研究阶段。
最后是直接把原始事件流送进脉冲神经网络,这是最"原生"的方案,下面单独讲。
6.3 主流网络
工程上目前的主力是帧式网络加循环状态这一路。
一个重要的早期工作是 E2VID(2019),它把事件流重建成灰度视频,从而让所有传统视觉算法都能复用。这种"桥接"思路在系统集成时很实用。
RVT(Recurrent Vision Transformer,Gehrig 和 Scaramuzza,CVPR 2023)是目前事件目标检测的标准强基线。它采用多阶段结构,每个阶段包含一个充当条件位置编码的卷积先验、局部与空洞全局自注意力、以及循环时序聚合模块。作者报告在 Gen1 汽车数据集上达到 47.2 mAP,在 T4 显卡上单次推理低于 12 毫秒,约为此前方法的六倍速度,参数量少五倍。后续有 PMRVT 等改进。ICCV 2023 的 GET 则把事件极性也当作一个 token 维度处理。
2024 年之后出现了状态空间模型路线,用 S4、S5、Mamba 一类的结构替代 LSTM 来处理事件序列。它们训练时可以并行、推理时是常数内存的递归,而且有一个对事件相机特别契合的性质:能在不同事件频率之间泛化——用 20 Hz 的数据训练、在 200 Hz 下推理,性能不会明显下降。
6.4 脉冲神经网络与神经形态硬件
事件本身就是脉冲,而脉冲神经网络(SNN)正是以脉冲作为信息载体的网络,两者在结构上是同构的。神经元只在膜电位累积到阈值时才发放脉冲,其余时刻不消耗算力,因此在专用硬件上功耗可以比传统网络低一到两个数量级。
代表工作包括引入脉冲自注意力的 Spikformer、面向检测的 EMS-YOLO 和 SpikeYOLO(ECCV 2024)、以及 2025 年出现的混合结构(用 SNN 做低功耗前端特征提取、用 ViT 做后端语义理解)。训练方法上,主流是替代梯度加时间反向传播——因为脉冲发放是不可导的阶跃函数,训练时用一个形状相近的可导函数替代它的梯度;另一条路是把训练好的传统网络转换成脉冲网络。
硬件方面,英特尔的 Loihi 2、SynSense 的 Speck(把事件传感器和脉冲处理器封装在一起)、BrainChip 的 Akida 是主要平台。2026 年已经出现了把帧式和事件式检测同时部署到边缘神经形态硬件、并给出统一评测基准的工作。
需要客观说明的是:在通用 GPU 上,脉冲网络通常打不过同等规模的传统网络。它的价值必须绑定神经形态硬件的功耗和延迟优势来谈。对于电池受限的小型无人机、可穿戴设备、以及需要常开待机唤醒的场景,这是一个真实可选的方案;在算力充足的车载或服务器场景,目前还看不出必要性。
常用数据集包括 N-Caltech101 和 N-Cars(分类)、Gen1(2020,检测)、1Mpx(2020,高分辨率检测)、DSEC(2021,包含立体事件、激光雷达和驾驶场景)。
激光雷达与点云
7.1 数据形态带来的三个难题
激光雷达通过发射激光脉冲并测量返回时间来获得距离,输出是一组三维坐标点,通常还附带一个反射强度值。一帧 64 线激光雷达大约包含十万个点。
这种数据形态对神经网络有三个不友好的地方。
无序性:点集本身没有天然顺序,交换任意两个点的存储位置,描述的仍是同一个场景。因此网络必须对输入顺序不敏感。PointNet 用的办法是对每个点独立做变换,最后用一个对称函数(最大值池化)聚合,从数学上保证了置换不变性。
稀疏且不均匀:激光雷达的点在近处密集、远处稀疏,而且整个三维空间中被占据的体素只占极小比例,通常在千分之一量级。如果用普通的三维卷积处理,绝大部分算力会浪费在空气上。这是稀疏卷积存在的理由——只在非空位置计算,跳过所有空体素。
语义可分性弱:远处的行人和一根柱子在点云上都只是一小簇点,没有颜色和纹理可供区分。这是激光雷达几乎总是需要和相机融合的根本原因,不是算法能够单独解决的。
除此之外还有两个必须在工程上处理的问题。一是运动畸变:机械旋转式激光雷达转一圈需要约 100 毫秒,这期间载体本身已经移动了,所以同一帧内不同时刻采集的点其实处在不同的坐标系下,必须借助惯性测量单元做逐点的去畸变。这一步做不好,后面所有网络的努力都会被抵消。二是雨雾雪产生的虚假回波,需要专门的滤除策略。
7.2 五条表征路线
点云的处理方法基本上可以按表征方式分成五类。
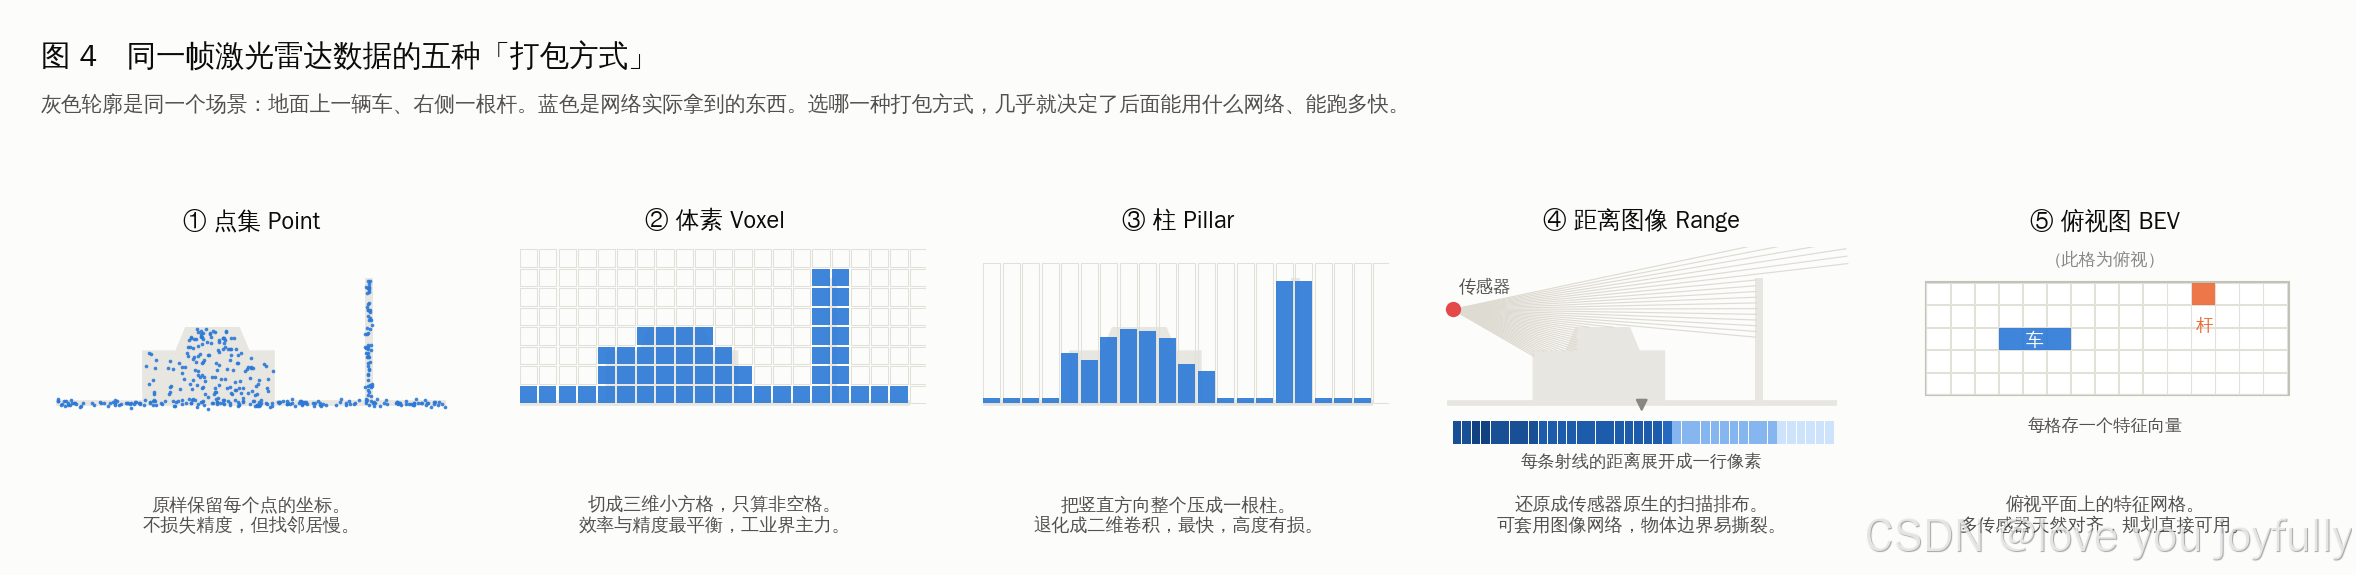
基于点的方法直接在原始点上工作,用对称函数保证置换不变,用球查询或 K 近邻构造局部邻域来提取局部结构。PointNet 和 PointNet++ 是奠基工作,后续有 DGCNN(在特征空间构图)、PointNeXt(用现代训练配方重新调优)、RandLA-Net(面向大规模场景的随机采样策略)。这条路不损失任何精度,但邻域查询是速度瓶颈——找每个点的邻居本身就很慢。
基于体素的方法把空间量化成规则的三维网格,配合稀疏卷积只在非空体素上计算。VoxelNet 是早期代表,SECOND 首次引入稀疏卷积大幅提速,MinkowskiNet 提供了通用的稀疏卷积框架,SpConv 和 TorchSparse 是常用的实现库。这条路在效率和精度之间平衡最好,是工业界的主力。
基于柱的方法更激进,把整个竖直方向压成一根柱子,三维问题于是退化成二维。PointPillars 是代表,PillarNeXt 和 PillarNet 是后续改进。速度极快,是车载实时系统的常见选择,代价是高度信息有损失。
基于距离图像的方法把点云投影回激光雷达原生的球面扫描排布,得到一张规则的二维图,于是所有图像网络都能直接用。RangeNet++、SalsaNext、RangeDet、FRNet 属于这一路。它稠密规则、速度快,但球面投影会带来尺度畸变,而且相邻像素在三维空间中可能相隔很远,物体边界容易"撕裂"。
多视角混合把上述若干种组合起来。PV-RCNN 同时用点和体素,Cylinder3D 用柱坐标系下的体素(更符合激光雷达的采样特性),SphereFormer 在球面邻域上做注意力。精度更高,但工程复杂度也更高。
当前的经验是:户外驾驶场景倾向于体素或柱加俯视图;室内密集场景倾向于点或体素 Transformer;追求极致时延则用柱或距离图像。
7.3 Transformer 与完全稀疏化
Point Transformer 的第一版和第二版(2021、2022)把注意力机制引入点云,用向量注意力在局部邻域内建模。它们在室内分割任务上很强,但受限于 K 近邻建邻域的开销,感受野难以扩大。
Point Transformer V3(CVPR 2024)提出了一个思路上的转变:放弃精确的 K 近邻,改用空间填充曲线(Z 序或 Hilbert 曲线)把三维点云序列化成一维序列,然后在序列上取连续片段当作"邻域"。空间填充曲线的性质保证了在三维空间中靠近的点,在序列上大概率也靠近,因此这是一个精度可控的近似。这个"用精度换规模"的取舍效果显著:作者报告感受野从 16 个点扩展到 1024 个点,相比第二版速度约提升三倍、显存效率约提升十倍,并在 20 多个室内外下游任务上刷新了当时的最好结果。它目前是通用点云骨干的首选之一,也被大量占据预测和自动驾驶模型采用。
DSVT(CVPR 2023)是另一条思路,用窗口内分组加旋转集合注意力来处理稀疏体素,其一个明确的设计目标是避免自定义 CUDA 算子,从而更容易部署。这类"为部署而做的架构选择"在工程上的价值往往被论文低估。
还有一个重要趋势是完全稀疏检测器。传统检测器在网络末端要把稀疏特征"稠密化"成一张完整的俯视特征图再做检测,在近距离场景下这没问题,但当感知距离扩展到 200 米以上(Waymo 数据集的量级)时,稠密特征图的面积按距离平方增长,代价迅速变得不可接受。SST、FSD 及其第二版、VoxelNeXt(CVPR 2023,直接从稀疏体素预测检测框,不需要锚框、稠密头和非极大值抑制)、SAFDNet(CVPR 2024,用自适应特征扩散解决完全稀疏结构下"物体中心处恰好没有点"的问题)是这条线上的代表。长距离感知需要完全稀疏结构,这一点目前已经是共识。
7.4 主要任务
三维检测方面,SECOND 和 PointPillars 是效率导向的基线,CenterPoint(2021)用中心点表示替代锚框,是使用最广泛的基线之一,PV-RCNN 走两阶段精修路线,VoxelNeXt 和 SAFDNet 代表完全稀疏方向,TransFusion 则既可以单模态也可以做融合。
语义分割方面,RangeNet++ 面向速度,Cylinder3D 和 SphereFormer 针对户外场景的采样特性做了专门设计,MinkowskiNet 和 PTv3 是通用强骨干。全景分割(同时区分类别和个体)有 Panoptic-PolarNet、Panoptic-PHNet 等。
点云配准(把两帧点云对齐)方面,学习方法有 PointNetLK、D3Feat、PREDATOR,以及在低重叠情况下表现突出的 GeoTransformer(CVPR 2022)。
里程计与建图方面有一个需要如实说明的现实:在激光雷达里程计这个具体任务上,经典几何方法至今仍然优于端到端学习方法。FAST-LIO2(紧耦合惯性测量单元的滤波方法)和 KISS-ICP(极简的纯几何配准)在大多数场景下比学习方法更准也更稳。学习方法真正胜出的地方在别处:语义理解、动态物体识别、闭环检测的描述子(OverlapNet、LoGG3D-Net)、以及长隧道、空旷广场这类几何退化场景下的先验补全。不要为了引入深度学习而替换掉一个已经能稳定工作的几何前端,这个建议在实践中被违反的次数超乎想象。
常用数据集包括 KITTI 及其分割版本 SemanticKITTI、nuScenes、规模最大且距离最远的 Waymo Open、Argoverse 2、ONCE,室内则有 ScanNet 和 S3DIS。
毫米波雷达
8.1 看懂信号链
调频连续波雷达的处理流程是一条相当长的链路。理解这条链路,是理解雷达深度学习方法分歧的前提。
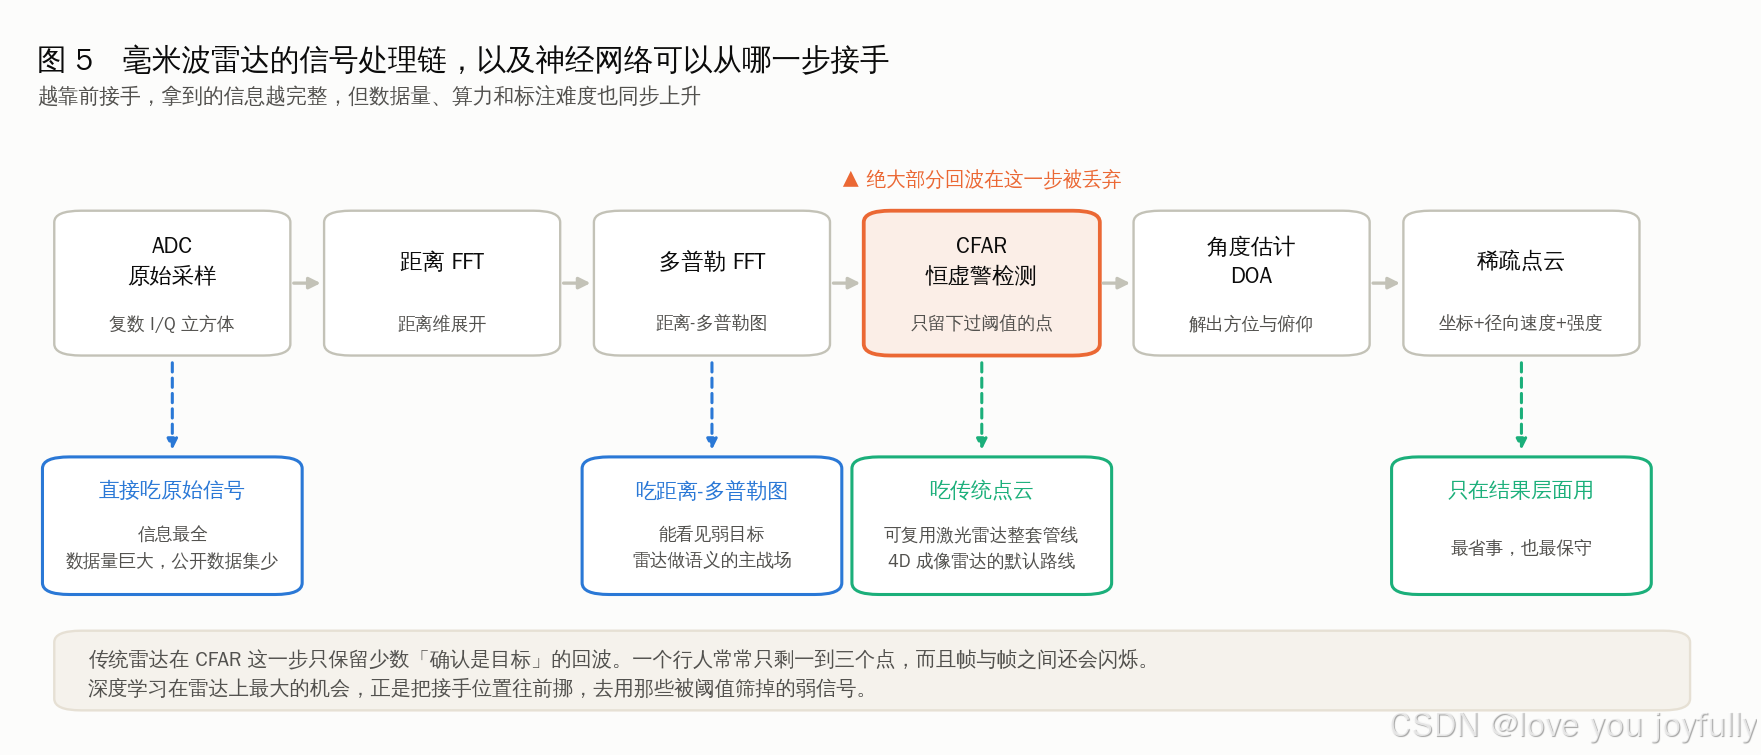
天线接收到回波后先与发射信号混频,得到中频信号,经模数转换得到原始的复数采样。对这些采样做第一次傅里叶变换得到距离信息,做第二次傅里叶变换得到速度(多普勒)信息,于是形成一张距离-多普勒图。接下来用 CFAR(恒虚警率检测)算法设定一个随环境噪声自适应的阈值,把低于阈值的部分全部丢弃,只保留少数"确认是目标"的单元。最后通过多个接收天线之间的相位差解算出方位角和俯仰角,得到最终的稀疏点云。
关键在于 CFAR 这一步丢掉了绝大部分信息。传统雷达这么做是必要的,因为后续的跟踪算法处理不了那么多虚警。但对神经网络来说,那些被丢掉的弱回波里往往包含着行人、自行车、静止障碍这类最需要检测的目标。
8.2 五种表征,对应五个接入点
原始 ADC 信号是信息最全的形式,一个复数采样立方体。直接在这一级训练网络理论上潜力最大,但数据量巨大,公开数据集也很少。2026 年出现了 DeeperRadar 这类联合优化 MIMO 波形设计与多模态融合的工作,属于这个方向的探索。
雷达张量包括距离-多普勒图、距离-方位图,以及三者兼有的立方体。这是"让雷达做语义理解"的主战场,因为它保留了低信噪比目标。RODNet(WACV 2021)在距离-方位张量上做目标检测;FFT-RadNet(CVPR 2022,配套 RADIal 数据集)处理高清雷达的多任务;RadarFormer 引入了 Transformer。
雷达点云是与激光雷达管线复用度最高的形式,因此也是 4D 成像雷达的默认路线。做法通常是把 PointPillars、PointNet 一类的网络移植过来。RTNH 是 K-Radar 数据集的官方基线,RadarPillars 是面向 4D 雷达的柱状方法。
栅格图把雷达数据转成占据或强度的俯视网格,便于与相机的俯视特征对齐。
微多普勒谱是时间-频率图,记录目标各部件的细微运动特征。人走路时手臂和腿的摆动会在多普勒维产生特有的周期性花纹,这是手势识别、跌倒检测、以及区分人-车-无人机的主力表征。
8.3 雷达的价值与它的难处
雷达有三个别的传感器给不了的东西。第一是直接测量径向速度,这是一个一阶量而非通过差分得到的估计,对运动目标的轨迹预测极有价值。第二是在雨、雾、雪、灰尘、烟中几乎不衰减,这使它成为恶劣天气下的最后一道冗余。第三是成本低、体积小、能穿透非金属外壳(因此可以藏在保险杠里)。
难处同样具体。角分辨率差是最根本的限制,传统三维雷达几乎没有高度信息,4D 成像雷达通过大规模 MIMO 天线阵把俯仰角做了出来,但仍远逊于激光雷达。多径与鬼影很常见——护栏、地面、隧道壁的多次反射会产生实际并不存在的目标。点云极度稀疏且帧间不稳定,一个行人可能只有一到三个点,而且这一帧有下一帧就没了,直接套用激光雷达的网络结构效果很差,需要重新设计邻域尺度和体素大小。
还有一个特殊的困难:人眼看不懂雷达张量,因此无法人工标注。这导致跨模态监督成为这个领域的标准做法——用同步的相机或激光雷达自动生成标签来训练雷达网络。RODNet 就是这么训练出来的。这个约束深刻地塑造了整个领域的方法论。
8.4 与其他传感器的融合
相机与雷达的融合是研究最多的组合,因为两者的互补性最强(相机有语义没速度没恶劣天气能力,雷达反之)也最便宜。CenterFusion(WACV 2021)用雷达点为相机检测结果补充深度和速度;CRAFT(AAAI 2023)在极坐标下做软关联,缓解了两者空间分布差异大的问题;CRN(ICCV 2023)用雷达辅助相机的俯视图变换;RCBEV、RCFusion、LXL 属于俯视空间融合;ICCV 2025 的 CVFusion 做 4D 雷达与相机的跨视角融合。
雷达与激光雷达的融合相对少见,主要动机是恶劣天气下的鲁棒性,AAAI 2025 的 L4DR 是代表。
还有一条很实用的路线是跨模态蒸馏:用激光雷达加相机的强组合训练一个教师模型,再把知识蒸馏给只有雷达加相机的学生模型。CRKD(CVPR 2024)和 RCTDistill(2025,带时序融合)是这条线的代表。它的意义在于用昂贵传感器训练、用廉价传感器部署,这在量产成本敏感的场合价值很直接。
数据集方面,nuScenes 包含五个稀疏的三维雷达,CARRADA 提供距离-多普勒和距离-方位张量的标注,RADIal 提供高清雷达的多种表征,K-Radar 是 4D 雷达数据集且覆盖雨雪雾等多种天气,View-of-Delft 侧重弱势道路使用者,此外还有 TJ4DRadSet 和 aiMotive。
射频与电磁信号
前面讲的雷达属于成像类的电磁传感。还有一大类电磁信号不产生图像,而是以复数时序或信道响应的形式存在。这类信号的处理方法与视觉差异最大,因为人类对它没有任何直观感受——看一眼原始数据完全不知道里面有什么。
9.1 共性方法论
先说这一类的共同规律,比罗列具体模型更有价值。
信号本质是复数。 无线信号通常表示成同相分量和正交分量(I/Q)的组合,幅度和相位各自携带信息。一种常见但不理想的做法是把 I 和 Q 当成两个独立的实数通道送进普通网络,这样做会破坏它们之间的复数运算关系。复值神经网络把卷积、批归一化、激活函数都重新定义在复数域上,从而保留相位信息。在合成孔径雷达目标识别、调制识别、信道状态信息感知这几个方向上,复值网络优于实数双通道的做法已经被反复验证。
表征的选择取决于信噪比。 把原始 I/Q 时序直接送进一维卷积或 Transformer,在信噪比高、数据量大的时候效果最好;把信号转成时频图(短时傅里叶变换、小波变换等)再用二维卷积处理,在低信噪比下通常更稳健,因为时频变换本身起到了相干积累的作用。
物理引导很重要。 把已知的信号模型——散射中心分布、多径传播模型、天线阵列流形——作为网络结构的先验或损失函数的约束,在样本稀少时能带来显著提升。这一类信号的标注数据几乎总是稀缺的。
域自适应是这个领域的头号问题。 换一个房间、换一个人、换一个天线摆位,模型性能就可能崩溃。所有射频感知论文的真正门槛都在跨域实验上。只报告同域测试结果的工作,参考价值有限。
9.2 WiFi 信道感知
这是一个乍看反直觉的方向:用普通的 WiFi 信号感知人的位置和动作。
原理在于信道状态信息(CSI)刻画了发射端到接收端之间所有传播路径的叠加。人体在环境中移动会改变多径结构,因此从 CSI 的变化中反推人的位置、姿态和动作在原理上是可行的。
MIT 的 RF-Pose(CVPR 2018)是这条线的标志性工作。它的训练方式很有启发性:用同步的相机作为教师,让网络学习从射频信号预测人体骨架;训练完成后,网络只需要射频信号就能工作,而且能穿过墙壁。这是"跨模态监督"范式的经典案例——用一个人类能标注的模态去训练一个人类无法标注的模态。
后续工作包括 ICCV 2019 的 Person-in-WiFi、2022 年的 DensePose from WiFi(用商用 WiFi 网卡做稠密人体估计)、以及各类穿墙动作识别系统。
Widar3.0 提出的思路值得单独提一下。它没有指望网络自己学会跨环境的不变性,而是先从 CSI 中提取一个叫"体速度剖面"的中间量——这个量在数学上与具体的收发位置无关。与其让网络学不变性,不如先把域相关的因素从表征里消掉,这个思路对所有存在严重域偏移的模态都适用。
网络结构上从早期的 CNN 加 LSTM,发展到双流结构、Transformer(如 THAT),近年也开始出现自监督预训练。SenseFi 是一个常用的基准工具箱。
应用方向包括跌倒检测、呼吸和心率监测、手势识别、穿墙人员计数、老人看护。对机器人来说,它的价值在于提供一种隐私友好、不依赖光照、能穿透墙壁的环境态势感知能力——在不适合装摄像头的场合(卧室、卫生间)尤其有意义。
9.3 调制识别与频谱感知
给定一段接收到的无线信号,判断它使用了哪种调制方式(BPSK、QPSK、16QAM 等),这是通信侦察、频谱管理、认知无线电的基础任务。
传统方法依赖专家设计的特征,比如高阶累积量。O’Shea 等人在 2016 年证明,直接把原始 I/Q 序列送进卷积网络,效果可以超过传统的专家特征方法。他们同时发布的 RadioML 2016 和 2018 数据集成为这个领域的标准基准。
此后的演进路径是 CNN → CLDNN(卷积加长短期记忆网络加全连接)→ ResNet → 复值网络(包括轻量的双分支复值结构)→ Transformer(如 IQFormer,以及 2025 年针对强干扰条件的轻量 Transformer 工作)。
评价这个方向的工作时,需要看低信噪比区间(大约 -20 到 0 dB)的准确率,而不是高信噪比下的小数点后两位。实际应用中信号往往很弱,高信噪比下的性能没有区分度。
相关的任务还包括频谱占用检测、干扰识别、射频指纹识别(通过发射机硬件的细微差异识别设备身份,ORACLE 是常用数据集)、以及辐射源个体识别。
9.4 合成孔径雷达目标识别
合成孔径雷达(SAR)通过平台运动合成一个等效的大孔径,从而获得高分辨率的雷达图像。它全天时全天候工作,是遥感和对地侦察的重要手段。
MSTAR 是这个领域的标准数据集,虽然年代久远(美军车辆的 SAR 切片),至今仍被广泛使用。A-ConvNets(2016)是经典基线,它去掉了全连接层改用全卷积,缓解了小样本条件下的过拟合。
近年的主要方向有几个。一是复值网络与知识引导,把 SAR 成像的散射机理编码进网络结构,2025 年有面向复值 SAR 图像识别的知识引导网络工作。二是小样本与域泛化——SAR 数据采集成本极高,如何从仿真数据迁移到实测数据、如何在扩展工作条件(俯角变化、型号变体、部分遮挡)下保持性能,是核心课题。三是频域辅助与可变形卷积,用于处理 SAR 图像对目标姿态高度敏感的特性。
对具身系统而言,这一块的相关性主要体现在无人机和无人车的对地感知,以及用遥感数据构建全局先验地图。
9.5 其他电磁量
超宽带(UWB)可以做到厘米级的测距和定位,常与惯性测量单元融合。深度学习在这里的主要作用是识别非视距传播情况并补偿由此产生的测距误差。
磁力计与地磁可以做室内指纹定位,用 CNN 或 LSTM 做序列匹配,成本极低,但容易受建筑物中铁磁材料的干扰。
卫星导航方面,深度学习主要用于多径和欺骗信号的检测,以及实时动态定位质量的预测。
声学
10.1 表征
音频信号的表征选择相对成熟。原始波形用于端到端模型(wav2vec 2.0、SincNet)。对数梅尔频谱是事件分类和场景分类的默认表征,它把频率轴按人耳的感知特性做了非线性压缩。
对于空间信息——也就是声音从哪个方向来——有几种专门的表征。广义互相关配合相位变换(GCC-PHAT)计算麦克风对之间的到达时间差,是声源定位的经典特征。SRP-PHAT 功率图把空间各个方向的似然值画成一张图,可以直接当成"声学图像"送进卷积网络。高阶球谐(Ambisonics)用一组系数紧凑地表达声场的方向分布。近年还有 SALSA 和 SALSA-Lite 这类专门为声音事件定位与检测任务设计的空间线索增强频谱。
10.2 网络与预训练模型
SELDnet 采用卷积加循环网络的结构,同时完成声音事件检测和方位估计,是 DCASE 系列挑战赛的基础框架。AST(Audio Spectrogram Transformer)和 PaSST 把 ViT 直接用在梅尔频谱上。
自监督方面,wav2vec 2.0 和 HuBERT 主要面向语音,BEATs 面向通用音频,用声学 tokenizer 配合掩码预测。跨模态方面,AudioCLIP 和 CLAP 把音频与文本对齐,从而支持用语言描述来检索或分类声音。
10.3 机器人语境下的声学感知
这一块常常被低估,但性价比很高。麦克风成本可以忽略不计,采样率通常在几十千赫兹(比视觉快两个数量级),而且在被遮挡时依然工作。
声源定位用于人机交互中判断说话人方位、以及定位异常声响。在混响明显的室内环境下,深度学习方法已经明显优于经典的 GCC-PHAT。
接触声学是另一种形式的触觉,这是近几年一个很有意思的发现。把接触式麦克风或压电片贴在夹爪上,敲击、划擦、倒水、插拔时产生的声音携带了视觉完全看不到的信息:容器里还剩多少液体、插头是否已经插到底、接触的是什么材质、有没有发生打滑。相关工作包括用听觉做接触密集型操作的 ManiWAV 与 Hearing Touch,以及通过主动敲击来感知物体的 SonicSense(CoRL 2024);2026 年还出现了利用声学空间信息做视听模仿学习的工作。
设备异常声检测用于机器人自身的故障预警,通常按无监督异常检测来做(因为故障样本稀少),DCASE 有专门的评测任务。
触觉与力觉
11.1 传感器类型决定了网络形态
触觉传感器的种类比其他模态更杂,而且不同类型的输出形式差异极大,因此有必要先分清楚。
视触觉传感器(GelSight、DIGIT、GelSlim、TacTip 等)在接触面覆盖一层弹性体,内部用一个小相机拍摄弹性体的形变。它的输出就是一张图像,因此可以直接复用整个计算机视觉的生态——这是它最大的工程优势,也是它近年发展最快的原因。Meta 的 Digit 360 进一步在同一个传感器里集成了图像、声音、惯性和压力等多种通道。
电容或磁性阵列(ReSkin、uSkin,以及各类电子皮肤)输出的是几十到几百维的低维时序信号。这类数据更适合用一维卷积、多层感知机或时序 Transformer 处理。它们的优势是可以做得很薄、覆盖面积大,适合做全手或全身的皮肤。
六维力/力矩传感器装在手腕上,输出三个方向的力和三个方向的力矩,是六维时序。通常与机器人本体状态拼接后一起处理。
11.2 从任务专用走向触觉基础模型
早期的触觉学习几乎都是"一个传感器加一个任务加一个从头训练的小网络"的模式:滑移检测训一个、材质分类训一个、位姿估计(如 Tac2Pose)再训一个。换个传感器型号就得重来。
近两年这个局面明显改变了。
T3(Transferable Tactile Transformers,2024)用"传感器专属编码器 + 共享主干 + 任务专属解码器"的结构,实现了跨传感器、跨任务的共享表征。UniT(2024)用向量量化自编码器学统一表征。
Sparsh(Meta,CoRL 2024)是这个方向的标志性工作。据论文,它在 46 万张以上无标注触觉图像上做自监督预训练,尝试了掩码重建和自蒸馏等多种方法,其中基于 DINO 和 I-JEPA 的变体表现最好。作者同时构建了 TacBench 评测基准,包含从触觉属性理解到物理感知与操作规划的六个任务。结果是:冻结的预训练特征加一个轻量探针,相比"针对具体任务和具体传感器从头端到端训练",平均提升 95.1%。这个数字来自作者自己的基准,但结论的方向性与视觉领域从专用模型转向基础模型的历程高度一致,可以说触觉领域到了它自己的"DINOv2 时刻"。
后续的 Sparsh-X(2025)把触觉图像、接触音频、惯性运动、压力这四种子模态融合成统一嵌入(面向 Digit 360 这类多通道传感器),Sparsh-Skin 面向磁性皮肤类传感器,2026 年的 TactX 进一步推进跨异构传感器的共享表征。
视触融合方面,See Through Your Skin(2020)是早期工作,MViTac 用对比学习对齐视觉与触觉,近年也有大量工作直接把触觉 token 拼进视觉-语言-动作模型的输入序列。
11.3 触觉真正不可替代的地方
触觉不是视觉的补充装饰,它解决的是视觉在物理原理上就获取不到的量。这一点值得说清楚,因为它决定了什么时候值得为触觉付出成本。
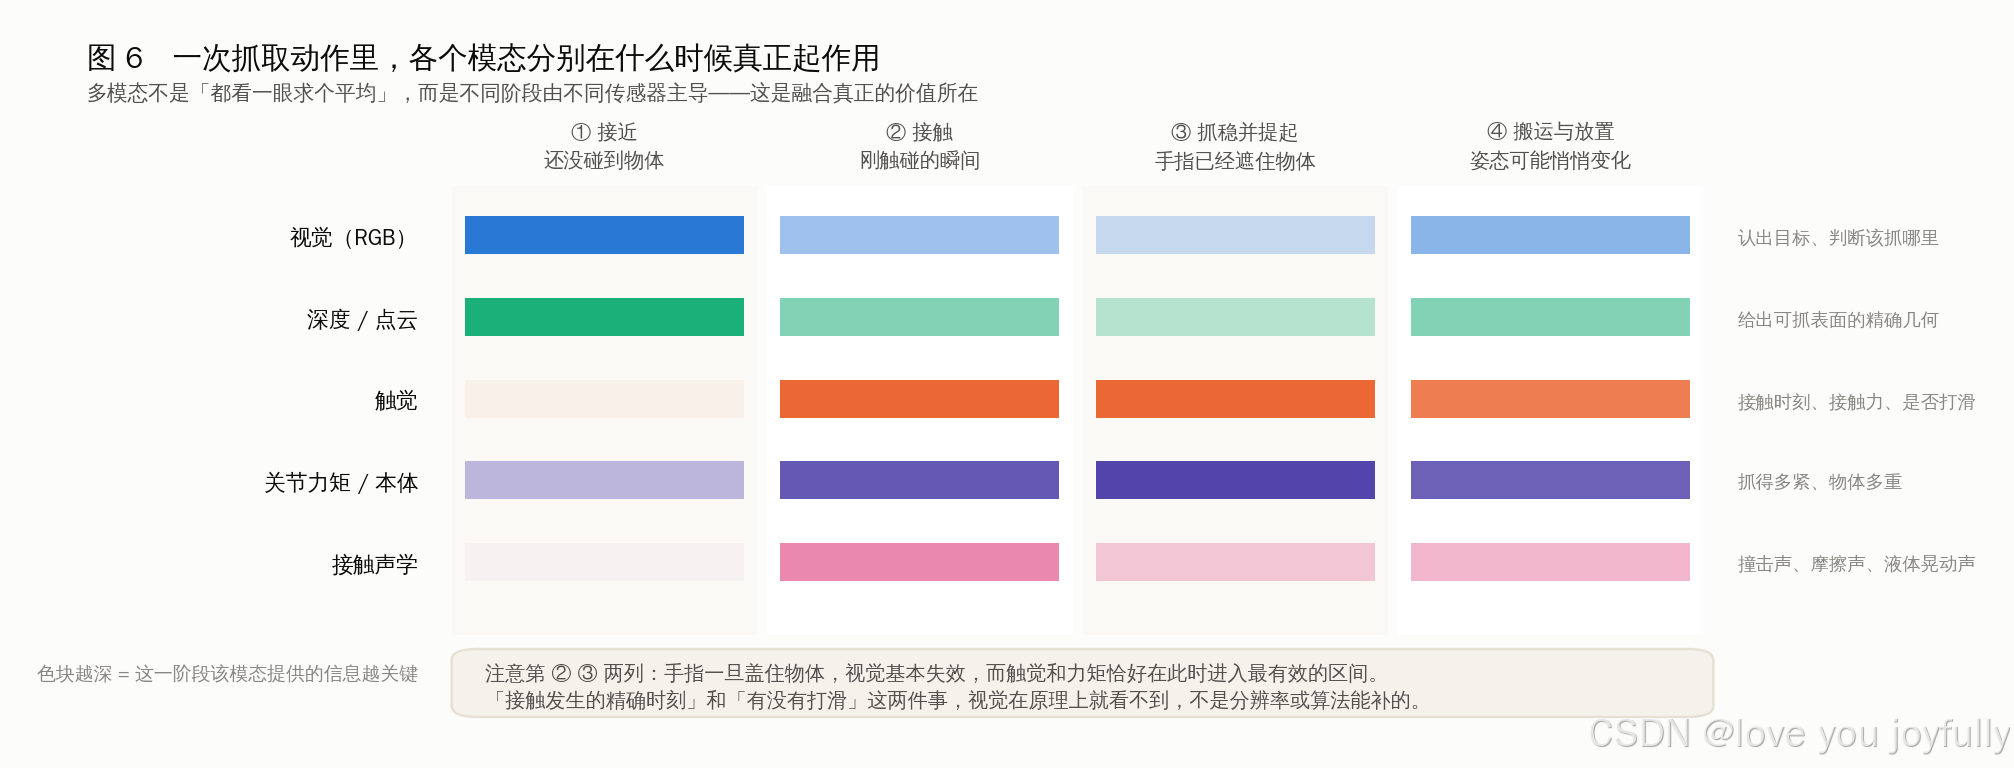
接触发生的精确时刻。 视觉有延迟、有遮挡,而且从图像上判断"碰到了没有"本质上是在猜测。触觉是直接测量,时间精度可以到毫秒级。
滑移。 物体开始滑动时,弹性体表面的切向力分布会出现特征性的微观变化,这个信号在视觉上完全不可见——等到从图像上看出物体在动,东西已经掉了。
接触力的大小与分布。 操作柔性物体(衣物、食材、生物组织)和精密装配都需要力控,而力只能测不能看。
手内物体的微小位姿变化。 抓住之后物体在手里转了几度,这个信息对后续放置至关重要,而此时物体多半已经被手指遮住。
上图展示的是一次完整抓取中各模态的分工。请特别注意第二、第三阶段:手指一旦盖住物体,视觉基本失效,而恰恰在这个区间触觉和关节力矩进入最有效的状态。这就是多模态融合真正的价值——不是"多看几眼求个平均",而是在不同阶段由不同传感器主导。
11.4 触觉的工程难点
触觉数据的采集成本极高,因为必须真机操作,无法像视觉那样从互联网上抓取。
更麻烦的是传感器个体差异。同一型号的两个 GelSight,因为弹性体制造批次、内部光源亮度、相机装配公差的不同,响应曲线可以有明显差别。在一个传感器上训练的模型换到另一个上就退化。这也是 T3、Sparsh、TactX 这条"传感器无关表征"路线的直接动机——如果每换一个传感器就要重新采数据重新训练,这个领域永远无法规模化。
本体感觉与惯性
12.1 数据性质与方法论
本体感觉指机器人对自身状态的感知:关节角度、关节速度、关节力矩、以及惯性测量单元给出的三轴加速度和三轴角速度。这类数据的特点是多通道、高频(惯性测量单元常在 100 到 1000 赫兹)、低维(几十到几百维)、时序依赖性强,而且已经有相当好的物理模型。
最后这一点决定了方法论。在视觉领域,从像素到语义的映射极其复杂,人类写不出解析式,所以端到端学习是自然选择。但在惯性导航领域,从加速度到位移的关系就是二次积分,这个物理模型完全正确——问题只出在传感器有偏置和噪声,积分会漂移。
因此这个领域的主流做法不是用网络替换物理模型,而是保留经过验证的物理与概率结构,用网络替换其中最难建模的那一项。这个思路值得推广到所有模态。
12.2 时序骨干的选择
一维卷积和时序卷积网络(TCN)适合固定窗口的动作分类,快、稳、容易部署,是嵌入式场景的首选。
DeepConvLSTM 用卷积提取局部模式、用长短期记忆网络建模长程依赖,是人体活动识别领域的经典基线。
时序 Transformer 近年发展很快。PatchTST 的"把序列分块加通道独立处理"是一个很强的默认配置;TimesNet 把一维序列按周期折叠成二维再用卷积处理,对有明显周期性的信号(比如步态)很合适;iTransformer 把注意力施加在变量维而非时间维上。
状态空间模型(S4、Mamba)适合超长序列,训练可并行、推理是常数内存的递归,对高频惯性数据和事件流都很契合。
图网络适合处理多个惯性单元或多关节之间的拓扑结构,因为人体和机器人的运动链天然是一张图。
12.3 惯性里程计与学习型状态估计
IONet(2018)用 LSTM 端到端回归位移增量,摆脱了纯积分的漂移。RONIN(2020)面向行人惯性导航,强调对设备佩戴姿态的无关性。
TLIO(2020)代表了这个领域最实用的范式:网络不直接输出位置,而是输出一个带不确定度的位移伪观测,再把它作为量测送进扩展卡尔曼滤波器。这样既利用了网络对复杂运动模式的建模能力,又保留了滤波器在状态估计上的理论保证和可解释性。
KalmanNet(2022)走得更远,用循环网络学习卡尔曼增益本身,在系统模型失配时仍保持滤波器的整体结构。
2025 年也有面向四足机器人的多惯性单元学习辅助状态估计工作,主要解决足端打滑造成的速度估计误差。
12.4 腿足机器人中的本体感觉
腿足机器人是本体感觉发挥作用最充分的场景,因为地形信息大部分要靠"踩上去之后感觉到了什么"来获得。
特权学习(也叫教师-学生训练)是这个领域的标准做法。在仿真环境里,我们知道地形高度图、摩擦系数、外力大小这些真实机器人无法直接测量的量。先用这些"特权信息"训练一个教师策略(这一步相对容易),再训练一个只能看到本体感觉历史序列的学生策略去模仿教师的行为。学生网络实际上被迫从本体历史中隐式地估计出环境参数——它感觉到脚落地时的冲击特征,就能推断地面是硬是软。苏黎世联邦理工的 ANYmal 系列工作(Science Robotics 2020)和 RMA(RSS 2021,在线系统辨识)是代表。
从感知的角度看,把最近若干帧的关节状态和惯性数据编码成隐状态的那个"观测编码器",本身就是一个感知模块。它感知的对象是"我自己和地面之间的关系"。
外感知与本体感觉的耦合方面,深度相机或激光雷达提供的地形高度图加上本体感觉,是四足越障的标准配置。近年的趋势是让学生策略直接从深度图像端到端学习,跳过高度图重建这一步,避免重建误差的累积。
12.5 视觉惯性融合
视觉惯性里程计(VIO)是移动机器人定位的主力技术。经典方法包括 VINS-Mono、OKVIS、ORB-SLAM3,都采用紧耦合的非线性优化。学习式方法有 DROID-SLAM(2021,用稠密光流配合可微光束法平差,鲁棒性很强)和更轻量的 DPVO。
现状与激光雷达里程计类似:几何方法在正常条件下仍然很强,学习方法的优势体现在弱纹理、剧烈运动、低照度这些退化场景。
其他模态
化学与气体传感用金属氧化物半导体阵列(俗称电子鼻)检测气体成分,配合一维卷积或循环网络做识别。应用包括气味源定位(通常需要结合风场做主动搜索)和泄漏检测。这类传感器的漂移非常严重,需要频繁校准,这是它难以大规模应用的主要障碍。
温湿度、气压等环境标量维度很低,一般直接拼进状态向量即可,不需要专门的网络。
生物电信号(肌电、脑电)用于外骨骼和假肢的意图识别,主流方法是卷积网络配合时序模型。跨被试泛化是核心难题——每个人的信号特征差异很大。
红外测距与超声是低成本的近距离避障手段,通常不需要深度学习。不过可以用一个很小的网络做多传感器之间的一致性校验,用来发现某一路传感器是否已经失效。
多模态融合
融合发生在哪一层
14.1 比"早中晚融合"更实用的分类
教科书通常把融合分成早期、中期、晚期三类,这个划分过于粗糙,实际设计时帮助有限。更有用的问法是:两路信息合流的时候,它们各自处在什么坐标系、什么抽象层级?
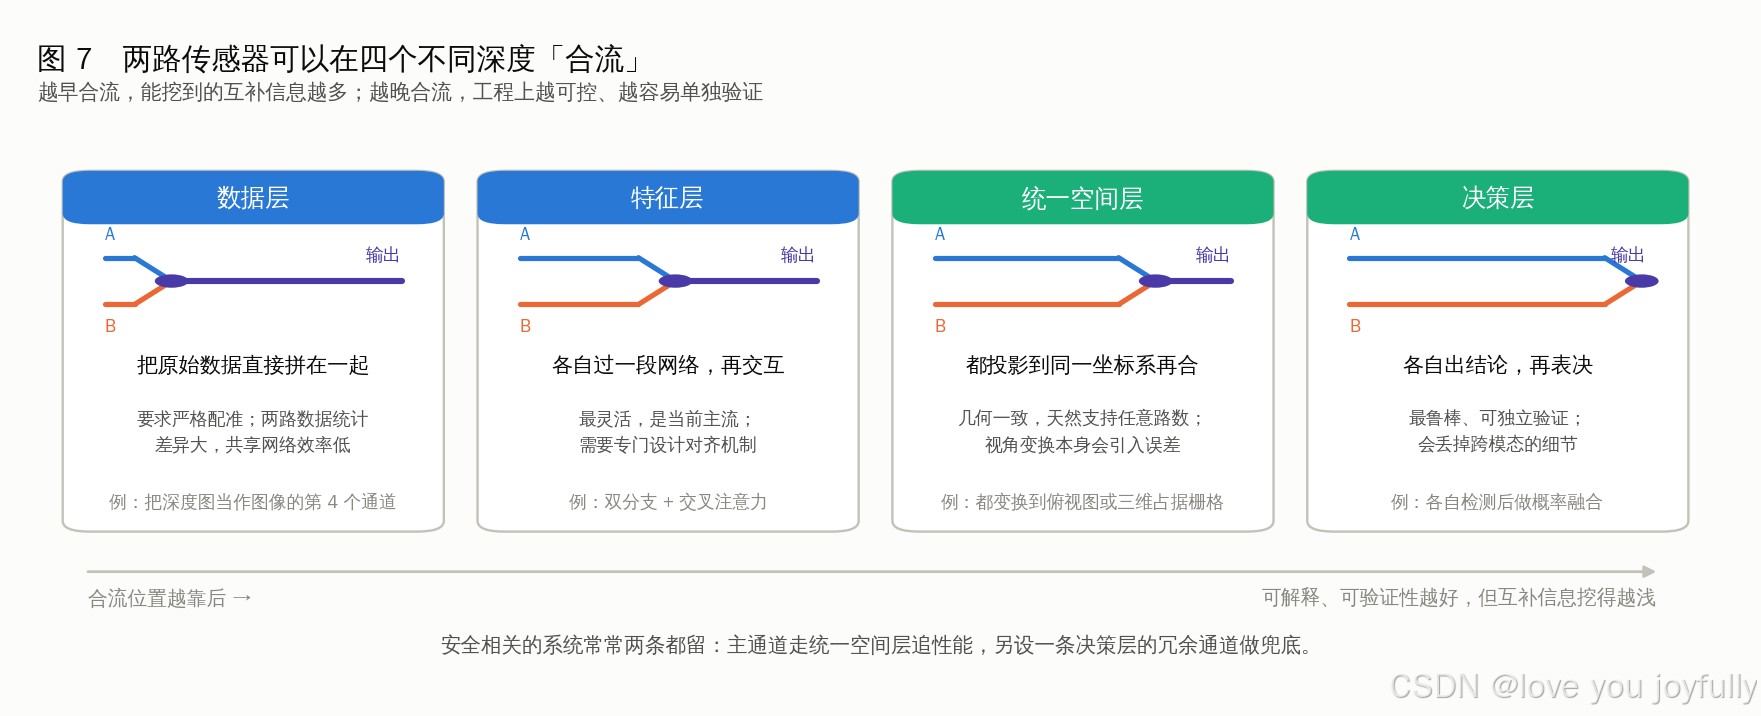
在数据层合流意味着把原始数据直接拼在一起,比如把深度图当成图像的第四个通道。这样做信息没有任何损失,但要求两路数据严格配准,而且两者的数值分布往往差异巨大,共享同一套网络参数效率不高。
在特征层合流是最常见的做法:两路各走一段网络提取特征,再通过注意力、门控或简单拼接来交互。灵活性最高,但需要专门设计对齐机制——两路特征在空间上未必对应同一个位置。
在统一空间层合流指的是先把所有模态都变换到同一个几何坐标系(最常见的是俯视图或三维体素网格),再在这个共同空间里融合。这条路的好处很实在:几何一致,天然支持任意数量的传感器,而且融合后的表征可以同时服务检测、分割、跟踪、规划等多个下游任务。代价是视角变换本身会引入误差,而且计算量不小。
在决策层合流指各路传感器独立完成感知,最后在结果层面做概率融合、非极大值抑制或跟踪滤波。这是最鲁棒的做法,每一路都可以独立验证,出问题时容易定位。代价是丢掉了跨模态的细节互补——两路各自都不确定的弱信号,本来合起来可能足以确认一个目标,但在决策层已经各自被丢弃了。
还有两种在近年变得重要的形式。查询式融合用一组可学习的查询向量分别到各个模态的特征上做交叉注意力采样,稀疏且高效,而且模态数量可变;BEVFormer、TransFusion、UniAD 都属于这一类。token 级融合把所有模态都切成 token 拼成一个长序列,扔进同一个 Transformer 甚至同一个大语言模型;这条路通用性最强,可以自然地接入语言,但算力开销大,而且缺乏几何先验。
安全相关的系统往往同时采用两条通路:主通路走统一空间层融合追求性能,另设一条决策层的冗余通路做兜底。纯粹的单通路端到端结构在功能安全上很难论证,这是一个现实约束而非技术偏见。
14.2 融合之前的准备
这一节的内容不涉及任何神经网络,但它决定了融合方案的上限。经验上,融合项目里"训练指标好、实车表现差"的问题,多数根源在这里而不在模型。
时间同步。 相机可能 30 Hz,激光雷达 10 Hz,雷达 20 Hz,惯性单元 200 Hz,这些数据流必须统一到同一个时间基准,并对每一帧做运动补偿。可靠性从高到低依次是硬件触发同步、基于 PTP/gPTP 的网络授时、以及最不可靠的软件时间戳。10 毫秒的不同步,在 10 米每秒的速度下就是 10 厘米的空间错位——足以让一个精心训练的融合网络失效。
外参标定。 相机与激光雷达之间、相机与红外之间、相机与惯性单元之间的相对位姿必须精确已知。标定误差会随距离放大:0.5 度的角度误差在 50 米外就是接近半米的偏差。在线自标定网络(CalibNet、LCCNet 一类)可以作为监控手段,定期检查标定是否漂移。
坐标系与运动畸变。 所有模态需要统一到车体或机体坐标系;激光雷达点云要做逐点去畸变;卷帘快门相机在剧烈运动时要做行级补偿。
统一表征:从俯视图到三维占据
15.1 为什么是俯视图
地面移动机器人和车辆的运动本质上是二点五维的——它们在一个近似平面上移动,垂直方向的变化有限。这个观察带来一个很有价值的表征选择:把所有传感器信息都变换到以地面为基准的俯视平面上。
俯视图(Bird’s-Eye View,BEV)的好处是具体的。这个空间里尺度是恒定的,不像图像里近大远小;物体不会互相遮挡叠置;多个传感器的数据天然对齐在同一张网格上;而且下游的路径规划本来就在这个平面上工作,不需要额外转换。
技术上的关键难点是如何把二维图像特征"抬升"到三维俯视空间,因为图像本身没有深度。目前有三条路线。
深度分布提升(Lift-Splat)的思路是:为图像上每个像素预测一个深度的概率分布,然后把该像素的特征按这个分布"撒"到视线上的各个三维位置,最后压到俯视平面。LSS(ECCV 2020)是奠基工作,BEVDet 做了工程化,BEVDepth 的关键改进是用激光雷达点云去监督那个深度分布,效果提升明显——这也说明深度估计的准确性是这条路线的瓶颈。
反向查询换了个方向:先在俯视网格上预设一组查询向量,每个查询投影回各个相机的图像平面,用可变形注意力在那里采样特征。BEVFormer(ECCV 2022)是代表,它还加入了时序自注意力来融合历史帧的俯视特征,从而获得速度估计能力。
BEVFusion 有两个同名工作(MIT 版发表于 ICRA 2023,北大版发表于 NeurIPS 2022),核心贡献是把相机俯视特征和激光雷达俯视特征在同一张网格上融合,并证明这种任务无关的统一表征可以同时服务多个下游任务,而且在某一路传感器失效时不会整体崩溃。它现在是多模态三维感知的标准起点。
15.2 俯视图不够用的地方
俯视图有一个内在的局限:它把高度压掉了。
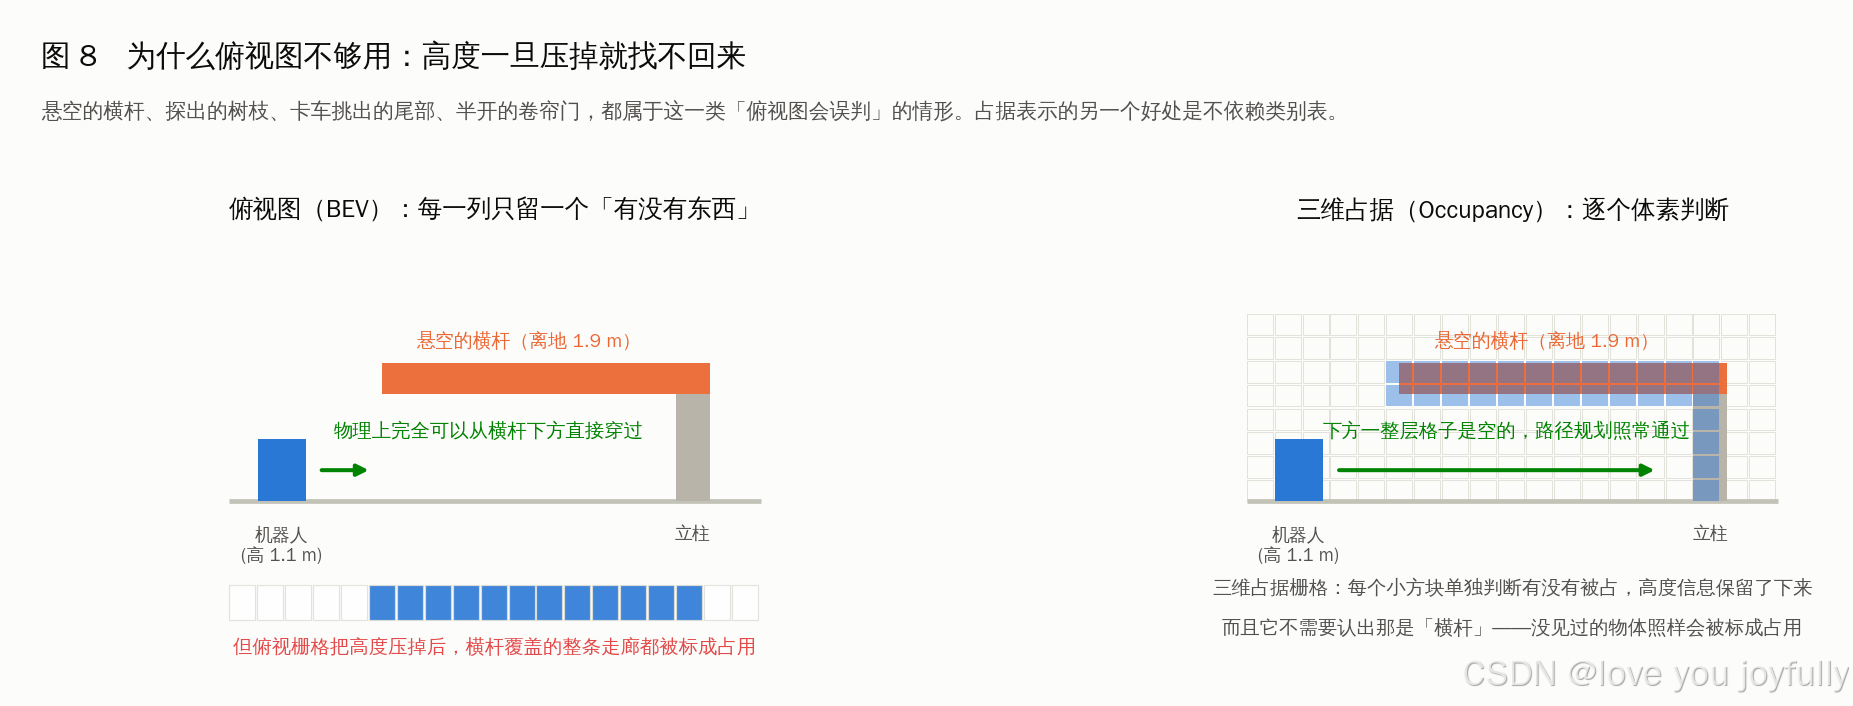
一根离地两米的横杆,在俯视图上会把它覆盖的整条走廊都标成障碍,而实际上机器人完全可以从下面通过。反过来,一辆卡车挑出的尾部在俯视图上可能只占一小格,但它实际上会在特定高度上阻挡通行。悬空的树枝、半开的卷帘门、桥下的限高结构,都属于这一类。
另一个局限更根本:基于检测框的表示依赖预定义的类别表。机器人在开放环境里遇到的绝大多数障碍物不在任何类别列表里——倒在路上的纸箱、掉落的货物、路面塌陷、施工设施。检测模型对没见过的类别要么漏检,要么强行归到某个已知类别。
三维占据表示(Occupancy)同时解决了这两个问题。它把空间切成三维体素,每个体素单独判断"是否被占据"、“是什么语义”,有的方法还预测"在往哪个方向运动"。高度信息得以保留,而且"被占据"这个判断不依赖类别——不认识的东西照样会被标记出来。对开放世界的具身智能来说,这个性质比多识别几个类别更重要。
15.3 占据预测的主要方法
MonoScene(CVPR 2022)开启了单目语义场景补全这个方向。TPVFormer(CVPR 2023)提出用三个正交平面(三视图平面)来近似完整的三维体素网格,大幅降低了计算量——这是一个典型的"用结构化近似换效率"的设计。SurroundOcc(ICCV 2023)面向环视多相机,并给出了稠密标签的生成流程(占据标注的获取本身就是个难题)。FB-OCC 结合了前向和反向两种视角变换,是 CVPR 2023 占据预测挑战赛的冠军方案。
SparseOcc 走完全稀疏路线,避免在大量空体素上浪费算力。GaussianFormer 和 GaussianOcc 用三维高斯基元代替规则体素,表示更紧凑也更连续。SelfOcc 和 OccNeRF 探索自监督占据预测,用体渲染作为监督信号,从而摆脱对昂贵三维标注的依赖。多模态方面,2025 年的 MS-Occ 做了多级的激光雷达-相机融合语义占据。
系统性的梳理可以参考《A Survey on Occupancy Perception for Autonomous Driving: The Information Fusion Perspective》(Information Fusion 2025),配套的 GitHub 仓库持续更新。
15.4 点级与查询级的激光雷达-相机融合
除了统一到俯视空间,还有几种更直接的融合方式。
PointPainting(CVPR 2020)的做法极其简单:把图像语义分割的类别分数投影到每个激光雷达点上,作为该点的额外特征。简单、有效、至今常用。PointAugmenting 用图像特征而非分数做同样的事。
TransFusion(CVPR 2022)采用两阶段结构:先用激光雷达特征生成一批物体查询,再让这些查询到图像特征上做交叉注意力去补充语义。这个顺序很关键——图像是"补充"而非"必需",因此对标定误差和图像质量下降更鲁棒。
DeepInteraction(NeurIPS 2022)提出了一个不同的观点:不要把两个模态的特征合并成一个,而是让它们持续交互但各自保留独立的表征,避免融合过程造成信息损失。CMT 和 SparseFusion 则走完全稀疏的查询式路线。
15.5 通用 token 化:让骨干与模态无关
当模态数量继续增加——视觉、触觉、听觉、本体、语言同时存在——为每一对模态设计专门的融合模块就不可持续了。于是出现了一批追求"模态无关"的通用结构。
Perceiver 与 Perceiver IO(2021)用固定数量的隐向量通过交叉注意力去"吸收"任意长度、任意模态的输入,把计算复杂度与输入规模解耦。Omnivore 和 OmniMAE(2022)用单一模型同时处理图像、视频和单视角三维数据。
ImageBind(CVPR 2023)的思路很巧妙:以图像为锚点,把文本、音频、深度、热成像、惯性这六种模态都对齐到同一个嵌入空间。它只需要每种模态与图像的配对数据(这类数据相对容易获得),就能得到任意两个模态之间的对齐能力。对于配对数据极度稀缺的机器人模态(触觉、雷达),这个范式很有价值。
Meta-Transformer(2023)证明了用冻结的共享 Transformer 可以编码 12 种模态,说明"模态专属的 tokenizer 加通用的共享编码器"这条路是可行的。
鲁棒性:融合最容易翻车的地方
16.1 一个反直觉但普遍存在的现象
一个只在"所有传感器都正常"的数据上训练出来的融合模型,在单路传感器退化时的表现可能比对应的单模态模型还差。
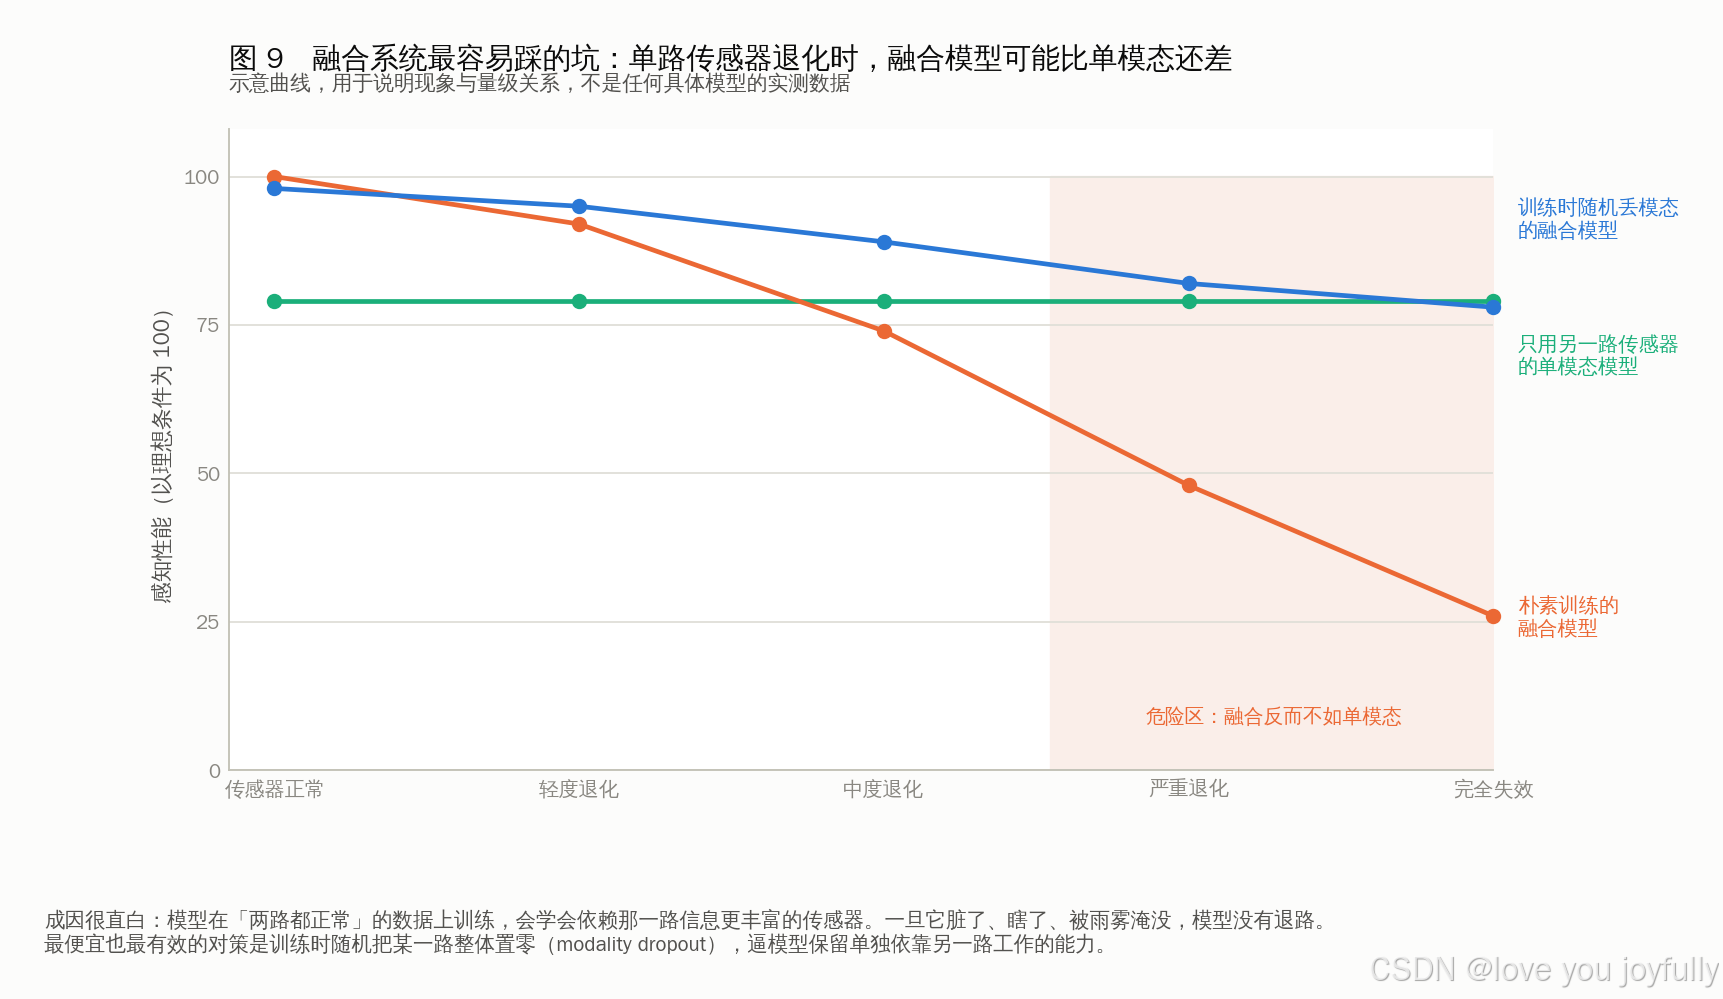
原因很直白。训练数据里两路都好用,模型自然会学会依赖那一路信息更丰富、更容易降低损失的传感器。一旦这一路被雨雾淹没、镜头脏了、或者干脆坏了,模型没有任何退路——它从来没学过只靠另一路工作。
这个现象在评审融合方案时特别值得警惕,因为标准的评测流程(在干净的验证集上比 mAP)根本发现不了它。
16.2 对策
训练时随机丢模态(modality dropout)是最简单也最有效的正则化手段:以一定概率把某一路输入整体置零,强迫模型保留单独依靠另一路工作的能力。几乎可以作为默认配置开启,成本极低。
基于不确定度的加权融合让每个模态分支在输出预测的同时输出一个不确定度估计(可以用异方差不确定度建模、深度集成、或证据深度学习等方法),融合时按不确定度的倒数加权。这个做法有一个额外好处:它同时给决策系统提供了"我有多确信"这个信号,可以用来触发降级策略或请求人工介入。
掩码模态投影与特征补全类的方法(如 2024 年的 MMP)训练模型把可用模态的特征投影到缺失模态的特征空间,从而在缺失时仍能维持完整的下游结构。
共享-特有解耦把特征分解成跨模态共享的部分和模态特有的部分,某一路缺失时,共享部分至少还在。
在鲁棒性基准上评测。RoboBEV、RoboDepth、nuScenes-C、Robo3D 这类基准专门评测传感器噪声、模态缺失、恶劣天气下的性能退化。评审一个融合方案时,退化曲线比干净数据上的绝对指标更有参考价值。 系统性的方法梳理可参考《Deep Multimodal Learning with Missing Modality: A Survey》。
第十七章 跨模态监督与蒸馏
有一类问题在前面已经反复出现:有些模态人类根本无法标注。没有人能看着一张距离-多普勒张量说出"这里有一个行人",也没有人能从 WiFi 信道数据里读出人的姿态。
解决办法是跨模态自动监督:用一个人类能标注、或者已有成熟模型的模态作为教师,去监督那个难以标注的模态。RODNet 用相机检测结果训练雷达网络,RF-Pose 用相机姿态估计训练射频网络,都是这个思路。对这些模态来说,跨模态监督不是可选项,而是唯一可规模化的路径。
同一个技术还有另一个用途:用昂贵的传感器组合训练,用廉价的组合部署。BEVDepth 用激光雷达监督相机的深度预测;BEVDistill、UniDistill、ICCV 2025 的 MemDistill 把激光雷达的知识蒸馏进纯视觉三维检测模型;CRKD(CVPR 2024)和 RCTDistill(2025)把"激光雷达加相机"教师的知识传给"雷达加相机"学生。在量产成本敏感的场合,这条路线的商业价值很直接。
第三个用途是仿真到现实的迁移。前面讲腿足机器人时提到的特权学习本质上也是跨模态蒸馏——教师用仿真中可得但现实中不可测的信息(地形高度图、摩擦系数),学生只用现实中可测的本体感觉。
感知与决策的融合
端到端自动驾驶
18.1 从模块串联到规划导向
传统的自动驾驶系统是一条模块化的流水线:感知(检测、分割、跟踪)→ 预测(其他交通参与者会怎么走)→ 规划(自车该怎么走)→ 控制。每个模块有明确的输入输出和独立的评价指标,可以分别开发、分别测试、分别回滚。
这个结构有两个内在问题。一是误差逐级累积——感知漏检一个目标,后面所有环节都无从补救。二是优化目标错配——检测的 mAP 提高两个百分点,不等于车开得更好;可能提升的都是远处无关车辆的检测精度,而真正影响决策的那几个目标并没有改善。
UniAD(CVPR 2023 最佳论文,标题是《Planning-oriented Autonomous Driving》)针对这一点提出:把检测、跟踪、建图、轨迹预测、占据预测、规划全部放进一个网络,用一组查询向量串联起来,所有中间任务都以最终的规划性能为导向联合优化。这是"感知决策一体化"范式的标志性工作。
后续的发展有几条线。VAD 与 VADv2(ICCV 2023 及后续)用矢量化的场景表示替代 UniAD 的稠密表示,大幅提速,VADv2 还引入了概率化的规划输出。GenAD(ECCV 2024)把规划建模成生成问题。PARA-Drive(CVPR 2024)指出全串行结构并非必要,改用并行的辅助任务结构,更快也更强。SparseDrive 走完全稀疏路线。DiffusionDrive(CVPR 2025)和 DiffAD 用扩散模型生成多模态的轨迹分布,解决了回归方法容易把多种合理选择"平均"成一条不合理轨迹的问题。
还有一条视觉语言模型化的路线:DriveVLM、Waymo 的 EMMA(2024,用多模态大模型直接从相机输出轨迹)、Senna 等,试图把互联网规模的常识引入长尾场景的处理。
世界模型路线则强调预测:GAIA-1、Drive-WM 生成未来的驾驶视频,OccWorld 和 4D 占据预测工作在占据空间里预测未来,2026 年的 GraphWorld 用世界模型做长时域规划。核心思想是让网络学会预测世界接下来会变成什么样,然后在想象中做规划。
18.2 一个必须知道的评测陷阱
nuScenes 数据集上的开环规划评测曾经是这个方向的主要指标,但它被证明存在严重的捷径:仅使用自车的历史状态、完全不看任何感知输入的简单多层感知机,就能取得接近当时最好方法的位移误差。原因是在这个数据集里,未来轨迹与历史轨迹的相关性太强,模型只要学会"保持当前运动状态"就能得到不错的分数。
这意味着只报告 nuScenes 开环 L2 误差的端到端工作,其证据强度是有限的。目前更可信的评测包括 NAVSIM(2024,非反应式仿真加更合理的驾驶评分)、Bench2Drive 与 CARLA 闭环评测。工业界最看重的接管率指标学术界通常无法获得。
看到一篇端到端论文时,先看它用什么评测,往往比看它的绝对数字更有信息量。
机器人的视觉-语言-动作模型
19.1 这条线在解决什么问题
传统的机器人策略是任务专用的:训练一个模型去拧螺丝,它就只会拧螺丝,换成拧瓶盖需要重新采数据重新训练。这个模式的成本使得机器人很难走出结构化的工厂环境。
视觉-语言-动作模型(VLA)试图借用大语言模型的路子:用一个在互联网规模数据上预训练过的多模态模型作为底座,让它同时理解视觉场景和语言指令,并直接输出机器人动作。期望是,从互联网数据中学到的常识和语义泛化能力,能够迁移到没见过的物体和场景上。
19.2 主要工作的脉络
RT-1(2022)用 EfficientNet 提取图像特征、用 FiLM 机制注入语言条件、用 Transformer 建模序列,动作被离散化成 token。PaLM-E(2023)把视觉和状态嵌入直接注入大语言模型,做具身推理。
RT-2(2023)是一个关键转折:它把机器人动作也表示成文本 token,然后在互联网视觉问答数据和机器人数据上联合微调一个视觉语言模型。这样做的结果是涌现出了此前没有的语义泛化能力——机器人能理解"把东西放到灭绝的动物旁边"这类需要外部知识的指令。
Open X-Embodiment(2023)汇集了 22 种机器人的数据,验证了跨本体训练存在正向迁移。Octo(2024)是开源的通用 Transformer 策略,用扩散动作头,支持灵活的输入输出配置。OpenVLA(2024)是一个 7B 参数的开源模型,值得注意的是它的视觉编码器采用 DINOv2 与 SigLIP 双编码器拼接——前者提供空间与几何对应能力,后者提供语义对齐能力。这个组合被反复验证有效,说明单一预训练目标很难同时给出好的空间感和好的语义。
π0(2024 年 10 月)在 PaliGemma 视觉语言模型基础上接了一个流匹配(flow matching)动作专家,输出连续的高频动作块,可达 50 Hz。π0.5(2025 年 4 月)强调开放世界泛化,展示了在完全没见过的真实家庭中执行长时程清洁任务的能力。RDT-1B 用扩散 Transformer 做双臂操作。
英伟达的 GR00T N1(2025 年 3 月)是开源的人形机器人基础模型,采用双系统架构:系统 2 是视觉语言模型负责慢思考,系统 1 是扩散 Transformer 负责快速动作生成。GR00T N1.6(2025 年 12 月,据官方页面)换用了内部的 Cosmos-2B 视觉语言模型变体(支持原生长宽比无需填充),把扩散 Transformer 从 16 层加深到 32 层,去掉了模型之后的四层适配器改为在预训练时解冻视觉语言模型顶部四层,并把动作预测从绝对关节角改为相对当前状态的增量。2026 年的 GR00T N1.7 据官方仓库和 HuggingFace 博客采用 Cosmos-Reason2-2B 作为系统 2 骨干,强调物理常识推理,并出现了面向手术机器人的领域版本。
Google DeepMind 的 Gemini Robotics 1.5 与 Gemini Robotics-ER 1.5(2025 年 9 月)采用"先思考再行动"的方式,生成内部推理链之后再产生动作,并用一个动作迁移层统一不同本体。
需要说明的是,这个领域迭代极快,上述版本号和日期在阅读时可能已经过时;其中 2026 年的条目部分来自官方仓库描述和二手报道,引用前建议核对原始来源。
19.3 从感知角度看几个关键设计
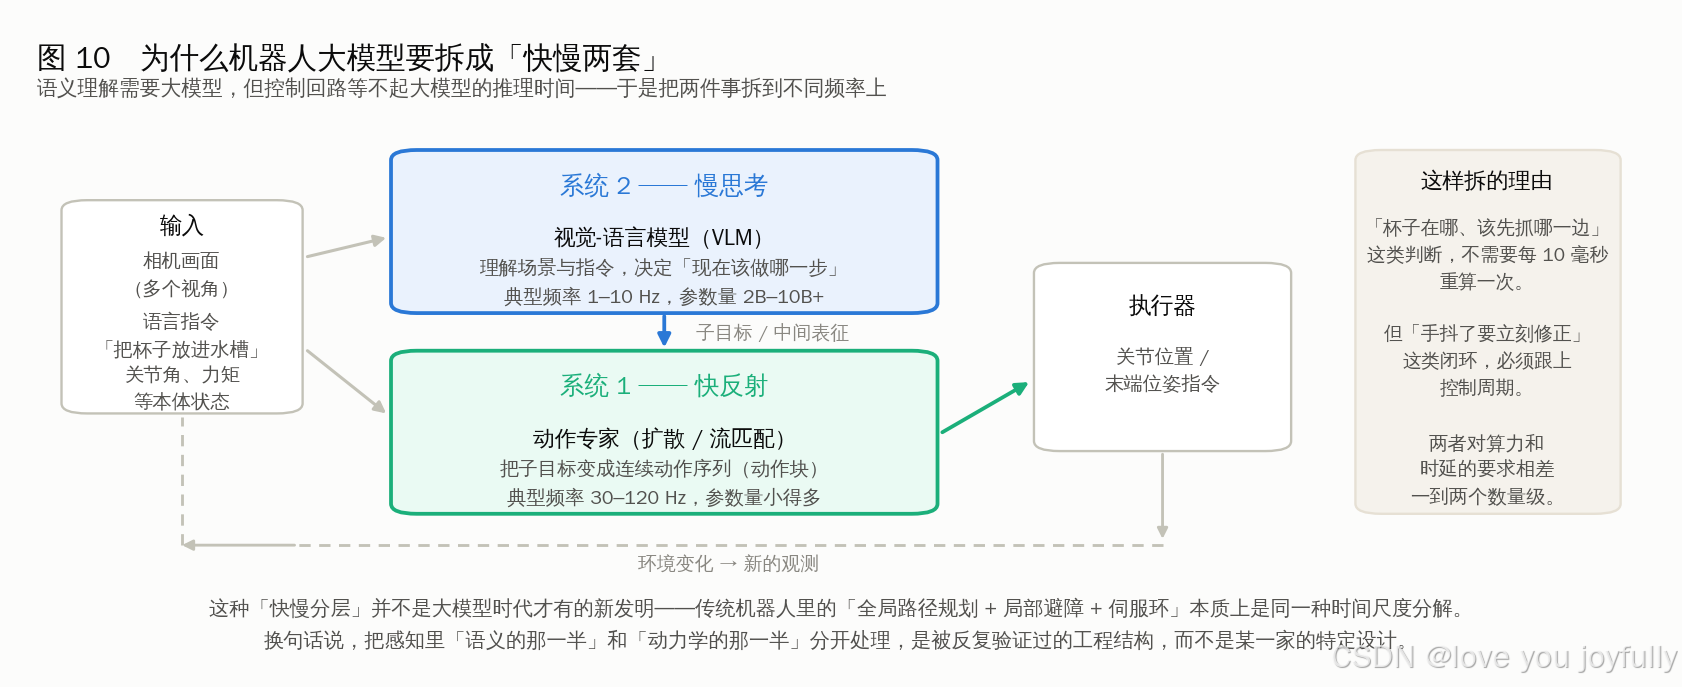
双系统结构的本质是时间尺度分解。 视觉语言模型参数量大、推理慢,只能跑到每秒几次到十几次;但机器人的闭环控制需要几十到上百赫兹。把"理解场景和指令、决定下一步做什么"这类语义判断交给慢的系统 2,把"根据当前状态生成平滑连续动作"交给快的系统 1,是解决这个矛盾的自然办法。
值得指出的是,这不是大模型时代才有的新发明。传统机器人系统里的"全局路径规划 + 局部避障 + 伺服控制环"本质上是同一种分解,只是每一层的实现方式不同。从感知的角度看,它做的事情是把感知里"语义的那一半"和"动力学的那一半"分开处理。
动作头有三条主要路线。 自回归离散 token(RT-2、OpenVLA)复用语言模型的词表,实现简单,但推理慢,而且动作精度受量化粒度限制。扩散或流匹配(π0、GR00T、RDT)输出连续动作块,天然能建模多模态的动作分布(同一个场景下有多种合理做法),适合高频控制,是目前的主流。回归加动作分块(ACT)一次预测未来若干步动作再用时序集成平滑,简单有效,在低成本双臂平台上应用广泛。
跨本体是一个尚未完全解决的问题。 不同机器人的关节数量、动作空间语义、运动学结构都不一样。目前的做法包括为每种本体配专属的编码解码头(GR00T 用 embodiment tag 标识)、统一的动作空间归一化、以及 Gemini Robotics 用的动作迁移层。
预测相对量比预测绝对量更容易。 GR00T N1.6 改用状态相对的动作预测后报告动作更平滑准确,这与视觉领域残差学习的经验、以及惯性里程计中预测位移增量而非绝对位置的做法,是同一个道理。
19.4 公开的挑战
多份综述在这几点上取得了共识:数据稀缺(机器人数据比视觉语言模型的预训练语料小六到八个数量级)、动作空间异构(跨本体迁移困难)、推理延迟(物理系统的实时约束)、真实交互能力不足、以及评测标准不统一(不同工作在不同平台不同任务上报告结果,难以横向比较)。
三维策略与世界模型
20.1 操作任务里,三维表征的样本效率优势
在桌面操作和灵巧操作这个子领域,有一个已被反复验证的结论:用三维点云作为输入,比用多视角二维图像的样本效率高得多。
Diffusion Policy(RSS 2023)把视觉运动策略建模成条件去噪扩散过程,解决了行为克隆中的一个老问题:同一个场景下人类演示可能有多种合理做法,用回归损失训练会把它们平均成一个不合理的中间值。扩散模型天然能表达多峰分布。它是目前模仿学习的标准基线。
DP3(3D Diffusion Policy,RSS 2024)把输入换成稀疏点云配合一个高效的点编码器。作者报告在同样的任务上,用远少于二维方法的演示数据(论文中多个任务用 10 条演示)就能达到更高成功率,而且对新视角、新物体、新场景的泛化更好。
iDP3(IROS 2025)改用自我中心的三维表征——直接在相机坐标系下处理点云,不做世界坐标系转换。这样就去掉了对精确相机标定和点云分割的依赖,让人形机器人能在没有预先布置的真实环境里工作。2026 年的 AnchorDP3 引入了可供性引导的稀疏扩散策略。
ACT 与 ALOHA 代表了另一条务实的路线:用低成本的双臂遥操作平台采集数据,配合动作分块 Transformer 训练,把数据采集和策略学习作为一个整体来设计。
关于表征选择,操作任务上有一条比较可靠的经验法则:需要精确几何接触的任务(插拔、装配、对准)用点云或三维表征;需要语义理解和开放词汇的任务(“拿起那个红色的马克杯”)用二维视觉语言模型特征;两者都需要时,用二维基础模型提取语义再投影到三维点上,形成"语义点云",这是目前最实用的折中。
20.2 世界模型
世界模型把感知从"识别现在"扩展到"预测未来"。这对决策的价值是直接的——规划本来就需要知道接下来会发生什么。
Dreamer 系列在学习到的隐空间里做想象式强化学习,跨领域通用性好。GAIA-1、Vista、Drive-WM 生成可控的驾驶视频。OccWorld 和各类 4D 占据预测工作在占据空间而非像素空间预测未来,计算量小得多,而且输出直接可用于规划——预测"哪些格子会被占据"比预测"每个像素是什么颜色"更贴近决策需要。Genie 系列从视频中学习可交互的环境。英伟达的 Cosmos 是面向物理 AI 的世界基础模型平台,被用作 GR00T 系统 2 的物理常识预训练来源。DreamVLA 尝试把世界模型的预测能力嵌进 VLA。
在实际系统中,世界模型目前有三种用法。作为数据引擎生成训练数据,以及作为仿真器做闭环评测,这两种已经在工业界大规模使用。作为策略内部的预测模块参与在线规划,目前主要还停留在研究阶段——生成的保真度和推理速度都还不足以支撑实时闭环。
第二十一章 显式感知与端到端:怎么选
这可能是做系统设计时最重要的一个判断,值得单独讨论。
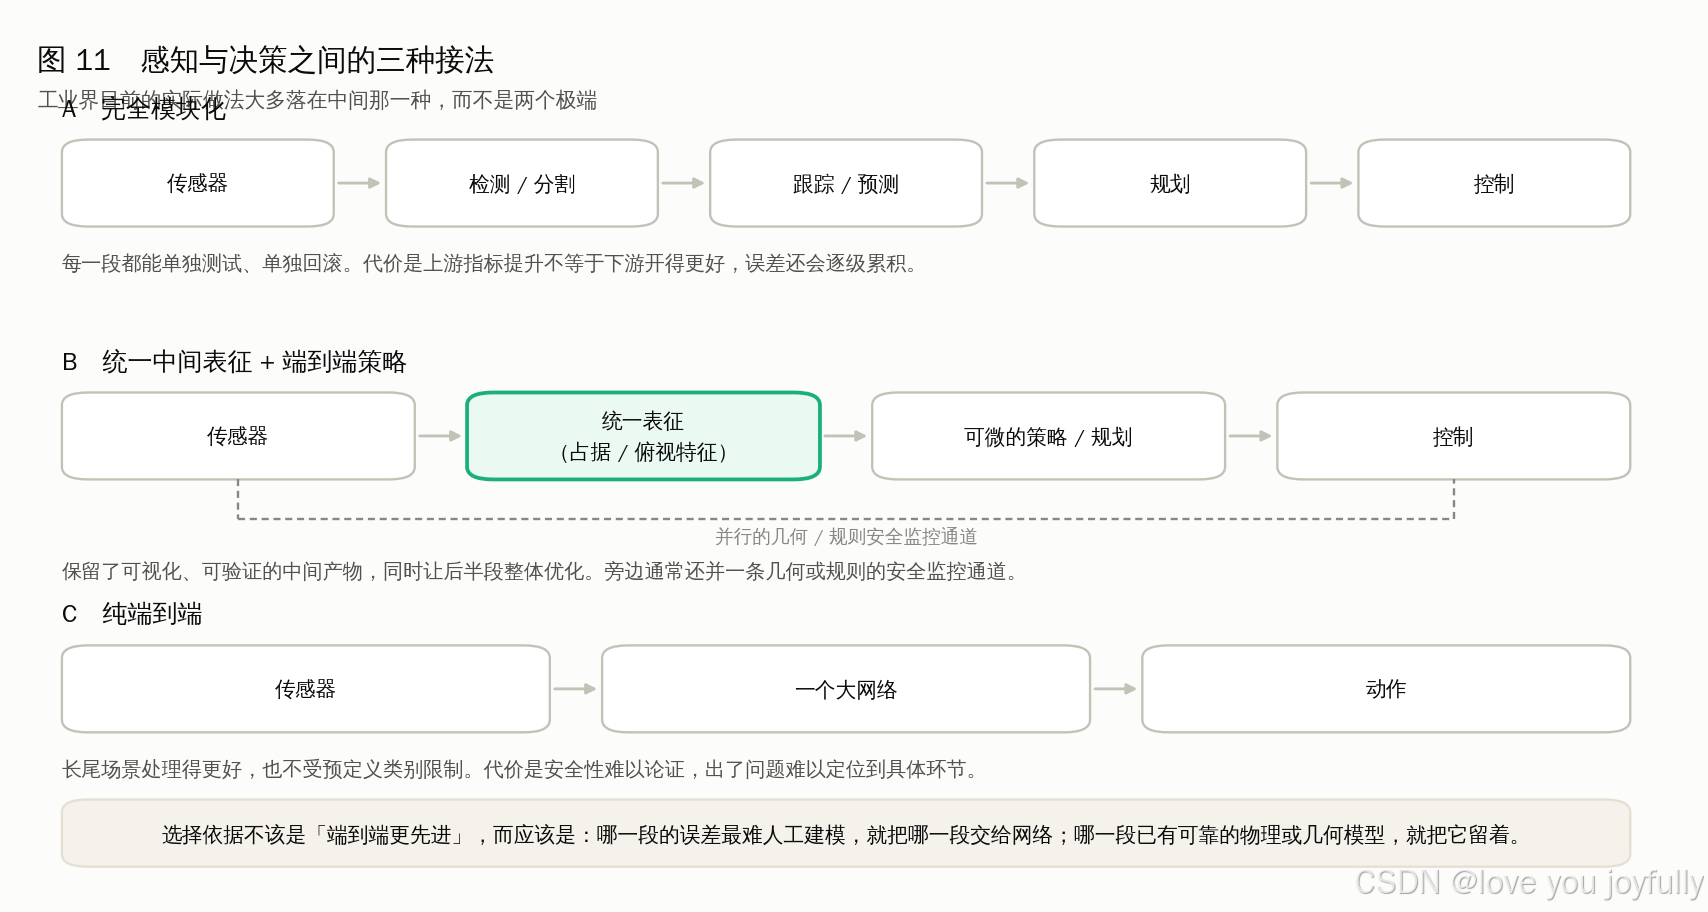
完全模块化的优势在工程属性上:每一段都能单独测试、单独验证、单独回滚;出了问题能定位到具体环节;各模块还可以用各自领域的大规模公开数据分别训练,数据效率高。劣势是误差累积和目标错配,以及受限于预定义类别、长尾场景处理能力弱。
纯端到端的优势在于全局优化、没有中间信息瓶颈、不受类别表限制、长尾场景处理更好。劣势也很实在:可解释性差,功能安全难以论证,需要大量端到端配对数据,而且改动任何一处都要重新验证整个系统。
目前工业界的实际做法几乎都是混合的。用基础模型或占据网络产出一个通用的中间表征(占据栅格、语义点云、俯视特征图),保留可视化和可验证的能力;在这个中间表征之上做端到端可微的策略或规划;同时并行保留一条基于几何和规则的安全监控通道做兜底。
给系统设计者的一条经验是:不要问"该用端到端还是模块化",而要问"哪一段的误差最难人工建模"。难以建模的那一段交给网络,已经有可靠物理或几何模型的那一段留着。前面讲过的 TLIO(网络输出带不确定度的伪观测,交给扩展卡尔曼滤波器融合)和 GR00T(视觉语言模型出语义,扩散头出动作)表面上属于完全不同的领域,本质上却是同一个设计哲学。
工程实践
选型
22.1 按任务选
下面这张表是把前面各章的结论浓缩成的速查索引,具体理由请回到对应章节。表格里的"首选"是指在没有特殊约束时的默认起点,不是唯一正确答案。
| 任务 | 表征 | 起点方案 | 什么时候改用备选 |
|---|---|---|---|
| 室外三维检测(车载) | 稀疏体素或柱 + 俯视图 | CenterPoint、DSVT | 感知距离超过 100 米时换完全稀疏结构(VoxelNeXt、SAFDNet) |
| 室外点云语义分割 | 稀疏体素 | PTv3、Cylinder3D | 时延要求极严时换距离图像(FRNet) |
| 室内点云理解 | 点或稀疏体素 | PTv3 | 需要部署到不支持自定义算子的硬件时换 MinkowskiNet |
| 通用视觉特征 | 图像 | 冻结的 DINOv3 + 轻量任务头 | 数据量大且领域特殊时改为微调 ConvNeXt 或 Swin |
| 开放词汇分割 | 图像 | SAM 3、Grounding DINO | 需要视频跨帧跟踪时用 SAM 2 及以上 |
| 单目深度 | 图像 | Depth Anything 3 | 需要真实米制尺度时用 Metric3D v2 一类度量深度模型 |
| 多视图几何与重建 | 多视图图像 | VGGT、Depth Anything 3 | 离线且要求极高精度时仍用 COLMAP 类传统流程 |
| 恶劣天气冗余 | 4D 雷达点云 | RTNH、RadarPillars + 与相机融合 | 需要更高灵敏度时改用距离-多普勒张量 |
| 高速运动或极端光照 | 事件体素网格 | RVT、状态空间模型 | 有神经形态硬件且功耗敏感时用脉冲网络 |
| 桌面操作策略 | 稀疏点云 | DP3、iDP3 | 需要语义泛化和语言指令时改为二维视觉语言特征 |
| 语言指令操作 | 图像 + 语言 | OpenVLA、π0.5、GR00T | 任务结构清晰时用"视觉语言模型规划 + 低层技能库"的分层方案 |
| 时序信号(惯性、力、音) | 多通道序列 | 边缘端 TCN,服务器端 PatchTST | 序列极长时用 Mamba 一类状态空间模型 |
22.2 按平台算力选
在嵌入式平台上,能不能跑得动往往比精度高低更早成为约束。下面给出几个常见平台的量级参考。
算力在 1 TOPS 以下的微控制器和数字信号处理器,能跑的是量化后的一维卷积、微型二维卷积(关键词唤醒、简单动作识别),以及脉冲网络。
Jetson Orin Nano 与 Orin NX 这一档(40 到 100 TOPS 量级)可以跑 YOLO 系列、PointPillars、轻量的俯视图网络、以及小型单目深度模型。
Jetson AGX Orin(约 275 TOPS)可以支撑多路相机的俯视图融合、CenterPoint 类的三维检测,以及经过量化的中等规模视觉语言动作模型。
Jetson AGX Thor(2025 年 8 月上市)是这一代的显著跃升。据英伟达官方技术博客,其 T5000 模块基于 Blackwell 架构,标称约 2070 FP4 TFLOPS(稠密 FP4 约 1035 TFLOPS),配备 128 GB LPDDR5X 内存、273 GB/s 带宽,功耗上限 130 瓦,官方称相比 AGX Orin 有约 7.5 倍的 AI 算力和约 3.5 倍的能效。这意味着此前因算力不足而被放弃的方案——机端运行多模态大模型、高分辨率占据网络——需要重新评估。
车规域控平台可以到数百至上千 TOPS,能够支撑完整的端到端多模态加占据网络。
22.3 延迟预算
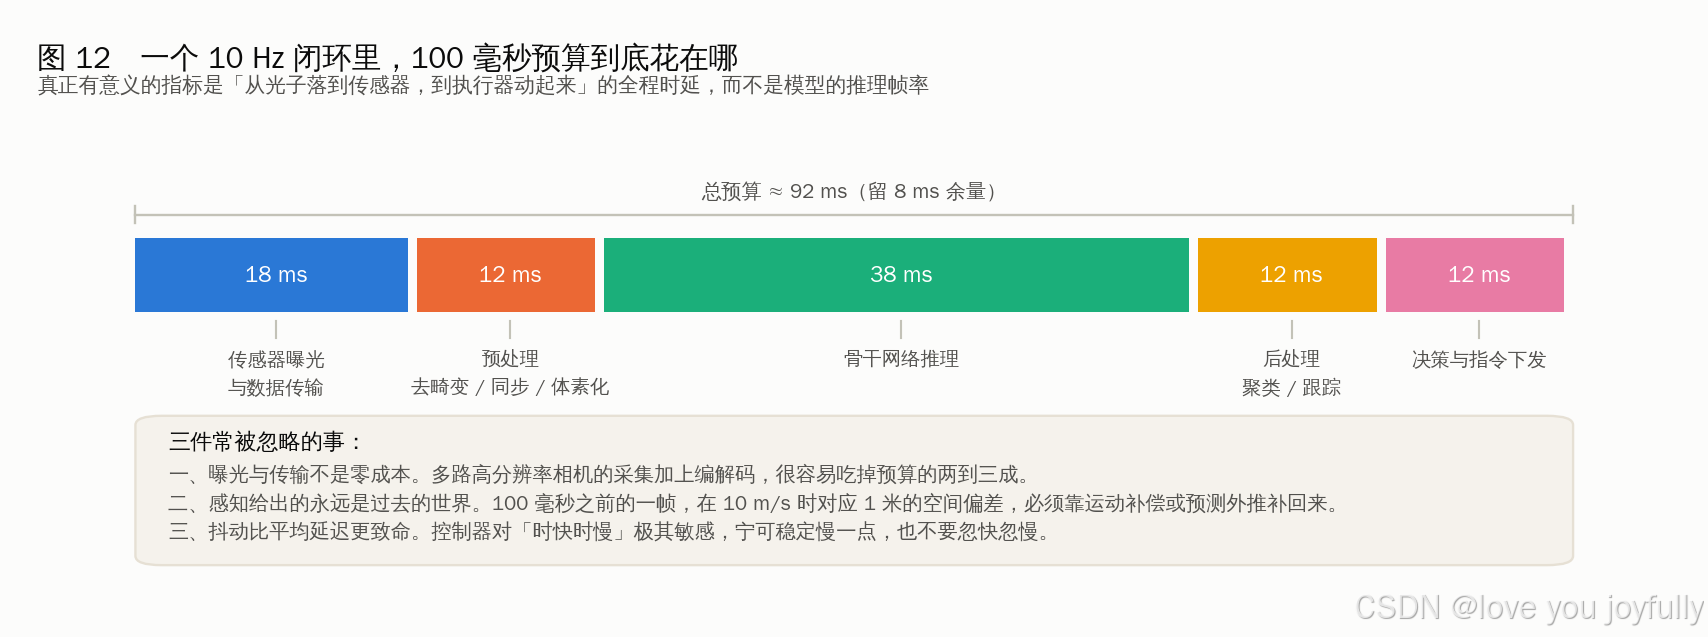
关于延迟,有三点在实践中最容易被忽略。
第一,传感器的曝光与数据传输不是零成本。多路高分辨率相机的采集、编解码和传输,很容易占掉整个预算的两到三成。只测量模型推理时间会严重低估实际时延。
第二,感知输出的永远是过去的世界。一帧在 100 毫秒之前采集的数据,在 10 米每秒的速度下对应一米的空间偏差。必须通过运动补偿或预测外推把这段时间差补回来,否则系统会表现出稳定的滞后。
第三,抖动比平均延迟更致命。控制器对"时快时慢"极其敏感,一个平均 50 毫秒但在 30 到 90 毫秒之间波动的系统,往往比一个稳定 70 毫秒的系统更难调。实践中应该用固定时间片调度,避免动态批处理带来的不确定性。
22.4 部署优化
量化方面,INT8 是安全线,绝大多数模型精度损失可接受。FP8 和 FP4 在较新的硬件上有原生支持,对 Transformer 类模型收益尤其明显。需要注意稀疏卷积和各类自定义算子往往是量化流程中最难处理的部分。
图优化方面,TensorRT、ONNX Runtime、TVM 都能做算子融合和层间内存复用,通常能带来可观的加速。
架构选择时就应该考虑部署友好性,而不是等训练完再想办法。前面提到 DSVT 明确宣称避免自定义 CUDA 算子,PointPillars 长盛不衰的一个重要原因是它退化成了标准二维卷积——这些都不是巧合。
多模型调度方面,视觉语言动作模型的双系统结构天然适合"大模型低频异步 + 小模型高频同步"的流水线组织。
数据集与基准索引
| 类别 | 常用数据集 |
|---|---|
| 通用视觉 | ImageNet、COCO、ADE20K、LVIS、Objects365 |
| 驾驶多模态 | nuScenes(相机 + 激光雷达 + 雷达)、Waymo Open、KITTI、Argoverse 2、ONCE、ZOD |
| 三维占据 | Occ3D、OpenOccupancy、SemanticKITTI-SSC、SurroundOcc |
| 点云分割 | SemanticKITTI、ScanNet 与 ScanNet++、S3DIS、nuScenes-lidarseg |
| 单目深度 | KITTI、NYUv2、DDAD、ETH3D、DIODE |
| 红外与 RGB-T | KAIST、FLIR ADAS、LLVIP、MFNet、M3FD、VTUAV |
| 事件相机 | N-Caltech101、N-Cars、Gen1、1Mpx、DSEC、MVSEC |
| 雷达 | CARRADA、RADIal、K-Radar(4D + 多天气)、View-of-Delft、TJ4DRadSet、Astyx |
| 射频与 WiFi | Widar3.0、SignFi、SenseFi(工具箱)、RadioML 2016/2018(调制识别)、ORACLE(射频指纹)、MSTAR(SAR) |
| 音频 | AudioSet、ESC-50、DCASE SELD、UrbanSound8K |
| 触觉 | TacBench(Sparsh 配套)、Touch and Go、YCB-Slide、ObjectFolder |
| 惯性与人体活动 | UCI-HAR、PAMAP2、Opportunity、Ego4D(第一人称多模态) |
| 机器人操作 | Open X-Embodiment、DROID、BridgeData V2、RoboMimic;仿真环境有 RLBench、ManiSkill、LIBERO、CALVIN |
| 端到端驾驶评测 | NAVSIM、Bench2Drive、CARLA Leaderboard |
| 鲁棒性评测 | RoboBEV、RoboDepth、nuScenes-C、Robo3D |
常见陷阱
下面这些问题按在实际项目中出现的频率大致排序。它们的共同特点是:症状往往表现为"模型效果不好",但根因不在模型。
时间同步没做对。 典型症状是静止时一切正常、一运动就飘。遇到这种情况应该先查时间戳,再查模型。
外参标定漂移。 典型症状是投影可视化看起来"差一点点",但融合精度掉了很多。建议加在线标定监控。
深度图的无效值被当成零处理。 会导致模型把玻璃、黑色物体、强光区域全部判成近距离障碍。
点云没做运动去畸变。 机械旋转式激光雷达上这一步是必做的。
融合模型在单模态失效时崩溃。 训练时加模态 dropout,评测时看退化曲线。
训练与部署的预处理不一致。 归一化参数、色彩空间、缩放插值方式的细微差别,都会造成"离线指标好、在线不对"。这是最容易排查也最容易被忽略的一类问题。
红外的季节性域偏移。 训练集必须跨季节采集。
把雷达点云直接套用激光雷达的网络。 两者稀疏度相差一个数量级,邻域尺度和体素大小都需要重新设计。
射频与信道感知模型的跨域崩溃。 测试集必须包含训练时未见过的房间和被试,否则指标没有参考意义。
用开环指标评价闭环系统。 nuScenes 开环位移误差、单帧 mAP 这类指标与实际闭环性能的相关性有限。
只在干净数据上评测。 雨雪、逆光、灰尘、传感器脏污的数据应该单独建立测试集。
忽略执行延迟。 感知给出的是过去的世界,控制作用于未来的世界。
触觉和事件相机的传感器个体差异。 同型号不同个体需要单独标定,或者使用传感器无关的表征。
在没有神经形态硬件的前提下使用脉冲网络。 在通用 GPU 上,脉冲网络几乎必然打不过同等规模的传统网络。
趋势判断
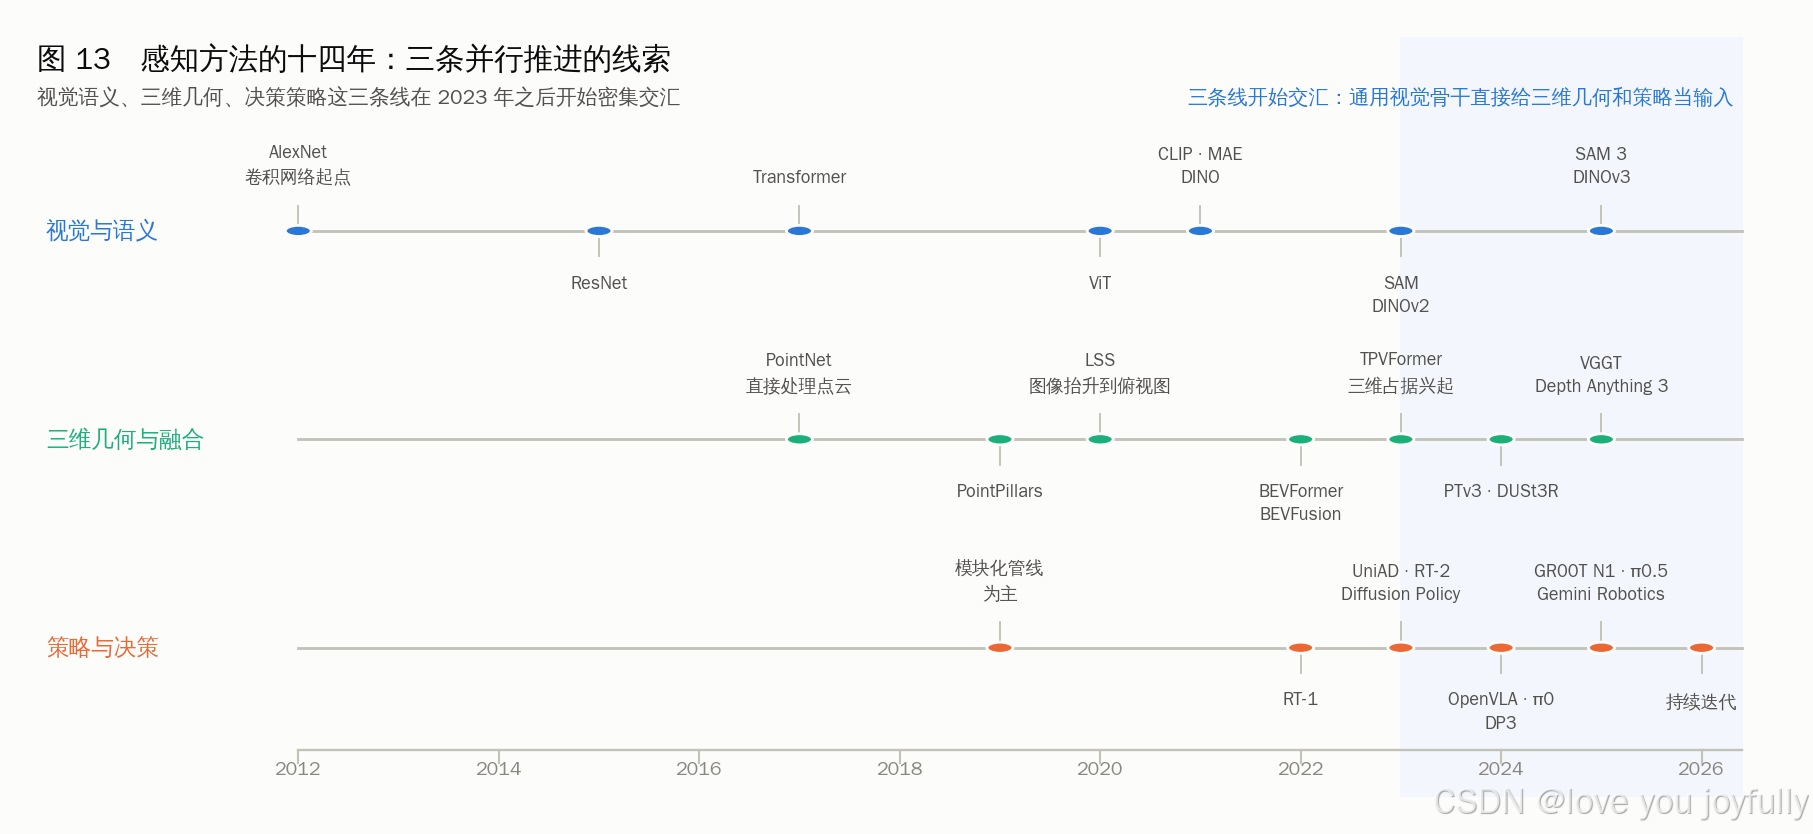
感知骨干的基础模型化会继续,并逐步覆盖长尾模态。 视觉(DINOv3、SAM 3)和几何(VGGT、Depth Anything 3)这两块基本完成了,触觉(Sparsh 系列)刚刚完成。雷达、事件相机、射频感知的"基础模型时刻"很可能是接下来两三年的事情。判断某个模态是否走到这一步,有一个简单的标志:是否出现了"冻结特征加轻量探针就能超过任务专用模型"的结果。
中间表征会继续向三维占据和高斯基元收敛。 类别无关的几何加上可挂载的语义特征场,是开放世界具身智能比较自然的接口形式。
动作生成向流匹配和扩散收敛,双系统架构成为标配。 这个方向的主要矛盾已经从"能不能做"转向"延迟和成功率",属于工程优化阶段。
世界模型会从"数据引擎"逐步走向"策略内部件"。 目前它主要用于生成训练数据和做闭环仿真,进入在线规划回路还需要保真度和速度上的进一步突破。
跨模态自动监督将决定哪些模态能规模化。 对于人类标不动的模态——雷达张量、信道状态信息、SAR 图像、触觉——谁先解决自动监督问题,谁就先具备规模化的条件。
鲁棒性与可验证性会成为竞争焦点。 当各家在干净数据上的指标趋同之后,退化条件下的表现和功能安全的论证能力才是真正的差异所在。
边缘算力的跃升正在改变架构选择。 Jetson Thor 这一代的算力提升幅度足以让一批此前被放弃的方案重新变得可行,值得定期重新评估技术选型。
附录 A 术语速查
| 术语 | 含义 |
|---|---|
| 表征(Representation) | 把原始信号整理成网络能接受的张量形式,是感知链路中最关键的设计决策 |
| BEV | Bird’s-Eye View,鸟瞰图/俯视图表征,把三维信息压到地面平面上 |
| Occupancy | 三维占据栅格,逐个体素判断是否被占据以及语义类别 |
| SSC | Semantic Scene Completion,语义场景补全,从部分观测推断完整三维场景 |
| LSS | Lift-Splat-Shoot,通过预测深度分布把图像特征抬升到三维的经典方法 |
| 稀疏卷积 | 只在非空体素上计算的卷积,是点云网络效率的基础 |
| 空间填充曲线 | 把多维空间映射成一维序列且保持局部性的曲线(Z 序、Hilbert),PTv3 序列化的核心 |
| CFAR | 恒虚警率检测,雷达传统信号链中丢弃大部分回波的那一步 |
| RD / RA / RAD | 距离-多普勒 / 距离-方位 / 距离-方位-多普勒张量 |
| I/Q | 同相与正交分量,无线信号的复数表示 |
| CSI | Channel State Information,WiFi 信道状态信息 |
| DOA | Direction of Arrival,波达方向,即信号来自哪个方位 |
| SNN | Spiking Neural Network,脉冲神经网络 |
| VLA | Vision-Language-Action,视觉-语言-动作模型 |
| 动作分块 | 一次预测未来多步动作而非单步,配合时序集成使动作更平滑 |
| 流匹配 | Flow Matching,扩散模型的一种连续时间表述,动作生成中常用 |
| 特权学习 | 教师用仿真中可得但现实不可测的信息训练,学生只用现实可测量模仿 |
| 模态 dropout | 训练时随机丢弃某一路输入,提升单路失效时的鲁棒性 |
| 跨模态蒸馏 | 用一个模态(或更贵的传感器组合)监督另一个模态的训练 |
附录 B 主要参考来源
综述与持续更新的索引仓库
- A Survey on Occupancy Perception for Autonomous Driving: The Information Fusion Perspective — https://github.com/HuaiyuanXu/3D-Occupancy-Perception | https://www.sciencedirect.com/science/article/abs/pii/S1566253524004494
- Multi-sensor fusion on autonomous driving perception: A comprehensive survey — https://www.sciencedirect.com/science/article/pii/S2772586326000377
- Multimodal Sensor Fusion in Autonomous Vehicles: Technologies, Architectures, and Open Challenges — https://www.mdpi.com/1424-8220/26/11/3528
- Awesome Radar Perception — https://github.com/Radar-Camera-Fusion/Awesome-Radar-Perception
- Awesome RGB-T — https://github.com/VisionVerse/Awesome-RGBT
- Awesome Multi-Camera 3D Occupancy Prediction — https://github.com/lvchuandong/Awesome-Multi-Camera-3D-Occupancy-Prediction
- Event Camera 顶会论文索引 — https://github.com/Event-AHU/Event_Camera_in_Top_Conference
- Awesome NeRF & 3DGS SLAM — https://github.com/3D-Vision-World/awesome-NeRF-and-3DGS-SLAM
- Awesome IMU Sensing — https://github.com/rh20624/Awesome-IMU-Sensing
- Deep Multimodal Learning with Missing Modality: A Survey — https://arxiv.org/pdf/2409.07825
- Pure Vision Language Action Models: A Comprehensive Survey — https://arxiv.org/html/2509.19012v1
- Review of Feed-forward 3D Reconstruction: From DUSt3R to VGGT — https://arxiv.org/abs/2507.08448
- A Comprehensive Survey on SAR ATR in Deep-Learning Era — https://www.mdpi.com/2072-4292/15/5/1454
- Wi-Fi Sensing Techniques for Human Activity Recognition(ACM Computing Surveys)— https://dl.acm.org/doi/10.1145/3705893
- A Review on Sound Source Localization in Robotics: Focusing on Deep Learning Methods — https://www.mdpi.com/2076-3417/15/17/9354
具体方法的原始文献
- Point Transformer V3: Simpler, Faster, Stronger(CVPR 2024)— https://arxiv.org/pdf/2312.10035
- BEVFusion: Multi-Task Multi-Sensor Fusion with Unified BEV Representation — https://arxiv.org/pdf/2205.13542 | https://github.com/mit-han-lab/bevfusion
- SAFDNet: A Simple and Effective Network for Fully Sparse 3D Object Detection — https://arxiv.org/html/2403.05817v3
- VoxelNeXt: Fully Sparse VoxelNet for 3D Object Detection and Tracking — https://arxiv.org/abs/2303.11301v1
- Depth Anything 3: Recovering the Visual Space from Any Views — https://depth-anything-3.github.io/ | https://arxiv.org/html/2511.10647v1 | https://github.com/ByteDance-Seed/Depth-Anything-3
- SAM 3: Segment Anything with Concepts — https://arxiv.org/abs/2511.16719 | https://ai.meta.com/blog/segment-anything-model-3/
- Recurrent Vision Transformers for Object Detection with Event Cameras(CVPR 2023)— https://arxiv.org/abs/2212.05598
- Hybrid Spiking Vision Transformer(2025)— https://arxiv.org/html/2505.07715v1
- Real-Time Frame- and Event-based Detection with SNN on Edge Neuromorphic Hardware — https://arxiv.org/html/2605.00146v1
- Sparsh: Self-supervised touch representations for vision-based tactile sensing — https://arxiv.org/abs/2410.24090 | https://sparsh-ssl.github.io/
- Tactile Beyond Pixels(Sparsh-X)— https://arxiv.org/abs/2506.14754 | https://github.com/facebookresearch/sparsh-multisensory-touch
- Transferable Tactile Transformers (T3) — https://arxiv.org/html/2406.13640v3
- Planning-oriented Autonomous Driving (UniAD) — https://arxiv.org/pdf/2212.10156
- Rethinking the Open-Loop Evaluation of End-to-End Autonomous Driving in nuScenes — https://arxiv.org/abs/2305.10430
- OpenVLA — https://arxiv.org/abs/2406.09246
- π0.5: a Vision-Language-Action Model with Open-World Generalization — https://www.pi.website/blog/pi05 | https://arxiv.org/html/2504.16054v1
- GR00T N1(含 N1.5 / N1.6 / N1.7 后续)— https://arxiv.org/pdf/2503.14734 | https://research.nvidia.com/labs/gear/gr00t-n1_6 | https://huggingface.co/blog/nvidia/gr00t-n1-7
- Gemini Robotics 1.5 / ER 1.5 — https://deepmind.google/blog/gemini-robotics-15-brings-ai-agents-into-the-physical-world/
- Diffusion Policy — https://diffusion-policy.cs.columbia.edu/
- 3D Diffusion Policy (DP3) — https://www.roboticsproceedings.org/rss20/p067.pdf | iDP3: https://arxiv.org/html/2410.10803v3
- CVFusion: Cross-View Fusion of 4D Radar and Camera(ICCV 2025)— https://openaccess.thecvf.com/content/ICCV2025/papers/Zhong_CVFusion_Cross-View_Fusion_of_4D_Radar_and_Camera_for_3D_ICCV_2025_paper.pdf
- RCTDistill(雷达-相机跨模态蒸馏)— https://arxiv.org/pdf/2509.17712
- MemDistill: Distilling LiDAR Knowledge into Memory(ICCV 2025)— https://openaccess.thecvf.com/content/ICCV2025/papers/Kwon_MemDistill_Distilling_LiDAR_Knowledge_into_Memory_for_Camera-Only_3D_Object_ICCV_2025_paper.pdf
- Meta-Transformer — https://kxgong.github.io/meta_transformer/
- NVIDIA Jetson Thor 规格 — https://developer.nvidia.com/blog/introducing-nvidia-jetson-thor-the-ultimate-platform-for-physical-ai/

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 2
 0
- 0


 已为社区贡献3条内容

所有评论(0)