新加坡国立大学:Show‑Harness,一个接口,直接让VLM操控实体机器人
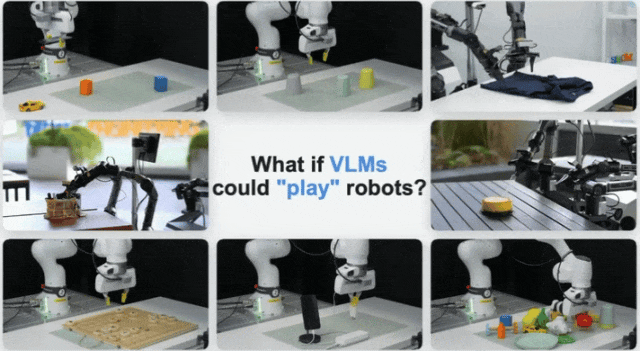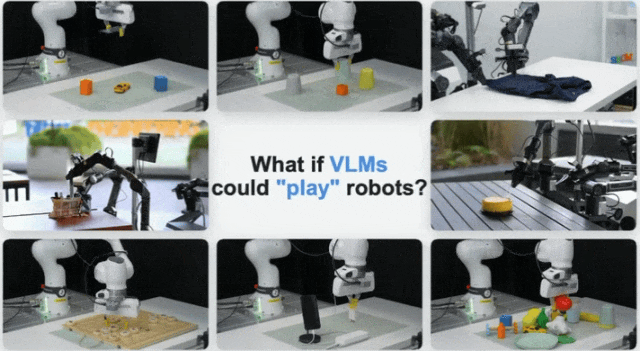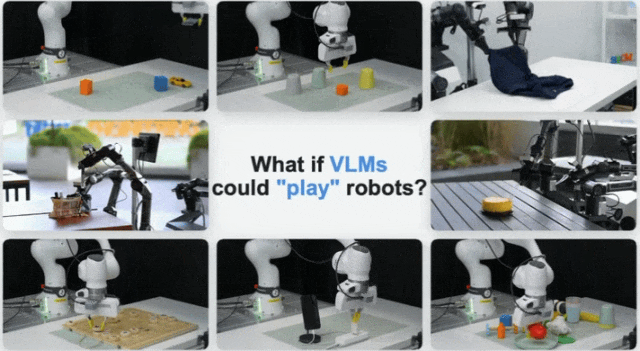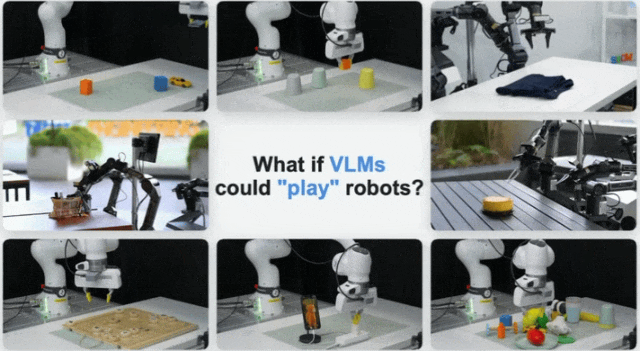
设计一个恰当的接口,就能让现成的VLM直接、精细地操控机器人。
——接口即能力
目录
01 Show‑Harness核心系统设计:语义动作接口 + 模块化插件 + GUMI数据采集
新加坡国立大学Show Lab团队提出Show‑Harness,一套模型无关的具身适配框架。
它不改动VLM内部权重,而是设计一套离散的语义动作单元接口,让VLM直接做细粒度物理决策;既可以直接调用闭源前沿VLM实现零样本机器人控制,也能仅用数小时GPU算力微调小参数量开源VLM完成低成本部署。
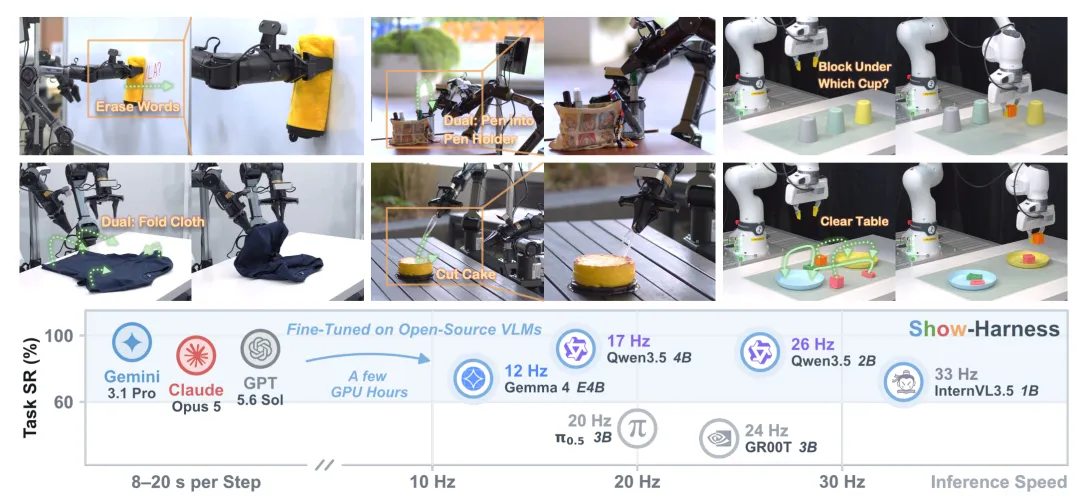
▲图|Show‑Harness跨多样任务、场景与机器人本体实现可泛化的具身操纵,支持前沿模型零样本部署、小尺寸开源模型轻量适配
01 Show‑Harness核心系统设计:语义动作接口 + 模块化插件 + GUMI数据采集
整套系统由三部分组成:面向VLM的语义动作空间、感知‑推理‑行动全套可插拔插件、GUMI GUI操纵演示界面。
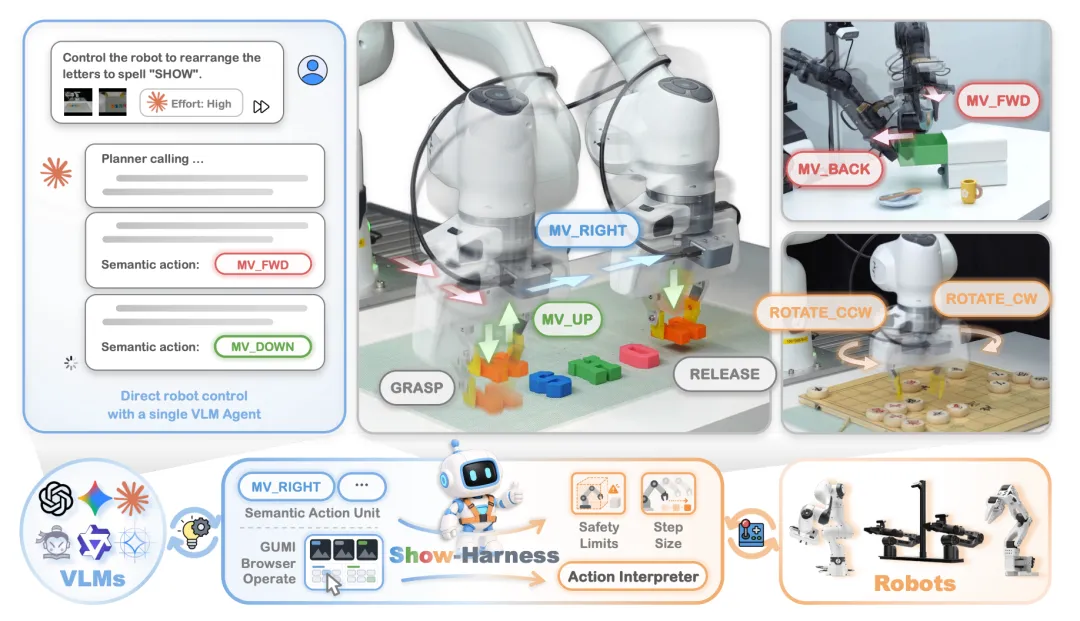
▲图|Show‑Harness通过一套语义动作接口连接基础VLM与多样机器人本体,实现前沿模型零样本控制与小型开源模型轻量适配
面向VLM的物理可落地语义动作接口
这套共享动作空间A由一组离散语义符号构成:
平移MV_FWD/MV_BACK/MV_LEFT/MV_RIGHT/MV_UP/MV_DOWN;
旋转ROTATE_CW / ROTATE_CCW;夹爪GRASP / RELEASE;
任务结束DONE。
简单理解:VLM不需要输出“末端X增加0.02米”这种硬件专属数字,只输出语义指令“向前移动一步”。
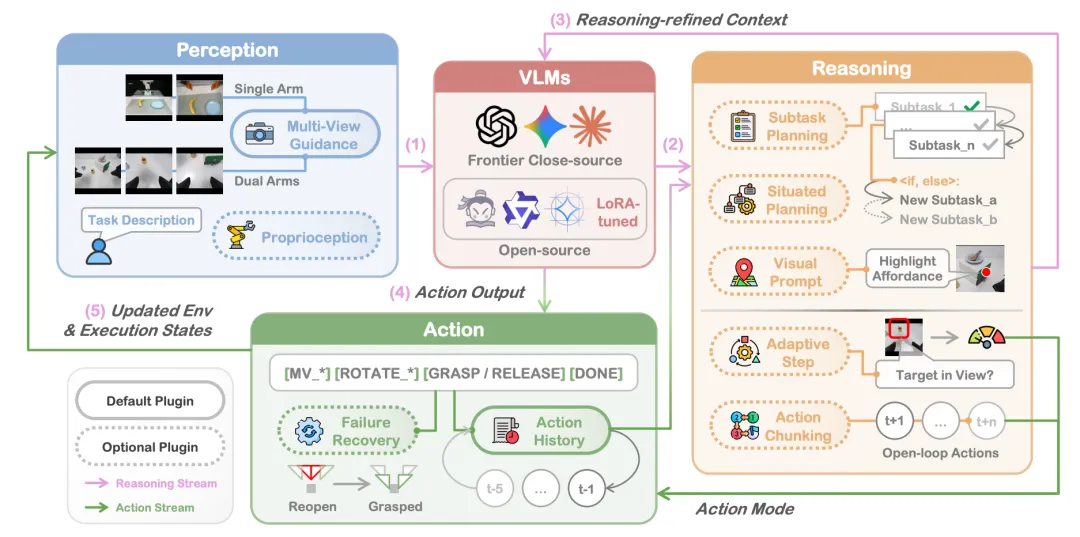
▲图|Show‑Harness 架构:模块化感知‑推理‑行动循环,通过共享的语义动作接口连接基础 VLM 到机器人控制
这套动作设计满足三个关键属性:
- 增量式:每一次动作只会产生一小段局部运动,模型可以根据视觉反馈一步一步迭代修正;同时支持动态调整步长,远距离用大步,靠近目标切换小步。
- 本体无关:全部是语义符号,和机械臂关节数量、机械结构无关;不同机器人只需要实现对应的解释器,不需要修改给VLM看的动作词汇。
- 视觉锚定:移动方向基于相机观测视图定义,VLM依靠图像就可以推理应该选择哪个动作。
语义动作输出之后,交给本体专属解释器,确定性转换为该机器人可执行的笛卡尔位姿更新。解释器内部会做工作空间限位、安全边界拦截,防止生成物理上非法的运动。
不同机械臂,比如Franka、AgileX双臂,只需要替换解释器,上层VLM推理逻辑完全不变。
解释器拿到“MV_FWD”,结合当前机器人位姿,按照设定步长更新末端位置,再映射成机械臂关节目标值,不同硬件做适配,上层模型完全无感。
感知‑推理‑行动全套可配置插件
整个闭环流程拆分为感知、推理、行动三大阶段,全部能力封装成可开关插件,不需要改动主框架。
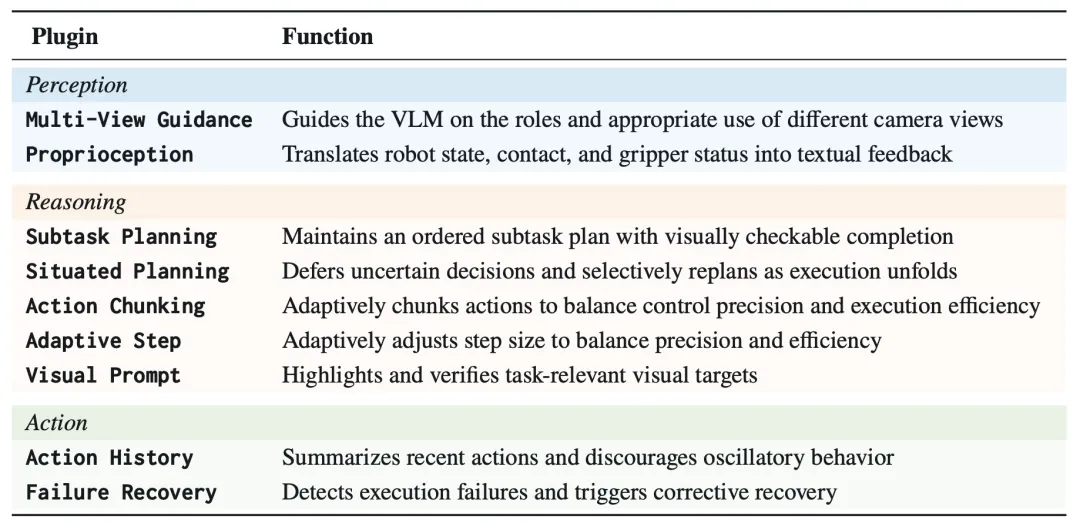
▲表|Harness插件,沿着感知‑推理‑行动循环组织
(1)感知插件
- 多视图引导:告诉VLM全局外视相机、腕部相机分别适合什么场景,腕部视图专门用于精细对齐;
- 本体状态转文本:把夹爪高度、接触状态、步长信息转为文本反馈送入大模型,弥补纯视觉的歧义。
(2)推理插件(是整套系统发挥能力的关键)
- 子任务规划:VLM把语言指令拆解为多条可视觉校验的子任务;
- 情境规划:不确定的决策先搁置,等观测到对应视觉信息之后再重新规划;
- 动作分块:远距离时允许VLM一次性输出一串连续动作开环执行,减少大模型调用次数;靠近物体自动切回单步推理,保证精度;
- 自适应步长:目标不在腕部视野用大步长,进入腕部视野切换精细小步;
- 视觉提示:当语言难以描述抓取位置,生成视觉标记高亮交互区域。
(3)行动插件
- 动作历史:保存近期动作序列,提示模型避免来回震荡往复运动;
- 失败恢复:检测空抓取等故障,自动复位夹爪、回到对应子任务重试。
这套插件是“放大器”,零样本模式下使用闭源Gemini‑3.1 Pro等模型;
微调模式下用LoRA微调2B级别的开源VLM,直接预测这套语义动作token,仅微调很少比例参数,单张24GB显卡就可以完成训练。
GUMI:GUI式操纵采集界面,摆脱专业遥操作硬件
因为语义动作空间对人类同样可读,研究实现了GUMI图形化操纵接口。
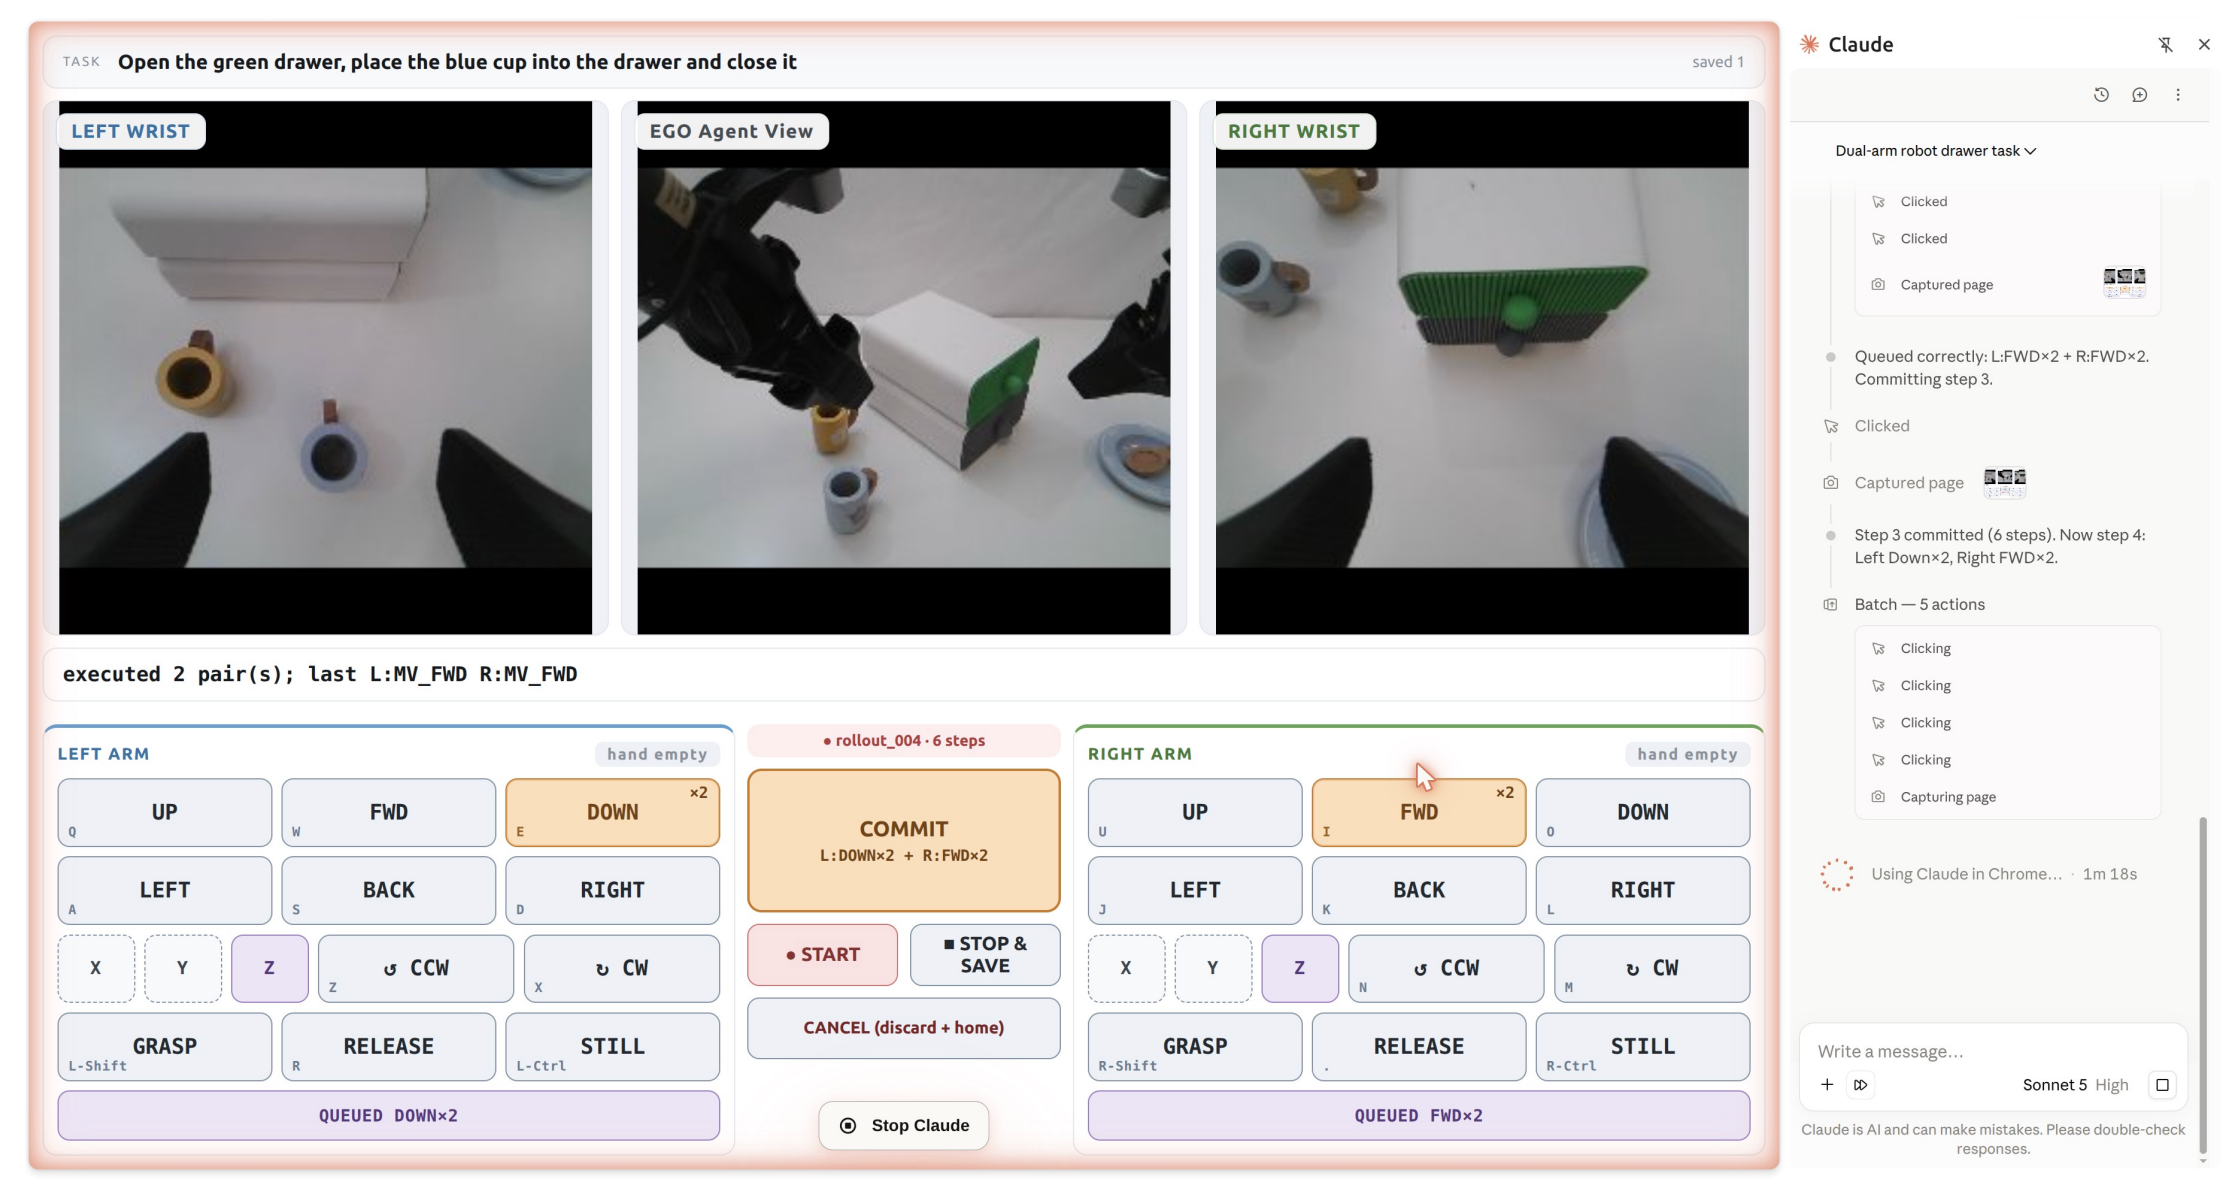
▲GUMI界面。GUI操纵界面,人类和前沿代理可以通过相同语义控制采集演示
人类通过键盘点击按钮,就可以操纵真实或者仿真机器人;VLM代理也可以调用这套GUI接口。
人类操作、AI代理操作产出的是完全同一套格式的样本,保存观测图像 + 语义动作,既可以用于微调开源VLM,也可以用于训练连续动作策略。
此外,同一套演示数据,只要目标机器人实现对应解释器,就可以跨不同机械臂本体复用,不需要重新采集。
整套采集流程不需要力反馈主手、动捕这类昂贵硬件,远程也可以完成数据收集。
02 实验
实验硬件使用Franka 7自由度单臂,AgileX双臂机器人,搭配两套多视角相机。测试包含10组物体‑容器配对任务,划分训练物体与OOD未见物体,评估分为跨任务、跨环境、跨本体三大维度;同时做大量消融验证各个插件、动作表示的价值。
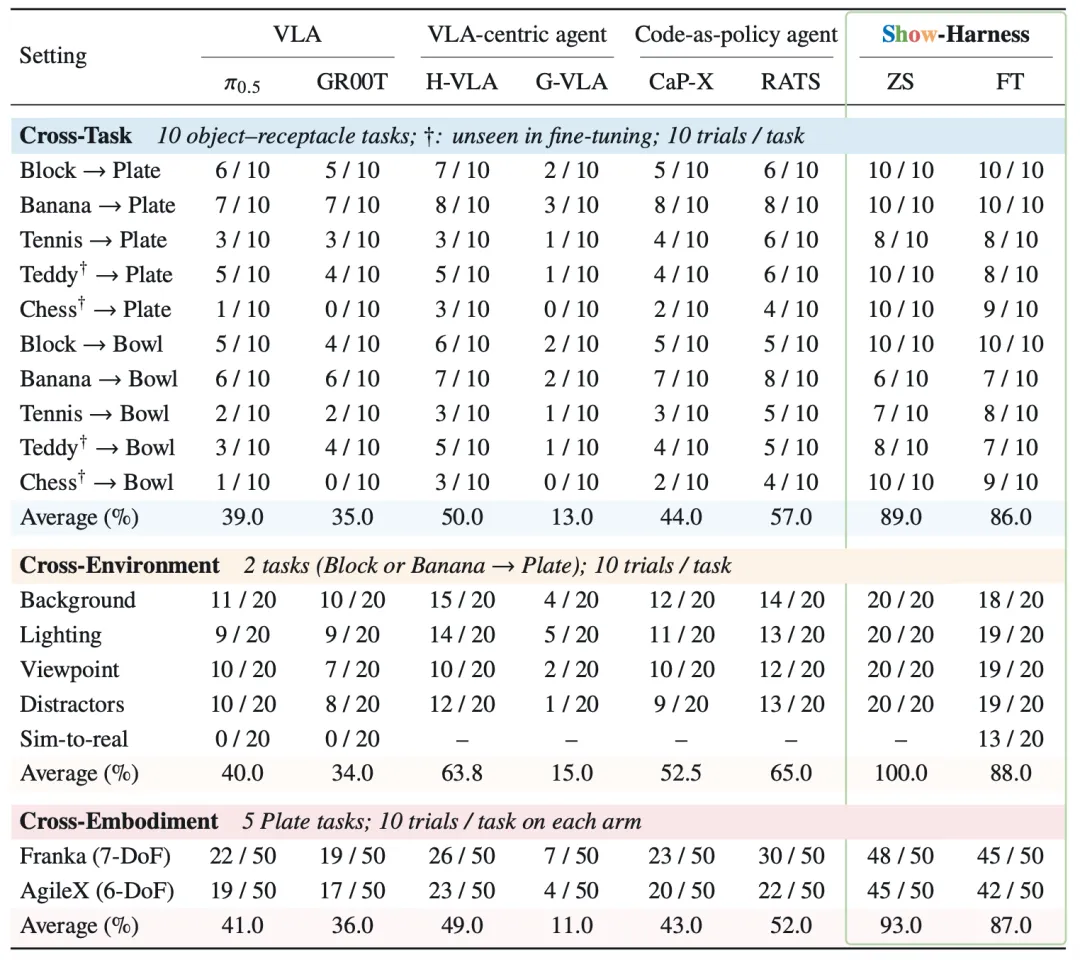
▲表|真实机器人三类泛化设置实验结果。ZS代表零样本Gemini‑3.1 Pro,FT代表微调Qwen3.5‑2B
零样本ZS模式平均任务成功率89%;FT微调2B小模型达到86%,显著超过π0.5、GR00T、CaP‑X等基线。
在背景、光照、视角变化、增加干扰物的跨环境测试,ZS模式实现100%成功率;FT达到88%;仿真到真实迁移FT取得88%。跨本体在Franka、AgileX两套机械臂上,ZS平均93%,FT 87%。
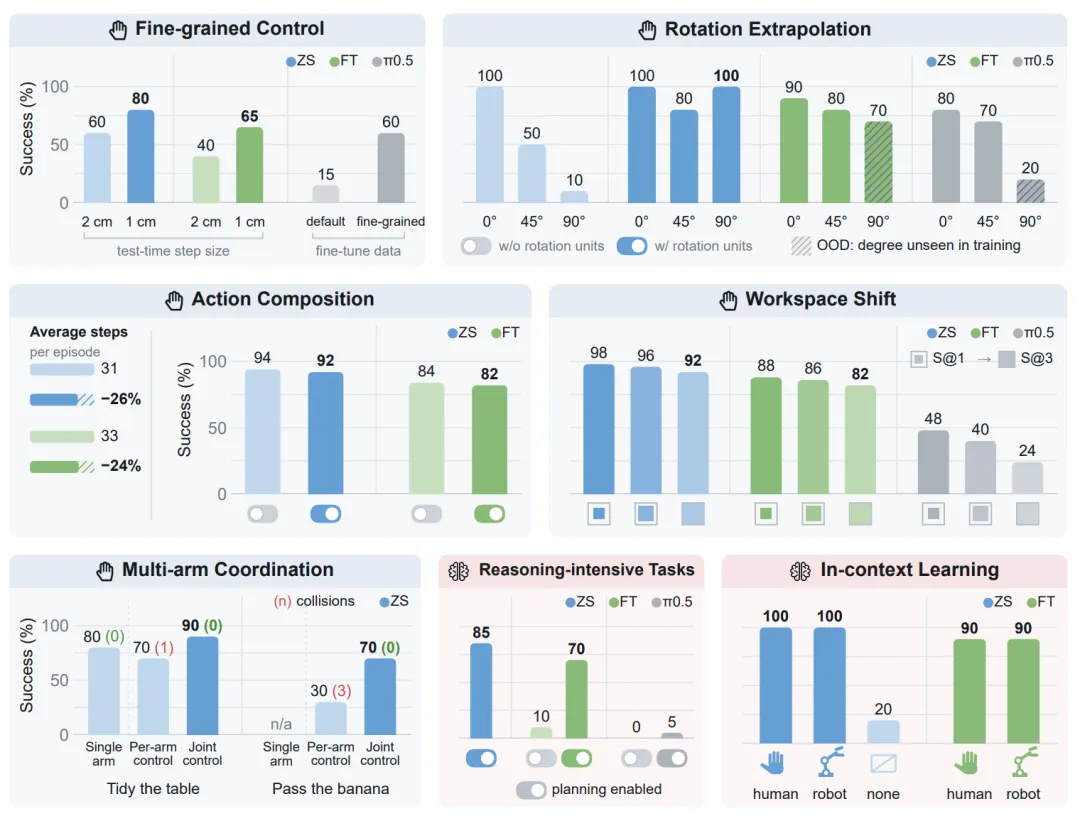
▲图|物理与语义适应性能力分析
研究进一步做了能力剖析:
- 物理适应性:
改变步长完成插孔、堆叠这类精细任务,不需要重新训练模型,仅调整解释器步长参数,ZS成功率从60%提升到82%;旋转角度外推,没有训练过的90°姿态依旧可以完成抓取;工作空间扩大到边界区域,性能衰减幅度远小于VLA基线。双臂协同任务,联合预测双臂动作,可以完成整理桌面、物体传递。
- 语义适应性:
杯子下寻找方块这类需要推理的任务,开启情境规划插件,ZS达到85%成功率;支持视频in‑context学习,看一遍人类或者机器人演示视频,就复现整套操作顺序。
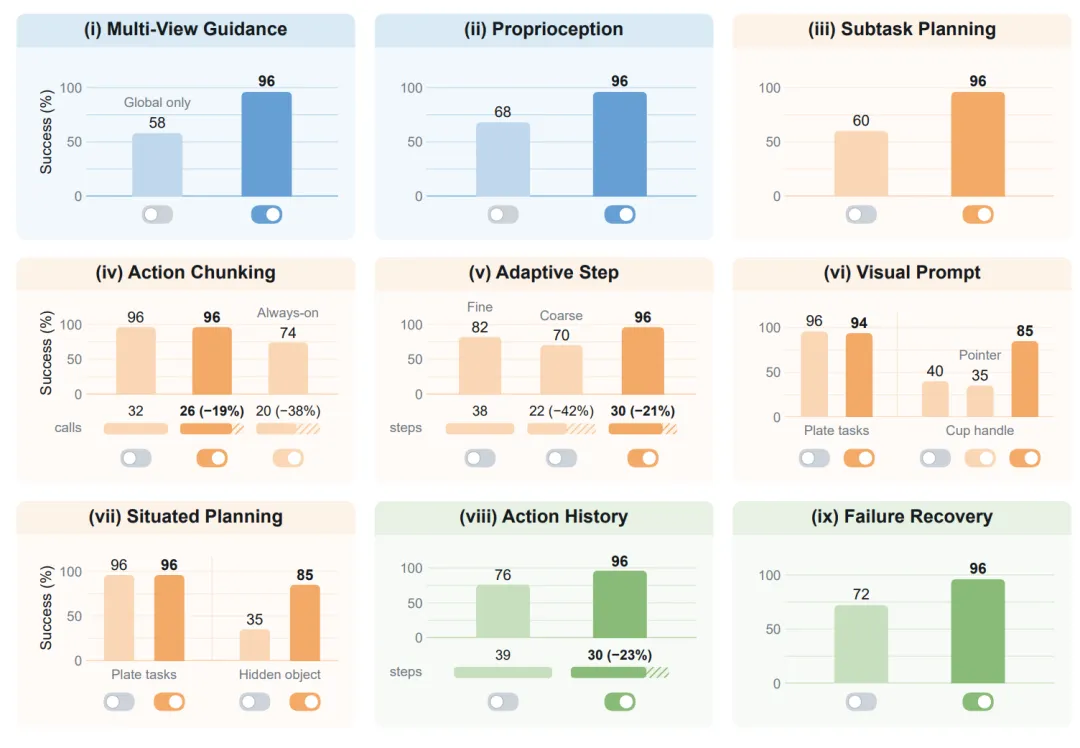
▲图|Franka真实机器人上零样本agent插件消融实验
- 消融实验可以看到各个插件的实际贡献:
去掉多视图引导,成功率从96%跌到58%;移除子任务规划跌到60%;关闭失败恢复跌到72%。动作分块、自适应步长在不降低成功率的前提下,减少推理步数;视觉提示、情境规划在对应困难任务上带来巨大增益。
从动作表示消融实验中也可以看出:
单纯无含义随机token符号很难让VLM学会动作;必须附带动作行为的文字约定说明,VLM才能真正理解每个语义符号对应的物理效果,只靠符号名字本身不够。
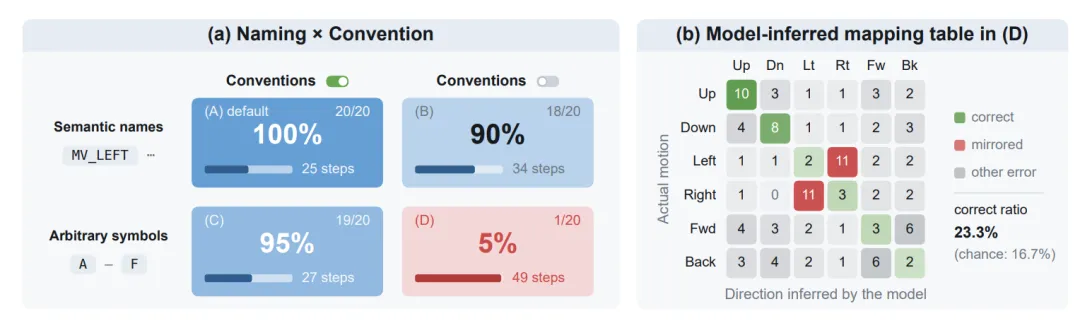
▲图|(a) 动作空间表示方式消融实验;(b) 20 次实验中模型推断得到的动作映射结果
定性对比可以直观看出差异,同样的演示数据训练,π0.5容易出现夹爪碰撞、抓取不稳;Show‑Harness无论是零样本大模型,还是微调小模型,能够完成未见物体的抓取放置。
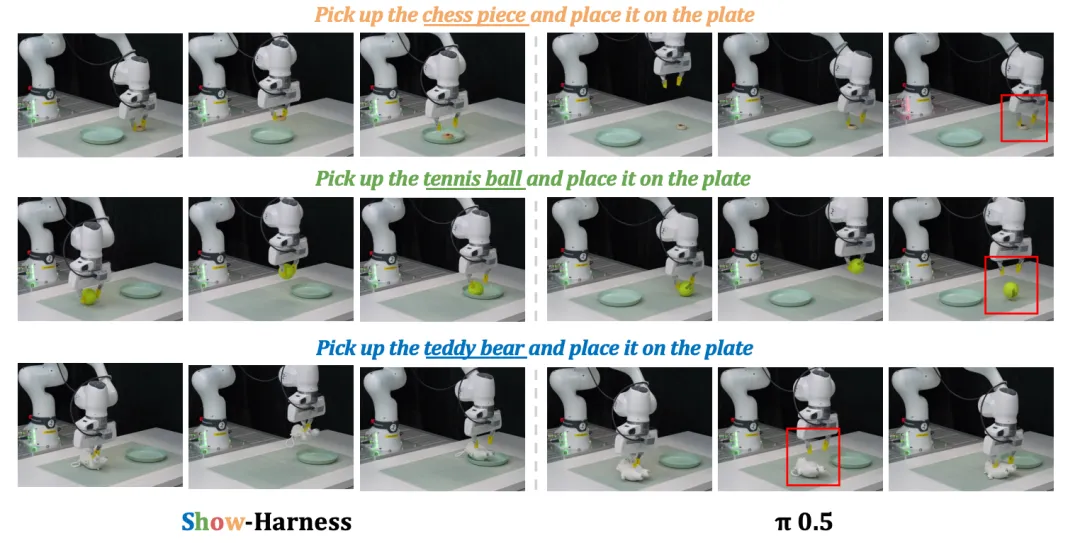
▲图|与π0.5定性对比。Show‑Harness全部完成三类样例,π0.5出现抓取不稳定、夹爪碰撞物体等失败,红框标记故障位置
- 局限补充:
真机实验还是桌面台式操纵,物体重量不大,没有大量极端的滑、滚等强动态物体;这套框架是决策层,底层依然依赖机器人本体跟踪控制器,如果底层控制器本身失效,上层决策再好也无法完成任务。
03 语义动作接口控制机器人
想要把VLM的通用知识用在机器人,不一定非要把大模型改成动作输出头。
换一套大模型和机器人之间的接口,也可以释放具身能力。
它没有去改造VLM网络权重,而是设计一套可读的离散语义动作接口,让VLM直接参与细粒度物理决策,再由解释器做硬件适配。实现两种使用路径:前沿闭源VLM直接零样本操控机器人;或者少量算力微调轻量开源VLM实现本地部署;搭配GUMI降低演示数据采集的硬件门槛。
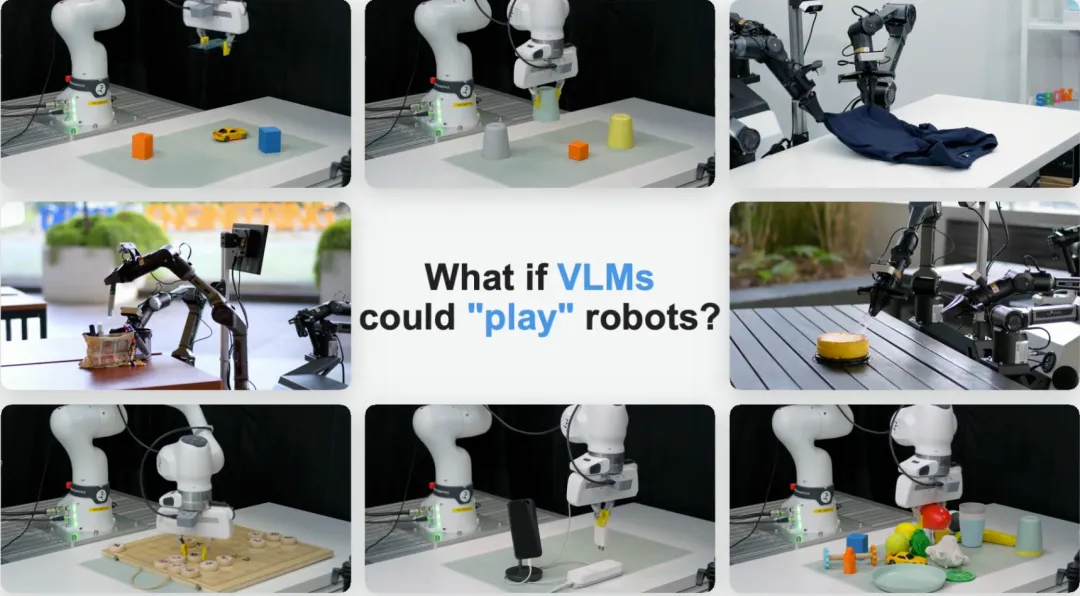
当然这套方案它受限于VLM本身空间推理水平,同时推理延迟、缺少触觉反馈、本体拓展不足都是接下来需要补齐的短板。但它提供了一条区别于VLA端到端、传统agent分层调度的新路线,给通用大模型落地实体机器人提供新的参考思路。
Ref
论文标题:Show‑Harness: Just a VLM Agent Can Play Robots
论文链接:https://arxiv.org/pdf/2609.10522
项目链接:https://showlab.github.io/Show-Harness/

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献229条内容

所有评论(0)