【CoRL 2025】Phantom 论文解读:只用人类视频训练机器人策略,零真机数据零样本部署|从具身智能数据缩放视角
摘要
本文解读 CoRL 2025 论文《Phantom: Training Robots Without Robots Using Only Human Videos》。该论文提出 Phantom,一个只用人类 RGBD 视频演示、完全不采集真机数据就能训练机器人操作策略的框架,通过融合手部姿态估计与深度精修、视频修复与渲染机器人叠加三条技术,把每一帧人类演示 $I_{h,t}$ 转换成机器人观测-动作对 $(I_{r,t}, a_{r,t})$,其特别之处在于训练与推理两个阶段都叠加虚拟机器人,从而在不需要任何真机数据的前提下完成零样本部署。实验表明在取放书本任务上成功率最高达 92%,系八字绳结这类高可变形操作可达 64%,在从未见过的室内外场景中扫地仍有 72%–84%,为机器人数据稀缺这一根本瓶颈提供了重要借鉴。
视频讲解:点击观看 B 站视频
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | Phantom: Training Robots Without Robots Using Only Human Videos |
| 标题(中文) | 只用人类视频,不用机器人也能训练机器人策略 |
| 作者 | Marion Lepert, Jiaying Fang, Jeannette Bohg |
| 机构 | Stanford University(Interactive Perception and Robot Learning Lab) |
| 会议 | CoRL 2025(PMLR v305, pp. 4545–4565) |
| arXiv | https://arxiv.org/abs/2503.00779 |
| 项目网站 | https://phantom-human-videos.github.io/ |
背景与动机
机器人学习最硬的约束从来不是算法,而是数据。当前主流做法依赖遥操作演示,采集慢、成本高、每换一个场景就要把硬件搬过去重来。论文开篇给出的事实是:机器人数据集比训练通用视觉语言模型的数据小几个数量级,而且光有数量并不够,多样性同样决定泛化。
人类视频看上去是天然的替代品——数量大、场景广、富含任务信息——但它有两个绕不开的障碍:
- 没有显式的动作标签:视频只有像素,没有末端位姿与夹爪开合;
- 人的外观与机器人差异极大:直接用人类图像训练的策略,部署到真实机器人上会遇到严重的视觉分布偏移。
已有的从人类视频学习方法大多没能绕开真机数据这个瓶颈。论文在附录里逐一按数据实情列出:Motion Tracks 至少有 22% 的数据来自遥操作真机演示,Track2Act 尽管用了 40 万段视频片段,每个任务仍需要约 40 条真机演示,EgoMimic 平均有 41% 的数据来自真机遥操作,MimicPlay 按其数据采集时间计算至少有 75% 是机器人演示,HOPMan 则要为 16 项技能额外采集 1000 条纯机器人演示。这类方法在"人类数据远多于机器人数据"的目标区间里会直接失效。
Phantom 的立场很明确:把真机数据从训练路径里彻底删掉,只保留人类视频。它瞄准的是一个渐近场景——人类演示的规模会迅速增长,而机器人数据依旧稀缺。
研究主线:从问题到结论
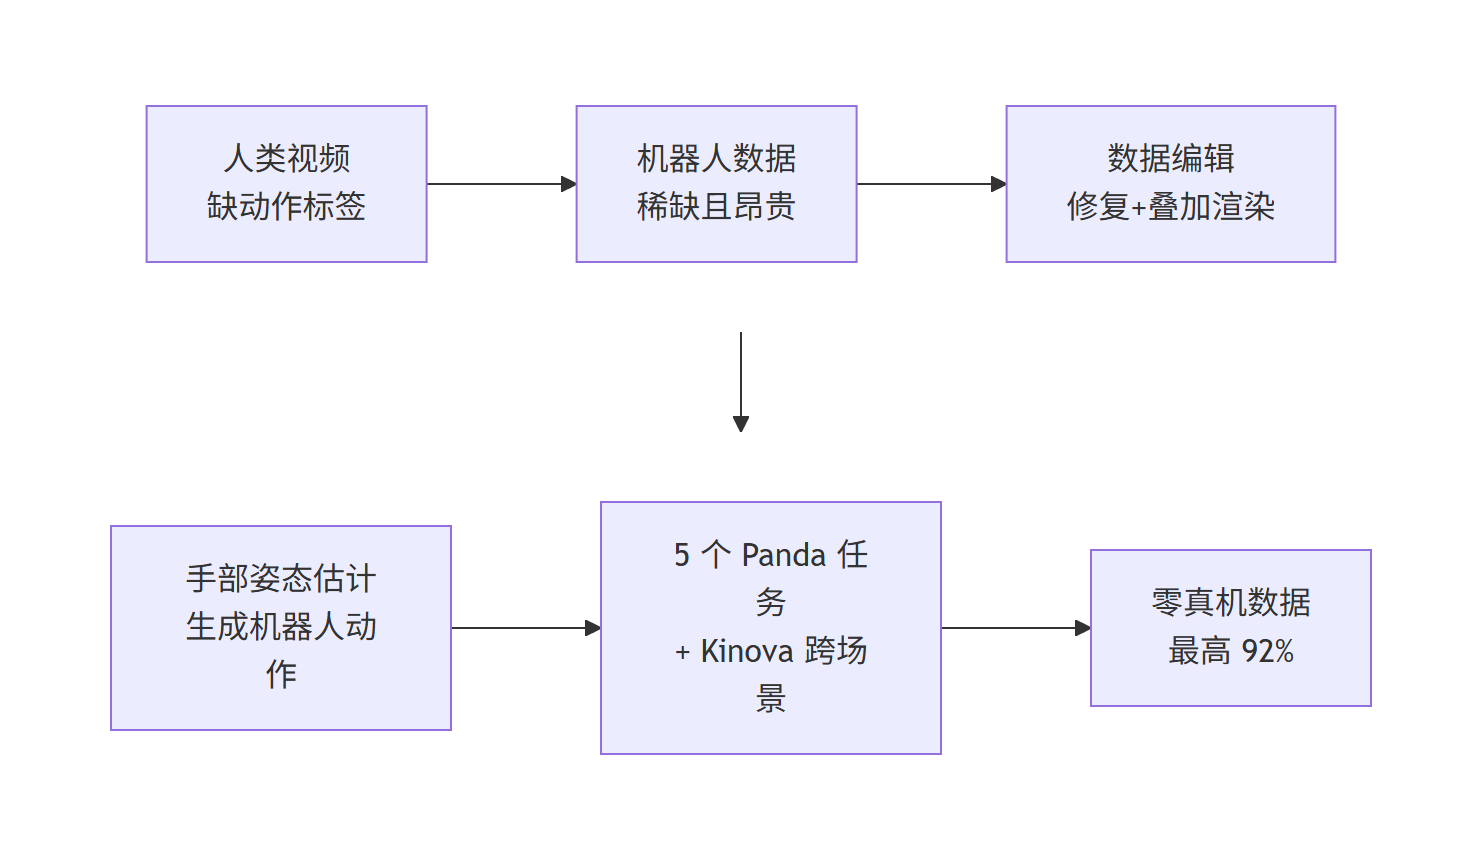
图 7:Phantom 的研究主线(Mermaid 流程图)。从人类视频缺动作标签与机器人数据稀缺两个问题出发,经数据编辑与手部姿态估计,到跨场景实验与零真机数据结论。
基准/方法设计
Phantom 的输入是人类演示集合 $\mathcal{D}{\text{human}}$,输出是机器人演示集合 $\mathcal{D}{\text{robot}}$,目标是让每一对人类图像 $I_{h,t}$ 都对应一个机器人观测-动作对。每个动作定义为 $a_{r,t}=(\mathbf{p}_t,\mathbf{R}_t,g_t)$:末端笛卡尔位置、六维连续旋转表示,以及归一化到 $[0,1]$ 的夹爪开合宽度。
整条设计由两块正交的机制组成,缺一不可:
- 动作标注链路:用 HaMeR 估计手部姿态得到 21 个关键点与 778 个网格顶点;再用 SAM2 分割手部并从深度图取出部分点云,通过 ICP 配准把网格对齐到点云上,得到精修后的关键点。
- 视觉对齐链路:用 SAM2 分割人类手臂,用 E2FGVI 做视频修复补出背景,再按已知相机外参用 MuJoCo 渲染目标机器人并叠加到场景里,遮挡关系由深度决定。
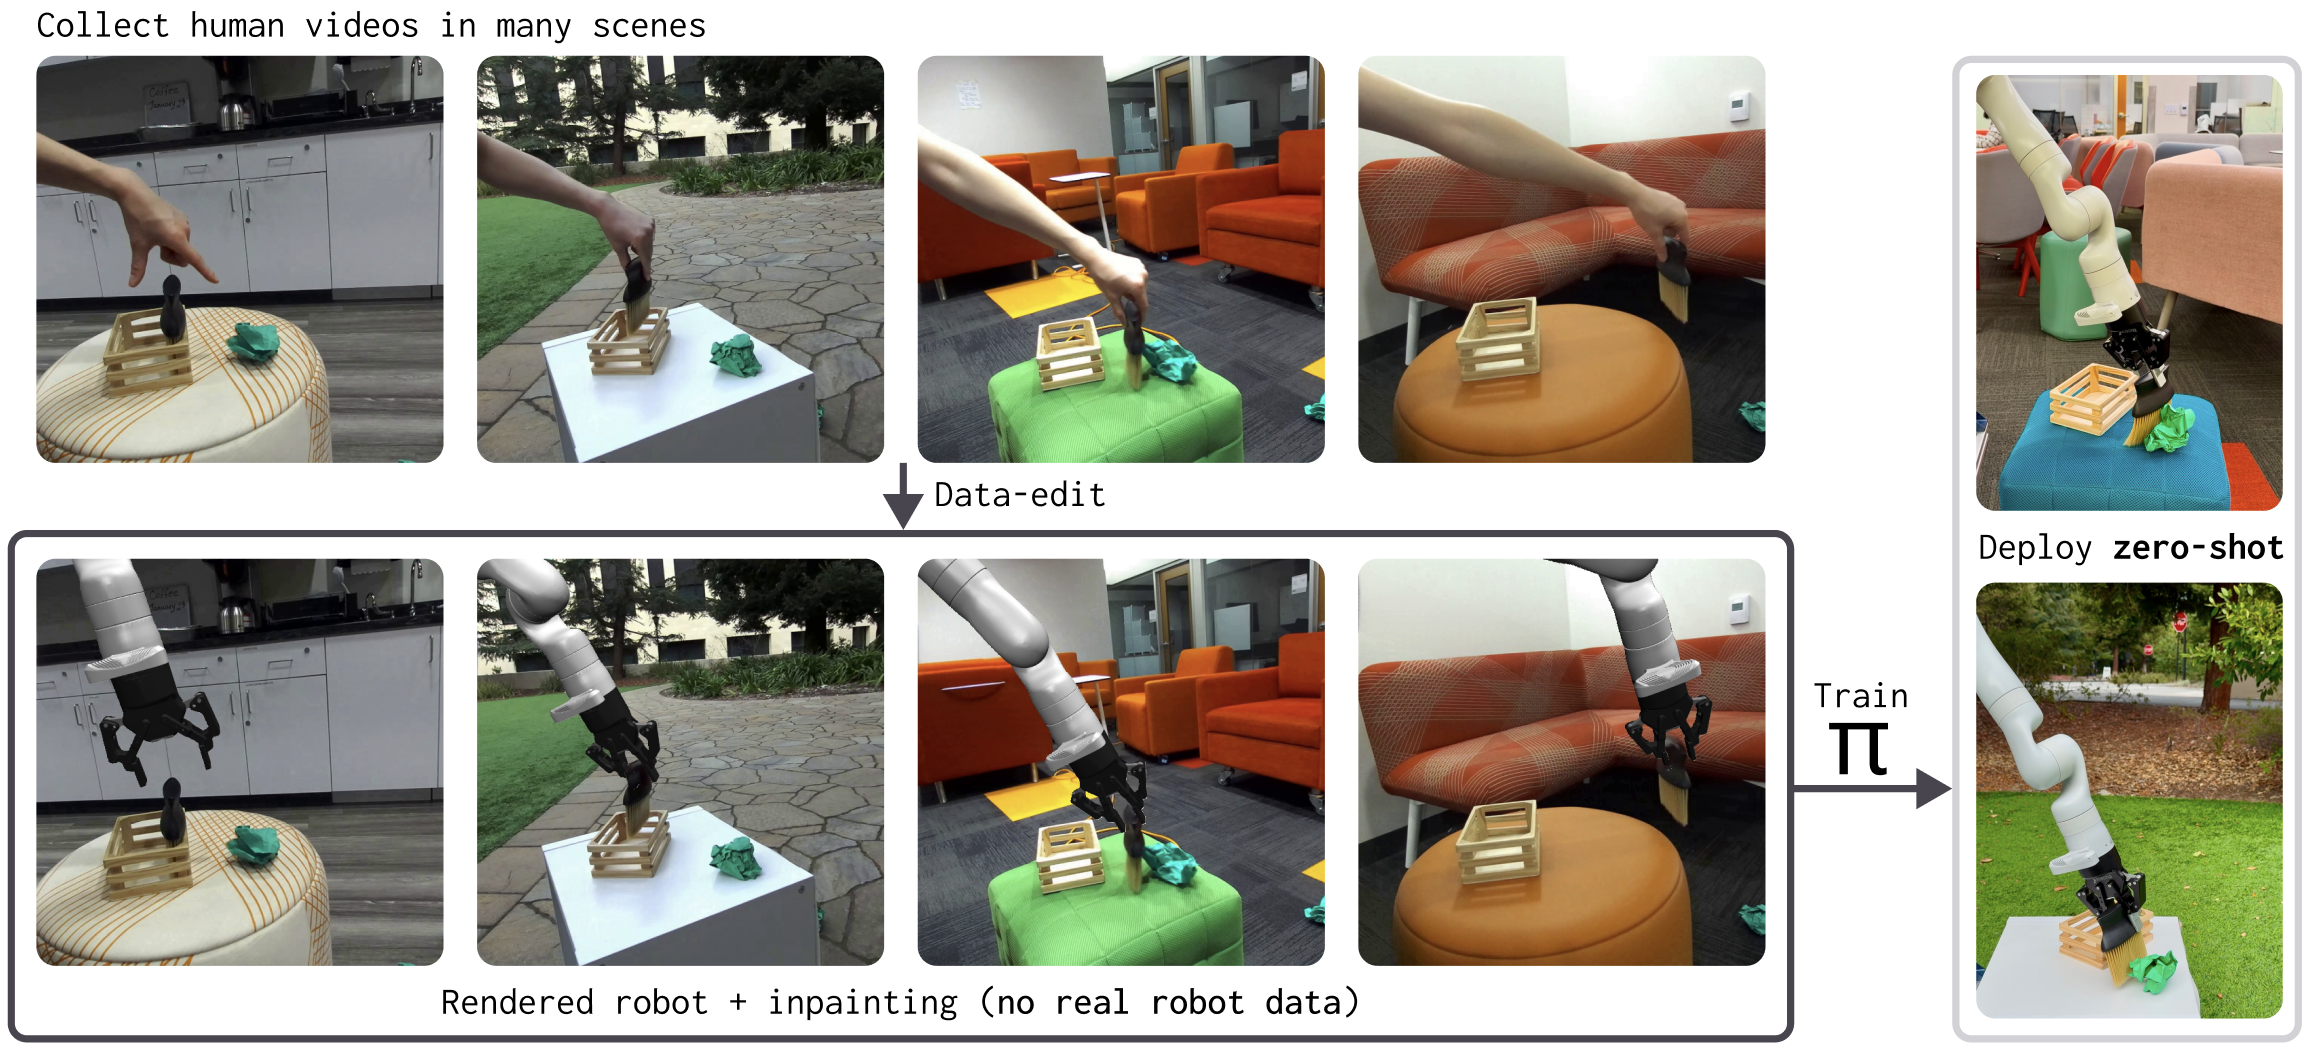
图 1:Phantom 总览。先在多样环境中采集人类演示并估计手部姿态得到动作,再用修复抹掉人手、按估计姿态合成机器人叠加到场景中;由此得到的数据集训练模仿学习策略,并零样本部署到真机。
分类全景
人类视频到机器人的迁移主要有三条技术路线,Phantom 属于第二条并在其上做了人机场景的首次验证。
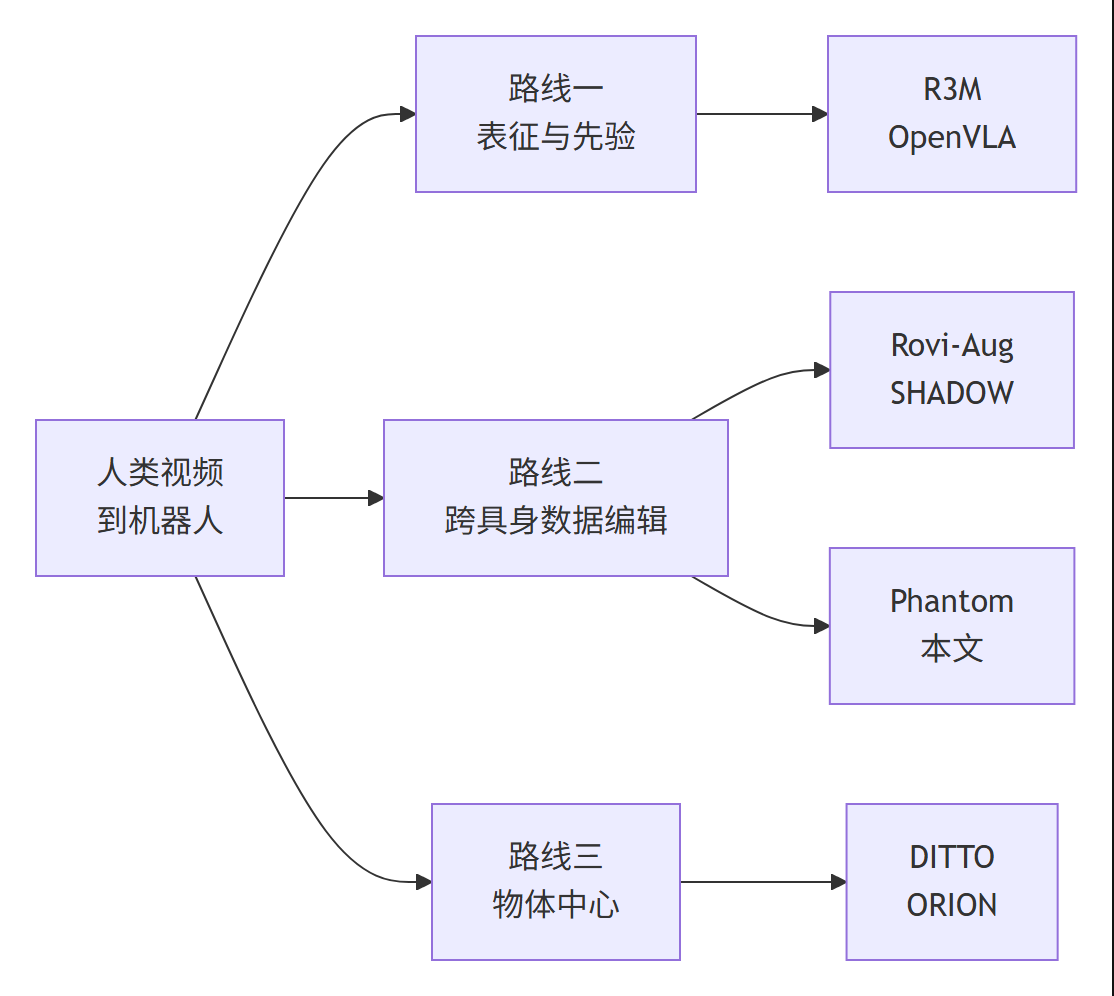
图 8:人类视频到机器人迁移的三条技术路线(Mermaid 分类图)。Phantom 属于跨具身数据编辑路线,与 Rovi-Aug、SHADOW 同族。
方法细节
动作标注是整条流水线里最需要工程力度的一环。HaMeR 在手形估计上很强,但由于只依赖单目图像,它给不出绝对的三维位姿;作者的做法是把深度信息引入进来,用分割掩码与深度共同构成手部部分点云,再求出刚体变换 $\mathbf{T}_t \in SE(3)$ 去对齐网格,最后把同一变换作用到关键点上。另一个细节是解剖约束——HaMeR 把手部关节都建模成球铰,在抓取这种遮挡严重的场景下会给出不合理的指姿,于是作者把拇指与食指的末端两个关节限制为单自由度。
目标动作的构造也值得一提:位置取拇指指尖与食指指尖的中点,姿态由拇指与食指的关键点拟合出的平面法向与拇指主轴决定,夹爪开合宽度取两指尖之间的距离;为了防止抓取时滑脱,单条轨迹中开合距离最低的 20 分位会被强制置为完全闭合。
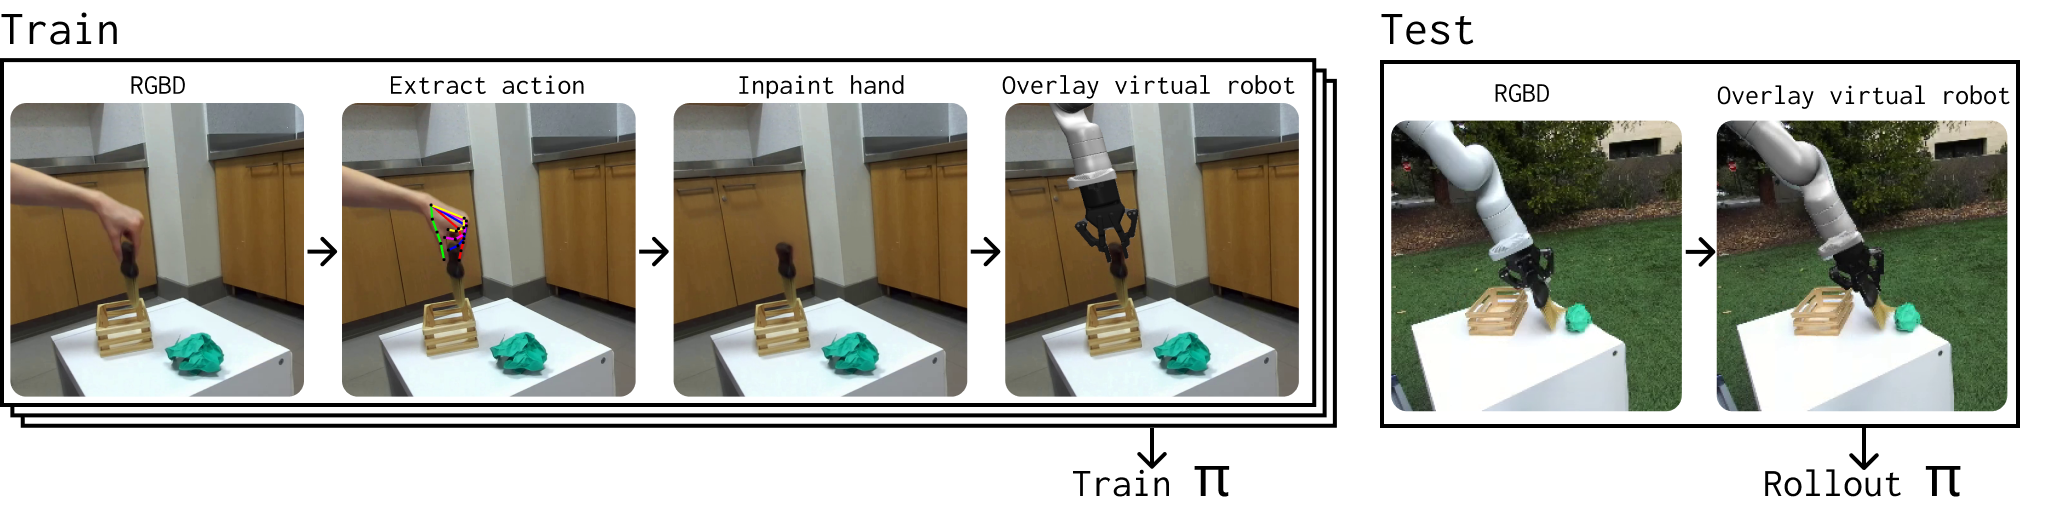
图 2:Phantom 流水线。训练时逐帧估计手部姿态并转成机器人动作,用修复移除人手、在原位叠加虚拟机器人;测试时同样在真实机器人观测上叠加虚拟机器人,使训练与推理的视觉分布一致。
视觉对齐部分有两个容易被忽略的设计选择。第一是用修复而不是用掩码:直接把手臂涂黑会留下明显的黑色块,与真实机器人观测差距较大。第二是测试时也要叠加:训练图像里是渲染出来的机器人,真实观测里是真实机器人,两者的颜色纹理存在细微差异,最省事的补偿方式就是在推理图像上也叠一层同样风格的虚拟机器人,而不是像 Rovi-Aug 那样在训练时做大量颜色扰动。策略本体沿用 Diffusion Policy,使用 DDIM 调度器(100 训练步 / 10 推理步),观测窗口 $T_o=2$、动作窗口 $T_a=8$、图像分辨率 240、学习率 $1\times10^{-4}$。
实验设计与结果
实验在两种机器人上展开。Panda 平台做五个同场景任务,每个任务采集 250–350 条人类演示(取放书 313、叠杯 268、扫地 279、系绳结 307、旋转盒 283);Kinova 平台做跨场景扫地任务,采集了 950 条覆盖大量室内外场景的人类演示,并在室外草坪、室内休息区以及"室内休息区 + 未见桌面"三种分布外设置下评测。所有配置都是 25 次 rollout。
主结果:三种数据编辑策略的对比
| 数据编辑策略 | 取放书 | 叠杯 | 系绳结 | 旋转盒 |
|---|---|---|---|---|
| Hand Inpaint(Phantom) | 0.92 | 0.72 | 0.64 | 0.72 |
| Hand Mask | 0.92 | 0.52 | 0.60 | 0.76 |
| Red Line(EgoMimic) | 0.0 | 0.0 | 0.0 | 0.0 |
| Vanilla(不编辑) | 0.0 | 0.0 | 0.0 | 0.0 |
Red Line 与 Vanilla 在全部任务上的成功率为 0,这是本文最有说服力的一条对照:训练图像里如果没有一个完整的机器人外观,策略根本学不到可迁移的控制。
多物体扫地任务:分档成功率和跨越场景泛化
| 方法 | 夹起刷子 | 扫入 >0 | 扫入 >2 | 扫入 >4 |
|---|---|---|---|---|
| Hand Inpaint(Phantom) | 0.88 | 0.80 | 0.72 | 0.40 |
| Hand Mask | 0.75 | 0.75 | 0.72 | 0.68 |
| 方法 | 室外草坪 | 室内休息区 | 室内 + 未见桌面 |
|---|---|---|---|
| Hand Inpaint(Phantom) | 0.72 | 0.84 | 0.64 |
| Hand Mask | 0.52 | 0.76 | 0.68 |
在"扫入更多垃圾"这种需要长时序协调的高难度档位,仅掩码的 Hand Mask 反而更强(0.68 对 0.40);但在夹取与起步档位,以及两种分布外场景中,Hand Inpaint 明显领先。考虑到 Hand Mask 在测试时需要额外跑一个扩散模型生成手部掩码,它的 rollout 平均慢 73%,综合成本并不划算。
修复质量消融
| 修复方式 | 未见室内场景成功率 |
|---|---|
| E2FGVI 高质量修复 | 0.84 |
| OpenCV 粗略修复 | 0.76 |
| 完全不修复(仅掩码) | 0.60 |
这条消融给出了全文最清晰的因果链:不修复直接损失 24 个百分点,而用 OpenCV 这种近乎原始的修复就能追到 0.76,说明训练时的修复伪影本身就构成了一种有益的数据增强,模型对修复质量并不敏感,但对"有没有修复"极其敏感。
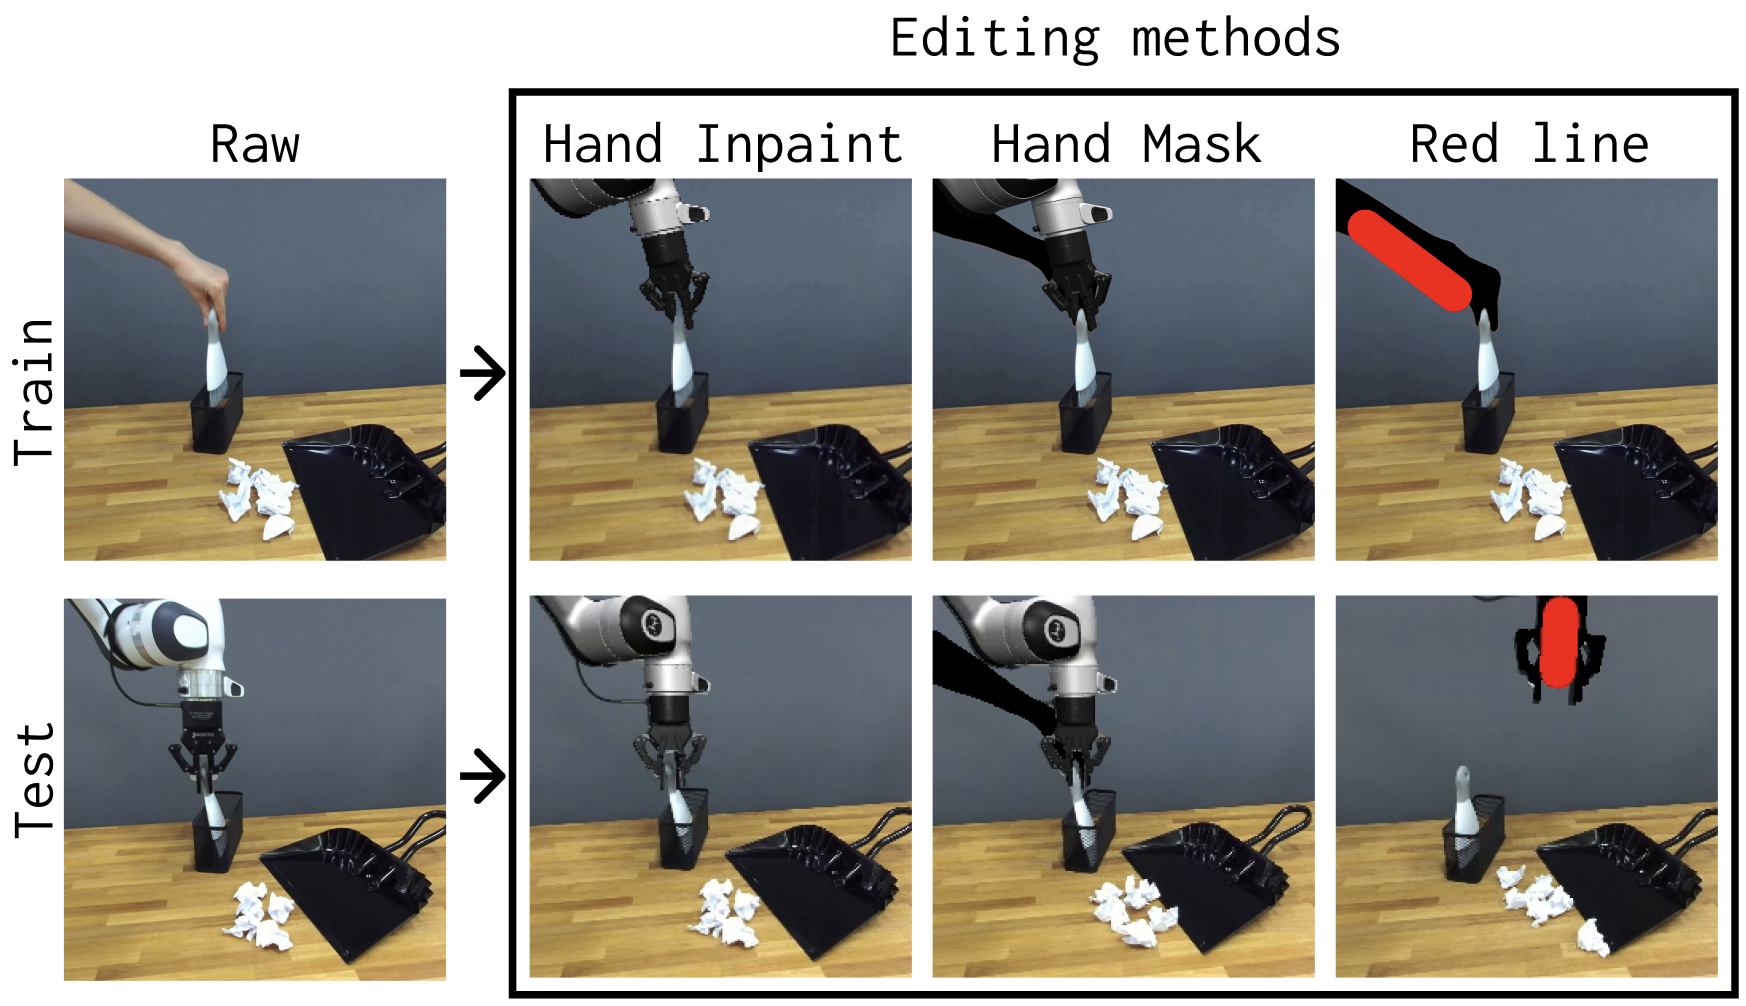
图 3:三种数据编辑策略的训练与测试图像。Hand Inpaint 用修复把手臂整段抹掉再叠加渲染机器人;Hand Mask 只把手臂涂黑再叠加;Red Line 沿用 EgoMimic 的做法,涂黑后画一条红色线段表示手臂方向。
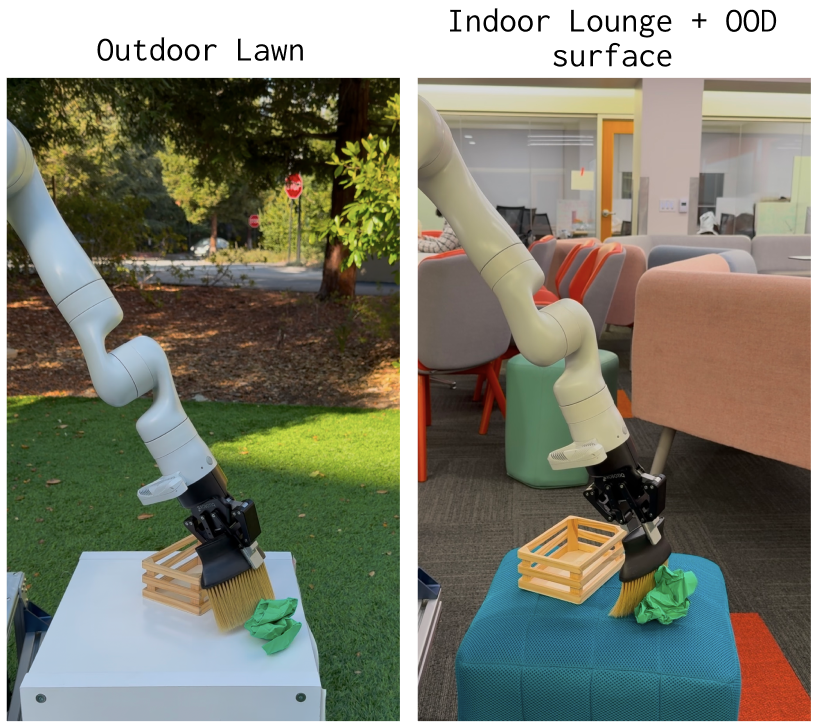
图 4:Kinova 扫地任务的分布外评测场景。室外草坪与室内休息区在数据采集时都没有出现过,rollout 过程中还会遇到行人、车辆这类动态背景变化。
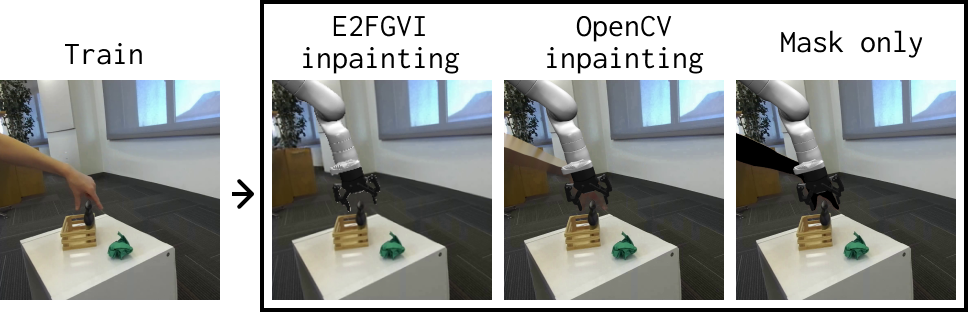
图 5:三种修复质量的可视对比。E2FGVI 高质量修复、OpenCV 低质量修复与完全不修复(仅掩码)对应的成功率依次为 0.84 / 0.76 / 0.60。
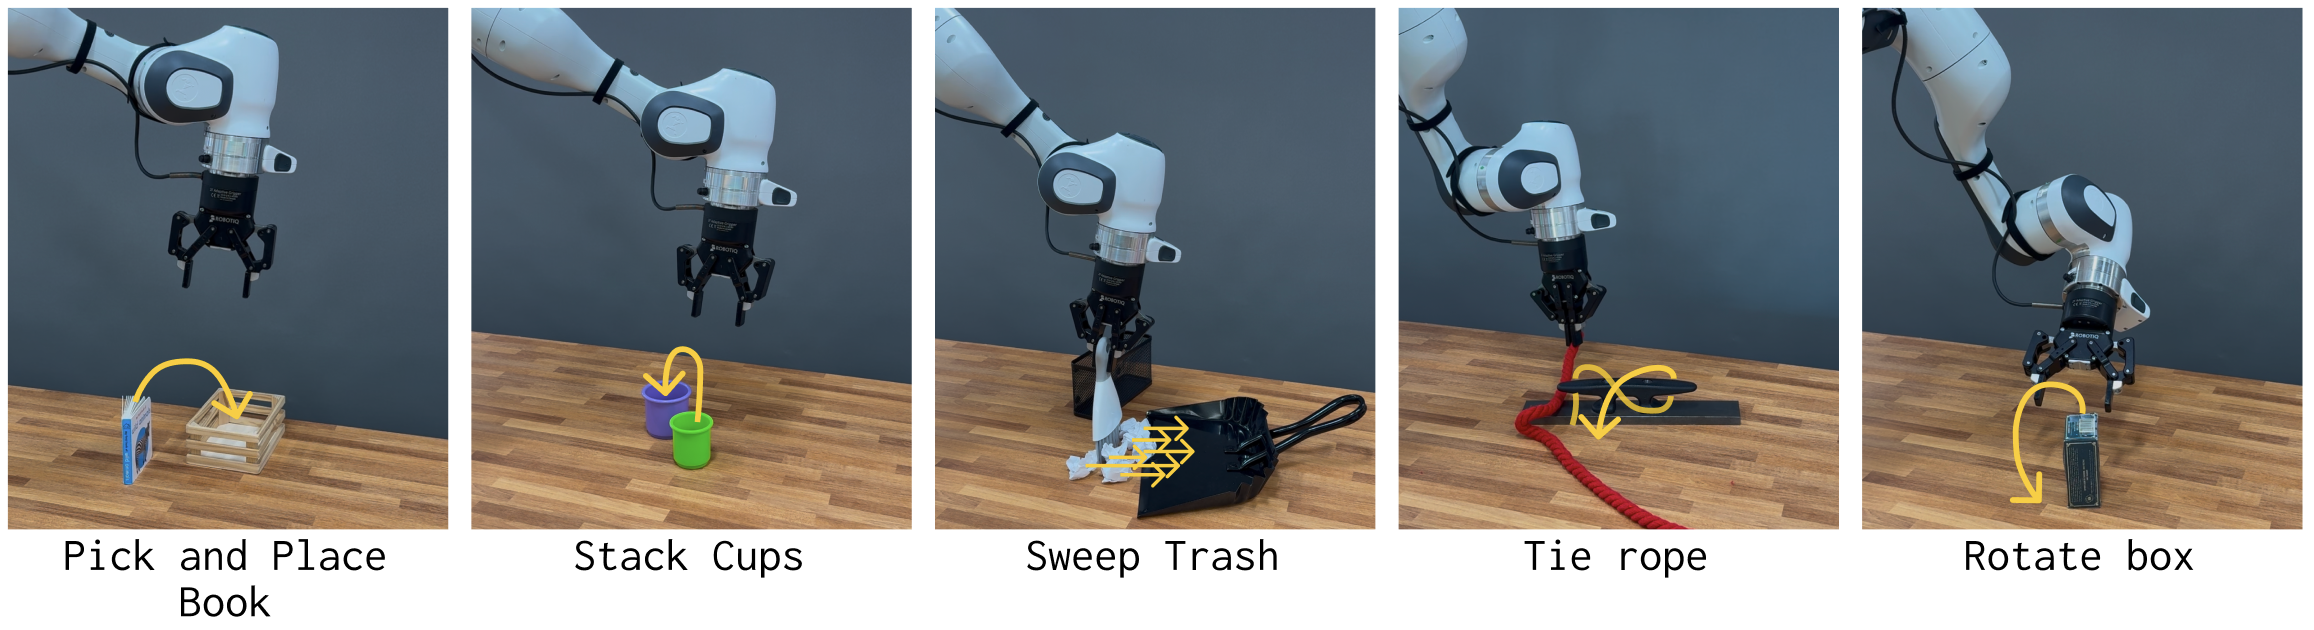
图 6:同场景评测的五个 Franka 任务。取放书、叠杯(直径差 1.5 厘米)、系八字绳结、受控旋转盒子,以及用刷子把六片垃圾扫进簸箕。
实验还补充了两组有价值的对照。其一是共训:纯真机数据策略在同场景能到 0.88,但换到新场景直接归零;把 100 条真机演示与 950 条跨场景人类演示共训后,新场景成功率回到 0.80。其二是人类演示与真机演示的精度对比:50 条时人类 0.44 对真机 0.52(Fisher 精确检验 $p=0.778$),100 条时人类 0.64 对真机 0.88($p=0.095$),两者都不显著;而把人类演示加到 300 条,成功率回到 0.84。
结果对比总结
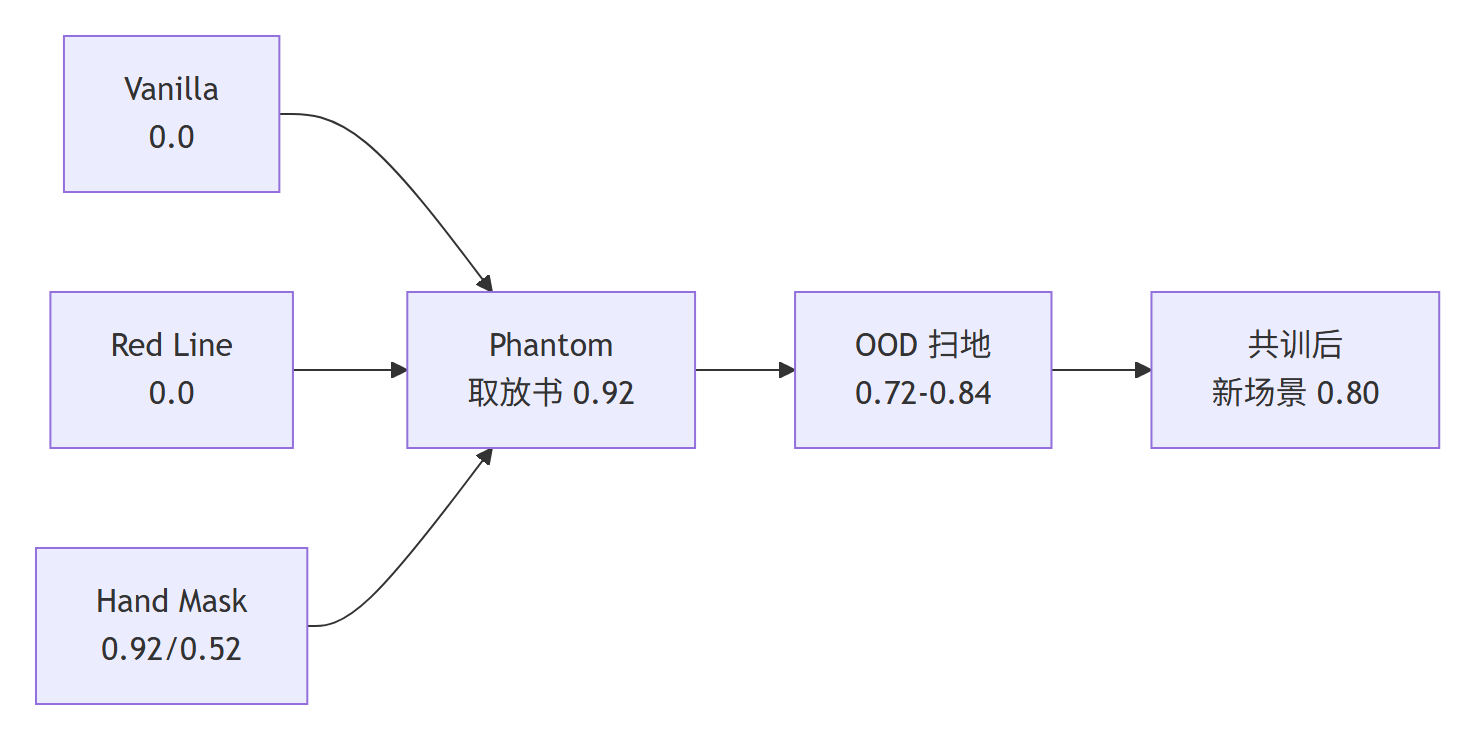
图 9:结果对比总结(Mermaid 流程图)。Vanilla 与 Red Line 全任务为 0,Phantom 在同场景取得 0.92、在分布外场景取得 0.72–0.84,共训后新场景回到 0.80。
关键发现
- 零真机数据可行:只用人类视频训练的策略,在取放书本任务上达到 92% 成功率,在系八字绳结这种高可变形操作上仍有 64%。
- 机器人外观必须显式出现:Red Line 与 Vanilla 在四个任务上成功率全为 0,证明"训练时叠加渲染机器人"不是可选项而是必要条件。
- 修复是核心变量:E2FGVI 0.84、OpenCV 0.76、不修复 0.60,不修复损失 24 个百分点,而修复质量本身几乎不敏感。
- 跨场景泛化成立:训练数据里 80% 来自室内,策略在室外草坪仍有 0.72,在室内休息区 0.84,换到未见桌面 0.64。
- 人类演示的精度代价可被规模抵消:50 条与 100 条时与真机数据的差距在统计上都不显著($p=0.778$、$p=0.095$),扩到 300 条即可追平 0.84。
- 共训有明确收益:纯真机策略在新场景从 0.88 直接掉到 0.0,加入跨场景人类视频共训后回到 0.80。
局限性
- 上限取决于手部姿态估计器:动作标签来自估计结果,遮挡下估计失效方法就失效;反过来说,估计器的进步会直接抬升本方法。
- 要求人机策略同构:只有当机器人能沿用人类的完成策略时才成立。人手的路径无碰撞不代表机器人无碰撞,指腹与平行夹爪的表面性质差异也会改变物体运动。
- 只支持捏取:因为机器人只有平行夹爪,所有演示都被限制为拇指与食指的捏取;作者指出这也是几乎所有大规模机器人数据集的共同限制。
- 只覆盖准静态任务:没有处理方法侧与真机 rollout 之间的时延不匹配,因此动力学快速的任务不在适用范围。
- 场景与相机外参有假设:训练与测试场景不需要相同,但假设采集相机与部署视角接近,且相机外参已知。
常见问题(FAQ)
Phantom 真的完全不需要机器人数据吗?
是的。策略训练只用经过数据编辑的人类视频演示,论文没有使用任何真机演示、人工标注或物体模型,部署时也不做任何微调,属于严格的零样本部署。
它和 EgoMimic、SHADOW 有什么区别?
SHADOW 与 Rovi-Aug 的数据编辑是为人机之外(机器人到机器人)场景设计的,需要精确的本体感知与动作标签;EgoMimic 用红色线段桥接外观差,且必须依赖真机数据来预测夹爪开合宽度,训练数据平均 41% 来自遥操作。Phantom 则把整套编辑机制迁移到人机场景,并把真机数据占比压到零。
为什么一定要做视频修复,直接把手遮住不行吗?
消融给出了直接答案:在未见场景中,去掉修复、只保留掩码会让成功率从 0.84 掉到 0.60,即损失 24 个百分点。黑色掩码与真实机器人观测差距过大,会持续污染视觉表征。
这套方法能处理可变形物体和多物体吗?
可以,而且这正是它区别于物体中心方法的地方。论文演示了系八字绳结(高可变形)与同时操作扫帚和六片垃圾的扫地任务(多物体、动力学不可预测),不依赖物体位姿跟踪或 SE(3) 运动假设。
测试时为什么还要在真实机器人上叠一层虚拟机器人?
因为训练图像里的机器人是渲染出来的,而测试图像里是真实机器人,颜色与纹理存在细微差异。在推理图像上叠一层同样风格的虚拟机器人,可以让训练与推理的视觉分布重新对齐,比在训练时做大量颜色扰动更简单。
它能为通用机器人策略提供什么?
Phantom 产出的就是标准的机器人观测-动作对,可以直接并入训练自回归通用策略(如 RT-X、OpenVLA、$\pi_0$ 一类)的数据集。作者把它视为把人类视频变成通用机器人策略可扩展数据源的路径。
参考链接
- 论文 arXiv 摘要页:https://arxiv.org/abs/2503.00779
- 项目主页(含视频演示):https://phantom-human-videos.github.io/
- CoRL 2025 官方论文页:https://proceedings.mlr.press/v305/lepert25a.html
- RoVi-Aug(数据编辑基础工作):https://arxiv.org/abs/2409.03403
- SHADOW(同组机器人互迁前作):https://arxiv.org/abs/2503.00774
- EgoMimic(对比基线):https://arxiv.org/abs/2410.24221
给大家推荐一款自用写文献综述、无虚构文献的 AI:
🌟 复旦大学 FudanNLP 团队自研 切问学术
覆盖 3.6 亿篇可溯源真实中英文文献,能自动整合文献观点生成规范综述
还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
🌸讨论QQ群:白拾的小屋 (750365700)
⭐B站账号:白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页:YhbCode000(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 1
 0
- 0


 已为社区贡献73条内容

所有评论(0)