多雷达多摄像头时空融合:数据感知融合技术方案全解析
多个雷达和多个摄像头协同感知——让机器既看得清、又测得准。
一辆自动驾驶车在路上跑,车顶转着几个激光雷达,车身围着一圈摄像头;一个安防园区里,雷达和摄像头盯着每个角落;一个工厂里,移动机器人靠多传感器避开障碍、识别工件。它们都面临同一个问题:单一传感器不够用。
摄像头看得清颜色、纹理、文字,却测不准距离,夜里和雨雾里就"瞎"了;激光雷达测距离准、不怕黑,却看不到颜色、认不出红绿灯和交通标志,远处点云还稀疏。
把多个雷达和多个摄像头的数据融合起来,让它们取长补短——这就是多传感器时空融合要解决的问题。但"融合"两个字说起来简单,做起来全是细节:时间对不齐、空间对不准、数据量爆炸、算法怎么设计、算力够不够……
这篇文章系统拆解:多个雷达和多个摄像头,到底怎么做数据的时空融合。从为什么要融合,到融合架构、时间同步、空间标定、三级融合方法、多雷达与多相机各自的融合、感知算法、工程落地、应用场景与能力边界,一次讲透。
|
核心判断:多传感器融合的本质,不是"把数据堆在一起",而是先在时间上对齐(同一时刻)、在空间上对齐(同一坐标系),再在合适的层级(数据 / 特征 / 决策)做互补增强。时间同步和空间标定是融合的地基,地基不稳,后面的算法再高级也没用。融合的目标是"1+1>2"——既保留摄像头的语义丰富性,又保留雷达的几何精确性,同时通过多传感器冗余提升鲁棒性。 |
|
本文看点
|
01 为什么要融合:雷达和摄像头各自的短板
1.1 摄像头:看得清,但测不准、怕黑
|
维度 |
优点 |
缺点 |
|
分辨率与语义 |
高分辨率,丰富纹理、颜色、文字,可识别标志、车牌、表情 |
— |
|
深度 |
— |
单目无绝对深度,双目/深度估计精度有限 |
|
光照 |
— |
受光照影响大,夜间、逆光、雨雾性能下降 |
|
成本 |
成本低、易部署 |
— |
|
遮挡 |
— |
对遮挡敏感,被挡就看不到 |
1.2 激光雷达:测得准,但没语义、怕天气
|
维度 |
优点 |
缺点 |
|
深度 |
精确三维深度,点云直接表达几何 |
— |
|
光照 |
主动光源,不受光照影响,夜间可用 |
— |
|
语义 |
— |
无颜色纹理,无法识别红绿灯、文字、标志 |
|
点云密度 |
— |
远距离点云稀疏,小目标易漏 |
|
天气 |
— |
雨、雾、粉尘会散射激光,产生噪点 |
|
成本 |
— |
成本较高(虽在快速下降) |
1.3 互补性:1+1>2
|
能力 |
摄像头 |
激光雷达 |
融合后 |
|
语义识别 |
强 |
弱 |
强(用相机) |
|
深度测量 |
弱 |
强 |
强(用雷达) |
|
夜间 / 低光 |
弱 |
强 |
强 |
|
雨雾天气 |
弱 |
中 |
中(互补降级) |
|
小目标检测 |
中 |
远距弱 |
强(互补) |
1.4 为什么需要"多个",而不是"一个"
•补盲:单个雷达有盲区(车顶雷达看不到车底和近处),多个雷达覆盖不同角度;单个摄像头视场有限,多个摄像头实现360° 环视;
•冗余:一个传感器故障或被遮挡时,另一个可以兜底,提升系统安全性;
•远近覆盖:长焦摄像头看远处、广角摄像头看近处;远距雷达和近距雷达配合;
•立体与视角:多摄像头可形成立体视觉,多雷达可从不同角度观测同一目标,减少遮挡。
所以呢?融合的出发点,是承认没有任何一种传感器是完美的。摄像头和雷达的优缺点几乎是镜像的,这正是它们能互补的基础。而"多个"的意义,是用数量换覆盖、换冗余、换鲁棒性。理解了这一点,才能理解后面为什么要做那么复杂的时空对齐和融合算法。
02 融合架构:从数据到决策的三级融合
多传感器融合不是一个算法,而是一套架构。理解融合,首先要搞清楚"在哪个层级融合"和"用什么方式组织"。
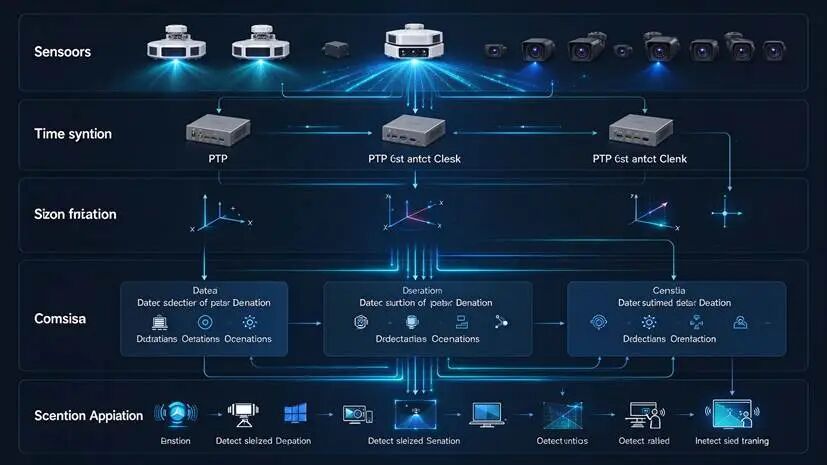
传感器—时间同步—空间标定—融合—感知应用,五层架构是融合系统的骨架。
2.1 三个融合层级
按融合发生的时机,分为数据级、特征级和决策级三级,越靠前信息越完整,越靠后计算越省。
|
层级 |
融合时机 |
优点 |
缺点 |
典型方法 |
|
数据级(早期) |
原始数据直接融合 |
信息损失最少 |
时空同步要求最高、数据量大 |
点云投影、点云着色、深度增强 |
|
特征级(中期) |
各自提取特征后融合 |
平衡信息与计算,当前主流 |
需统一特征空间 |
BEV 鸟瞰、跨模态注意力、Transformer |
|
决策级(晚期) |
各自输出结果后融合 |
计算量小、鲁棒、易实现 |
信息损失大 |
目标关联、加权投票、跟踪融合 |
2.2 数据级融合:最原始,也最苛刻
数据级融合直接把雷达点云和相机图像在原始数据层面结合,比如把点云投影到图像上、给点云着色、用雷达深度增强图像。它保留的信息最多,但对时间同步和空间标定的要求也最高——差几个毫秒、差几个像素,投影就错位了。
2.3 特征级融合:当前的主流
特征级融合先让每个传感器各自提取特征(如图像的 CNN 特征、点云的 PointNet / Voxel 特征),再把不同模态的特征映射到统一空间(如 BEV 鸟瞰图),用注意力或拼接等方式融合。它在信息保留和计算效率之间取得了较好平衡,是当前自动驾驶和机器人感知的主流方案。
2.4 决策级融合:最省心,也最粗糙
决策级融合让每个传感器独立完成检测或识别,输出目标框、类别、置信度,再在结果层面做关联和融合。它计算量小、传感器之间解耦(一个坏了不影响另一个),但因为中间信息都被丢弃了,融合效果相对粗糙,适合对延迟要求极高或传感器异构性很强的场景。
2.5 集中式、分布式与混合式
|
架构 |
做法 |
优点 |
缺点 |
|
集中式 |
所有原始数据传到中央计算单元统一处理 |
信息完整、融合充分 |
带宽和算力要求高,单点故障风险 |
|
分布式 |
每个传感器先做本地处理,再传结果到中央 |
带宽小、鲁棒、易扩展 |
信息损失大 |
|
混合式 |
关键传感器传原始数据,其他做边缘处理 |
兼顾性能与带宽 |
架构较复杂 |
2.6 融合策略怎么选
•算力充足、带宽够:优先数据级 + 特征级,信息最完整;
•算力有限、传感器多:特征级为主,决策级兜底;
•安全冗余要求高:决策级独立通道 + 特征级主通道,双保险;
•实际工程:通常是混合策略——不同任务用不同层级,比如检测用特征级、跟踪用决策级。
所以呢?融合架构没有"最好",只有"最合适"。数据级保信息、特征级保平衡、决策级保鲁棒,工程上往往是三级混合使用。选架构的核心,是在信息完整度、计算资源和系统鲁棒性之间找平衡。
03 时间同步:让所有传感器看到"同一时刻"
3.1 为什么时间同步是地基
激光雷达通常 10 Hz(每秒 10 帧),相机可能 30 fps,毫米波雷达可能 20 Hz——帧率不同、启动时刻不同、时钟也不同。如果时间不对齐,融合时雷达看到的车在 A 点、相机看到的车在 B 点,投影和检测都会错位。
|
时间偏差造成的位置误差可以估算:误差 ≈ 目标速度 × 时间偏差。例如车速 36 km/h(10 m/s),时间偏差 10 ms,位置误差就是 0.1 m;高速 100 km/h 时,10 ms 偏差就是 0.28 m。速度越快,对时间同步的要求越高。 |
3.2 时间同步的三个层次
|
层次 |
做法 |
精度 |
|
触发同步 |
硬件信号同时触发所有传感器采集 |
微秒级 |
|
时钟同步 |
所有传感器共用同一时钟基准(PTP / GPS) |
亚微秒至微秒级 |
|
时间戳对齐 |
软件层面按时间戳匹配或插值 |
毫秒级(受帧率限制) |
3.3 硬件触发同步
由主设备(如工控机、时间同步盒)发出触发信号(PPS 秒脉冲、GPIO 电平),所有传感器在同一时刻曝光或采集。这是精度最高的方式,可达微秒级,但需要硬件支持和专门布线,传感器数量多时布线复杂。
3.4 PTP / IEEE 1588 网络同步
•PTP(IEEE 1588):通过以太网精确同步时钟,主从时钟之间测量网络延迟和偏移,精度可达亚微秒至微秒级;
•gPTP(802.1AS):PTP的车载简化版,是自动驾驶和工业以太网常用的时间同步标准;
•适合支持 PTP 的工业相机、激光雷达和交换机,不需要额外触发线,通过网线即可同步。
GPS 提供绝对时间和 PPS 秒脉冲,适合户外、多设备分布式场景,精度微秒级。但室内或遮挡环境 GPS 失效,需要配合其他同步方式。
3.6 软件时间戳对齐
每个数据携带时间戳,融合时在软件层面做对齐:
•最近邻匹配:选时间最接近的一帧;
•线性插值:在两帧之间插值出目标时刻的状态;
•运动补偿:利用车辆/机器人自身运动(里程计、IMU)把不同时刻的数据补偿到同一时刻。
软件对齐实现简单、无需额外硬件,但精度受时钟漂移和帧率限制,通常作为硬件同步的补充。
3.7 同步精度要求
|
场景 |
建议时间同步精度 |
|
高速自动驾驶 |
< 5 ms |
|
城市自动驾驶 / 机器人 |
< 10 ms |
|
工业检测 / 低速 AGV |
< 20 ms |
|
静态场景(安防、监控) |
要求较低,秒级可接受 |
所以呢?时间同步是融合的第一道关。硬件触发保精度、PTP 保便利、软件对齐保兜底,工程上通常是"硬件同步为主、软件对齐为辅"。时间同步做不好,后面的空间标定再准、算法再强,融合结果也会是"错位的拼图"。
04 空间标定:让所有传感器在同一个坐标系里说话
时间对齐之后,下一个地基是空间对齐。每个雷达、每个相机都有自己的坐标系,如果不把它们统一到同一个基准,点云和图像就"对不上"。
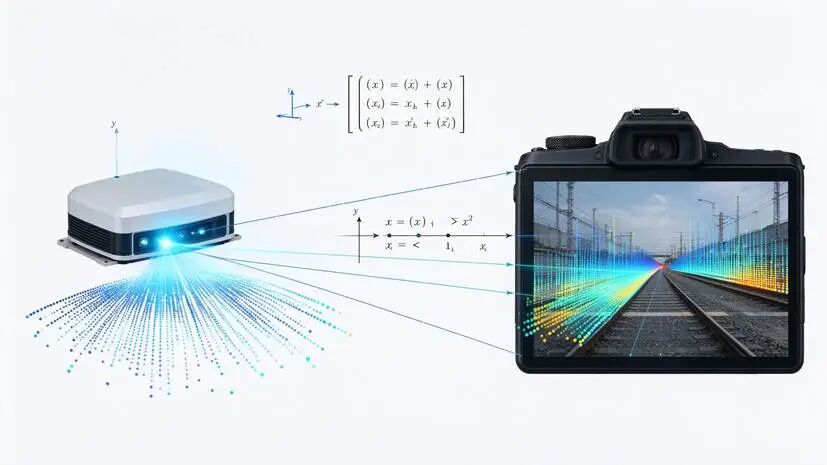
雷达点云经外参变换投影到图像——空间标定是融合的几何基础。
4.1 坐标系体系
|
坐标系 |
说明 |
|
雷达坐标系 |
每个激光雷达自身的三维坐标系 |
|
相机坐标系 |
每个相机自身的三维坐标系 |
|
图像像素坐标系 |
相机成像后的二维像素坐标 |
|
车体 / 基座坐标系 |
所有传感器的统一基准(如车辆后轴中心) |
|
世界坐标系 |
全局坐标,用于定位和地图 |
4.2 相机内参标定
相机内参描述相机自身的成像特性:
•焦距 fx、fy;
•主点 cx、cy(光心在图像中的位置);
•畸变系数 k1、k2、p1、p2(径向和切向畸变)。
通常用棋盘格或标定板,从不同角度拍摄多张照片,用张正友标定法等算法求解。标定后可对图像做去畸变处理。
4.3 雷达到相机的外参标定
外参是雷达坐标系到相机坐标系的旋转矩阵 R 和平移向量 t(共 6个自由度)。有了外参,雷达点云就能变换到相机坐标系,再投影到图像上:
|
投影公式:将雷达点 (X, Y, Z) 变换到相机坐标系后,投影到像素坐标 u = fx · X / Z + cx,v = fy · Y / Z + cy。外参不准,投影就会错位。 |
标定方法包括:
•标定板法:用同时被雷达和相机看到的棋盘格 / 标定靶,提取对应点求解;
•手动标注法:在点云和图像上人工标注对应点,求解外参;
•自动标定法:利用边缘、平面等特征自动匹配,减少人工。
4.4 多雷达之间的标定
多个雷达需要统一到车体坐标系。每个雷达都有一个到车体的外参。标定方法:
•共用标定靶,同时被多个雷达观测;
•在重叠区域做点云配准(ICP);
•已知安装位置(机械尺寸)+ 现场校准修正。
4.5 多相机之间的标定
多个相机(如环视 4 路、前视双目)需要相机间外参,用于立体视觉、环视拼接和跨相机跟踪。标定方法与雷达到相机类似,用标定板同时拍摄,求解相对位姿。
4.6 联合标定与在线标定
•联合标定:用同一个标定场景或标定靶,同时被所有传感器观测,一次性求出所有外参,保证全局一致;
•在线标定 / 自标定:车辆运动中,利用道路、车道线、固定目标持续估计外参漂移,自动修正振动、温度变化导致的标定偏差。
4.7 标定精度与维护
|
因素 |
影响 |
|
外参角度误差 |
远距离投影错位被放大(1° 误差在 50 m 处约错位 0.87 m) |
|
振动 / 碰撞 |
传感器位置变化,外参失效 |
|
温度变化 |
结构热胀冷缩,外参微小漂移 |
|
维护 |
定期复检,振动大的场景缩短标定周期 |
所以呢?空间标定回答的是"这个点在图像上的哪个像素、在车体的哪个位置"。内参管成像、外参管位姿、联合标定管全局一致、在线标定管长期稳定。标定是融合的几何基础,标定误差会被距离放大,越远越明显,必须定期维护。
05 数据级融合:点云与图像的直接对话
数据级融合是最"早"的融合——在原始数据层面,让点云和图像直接发生关系。它保留的信息最多,也是可视化和后续处理的基础。
5.1 点云投影到图像
利用标定好的外参和内参,把雷达三维点云投影到二维图像上,每个点获得对应的像素坐标。这是最基础的数据级融合操作,可用于:
•可视化:在图像上叠加深度点云,直观检查融合效果;
•ROI 提取:用点云的深度范围,在图像上裁剪出感兴趣区域;
•数据校验:检查标定和同步是否准确。
5.2 点云着色:给点云"上色"
点云投影到图像后,取对应像素的 RGB 值赋给点云,原本灰白的点云就变成了彩色点云。着色后的点云:
•便于人工查看和标注;
•可结合颜色做点云语义分割;
•提升可视化效果和人机交互体验。
|
遮挡问题:被前景物体挡住的点,投影后会落在错误的像素上。着色时必须做深度排序——只有离相机最近的点才取像素颜色,被遮挡的点跳过或用邻域颜色插值。 |
5.3 深度增强:用雷达补全图像深度
激光雷达点云是稀疏的(远处可能几米一个点),而图像每个像素都有信息。数据级融合可以用雷达稀疏深度作为"锚点",补全出稠密深度图:
|
方法 |
做法 |
特点 |
|
传统插值 |
对稀疏深度点做插值(最近邻、双边、联合双边) |
快,但边缘模糊 |
|
深度学习补全 |
用 CNN / GAN 以图像为引导,从稀疏深度预测稠密深度 |
边缘清晰,需训练数据 |
|
多帧累积 |
融合多帧点云,增加深度密度 |
需运动补偿,动态物体有重影 |
稠密深度图可用于障碍物检测、可通行区域分析、三维重建等。
5.4 图像引导点云去噪
雨、雾、粉尘会让雷达产生大量飞点噪点。利用图像的语义信息(如识别出天空、远处地面),可以引导点云去噪:图像上对应天空或远处的点,大概率是噪点,予以过滤。
5.5 工程实现要点
•投影矩阵预计算:外参内参固定时,投影矩阵可预计算,减少运行时计算;
•点—像素索引映射:建立每个点到像素的映射表,加速着色和深度增强;
•遮挡检测:按深度排序,只保留可见点;
•GPU加速:点云和图像数据量大,投影、着色、插值都适合GPU 并行。
5.6 数据级融合的局限
•对时间同步和空间标定要求极高,差一点就错位;
•数据量大,高分辨率图像 + 高密度点云对带宽和算力压力大;
•雷达看不到的遮挡区域,无法用数据级融合增强;
•投影错位会导致着色错误、深度补全错误,误差会传导到后续感知。
所以呢?数据级融合是"最原始、最完整、也最挑剔"的融合方式。它的价值在于可视化、深度增强和为后续算法提供更丰富的输入,但它不能单独完成感知任务,通常作为特征级融合的预处理步骤。
06 特征级融合:BEV 鸟瞰与跨模态注意力
特征级融合是当前的主流——先让每个传感器各自提取特征,再把特征映射到统一空间做融合。它在信息保留和计算效率之间取得了平衡,也是自动驾驶和机器人感知最常用的方案。
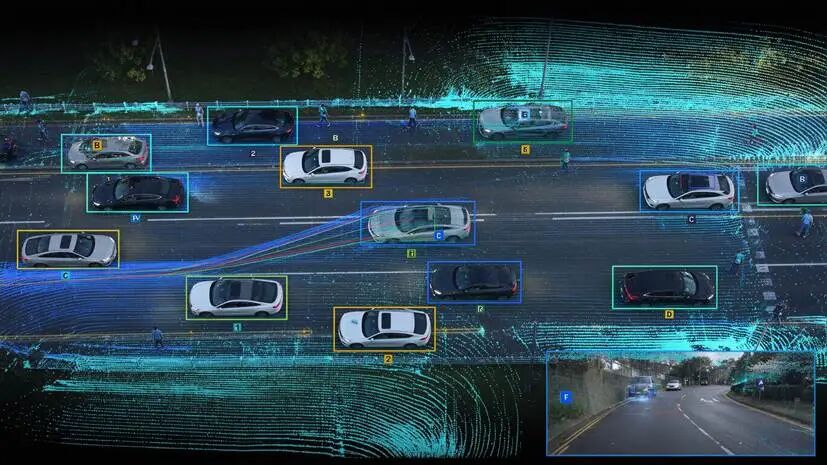
所有传感器特征汇聚到 BEV 鸟瞰图——特征级融合的统一舞台。
6.1 为什么特征级是主流
|
层级 |
信息保留 |
计算量 |
同步要求 |
|
数据级 |
最多 |
最大 |
最高 |
|
特征级 |
中等 |
中等 |
中等 |
|
决策级 |
最少 |
最小 |
最低 |
特征级既避免了数据级的海量原始数据和苛刻同步要求,又比决策级保留了更多中间信息,因此成为工程上的首选。
6.2 BEV 鸟瞰图:统一特征空间
BEV(Bird's Eye View,鸟瞰图)是自动驾驶最常用的统一特征空间。所有传感器的特征都变换到 BEV 下(x 向前、y 向左的俯视图),再做融合。BEV 的优势:
•自上而下的视角,天然适合检测、跟踪和路径规划;
•不同传感器的特征在同一坐标系下可直接对齐;
•尺度一致,远近目标在 BEV 下有相同的物理分辨率。
6.3 图像到 BEV 的变换
|
方法 |
做法 |
特点 |
|
逆透视变换(IPM) |
假设地面为平面,把图像直接投影到 BEV |
快,但只适用于地面,高处物体变形 |
|
深度估计 + 投影 |
先估计每个像素深度,再投影到 3D,再体素化到 BEV |
精度依赖深度估计 |
|
LSS(Lift-Splat-Shoot) |
预测像素深度分布,lifting 到 3D,splatting 到 BEV |
端到端可训练,主流方法 |
|
Transformer 注意力 |
用 BEV query 交叉关注图像特征,直接生成 BEV |
灵活,计算量大 |
6.4 点云到 BEV 的变换
•体素化(Voxelization):把点云分到 3D 体素网格,提取每个体素特征,再沿 z 轴压缩到 BEV;
•柱体化(Pillarization):PointPillars 方法,把点云分到垂直柱体,提取柱体特征,直接形成 BEV;
•直接投影:点云的 x-y 坐标直接对应 BEV 网格,z 信息作为特征通道。
6.5 跨模态融合方法
|
方法 |
做法 |
特点 |
|
拼接(Concat) |
BEV 下图像特征与点云特征在通道维度拼接 |
简单,常用 |
|
相加(Add) |
特征逐元素相加 |
参数少,需特征维度一致 |
|
注意力(Attention) |
跨模态注意力,动态学习每个位置的模态权重 |
灵活,效果好,计算量大 |
|
门控(Gating) |
学习门控权重,自适应融合 |
可处理模态失效 |
6.6 Transformer 与注意力融合
基于 Transformer 的融合是当前研究热点:
•自注意力:模态内特征交互,捕捉长距离依赖;
•交叉注意力:模态间特征交互,让图像特征关注点云、点云特征关注图像;
•BEV Query:用一组BEV 查询向量,同时交叉关注图像特征和点云特征,直接解码出BEV 表示。
6.7 典型网络结构
|
网络 |
融合思路 |
|
BEVFormer |
图像 BEV + 时序对齐,纯视觉方案 |
|
TransFusion |
点云为主干,用图像 query 补充语义 |
|
DeepFusion |
图像与点云在特征深度融合,Inverse Augmentation |
|
CenterFusion |
点云先检测,再把图像特征追加到检测框 |
6.8 特征级融合的优势与挑战
优势:统一空间下融合充分,语义与几何结合,端到端可训练,性能上限高。
挑战:图像到 BEV 的变换有误差(深度估计不准会导致特征错位);计算量大,需要 GPU 加速;多传感器特征对齐难;需要大量标注数据训练。
所以呢?特征级融合的核心思想是"先各自理解,再统一对话"。BEV 提供了统一的"对话空间",注意力提供了灵活的"对话方式"。它是当前性能最好的融合方案,但也是对算力、数据和标定要求最高的方案——工程落地时,需要根据实际资源选择合适的网络结构。
07 决策级融合:结果层面的智慧投票
7.1 决策级融合的定位
决策级融合是最"晚"的融合——每个传感器独立完成检测或识别,输出目标列表(位置、大小、类别、置信度),再在结果层面做关联和融合。它计算量最小、传感器之间解耦最彻底,是工程上最容易落地的融合方式。
7.2 目标关联:怎么知道是同一个目标
决策级融合的第一步,是判断不同传感器检测到的目标是不是同一个。常用方法:
|
方法 |
做法 |
|
IoU 交并比 |
统一坐标系后,计算检测框的交并比,超过阈值视为同一目标 |
|
马氏距离 |
考虑目标状态的协方差,计算统计距离,适合跟踪融合 |
|
匈牙利算法 |
全局最优匹配,解决多目标关联的分配问题 |
|
贪心匹配 |
按距离从小到大依次匹配,简单快速 |
关联前必须先把所有传感器的检测结果统一到同一坐标系(用车体外参变换),否则位置不可比。
7.3 融合策略
|
策略 |
做法 |
特点 |
|
加权投票 |
按置信度加权,类别和状态取加权平均 |
简单常用 |
|
贝叶斯融合 |
用贝叶斯公式融合多个传感器的概率估计 |
概率意义明确 |
|
D-S 证据理论 |
处理不确定性和传感器冲突,支持"未知"状态 |
适合高冲突场景 |
|
取并集 / 交集 |
并集提高召回率,交集提高准确率 |
最简单 |
|
置信度择优 |
同一目标取置信度最高的检测结果 |
实现简单 |
7.4 跟踪融合:卡尔曼滤波
决策级融合不仅融合单帧检测,还融合多帧跟踪结果。每个传感器可以独立跟踪,输出轨迹;再在轨迹层面做融合:
•卡尔曼滤波:融合多个传感器的观测,更新目标状态(位置、速度、加速度),是最经典的跟踪融合方法;
•联邦卡尔曼:每个传感器做局部滤波,再在全局融合,适合分布式架构;
•联合概率数据关联(JPDA):处理密集目标下的数据关联问题;
•多假设跟踪(MHT):保留多种关联假设,延迟决策,适合复杂场景。
7.5 工程实现要点
•统一目标表示:所有传感器输出统一格式(位置、大小、速度、类别、置信度、传感器来源、时间戳);
•关联阈值:根据场景设置合理的距离和 IoU 阈值,避免误关联和漏关联;
•冲突处理:传感器结果不一致时(如雷达说有车、相机说没有),按置信度或策略处理,不简单丢弃;
•传感器健康监控:监控每个传感器的状态,一个失效时自动降级,用剩余传感器继续工作。
7.6 决策级融合的优势与局限
|
维度 |
说明 |
|
优势 |
计算量小、传感器解耦、易替换扩展、鲁棒性好、易实现调试 |
|
局限 |
信息损失大、关联错误会传导、小目标漏检后无法补回、精度受单传感器限制 |
所以呢?决策级融合是"最省心、最鲁棒,但也最粗糙"的融合方式。它适合算力有限、传感器异构、安全冗余要求高的场景,也常作为特征级融合的兜底通道。在实际系统中,决策级和特征级往往同时存在——主通道用特征级保性能,兜底通道用决策级保安全。
08 多雷达融合:多个激光雷达怎么拼成一个
8.1 为什么需要多个雷达
|
目的 |
说明 |
|
补盲 |
单个雷达有盲区(车底、近处、被车身遮挡),多个雷达从不同角度覆盖 |
|
增密 |
重叠区域点云密度更高,小目标更易检测 |
|
扩范围 |
前向、侧向、后向雷达配合,实现 360° 覆盖 |
|
冗余 |
一个雷达故障或被遮挡时,另一个可以兜底 |
8.2 坐标系统一:第一步是变换
多雷达融合的第一步,是把每个雷达的点云通过外参变换到统一的车体坐标系。外参(旋转 R + 平移 t)在标定阶段确定,运行时直接做坐标变换:
|
P |


8.3 点云配准:外参不准时怎么办
如果外参标定有误差,或运行中因振动发生漂移,直接变换会出现"重影"。此时需要点云配准来修正:
|
方法 |
做法 |
特点 |
|
ICP(迭代最近点) |
迭代寻找最近点对,最小化距离,优化位姿 |
经典,需初始位姿较准 |
|
NDT(正态分布变换) |
把点云分成体素,用正态分布描述,优化匹配概率 |
比 ICP 快,对初始位姿要求低 |
|
特征匹配 |
提取边缘、角点等特征,匹配后求解位姿 |
适合特征丰富的场景 |
|
在线自标定 |
利用重叠区持续修正外参漂移 |
长期运行中自动维护精度 |
8.4 重叠区处理:去重与融合
多个雷达的视野会有重叠,同一物体可能被多个雷达同时看到,产生重复点:
•体素下采样(Voxel Grid):把空间分成体素网格,每个体素只保留一个点(或重心),高效去重;
•保留重叠:重叠区密度更高,对检测有利,可选择不去重;
•冲突处理:不同雷达对同一物体测量不一致时,取平均值或按置信度加权。
8.5 时间同步与运动补偿
多个雷达帧率不同、采集时刻不同,在运动中会导致点云"错位":
•运动补偿:利用 IMU / 里程计记录车辆运动,把不同时刻的点云补偿到同一时刻;
•统一时间戳:每帧点云带精确时间戳,融合时选最近时刻或插值;
•硬件同步:用 PTP 或触发信号让多雷达同时采集,从源头减少时间差。
8.6 多雷达点云的去噪与滤波
多雷达融合后,噪点也会叠加,需要统一滤波:
•统计滤波:去除邻域内点数过少的离群点;
•半径滤波:去除指定半径内邻居不足的点;
•地面分割:去除地面点,减少数据量;
•动态物体处理:多帧对比,识别并处理运动物体的点云。
8.7 工程实现要点
|
环节 |
要点 |
|
处理顺序 |
坐标变换 → 运动补偿 → 去重 → 滤波 → 输出统一点云 |
|
数据量管理 |
多雷达点云数据量大,按需抽稀,控制处理延迟 |
|
实时性 |
配准和滤波要在帧间完成,常用 GPU 加速 |
|
质量监控 |
监控每个雷达的点云质量、覆盖率和外参稳定性 |
所以呢?多雷达融合的核心是"先统一坐标、再处理重叠、最后保证实时"。外参是基础,配准是修正,去重滤波是收尾。多个雷达不是简单"1+1=2",而是通过融合实现覆盖更全、密度更高、鲁棒性更强的点云输出。
09 多摄像头融合:环视、立体与跨相机跟踪
9.1 为什么需要多个摄像头
|
目的 |
说明 |
|
360° 环视 |
前、后、左、右多个摄像头,覆盖车辆周围全部方向 |
|
立体视觉 |
双目 / 多目相机,通过视差计算深度 |
|
远近配合 |
广角摄像头看近处,长焦摄像头看远处 |
|
冗余 |
一个摄像头被遮挡或故障时,其他可以兜底 |
9.2 坐标系统一
每个摄像头都有内参(焦距、主点、畸变)和到车体的外参(旋转 + 平移)。多摄像头融合的第一步,是把所有相机统一到车体坐标系或BEV 坐标系下,这样不同相机的观测才能互相对齐和关联。
9.3 环视拼接:360° 全景
自动泊车和低速场景常用 4–6 个摄像头(前、后、左、右)拼接成 360° 环视全景图:
•每个相机图像经逆透视变换(IPM)投影到统一俯视平面;
•做亮度均衡、畸变校正和接缝融合;
•输出一张无缝的鸟瞰全景图。
挑战:拼接缝错位、不同相机曝光差异、动态物体在接缝处重影、标定漂移导致全景变形。需要精细的标定和实时的亮度均衡。
9.4 立体视觉:纯视觉深度
双目或多目相机通过基线(两相机间距)和视差计算深度:
|
方法 |
做法 |
特点 |
|
传统立体匹配(SGM) |
半全局匹配,计算像素级视差 |
成熟,弱纹理区域难匹配 |
|
深度学习立体匹配 |
用 CNN / Transformer 预测视差图 |
精度高,需 GPU 和训练数据 |
|
多目立体 |
三个以上相机,多基线融合 |
鲁棒性更好,计算量大 |
立体视觉的优势是纯视觉、成本低,但基线短则测不远,弱纹理区域(白墙、天空)匹配困难。
9.5 跨相机目标关联与跟踪
目标从一个相机视野移动到另一个相机视野时,需要跨相机关联,保持同一个目标的连续轨迹:
•位置预测:用卡尔曼滤波预测目标在下一帧、下一相机中的位置;
•外观特征(ReID):提取目标外观特征,跨相机匹配同一目标;
•匈牙利匹配:在预测位置和外观特征的基础上,做全局最优关联;
•统一轨迹:在车体坐标系下,合并不同相机的观测,形成一条连续轨迹。
9.6 多摄像头时序融合
多个摄像头帧率可能不同(如前视 30 fps、环视 15 fps),需要:
•精确时间同步(硬件触发或 PTP);
•统一时间戳,融合时选最近帧或插值;
•多帧累积,提高检测稳定性(尤其是低帧率相机)。
9.7 工程实现要点
|
环节 |
要点 |
|
标定 |
每个相机的内参和外参,定期复检 |
|
预处理 |
去畸变、缩放、亮度均衡、色彩校正 |
|
统一规格 |
统一分辨率和帧率,便于并行处理 |
|
GPU 并行 |
多路视频同时处理,需 GPU 并行和解码 |
|
带宽管理 |
多路高清视频数据量大,需压缩和传输优化 |
所以呢?多摄像头融合的核心是"统一坐标、统一时间、统一轨迹"。环视拼接解决"看得全",立体视觉解决"测得深",跨相机跟踪解决"跟得住"。多个摄像头不是简单的"多路视频",而是通过标定和关联形成一个统一的视觉感知系统。
10 融合感知算法:检测、分割与跟踪
时空对齐和三级融合之后,最终要输出感知结果——目标在哪、是什么、在怎么动。这一节讲融合感知的三大任务:检测、分割、跟踪。
10.1 融合目标检测
目标检测是融合感知最核心的任务,输出每个目标的 3D 检测框:位置 (x, y, z)、尺寸 (l, w, h)、朝向 (yaw)、类别和置信度。
|
融合方式 |
做法 |
代表方法 |
|
前融合(特征级) |
点云和图像一起输入网络,在 BEV 或特征空间融合,输出 3D 检测框 |
BEVFusion、TransFusion |
|
中融合(点云着色) |
先给点云着色(附加图像语义),再用点云检测网络 |
PointPainting、FusionPainting |
|
后融合(决策级) |
点云和图像各自检测,再在结果层面关联融合 |
CenterFusion、加权关联 |
10.2 融合语义分割
语义分割给每个点或像素分类(如道路、人行道、车辆、行人、建筑物)。融合方式:
•点云引导图像分割:用点云深度提供几何先验,提升图像分割的边界精度;
•图像引导点云分割:用图像语义给点云分类(如 PointPainting 思路);
•跨模态联合分割:在统一特征空间同时分割点云和图像。
应用场景:可通行区域检测、车道线识别、障碍物分类、地面与非地面分离。
10.3 实例分割与全景分割
•实例分割:不仅分类,还区分每个目标实例(如"车1""车2");
•全景分割:语义分割 + 实例分割,既分类又区分实例,是更完整的场景理解;
•融合后,点云的几何和图像的语义互补,实例分割的边界更准确、类别更可靠。
10.4 融合多目标跟踪
检测给出单帧目标,跟踪给出跨帧的连续轨迹:
•卡尔曼滤波:融合多个传感器的观测,更新目标状态(位置、速度、加速度);
•数据关联:用匈牙利算法或 JPDA,把检测和已有轨迹匹配;
•轨迹管理:新目标新生、稳定目标维持、长时间未检测到的目标消失;
•跨传感器跟踪:目标从一个传感器视野进入另一个时,保持轨迹连续。
10.5 融合感知的输出
|
输出 |
内容 |
|
3D 目标列表 |
位置、尺寸、朝向、类别、速度、置信度、跟踪 ID |
|
语义分割图 |
每个点 / 像素的类别标签 |
|
可通行区域 |
地面、可行驶区域的边界 |
|
不确定性 |
每个结果的置信度和传感器来源 |
10.6 典型算法框架
|
框架 |
融合思路 |
|
BEVFusion |
点云和图像都变换到 BEV,统一空间后融合,支持检测和分割 |
|
TransFusion |
点云为主干,用图像 query 补充语义,Transformer 融合 |
|
PointPainting |
图像语义分割结果"画"到点云上,再做点云检测 |
|
CenterFusion |
点云先检测中心,再把图像特征追加到检测框,后融合 |
所以呢?融合感知算法的目标,是把"点云的几何"和"图像的语义"变成结构化的场景理解——知道有什么、在哪里、在怎么动。检测回答"是什么在哪",分割回答"每个像素是什么",跟踪回答"它在怎么动"。三者结合,才是完整的融合感知。
11 工程落地:算力、延迟、标定维护与异常处理
算法再好,落不了地也是空谈。这一节讲多传感器融合系统在工程上要面对的现实问题:算力够不够、延迟能不能接受、标定怎么维护、传感器坏了怎么办。
11.1 算力需求与硬件选型
多个激光雷达(每帧数十万到上百万点)+ 多个摄像头(多路高清视频)的数据量巨大,融合感知需要强大的算力:
|
计算任务 |
算力需求 |
|
点云预处理 |
去噪、体素化、特征提取,CPU + GPU |
|
图像推理 |
多路视频的检测 / 分割,GPU / NPU |
|
融合计算 |
BEV 变换、注意力、特征拼接,GPU |
|
跟踪与后处理 |
卡尔曼滤波、数据关联,CPU |
硬件平台通常选择车规级或工业级 GPU / NPU 边缘计算平台(如 NVIDIA Jetson 系列、车规级 SoC),并根据传感器数量和算法复杂度做算力预算。
11.2 延迟控制
自动驾驶和机器人对延迟敏感,通常要求端到端延迟在百毫秒以内:
•流水线处理:采集 → 预处理 → 推理 → 融合 → 输出,各阶段流水线并行;
•多线程 / 多进程:不同传感器、不同任务并行处理;
•帧率匹配:不同传感器帧率不同,用缓冲区和时间戳同步;
•模型优化:量化、剪枝、TensorRT 加速,降低推理延迟。
11.3 标定维护与在线校准
|
工作 |
要点 |
|
定期标定 |
按周期复检外参,振动大的场景缩短周期 |
|
在线自标定 |
运行中利用场景特征自动修正外参漂移 |
|
标定验证 |
投影检查、重叠区一致性检查,发现超差及时报警 |
|
版本管理 |
记录每次标定的参数、时间和人员,可追溯 |
11.4 传感器异常与降级处理
传感器可能离线、被遮挡、数据质量下降,系统必须能检测并降级:
•故障检测:监控每个传感器的在线状态、数据频率、点云质量、图像质量;
•降级策略:一个传感器失效时,自动切换到剩余传感器的融合模式,不中断工作;
•置信度调整:数据质量下降时,降低输出置信度或标记"待复核";
•故障记录:记录故障时间、传感器、影响范围,便于运维和追溯。
11.5 数据存储与回放
•原始数据记录:点云、图像、时间戳、传感器状态、车辆状态,完整记录;
•问题复现:出问题时回放数据,定位算法或标定问题;
•模型训练:积累的数据用于模型迭代和优化;
•存储管理:数据量大,采用循环覆盖、分级存储(热数据 SSD、冷数据 HDD / 云)。
11.6 测试与验证
|
阶段 |
内容 |
|
仿真测试 |
在仿真环境中验证算法,覆盖极端场景 |
|
封闭场地 |
可控环境下测试精度、延迟、降级 |
|
真实场景 |
实际道路 / 工厂 / 园区长时间运行验证 |
|
核心指标 |
检测率、误报率、定位精度、跟踪稳定性、端到端延迟 |
所以呢?工程落地的核心是"算得动、跟得上、稳得住、坏了能扛"。算力是基础,延迟是红线,标定是保障,降级是底线。一个能跑demo 的融合系统和一个能长期稳定运行的融合系统,差距全在这些工程细节里。
12 应用场景:融合感知在哪里发挥价值
12.1 自动驾驶
自动驾驶是多传感器融合最典型的场景。车辆通常搭载多个激光雷达(车顶主雷达 + 侧向补盲雷达)、多个摄像头(前视、环视、侧视)、毫米波雷达和超声波雷达。融合感知负责:
•3D 目标检测(车辆、行人、骑行者、障碍物);
•车道线和可通行区域识别;
•交通标志和红绿灯识别(用摄像头);
•多目标跟踪和轨迹预测;
•冗余安全:一个传感器失效时,其他传感器兜底。
12.2 移动机器人与 AGV
工厂、仓库、园区的移动机器人(AGV / AMR)用激光雷达 + 摄像头实现:
•同步定位与地图构建(SLAM);
•动态障碍物检测与避障;
•人员识别和安全区域监控;
•物料识别和精准对接。
12.3 智能安防
园区、港口、机场的安防系统用雷达 + 摄像头融合:
•雷达提供远距离、全天候的目标检测和定位;
•摄像头提供目标的图像和身份识别(人脸识别、车牌识别);
•融合后实现"雷达发现 → 摄像头跟踪 → 身份识别"的联动;
•夜间、雾天、雨天下,雷达补摄像头的短板。
12.4 工业检测与质量控制
工厂产线上,激光雷达 + 摄像头融合用于:
•产品三维尺寸测量(雷达测几何、相机测外观缺陷);
•缺陷检测(表面划痕、变形、缺件);
•机器人引导(视觉引导机械臂精准抓取);
•体积测量(物流包裹、散料堆体)。
12.5 智慧交通与车路协同
路侧感知设备(雷达 + 摄像头)融合后:
•全天候监测路口和路段的车辆、行人;
•提供超视距感知(路侧雷达看到车辆看不到的角落);
•交通流量统计和事件检测(事故、拥堵、逆行);
•向车辆和行人广播危险预警。
12.6 无人机与低空经济
无人机搭载激光雷达 + 摄像头:
•三维测绘和建模(地形、建筑、电力线巡检);
•障碍物检测与避障(低空飞行安全);
•目标识别与跟踪(巡检、搜救、安防);
•精准降落和自主导航。
|
场景 |
核心融合价值 |
|
自动驾驶 |
3D 检测 + 语义识别 + 冗余安全 |
|
移动机器人 |
SLAM + 避障 + 人员安全 |
|
智能安防 |
全天候发现 + 图像识别 + 联动跟踪 |
|
工业检测 |
几何测量 + 外观缺陷 + 机器人引导 |
|
智慧交通 |
超视距感知 + 流量统计 + 事件检测 |
|
无人机 |
三维测绘 + 避障 + 目标跟踪 |
所以呢?多传感器融合不是某个行业的专属技术,而是所有需要"既看得清又测得准"的感知系统的共同选择。场景不同,传感器配置和融合策略不同,但核心逻辑一致——用互补的传感器和合理的融合架构,构建一个更鲁棒、更精确的感知系统。
13 难点与能力边界
13.1 标定漂移
车辆振动、温度变化、碰撞维修都会导致传感器外参漂移。标定一旦漂移,融合就会错位,而且漂移是缓慢发生的,不容易被立刻发现。应对:在线自标定 +定期复检 +标定超差报警。
13.2 极端天气
暴雨、浓雾、大雪、扬尘会同时影响激光雷达(散射、噪点)和摄像头(能见度低、画面模糊)。融合可以在一定程度上互补,但极端天气下所有传感器性能都会下降,系统应能识别并降低置信度,而不是强行输出结果。
13.3 算力与延迟的矛盾
传感器越多、算法越复杂,算力需求越大,延迟也越高。但自动驾驶和机器人对延迟敏感。应对:模型优化(量化、剪枝)、硬件加速、流水线并行、合理选择融合层级(不是所有任务都要用最重的特征级融合)。
13.4 数据标注成本
特征级融合(尤其是深度学习方法)需要大量标注数据,而多传感器数据的标注(3D 框、点云分割、跨传感器对应)比纯图像标注昂贵得多。应对:仿真数据生成、半监督 /自监督学习、主动学习、数据闭环。
13.5 传感器故障与共因失效
多传感器冗余可以应对单个传感器故障,但如果多个传感器因同一原因失效(如共用电源故障、共用线束损坏、同一场极端天气),就是"共因失效"。应对:电源和通信冗余、物理隔离、独立的降级通道。
13.6 融合不是万能的
|
多雷达多摄像头时空融合,本质上是在回答一个问题:如何让机器用多种感官,构建一个对物理世界的统一、准确、鲁棒的理解。
它不是简单地把数据堆在一起,而是从时间同步、空间标定这些地基开始,在数据、特征、决策三个层级做互补增强,最终输出结构化的感知结果。每一层都有自己的方法、挑战和适用场景。
评估一套融合系统是否靠谱,可以看三件事——
|
好的融合系统,不是传感器越多越好,而是每个传感器都在对的位置、用对的方式、在对的层级发挥作用。当雷达的精确几何和相机的丰富语义真正融为一体,机器对世界的理解,才真正从"看到"走向"看懂"。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 3
 0
- 0


 已为社区贡献7条内容

所有评论(0)