第09讲 · 多媒体与音频 SDK:硬件编解码与端侧语音
系列:《高通 NPU 边缘 AI 实战:从芯片架构到开发板落地》
从零到一 · 高通 Dragonwing 边缘 AI 12 讲
数据口径:本讲数值凡标注[官方](厂商公开规格)、[推算](基于架构的估算)、[实测](仅给测量方法、不替你出数字)。估算不冒充实测。
本讲定位:前 8 讲你已能在犀牛派 A1(QCS6490)上把模型转换、量化、编译并在 HTP 上首跑,第 08 讲还接了相机做实时检测。但真实产品里,视频和音频是流——摄像头在持续吐画面、麦克风在持续收声音,你不可能"先录完一段再离线分析"。本讲解决的就是这个 gap:让 AI 推理嵌进音视频流,边采集、边解码、边推理、边出结果。
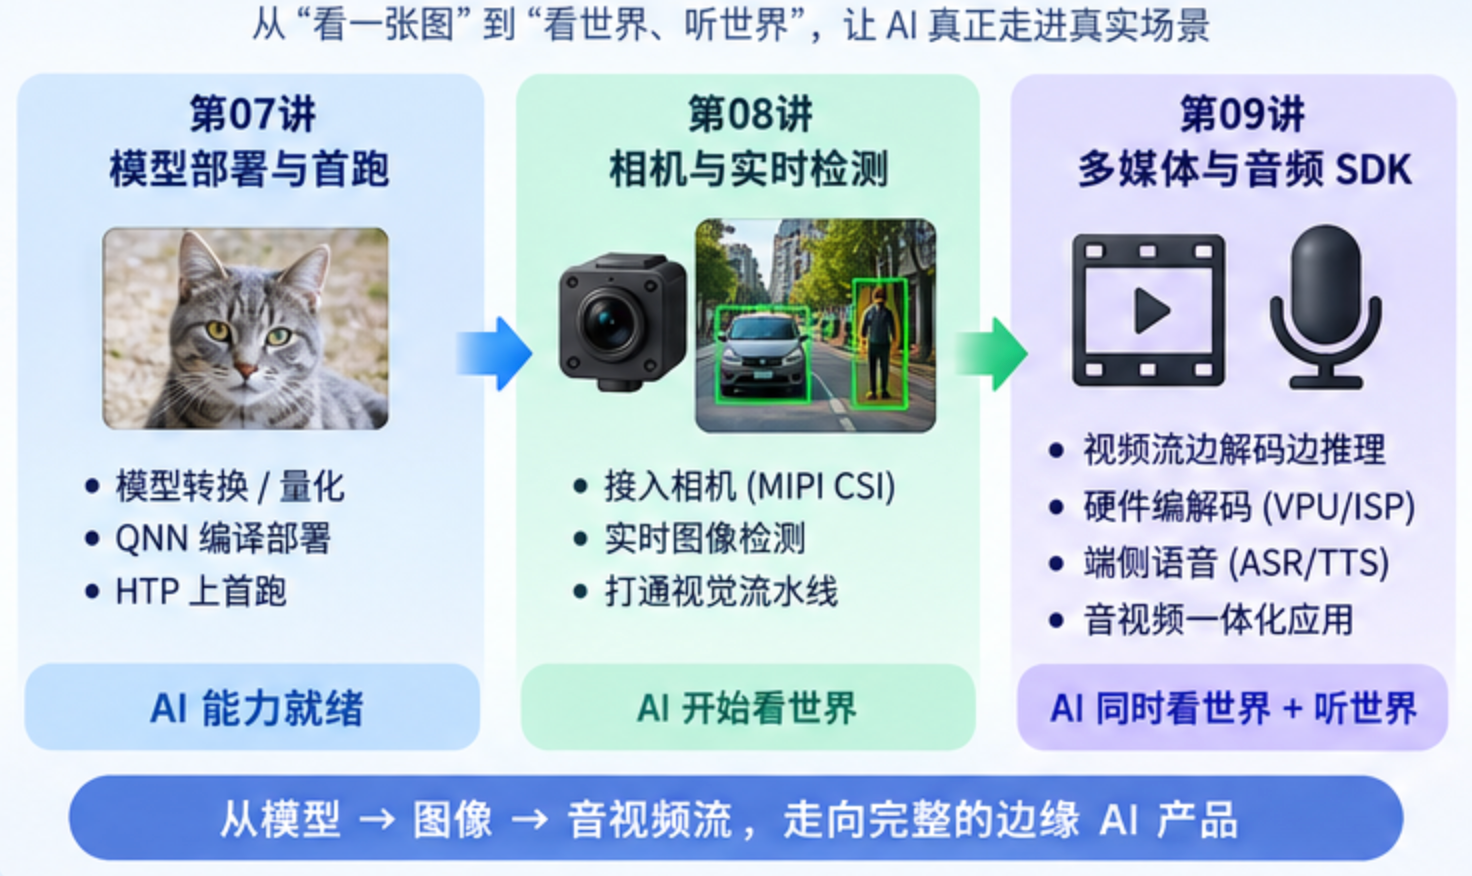
本讲目标
- 目标读者:已完成第 03–08 讲、能在板上跑通单帧/单路推理,想把能力扩展到"连续音视频流"的开发者。
- 本讲目标:
- 理解为什么硬件编解码是实时 AI 的隐形前提——软件编解码会吃掉本就紧张的 CPU 与带宽。
- 掌握"视频流边解码边推理"的 pipeline 设计(capture → decode → NPU → display/encode)。
- 理解端侧语音(ASR/TTS)在 NPU 上的部署思路与延迟/体积权衡。
- 能拼出一个"录像 + 推理标注"一体化样例的架构。
- 你将带走:一张视频流 pipeline 架构图、一张端侧语音 pipeline 架构图、带宽与音频吞吐的估算方法、多媒体/音频 SDK 选型对照表。
一、环境调研:为什么"边采集边推理"是边缘 AI 的必答题
1.1 离线分析 vs 流式处理
我们在第 07、08 讲做的推理,大多是"给一张图、出一次结果"。但工业产线、安防监控、车载环视、机器人感知的真实输入是持续不断的流:
| 维度 | 离线分析(第07/08讲风格) | 流式处理(本讲) |
|---|---|---|
| 输入 | 单张图片 / 单段视频文件 | 持续相机流 / 麦克风流 |
| 节拍 | 手动触发一次 | 固定帧率(如 30fps)循环 |
| 解码 | 一次性解码完 | 边解码边送 NPU,不能积压 |
| 瓶颈 | 单次延迟 | 端到端延迟 + 缓冲堆积 |
| 典型场景 | 图片分类 demo | 实时监控、机器人避障 |
[推算] 一个 1080p30 的 H.265 视频流,原始像素速率约 1920×1080×3×30 ≈ 186 MB/s;若每帧还要做检测 + 跟踪 + 编码回传,数据搬运量远超 NPU 算力本身。能不能"边采边推",本质上是在和第 01 讲讲的带宽墙正面对抗。
1.2 多媒体能力在栈中的位置
高通 SoC 的多媒体是一套独立硬件流水线:图像信号处理器(ISP,Spectra)、视频编解码器(VPU,硬件 H.264/H.265)、音频 DSP(cDSP/aDSP)都是独立于 CPU/GPU/NPU 的专用块。它们和 NPU 的关系是这样:
关键点:这几块可以并行流水,而不是让 CPU 包揽一切。正是这种"专用块各管一段"的设计,让 QCS6490 这类 SoC 能在低功耗下同时做采集、解码、推理、编码。
1.3 本讲环境前提
- 已按第 03 讲点亮犀牛派 A1,第 04 讲装好 QNN SDK。
- 已按第 07、08 讲在 HTP 上跑通至少一个量化后的视觉模型(如 YOLO 系列)。
- 多媒体 SDK / 相机与音频接口由板端系统(AidLux / 底层 Linux 多媒框架)提供;具体 API 名称与版本以阿加犀/高通官方资料为准,本讲给架构与原则,不绑定某个写死的接口版本。
1.4 传统"先解码后批量推理"为什么在边上不行
很多团队的第一版边缘视频 AI 是这样写的:用脚本把 RTSP 流整段录下来 → 离线逐帧推理 → 存结果。这在验证阶段没问题,但有三个致命问题:
- 时效性为零:等录完再分析,告警永远慢半拍,安防/避障场景不可用。
- 存储爆炸:原始视频远比分析结果大,长时间运行存储立刻见底。
- 算力浪费:录制的峰值带宽和推理的峰值算力错峰,设备要么空转要么拥堵,无法平稳流水。
“边采边推"的本质,是把第 07 讲的"单次推理"升级成"持续服务”,用流水并行抹平峰谷。这也是从 demo 走向产品必须跨过的一道坎。
二、硬件编解码:把 CPU 从编解码中解放出来
2.1 为什么需要硬件编解码
很多人第一次做"视频 AI"会这么写:用 OpenCV 的 VideoCapture 读 RTSP 流 → 软解码成 BGR → 送 NPU → 画框 → 再软编码存盘。这套流程在 PC 上 OK,在边缘板上会立刻崩:
- 软解码吃掉 CPU:H.265 4K 软解在 Cortex-A78 上能占满所有大核,NPU 反而饿着。
- 软编码更贵:把检测后的画面重新编码成 H.264 存盘/推流,软编码的算力开销常常比推理本身还大。
- 带宽墙:软解码出的原始帧要先搬进 CPU 内存、再搬去 NPU,多绕一圈(呼应第 01 讲带宽墙)。
[官方] 高通 QCS6490 集成硬件视频编解码器,支持 H.264/H.265 的硬件编解码,部分配置可到 4K 级别(具体编码档位、分辨率、帧率以官方规格书为准)。用硬件编解码,解码/编码这一步几乎不占 CPU/NPU,只走专用 VPU 块。
2.2 QCS6490 多媒体能力速览 [官方]
| 能力 | 说明 | 给 AI 开发者的意义 |
|---|---|---|
| Spectra ISP | 硬件图像信号处理 | 白平衡/降噪/缩放由硬件做,CPU 不介入 [官方] |
| 硬件视频编解码(VPU) | H.264/H.265 硬件编解码 | 解码输入流、编码输出流都不占 NPU [官方] |
| 多路 MIPI CSI | 多相机接入 | 第 08 讲已用,多路视觉基础 [官方] |
| 音频 DSP(aDSP) | 音频采集与预处理 | 端侧语音的采集与前端处理 [官方] |
注意:上面是能力类别,具体支持的解码档位、最大分辨率、路数请查官方规格书。本讲不替你写死数字——写死反而容易错。
2.3 硬件编解码与 NPU 的分工原则
一句话原则:凡是"格式转换"(解码、缩放、色彩空间、编码)都交给专用硬件块;凡是"语义理解"(检测、分类、识别)才交给 NPU。NPU 的算力应该花在"思考"上,而不是花在"搬数据、转格式"上。
这也是为什么第 08 讲强调"zero-copy / 硬件预处理"——让相机原始数据尽量在硬件块之间流转,少进 CPU 内存。
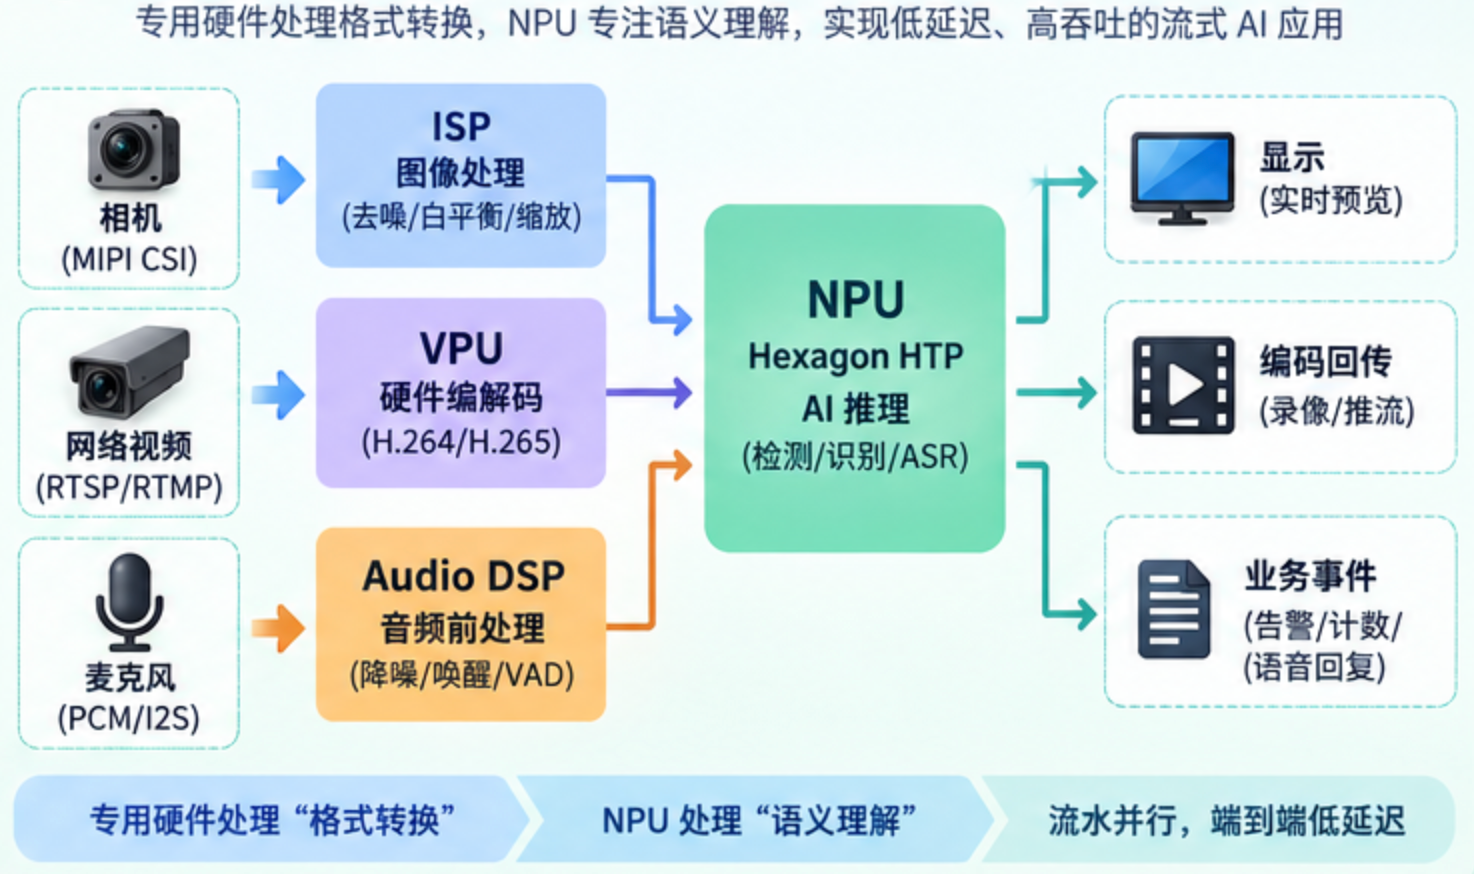
2.4 视频流 pipeline 全景
这条链里,B、C、F 都是专用硬件块;只有 D(推理)和 E(轻量后处理)需要通用算力。整条链可以流水并行:第 N 帧在 NPU 推理时,第 N+1 帧正在 VPU 解码——吞吐取决于最慢的一段。
2.5 软硬编解码的实测对比方法 [实测]
不要听信"硬件一定快"的笼统说法,要在你的板上实测对比。方法:
# [实测] 编解码路径耗时对比的测量思路(伪代码,具体 API 以板端多媒体框架为准)
import time

def bench_decode(path, use_hw=True):
    dec = open_decoder(path, hw=use_hw)   # hw=True 走 VPU, False 走 CPU 软解
    t0 = time.time(); n = 0
    while dec.has_frame():
        f = dec.get_frame(); n += 1
    dt = time.time() - t0
    print(f"{'HW' if use_hw else 'SW'} 解码 {n} 帧 耗时 {dt:.2f}s  平均 {dt/n*1000:.1f} ms/帧")
    # 同时用 top / 板端性能工具观察 CPU 占用率差异
[实测] 用上面思路分别测硬件与软件路径,记录每帧耗时与 CPU 占用。通常硬件路径在 4K 下 CPU 占用从"接近 100%×多核"降到"个位数百分比"——这就是把 NPU 解放出来的意义。具体数字以你的真机为准,本讲不替你出。
三、视频流"边解码边推理"架构
3.1 capture → decode → NPU → display 的落地形态
落到代码层面,推荐用"生产者-消费者"模型:一个线程/进程负责从硬件解码器拿帧,另一个负责把帧送进 NPU。伪代码骨架:
# [推算] 视频流边解码边推理的骨架(架构示意,具体 API 以板端多媒体框架为准)
import threading, queue

frame_q = queue.Queue(maxsize=4)   # 解码 → 推理 的缓冲,maxsize 控制积压

def decoder_loop(source):
    """硬件解码线程:从相机/RTSP 取流,硬件解码出帧,塞进队列(不占 NPU)"""
    cap = open_hw_decoder(source)          # 以板端多媒体 SDK 为准
    while True:
        frame = cap.get_frame()            # 硬件解码产出
        frame_q.put(frame)                 # 生产者

def infer_loop(model):
    """推理线程:从队列取帧,送 NPU,出结果"""
    while True:
        frame = frame_q.get()              # 消费者
        det = model.run(frame)             # HTP 推理(第07讲产物)
        emit_result(det)                   # 显示/回传/告警

t1 = threading.Thread(target=decoder_loop, args=(src,))
t2 = threading.Thread(target=infer_loop, args=(net,))
t1.start(); t2.start()
要点:
- 解码与推理分离,两者流水并行,互不阻塞。
- 队列
maxsize是关键保险:网络抖动或 NPU 偶发卡顿时,队列满了就丢最老的帧,而不是无限积压把内存吃爆。这是边缘流处理的经典手法。
3.2 零拷贝与硬件预处理
第 08 讲讲过带宽墙,这里再强调一次:帧从 VPU/ISP 到 NPU 之间的搬运,是隐形杀手。理想情况是帧buffer在同一块内存(或 DMA 可达区域)里被不同硬件块接力处理,避免 CPU memcpy 把数据在内存里搬来搬去。
[推算] 1080p 帧 YUV420 约 3.1 MB;若每帧在内存里被 memcpy 两次(解码→CPU→NPU),30fps 下就是 3.1MB × 2 × 30 ≈ 186 MB/s 的纯搬运带宽,几乎白耗。用硬件预处理 + zero-copy,这部分可以压到接近 0。
3.3 带宽估算:你的流到底多"重"
# [推算] 不同分辨率/帧率下的原始像素带宽(未压缩)
def raw_bandwidth(width, height, fps, channels=3, dtype_bytes=1):
    """估算未压缩视频流的字节速率 (MB/s)"""
    bps = width * height * channels * fps * dtype_bytes
    return bps / (1024 * 1024)

for (w, h, f) in [(640,360,30), (1280,720,30), (1920,1080,30), (3840,2160,30)]:
    print(f"{w}x{h}@{f}fps 原始带宽 ≈ {raw_bandwidth(w,h,f):.1f} MB/s")
# 输出(推算): 640x360 ≈ 19.8 | 720p ≈ 79.1 | 1080p ≈ 178.0 | 4K ≈ 712.0 MB/s
结论很明显:未压缩的原始带宽极其恐怖,这就是为什么必须用硬件编解码把流压成 H.265 再处理,也为什么"边解码边推理"比"先全解码再批量推理"省一个数量级的搬运。
3.4 端到端延迟拆解
以 1080p30 实时检测为例,端到端延迟大致由这几段组成(单位 ms,[推算] 量级):
| 环节 | 典型耗时 | 说明 |
|---|---|---|
| 采集 + ISP | 5–15 | 硬件块,确定性较好 |
| 硬件解码 | <5 | VPU,几乎不占 CPU |
| NPU 推理(YOLO 量化) | 15–40 | HTP,第 07 讲实测对象 |
| 后处理 NMS | 2–8 | CPU 轻量 |
| 显示/编码回传 | 5–15 | 硬件块 |
| 合计 | 约 30–80 | 需真机实测定数 |
[实测] 上面的具体数字请在第 07 讲装好 qnn-profile 后,用你的模型在犀牛派 A1 上实测 NPU 段;解码/显示段用板端多媒体框架的计时接口实测。本讲只给拆解框架,不替你出终值。
3.5 背压与缓冲的数学:maxsize 怎么定
队列 maxsize 不是拍脑袋。设解码帧率为 f_d、推理吞吐为 f_i(帧/秒),若 f_d > f_i,积压速率为 f_d - f_i。队列能撑的时间 T = maxsize / (f_d - f_i)。若你容忍最多 1 秒的"新鲜度损失",则 maxsize ≈ f_d - f_i(取整数)。例如 30fps 输入、25fps 推理,maxsize=5 大约容忍 1 秒积压。定得太小会频繁丢帧,太大则内存涨、延迟老。这是流式系统的通用调参公式。
四、端侧语音:ASR 与 TTS
4.1 端侧语音的 pipeline
视觉之外,语音是边缘 AI 另一大入口。端侧语音要解决的问题是:不把录音上传云端,在本地完成"听懂"和"说出去"。
4.2 ASR:把声音变成文字
端侧 ASR(自动语音识别)的关键工程点:
- 流式 vs 非流式:边缘场景(唤醒词、实时字幕)要求流式——边听边出字,延迟低;非流式要等一句话说完。流式对模型结构与缓存管理要求更高。
- 量化部署:ASR 模型(如基于 Conformer/Transformer 的架构)同样走第 05/06 讲的"转 QNN IR → INT8 量化"流程,在 HTP 上跑。语音模型对量化更敏感,校准集要覆盖口音、噪声、语速(呼应第 06 讲精度纪律)。
- 音频前端:降噪、回声消除、波束成形通常在音频 DSP(aDSP)上做,不占 NPU——又是"专用块各管一段"的思路。
4.3 TTS:把文字变回声音
端侧 TTS 用于让设备"开口说话"(机器人播报、车载语音助手反馈)。端侧 TTS 模型相对小,但实时性要求高(用户说完就要快回)。部署思路和 ASR 一致:量化 + HTP 推理。注意 TTS 的首包延迟(从拿到文本到开始出声)对体感影响很大。
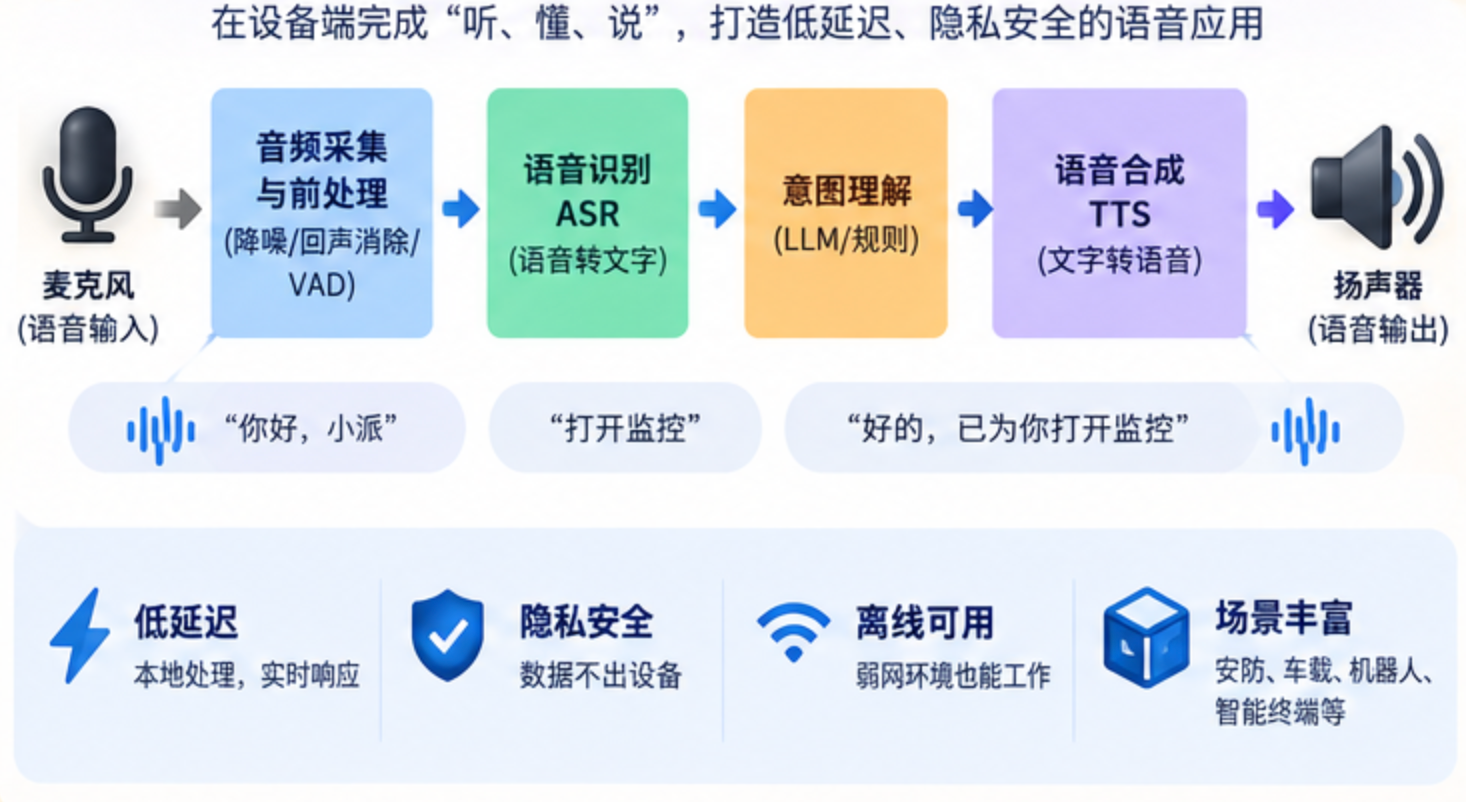
4.4 音频吞吐估算
# [推算] 音频采样与每帧模型输入的字节量级
def audio_frame_bytes(sample_rate=16000, frame_ms=20, channels=1, dtype_bytes=2):
    samples = int(sample_rate * frame_ms / 1000)
    return samples * channels * dtype_bytes

print("16kHz/20ms 单帧 ≈", audio_frame_bytes(), "bytes")        # 640 bytes
print("16kHz/1s  ≈", audio_frame_bytes(frame_ms=1000), "bytes") # 32000 bytes
# [推算] 流式 ASR 以 20ms 为窗,每秒 50 窗;模型每窗推理一次,NPU 负载远低于视觉
[推算] 语音的带宽比视频小几个数量级(16kHz 单声道每秒才 ~32 KB),所以语音端侧化的瓶颈通常不是带宽,而是模型延迟与功耗——这也解释了为什么端侧语音比端侧视频更早普及。
4.5 唤醒词与关键词 spotting
在完整 ASR 之前,很多设备先用一个极轻量的唤醒词检测(KWS,如"你好小X")常驻运行。KWS 模型极小(几十 KB 到几百 KB),可以跑在始终在线的低功耗子系统上,只在被唤醒后才拉起大模型做 ASR。这种"两级唤醒"架构是端侧语音功耗优化的核心套路,也是为什么你的设备能"一直听却不费电"。
4.6 端侧语音的隐私与离线价值
把语音留在本地,不只是省流量,更是隐私合规与离线可用的硬需求:工厂、车载、医疗等场景往往不允许音频出域;隧道、地下、偏远地区网络不稳,必须本地闭环。这恰是高通这类"端侧 NPU"平台相较于"上云"方案的根本优势——AI 在产生数据的那台设备上就地完成。
五、录像 + 推理标注一体化样例
很多安防/质检场景要"边录边打标":把原始视频存下来,同时叠加 AI 检测结果(框、标签、时间戳),便于回溯与复核。架构:
- 相机 → 硬件解码(VPU)
- NPU 推理出检测框
- 叠加层(overlay)把框画到帧上
- 硬件编码(VPU)成 H.264/H.265 落盘或推流
关键点:编码这一步也是硬件做,所以"存盘"几乎不额外占算力。代价是叠加层要在编码前合成——这部分若用 GPU/专用合成硬件做,就不占 CPU;若用 CPU 软叠加,则是一笔额外开销,规模大时要留意。
5.1 存储预算与"仅事件段留存"
录像最大的成本是存储。一个 1080p H.265 大概 2–4 Mbps,一天约 20–40 GB。工程上常用"仅事件段留存":平时不存,只有检测到目标(人/缺陷/异常)才触发落盘前后若干秒。这样既留了证据,又把存储压到原来的几十分之一。
| 策略 | 日均存储(推算) | 适用场景 |
|---|---|---|
| 全量 24h 录制 | 20–40 GB | 强合规、无遗漏要求 |
| 仅事件段(命中才存) | 0.5–3 GB | 绝大多数安防/质检 |
| 低码率+关键帧 | 5–10 GB | 带宽受限回传 |
5.2 与第 11 讲 thermal 的衔接
本讲讲的是"功能正确",但连续录制 + 连续推理一跑几小时,设备会发热。一旦 thermal 降频(第 11 讲重点),解码/推理会一起变慢,流式系统最先表现就是"掉帧 + 延迟升高"。所以本讲的 maxsize 缓冲、丢弃策略,本质上也是为 thermal 波动预留弹性——系统要在算力忽高忽低时仍能优雅降级,而不是崩。
六、坑点清单
6.1 用软件编解码跑实时流
症状:CPU 占满、帧率上不去、NPU 利用率反而低。对策:一律走硬件编解码,确认解码/编码走的是 VPU 而非 CPU。
6.2 队列无限积压
症状:运行几分钟后内存爆炸、进程被杀。对策:解码→推理队列设 maxsize,满了丢最老帧(实时场景丢帧优于崩)。
6.3 帧拷贝过多触发带宽墙
症状:明明 NPU 算力够,端到端却卡。对策:用硬件预处理 + zero-copy,减少 CPU 侧 memcpy。
6.4 音频前端与 ASR 采样率不匹配
症状:ASR 乱识别或报格式错。对策:前后端统一采样率(常见 16kHz),确认 aDSP 输出格式与模型输入一致。
6.5 流式 ASR 状态管理错乱
症状:长句识别断片、重复。对策:维护好流式窗口与历史上下文缓存,按模型要求的 chunk 大小喂数据。
6.6 把"云端验证"当"量产验证"
症状:Device Cloud 上跑通就以为板上稳。对策:真机离线长时间压测,尤其第 11 讲要讲的 thermal 降频。
6.7 只盯 NPU 利用率
症状:NPU 利用率很高却还是卡。对策:看整条链(解码/ISP/推理/编码/显示)的最慢段,瓶颈常不在 NPU。
6.8 录像落盘用软编码
症状:录制一开始 CPU 飙升、帧率掉。对策:落盘编码务必走 VPU 硬件编码,不要 cv2.VideoWriter 软编码。
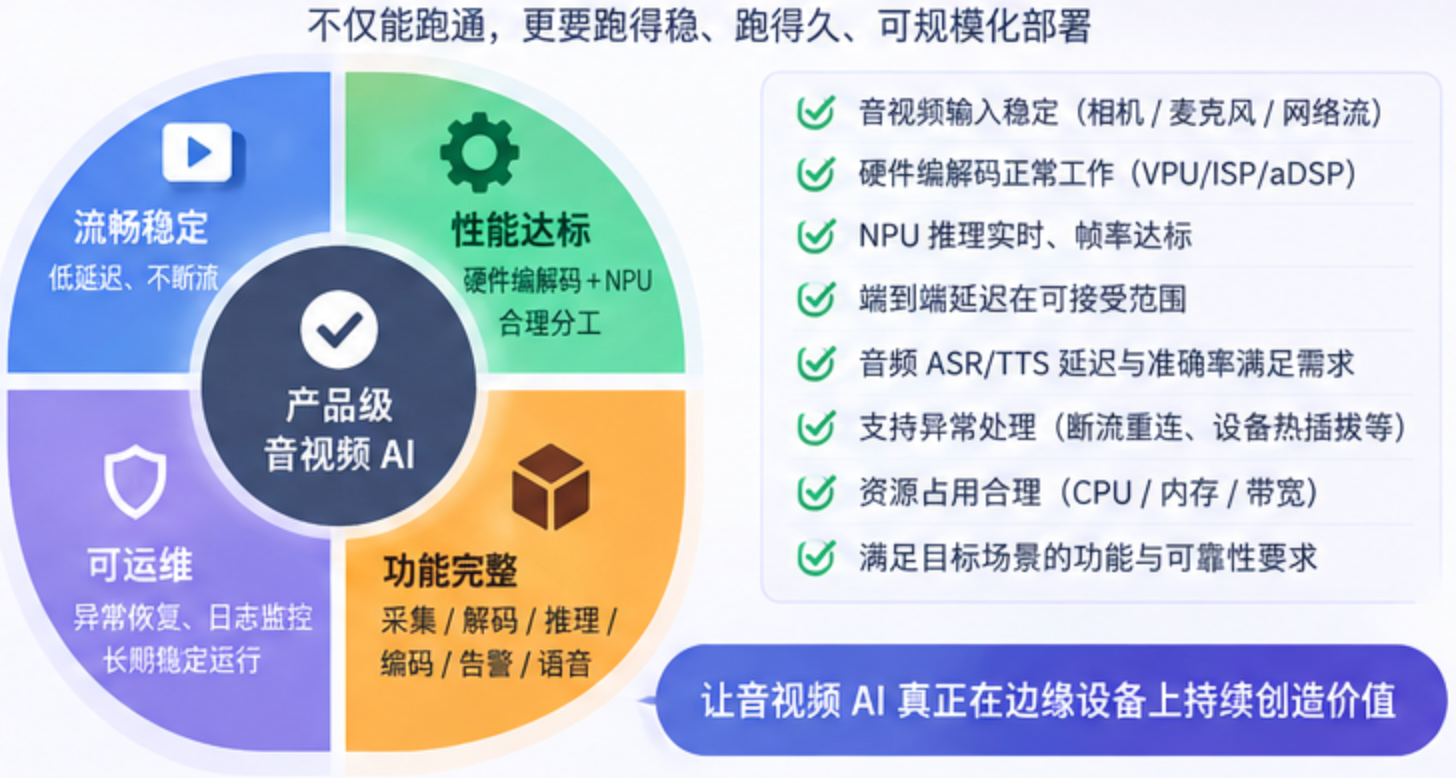
到这里,可以把前面的工程问题收敛成四个产品级要求:
流水稳定、性能达标、可运维、功能完整。
七、FAQ
Q1:硬件编解码和软编解码,NPU 推理结果有差别吗?
没有。编解码只改变"帧的容器和格式",不改变像素语义;只要解码后喂给 NPU 的帧一致,推理结果一致。差别只在算力占用和延迟。
Q2:犀牛派 A1 支持哪些编码格式?
以阿加犀/高通官方资料为准(QCS6490 集成硬件 H.264/H.265 编解码,[官方])。具体档位、分辨率、路数查规格书,本讲不写死。
Q3:能不能 NPU 推理的同时硬件编码?
能,而且应该这么做。VPU 和 HTP 是独立硬件块,可并行。正是这种并行让"边推边录"可行。
Q4:多路相机流怎么分配算力?
参考第 08 讲多路相机与第 11 讲并发策略。原则:每路独立解码线程 + 共享推理线程池,按帧优先级调度;多路总带宽要先过第 01 讲带宽墙这关。
Q5:端侧 ASR 一定要量化吗?
基本是。端侧算力/内存有限,FP16/INT8 量化是常态。但语音对量化比视觉更敏感,校准集要更讲究(见第 06 讲)。
Q6:TTS 能不能不跑 NPU、用 CPU?
小模型可以,但实时 TTS 为保证低首包延迟和续航,放 NPU 更稳。是否上 NPU 看你对延迟和功耗的要求。
Q7:音频和视频能共用一条 pipeline 吗?
架构上可以(AV 同步),工程上建议分开两条线程/队列,最后在合成/业务层对齐时间戳,避免互相阻塞。
Q8:录制文件太大怎么办?
用硬件编码压成 H.265(比 H.264 省约一半码率),配合动态码率与"仅事件段留存"策略(只在检测到目标时落盘)。
Q9:本讲和第 08 讲的关系?
第 08 讲解决"单路相机实时检测",本讲把它扩展成"连续音视频流 + 硬件编解码 + 端侧语音"的完整媒体栈,是产品化的下一级。
Q10:唤醒词一定要端侧吗?
强烈建议。KWS 要始终在线,上云既费流量又慢又有隐私风险;本地小模型常驻低功耗子系统才是正解(见 4.5)。
Q11:流式 ASR 对延迟要求多严?
语音交互的端到端(说话→出字)通常要求 <500ms 体感才自然;其中 ASR 段要留足余量给网络/业务逻辑。具体在你的模型+板上实测。
Q12:overlay 叠加用什么做最省?
优先用 GPU/专用合成硬件或多媒体框架自带的合成能力;避免 CPU 逐像素画框再拷贝,那是又一笔带宽墙税。
八、速查卡与术语表
8.1 媒体栈任务 → 硬件块 速查表
| 你要做的事 | 该交给的硬件块 | 千万别 |
|---|---|---|
| 解码相机/网络视频流 | VPU(硬件解码) | 用 CPU 软解 |
| 白平衡/降噪/缩放 | Spectra ISP | 用 CPU 逐像素处理 |
| 跑检测/分类/识别 | Hexagon HTP(NPU) | 把格式转换也塞给 NPU |
| 编码回传/落盘 | VPU(硬件编码) | 用 cv2 软编码 |
| 采集/降噪/波束成形 | aDSP | 在 CPU 上做实时音频前端 |
这张表就是把第 01 讲"异构计算"落到多媒体场景的速查:每个专用块只干自己最擅长的事,NPU 只负责"语义理解"。凡是看到代码里出现 cv2.VideoCapture 软解码或 cv2.VideoWriter 软编码跑在边缘板上,第一反应都应该是"这条路不对,换成硬件块"。
8.2 端到端延迟 checklist
部署一个视频 AI 前,按这张单逐项确认(单位 ms,[实测] 用你的真机填):
- 采集+ISP 实测:___ ms
- 硬件解码 实测:___ ms
- NPU 推理 实测(qnn-profile):___ ms
- 后处理 NMS:___ ms
- 显示/编码回传:___ ms
- 端到端合计:___ ms(目标:实时场景 <100ms 体感较好)
- 30 分钟压测后是否 thermal 降频(见第 11 讲)
8.3 术语表
- VPU(Video Processing Unit):专用视频编解码硬件块,H.264/H.265 硬件编解码都走它。
- ISP(Image Signal Processor):图像信号处理器,Spectra 即高通的 ISP 品牌,负责把 sensor 原始数据转成可用图像。
- Zero-copy:数据在不同硬件块/进程间传递时不复制,只传引用或共享内存,避免带宽墙。
- 流式 ASR:边接收音频边输出文字的语音识别,区别于"等整句说完再识别"。
- KWS(Keyword Spotting):关键词/唤醒词检测,极轻量常驻模型,用于触发大模型。
- 背压(Backpressure):下游处理慢导致上游堵塞的现象;用队列 + 丢旧帧缓解。
- H.265 / HEVC:高效视频编码标准,比 H.264 省约一半码率,边缘设备首选。
8.4 本讲自查清单
- 解码/编码是否确认走硬件(VPU)而非 CPU?
- 解码→推理队列是否设了 maxsize(防内存爆炸)?
- 帧传递是否用了零拷贝/共享内存?
- 端到端延迟是否在业务可接受范围内(真机实测,非推算)?
- 音频前端采样率与 ASR 模型输入是否一致?
- 录像是否"仅事件段留存"以控存储?
- 是否做过连续数小时压测,观察 thermal 波动下的降级表现?
8.5 三种典型场景的组合方案
同一套媒体栈底层能力,按场景调参数就能长出三类应用:
- 安防监控(监测类):相机 → 硬件解码 → NPU 检测 → 硬件编码落盘(仅事件段留存)。强调"低功耗常驻 + 事件触发存储",平时几乎不占算力,命中目标才动编码与存储。
- 工业质检(单帧判定类):相机 → ISP → NPU 分类/分割 → 业务计数/剔除信号。强调"高确定性、低漏检",校准集要覆盖缺陷的全部形态与光照变化(呼应第 06 讲)。
- 车载/机器人(实时避障类):相机 → 硬件解码 → NPU 检测 → 决策 → 控制,端到端预算 <100ms。强调"延迟优先、丢帧优于崩",队列与跳过策略最激进。
这三种组合,核心差异只在"哪个环节最敏感、余量留给谁"。本讲讲的媒体栈与队列策略,在三者里都是同一套底层能力,只是参数不同——这正是工程化的复利:一次把流水做对,三类场景复用。
8.6 媒体栈与 NPU 协同的三个误区
- 误区一:“NPU 够强就不需要硬件编解码”。错。NPU 强只解决"算得快",解决不了"数据进得来快不快"。没有硬件编解码,数据在门口就堵死了,NPU 再强也饿着——这正是第 01 讲带宽墙的现实版。
- 误区二:“软解码先凑合用,后面再优化”。边缘板 CPU 本就紧张,软解码是雪上加霜,往往 demo 第一天就跑不动。一开始就走硬件路径,反而省时间。
- 误区三:“录制直接软编码存盘”。落盘编码是硬需求,必须走 VPU;否则录制一开,CPU 立刻被编码吃满,顺带把推理也拖垮。
记住一句话:专用块把"脏活累活"(采集、解码、缩放、编码)揽走,NPU 才能专心"动脑"(语义理解)。任何让 CPU 包揽这些脏活的写法,都是和边缘设备的物理极限对着干。
8.7 端侧多模态:当视觉遇上语音
真实产品很少"只做视觉"或"只做语音"。一台服务机器人既要"看"(相机 + NPU 检测),也要"听"(麦克风 + ASR),有时还要"说"(TTS)。它们如何在同一颗 SoC 上共存,正是本讲媒体栈 + 第 10 讲节点化思想的合流:
- 共享 NPU:视觉模型与 ASR 模型都跑 HTP,按优先级分时调度。视觉(安全相关,如避障)通常优先级高于语音(可降级),ASR 用尽力而为策略。
- 共享媒体栈:相机流水线与音频前端各自走专用硬件块(VPU / aDSP),互不抢 CPU——这正是异构设计的红利。
- 时间对齐:视觉事件(“检测到人”)与语音指令(“跟我去厨房”)靠
header.stamp对齐,下游才能理解"你说的是刚看到的那个人"。 - 低功耗协同待机:用 KWS(第 09 讲 4.5)常驻唤醒语音、用运动触发相机,平时整系统近零功耗,事件来了才拉起大模型。
这就是"边缘多模态"的雏形——也是第 01 讲背景里讲的行业趋势在板端的落地。它不神秘:不过是把多个单模态流水,用专用块 + 节点化拼成一张协同网。
8.8 把媒体栈送进第 11 讲的性能账
第 11 讲要算的热与功耗账,本讲其实已经埋了伏笔:连续解码 + 连续推理意味着设备持续满载,thermal 降频会同时拖慢解码与推理,流式系统的跳过率随之上升。所以本讲的 maxsize 缓冲与"丢旧帧"策略,不只是防内存爆——更是为 thermal 波动预留弹性。设计阶段就把峰值功耗留 30% 余量,量产时才不会"demo 跑半天就变卡"。这也是为什么前面反复强调"先正确、再谈极致优化":一个在满载下会雪崩的系统,优化得再花哨也没用。
九、结论与下讲预告
本讲你实际搭起来的东西:从"一张图跑一次检测"走到了"一条连续音视频流上持续推理",并顺手把视觉与语音捏成了多模态协同的雏形。你掌握了硬件编解码为什么是隐形前提、生产者-消费者模型如何解耦、带宽与音频吞吐怎么估算、三种典型场景的组合参数,以及一张可贴显示器上的端到端延迟 checklist 与术语表。这些不是纸面知识——它们是任何一个"能上产线"的边缘视频/语音产品的共同底座。当你能把"边采边推"和"多模态协同"这两件事做对,剩下的就只是按场景调参数——这才是边缘 AI 工程化的复利:底层流水一次做对,上层的安防、质检、车载、机器人场景全部复用同一套能力,只是参数不同。本讲是第 08 讲"单路实时检测"与第 10 讲"机器人节点化"之间的桥:媒体栈解决"看得清、听得清且持续",节点化解决"怎么把感知喂给系统全身"。
核心一句话:边缘 AI 不是"跑一次推理",而是"在一条连续的多媒体流上持续推理";把编解码交给专用硬件块、把语义理解留给 NPU,并用生产者-消费者模型解耦,才能既稳又省。
下一讲(第 10 讲) 我们把视觉/语音感知能力进一步"系统化成机器人节点":用 ROS2 + Intelligent Robotics SDK,把 NPU 推理封装成一个标准感知节点,接入导航、控制等下游。媒体流解决"看得清、听得清",ROS2 解决"怎么把感知喂给机器人全身"。
本讲所有代码、带宽/音频吞吐估算与 pipeline 设计均为架构示意与推算;具体的编解码档位、API 名称、端到端延迟数字,务必在你的犀牛派 A1 真机上用板端多媒体框架与
qnn-profile实测确认,不要直接拿本讲的推算值当终值。
参考链接

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献9条内容

所有评论(0)