27岁清华最年轻助理教授的“非典型选择”:放弃DeepMind、回国当老师、3个月融4亿
27岁清华最年轻助理教授的“非典型选择”:放弃DeepMind、回国当老师、3个月融4亿
|
🎓 27岁的陈勇超,成为了清华大学人工智能学院有史以来最年轻的助理教授。 |
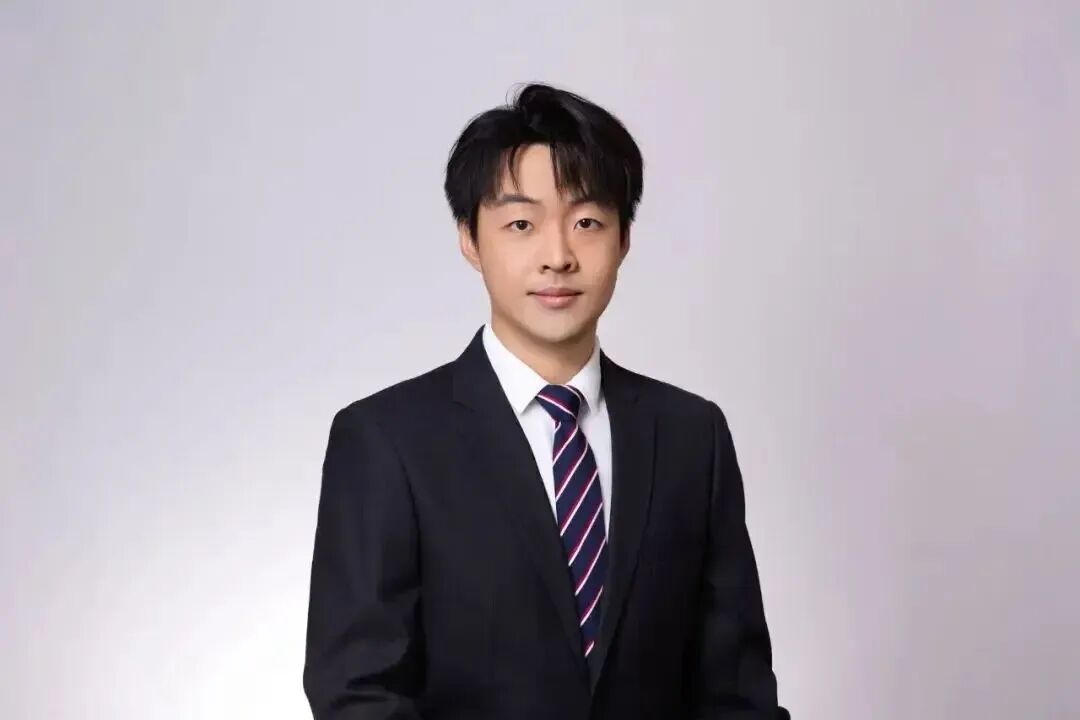
2026年1月,哈佛-MIT联合培养博士陈勇超即将毕业。摆在他面前的选择堪称“顶配”:一边是DeepMind的工作邀约,以及两家专注AI自动科研的海外初创公司(Periodic Labs、Unreasonable Lab)抛来的联创橄榄枝;另一边,是他“等了两年的创业Timing”。
大多数人会选前者。
他选了后者。回国,创办超衍智能(Apex Intelligence) ,专注自主进化基模研发,同时入职清华大学人工智能学院。陈勇超本硕就读于中国科学技术大学,拿下郭沫若奖学金,博士为哈佛-MIT联合培养,期间先后在Google Research、Google DeepMind、微软研究院、MIT-IBM Watson AI Lab从事研究工作。
“微软让我想创业,谷歌让我知道创业要做什么。 ”这句话,是他做出选择的全部逻辑。
陈勇超的“创业Timing”不是冲动。
2025年夏天,他仍然认为“模型能力不足以支撑这一愿景”——AI自主做研究,想法很美,但模型还不够强。
真正的转折发生在2025年底至2026年初。当模型在编程和推理任务上的能力连续跨过几个关键门槛后,他判断:“Coding平权之后,下一波会是Research的平权。”
“平权”这个词,是理解陈勇超全部选择的钥匙。
正如过去两年AI编程工具让“写代码”从专业能力变成了通用能力,陈勇超赌的是:AI做研究,也会经历同样的平权过程——从只有顶尖实验室才能做的事,变成任何人都能调用的能力。
他手上的第一个有力证据,出现在2026年5月。
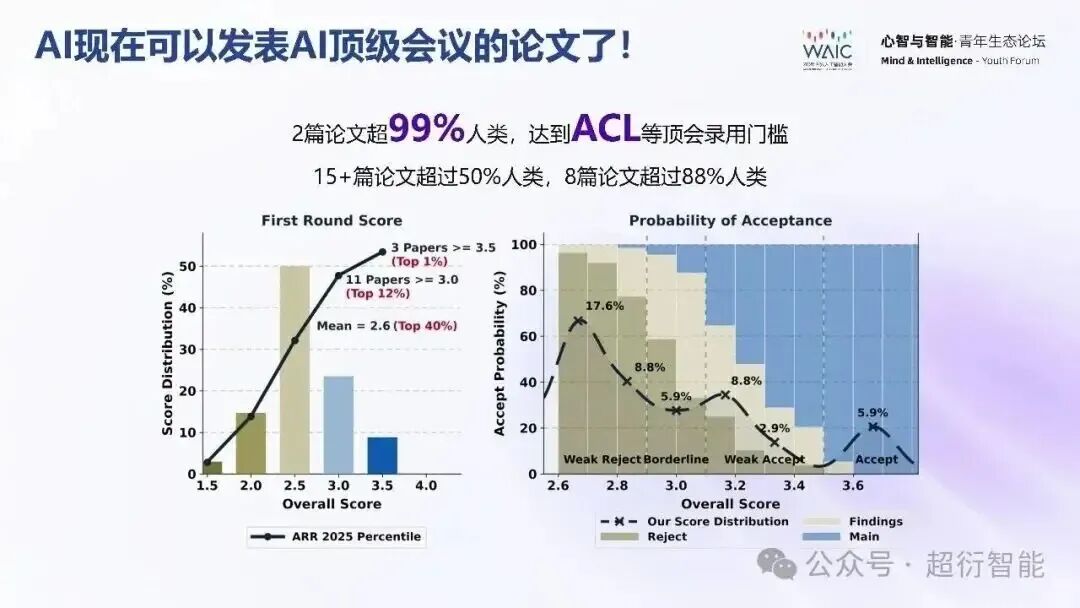
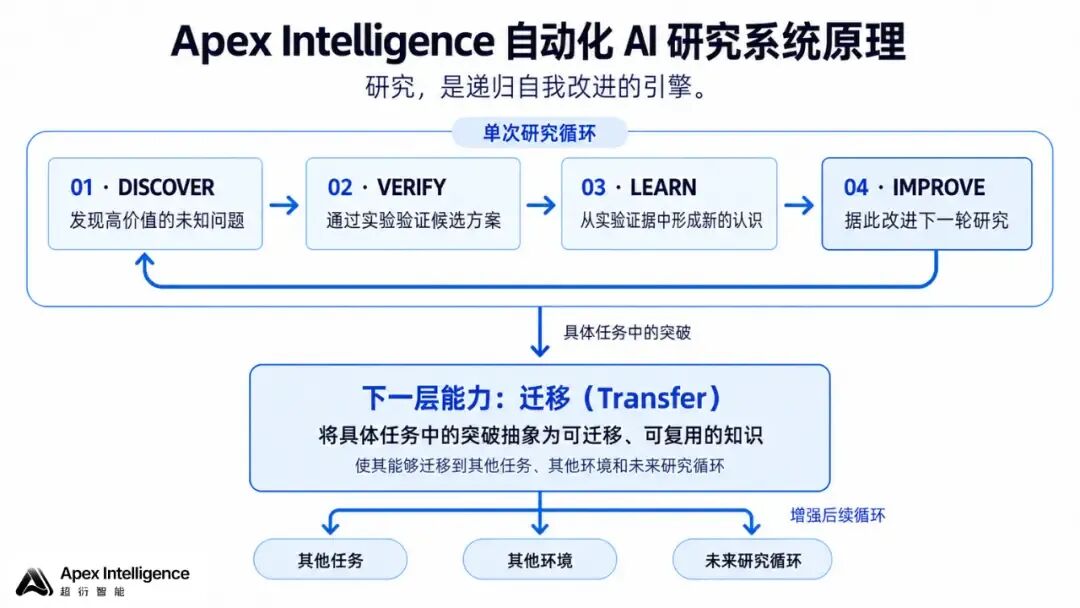
今年5月,陈勇超团队让公司的自进化AI系统Apex Research自主产出了34篇机器学习论文,提交到ACL Rolling Review(ACL系列会议的统一审稿平台)接受双盲评审。
结果:11篇拿到3分以上,其中2篇达到3.67分,超过约99%的人类投稿。34篇论文的平均评审分为2.60,与团队统计的人类投稿平均分2.63接近。
这意味着什么? 一个不低于博士水准的初审分,而且是AI在没有人类提供完整方法和步骤的情况下自主完成的。
更关键的是过程。 从一个研究方向出发,Apex Research系统可以自主完成文献调研、提出Idea、设计方法、写代码、运行实验、分析结果,再整理成论文——全流程由AI独立完成,过程中只有少量非专业人工干预。
“很多想法都挺让人眼前一亮的,有些论文几乎达到了博士生水平,这在我们的意料之外,但也在情理之中,因为这个时刻迟早都会到来。 ”陈勇超说。
数学方向上,团队已完整证明优超猜想,并在优化理论、几何拓扑等方向取得多项突破。
与业内其他路径不同,超衍智能并非在现成的通用大模型上叠加一层智能体,而是从基础模型层面构建“发现原生”能力。
公司技术路线锚定四个特征:基础模型——将自我进化能力做进模型底层,而非依赖外部脚手架拼接;大模型——以大规模参数与算力为底座;通用模型——面向全域学科而非单一垂类;非实时进化——模型的自我提升发生在训练迭代而非实时推理中,经充分评估后再交付,以保证可控。
在超衍内部,这套逻辑被概括为 “Research is the engine of RSI” ——研究,才是递归自我改进的核心动力。每一次研究任务生成的轨迹,都会变成训练数据,用于改进模型,并进一步攻克更难的问题。
最终目标,是用一套递归智能系统连接数字世界与物理世界,将统一的能力拓展至AI、数学、物理、芯片设计、机器人、工业制造、化学、生物等各个领域。
27岁成为清华AI院最年轻的助理教授,与3个月完成近4亿融资,是同一枚硬币的两面。
“最年轻助理教授”提供了学术身份和人才引力。 超衍智能核心团队来自清华、北大、哈佛、MIT等顶尖高校,以及Google、Microsoft、Amazon等企业,部分核心成员此前有字节、Kimi、智谱等头部大模型团队的研发经历。公司成立不到三个月,核心团队已接近30人。
“3个月4亿”提供了算力和团队扩张的弹药。 天使轮由IDG资本、星连资本、晶泰科技联合领投,德迅资本、无限基金、初心资本、云岫资本跟投;天使+轮由中关村科学城基金、深创投、上海未来产业基金三地国资联合领投。融资将重点用于基础模型与算力基础设施构建、递归自进化技术研发投入,以及核心团队扩张。
一个人同时拥有“学术身份”和“资本信任”,才能在RSI这个需要长期投入的赛道上跑起来。
陈勇超的选择,放在一个更大的背景下看,意义更加清晰。
近一年来,用AI自我改进AI几乎成了海内外头部实验室的共识。 OpenAI创始成员Andrej Karpathy、前Meta FAIR研究总监田渊栋、前DeepMind首席科学家Jeff Dean都相继加入RSI创业热潮。
田渊栋所在的Recursive Superintelligence,在还没有交出成果的时间点上,就已官宣完成6.5亿美元融资,估值推高至46.5亿美元。
OpenAI在9月披露,其内部已经达到Automated Research Intern阶段,AI可以在研究人员指导下完成原本需要数天的明确研究任务。Anthropic也在让Claude承担越来越多代码、实验和开放式研究工作。
RSI正在从“概念”变成“赛道”。 而陈勇超的判断是:这个赛道最稀缺的不是“更聪明的模型”,而是“能让模型自己变聪明的系统”。
从DeepMind邀约到回国创业,从哈佛-MIT到清华助理教授——陈勇超的“非典型选择”揭示了一个朴素的判断:在AI人才流动的叙事里,最稀缺的不是“回不回国”,而是“在什么时机、带着什么判断回来”。
他带回的不是一篇论文或一个技术方案,是一个被等了两年的创业Timing。
而“带着判断力回来”,才是这个选择真正的含金量。
参考资料:
https://eu.36kr.com/zh/p/3985787773402120#1
https://www.sohu.com/a/1077615375_122014422
https://www.cnr.cn/mspd/msgc/qwfb/20260916/t20260916_527815351.shtml
https://stcn.com/article/detail/4187353.html

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献146条内容

所有评论(0)