端到端具身交互智能落地:一个能被打断、能比划手势的咖啡师智能体是怎么搭起来的
端到端具身交互智能落地:一个能被打断、能比划手势的咖啡师智能体是怎么搭起来的
B 站手冲视频你收藏了三十个,V60 的注水画圈看了上百遍,豆袋上的风味描述也背得下来——可周六早上真站在自己家吧台前面,那杯耶加雪菲还是又苦又尖,粉层塌在一边,你甚至说不清到底是水温的错、研磨的错,还是刚才那一下水流太大了。
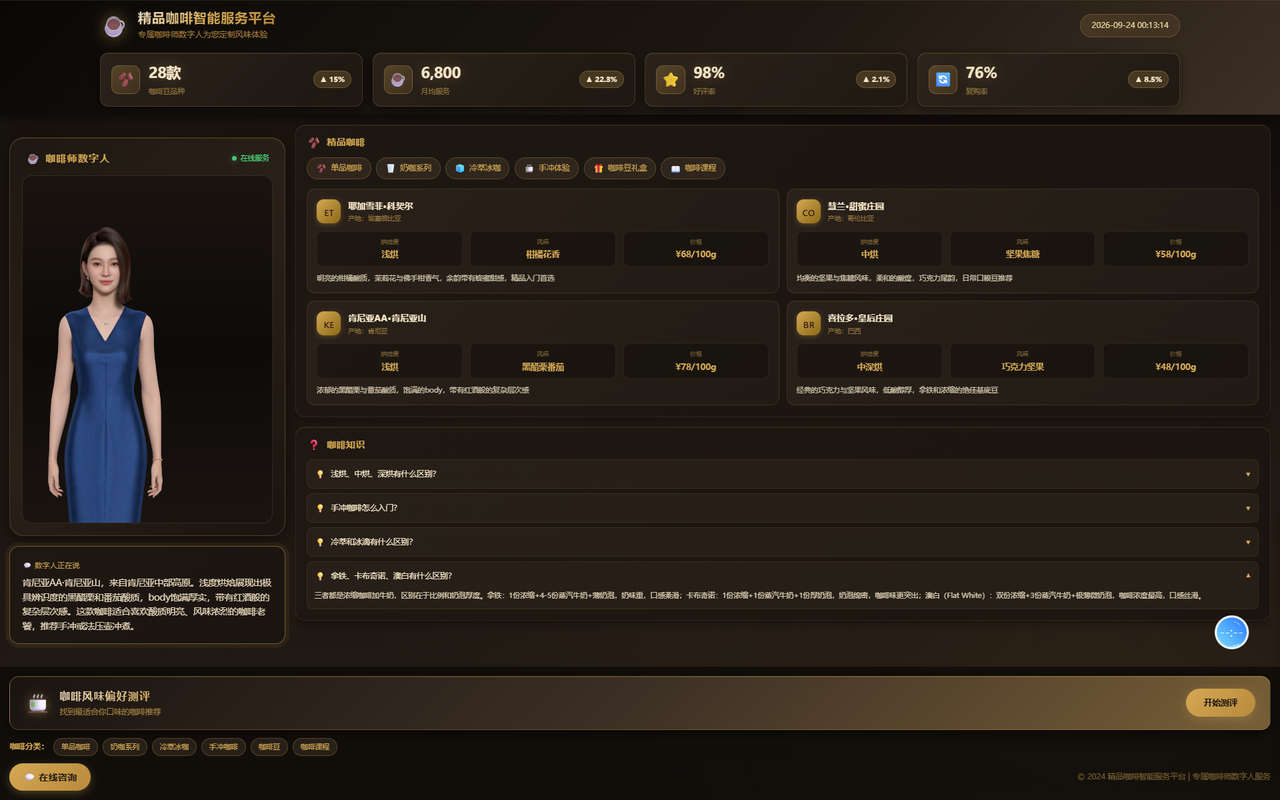
线下咖啡课能解决这个问题,一节 300~600 元,老师确实会按住你的手腕说“这里慢一点”。但你得约时间、得跑一趟,回家那台机器还是只有你一个人。至于对着 APP 打卡,它只会告诉你“本次萃取时长 2 分 48 秒”,不会回答你真正想问的那句:“那我这次到底该改水流还是改研磨度?”
学习者缺的从来不是一份更长的配方表,而是一个随时站在吧台对面、听得懂你在说什么、能一边讲一边做手势给你看、还能被你随时打断的咖啡搭子。
三种学咖啡的路子,快来看看你在那一步1
| 方式 | 你的真实体验 | 卡在哪里 | 代价 |
|---|---|---|---|
| 线下咖啡课 | 有人当场纠正手法 | 一周一次,回家就断 | 300~600 元/节 |
| 视频 + APP 打卡 | 信息量很大 | 只能看,问不出去 | 时间全花在反复搜 |
| 纯文本 AI 问答 | 想问就问 | 给的是段落,不是示范 | 看懂了但手不会 |
三条路各自解决了其中一角,学咖啡的人被卡在同一个死循环里:冲坏了不知道为什么,知道了也做不出来,做不出来就再也不冲了。
什么叫端到端具身交互智能
想象一个再普通不过的下午:你打开 APP,一位“咖啡师智能体”站在吧台那一侧。你说“我手上有支浅焙肯尼亚,昨天冲出来尖酸”,她点点头,先反问你的研磨度和水温;你报出数字,她立刻给出一个调整方向,同时抬手比了一个小圈,演示绕注时那段最关键的稳定水流;你注到一半突然想到“等等,闷蒸时冒的那个泡到底是什么”,她马上停下当前这段话,转过来专门回答这个新问题,答完再自然接回刚才的节奏。
这就是端到端具身交互智能——它不是 ASR + LLM + TTS 三段拼起来的“你说我听、你问我答”,而是围绕一次完整的人机协作把整个系统设计成一个持续交互循环(Continuous Interaction Loop):
持续感知 → 持续理解 → 持续决策 → 持续表达 → 持续反馈
翻译到吧台上就是:她不是等你按下“提问”才工作,而是整段时间都在听你、判断现场正在发生什么。你插话,她立刻让位;她正在说话时你先开口,她分得清那是你的声音、还是她自己喇叭里的声音。
前端接住这一切,只需要一个 XingyunAvatarAgent 实例。下面是本项目里初始化吧台智能体的真实代码:
// src/services/coffeeBuddy.ts
this.agent = new window.XingyunAvatarAgent({
  container: this.stageEl,              // 挂载容器,必须有明确宽高
  appId,
  appSecret,
  gatewayServer: SDK_CONFIG.GATEWAY_URL, // 星云端到端网关(ttsa_v2)
  enableClientInterrupt: true,           // 打断默认开启,手上湿漉漉不用去点按钮
  agentCallbacks: {
    onAgentStateChange(state) { / idle / listening / thinking / speaking / },
    onASRResult(result)       { / 语音识别:实时增量 + isFinal 最终结果 / },
    onLLMResponse(event)      { / 文本先于语音到达,可立刻上屏对照 / },
    onConversationChange(event) { / 对话轮次与状态变化 / },
    onError(error)            { / 错误回调,别静默吞掉 / },
  },
})
// 一次 init 建立渲染、网关、ASR 三条链路
await this.agent.init({ onDownloadProgress(p) { / 资源加载进度 / } })
三件事被这段代码一并做完了:传容器与凭证(container 是渲染舞台,appId / appSecret 来自星云后台,gatewayServer 指向端到端网关)、注册回调(让前端实时看见智能体“感知 → 理解 → 表达”的全过程)、init() 建链(完成后即可 ask(text) / startASR() / stopASR())。
有个坑必须提醒:init() 失败时不会主动 reject,一定要自己包一层超时保护(本项目用 Promise.race 卡 60 秒),否则用户会永远停在“正在连接吧台”。
一次真实的吧台对话,重点看她怎么被打断
学员:“我想把那支肯尼亚冲干净一点,昨天太酸了。”
咖啡师智能体:(微微侧身,抬手做注水手势)“尖酸一般是萃取不足,先别急着换豆子。你现在是几档研磨、水温多少?”
学员:“研磨度 4.5,水温 92 度,注水三分段。”
咖啡师智能体:“92 度对浅焙不算高,问题更可能在水流。来,我把第二段那个‘小圈稳定注水’的手势演示给你看——注意手腕是匀速转,不要往下压……”
学员:(打断)“等一下,我上次看有人说浅焙要降低水温,到底听谁的?”
咖啡师智能体:(立刻停住手势,转向新问题)“两个说法都不错,只是解决的痛点不同。降水温是为了减少苦涩、让酸更柔和;你现在是酸得发尖,说明的不是水太烫,而是可溶物没抽够,这时候该动的是水流和研磨,而不是温度。”
听得懂上下文、演得出手法、随时被你插话——这才是“陪练”两个字真正的分量。
支撑这一次陪练的五项能力
多模态感知。 麦克风持续接收你的语音,算法降噪、回声消除、智能打断(Barge-in)一体运行:你开口她立刻停,你停顿她能分辨是卡壳还是说完了。手边都是水、壶、称,你根本腾不出手去点“停止”——这套感知让智能体自己让位。前端启动语音只需要一句:
// src/stores/coffee.ts
async startVoiceInput() {
  appState.ui.text = ''               // 先清残留,避免混进本轮识别
  await avatarService.startASR()      // 直接用 SDK 内置 ASR
  appState.asr.isListening = true
}

async stopVoiceInput() {
  await avatarService.stopASR()
  // isListening 交给 onASRResult 的 isFinal 收口,这里不置 false
}
注意第二个方法里那行注释:ASR 的最终结果可能在 stopASR() 之后才回填,一停就改状态会丢掉最后一句。
多模态表达。 她输出的不是一段文字,而是语音、口型、表情、眼神、手势与身体动作的同一次实时生成。讲到“水流要细要稳”时她抬手比划,你冲成功时她点头笑一下。语言、语气和动作本就是一回事,拆开播放就露馅了。
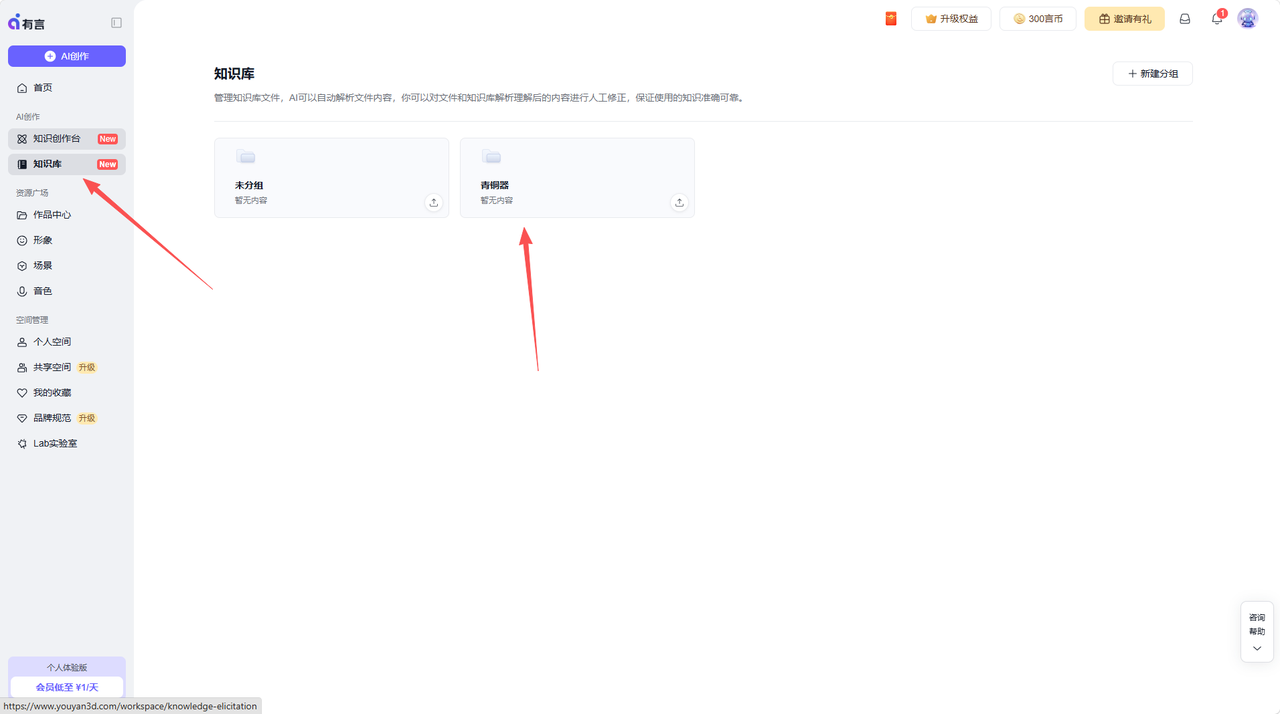
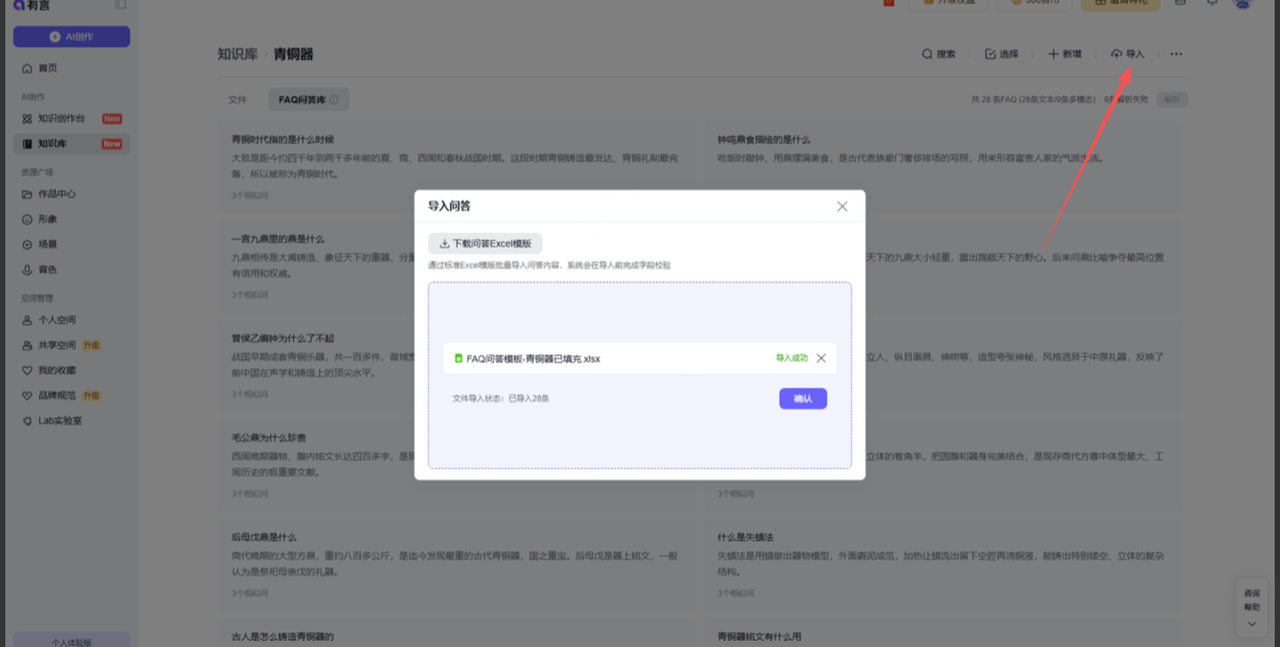
智脑。用户可以根据自己的需求来配置自己用的习惯的大模型等等,如果没有自己常用的大模型,可用我们的自研——智脑,"智脑"就是将我们的一些知识库,资料文档上传,不同媒介资料能够快速转化成AI所能理解的,可以检索的知识库,其实很重要的一点就是全模态数据分析,我们可以一股脑地的把我们的PDF、Word、PPT、图片、音频、表格等不同类型资料导入进去,智脑能同时保留资料中的层级关系、图文关系、表格关系、说话人信息和上下文。
智脑的调用需要进入魔珐有言纪念性配置,魔珐有言官网:https://www.youyan3d.com/
AI 端渲。 渲染跑在你的设备上——手机、平板、店里那台大屏,不依赖云端 GPU 持续推流,端到端延迟低于 500ms,店里网络挤也不至于卡成幻灯片。往工程层面看,它同时压低了云 GPU 成本与带宽占用,让大规模并发成为可能:一家咖啡馆的十个工位、一条展线的二十块屏,都能各自流畅对话。
数字与物理性动。同一个智能体,可以拥有不同的身体;智能体持续存在,身体不断升级。你家厨房的平板、吧台旁边的竖屏、门店自助终端,乃至未来的 AI 屏幕、移动 AI 屏幕与人形机器人形态。身份、知识、记忆、任务和业务能力在切换不同身体时可以持续复用 —— 早上教过你肯尼亚的那一位,下午在门店大屏上认得你的偏好。她不只是 “生成一段答案”,而是把答案说出来、演出来、表达出来。
一次文本提问,前端只要一行:
async sendMessage() {
  const text = appState.ui.text?.trim()
  if (!text || !appState.avatar.instance) return

  await avatarService.ask(text)   // 云端:Brain 推理 → TTS → 具身表达
  appState.ui.text = ''
}
ask() 背后是整条链路联动:模型推出回复,TTS 转成语音,同步驱动口型、表情与手势。前端不必分别去调 LLM、TTS 和动作接口,一次调用就是一次完整的具身表达。
四个能立刻落地的场景
家用吧台陪练:从磨豆刻度到注水节奏,逐壶追问、逐壶复盘,不用再靠猜
门店新品培训:一款新豆上架,店员跟着同一位咖啡师智能体练话术、练手法,当天可上岗
设备与器具导购:看着实物讲差异,随手演示“这款壶的壶嘴为什么更适合绕注”
咖啡师考证带练:感官杯测术语、萃取参数设计,按考试口径一问一答反复打磨
写在最后
咖啡师智能体的意义,不是把人类咖啡师换掉,而是让“有一个人愿意坐在你对面,陪你把这三杯冲明白”这件事,从预约表和课时费里挪出来,变成随时可得的日常。她 24 小时在线、不会因为你第五次问同一个问题而失去耐心、并且认得你手上那一支豆子的脾气。
大模型让 AI 听懂了语言,端到端具身交互智能让 AI 站到吧台对面,成为你手边那位能听、能说、能演、能被打断的具身交互智能体。当教学不再只是一屏文字,学咖啡这件事,也就从“看会了”真正变成“冲出来了”。
魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。
想给自己那位冲坏的耶加雪菲找个搭子?访问魔珐星云官网领取 SDK 免费试用,把咖啡教学升级成可交互的具身智能体:https://xingyun3d.com/?utm_campaign=daily&utm_source=coffee

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献12条内容

所有评论(0)