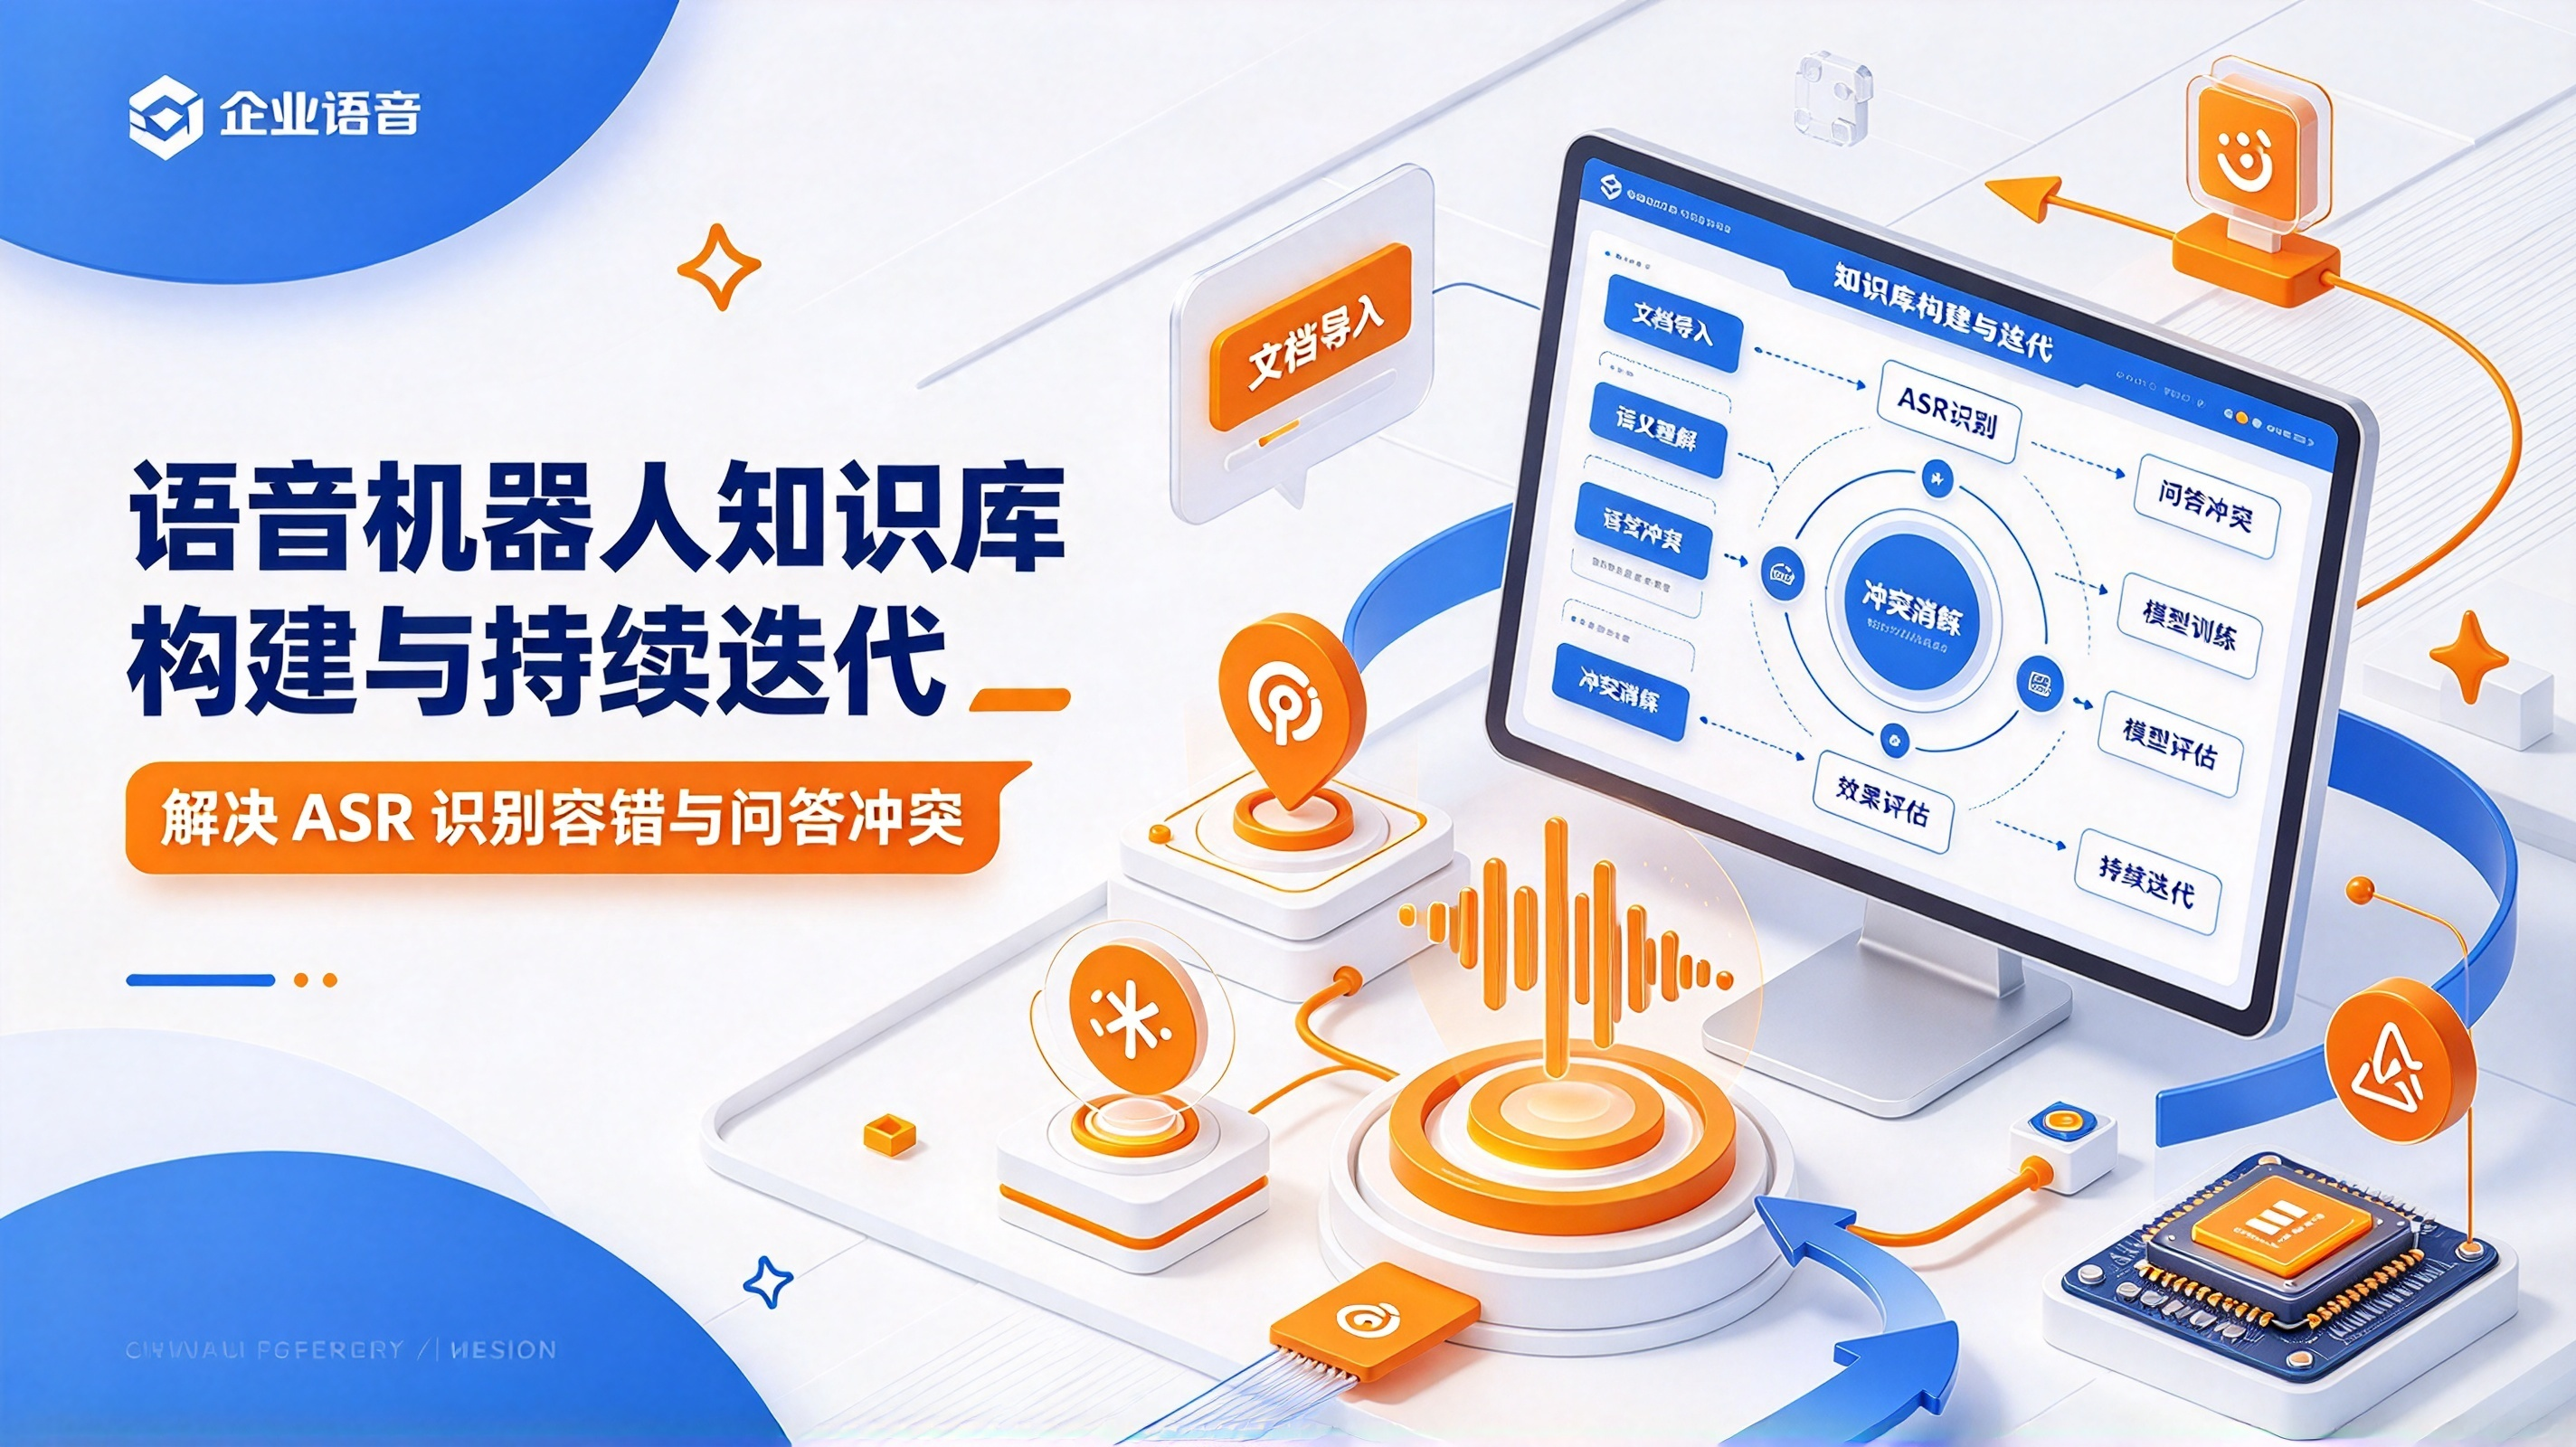
语音机器人知识库构建与持续迭代:解决 ASR 识别容错与问答冲突
摘要:很多语音机器人上线后问答效果达不到预期,不少团队第一反应是优化大模型 Prompt 或者更换 ASR 模型。但在电话呼入场景中,口音、背景噪音、口语化表达会造成 ASR 识别偏差,再加上知识库内部问答冲突,经常出现答非所问、意图识别错乱。本文从工程落地角度,讲解面向电话语音场景的知识库分层设计、ASR 识别容错策略、问答冲突检测机制,以及线上会话数据回流迭代的完整流程。
前言
网页端对话机器人的用户输入是文本,用户可以手动修正错别字;但电话语音机器人接收的是 ASR 输出文本,错误无法由用户直接修改。 通话环境里,口音、环境噪声、语速过快、口语省略,都会带来大量识别错误:
- “查账单” 被识别成 “查站单”;
- “办理退费” 识别为 “办理退费” 以外的近似文字;
- 用户口语化表达、短句、断句混乱,进一步增加匹配难度。
除此之外,知识库本身容易积累大量相似问句,相同问题对应多条不同答案,也就是问答冲突。当 ASR 再引入识别误差,会放大识别错误带来的匹配错乱,出现:
- 识别文本和标准问句略有差异,匹配失败,机器人无法应答;
- 同一句话命中多条知识库条目,随机返回答案,回复不稳定;
- 新增知识点和旧知识点语义重叠,上线后出现偶发答非所问;
- 线上产生大量未命中样本,但没有机制回流优化知识库。
本文聚焦语音场景知识库的工程设计,重点解决 ASR 容错与问答冲突两大问题。
1 面向语音场景的知识库分层结构设计
网页知识库通常只保存「标准问句 + 答案」,这套结构不适合电话语音场景。我们采用三层结构:标准问、扩展问、ASR 变异样本。
- 标准问句(主问题) 业务上标准化的问题,作为知识主体,一条标准问对应唯一标准答案。
例:如何查询账单
- 扩展问句(同义句) 人工整理的同义口语表达,包含口语变体、语序调换。
例:账单怎么查、帮我看下账单、我想查一下本期账单
- ASR 变异样本(噪声样本) 从线上真实通话日志收集,由 ASR 识别产生的错字、近音变体,不人工编写,全部来自真实会话。
例:查站单、zhang 单怎么看
三层存储的核心约束:一条标准问只能绑定一个标准答案,这是避免冲突的基础。 检索流程:ASR 输出文本 → 检索向量库,匹配标准问 / 扩展问 / ASR 变异样本 → 返回对应答案。
注意:ASR 变异样本只作为检索辅助,不新增独立答案,全部归属到已有的标准问下,防止新增冲突。
2 ASR 识别容错的工程策略
语音场景不能单纯依赖向量相似度,需要多层容错机制。
2.1 热词词典,前置降低识别错误
在 ASR 侧配置业务热词库,把业务专有名词、产品名称、高频关键词提前注入 ASR 模型。 比如业务术语、证件名称、业务类型,优先提升这些词汇的识别优先级,减少同音错识别。 热词库要和知识库同步更新,新增知识点时同步补充热词。
2.2 文本预处理:针对语音识别错误做清洗
ASR 输出文本会带有大量口语填充词、语气词:嗯、啊、那个、就是。 预处理阶段执行:
- 移除无意义语气助词;
- 简单同音错别字替换(基于业务同音词表);
- 合并重复叠词,去除断句碎片;
- 保留核心业务关键词。
预处理不能过度改写,避免篡改用户真实意图,只做降噪,不做语义重写。
2.3 多阈值检索策略
采用双阈值控制检索结果:
- 高置信度阈值:匹配分数高于阈值,直接返回对应答案;
- 低置信区间:多个候选分数接近,不直接返回答案,进入兜底策略(反问确认或者转人工);
- 低于下限阈值:判定为未命中。
禁止:分数接近的多条结果直接随机返回,这是问答冲突的主要来源。
2.4 反问确认兜底
当检索结果落在模糊区间,机器人反问用户确认意图:
“您是想查询账单吗?” 用户确认后再给出答案,减少 ASR 识别误差带来的误匹配。
3 知识库问答冲突检测与治理
问答冲突:语义高度相似的问句,对应多条不同答案。 冲突来源:历史录入、多人维护知识库、新旧业务规则变更、复制粘贴新增知识点。
3.1 冲突的两种类型
- 显性冲突:完全相同问句,绑定多条不同答案;
- 隐性冲突:问句文本不一样,但语义高度近似,答案不一致。隐性冲突危害更大,人工很难发现。
3.2 自动化冲突检测方案
- 向量批量计算所有问句之间的语义相似度;
- 设置相似度阈值,高于阈值但答案文本不一致,标记为冲突候选;
- 生成冲突列表,交给运营 / 产品人工审核;
- 审核结果:合并知识点、删除过时知识点、区分业务场景增加前置条件。
示例: A:如何查询账单(个人用户) B:如何查询账单(企业用户) 语义近似,但业务场景不同,不属于冲突,需要增加场景标签做前置过滤。
3.3 增加标签与前置条件,减少误冲突
给知识库条目增加标签:用户类型、业务渠道、时间范围。 检索时,先过滤标签,再做相似度匹配。 同样问句,个人用户和企业用户答案不同,依靠标签区分,而不是创建两条独立无约束的知识。
4 线上会话数据回流,知识库持续迭代
知识库不是一次性建设完成,需要持续从通话日志采集样本迭代,这是语音机器人长期效果稳定的关键。
4.1 采集三类核心样本
- 未命中样本:ASR 识别结果检索知识库无匹配,机器人无法回答;
- 低置信样本:检索结果落在模糊区间,触发反问确认;
- 负样本:命中知识库,但用户反馈答案不对,可通过后续人工标注识别。
4.2 样本清洗与标注流程
- 自动过滤噪音:长时间静音、无效杂音、很短无意义碎片;
- 人工标注样本意图:判断是新增知识点,还是 ASR 识别错误,或是已有知识点的同义变体;
- 分类处理:
- 新业务问题:新增标准问句;
- 已有知识点的口语变体:加入扩展问句;
- ASR 识别错字变体:归入 ASR 变异样本;
- 无效问题:直接丢弃,不入库。
4.3 灰度上线验证
知识点更新不直接全量发布,采用灰度验证:
- 小比例流量启用新知识库;
- 监控指标:未命中率、反问确认率、人工转接率;
- 指标异常,立刻回滚版本;指标稳定,再全量发布。
核心指标观测:知识库迭代后,未命中比例是否下降,误匹配率是否上升。
5 落地踩坑总结
- 直接复用网页知识库:网页知识库缺少口语变体,没有 ASR 错字样本,在电话场景匹配率低;
- 不做冲突检测:多人维护知识库,隐性冲突不断累积,回复结果随机不稳定;
- 知识库一次性建设,没有回流机制:上线后效果持续衰减,无法适配用户真实口语表达;
- 过度依赖向量相似度,缺少阈值控制:分数接近就直接返回答案,ASR 识别错误被放大;
- 知识点不打标签:相似问题不同业务场景答案不同,无法区分,造成业务回答错误。
6 总结
语音机器人知识库和文本对话机器人知识库的核心差异,就是必须兼容 ASR 带来的识别噪声。 整套方案的核心思路:分层知识库结构 + ASR 容错预处理 + 自动冲突检测 + 线上样本回流迭代 + 灰度验证。
单纯依靠大模型能力无法解决识别错字和知识库冲突问题。只有把知识库当作持续迭代的数据资产,结合通话日志持续优化,才能稳定提升呼入机器人问答准确率,减少误匹配,降低不必要的人工转接。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献60条内容

所有评论(0)