EdgeVLA-Arm:Manip 1.5B 端侧部署实践——Visual Token 压缩与 Streaming KV Cache
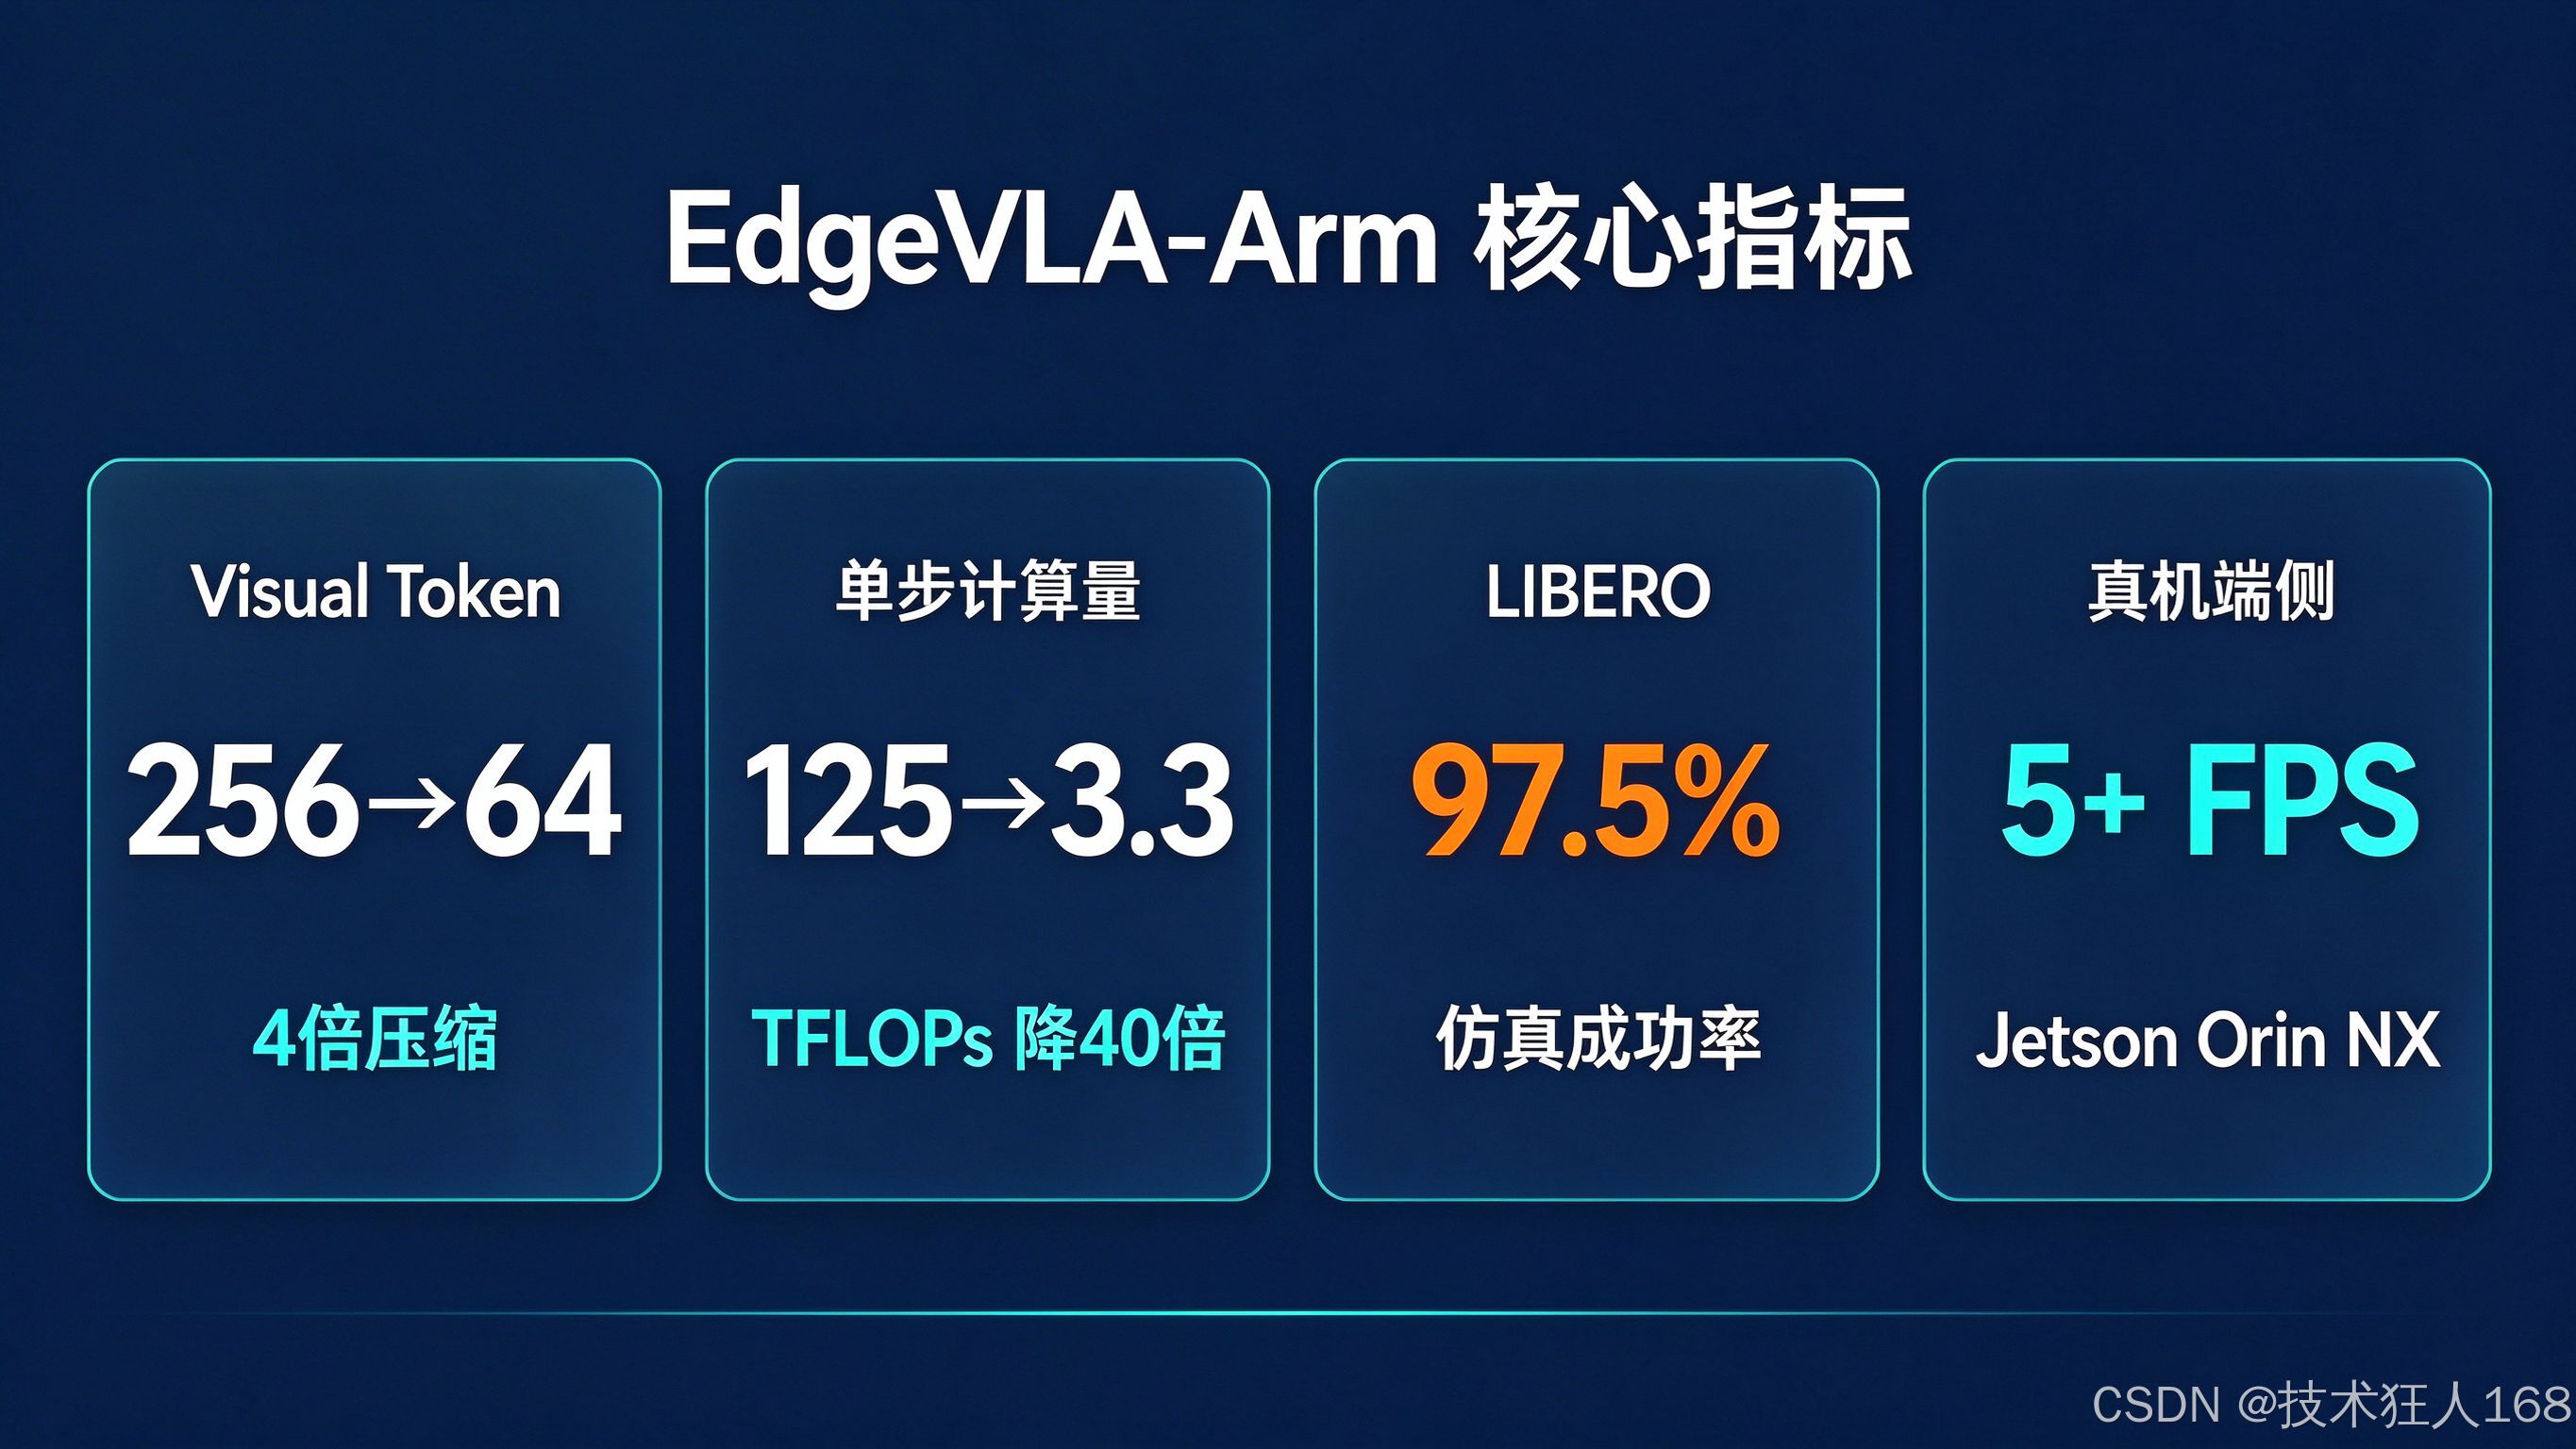
最近把 Manip 1.5B 的 VLA 模型从 H100 搬到 Jetson Orin NX 16GB,单帧推理压到 120ms,真机端到端 180ms,端侧 5+ FPS。这篇文章把整个部署链路、关键优化和踩过的坑记录下来,方便做端侧推理部署的同学参考。
1. 项目背景
机械臂操作目前主要依赖人工示教,换任务成本高。VLA(Vision-Language-Action)模型希望通过视觉编码器加 LLM backbone 直接输出动作序列,但原生模型推理延迟高,端侧硬件显存和算力都受限。EdgeVLA-Arm 的目标是在 Jetson Orin NX 上跑通 Manip 1.5B,action chunk shape=(30, 80),STATE_DIM=80,IMAGE_SIZE=(448, 448)。
整体数据流:双目 448×448 图像 → DINOv3 + SigLIP 双视觉编码器 → visual token 256→64 四倍压缩 → 拼接 STATE_DIM=80 的本体状态 → 1.5B LLM backbone(Streaming KV Cache 60 帧窗口)→ action head 输出 (30, 80) → WebSocket + MessagePack 下发到 Unitree Go2 EDU。
2. 模型加载与基础配置
模型基于 Manip 1.5B 加载,关键配置如下:
import torch
from transformers import AutoModelForCausalLM

class EdgeVLAInfer(torch.nn.Module):
    def __init__(self, model_path, state_dim=80, chunk_size=30, image_size=(448, 448)):
        super().__init__()
        self.state_dim = state_dim
        self.chunk_size = chunk_size
        self.image_size = image_size
        # 双视觉编码器:DINOv3 提空间特征,SigLIP 提语义对齐特征
        self.visual_encoder = build_dual_encoder(
            dino_name="dinov3_small",
            siglip_name="siglip_base",
            out_tokens=256
        )
        # 1.5B LLM backbone
        self.llm = AutoModelForCausalLM.from_pretrained(
            model_path, torch_dtype=torch.bfloat16, trust_remote_code=True
        )
        # action head:输出 (chunk, state_dim)
        self.action_head = torch.nn.Linear(
            self.llm.config.hidden_size, chunk_size * state_dim
        )

    def forward(self, images, state):
        # images: [B, 2, 3, 448, 448]
        v = self.visual_encoder(images)          # [B, 256, D]
        v = self.token_compress(v)               # [B, 64, D]
        x = torch.cat([v, state.unsqueeze(1)], dim=1)
        h = self.llm(inputs_embeds=x).last_hidden_state
        a = self.action_head(h[:, -1])           # [B, chunk*state]
        return a.view(-1, self.chunk_size, self.state_dim)
3. Visual Token 四倍压缩
原始双编码器输出 256 个 token,直接进 backbone 在 Orin NX 上 attention 开销过大。我们加了一个可学习的压缩投影层,在训练阶段和 backbone 联合微调,把 256 token 压到 64 token:
class TokenCompressor(torch.nn.Module):
    def __init__(self, dim=384, keep=64):
        super().__init__()
        # 用一个可学习的 query 做 cross-attention 汇总
        self.query = torch.nn.Parameter(torch.randn(1, keep, dim))
        self.attn = torch.nn.MultiheadAttention(dim, num_heads=8, batch_first=True)
        self.norm = torch.nn.LayerNorm(dim)

    def forward(self, tokens):
        # tokens: [B, 256, D] -> [B, 64, D]
        q = self.query.expand(tokens.size(0), -1, -1)
        out, _ = self.attn(q, tokens, tokens)
        return self.norm(out + q)
消融结果:直接平均池化从 256→64,LIBERO 从 97.5% 掉到 89%;换成上面这个可学习压缩层,LIBERO 只掉 1.2 个点,单步计算量从 125 TFLOPs 降到 3.3 TFLOPs,约 40 倍下降。
4. Streaming KV Cache 滚动窗口
VLA 是滚动推理,每帧都要复用历史 KV。我们实现了一个 60 帧窗口的 streaming KV cache,超出窗口的旧 token 直接淘汰:
class StreamingKVCache:
    def __init__(self, max_len=60, num_layers=28, dim=2048, device="cuda"):
        self.max_len = max_len
        self.cache = [
            {"k": torch.zeros(0, dim, device=device),
             "v": torch.zeros(0, dim, device=device)}
            for _ in range(num_layers)
        ]

    def append(self, k, v, layer_idx):
        # k/v: [B, seq, dim]
        c = self.cache[layer_idx]
        c["k"] = torch.cat([c["k"], k], dim=1)[:, -self.max_len:, :]
        c["v"] = torch.cat([c["v"], v], dim=1)[:, -self.max_len:, :]

    def get(self, layer_idx):
        return self.cache[layer_idx]["k"], self.cache[layer_idx]["v"]

    def reset(self):
        for c in self.cache:
            c["k"] = torch.zeros_like(c["k"][:, :0])
            c["v"] = torch.zeros_like(c["v"][:, :0])
窗口长度扫过 30/45/60/90 四档,60 帧时延迟和成功率平衡最好;90 帧延迟涨 15% 但成功率几乎不变,30 帧长时序任务明显掉点。
5. TensorRT 混合精度导出
全 FP16 导出后 LIBERO 崩到 60%+,动作输出抖动。定位后发现是 LayerNorm/RMSNorm 在 FP16 下累积误差被放大。正确做法是 norm 层保留 FP32,其他层 FP16:
import tensorrt as trt

def build_engine_fp16_mixed(onnx_path, engine_path):
    logger = trt.Logger(trt.Logger.WARNING)
    builder = trt.Builder(logger)
    network = builder.create_network(
        1 << int(trt.NetworkDefinitionCreationFlag.EXPLICIT_BATCH)
    )
    parser = trt.OnnxParser(network, logger)
    with open(onnx_path, "rb") as f:
        parser.parse(f.read())

    config = builder.create_builder_config()
    config.set_flag(trt.BuilderFlag.FP16)
    # 关键:norm 层强制走 FP32,不参与 FP16 量化
    for i in range(network.num_layers):
        layer = network.get_layer(i)
        if "norm" in layer.name.lower() or "ln" in layer.name.lower():
            layer.precision = trt.DataType.FLOAT
            for j in range(layer.num_outputs):
                layer.get_output(j).dtype = trt.DataType.FLOAT

    engine = builder.build_serialized_network(network, config)
    with open(engine_path, "wb") as f:
        f.write(engine)
改完之后 LIBERO 回到 96%+,延迟和全 FP16 基本持平。
6. WebSocket + MessagePack 策略服务器
推理跑在 Orin NX 上,下位机控制板单独进程收动作。用 WebSocket 做策略服务器,序列化用 MessagePack(注意 numpy 数组要先转 bytes):
import asyncio, msgpack, numpy as np, websockets

async def policy_server(websocket):
    inferer = EdgeVLAInfer(...).cuda().eval()
    async for msg in websocket:
        data = msgpack.unpackb(msg, raw=False)
        img = np.frombuffer(data["img"], dtype=np.uint8).reshape(2, 3, 448, 448)
        state = np.frombuffer(data["state"], dtype=np.float32).reshape(1, 80)
        with torch.no_grad():
            act = inferer(
                torch.from_numpy(img).cuda(),
                torch.from_numpy(state).cuda()
            )[0].cpu().numpy()
        # numpy 数组必须 tobytes 再打包,否则 MessagePack 序列化报错
        payload = {"action": act.tobytes(), "shape": act.shape}
        await websocket.send(msgpack.packb(payload, use_bin_type=True))

async def main():
    async with websockets.serve(policy_server, "0.0.0.0", 8765):
        await asyncio.Future()

asyncio.run(main())
7. 评测数据与延迟分解
| Benchmark | 结果 |
|---|---|
| LIBERO | 97.5% |
| RMBench | 53.3% |
| CALVIN ABC→D | 2.1 |
H100 BF16 单帧 120ms 分解:视觉 encoder 30ms + LLM backbone 70ms + action head 10ms + 预处理 10ms。端侧 Go2 EDU + Orin NX 16GB 5+ FPS,真机端到端 180ms。单步计算量 125→3.3 TFLOPs。0.9B Track 模型控制 Go2 人体跟随稳定。
8. 踩坑清单
- deepspeed 编译报
cuda_runtime.h: No such file:CUDA 环境变量没配,export 正确的 PATH 和 LD_LIBRARY_PATH。 - 4090 微调 OOM:batch size 从 4 砍到 1,开梯度累积。
- 多卡 NCCL 通信错误:多网卡环境指定 NCCL_SOCKET_IFNAME。
- MuJoCo EGL 渲染黑屏:headless 环境装对 EGL 后端,设置 MUJOCO_GL=egl。
- torch.compile 崩溃:定位到不支持的自定义 op,先 dynamo 禁用该部分。
- DataLoader 卡住 loss 不下降:shuffle 打开,num_workers 从 0 改成 4。
- 微调 loss 不下降:学习率从 1e-4 降到 1e-5。
- TensorRT 全 FP16 精度不对:norm 层保留 FP32。
- MessagePack 序列化 numpy 报错:先 tobytes。
9. 小结
端侧 VLA 部署的核心矛盾是延迟和精度的 trade-off。visual token 压缩把计算量砍了 40 倍,streaming KV cache 把长序列开销压住,TensorRT 混合精度把推理跑满 Orin NX 的算力,最后用 WebSocket + MessagePack 把通信开销压到 1ms 级别。整个项目从仿真到真机的完整笔记、代码和面试复盘我都整理成了一份文档,做这个方向的同学可以交流。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)