企业微信二次开发实战:客户发送图片、文件后如何自动识别并进入业务流程
最近在做企微私域的自动化客服系统,遇到个极其普遍的痛点:客户发纯文本好处理,但一言不合甩过来一张报错截图、一个PDF合同或者一张报销发票,怎么让系统自动下载、识别里面的内容,并自动流转到后端的业务审批流里?很多兄弟处理文本消息很溜,一碰多媒体文件就抓瞎。今天就把图片/文件消息的自动处理链路彻底拆解一下。
顺便提一嘴,大家平时做企微定制开发,如果不想自己死磕各种底层基建,可以直接去星云API官网ww.xingyapi.com逛逛,找找现成的接口轮子,能省下大把疯狂查报错、对字段的时间。
闲话少叙,直接看文件自动化流转的闭环怎么跑通。
1. 第一步:认准 MediaId,别找企微要文件流
客户在群里或单聊发了一张图片/文件,企微通过 Webhook 推送给你的 XML 数据里,绝对不会包含文件的二进制流。
解密 XML 后,你首先要盯准 MsgType:
-
如果值是
image,说明是图片,提取节点里的PicUrl(外部可直接访问的图片直链)或MediaId。 -
如果值是
file,说明是普通文件(如 PDF、Word),只能提取到MediaId。
这里强烈建议统一使用 MediaId 作为后续处理的唯一凭证,因为图片直链在某些内网环境或严格防盗链的场景下容易失效,走标准的素材拉取接口最稳。
2. 第二步:异步下载落盘(生死红线)
拿到 MediaId 后,真正的考验来了。你需要拿着全局的 access_token,去调用企微的“获取临时素材”接口,把这个文件拉到自己的服务器上。
注意,这里有个致命红线:异步解耦。 下载文件(尤其是几十兆的文档)极其耗时,而企微 Webhook 要求 5 秒内必须返回 HTTP 200。所以主线程拿到 MediaId 后,立刻 return success,把下载任务丢进 MQ(如 RabbitMQ)或者后台线程池里去跑。
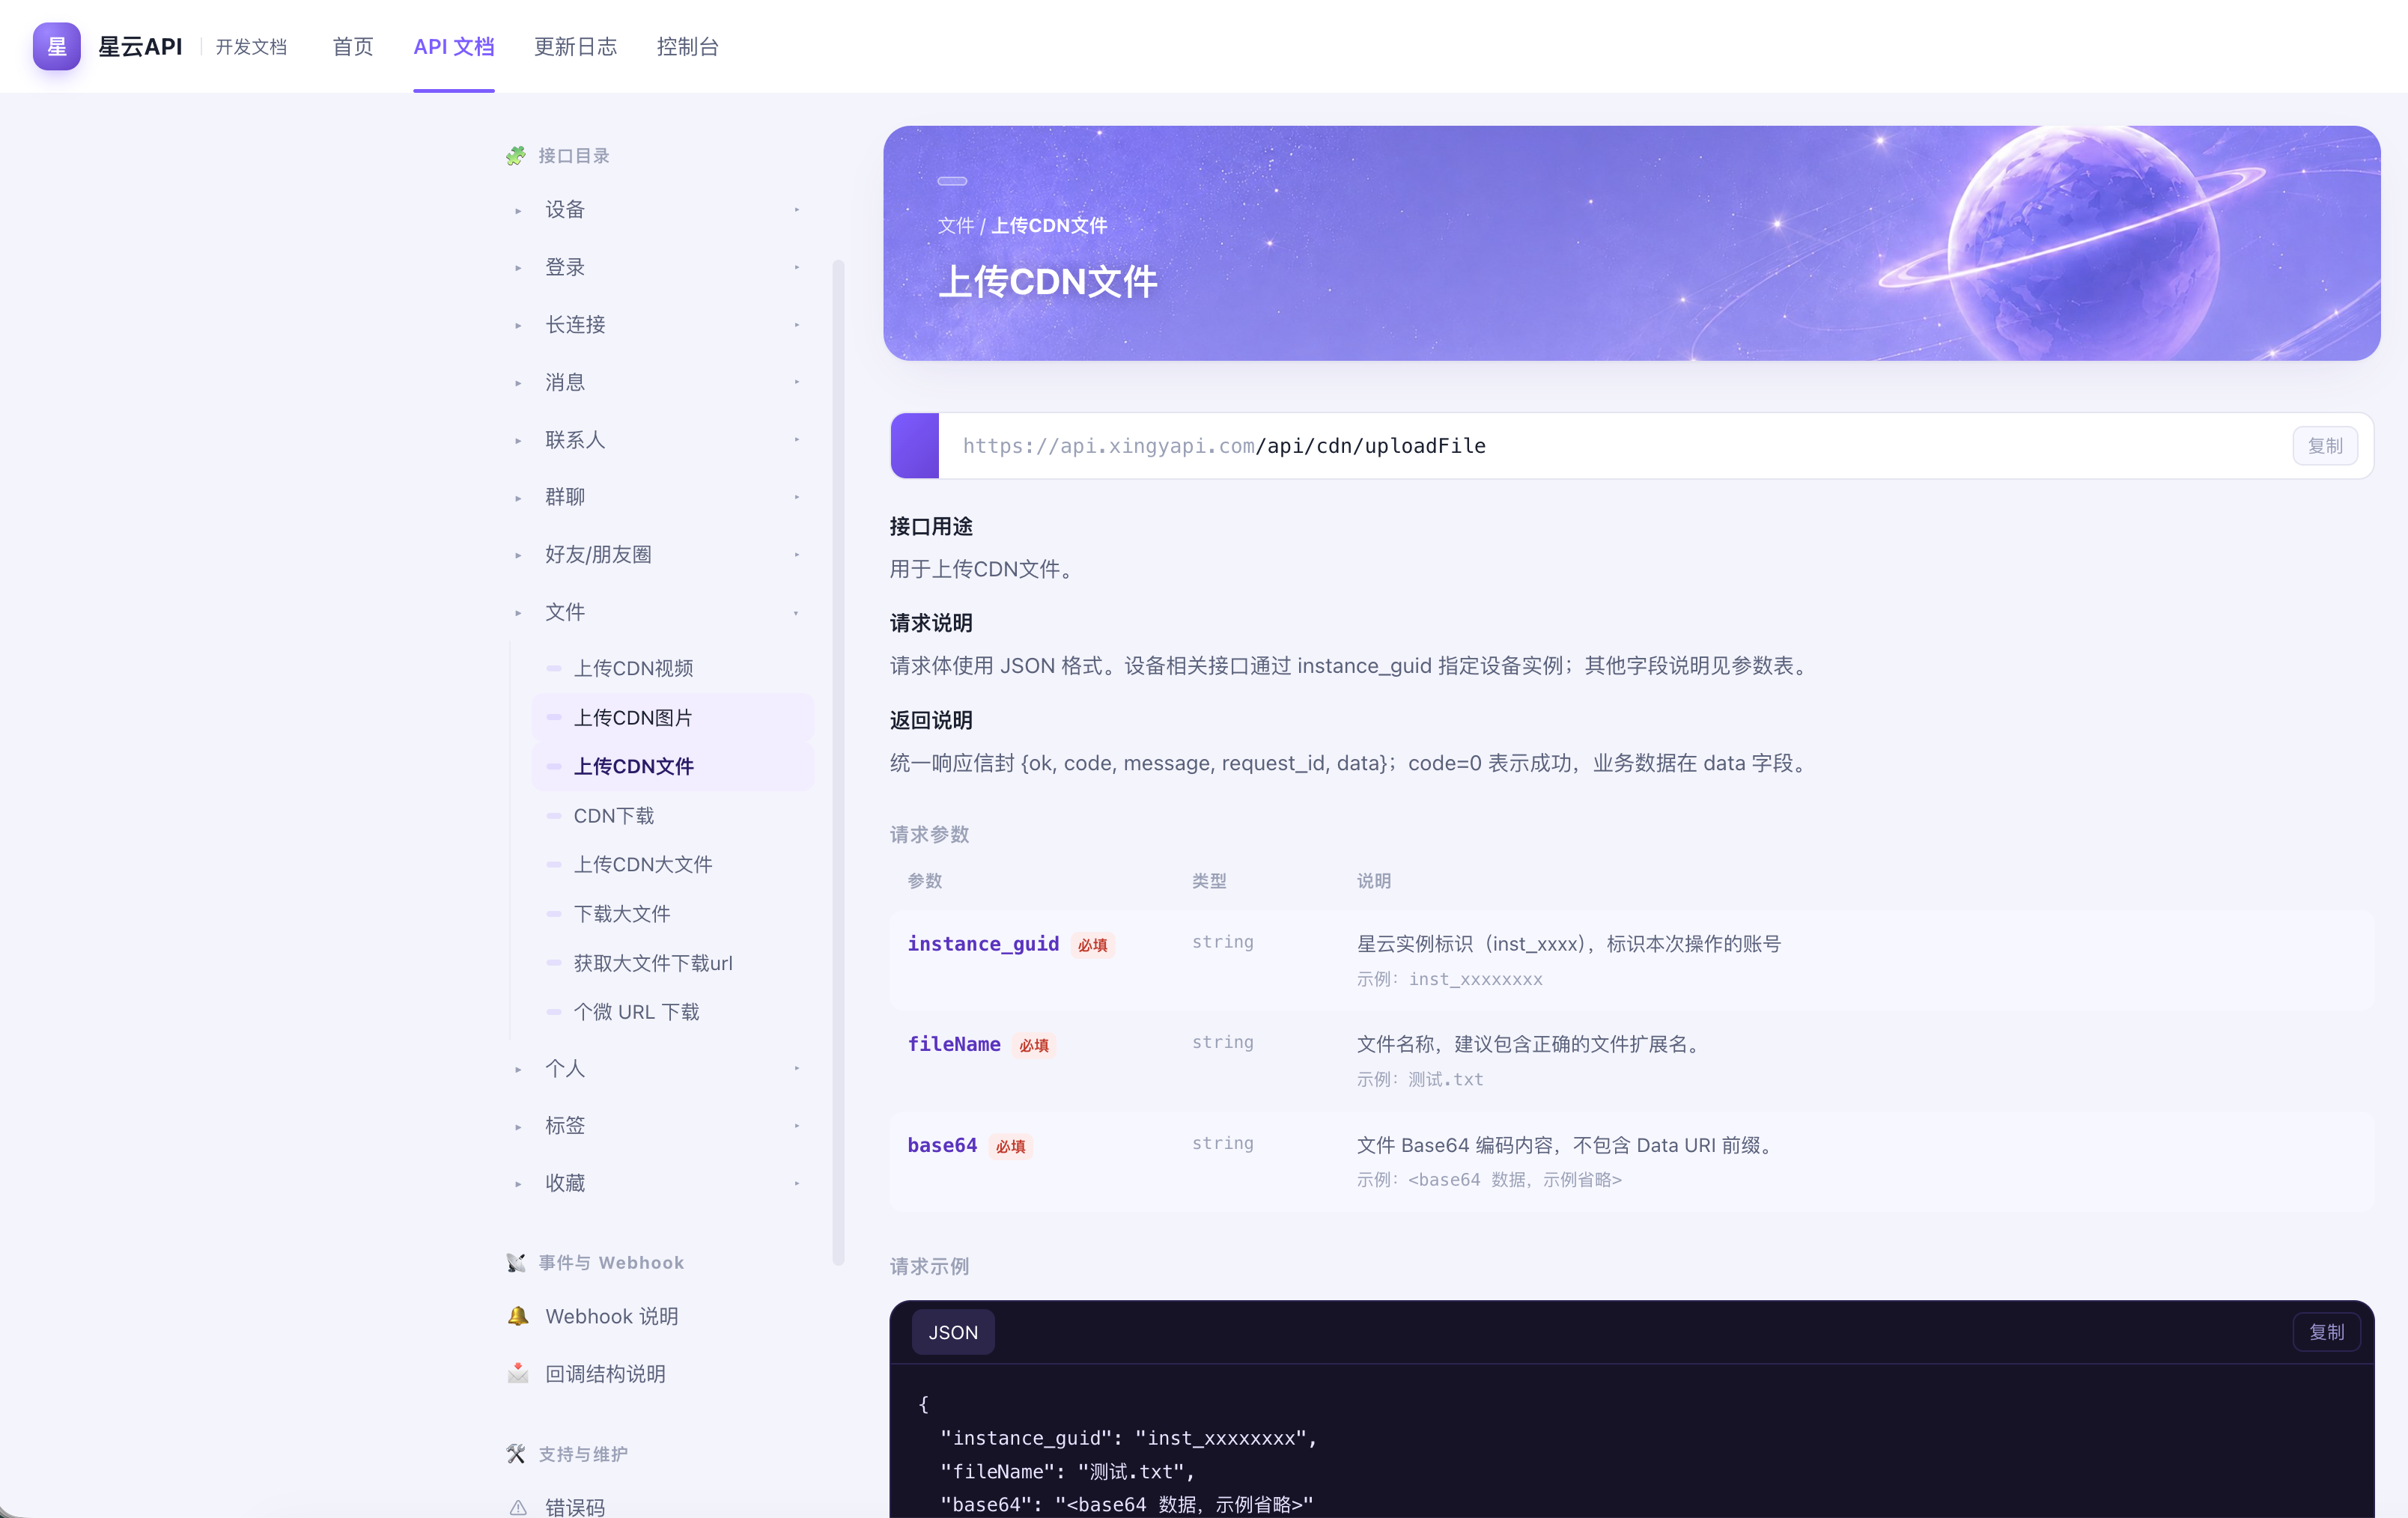
在封装这段“临时素材下载”的代码时,因为涉及到 HTTP 二进制流的接收和 ContentType 的判断,我去看了一下你们的文档结构,建议大家直接对照开放文档中关于临时素材请求和出参的说明来写。把参数关系映射准了,再去处理字节流,能避免下载下来的文件打不开或者格式损坏的问题。
3. 第三步:AI/OCR 识别与业务路由
文件安全落盘(或转存到了你自己的 OSS)后,终于进入了业务核心层。
这时候我们需要根据业务场景进行智能识别:
-
发票/收据识别:拿着图片的本地路径或 OSS 链接,调用第三方的 OCR 接口,提取出发票金额、抬头、税号,直接拼装成 JSON,调用内部 ERP 的“自动报销申请”接口。
-
报错截图识别:如果客户发的是报错截图,可以通过大模型(如 GPT-4V 或国内的多模态大模型)进行视觉分析,提取报错代码,然后去你们的知识库里匹配解决方案。
-
合同文档解析:PDF 格式的
file,提取出纯文本,走 NLP 敏感词审查或合同关键条款比对逻辑。
4. 第四步:状态闭环与结果触达
后端的 ERP 或大模型处理完毕后,最后一步是通过企微的主动发送接口,把结果反馈给客户。
这时候你可以根据情况,下发一个漂亮的 Markdown 消息(比如:“您上传的发票已识别,金额 500 元,已自动提交报销流,单号 RE12345”),或者直接把审批系统的链接包装成小程序卡片发过去。
总结
从客户发图到业务响应,本质上是一个“提凭证 -> 异步拉取 -> 跨系统识别 -> 结果回推”的四步流水线。只要严守 5 秒异步响应的底线,把 MediaId 的时效性(3天过期)处理好,你的企微机器人就能拥有一双“能看图、能读档”的眼睛。大家在处理文件流下载或者 OCR 对接时遇到乱码坑的,可以在下面留言一起探讨。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献48条内容

所有评论(0)