用 SDK 落地一个英语口语陪练具身交互智能体:从“能说话“到“像在和人说话“
文章目录
用 SDK 落地一个英语口语陪练具身交互智能体
摘要:本文用魔珐星云 SDK 落地一个英语口语陪练具身交互智能体,从端到端交互架构到可复制代码,完整演示如何让 AI 不再只是"能说话",而是"像在和人说话"——能随时被打断、会看场合、有表情地陪你练口语。
先交代背景:我平时会做一些 AI 落地的小项目,这次的目标很明确——不做 Demo 演示视频,而是做一个真的能天天用的英语口语陪练:打开网页,一个 具身交互智能体坐在屏幕里陪你练口语,你能随时插话,它会停下来听你说完,再接着聊。
做之前我以为这就是「语音识别 + 大模型 + TTS」三件套的活儿。做完之后我发现,难点根本不在"能不能说话",而在**“像不像在和人说话”**。这篇文章把整个落地过程、踩的坑和实测数据都记下来,代码可以直接抄走跑起来。
一、练口语最大的敌人,是"没有对手"
市面上练口语的产品我几乎用了个遍:跟读打分型的,你念一句它评个分;情景选择型的,你点 A 它念 B。用一句话总结就是:这不是对话,是做题。
后来 ChatGPT 类产品出现,语音对话确实能聊了。但用了两个月,我还是会出戏——
-
它说话的时候,你插话,它要么听不见,要么把你半句话和它没说完的话搅在一起;
-
屏幕上永远是一颗"光球"或者一张静态照片在震动,你看不到它"听到你犯错时皱眉",也看不到它"在你答对时点头";
-
回合感很重:你问一句,它想两秒,答一大段,然后又轮到你。
问题出在哪?我后来想明白了:对话的"内容"只是对话的一小半,剩下的一大半是"状态"——对方在不在听、有没有被打断、表情给你什么反馈。 大模型解决的是内容,这些状态没人管。
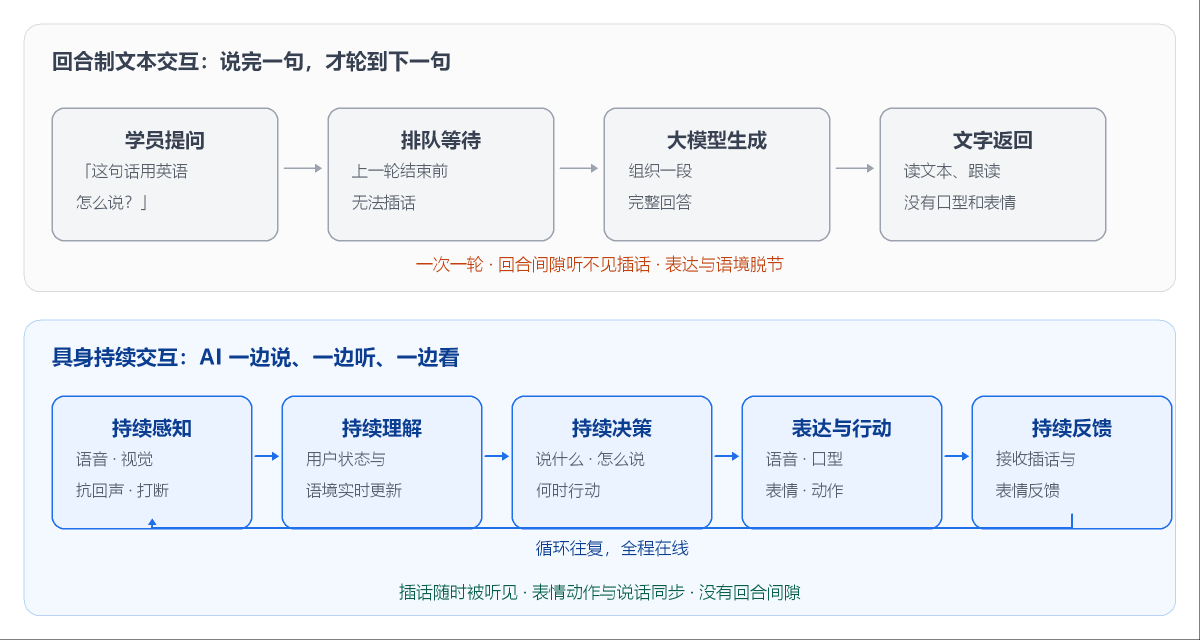
图 1把两种交互范式摆在一起看就很清楚了:传统方案是串行流水线——ASR 识别、LLM 生成、TTS 合成,一环做完交一环,每一环都有延迟,而且环与环之间状态不同步;你听到的那句回答,可能是三秒前的"你"换来的。而真正自然的对话是一个持续交互循环:AI 一边说、一边听、一边看,随时被打断,随时调整。
这就是这两年大家说的具身交互:AI 不只是会思考,还要有身体、能感知、会表达。而我要做的口语陪练,恰恰是对这个循环要求最苛刻的场景之一——口语练习本来就该像面对面聊天。
二、不缺脑子,缺身体:魔珐星云补的就是这一层
顺着这个思路去找方案的时候,我注意到了魔珐星云——一个端到端具身交互智能平台(后面有 PC 端体验入口,可以先行感受)。
官方对它的定义是这么一句,我抄在这里,因为它基本概括了我这个项目能得到的所有支撑:
魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。
具体来说,它把多模态感知 + 专属智脑 + 多模态表达 + AI 端渲 + 数字与物理行动,连同 Real‑time Interaction Runtime,连接成一套完整系统,让 AI 可以通过不同的屏幕和机器人身体进入真实世界。
它的定位我用自己的话概括:大模型负责 AI 的"大脑",魔珐星云补齐 AI 的"身体、表达和实时交互"。它不是又一个套壳聊天产品,而是一层平台能力,让任何一个大模型/Agent 拥有可以被看见的 3D 形象、自然的语音表情,以及能随时被打断的实时交互。
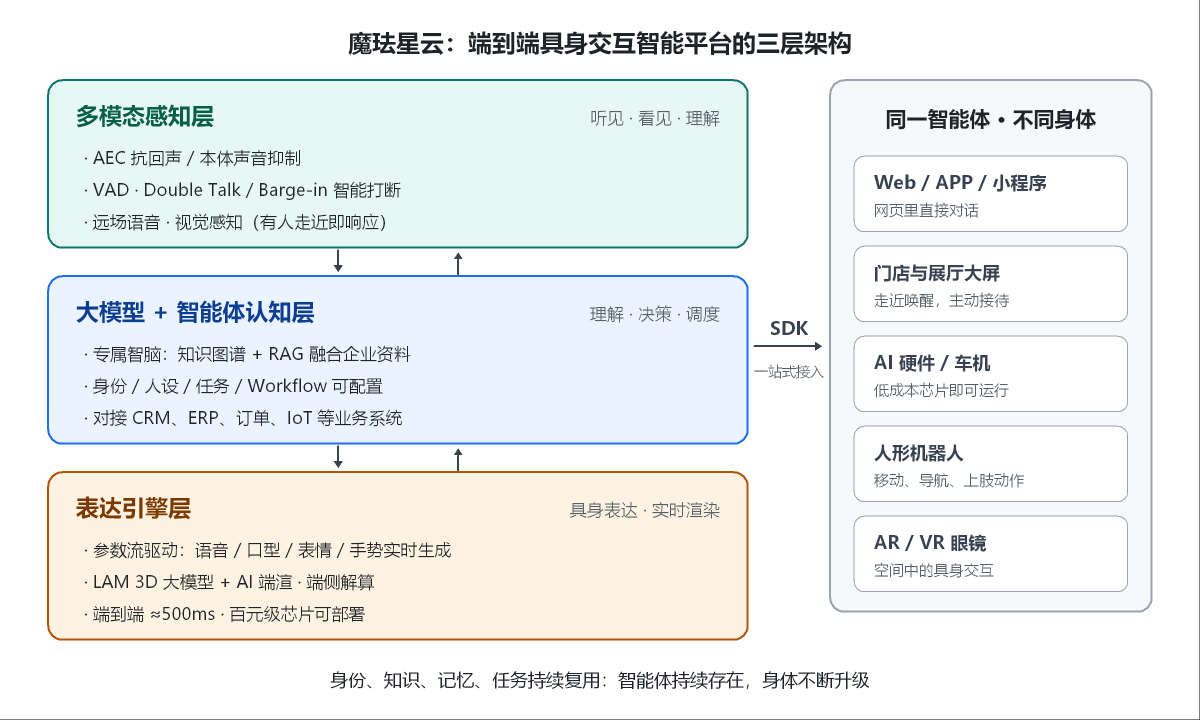
从图 2 的三层架构能看到它和"三件套拼接"的本质区别:
-
多模态感知层:不是"听清一句话"就完事,而是持续地听——AEC 抗回声把数字人自己的声音滤掉、VAD 判断有效语音、Double Talk/Barge-in 处理"你说话时它正在说"的冲突。这一层直接决定了口语陪练里"我能不能随时插话"。
-
大模型 + 智能体认知层:星云专属智脑支持全模态数据解析、知识图谱与 RAG 深度融合、知识治理搭建企业知识底座,身份、人设、任务、Workflow 都可配置,还可以对接 CRM、ERP 等各类外部业务系统。对陪练场景来说,就是把 “这是一个有耐心的英语老师” 写进它的认知里。
-
表达引擎层:这是我最关心的部分。它走的是参数流路线——云端下发的不是视频流,而是驱动 3D 形象的参数,渲染靠 AI 端渲和端侧解算在终端侧完成。别小看这个技术选择,它直接带来三个结果:端到端 ≈500ms 的响应延迟、支持高并发、终端成本压到百元级芯片也能跑。
对比一下就明白这个路线的意义:视频流方案里,终端越多、并发越高,云 GPU 和带宽的成本曲线就越陡;参数流方案里,云端只算参数,渲染分布在每个终端上——交互体验的实时性和规模化落地,第一次不再互相矛盾。
2.1 专属智脑:不是通用 Chatbot,而是让智能体知道"我是谁、知道什么、应该做什么"
这一层是我在选型时最看重、也是最后被说服的地方。
先说一个我最初的误解:我以为"智能体的人设"就是往 System Prompt 里塞一句话。真正用起来才发现,通用模型和专属智脑解决的是两个不同层面的问题——大模型更像解决"我能不能回答这个问题",专属智脑还要解决"我是谁、我代表谁、我掌握哪些知识、当前任务是什么,以及下一步该调用哪个系统"。
对口语陪练来说,这一层要落三件事。
第一件事:它知道什么——知识底座不是"把资料传进去"那么简单
我原本打算把几份口语教材 PDF 丢进向量库就完事,看完文档才发现全模态数据解析的差别:它支持 PDF、Word、PPT、图片、音频、表格等不同类型资料,而且解析过程中会同时保留资料里的层级关系、图文关系、表格关系、说话人信息和上下文。
这一点在教材场景里很致命。一本口语教材,“句型 → 例句 → 替换练习"是三层嵌套结构;一张发音图表,音标和口型示范图是"图文对应"关系;一段真人对话音频,不同说话人的角色标注本身就是信息。如果只是把文件"转成文字”,这些结构全丢了,检索出来的就是一堆没有上下文的碎句。
再往上是知识图谱 + RAG 深度融合:不是只在资料里寻找"最相似的一段文字",而是进一步把文档中的实体、概念和关系组织起来,让 AI 从"找到一段话"升级为"基于关系组织答案"。底层可以结合向量语义、关键词和知识图谱进行召回,让智能体面对跨资料、跨知识点的问题时,不只是命中某个片段,而是能把多个相关知识连接起来。
放到陪练场景里,这个区别很直观:学员说 “I want a coffee”,普通 RAG 只会捞出教材里最像的那句话;而带上关系组织之后,智脑能顺着"点单场景 → 常见句式 → 该学员当前的 CEFR 级别 → 上周卡壳过的表达"这条链,给出既符合场景、又匹配他当前水平的回应。
第三项是高效知识治理——这块我一开始觉得是"企业才需要的东西",后来发现恰恰相反。口语素材是会变旧的:我调整了纠音规则、换掉了几个场景剧本,如果没有围绕知识块、标签、实体、关系、向量索引和来源信息的持续治理,改完之后老答案还会从旧索引里冒出来。企业知识不是一次建完就不变,真正重要的是在资料持续新增、修改和废止后仍然保持准确。
第二件事:它是谁、当前要做什么——把"有耐心的老师"写进认知
专属智脑不只是"知道内容",还要知道自己代表谁、服务谁、遵循什么规则、当前要完成什么任务。可配置的内容包括:身份、人设、角色、任务、规则、音频、Agent、Workflow、对话流程和工具调用。
我给 Amy 配的东西,基本都落在这一层:
| 配置项 | 我给口语陪练配的内容 |
|---|---|
| 身份 / 人设 | “有耐心的英语陪练老师 Amy”,鼓励式教学,不打击表达欲 |
| 角色 / 规则 | 不中途纠正发音、不评价对错、单句不超过 15 个词 |
| 任务 | 按情景剧本推进对话,把学员的开口时长拉满 |
| Workflow / 对话流程 | 接话 →(必要时)降速重复关键词 → 一轮结束再复盘 |
| 音频 | 美音、语速 0.95,随学员水平浮动 |
| 工具调用 | 查询学员历史卡壳点、按需拉取新的情景剧本 |
配完之后的体感变化挺大:她不再只是"回答得对",而是开始具备岗位化、场景化、流程化的工作能力——知道自己现在是个陪练老师,知道这一轮该让学员多说而不是自己说,知道什么时候把话题推进到下一个剧本。
文档里还有一句我觉得对开发者很友好:用户可以根据自己的需求配置习惯使用的大模型,如果没有常用的大模型,可以直接用自研智脑。我这次正好是这么分工的——内容生成继续跑 DeepSeek,而身份、知识、任务、流程这些"智脑该管的事"交给平台,两者不冲突。
第三件事:它能不能真正进入业务
第三层是我做 Demo 时用不到、但看文档时觉得最有想象力的部分:专属智脑最终不是停留在对话层,而是要能进入企业真实业务流程,可连接 CRM、ERP、OA、HIS、BI、商品系统、订单系统、客户系统、门店系统、IoT 以及第三方 Agent。
口语陪练是个人项目,用不上这些。但如果把同一套认知层放进企业培训,逻辑立刻通了:学员的练习记录进 HR 系统、卡壳点进培训看板、课程完成度触发后续排课——AI 不只是生成一个答案,而是可以结合业务系统完成查询、协同、触发和流程推进。
这一层的核心优势,一句话概括:从通用回答能力,升级为面向具体身份、岗位和业务的智能体能力。
2.2 端到端,不是 ASR + LLM + TTS 的简单拼接
这里必须说清楚一件事,因为它最容易被误解。
传统方案往往是:ASR → LLM → TTS → 屏幕 / 机器人。各个模块单独都能工作,但到了连续的人机交互中,就会出现状态不同步、响应链路变长、表达与用户当前状态脱节的问题。
问题不在于这些单项技术不好,而在于它们之间缺少统一的状态管理。 ASR、LLM、TTS 这些能力本身都很重要,也都在快速进步,我完全没有否定它们的意思——真正进入持续的人机交互,需要的是把它们围绕一次完整的用户交互连接起来。
星云不是简单把几个模块连起来,而是围绕一次完整的人机交互设计整个系统,形成:
持续感知 → 持续理解 → 持续决策 → 持续表达与行动 → 持续反馈
也就是 Continuous Interaction Loop(持续交互循环)。
一句大白话解释:不是"你问一句,它答一句",而是 AI 一边和你交流,一边继续听、继续看、继续判断接下来应该怎么回应和行动。
落到我的项目上就是:学员说话的同时,AEC 在滤掉 Amy 自己的声音、VAD 在判断有效语音、Barge‑in 在判断这是插话还是背景噪声;与此同时,LLM 那边的流式结果正一句句喂给表达层。三件事并行推进,任何一件的中间状态变化都能立刻影响另外两件事——这才是"随口插话她就能停下来"的技术底座。
2.3 可插拔组件:换掉一个模块,交互不能散架
文档里"模块支持可插拔"这句话,我第一遍读得很快,后来才意识到它说的是件挺硬的事。
先明确一点:可插拔并非简单的 API 拼接。感知、认知、表达与执行之间存在紧密的时序依赖与状态关联——比如换了 ASR,语音事件的到达时序就变了,如果表达层还在按老节奏等文本,播报就会错拍。
星云的做法是通过标准化的接口契约与统一的状态管理机制,确保模块替换之后,事件流转、会话状态、时间同步与异常处理仍然保持一致,端到端交互体验不受影响。当前支持的组件大致是:
对我这种个人开发者来说,这里最实际的价值是**“不被单一供应商绑死”**:Brain 那一栏我正好是在自研智脑和第三方 LLM 之间做选择,语音音色也能按风格换。而对企业客户更有意义——有些客户的数据必须私有化,有些客户的模型栈已经定了,可插拔意味着这些都不用推翻重来。
2.4 数字与物理行动:从"生成答案"到"真的做出来"
三层之外还有两项容易被忽略的能力。AI 端渲是让整套东西能真正铺开的基础设施(第 4 节细说);而数字与物理行动决定的是智能体从"文字回复"走向真实场景中的表达与互动:
-
数字行动:智能体不再只是"生成了一段答案",而是能通过语音、口型、表情、手势和身体动作,把答案自然地说出来、演出来、表达出来;
-
物理行动:当智能体进入机器人以后,行动进一步延伸到物理世界——转向用户、靠近用户、移动、导航带路、跟随指示、上肢动作、Robot Skill,以及与物理环境的交互。
我的口语陪练只用到屏幕这一半,但这恰好解释了文档里那句话的分量:同一个智能体,可以拥有不同的身体;智能体持续存在,身体不断升级。 今天我为网页写的接入代码,换到展厅大屏上大部分能直接复用;将来它如果上了机器人,认知层里那套"身份、知识、记忆、任务"也还是这一套。屏幕和机器人从来不是两套智能能力,只是同一个智能体的两种身体。
三、动手:把口语陪练做出来
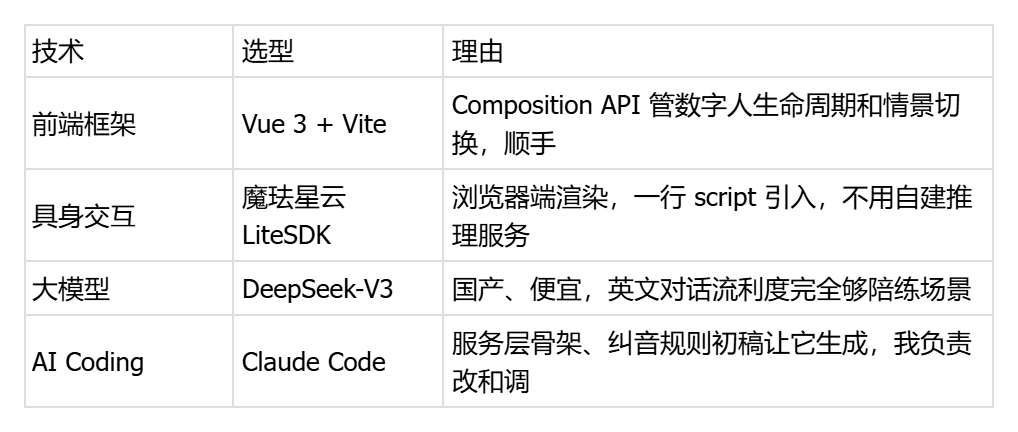
3.1 技术选型
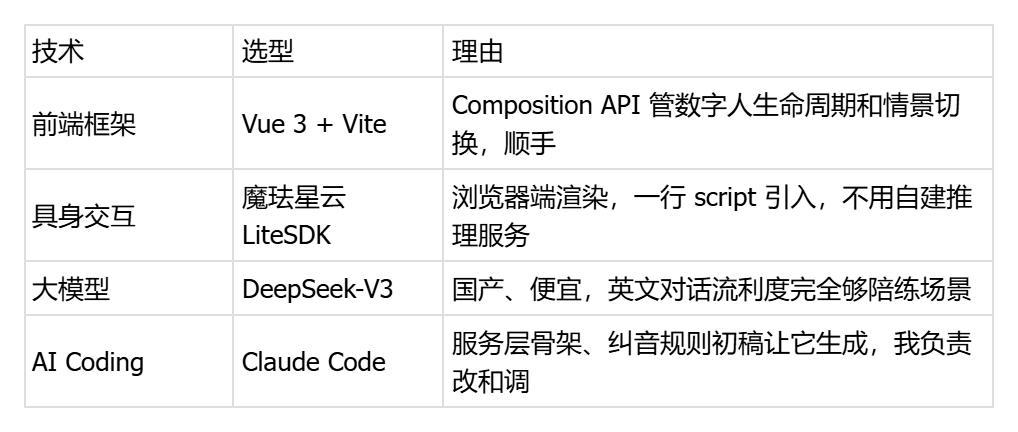
AI Coding 工具这里多说一句:这次的开发模式是"Claude Code 出骨架,我做架构决策和调试"。服务层单例封装、DeepSeek 流式输出的分句逻辑,都是先把需求描述清楚让它生成,再按 SDK 实际行为修正。效率确实高,但API 行为一定要自己验,它生成的初始化参数和文档有出入,跑了两次才对上。
3.2 系统架构
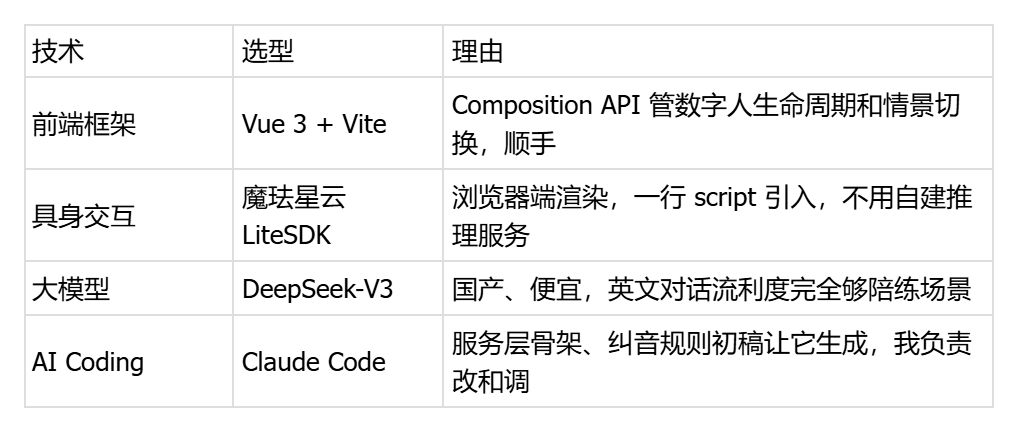
整体分三层:组件层管界面状态,服务层做 SDK 和 LLM 的封装,业务层放情景剧本和纠音策略。数据流不复杂:学员语音进 SDK → 感知层做抗回声和打断判定 → 我这边把学员意图连同情景剧本发给 DeepSeek → 流式返回逐句喂给星云 speak() → 参数流驱动具身智能体开口。
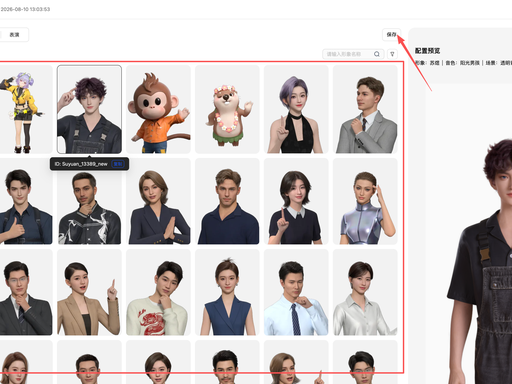
顺便补一个架构视角:音色、形象、场景这些呈现资产,都绑定在星云控制台对应 AppID 的配置里,前端只能调用、不能切换 3D 资产。一开始我想"代码里随时换个人",后来接受了这个设计——它正好对应"智能体持续存在、身体可升级"的分层思路:业务代码管认知与流程,形象资产在平台上统一管。
3.3 极简 Demo(可复制直接跑)
先把最小可运行版本贴出来,五个步骤就能跑通,具体字段以官方 SDK 文档为准:
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>口语陪练最小 Demo</title>

  <script src="https://media.xingyun3d.com/xingyun3d/general/litesdk/xmovAvatar@latest.js"></script>
</head>
<body>

  <div id="avatar-container" style="width:100%;height:70vh"></div>
  <button onclick="startTutor()">开始陪练</button>

  <script>
    let sdk = null;

    async function startTutor() {
      // ③ 初始化:appKey 在星云控制台申请
      if (!sdk) {
        sdk = await initAvatar({
          appKey: '你的appKey',
          accessToken: '你的token',
          avatarId: '选择一个数字人形象'
        });
      }
      // ④ 情景 Prompt 注入,LLM 流式生成回应
      const reply = await askDeepSeek(
        '你是口语陪练老师 Amy。情景:咖啡店点单。' +
        '请用 B1 难度英文先开口,一句不超过 15 个词。'
      );
      // ⑤ 逐句交给数字人说出来,参数流驱动口型和表情
      sdk.speak(reply);
    }
  </script>
</body>
</html>
生产代码里我会把 SDK 操作封成单例服务,重点处理两件事——流式分句和打断:
// llm.service.js(节选):DeepSeek 流式输出按句切分,边生成边播
function splitSentences(buffer) {
  // 按 . ! ? 切句,残句留在 buffer 里等下一批
}

// xingyun.service.js(节选):打断是口语陪练的命根子
class XingYunService {
  async init() { /* 动态加载脚本 + 初始化,解决加载时序问题 */ }
  speak(text)  { this.instance.speak(text); }
  stop()       { this.instance.stop(); }        // Barge-in 后立即停止当前表达
  onInterrupt(cb) { this.instance.on('bargein', cb); } // 用户插话事件
}
两个踩坑记录:
-
SDK 脚本加载时序:
@latest直引偶尔会碰到XmovAvatar is not defined,我在服务层里做了动态加载兜底;生产环境建议锁版本号。 -
打断后的状态清理:用户插话 →
stop()停掉当前表达 → 但 LLM 那边还在流式吐字,必须同时 abort 上游请求,否则数字人停了、队列里还在补词,嘴会对不上。
3.4 把专属智脑配成"一位真正的陪练老师"
代码跑通之后,真正决定体验好坏的是认知层怎么配。我按前面那张表把它拆成了四块,也顺便踩到了认知层最典型的一个坑。
第一块是身份和人设。我给她写的不是"你是英语老师",而是带边界的描述:
身份:英语口语陪练老师 Amy,美音,鼓励式教学
规则:
1. 不中途纠正发音,不评价对错
2. 单句不超过 15 个词,先让学员听懂,再让他开口
3. 学员卡壳时先等待,再降速重复关键词,最后才给提示
4. 一轮对话结束再复盘,一次只挑一个改进点
5. 永远不表现出不耐烦
第二块是知识底座。我把三类资料分开放进知识库,因为它们的检索路径完全不同:
第三块是任务和流程。这部分我用 Workflow 描述对话推进的节奏:开场问候 → 抛出场景问题 → 等待学员表达 →(卡壳则降速重复)→ 一轮结束 → 复盘一个点 → 进入下一轮。把它写成流程而不是塞进 Prompt 的好处是——它不会因为某轮回答变长而被模型"忘掉"。
第四块是工具调用。我给 Amy 挂了两个轻量工具:查学员历史卡壳点(决定这轮复盘挑哪个问题)、按需拉取新剧本(避免一直在咖啡店里出不来)。
这里说一个我踩的坑,也正好回答了"为什么不能只靠 System Prompt":我最初把所有规则都写在一段 Prompt 里,结果对话一长,模型开始顾此失彼——要么忘了不纠正发音,要么忘了单句词数限制。移到认知层按"身份 / 规则 / 任务 / 流程"分开配之后,稳定性明显好了。这不是模型变聪明了,而是它不该靠一次性的提示去记这些长期约束。
四、实测:三个让我印象最深的瞬间
第一个是打断。 我特意在 Amy 说到一半的时候插话:“wait, I didn’t catch that”。几乎零等待,她停下来了,眼神朝向我,重新听我说完。这个体验在跟读打分型产品里根本不存在——你只能等它把这段话放完。整个"感知 → 决策 → 开口"链路实测在 500ms 量级,插话的体感接近真人接话。
插话打断实测录屏/GIF——Amy 说到一半被插话后停下、转向倾听的连贯画面。建议截取打断前后 3 秒。
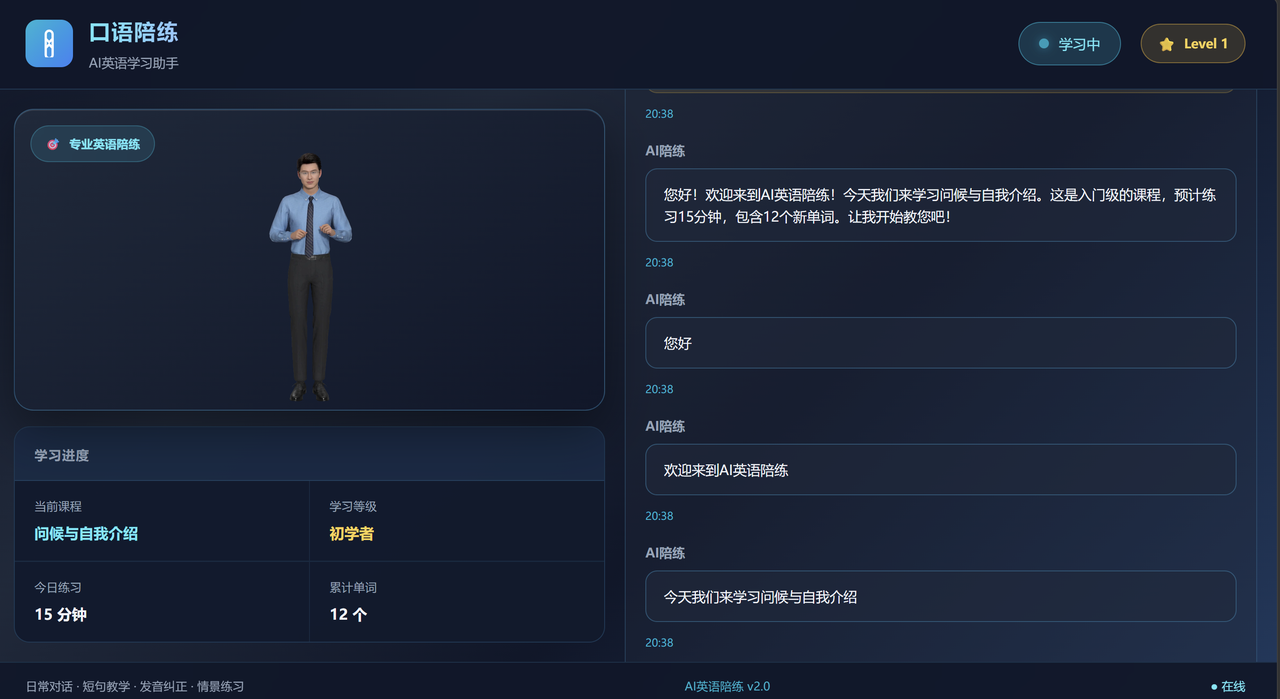
第二个是表达不是"贴"上去的。 学员答对时她会笑、会点头;听到明显的中式发音时,眉毛会有一个很轻的"嗯?"的动作,然后放慢语速重复一遍关键词。这些反应不是预设动画库的播放,是参数流实时驱动出来的——这也是为什么我能把"鼓励式教学"的人设写进认知层,她的表达会跟着人设走,而不是千人一面。
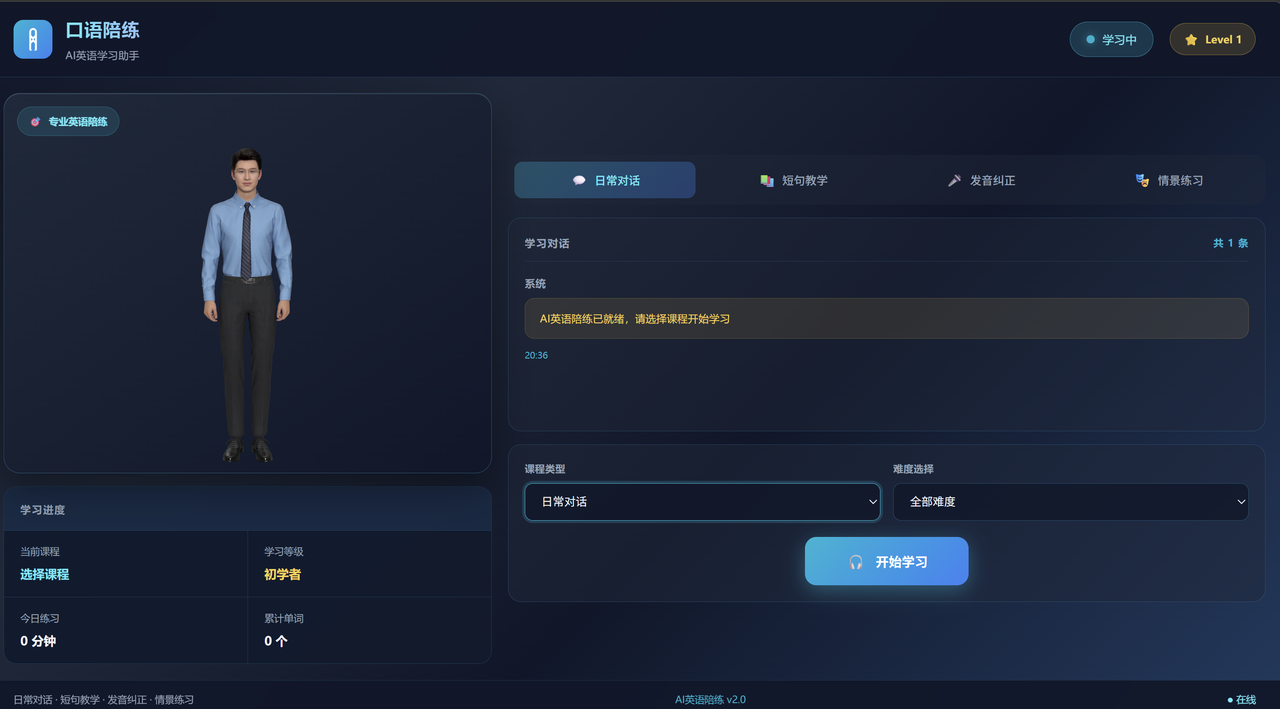
口语陪练数字人 + 实时字幕 + 情景选择。
第三个是多端的"免费"程度。 同一套服务层代码,我把渲染容器尺寸改了改,直接就在手机浏览器上跑起来了,弱网环境下也没断——因为渲染在端侧,云端只传参数流,对带宽的要求和视频流方案完全不是一个量级。这意味着这套东西放到门店大屏、展厅设备上,边际成本非常低。
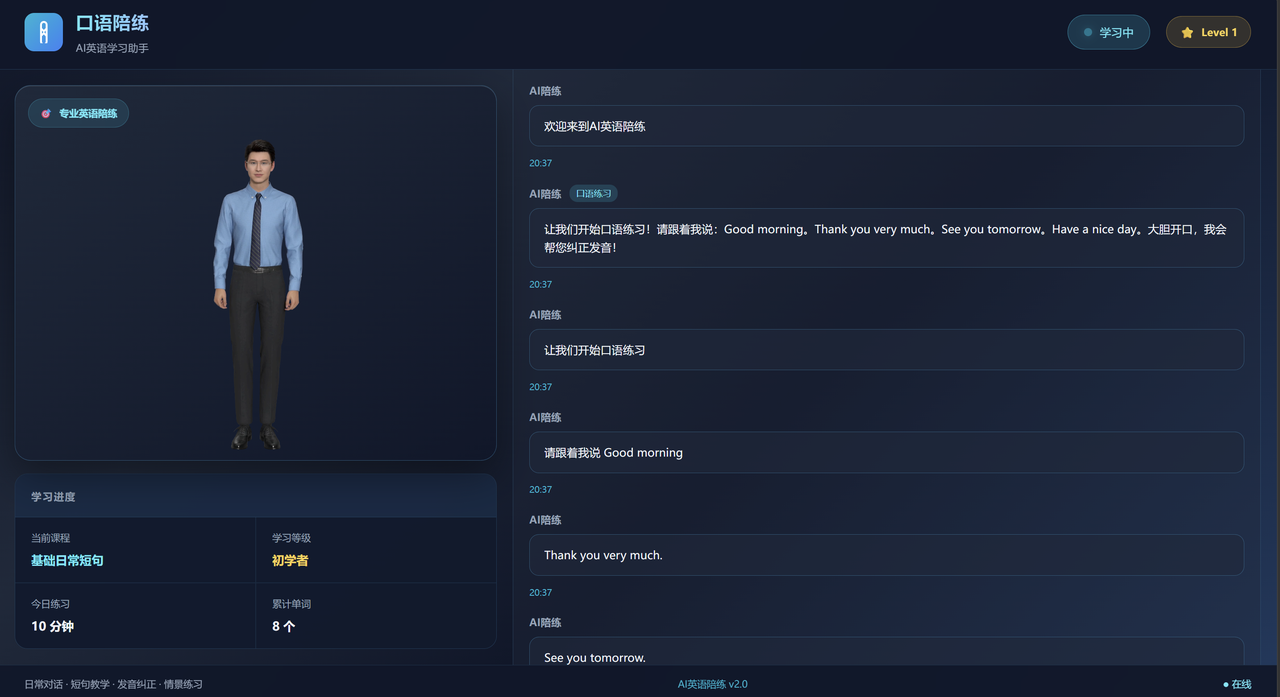
简单日常对话:
五、开发者视角的总结
一周用下来,我的结论是:交互层的成熟度,比我预想的更接近"可规模化落地",而不是"能演示"。
值得说的优点:SDK 接入成本低(一行脚本 + 一次初始化);参数流 + AI 端渲的路线让延迟、并发、成本三个指标同时成立;感知层把 Barge‑in 这种"脏活"做掉了,业务侧只需要关心认知层的配置和情景剧本。
也要提醒两点:纠音能力目前要自己在业务层做(我用的方案是 DeepSeek 按 CEFR 难度分级 + 常见中式发音规则清单,够用但不算智能);另外 SDK 的部分高级配置文档更新快,开发时留意版本。
如果说大模型这两年解决了 AI "会思考"的问题,那这一类具身交互平台真正开始解决的是 AI "能对话"的问题——能被打断、会看场合、有表情的对话,才谈得上陪伴和教学。 口语陪练只是我挑的第一个场景,同样的架构换成门店导购、展厅讲解,改的只是认知层和剧本。
回到平台本身,我最后记住的还是那句话:魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。
最后抛个问题:你觉得 AI 进入真实世界的第一个主入口,会是屏幕里的ai,还是人形机器人?我做这个项目之后的答案是前者——至少在成本降下来之前,"身体"先长在屏幕上的 AI,会先一步走进我们的生活。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献12条内容

所有评论(0)