每天早上 7 点半先开口:用交互做了个AI小晨
文章目录
每天早上 7 点半先开口:用具身交互做了个"小晨"
你的 AI 助手,敢不敢在你开口之前先说话?
一、早晨这个场景,AI 一直是"被动"的
朋友家里有智能屏,装了个语音助手 APP。用了一年多,我发现一个有意思的事实:早晨这个最适合 AI 发挥的场景,AI 反而帮不上什么忙。
不是我懒得问——是整个交互模式就不对劲:
-
它不会先开口。 降温了、今天有会、路上会堵,这些它都知道,但只要你不想起来问,它就永远沉默;
-
它没有身体。 你收到的是一段段文字,或者一个冷冰冰的 TTS 女声,播完就完;
-
它打断不了。 就算它在播报,你想插一句话,也只能等它把一整段念完。
说白了,对话框里的 AI 是回合制的:你不落子,它不动。但真实的早晨不是回合制——你一边刷牙一边想插话,你路过屏幕时希望它看见你,你只想要一句"降温了,加件外套"而不是一份让你自己读的报告。
AI 要进入真实场景,缺的不是更聪明的大脑,而是主动开口的身体、持续在线的耳朵,和能被随时打断的交互。我找了一圈方案,最后选了一套做"端到端具身交互"的 SDK。打动我的不是它宣传页上的能力清单,而是它的思路恰好对着上面三个问题:把感知、理解、表达、行动连成一条完整的交互链路,而不是把几个模块简单拼在一起。
于是我拿它的 SDK 做了个晨间具身交互智能体"小晨",每天早上 7 点半,她自己先开口。这篇文章就是整个项目的技术复盘。
二、同一个早晨,两种 AI
先看两种交互范式的差别(这是我做这个项目时体会最深的):
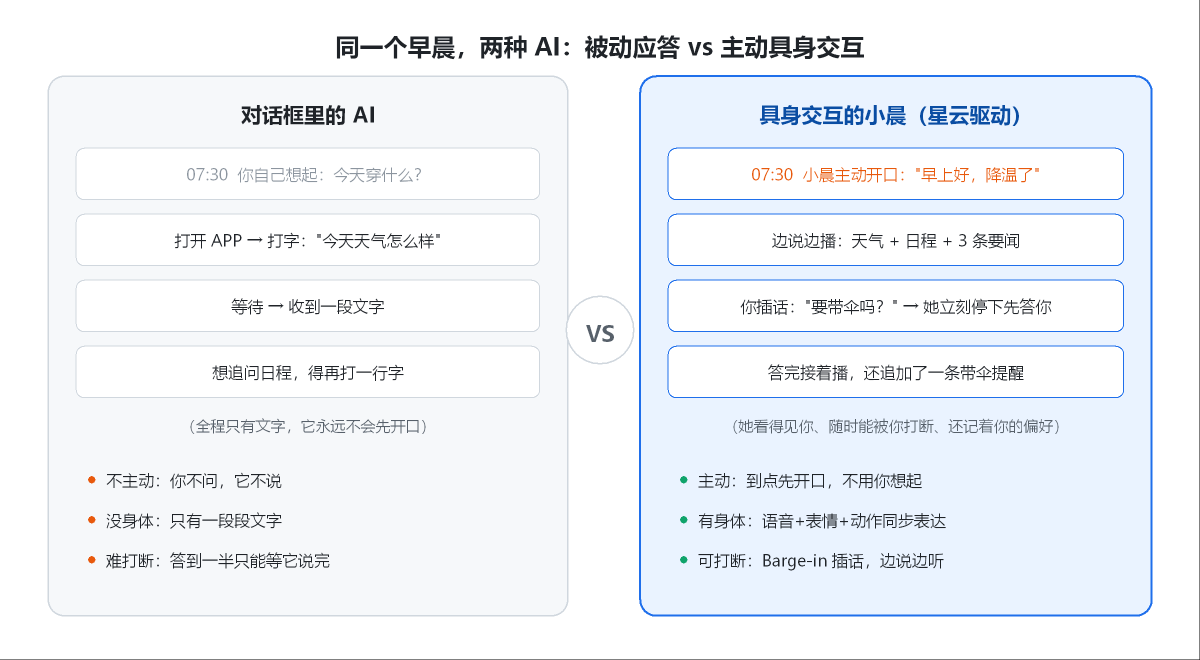
左边是绝大多数 AI 助手的现状:所有信息都在,但交互的发动权永远在你手里——你不问,它不说。
右边是具身交互后的小晨:到点先开口,边说边播,你随时插话她立刻停下先答你,答完还能接着播、追加提醒。
区别不在"她说了什么",而在交互的底层逻辑变了:从"一问一答的两个孤立的回合",变成"一段连着的、可以随时被改写的对话"。用户感受层面,前者是个工具,后者才像个每天和你打招呼的人。
三、小晨的背后:不是"给它接了个身体",是五件事连成了一条循环
动手之前我有个挺天真的想法:做小晨不就是"大模型 + TTS + 一张会动的脸"三件套拼一下吗?
真跑起来才发现,一个能在早晨主动开口、还能被人随时打断的智能体,背后至少有五件事在同时运转:多模态感知 + 专属智脑 + 多模态表达 + AI 端渲 + 数字与物理行动。这五件事再通过 Real-time Interaction Runtime 连成一套完整系统——这才是我理解里的端到端具身交互智能:AI 进入屏幕、机器人之后,不只是把大模型的回答"搬"到一个终端上,而是要能持续感知、理解、表达并行动。
下面按我实际踩到的顺序,一件件说。
3.1 多模态感知:她敢先开口,靠的不只是定时器
我最初的实现特别朴素:setInterval 到 7:30,调一次 LLM,念出来。跑了两天自己都嫌烦——我在洗手间,她在客厅念;我出门了,她还在念。
问题的关键在于,多模态感知要解决的不是"听清一句话",而是持续知道现场正在发生什么。
改了之后小晨的触发条件变成两个:时间到了,外加摄像头感知到有人进入交互范围。视觉侧那一路是主动交互的开关:有人走近时,AI 能通过摄像头感知到有人进入交互范围,并由此触发主动交互。这件事听起来小,但它是"被动助手"和"会打招呼的人"之间的分水岭——前者只能等指令,后者会挑时机。
语音侧的那一路,才是决定"我能不能随时插话"的地方。SDK 在语音侧做了一整层感知处理:算法降噪、AEC / 抗回声、本体声音抑制、VAD、ASR、远场语音,以及 Double Talk / Barge-in 智能打断。这几个词摆在一起才看得懂:真正的难点不是"听见",而是在她自己正在说话的时候,怎么听见我。
系统既不能把她自己的扬声器声音误识别成用户,也不能因为 AI 正在表达就听不到真正的用户输入。所以它需要连续地做一串判断:
判断真实用户声音 → 去除本体回声 → 区分噪声、咳嗽、Backchannel 与真实插话 → 检测有效打断 → 停止当前表达 → 持续接收用户完整输入 → 进入新一轮交互。
我在测试时故意试了几种"假插话":清嗓子、说"嗯嗯"、走过屏幕旁边聊天。小晨都不停——因为她区分了 Backchannel 和真实插话。只有我明确问她一句"要带伞吗",她才会停。这个区分做不好,实际用起来就是一场灾难:她会一直被我自己的语气词打断,播报永远播不完。
一句话总结这一层:感知是持续的,不是一次输入。
3.2 专属智脑:让智能体知道"我是谁、知道什么、今天该说什么"
这一层是我做完小晨之后,回头看觉得最被低估、也最值得展开讲的一层。
我一开始的认知特别浅:不就是往 System Prompt 里塞一句"你是小晨,一个温柔的晨间播报员"吗?后来才琢磨明白,通用大模型和专属智脑解决的是两个完全不同层面的问题——大模型解决的是"我能不能回答这个问题",而智脑这一层还要解决"我是谁、我代表谁、我掌握哪些知识、当前任务是什么、下一步该调用哪个系统"。
说白了,就是把通用模型变成一个真正属于某个企业、某个品牌、某个岗位,或者某个具体的人的智能体。它要落三层事。
第一层:它知道什么——知识底座不是"把资料传进去"那么简单
小晨的信息源其实很杂:家庭共享日历(表格)、公司 OA 日程(结构化字段)、天气接口、3 条新闻(还带音频)、我订阅的行业简报(PDF)。一开始我的做法很粗暴——全部转成文本塞向量库,结果她念出来的东西经常是断的。
查了资料才搞清楚差在哪:全模态数据解析不只是支持 PDF、Word、PPT、图片、音频、表格这些格式,更重要的是解析过程中会同时保留资料里的层级关系、图文关系、表格关系、说话人信息和上下文。
这不是"转成文字"和"转得更好"的区别,是有没有信息的问题。举两个我实际遇到的:
-
一份简报 PDF 里的数据表格,孤零零转出来是一串没有主语的数字;但如果保留了"表格关系 + 上下文",智脑知道这行数字对应的科目是什么,播报时才不会说成"上升了 12%"却不知道是什么上升了 12%;
-
一段新闻音频,说话人标注本身就是信息。谁在说、是主播转述还是受访者原话,直接决定我该不该把它当成一条要闻念出来。
再往上是知识图谱 + RAG 深度融合:不是只在资料里找"最相似的一段文字",而是进一步把文档中的实体、概念和关系组织起来,让 AI 从"找到一段话"升级为"基于关系组织答案"。底层结合向量语义、关键词和知识图谱进行召回,面对跨资料、跨知识点的问题时,不只是命中某个片段,而是能把多个相关知识连接起来。
落到早晨这个场景,这个差别特别直观。我的三条信息本来是散的:
-
日程里写着"周三 9:00 客户拜访,地点浦东";
-
天气里写着"周三上午浦东有雨,降水概率 80%";
-
聊天记录里我提过一句"伞放公司了"。
普通 RAG 最多捞出"浦东""有雨"这两条。而带上关系组织之后,智脑能顺着"人 → 行程 → 地点 → 天气 → 通勤"这条链,把小晨的话组织成:“周三上午浦东有雨,拜访客户记得早点出门;伞你上周放公司了,出门前可以从工位拿。” 这就是"找到一段话"和"基于关系组织答案"的差距。
第三项是高效知识治理,我原本以为这是企业才需要的东西,结果自己先踩了坑。小晨的播报优先级我改过一版:从"日程→天气→新闻"改成"先安全提示(恶劣天气、限行)→ 再日程 → 最后新闻"。改完当天她播报还是老顺序——旧索引里的内容还在往外冒。**知识不是一次建完就不变,真正重要的是在资料持续新增、修改和废止之后仍然保持准确。**这就是知识治理要处理的事:围绕知识块、标签、实体、关系、向量索引和来源信息持续维护,让资料变了之后,检索结果和问答结果跟着一起变。
第二层:它是谁、当前要做什么——把"播报员"写进认知,而不只是写在提示词里
专属智脑不只是"知道内容",还要知道自己代表谁、服务谁、遵循什么规则、当前要完成什么任务。可配置的内容包括:身份、人设、角色、任务、规则、音频、Agent、Workflow、对话流程和工具调用。
这几项配完之后,智能体才真正开始具备岗位化、场景化、流程化的工作能力——它不再只是"会回答",而是知道自己现在是个晨间播报员,知道今天这一轮要先说什么、说到哪里算完、被打断之后该怎么接回去。具体我怎么配的,放在第 5.2 节,那里有一段我踩过的真实坑。
第三层:它能不能真正进入业务
第三层是我做家庭 Demo 时用不到、但调研时觉得最有想象力的部分:专属智脑最终不是停留在对话层,而是要能进入企业真实业务流程,可连接 CRM、ERP、OA、HIS、BI、商品系统、订单系统、客户系统、门店系统、IoT 以及第三方 Agent。
家庭版的小晨没有业务系统可接。但把同一套认知层放到企业场景,逻辑立刻就通了:如果是给销售团队做的晨会播报智能体,那句"今天有 3 个客户回访到期",就可以是实时从 CRM 里查出来的;播报完还能顺手触发跟进任务、把结果回写进系统。AI 不再只是生成一个答案,而是可以结合业务系统完成查询、协同、触发和流程推进。
还有一点对我这种个人开发者很友好:大模型可以自选——我用惯了通义千问就继续用,没有偏好的话也可以直接用平台自带的智脑。我这次正好是这么分工的——内容生成继续跑通义千问,而身份、知识、任务、流程、工具这些"智脑该管的事"交给平台,两者不冲突。
一句话总结这一层:从"通用回答能力",变成"面向具体身份、岗位和业务的智能体能力"。
3.3 多模态表达:不是 TTS 播放,是实时生成统一、连续、同步的具身表达
真实的人际交流,从来不只有一句话。语言之外,还有声音、语气、情绪、节奏、停顿、眼神、表情、头部动作、手势和身体动作。
所以我用的这套表达层并不是简单的 TTS + Lip Sync。系统会依据当前的语言、用户状态、智能体角色、情绪、场景以及当前交互状态,实时生成并驱动语音、口型、情绪表情、眼神、头部动作、手势和身体动作。
这里有两个区别我是在实际对比之后才真正体会到的。
第一,不是预制播放,而是根据上下文实时生成。 小晨的手势不是从几个预设动画里随机抽卡的。播到具体数字和数据时我用 SSML 注入 Explain 动作,她做出讲解手势;开场 Hello、收尾 Goodbye——动作和内容是对得上的。播报内容每天都不一样,靠预制动画很难做到这一点。
第二,表达和感知不是前后两个独立阶段。 这是和小晨交互时最明显的一个感受:她在说的时候,耳朵还开着。我插话"要带伞吗",她停下来答完,眼神转回来继续播——整个过程不是"动画被打断、切了个镜头、再切回来",而是表达中断之后立刻进入了新的表达。
一句话总结这一层:统一、连续、同步,而不是语音、表情、动作各自播放。
3.4 AI 端渲:为什么百元级芯片的智能屏也跑得动
这一层解决的不是"画面好不好看",而是一个更底层的工程问题:实时交互能力能不能真正低成本、低延迟、稳定地部署到大量终端。
传统云端渲染要持续依赖云 GPU,再通过网络把视频流传到终端。我用的这套方案走的是另一条路:端侧实时渲染——3D 画面在终端本地渲染,云端只下发驱动参数(参数流),不传视频流。落到我自己的项目上,实际拿到的好处有这几条:
-
云侧成本压下来了:不用为每台终端持续烧 GPU 算力;
-
带宽占用小:传的是驱动参数,不是高清视频流;
-
延迟更低:就近渲染,交互链路更短;
-
弱网也能跑:我特意用手机热点试过,会卡但不会断;
-
并发不再被云端渲染资源卡死:设备越多,这条优势越明显;
-
对终端芯片要求低:我那块百元级芯片的卧室智能屏就是活证据。
也是因为这条链路,端到端延迟做到了 ≈500ms——她开口几乎没有延迟感,云侧成本低,还能撑高并发。
回头看,端渲和 Runtime 不是两个孤立的功能点,它们是前面感知、智脑、表达、行动四件事能在终端上真的跑起来的底座。一个 Demo 能跑,不代表一套能力可以大规模落地;如果每台终端都持续依赖云 GPU 和高清视频流,设备越多,成本、带宽、并发和稳定性的压力就越大。
3.5 数字与物理行动:从"生成答案"到"真的做出来"
真正的智能体进入业务场景,不只是"能回答问题",还需要把回答表达出来、互动起来,并呈现在真实终端上。这分成两层:
-
数字行动:常见智能体的输出主要是文字——用户提问,智能体给一段答案。具身交互在屏幕端进一步补上了表达层:不仅能生成内容,还可以通过语音、口型、表情、手势和身体动作实时完成表达。从"生成了一段答案",变成"把答案自然地说出来、演出来、表达出来"。小晨就落在这里。
-
物理行动:当智能体进入机器人以后,行动进一步延伸到物理世界——转向用户、靠近用户、移动、导航带路、跟随指示、上肢动作、Robot Skill,以及与物理环境的交互。如果小晨将来上了机器人,"7 点半叫你起床"可能会变成走到床边先开口。
所以屏幕和机器人并不是两套不同的智能能力,而是同一件事的两种形态:同一个智能体获得表达与行动能力之后,可以根据不同终端形态,在屏幕或机器人上完成现实场景中的交互。
换成一个我更喜欢的说法:同一个智能体,可以拥有不同的身体;智能体持续存在,身体不断升级。
四、端到端不是拼接:一条不退出的循环,加一套可插拔的组件
4.1 不是 ASR → LLM → TTS,而是 Continuous Interaction Loop
这里必须说清楚一件事,因为它最容易被误解。
传统方案往往是:ASR → LLM → TTS → 屏幕 / 机器人。各个模块单独都能工作,但到了连续的人机交互中,就会出现状态不同步、响应链路变长、表达与用户当前状态脱节的问题。
**问题不在于这些单项技术不好,而在于它们之间缺少统一的状态管理。**ASR、LLM、TTS 这些能力本身都很重要,也都在快速进步,我完全没有否定它们的意思——真正进入持续的人机交互,需要的是把它们围绕一次完整的用户交互连接起来。
我用的这套 SDK 不是简单把几个模块连起来,而是围绕一次完整的人机交互设计整个系统,形成:
持续感知 → 持续理解 → 持续决策 → 持续表达与行动 → 持续反馈
也就是 Continuous Interaction Loop(持续交互循环)。
一句大白话解释:不是"你问一句,它答一句",而是 AI 一边和你交流,一边继续听、继续看、继续判断接下来应该怎么回应和行动。
落到小晨身上,每一环都有具体的早安场景:
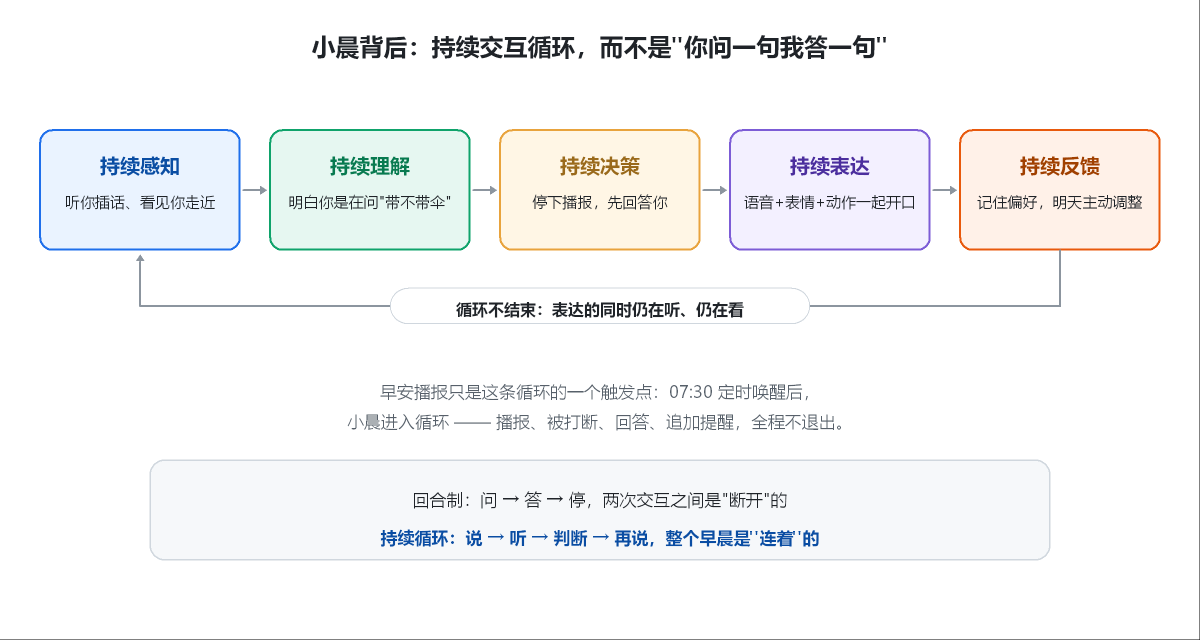
我最看重的是"循环不退出" 这件事。传统方案里,“播报"和"对话"是两个割裂的状态:播报时听不见你,对话时不播报。而小晨在说的同时仍然在听——你插话"要带伞吗”,她停下播报先回答,答完接着播剩余日程。整个过程没有"重启对话"这个动作,因为循环从来没退出去过。
先在控制台里小晨的形象配置页(人设、声音、任务设定)
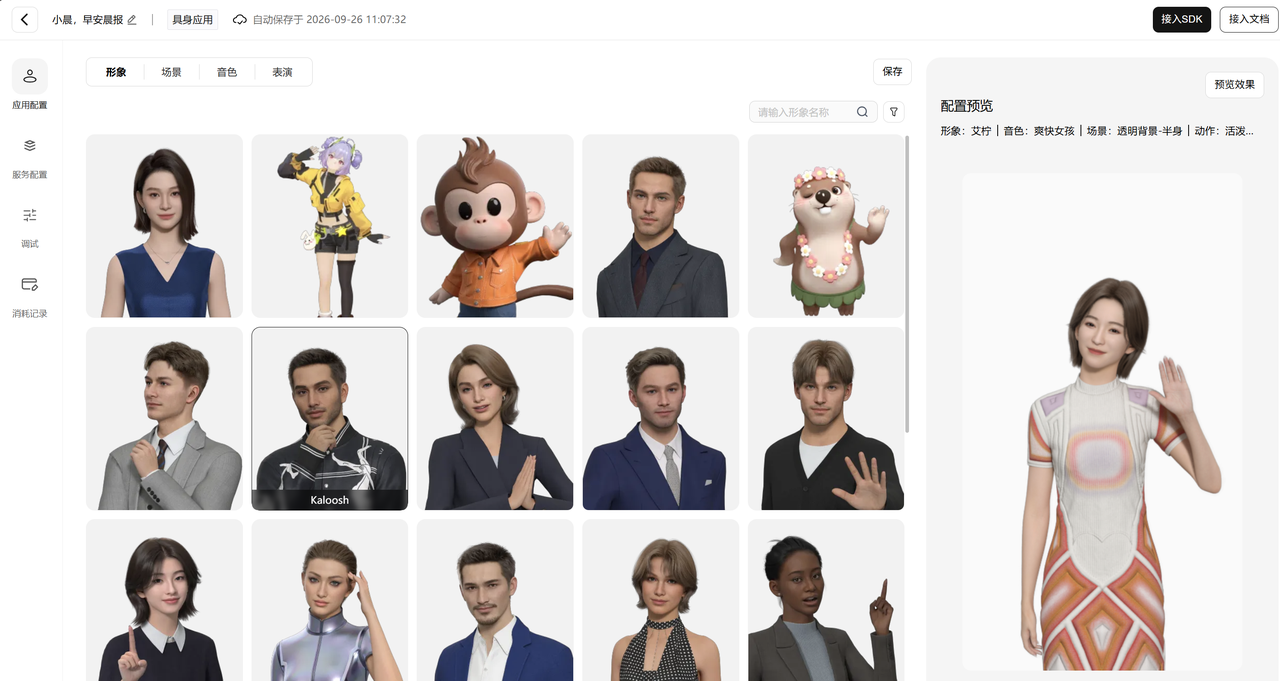
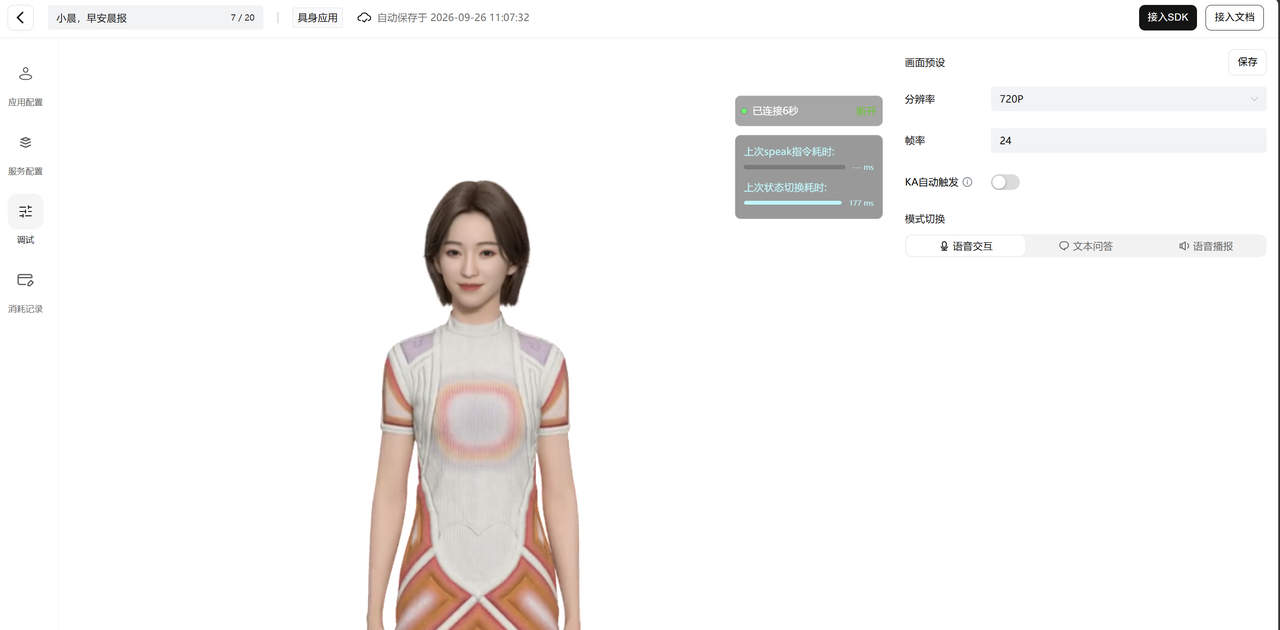
下面是 Continuous Interaction Loop 的架构流程图,把五个环节和它们对应的技术组件串起来看更直观:
4.2 可插拔组件:换掉一个模块,交互不能散架
文档里"模块支持可插拔"这句话,我第一遍读得很快,后来才意识到它说的是件挺硬的事。
先明确一点:可插拔并非简单的 API 拼接。感知、认知、表达与执行之间存在紧密的时序依赖与状态关联——比如换了 ASR,语音事件的到达时序就变了,如果表达层还在按老节奏等文本,播报就会错拍。
它的做法是通过标准化的接口契约与统一的状态管理机制,确保模块替换之后,事件流转、会话状态、时间同步与异常处理仍然保持一致,端到端交互体验不受影响。
对这个项目来说,可插拔最实际的价值是**“不被单一供应商绑死”**:智脑这一块我正好是在自研和第三方 LLM 之间做选择,语音音色也能按风格换。而对做企业项目的团队更有意义——有些数据必须私有化,有些模型栈已经定了,可插拔意味着这些都用不着推翻重来。
下面这张图把可插拔的机制画出来了:感知、认知、表达、行动四个模块都通过标准接口契约接入,由统一状态管理负责事件流转、会话状态与时间同步,替换任意一个模块都不会让整条链路散架。
以替换 ASR 为例:新的 ASR 接入后,语音事件的到达时序可能变化,但统一状态管理会重新对齐事件流转与会话状态,表达层不会因为等文本而错拍;替换 LLM 时,认知层通过标准接口契约只换模型实现,事件流转与状态同步路径保持不变,端到端交互体验不受影响。
五、动手实现:两个 service,一条调用链
小晨的工程实现不复杂,核心就是两个单例 service,一条"先问大模型、再让具身交互智能体开口"的调用链:
在这里插入图片描述
几个关键设计决策:
-
智脑用通义千问 qwen3.8-max(走阿里云百炼的 OpenAI 兼容接口,换成 DeepSeek 等其他模型也只是换个 baseURL 的事,这套可插拔架构不挑大模型):负责组织播报稿、维持小晨人设;
-
播报素材是普通的三件套:天气、日程、3 条要闻,再加一句结尾的正能量寄语;
-
表达交给 SDK:SDK 动态加载,云端表达引擎用参数流驱动形象(传的是驱动参数而不是视频流),配合 AI 端渲 + 端侧解算把渲染下沉到终端——这也是为什么卧室智能屏这种百元级芯片也能跑,且端到端延迟 ≈500ms,云侧成本低、可高并发。
所用大模型:通义千问 qwen3.8-max(阿里云百炼);AI Coding 工具:Claude Code(负责生成前端骨架和调试)。
5.1 两个 service 的关键代码
下面是项目里两个 service 的关键代码(凭证已脱敏),核心逻辑一目了然:
① llm.service.js —— 负责"说什么":
// src/services/llm.service.js(节选)
import OpenAI from 'openai'

class LLMService {
  constructor() {
    this.openai = new OpenAI({
      apiKey: 'sk-xxxx', // 替换为你的百炼 apiKey
      // 经 Vite 代理转发到阿里云百炼,绕过浏览器跨域(SDK 要求绝对地址)
      baseURL: window.location.origin + '/llm-api/compatible-mode/v1',
      dangerouslyAllowBrowser: true,
    })
  }

  async sendMessage(userMessage) {
    const completion = await this.openai.chat.completions.create({
      model: 'qwen3.8-max',
      messages: [
        { role: 'system', content: XIAOCHEN_PROMPT }, // 小晨人设,见下文
        { role: 'user',   content: userMessage },
      ],
      temperature: 0.7,
      max_tokens: 900,
      enable_thinking: false, // 关键:关掉思考过程,播报只含正文
    })
    return completion.choices[0].message.content
  }
}
export default new LLMService()
小晨的人设写在 system prompt 里,这段"角色卡"决定了她每天怎么说:
你是「小晨」,一位贴心的晨间播报员:25-30 岁的亲和女性,
穿浅色休闲西装,气质清爽专业……
你每天用一段话播报今日天气、日程提醒和 3 条精选新闻,
语气温暖有活力,结尾送上一句正能量寄语。
② xingyun.service.js —— 负责"怎么说、怎么演":
// src/services/xingyun.service.js(节选)
const SDK_URL =
  'https://media.xingyun3d.com/xingyun3d/general/litesdk/xmovAvatar@latest.js'

async initSDK() {
  // 动态加载 LiteSDK,拿到 window.XmovAvatar
  if (!window.XmovAvatar) await this.loadSDKScript()

  this.sdkInstance = new window.XmovAvatar({
    containerId: '#avatar-container',
    appId: '你的 AppID',
    appSecret: '你的 AppSecret',
    gatewayServer: 'https://nebula-agent.xingyun3d.com/user/v1/ttsa/session',
    // 字幕/背景由前端自行渲染:onWidgetEvent 是全量接管模式
    onWidgetEvent: (data) => {
      if (data.type === 'subtitle_on')  this.onSubtitle?.(data.text)
      if (data.type === 'subtitle_off') this.onSubtitleEnd?.()
    },
  })

  await this.sdkInstance.init({ /* 资源加载进度 / 错误 / 关闭回调 */ })
}

// 让具身交互智能体说话:isStart / isEnd 控制一段话的起止
speak(text, isStart = true, isEnd = true) {
  this.sdkInstance.speak(text, isStart, isEnd)
}

// 播报数据时注入手势:SSML 的 ue4event 动作语义
speakWithAction(text, action = 'Explain') {
  const ssml = `<speak><ue4event><type>ka</type>
    <data><action_semantic>${action}</action_semantic></data>
  </ue4event>${text}</speak>`
  this.speak(ssml)
}
代码量不大,但有三处我踩过坑,值得提前说:
坑一:LLM 请求的跨域问题。 百炼走 OpenAI 兼容模式,浏览器直连会被跨域拦住,而 SDK 又要求 baseURL 必须是绝对地址。解法是在 vite.config.js 里加一条代理,把 /llm-api 转发到百炼域名,前端拿着自己 origin 的"绝对地址"就绕开了限制:
// vite.config.js(节选)
server: {
  proxy: {
    '/llm-api': {
      target: '阿里云百炼兼容模式域名',
      changeOrigin: true,
      rewrite: (p) => p.replace(/^\/llm-api/, ''),
    },
  },
}
坑二:并发驱动槽被占。 星云同一形象的驱动会话有并发限制——如果页面关闭/刷新前不销毁实例,下次进来会发现"上一个会话还挂着",连不上。所以我在构造时就挂好 beforeunload,退出前统一 destroy(),这是很多 Demo 不会告诉你但上线必踩的坑。
坑三:思考过程混进播报稿。 qwen 系列默认可能带思考输出,播报稿里会混入一段"分析过程",具身交互智能体照着念就穿帮了。百炼参数 enable_thinking: false 一关,回复只剩正文,播报语气立刻干净。
5.2 把专属智脑真正配成"小晨"
第 3.2 节讲的是这一层"是什么",这里说我是怎么配的,以及一个必须说出来的踩坑。
先说结论:把身份、规则、任务、流程、工具这几样从 System Prompt 里挪出来,放进智脑配置层之后,小晨的稳定性肉眼可见地变好了。
我一开始图省事,把所有东西都塞进 system prompt——人设、播报结构、优先级、禁忌词、要调哪几个接口,一坨全写在一起。头两天没问题,第三天开始飘:
-
播报结构会丢。说好"天气→日程→新闻→寄语"四段,某天开始只播天气和新闻,日程直接跳过;
-
人设会漂。她开始用书面语,冒出"根据您提供的信息""以上是为您整理的今日资讯"这种句子,晨间播报员的味道全没了;
-
规则会顾此失彼。我同时写了"要详细"和"要简短"两条约束,轮次一多,模型开始随机重视其中一条。
后来我按专属智脑的配置项把职责拆开,prompt 里只留"语气和风格",其余交给配置层:
拆完之后,那三个飘的现象基本都收敛了。我的理解是:上层的"怎么说"是风格问题,下层的"我是谁、做什么、先做哪一步"是认知和流程问题——风格放 prompt 里灵活调整没问题,但认知和流程放在 prompt 里,就会随着上下文变长被稀释掉。这也是为什么我会说,专属智脑不是"更长的提示词",而是另一层东西。
六、实测:7 点半的那 90 秒
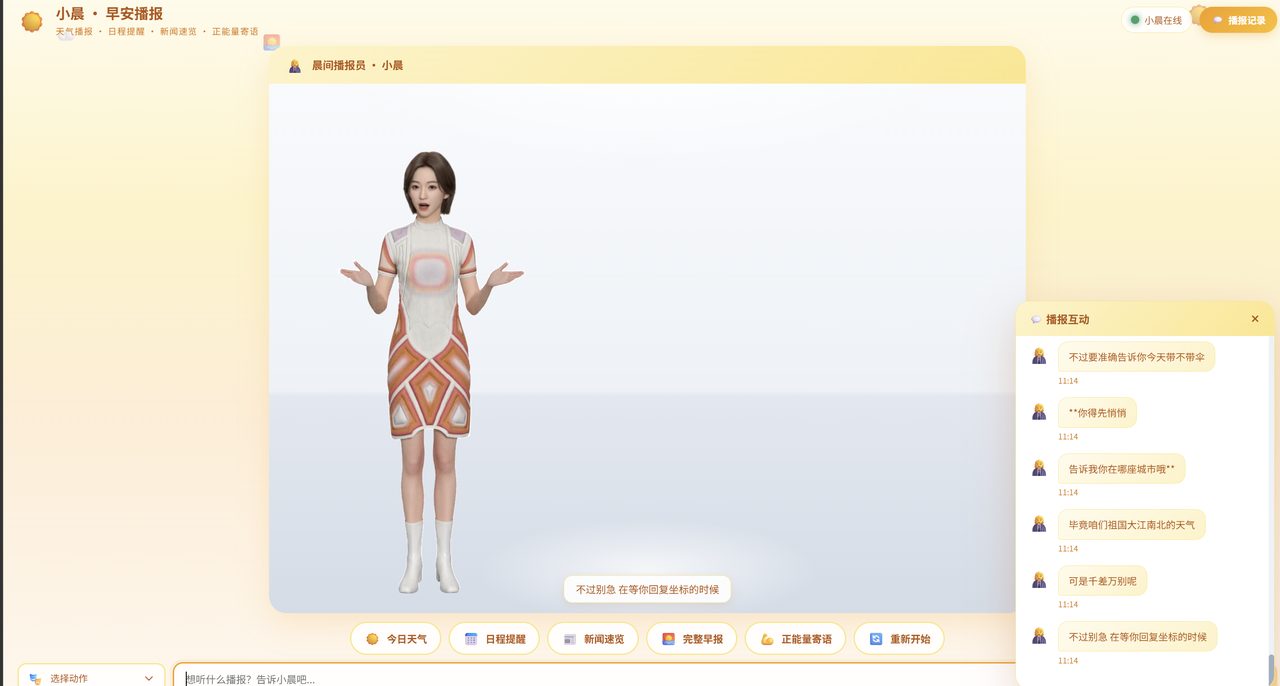
跑通后的完整链路如下(时间点均来自实际测试):
两个体感细节:
-
打断的响应速度。 我在她播天气时插话"今天要带伞吗",几乎是零等待——她停下来,眼神转向我,答完"建议带伞,中午有雨"之后自己接上了刚才没播完的日程。这个"接上"的动作很关键,它说明循环真的没退出,而不是重新开始了一次对话;
-
500ms 是什么概念。 参数流 + AI 端渲的链路下,她开口几乎没有"具身交互智能体那种延迟感",口型和表情是跟着语音同步出来的,不是先出声再对口型。低延迟、低成本、可高并发这三件事,在这里是同一套架构带来的;
-
手势跟着内容走。 播到具体数字和数据时,我用 SSML 注入
Explain动作,她做出讲解手势;开场Hello、收尾Goodbye——一分钟的播报里,动作不是随机抽卡,而是和内容对得上的。字幕也没有用 SDK 默认样式,onWidgetEvent把subtitle_on转给前端,字幕条和播报节奏完全同步。
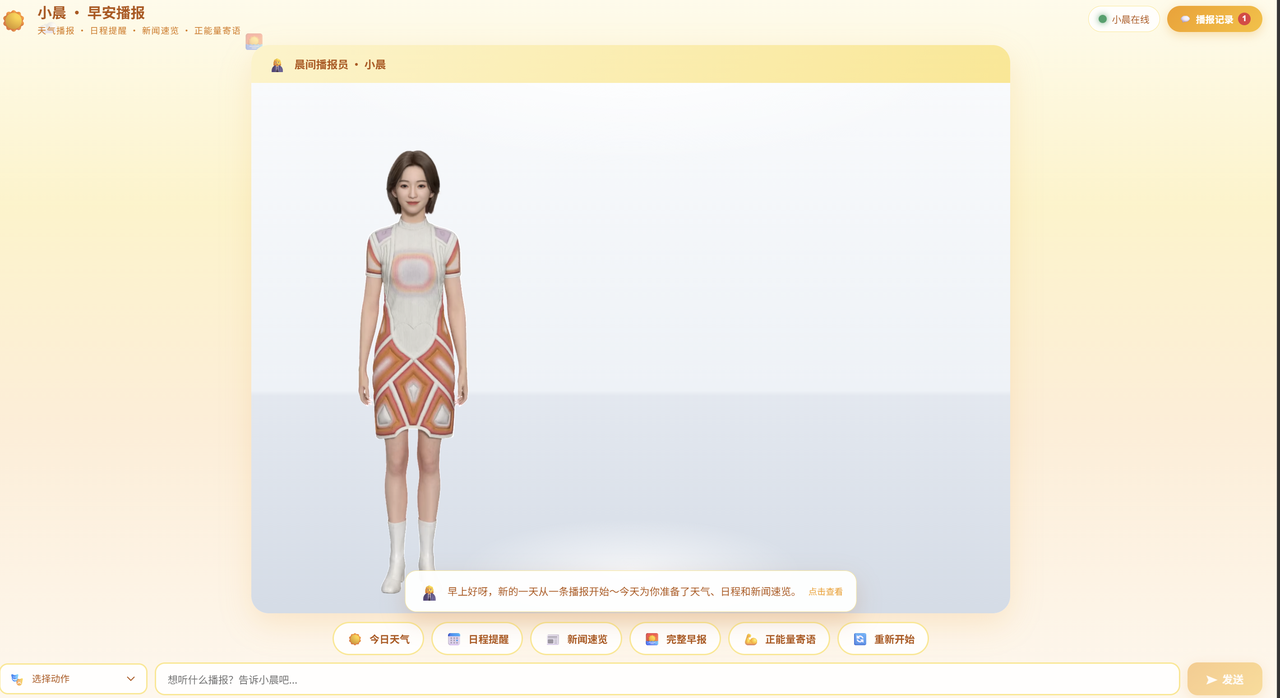
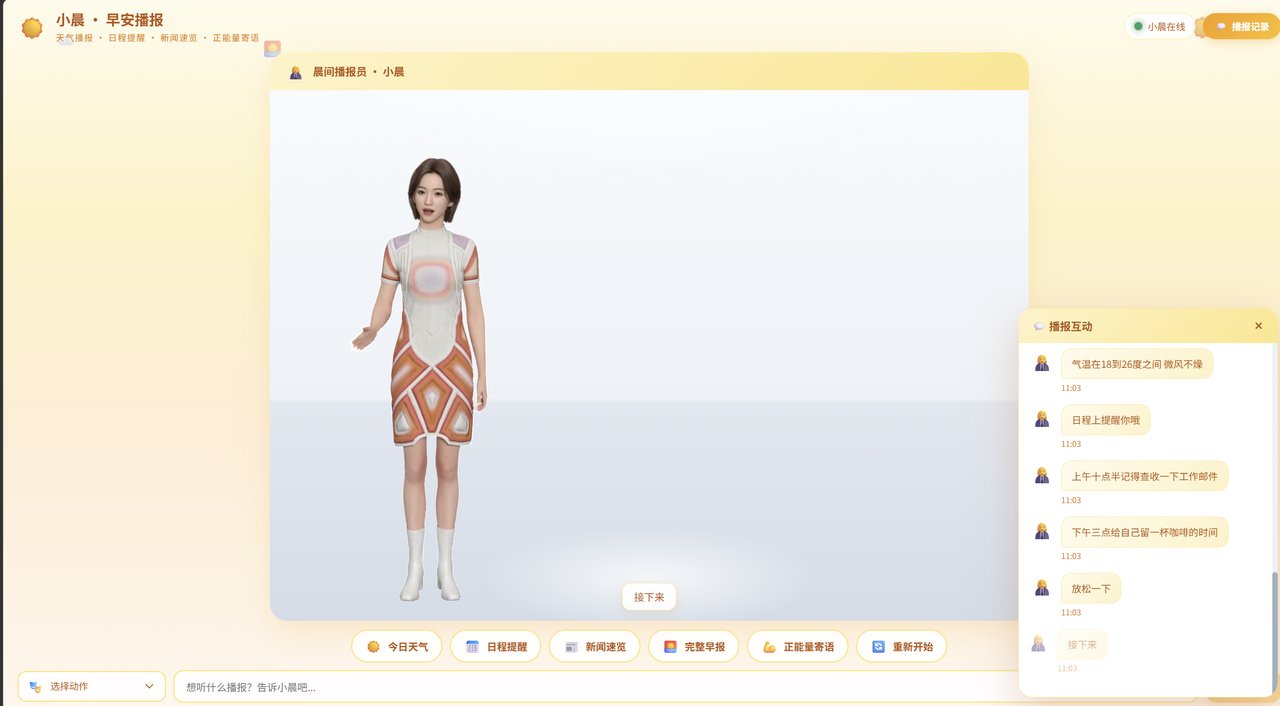
小晨播报时的运行时的口型/表情清晰可见
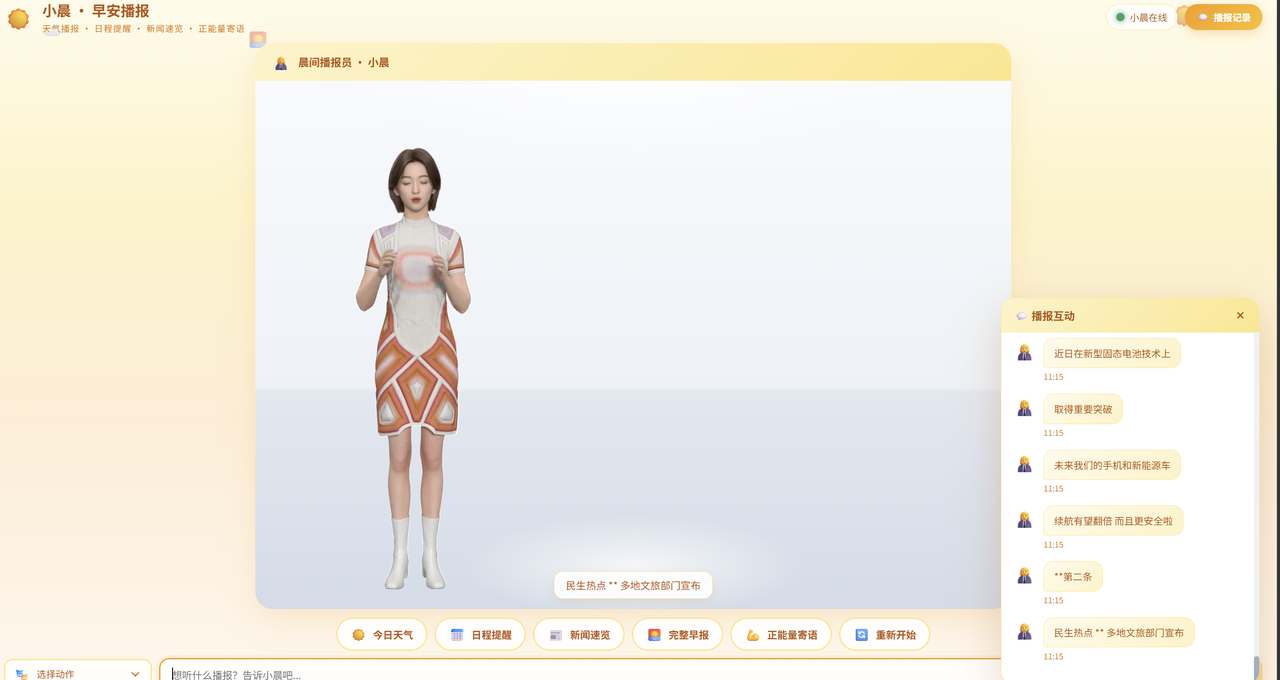
还有一层是图上看不出来的:这套小晨是"一套代码、多种身体"。同一份智能体配置,今天跑在卧室智能屏上,明天可以跑在车机里(通勤路上接着聊)、大堂大屏上,甚至人形机器人身上——身份、记忆、任务持续复用,身体不断升级。
七、写在最后
做完这个 Demo,我对"AI 走出对话框"有了更具体的理解:具身交互的价值,不是给聊天记录加一张会动的脸,而是把交互的发动权、节奏控制权交还给 AI 和用户双方——她可以先开口,你可以随时打断,循环始终在线。
这个项目里真正花时间的是把感知、智脑、表达这几层的职责想清楚、拆开来配。回过头看,五件事里最容易被低估的就是智脑那一层——提示词写得再好,也替代不了一个可治理、能进业务的认知层。
早安播报只是这条循环最日常的触发点。同样的架构,换成"到点提醒吃药"“下班前汇总待办”“孩子放学主动问今天怎么样”,都是成立的。
最后留个问题:你希望家里的 AI 每天早上先对你说什么?是天气、日程,还是别的什么?评论区聊聊,说不定下一个 Demo 就做它。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献12条内容

所有评论(0)