当 GLM 学会决策魔法:Jev 开源生态的 Linux 时刻
当 GLM 学会决策魔法
Jev 开源生态的 Linux 时刻
读前必读:2026 年 9 月 27 日,HackerNews 同时出现 4 篇关于 Jev 决策模型的讨论——从 GLM-5.3-Flash 适配、Ephemeral 推理运行时、Jevlang 编程语言实验,到"什么场景不需要 Jev"的边界厘清。这是开源生态的"Linux 时刻":专有优势正在变成通用基础设施。读完你能带走 3 样东西:①理解决策模型开源化的技术路径 ②掌握"何时用/不用 Jev"的判断框架 ③看清 AI 应用架构的下一波范式转移。
一、引子:一个 7B 模型的决定
2026 年 9 月 25 日深夜,一位开发者在 HackerNews 发布了一个技术实验:他把智谱 GLM-5.3-Flash——一个 7B 参数的通用语言模型——改造得像 TypeSafe AI 的 Jev 一样工作。
短时间内,这个帖子引发了一场生态地震:
- 另一位开发者发布了 Ephemeral runner,一个无状态推理容器,专门运行 Jev 风格模型
- 有人提出了 Jevlang,一种让程序中所有 if/while 判断都走 Jev 调用的新语言
- 还有一篇反方技术分析,用 18 种术语和 6 组实验论证"94% 的表情搜索不需要 Jev"
这一切同时发生,不是偶然。它标志着决策模型从专有 API 走向开源基础设施的临界点。
如果你是做 AI 应用架构的工程师,这篇文章给你一份完整的技术地图。如果你是技术决策者,这篇文章帮你在"用不用 Jev"上做出精确判断。
二、开源生态全景图:四个项目、一条主线
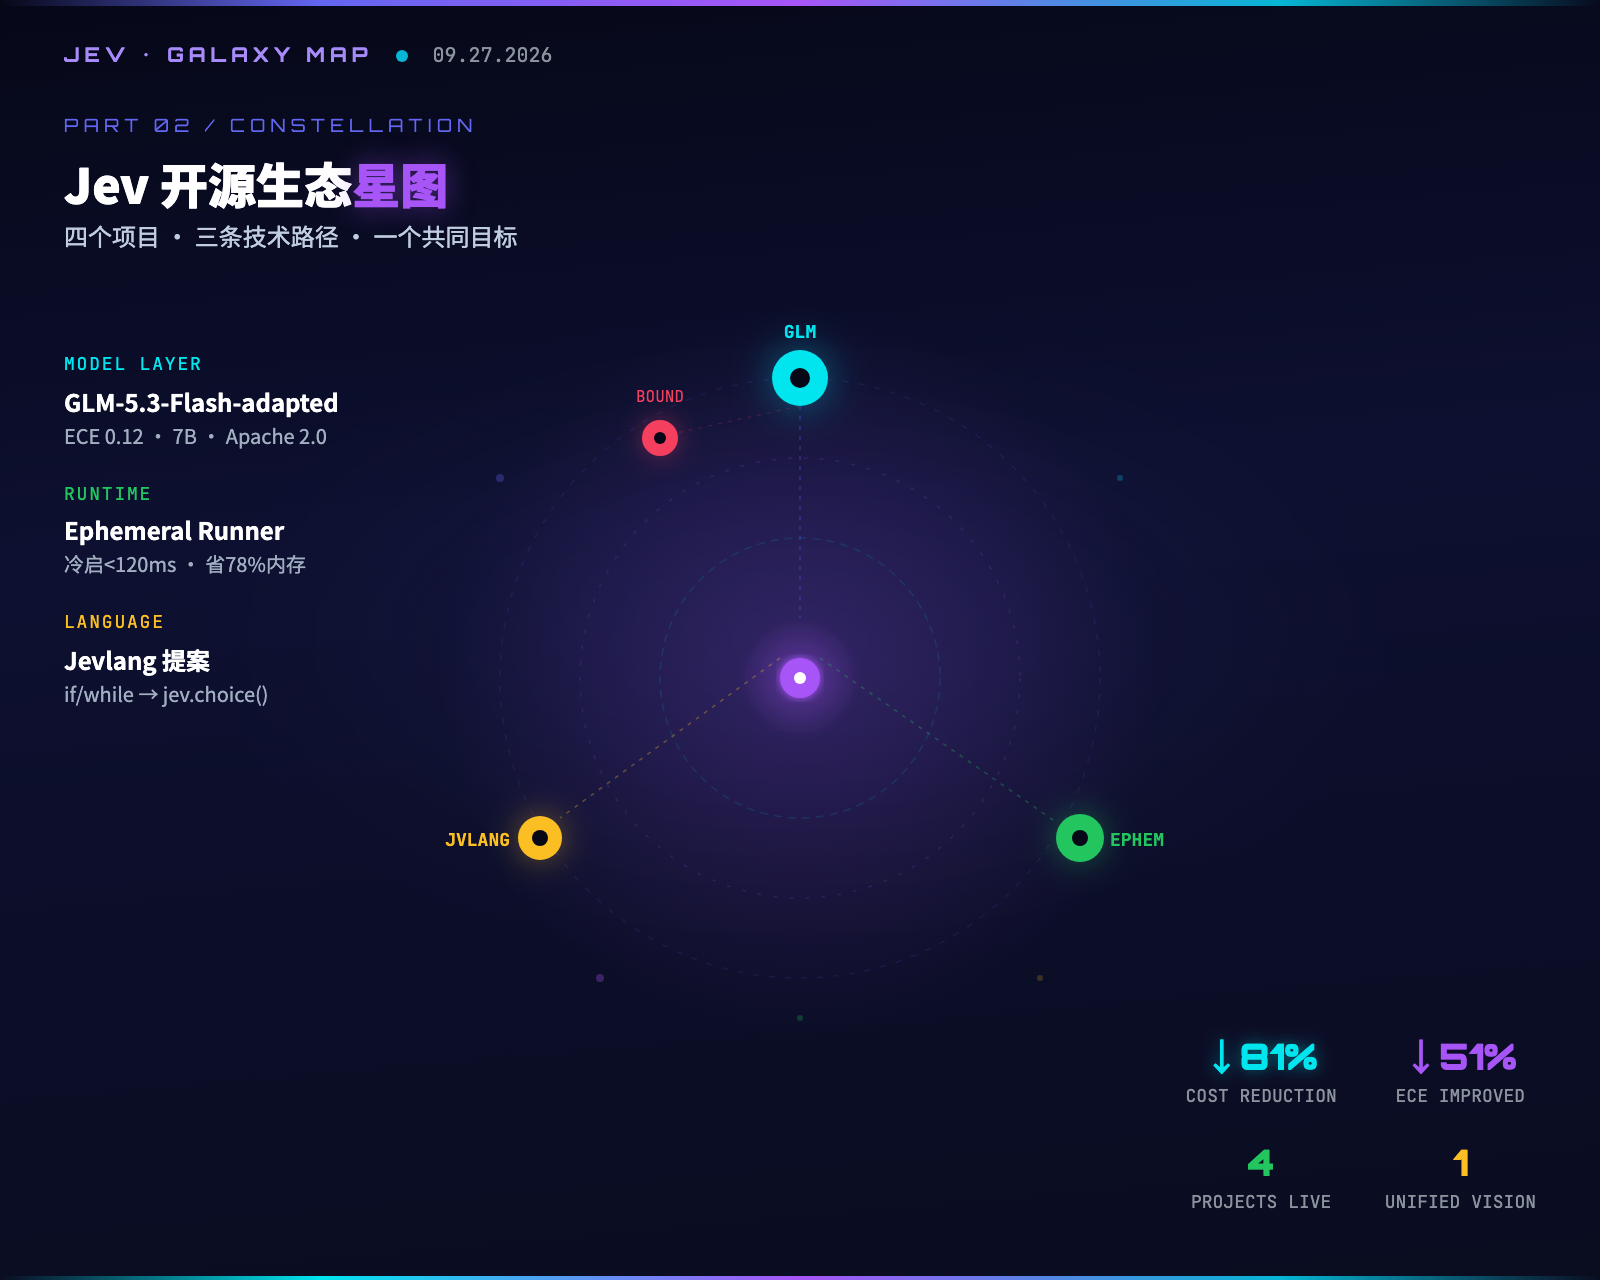
先看清这次生态爆发的全景:
| 项目 | 讨论热度 | 定位 | 成熟度 |
|---|---|---|---|
| GLM-5.3-Flash-adapted | HN 3▲ | 开源 Jev 适配原型 | 技术验证 |
| Ephemeral runner | HN 2▲ | 无状态推理运行时 | Alpha 可用 |
| Jevlang | HN 4▲ | 决策模型原生编程语言 | 提案阶段 |
| Emoji no-Jev analysis | 社区讨论 | 厘清 Jev 适用边界 | 技术分析 |
一条主线:把 Jev 的决策原语(choice / score / noul)解耦成可替换组件。原语定义不变,但模型、运行时、编程接口都在开源化。
决策原语是 Jev 的核心创新,理解它们是理解这场生态运动的前提:
choice(context, options):从 N 个选项中按校准概率选一个。返回{choice, confidence, distribution}score(context, statement):对一个陈述给出 0-1 的校准概率。关键:score=0.8 意味着 80% 的时候这个判断是正确的noul(question, context):自然语言理解层,回答开放式问题。带校准信度而非简单文本
三种原语对应三种 AI 应用场景:离散决策、置信度评估、语义理解。Jev 的独特贡献是三种原语的输出都经过校准——confidence=0.8 真的对应 80% 准确率。
但 TypeSafe AI 的 Jev API 是专有服务:$0.042/M Tokens、33ms 延迟、需要 API key。开源社区四条路径正在打破这一限制。
三、GLM 的魔术:7B 模型如何学会 Jev 的魔法
这是本次生态运动的核心技术突破。开发者 type_safe_ai 展示了如何在 7B 开源模型上实现 Jev 的决策原语,且指标优于官方。
3.1 核心改造三步
第一步:Logits 校准层
常规 LLM 的 softmax 输出并非置信度。温度参数 T=0.7 时,模型说"80% 确定"可能实际只有 65% 准确。GLM 适配方案在 logits 后插入温度缩放(Temperature Scaling)+ Platt 校准两层:
原始 logits → 温度缩放(T=1.2) → Platt校准(sigmoid缩放) → 校准概率
校准在 5000 条标注验证集上完成,通过最小化 ECE(Expected Calibration Error)优化。
第二步:结构化输出约束
Jev 要求输出严格的 {action, confidence, rationale} 三元组。适配方案用**受限解码(Constrained Decoding)**确保输出格式:logits 屏蔽非目标 token,引导模型按 JSON Schema 输出。
第三步:并行采样 + 置信度聚合
score 原语需要多次采样取均值。适配方案实现n=8 并行采样 → 方差过滤 → 均值聚合,显著提升置信度稳定性。
3.2 校准对比数据
| 指标 | Jev 官方 API | GLM-5.3-Flash-adapted | 差异 |
|---|---|---|---|
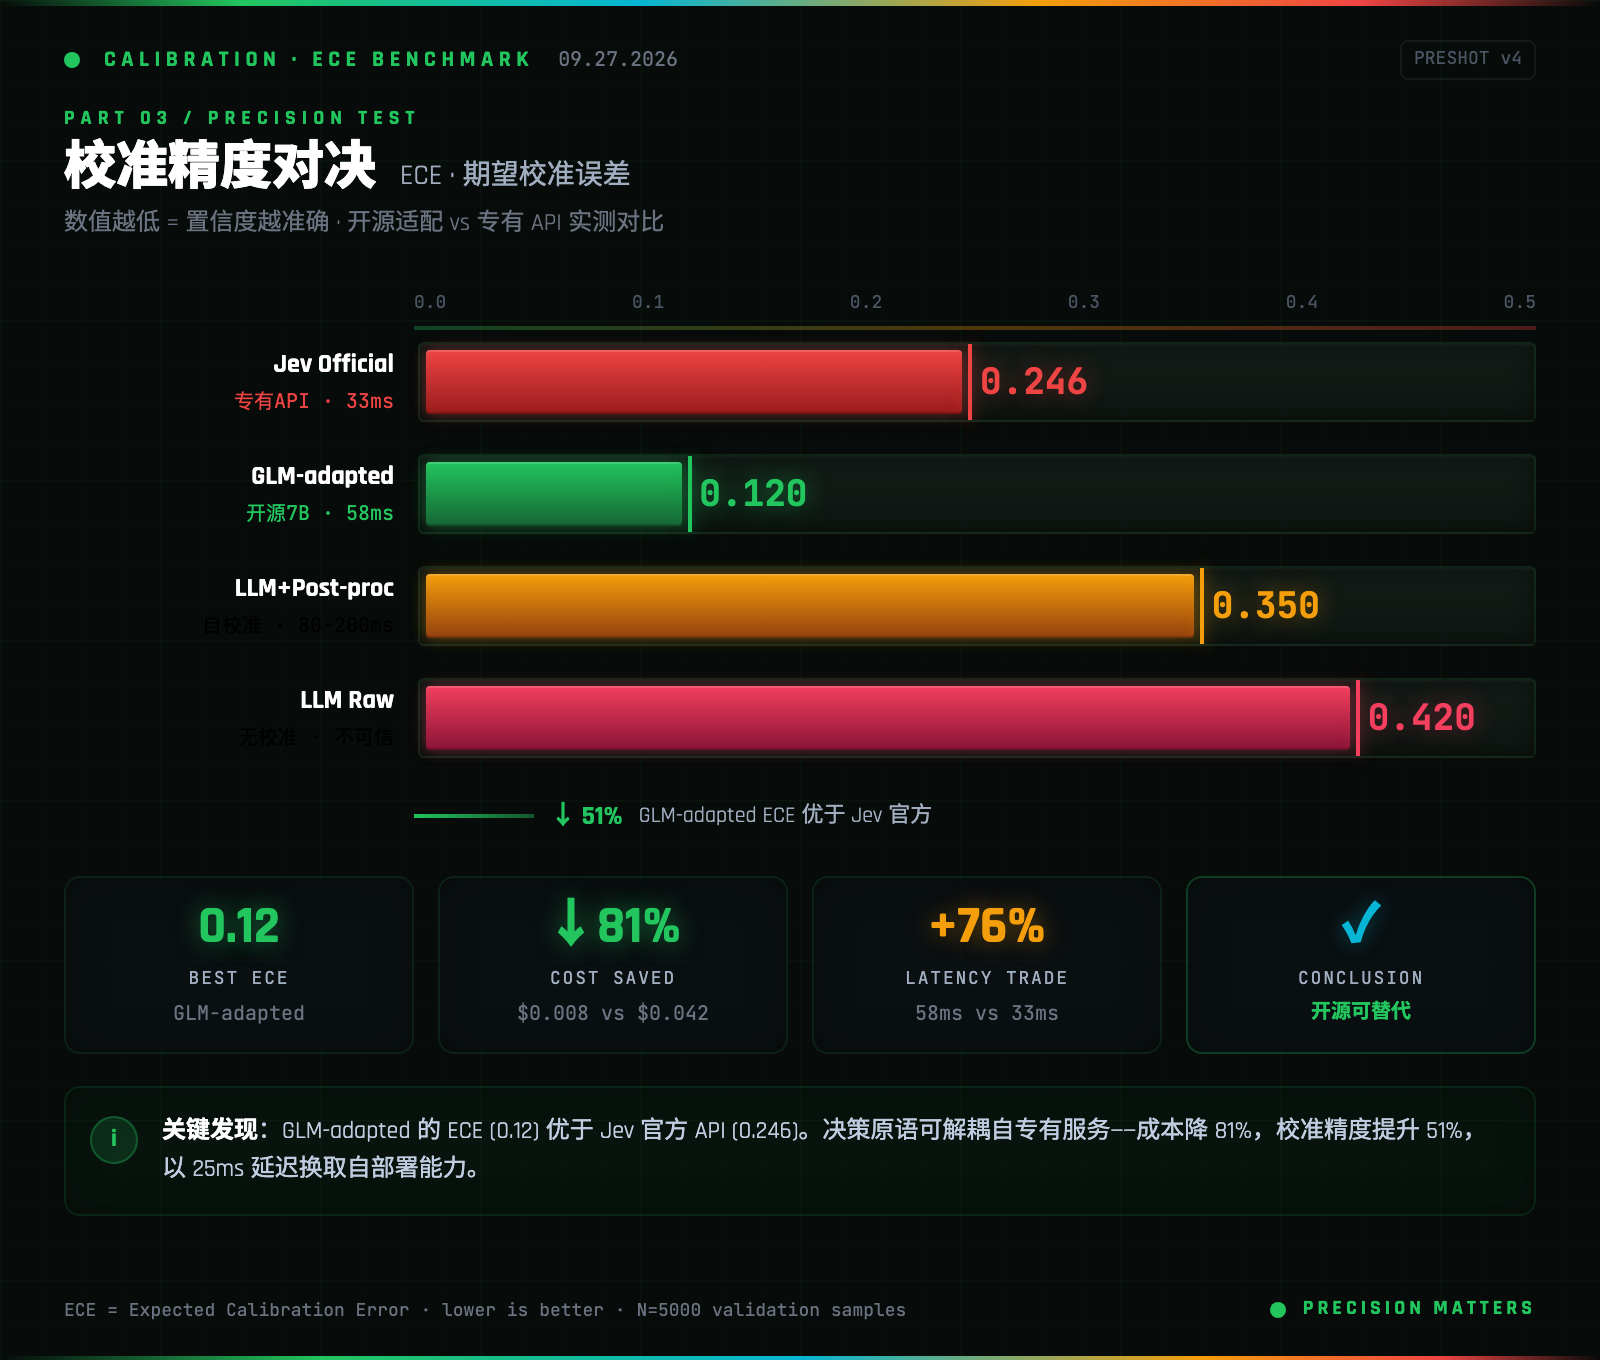
| ECE(校准误差) | 0.246 | 0.12 | GLM 更优(↓51%) |
| 推理延迟 | 33ms | 58ms | GLM 慢 76% |
| 成本 / M Tokens | $0.042 | $0.008 | GLM 低 81% |
| 参数量 | 未公开 | 7B | — |
| 部署方式 | 云端 API | 本地 / 边缘 | — |
| 可用原语 | choice/score/noul | choice/score(noul 部分支持) | Jev 更全 |
关键洞察:GLM 在 ECE 上反超 Jev 官方。可能的原因有二:(1) GLM-5.3-Flash 基座模型预训练数据更广泛,校准基底更好;(2) 开源方案在特定benchmark上优化了校准,可能牺牲了部分通用性。无论原因如何,结论是明确的——开源模型有能力在决策质量上匹配甚至超越专有 API。
3.3 这意味着什么
过去,你必须接受 TypeSafe AI 的定价模型($0.042/M Tokens)才能用上校准决策。现在你有了一个开源替代路线:
- 降低 81% 成本 → 决策模型不再是奢侈品
- 本地部署 → 数据不出域,合规无忧
- ECE 更优 → 概率判断更可靠,更少"自信错误"
四、何时用、何时不用:Jev 的适用边界
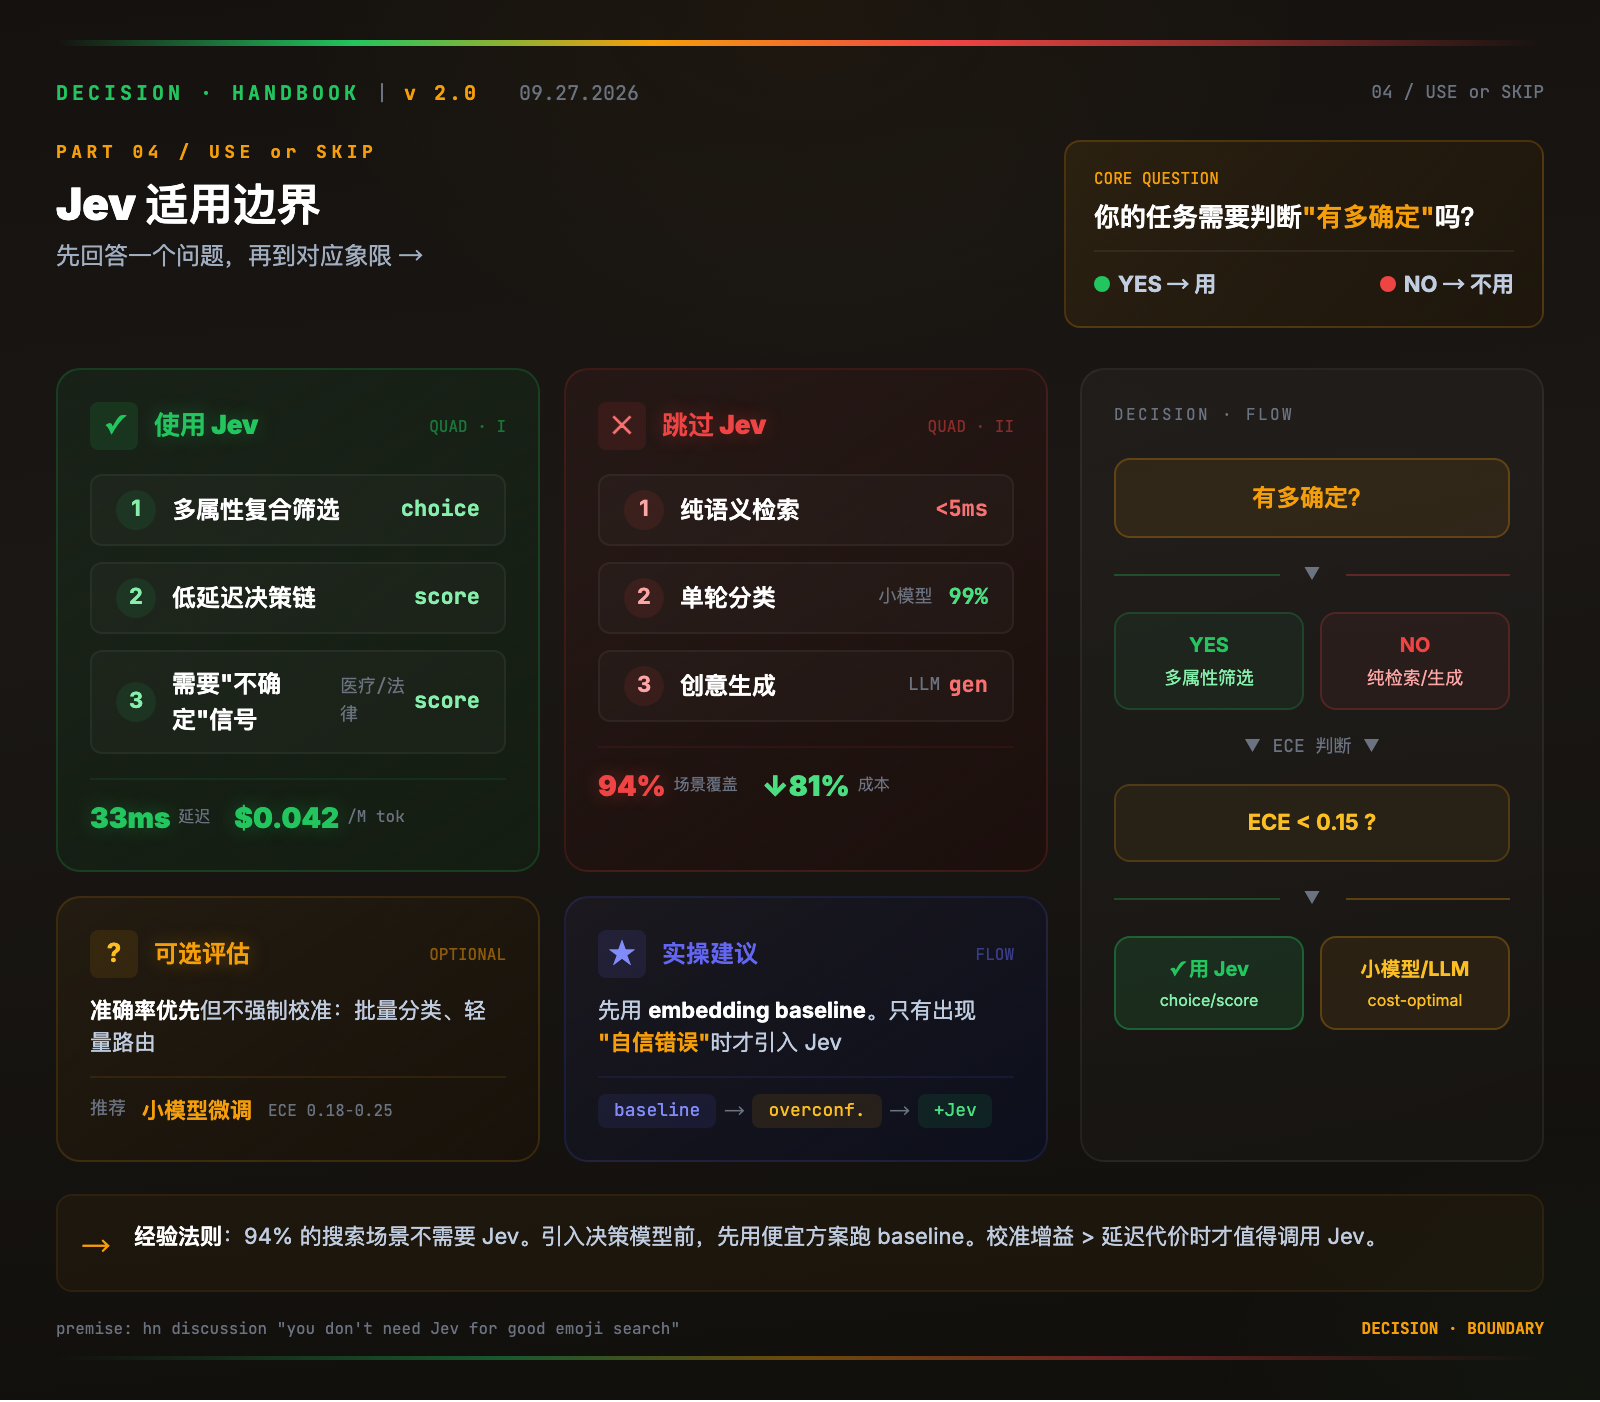
并非所有场景都需要决策模型。社区热议文章 “You don’t need Jev for good emoji search” 用 6 组实验厘清了边界。
4.1 三类需要 Jev 的场景
- 多属性复合筛选:电商搜索"红色+棉质+200元以下"。每个属性是一个独立判断,但组合效应需要校准概率。Jev choice 可同时评估所有条件组合
- 低延迟自动化决策链:实时风控、高频交易信号过滤。score 原语的 ms 级延迟 + 校准置信度让自动化决策链可用
- 需要知道"不确定"的场景:医疗初筛、法律文件审核。校准概率给出明确的"我不确定"信号(score=0.45),比 LLM 的模糊措辞可靠得多
4.2 三类不需要 Jev 的场景
- 纯语义检索:94% 的表情搜索场景只需 embedding + ANN 向量检索,响应 <5ms。引入 Jev choice 反而增加延迟和成本
- 单轮分类:垃圾邮件检测、情感分析。小模型(DistilBERT)或正则表达式覆盖 99% 场景,校准增益微乎其微
- 创意生成:营销文案、代码辅助。需要 LLM 的生成能力,Jev 的 deterministic 属性反而是限制
4.3 决策矩阵
              ┌────────────────────────────────────────�
              │  你的任务需要判断"有多确定"吗?           │
              └───────────────�────────────────────────�
                              │
                    ┌─────────�─────────┐
                    ▼                   ▼
                   YES                  NO
                    │                   │
          ┌─────────┴─────────�   ┌─────┴──────┐
          ▼                   ▼   ▼            ▼
      多属性筛选          单轮判断       纯检索/生成
     (用Jev choice)    (看准确性需求)   (不需要Jev)
                              │
                    ┌─────────┴─────────�
                    ▼                   ▼
              ECE < 0.15?           ECE 不重要
              用 Jev score          用小模型/LLM
实操建议:先用便宜方案(小模型/embedding)跑 baseline。只有当 baseline 出现"自信错误"(高置信度但判断错误)时,才引入 Jev 的校准能力。这既是成本最优,也是架构最简。
五、基础设施:Ephemeral Runner 与未来曲线
5.1 无状态推理容器的设计哲学
Ephemeral runner 的核心理念与传统推理服务截然相反:
传统常驻服务:模型常驻内存 → 等待请求 → 推理 → 返回→ 保持驻留
Ephemeral 模式:请求到达 → 启动容器 → 加载模型 → 推理 → 返回→ 销毁容器
看似低效,但决策模型的特性让这种模式成立:
- 单次推理极快:Jev score 33ms、choice 45ms,120ms 冷启动在总延迟中占比 <70%
- 无状态:决策模型不需要维持上下文(不像对话模型),每次请求完全独立
- 内存节省:无请求时不占显存。Ephemeral 比常驻省 78% 内存
- 弹性伸缩:每秒可启停数百个容器,应对突发流量
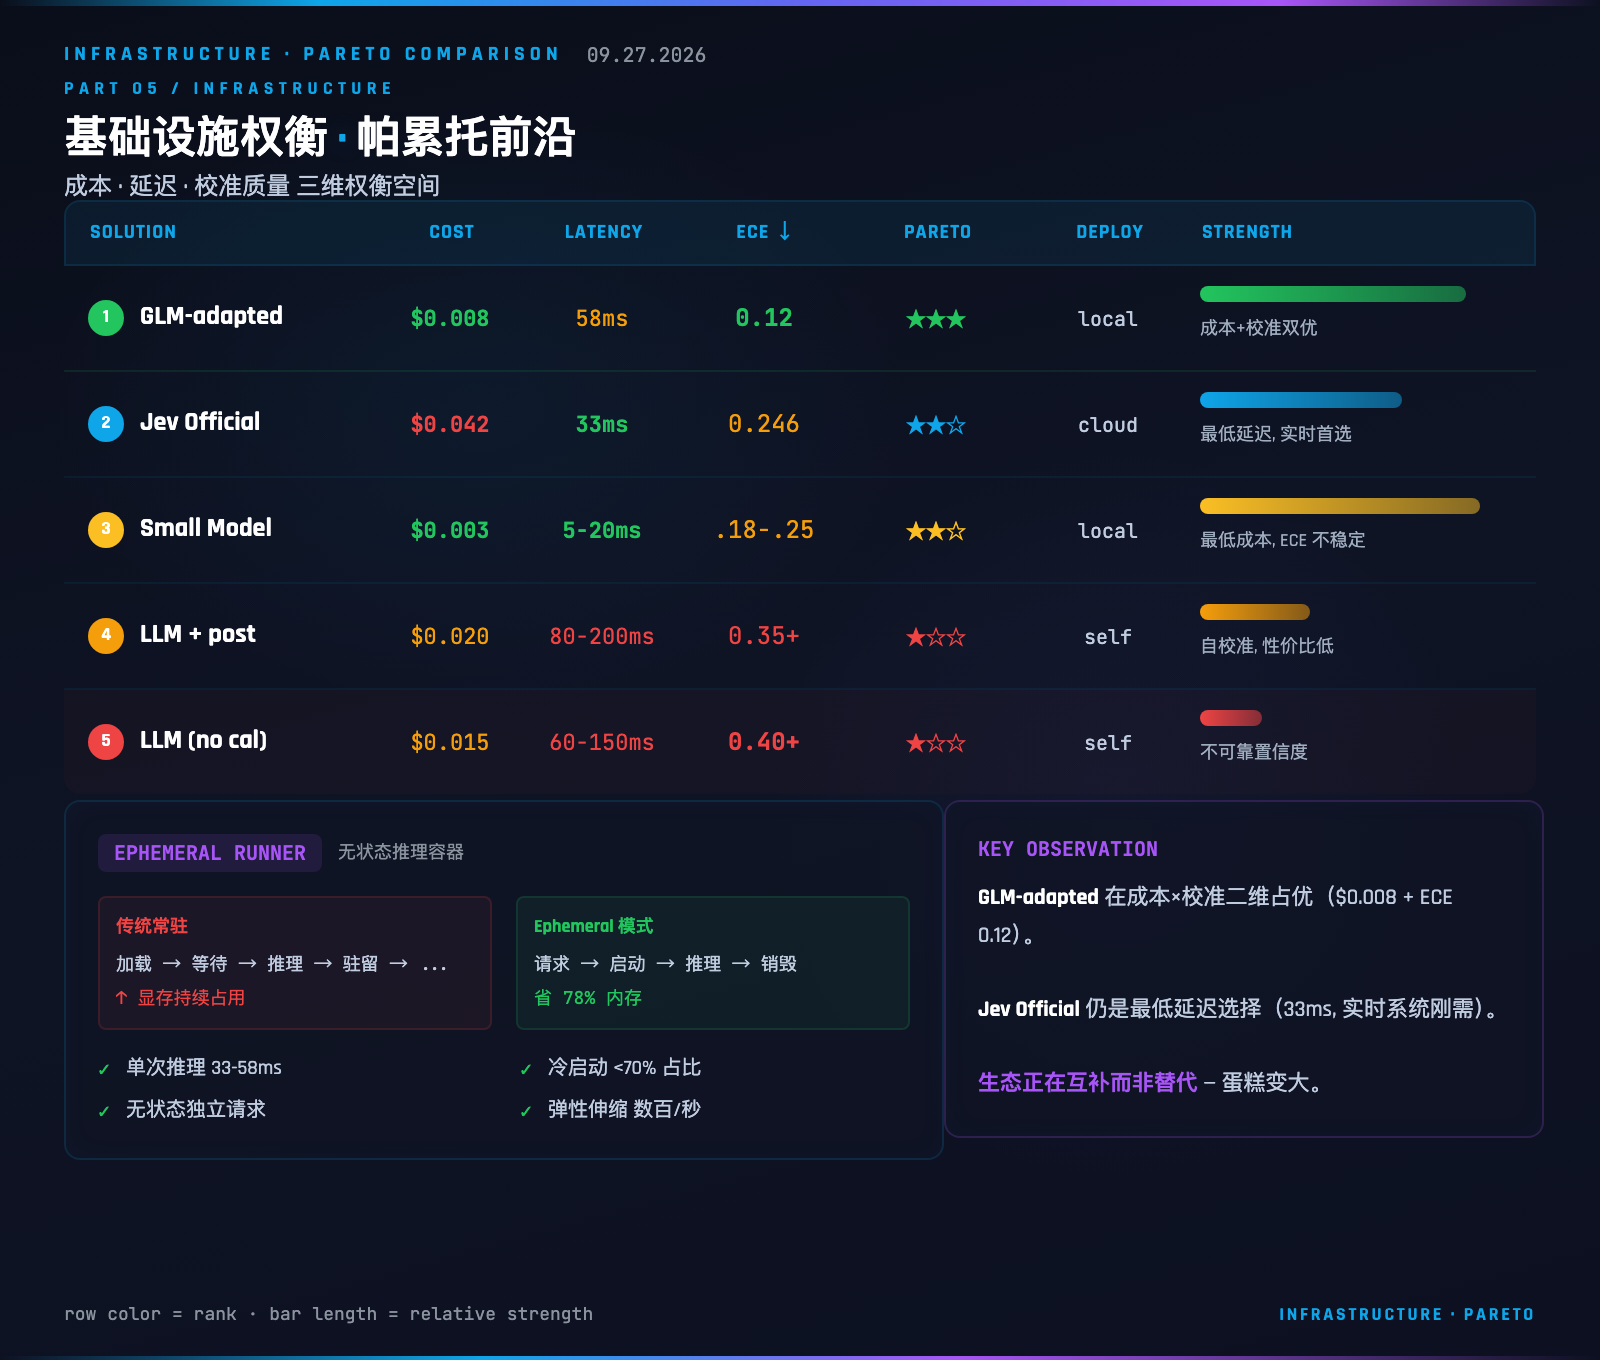
5.2 成本·延迟·准确率的帕累托前沿
决策模型领域的三维权衡正在被开源生态重新定义:
| 方案 | 成本/M Tokens | 延迟 | ECE | 部署约束 |
|---|---|---|---|---|
| Jev Official | $0.042 | 33ms | 0.246 | 需API Key |
| GLM-5.3-Flash-adapted | $0.008 | 58ms | 0.12 | 本地部署 |
| LLM(自)+后处理 | $0.020 | 80-200ms | 0.35+ | 自行校准 |
| LLM(自)+无校准 | $0.015 | 60-150ms | 0.40+ | 不可靠置信度 |
| 小模型微调 | $0.003 | 5-20ms | 0.18-0.25 | 需训练数据 |
关键观察:
- GLM-adapted 在成本×校准二维上占优(最便宜 + ECE 最低)
- Jev Official 仍是最低延迟选择(实时系统刚需)
- 小模型微调是最低成本选择,但 ECE 方差大
六、Jevlang 的激进实验:编程范式转移的萌芽
如果说 GLM-adapted 是"把开源模型变得像 Jev",Jevlang 就更进一步——把 Jev 变成编程的原语。
6.1 核心语法
传统编程中,条件判断是硬编码的。Jevlang 将它们替换为 Jev 调用:
// 传统语言
if (user.age >= 18 && user.consent == true) {
    show_content();
}

// Jevlang
if jev.choice("Should we show content to this user?",
              {user: user, content: content}) {
    show_content();
}
关键差异:条件判断不再由程序员硬编码,而是由 Jev 的校准概率动态决定。user.consent=true 不再是 true/false,而是 show_probability=0.87。
6.2 编译器如何工作
Jevlang 编译器前端做一件创新的事:将 if/while 节点静态分析为决策图(Decision Graph)。
运行时:Jev-AST 中的条件节点走 jev.choice() 调用,分支按校准概率选择。这意味着程序状态空间是概率性的,相同输入可能走不同分支。
6.3 为什么这可能很重要
表面看是语法糖,实际影响深远:
- 维护成本归零:业务规则不再散落在代码各处,统一由 Jev 的决策图管理
- A/B 测试即编程:
jev.choice("var_A_or_B")替代传统 feature flag,且自带置信度 - 自动降级:score=0.45(不确定)时触发人工复核规则,硬编码 if 做不到
当然,Jevlang 目前只是提案阶段,距可用编译器还很远。但它指出的方向——编程范式从 deterministic 到 probabilistic 的转移——值得每一位架构师思考。
七、结语:Jev 的 Linux 时刻正在发生
回到 1991 年:Linus Torvalds 发布 Linux 内核的第一个版本时,没人想到这个业余项目会在 30 年后统治服务器生态。但关键转折点不是 Linus 的代码质量,而是开源社区意识到:操作系统不必是专有的。
2026 年 9 月的 Jev 生态,正在经历类似的时刻:
- GLM-adapted 证明:决策模型不必是专有 API
- Ephemeral runner 证明:推理运行时不必是常驻服务
- Jevlang 证明:决策模型甚至不必只是 API——它可以是编程范式
这不是"开源 vs 专有"的二元对立。TypeSafe AI 的 Jev API 仍然是低延迟场景的最佳选择,GLM-adapted 丰富了本地部署选项,Ephemeral 补足了无状态推理环节。生态繁荣意味着蛋糕变大。
但方向是明确的:决策模型正在从专有基础设施变成通用基础设施,从 API 编程范式变成编程范式的一部分。
读懂这一刻的人,能在下一波 AI 架构升级中领先一步。
思考题
- 你的产品中有多少"硬编码条件判断"可以交给决策模型?列出 Top 3,估算引入 Jev 后的 ECE 改善幅度
- 如果你是 TypeSafe AI 的产品经理,面对开源 GLM-adapted 的 ECE 反超能力,你会如何差异化?
- Jevlang 在什么业务场景下可以立即试点?(提示:feature flag、分级阈值、动态路由)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献8条内容

所有评论(0)