碗沿那道裂纹被我描成了金线:具身智能交互把一位旧物修复师请进浏览器
碗沿那道裂纹,被我描成了金线:具身智能交互把一位旧物修复师请进浏览器
外婆留下的那只瓷碗,碗沿磕裂了一道纹。
我在"扔了买只新的"和"舍不得"之间,放了它快一年。直到上周,我推开了一家开在浏览器里的旧物修复铺——拾光旧物修复铺,店主叫阿铮。他没急着让我换只新碗,先问我:这只碗,陪过你们家多少顿饭?
今天想认真写写这家铺子,以及我第一次直观理解的那个词:具身智能交互。
一、推门前,先被门口的粒子接住了
打开页面的瞬间,我愣了一下。
深褐色的铺子里,飘着大团淡紫色的圆点像素——不是普通网页那种循环播放的动图,而像有生命:它们以 Bayer 抖动的规则聚成一片又散开,鼠标点下去,涟漪从指尖一圈圈荡开;光标划过,像素像液体一样轻轻变形、回流。
后来我才知道,这是一个跑在 WebGL 上的实时图形组件(React Bits 的 PixelBlast),所有粒子都靠端侧 GPU 实时算出来。它给我的第一感觉很准:这家铺子不是一张"网页",是一个可以走进去的"空间"。
点击"推开铺子的门",粒子层立刻停止渲染、释放显存,阿铮出现在工作台后。
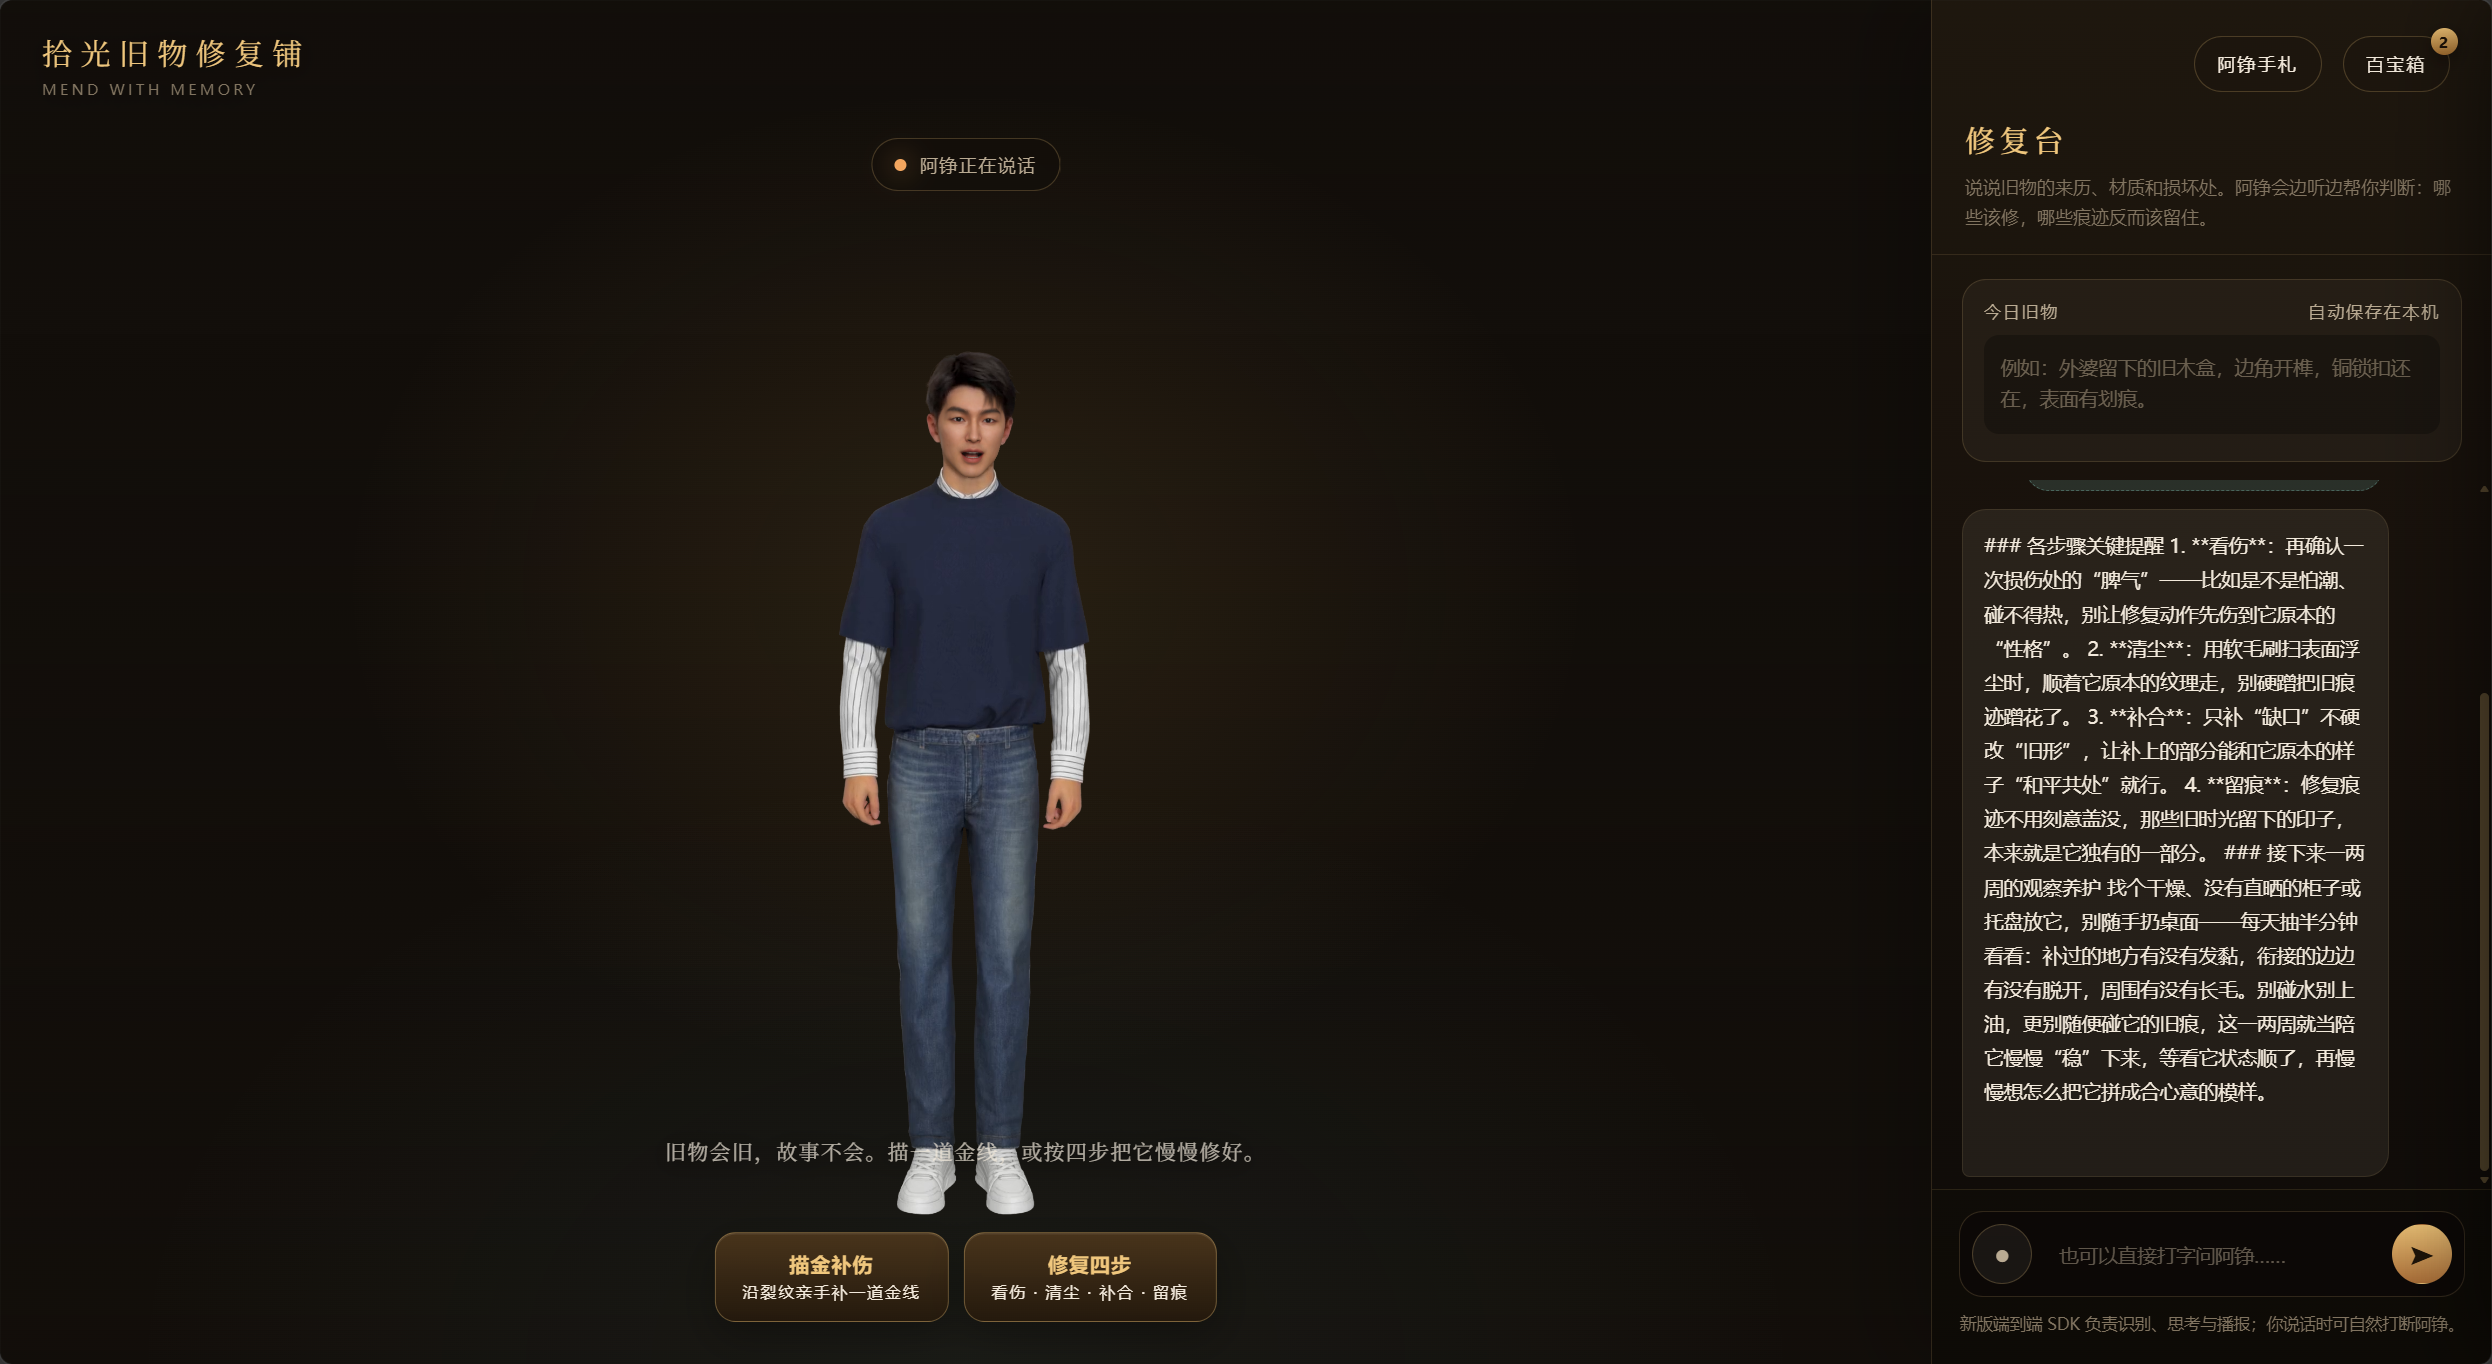
二、我以为要填表,结果只是"说话"
我准备好要对着一堆下拉框描述"破损类型",但阿铮的对话方式让我意外——
我直接说:“这是只白瓷碗,碗沿有一道斜裂纹,大概三厘米,没碎开,但盛汤会一点点渗。”
他一直在听。我说到一半改口"不对,是两厘米多",他也接得住,不需要我重新组织语言、点"发送"。说完他开口:瓷质、裂纹走向、会不会继续延伸,哪些能修、哪些痕迹反而该留住。
这个"他一直在听、随时能接上"的体验,恰恰是多模态感知最核心的部分:
不是"听见一句话"转成文字就结束了,而是持续知道现场正在发生什么。 我停顿、改口、甚至在他说话时插话补充,他都能识别出这是有效插话、而不是噪声,然后顺着新的信息继续。
这背后要处理的事其实非常棘手:AI 自己正在说话时,用户突然插话怎么办? 系统既不能把扬声器的声音误认成用户,也不能因为自己在"说",就听不到真正的用户。判断真实声音 → 去除回声 → 区分咳嗽、附和与真实插话 → 检测有效打断 → 停掉当前表达 → 继续接收完整输入——整条链路必须连续完成,交流才不会"卡住"或"自说自话"。
持续感知,而不是一次输入。
三、我亲手把裂纹描成了金线
铺子里有两件正经"家伙事",也是页面底部仅有的两个按钮:描金补伤和修复四步。
我先点了"描金补伤"。
全屏的工作台展开,画面里是一只线描瓷盏,一道暗色裂纹贯穿盏壁。规则很简单:按住裂纹,顺着它,用手指(或鼠标)慢慢描。 我沿着裂纹拖过去,笔尖经过的地方,暗纹被一道金线逐段覆盖,金线带微微的辉光,进度条同步往前走。
手有点抖,描歪了几次——系统允许小范围回摆,但不接受大段倒退,像真的有位师傅在旁边扶着你的手。描到九成,金线自动收尾,裂纹从此不是碗的"缺陷",而成了它故事的一部分。
这就是金缮的意思:不掩饰伤痕,把修补本身变成器物的美。
我查了一下背后的原理才更感慨:我的手指轨迹被采样、映射到裂纹路径、再实时驱动 SVG 金线的生成——这不是预制动画,每一道线都是我"走"出来的。页面没有内置任何"结论性文案",我看到的画面,是我的动作和实时计算共同生成的。
四、修复四步:看伤 · 清尘 · 补合 · 留痕
金线解决的是"心结",真正动手还有一套老老实实的工序。
点开"修复四步",四个节点一字排开,每一步都有具体到能上手的提醒:
- 看伤:先拍照、记位置,用手电斜照看清裂纹走向,没把握前别碰水、别上胶;
- 清尘:软毛刷顺一个方向扫,缝隙用气囊吹,擦拭先从看不见的边角试;
- 补合:先干拼一次确认每块的位置,胶要薄、要可逆,给以后的修复留路;
- 留痕:补痕可以被看见,不必假装岁月没发生过;阴干、观察,然后让它重新被用起来。
我注意到一个细节:他反复强调"包浆不必擦亮"“补痕可以被看见”“胶要可逆”——他不是把旧物变回"新",而是帮它带着历史继续走下去。
走完四步,这次操作会被存进"百宝箱",阿铮还会针对这只碗再做一段收尾叮嘱。所有记录只存在我自己的浏览器本地。
五、为什么这不是"给 AI 接了个身体"
聊到这里,我大概想明白具身智能交互到底是什么了。
过去我们理解的 AI,住在对话框里:你问一句,它答一句。而阿铮住在一个空间里——他有形象、有工作台,能持续地感知、理解、表达、行动,还能接收我的反馈再调整。
这绝不只是把大模型的回答"搬"到一个虚拟形象上。 真实的人机交互要求智能体持续地走这条链路:
感知 → 理解 → 决策 → 表达与行动 → 接收反馈。
人的语言、位置、动作、交互状态一直在变,智能体也必须持续感知和调整。这就是魔珐星云所定义的端到端具身交互智能。
更关键的是第二件事:端到端,不是 ASR + LLM + TTS 的简单拼接。
传统方案像一条流水线:语音识别 → 大模型 → 语音合成 → 屏幕。每个模块单独看都能工作,但一旦进入连续交互,就容易出问题——状态不同步、响应链路变长、表达和用户当前状态脱节。我的手抖、改口、插话,任何一个环节对不上,对话就"断"了。
星云的做法,是围绕一次完整的人机交互来设计整个系统:
持续感知 → 持续理解 → 持续决策 → 持续表达与行动 → 持续反馈。
这就是 Continuous Interaction Loop(持续交互循环)。一句大白话:不是"你问一句、它答一句",而是它一边和你交流,一边继续听、继续看、继续判断接下来该怎么回应和行动。
我描金线时它能同时看见我的手、我说话时它能随时被打断——都是这个循环在跑,而不是几个模块在排队交接。
当然,这不是说 ASR、LLM、TTS 这些单项技术不重要——它们每一个都重要。只是当 AI 要真正进入持续的人机交互,需要把它们围绕完整的用户交互连接成一个整体。
六、同一个阿铮,以后可以坐在不同的"身体"里
最让我心动的是第三个认知:一个智能体,可以进入不同的身体。
星云并不绑定某一种硬件。同一个阿铮、同一段关于我那只碗的记忆、同样的手艺和说话方式,可以存在于 Web、PC、手机、Pad,可以进入 AI 屏幕、移动 AI 屏幕,未来也可以走进人形机器人。
身体可以变化,但他的身份、知识、记忆、任务和业务能力可以持续复用;随着身体升级,他还能逐步获得更多感知、表达、移动和空间能力。
智能体持续存在,身体不断升级。
我甚至已经在想象:如果线下真有一家旧物修复铺,店里的人形机器人阿铮认得我,知道我外婆的碗已经描过金线,这次再接过我带来的旧木盒——屏幕里的他和铺子里的他,是同一个他。
写在最后
那天之后,那只碗重新被我们用了起来。盛菜时,碗沿的金线在灯下一闪,像外婆也觉得挺好。
官方资料里,魔珐星云的定义是:端到端具身交互智能平台。它把多模态感知、专属智脑、多模态表达、AI 端渲、数字行动与物理行动,连同 Real-time Interaction Runtime,连接成一套完整系统——让 AI 可以通过不同的屏幕和机器人身体进入真实世界。
而我这个普通用户的版本是:它让一位懂旧物、有耐心、记得住故事的师傅,住进了我的浏览器。
魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。
如果你的抽屉里也有一件"扔了可惜、留着不会修"的旧物,不妨推门进去坐坐。不用买新的,有些东西,修修就还能陪你很久。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献17条内容

所有评论(0)