Skild AI带着Physical Self-Play来了!想把 AlphaGo 那套搬到物理 AI 中。
昨天就看到预告,今天早上一起床就看到Skild AI团队发布了他们最新实现的后训练突破性成果。
博客中的把方案叫 Physical Self-Play。
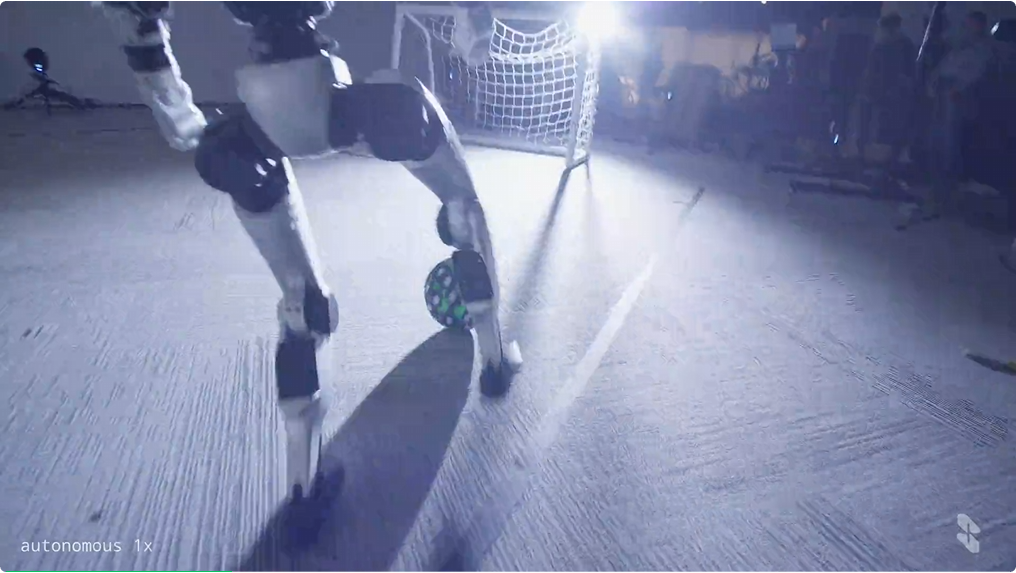
表面上看,它讲的是机器人踢足球,但更多是 Skild 对机器人基础模型下一阶段的判断:
靠人类数据预训练出来的模型,终究会被人类数据限制。
之前,机器人基础模型的主线大多是扩大数据规模。
Skild 自己的 S1 也是这么来的。
按照他们此前的说法,S1 是一个机器人 in-context learning 模型,可以通过视频示范理解任务,并在不针对新任务微调的情况下完成执行。
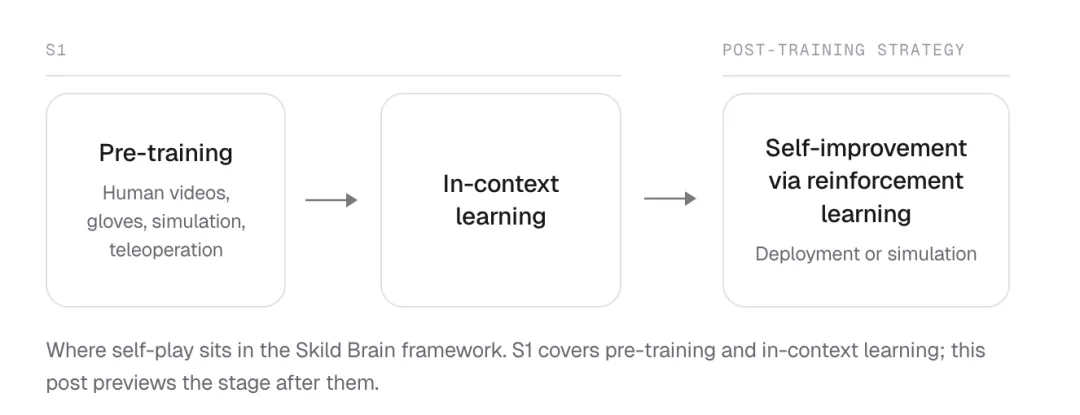
但问题是,人类数据再多,模型学到的仍然是人类已经展示过的行为。
它可以越来越像人,但很难自然超过人。
Skild 这次想表达的,就是下一步:让机器人通过 self-play 自己提升。
这个思路并不新。
AlphaGo 当年之所以重要,就是因为它不只是模仿人类棋谱,而是在自我博弈中发现了人类棋谱里没有的策略。后来 AlphaStar、OpenAI Five 也沿着类似路线,把 self-play 推到更复杂的多人博弈里。
Skild 的判断是,这套方法该进入物理 AI 了。
这次他们选的任务是足球。
因为,足球同时考验身体能力和策略能力。机器人不仅要站稳、移动、控球,还要面对对抗、遮挡、碰撞和动态决策。
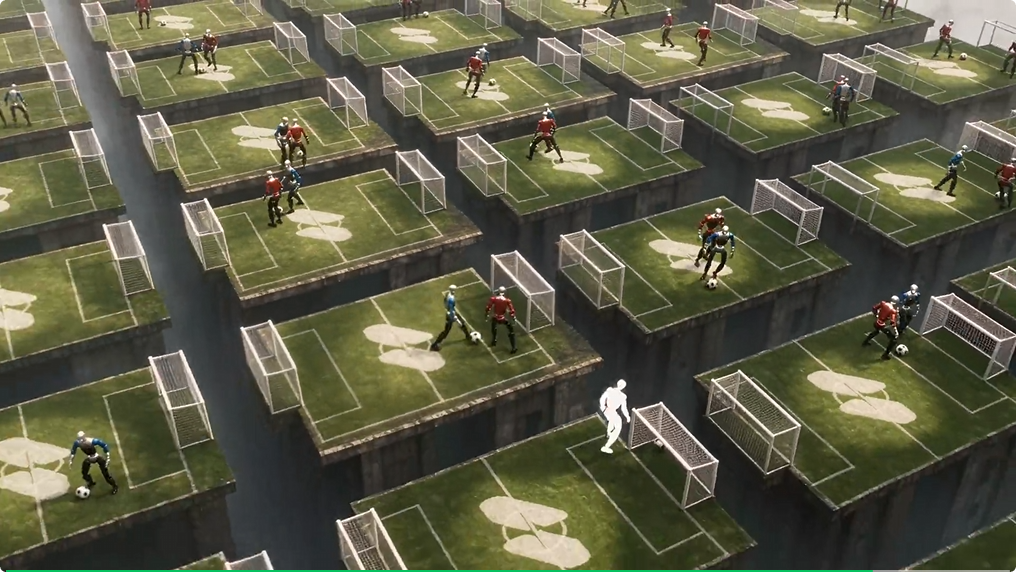
Skild 给模型的目标也很简单:进球。
模型在 NVIDIA Isaac Sim 里和近期版本的自己对抗。每当它变强,对手也变强。于是每一次能力提升,都会变成下一轮训练里的新压力。
这就是 self-play 最有意思的地方。
它不需要人把所有行为都标出来,也不需要工程师手工规定“什么时候护球”“什么时候抢断”“什么时候绕开对手”。只要这些行为有助于进球,它们就可能在训练里自然出现。
Skild 在文中提到,模型一开始连走路都不稳;经过模拟中的长期对抗后,逐渐学会了起身、带球、护球、抢断等能力。
最后,他们把经历 140 年模拟比赛的策略迁移到实体人形机器人上,完成了真实对抗演示。
从我们角度来看,这件事最重要的信号在于:机器人基础模型的训练链路,正在从“预训练获得广度”,走向“后训练获得上限”。
预训练解决的是能力覆盖。
Self-play 解决的是策略突破。
前者让机器人见过足够多的人类行为,后者让机器人在可验证目标下持续试错,发现人类数据里没有写明的动作和策略。
不过博客里展示的是足球场景,训练主要发生在仿真里,真实机器人演示也还需要更多测试条件和量化结果来判断泛化能力。
但这条路线又给行业提供了一个新的思路,值得继续追。
重磅!
全网首个!具身智能开源知识库来啦(技术/产业/投融资/上下游)
推荐阅读
我们用低成本的机械臂完成pi0/pi0.5/GR00T/世界模型等VLA任务~
VLA+RL方向首个系统教程来啦!Online RL/Offline RL/test time RL等~
VLA/VLA+触觉/VLA+RL/具身世界模型等!具身大脑+小脑算法与实战全栈路线来啦~
1v1 科研论文辅导来啦!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献167条内容

所有评论(0)