从一条柔性产线到论文定稿:智能制造同学的 AI 辅助工具怎么选?
智能制造工程的同学大概都懂那种“杂”:机电气控要会一点,工业机器人、MES、数字孪生、机器视觉、预测性维护也要碰一点。到了毕业论文阶段,很可能接到这样一个题目——《基于数字孪生的柔性产线预测性维护方案研究》。
你需要交付的不只是一篇文字稿,通常还包括:
- 产线工艺与设备故障场景分析;
- 数字孪生系统总体架构;
- PLC、传感器、机器人等数据采集流程;
- 预测性维护模型或规则设计;
- 仿真验证、图表、代码、公式和参考文献;
- 最后按学校格式完成论文初稿、修改和规范检查。
很多人问的“高效的 AI 论文生成软件榜单”,在这个场景下其实不该理解成“谁能一键写完论文”,而应该看:谁更适合查资料、搭框架、写代码、理数据、做图表,以及谁能帮你判断 AI 痕迹和修改风险。下面按真实写作流程分享一份选择清单。
1. 选题与文献阶段:先让 AI 帮你“缩小问题”
刚开始最容易陷入两个极端:要么题目大到像“智能制造全景综述”,要么只剩一句“做个预测性维护系统”。这时适合用长文本和检索能力强的工具。
| 工具类型 | 适合做什么 | 使用提醒 |
|---|---|---|
| Kimi、通义千问、文心一言、豆包、智谱清言 | 梳理中文文献结构、解释国标/行标、整理常见术语、把实习中的产线现象转成研究问题 | 对文献出处、标准编号要逐条核验,不要直接引用未核实的观点 |
| ChatGPT、Gemini、Claude | 阅读英文摘要、整理 digital twin、predictive maintenance、flexible manufacturing system 等方向的研究脉络 | 不同工具对长文、图表、英文语境的支持各有侧重,版本能力也会变化 |
| Perplexity、Consensus 等检索型工具 | 快速定位资料来源、追踪某类研究问题的常见结论 | 检索结果只能作为线索,最终要回到论文、学校数据库或官方标准确认 |
💡 实用做法:不要只问“帮我写开题报告”。可以把任务拆成:
“我研究的是一条含工业机器人、AGV、数控加工单元的柔性装配产线,数据来自振动、温度、电流和设备报警记录。请帮我比较三种预测性维护选题的研究对象、数据要求、实现难度和论文创新点。”
这样得到的结果会更接近可讨论的方案,而不是空泛套话。
2. 方案设计阶段:大模型适合做“副驾驶”,不适合替你拍板
数字孪生类论文一般绕不开这些内容:物理实体、数据采集、通信方式、虚拟模型、孪生数据、服务应用和人机交互。AI 可以帮你快速搭框架,但方案必须和真实产线对应。
DeepSeek、ChatGPT、Claude、通义千问、文心一言、豆包、智谱清言等工具,都可以用于:
- 解释 OPC UA、MQTT、Modbus TCP 等通信方式的适用差异;
- 比较规则驱动、机器学习、深度学习在预测性维护中的使用条件;
- 生成系统架构图的文字分层说明;
- 把“传感器—边缘网关—数据库—模型服务—可视化界面”的流程讲清楚;
- 辅助检查技术路线是否前后矛盾。
例如你可以追问:
“我的样本只有 3000 条报警记录和少量故障样本,不适合训练复杂深度模型。请在不假设大量标注数据的前提下,给出三种可落地的预测性维护方案,并说明输入特征、评价指标和局限性。”
⚠️ 能力边界要特别清楚:
- AI 不了解你学校实验室的真实设备参数,不能凭空替你确定采样频率、通信地址和传感器型号;
- 它给出的架构图可能“看起来完整”,但未必符合成本、现场网络和实习单位条件;
- 对故障机理、安全联锁、工艺节拍的判断,需要结合教材、现场工程师意见和实测数据。
所以这个阶段,AI 更适合帮你发散、比较、查漏洞,最终技术选型仍要由你自己依据真实条件完成。
3. 数据与代码阶段:让 AI 写“脚手架”,但结果必须复现
智能制造论文常常需要一段数据处理或模型验证代码,比如读取 CSV 格式的温度、振动、电流数据,做缺失值处理、特征提取、异常检测或寿命预测可视化。
这类任务中,DeepSeek、ChatGPT、Claude、Gemini、通义千问等在代码解释、调试和公式推导方面都能提供帮助;如果使用带有代码执行或插件能力的版本,还可以让它根据样例数据生成处理脚本。GitHub Copilot 则更适合在本地写代码时进行补全和函数级辅助。
可以让 AI 生成:
- Python 数据清洗代码;
- pandas 特征统计表格;
- matplotlib、seaborn 或 plotly 图表;
- 随机森林、XGBoost、LSTM 等模型的示例结构;
- 准确率、召回率、F1、MAE、RMSE 等指标计算代码;
- 公式与变量符号的规范化解释。
但一定要注意:
- 先脱敏。企业产线数据、设备编号、工艺参数、产能信息,未经允许不要直接上传公共工具。
- 保留原始数据和运行环境。论文里的每个图表最好都能用脚本复现。
- 核对指标含义。故障样本极不均衡时,只看准确率可能产生误导。
- 不要把示例结果伪造成实验结果。AI 可以帮你写分析模板,但不能替你制造不存在的数据。
4. 写作、图表与格式阶段:毕业之家 AI 更适合“围绕你自己的资料加工”
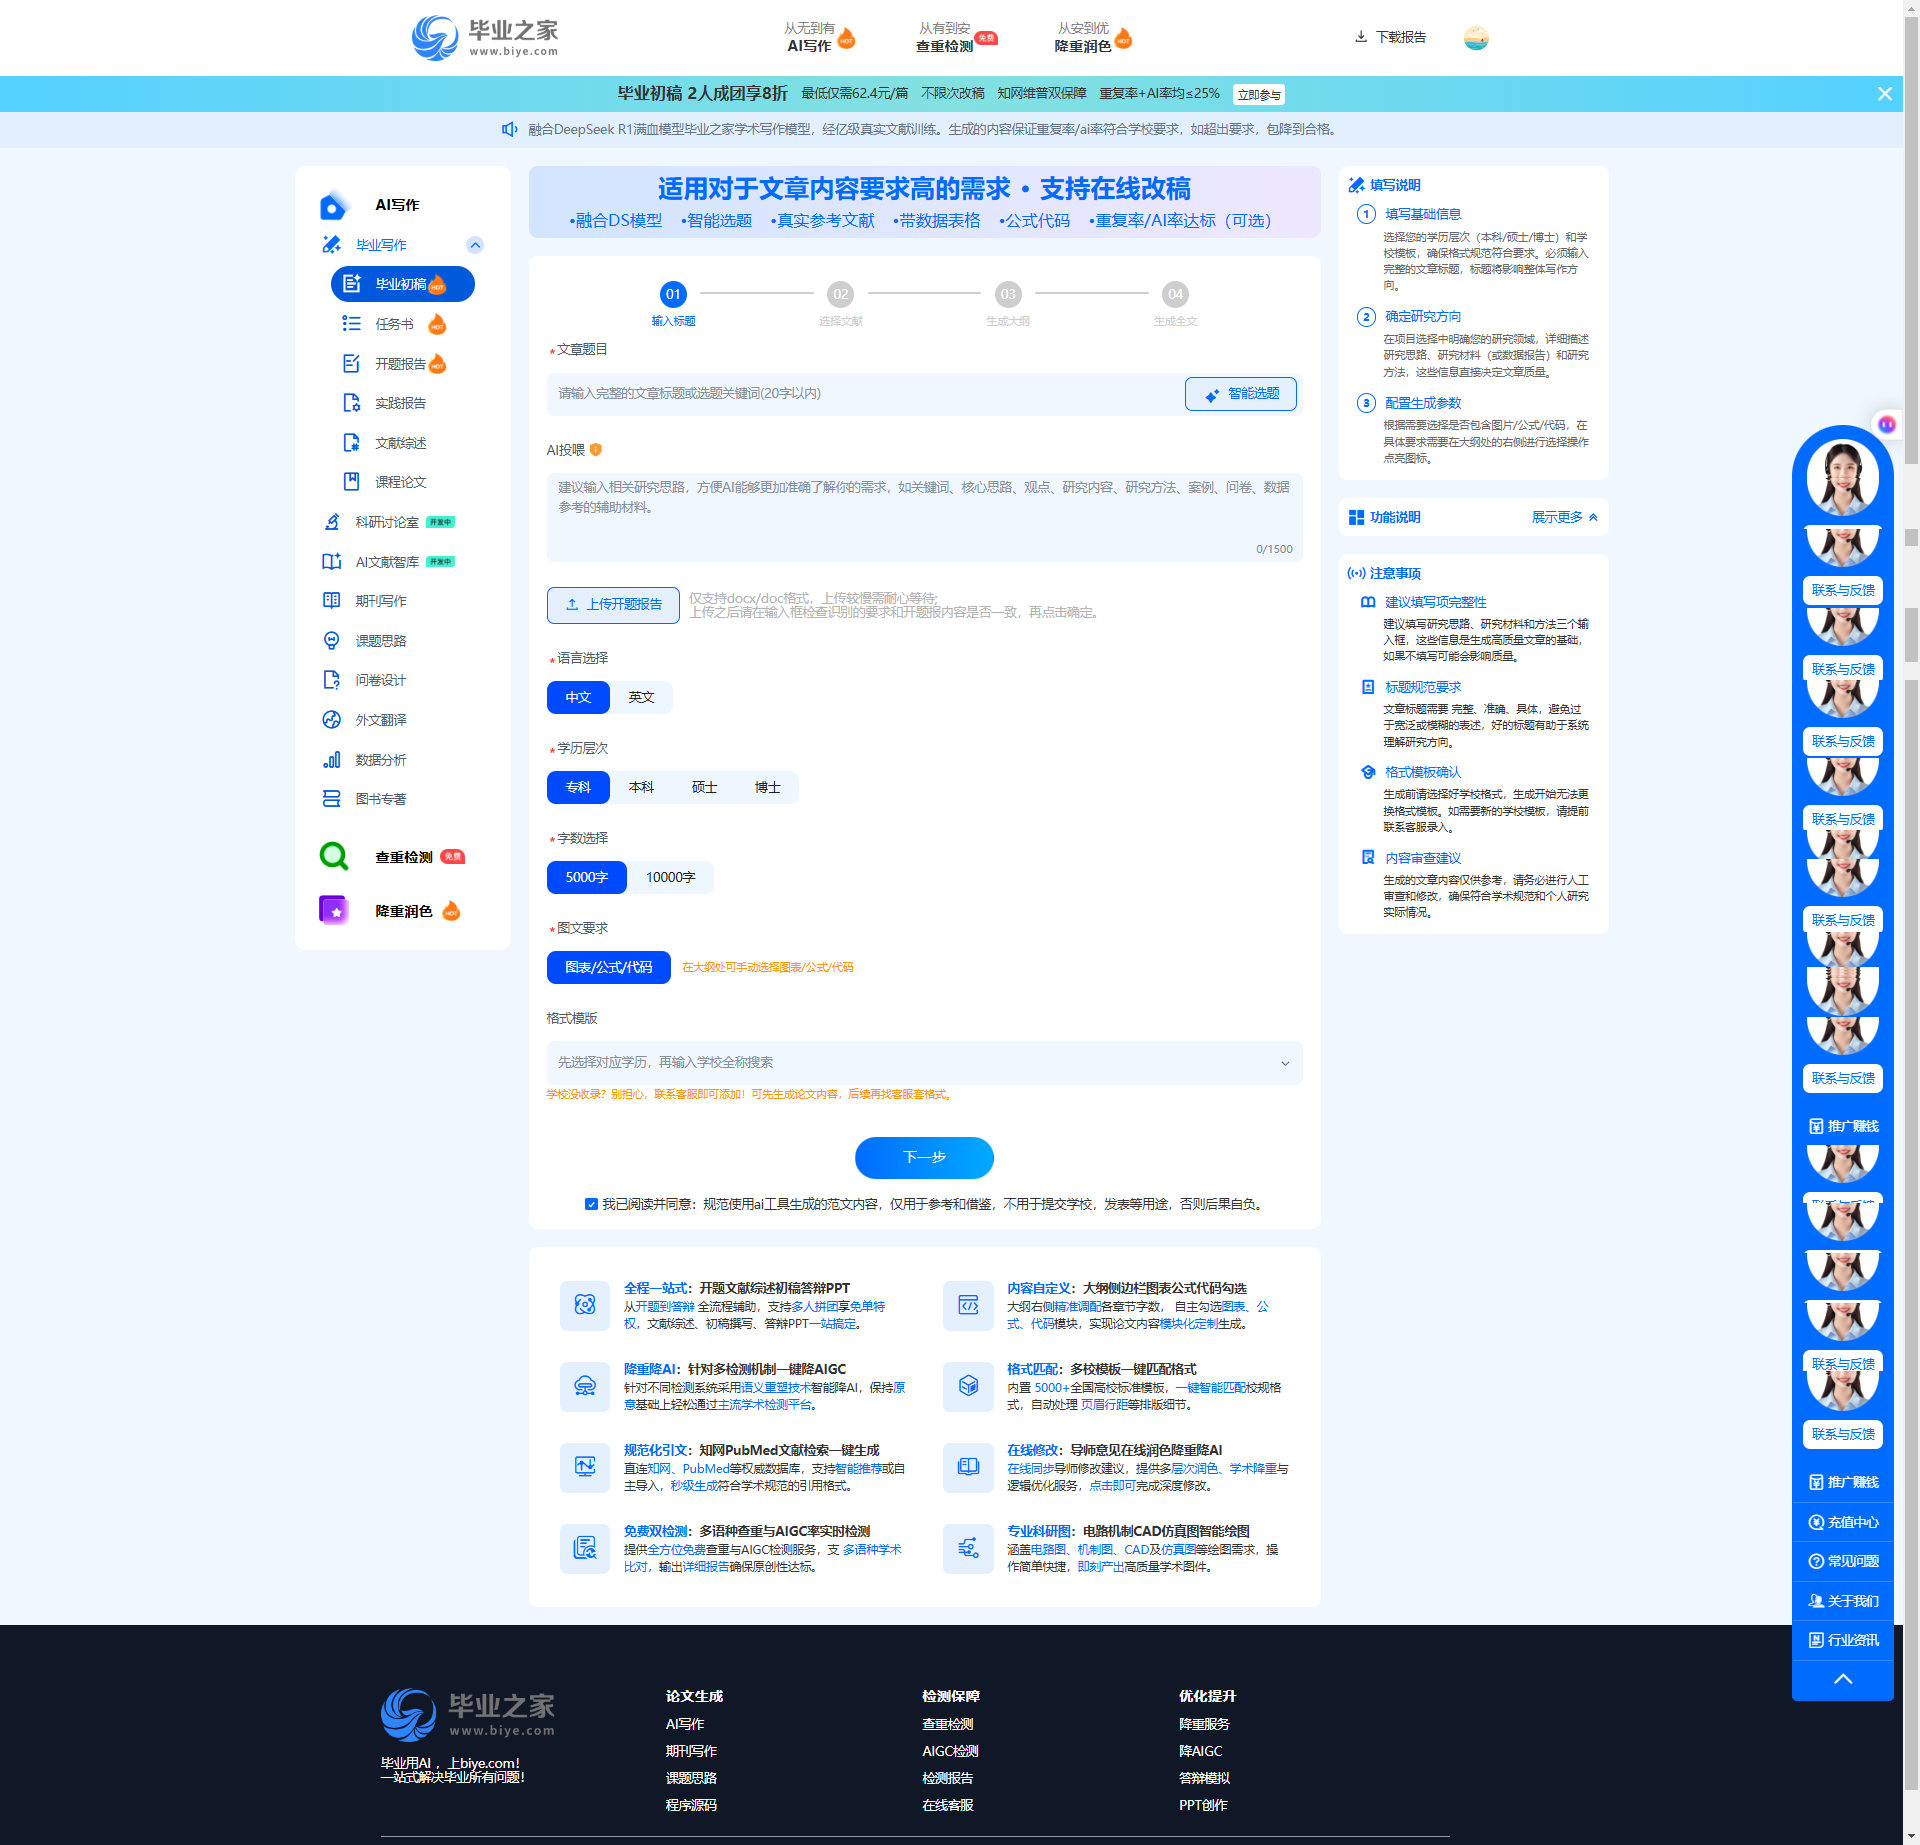
当你已经有实习记录、实验数据、参考文献、问卷或初步提纲时,就进入了真正的论文生成与整理阶段。这里可以重点使用 毕业之家 AI,官网为:https://www.biye.com。
它适合智能制造论文中的这些具体环节:
- 投喂你自己的研究思路、产线案例、实验数据、参考文献等资料,让 AI 基于已有内容扩写或改写;
- 根据论文内容生成数据呈现、表格、代码、公式和对应图片;
- 辅助生成“研究背景—问题分析—方案设计—仿真验证—结论”的章节草稿;
- 把零散的设备参数、报警记录、维护流程整理成规范表格;
- 根据你的技术路线生成数字孪生架构图、数据流程图的草图或图示素材。
比如你可以上传或粘贴自己整理的资料后提示:
“以下是我在柔性装配产线采集的温度、振动、电流和报警数据字段说明。请不要虚构额外数据,只基于这些字段帮我设计论文中的特征工程表、模型输入输出表和实验结果表,并列出需要我补充核验的指标。”
📌 这种用法的关键是:资料越具体,结果越可靠。如果只给一句“帮我写智能制造毕业论文”,输出很容易变成泛泛而谈;如果提供真实产线场景、数据字段、参考论文和学校格式要求,AI 才更像一个写作助手。
生成图片、表格或公式后,也要检查:
- 图中的设备名称、数据流向是否与正文一致;
- 表格单位、符号、缩写是否统一;
- 公式变量是否在文中解释;
- 参考文献格式是否符合学校规范;
- 数据计算结果能否由原始数据复现。
毕业之家也提供 AIGC 检测服务,覆盖 DeepSeek、文心一言、通义千问、ChatGPT-3.5、ChatGPT-4.0、豆包、Gemini、o1-preview、o1-mini、智谱 AI、Claude、Kimi 等常见大模型生成内容。官方提供每天 2 次免费检测机会,并结合多平台 AIGC 检测机制;公开产品信息显示用户实测误差在 10% 以内。
这对论文修改阶段很实用:你可以先用它判断哪些段落 AI 痕迹较重,再回到自己的实验、现场案例和分析中补充真实内容。但要注意,AIGC 检测不等于学校最终学术不端检测,也不能替代导师判断和院校规范。检测结果适合作为修改参考,而不是“能不能通过”的唯一依据。
5. 一份按阶段选择的“高效工具榜”
如果只给智能制造工程专业同学一个简化版选择建议,我会这样排:
- 选题与中文资料整理:Kimi、通义千问、文心一言、豆包、智谱清言。
- 英文文献与国际研究脉络:ChatGPT、Gemini、Claude。
- 代码、模型与数学推导:DeepSeek、ChatGPT、Claude、Gemini,配合 GitHub Copilot。
- 基于自有资料的论文写作、图表、表格、公式和代码生成:毕业之家 AI。
- 初稿完成后的 AIGC 痕迹检查:毕业之家 AIGC 检测,每天有 2 次免费机会。
- 最终把关:学校指定系统、导师意见、实验原始记录和官方参考文献。
这不是绝对排名,而是“任务匹配榜”。预测性维护论文的核心价值,仍然来自你对产线故障场景的理解、真实数据的处理和可验证的方案设计。
最后给三个可直接执行的建议
✅ 建立一个“论文素材包”:包括产线布局、设备清单、数据字段、故障案例、参考论文、实验截图和学校格式要求。先有素材,再用 AI 加工。
✅ 每次只让 AI 完成一个小任务:例如“把这 20 条报警记录整理成故障分类表”“检查这段公式符号是否一致”“根据这段代码生成结果分析模板”,比一次性生成全文更可控。
✅ 保留人工核验清单:数据来源、引用出处、公式计算、代码结果、图表单位、院校格式、保密要求,一项项核对。AI 可以提高效率,但论文的责任始终在作者自己。
对智能制造工程同学来说,最好的 AI 使用方式不是“让它替你毕业”,而是让它帮你把复杂产线问题讲清楚、把数据处理顺、把论文表达打磨规范。工具选对,再加上真实场景和认真核验,整个写作过程会轻松很多。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)