首次从无标注Ego视频中提取物理因果先验:Zeva-Ego让机器人“看人干活就能学”
9月21日,无锡「ICCL自进化·物理智能Open Day」。
世界级科学家和企业家张亚勤院士提出Physical Self- Improvement,并对物理智能的下一阶段作出判断:物理智能的scaling要靠在部署中完成自进化。
清华AIR联手域变换发布的上一代Zeva已经证明过这条路线的可行性:模型不更新,能力也能持续增长。但还有一个更关键的问题没有解决 --
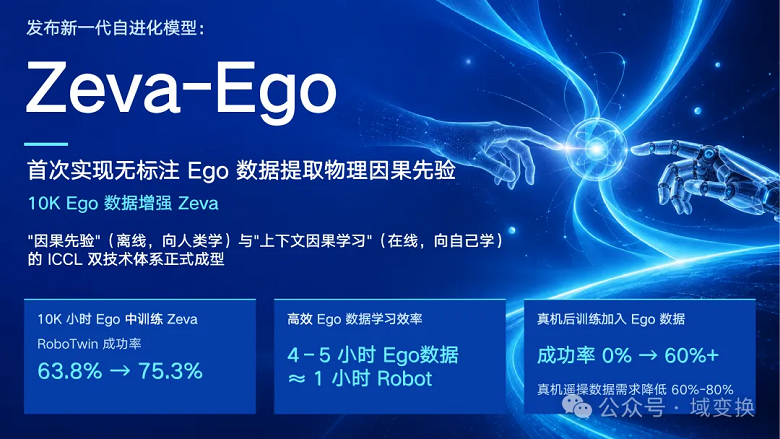
这正是 Zeva-Ego 要回答的问题。
01 预训练决定 60 分,自进化决定 100 分
具身智能行业今天最不缺的,是 Demo。
真正稀缺的,是能长期、稳定、少人接管干活的机器人。
原因并不复杂:离线数据无法穷举真实物理世界。摩擦会变,物体会偏,光照会变,抓取会滑动,执行会失败。换一个环境、换一条产线、换一批物料,往往就要重新采数据、重新微调、重新部署。
所以,具身智能有两道关:
第一道关,是“会做”。这靠预训练,靠数据、参数和算力,把通用能力做出来。
第二道关,是“做好”。这靠自进化,让机器人在真实部署中,从每一次动作、结果和失败里继续学习,越做越好。
预训练决定 60 分,自进化决定 100 分。
清华AIR和域变换早些时候发布的 Zeva,解决的是第二道关。
它把机器人每一次“动作→状态变化”变成可检索的因果记忆。模型参数保持冻结,能力却能在重复尝试中持续提升。在 RoboCasa365 上,同一个冻结模型的累计成功率从 26% 提升到 73%;在真实化学实验室里,机械臂也随着尝试次数增加,越用越稳。
在Zeva眼中,失败不是无效样本,而是学习信号。
但 Zeva 仍然有一个天花板:它的物理先验,来自原本的基础模型。它没有回答,怎么样用更低成本、更大规模的数据,把机器人的“起步能力”也一起抬高。
Zeva-Ego 的不同,就在这里。
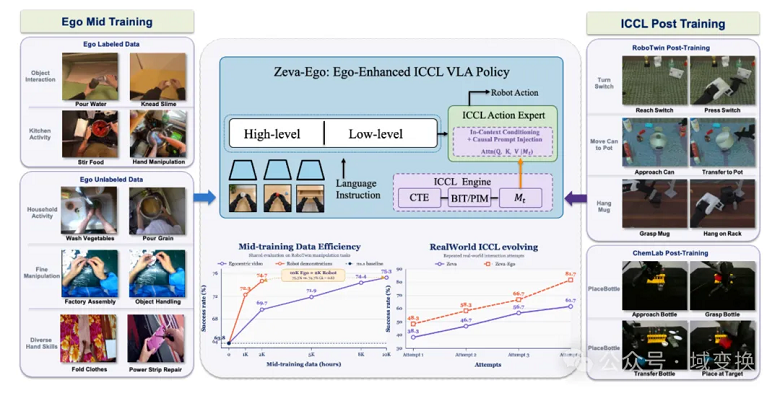
图1|Zeva-Ego设计和性能表现。图源:Zeva-Ego 论文
02 Zeva-Ego 的新突破:把两条曲线接在一起
Zeva-Ego 不是一个只做“部署后自进化”的模型。
它同时做了两件事:
第一,把人类第一视角视频,变成机器人的物理先验。
机器人真机数据昂贵、稀缺,但人类第一视角视频极其丰富。人们做饭、整理、装配、搬运、操作工具,这些视频里藏着大量真实的物理交互经验。
问题是,它们大多没有机器人动作标签,不能直接拿来训练机器人。
Zeva-Ego 的解法,是建设一条大规模 Ego 数据中训练管线。它覆盖六大数据源,合计接近 1.8 万小时语料,其中人类第一视角部分约 1 万小时。通过自动标注和动作表征技术,这些没有机器人标签的视频,被转换成可训练的动作监督。
这些数据在进入训练前,还要先过一条“数据集感知”的清洗管线:先检查视觉完整性,剔除解码失败、坏帧、时间戳断裂、镜头切换和相机标定异常;再把第一视角鱼眼画面统一到相同相机模型;然后过滤掉主要是穿戴者运动、而不是手部操作物体的片段;对有动作标注的数据,还要逐段校验位姿轨迹、四元数和跟踪连续性。只有通过这一整套检查的片段,才会进入中训练。
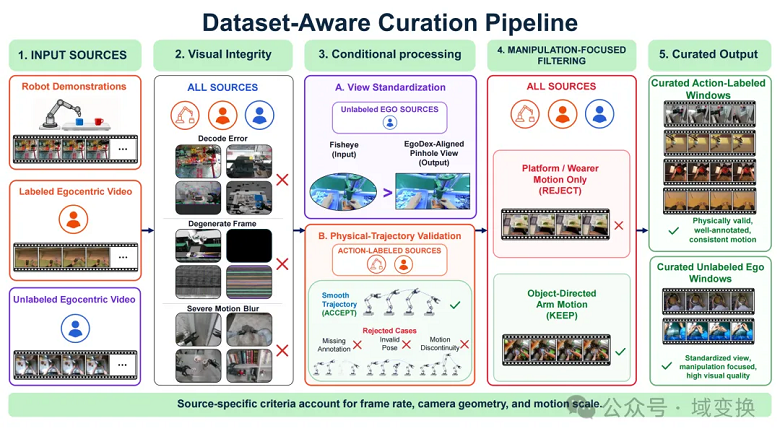
图2|数据集感知的清洗管线:视觉完整性检查、视图标准化、操作聚焦时序过滤和物理轨迹校验,把多来源数据清洗成统一可训练语料。图源:Zeva-Ego 论文
更直白地说:它让机器人先读一部由全人类贡献的“第一视角操作教科书”。
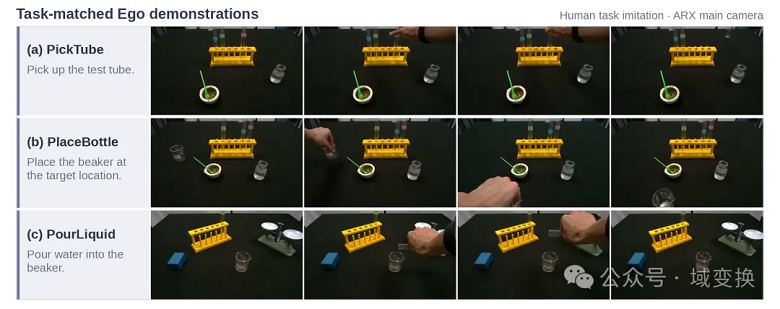
图3|任务匹配的人类第一视角示范:经过清洗和动作编码后用于机器人中训练。图源:Zeva-Ego 论文
第二,把 Zeva 的因果记忆,装进 VLA 的动作专家。
Zeva-Ego 采用 π0.5 作为视觉—语言—动作基础模型。VLM 负责理解场景、理解任务、预测下一步子任务;Action Expert 负责生成具体的连续动作。
Zeva 的因果自进化能力,没有去改动 VLM 主干,而是直接注入 Action Expert。
这意味着:机器人对世界的理解保持稳定,高层任务逻辑不被打乱;但低层“怎么抓、怎么放、怎么调整力度”会随着真实交互经验持续优化。
同样,模型参数保持冻结,不重训、不微调。变的,是上下文,是记忆,是下一次动作生成的依据。
前者让机器人起步更像人,后者让机器人越干越像老师傅。
先看模型是怎么训练的。Zeva-Ego 的训练分两段:第一段,在 π0.5 基础模型上做 Ego 中训练,把人类第一视角视频变成机器人的物理先验;第二段,再进入统一的任务后训练。为了确认增益确实来自 Ego 数据,论文固定了模型架构、优化设置和后训练配方,只改变中训练数据时长和来源。
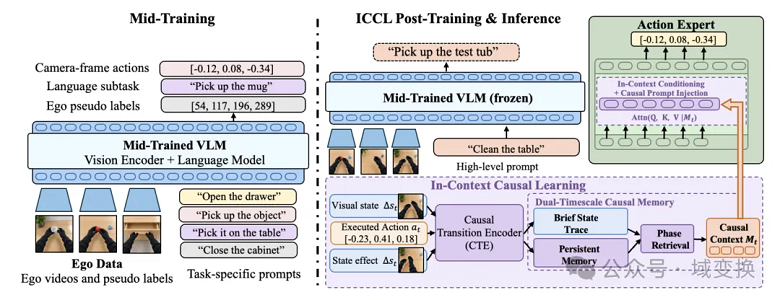
图4|Zeva-Ego 训练框架与过程:离线 Ego 中训练建立物理先验,在线 ICCL 将交互经验注入 VLA Action Expert,实现冻结参数下的持续进化。图源:Zeva-Ego 论文
03 Zeva-Ego到底有多能打?
Zeva-Ego 在受控实验里给出了几条很硬的结论。
第一,Ego 数据确实在形成一条新的 Scaling 曲线。从同一个基础模型出发,Ego 中训练数据从零扩展到 1 万小时,RoboTwin 成功率从 63.8% 提升到 75.3%,提升 11.5 个百分点,而且没有看到饱和。
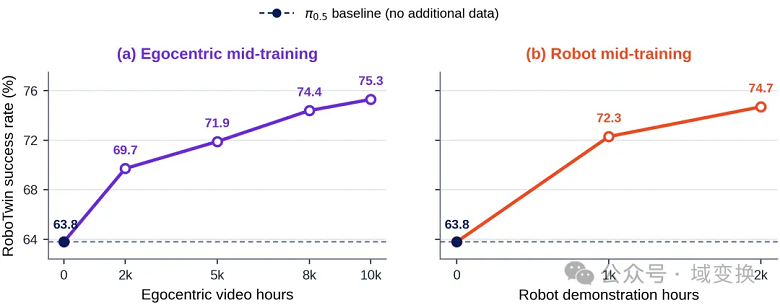
图5|Ego 数据 Scaling:从同一个 π0.5 基础 checkpoint 出发,先做 Ego 中训练,再做统一的 RoboTwin 后训练;Ego 数据从 0 到 1 万小时,成功率从 63.8% 提升到 75.3%。图源:Zeva-Ego 论文
第二,Ego 数据可以量化替代真机数据。在取得相近下游增益的区间里,4—5 小时人类第一视角数据,约等于 1 小时机器人真机数据。
第三,它对真机低数据场景帮助最大。在真实化学实验室 ChemLab-Evo 上,只给 10 条机器人示范时,PickTube 成功率提升 70 个百分点,PlaceBottle 提升 60 个百分点;在 20 条示范时,PourLiquid 提升 20 个百分点。
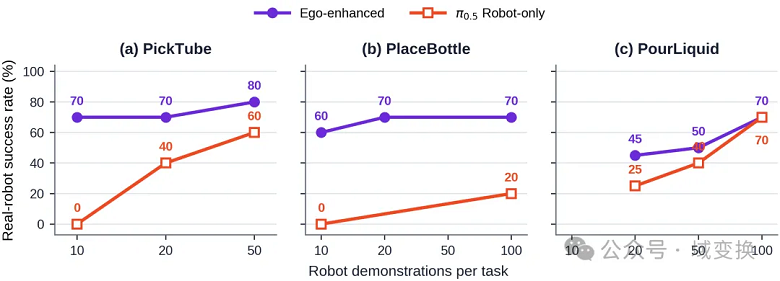
图6|真机数据效率:固定 50 条任务匹配 Ego 片段,只改变机器人示范数量;机器人数据越少,Ego 增强越明显。图源:Zeva-Ego 论文
第四,Ego 数据的价值不只是“时长”,更是“多样性”。在同等训练预算下,任务语义覆盖从 5 个任务簇扩展到约 1,000 个任务簇,RoboTwin 成功率从 65.7% 提升到 70.2%。
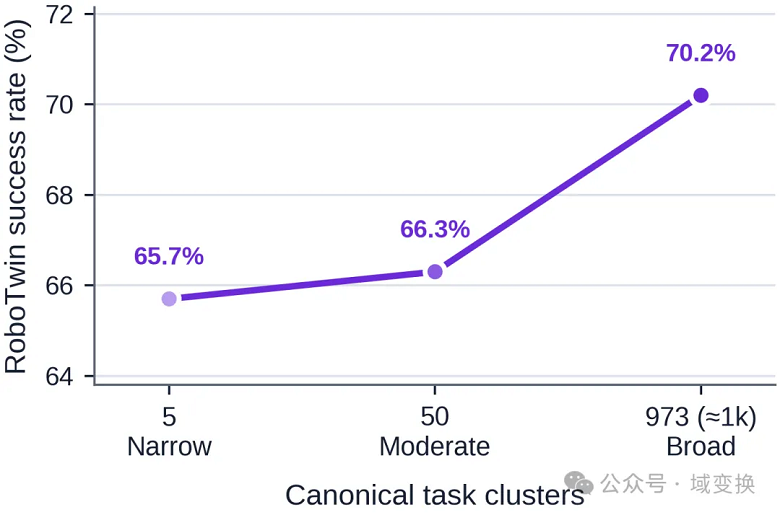
图7|任务多样性的影响:同等预算下,任务簇从 5 到 50 再到 973,RoboTwin 成功率从 65.7% 提升到 70.2%。图源:Zeva-Ego 论文
这条结论很关键:真正能迁移的物理常识,来自广泛、长尾、多样的人类操作经验,而不是对少数任务反复训练。
对行业来说,这意味着机器人数据的护城河正在变化。未来最值钱的数据,可能不是自有机器人回传的轨迹,而是能否把海量、低成本、多样化的人类视频,转化成机器人可消费的物理先验。
04 两版模型,清华AIR和“域变换”到底做到了什么?
Zeva 和 Zeva-Ego 把具身智能落地路上的两块拼图放上了桌面。
第一次发布 Zeva,做到的是:让机器人在部署后,从自己的真实交互中学习。模型不更新参数,也能把每一次动作、结果和失败,变成下一次决策的依据。它把“部署后自进化”从一个概念,变成了可验证的结果。
这一次发布 Zeva-Ego,做到的是:把自进化的起点抬高一个量级。它用约 1 万小时人类第一视角视频,建设大规模 Ego 中训练数据,让机器人先获得更通用、更低成本、更可规模化的物理先验;再把 Zeva 的因果记忆接入 VLA 的 Action Expert,让高层理解保持稳定,低层动作在真实部署中持续优化。
所以,两次发布连起来,答案很清晰:Zeva 证明了机器人可以越用越强;Zeva-Ego 证明了这种越用越强,可以建立在大规模人类数据带来的物理先验之上。
它们共同指向同一件事:机器人不止要会做,更要越做越好、越做越可靠。
05 为什么这件事值得关注?
因为它改变的不只是模型指标,而是机器人的商业模型。
过去,客户买的是一台机器人、一套模型、一个项目制交付。每换一个场景,就要重新采集、重新训练、重新调试。技术很先进,但 ROI 很难算。
当模型可以在大规模人类数据上获得通用物理先验,又能在部署后持续自进化,商业模式就会从“卖机器”转向“卖持续增长的生产力”。
客户不再为技术名词买单,只为真正能跑通 ROI 的结果买单:任务是否稳定完成、人工接管是否减少、部署成本是否下降、产出是否持续提高。
这背后是一条数据飞轮:
部署越多 → 真实交互越多 → 因果经验越丰富 → 新场景适配成本越低 → 部署更多。
而 Zeva-Ego 所代表的,正是 Model-Agent-Infra 完整体系中的模型层:模型负责变强,Agent 负责把能力用起来,Infra 负责让自进化跑得更快、更省、更可扩展。
06 结语:部署元年,由“越用越好”定义
具身智能可能不会像 ChatGPT 那样,突然出现一个单点时刻。
它更像 Waymo 走过的路径:可靠性、部署能力、成本结构逐步跨过临界点,机器人悄然进入越来越多的真实岗位。
下一阶段的竞争,不会再只是“谁的模型更大”,而是两条曲线同时展开:
一条是训练前的物理先验曲线,一条是部署后的经验进化曲线。
Zeva-Ego 背后所展示的是清华AIR和域变换的思考:机器人落地缺的不是又一个更大的模型,而是把这两条曲线接在一起。用人类第一视角视频规模化地抬高物理先验,再用因果记忆把每一次真实交互变成下一次的能力。
预训练让机器人从不会到会做。
自进化让机器人从会做到做好,越做越好。
而 Zeva-Ego,正在把这两件事连成一条路。
项目信息
- 项目名称:Zeva-Ego
- 发布机构:清华 AIR、域变换 Z-Trans
- 论文题目:Zeva-Ego: Egocentric Mid-Training with In-Context Causal Learning for Robot Manipulation
「免责声明」:以上页面展示信息由第三方发布,目的在于传播更多信息,与本网站立场无关。我们不保证该信息(包括但不限于文字、数据及图表)全部或者部分内容的准确性、真实性、完整性、有效性、及时性、原创性等。相关信息并未经过本网站证实,不对您构成任何投资建议,据此操作,风险自担,以上网页呈现的图片均为自发上传,如发生图片侵权行为与我们无关,如有请直接微信联系g1002718958。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献222条内容

所有评论(0)