【LLM】第七章:LangChain中的消息、提示词模板、工具的使用
【LLM】第七章:LangChain中的消息、提示词模板、工具的使用
一、本章要讲解的内容:消息和提示词模板
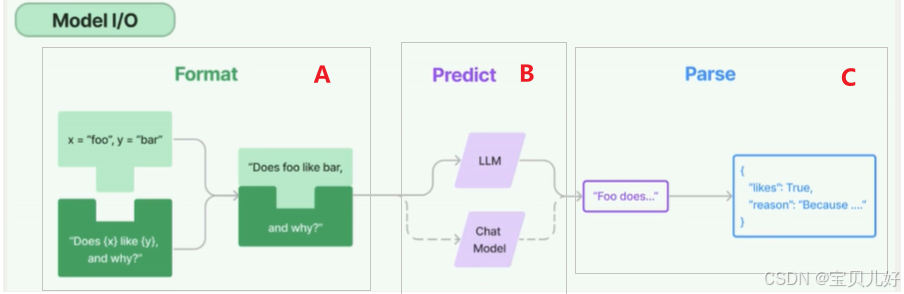
上图是我们和大模型交互的流程,分A、B、C三部分:
A是用户喂入大模型的提示词。对提示词进行格式封装的称为提示词模板,本章节讲这部分。
B是大模型本模,也叫基座,目前都以对话模型为主。大模型创建和调用请参考:【LLM】第六章:LangChain框架中的大模型的创建与调用-CSDN博客 。
C是大模型的输出,因为大模型本身的输出格式,不一定是用户想要的输出格式,比如我们想让大模型输出字符串格式或者json格式或者其他指定的格式,那此时就得把大模型的输出进一步解析(Parse)才能得到我们想要的特定输出格式。这部分内容后面章节会单独讲。
二、langchain的消息对象
在langchain中,消息(Message)是模型交互的基本单元。Message标准可以保证,不同的模型(无论你使用的是OpenAI、Anthropic、Gemini还是本地大模型)的消息格式自动对齐,提供一致的上下文数据结构。
1、消息的构成
一轮大模型对话,由一条或多条Message构成。每个Message包括三种字段:
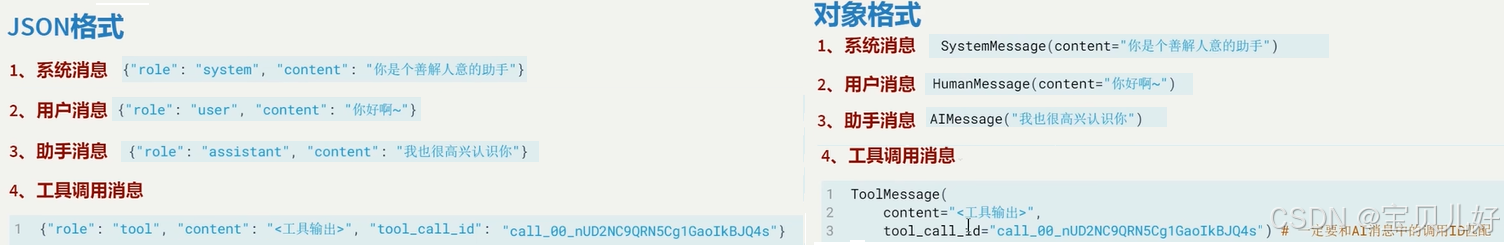
(1)Role:消息所属的角色。目前共有4种角色:system、user、assistant、tool。
system表示这是系统消息,用于在用户对话开始时给模型设定的角色、行为准则和上下文背景。
user表示这是用户信息,也就是用户喂入模型的提示词prompt,可是是文本、图片、音频、文档等,也叫user message。
assistant是模型的回复,就是模型生成的文本、工具调用、元数据等,也叫AI message。
tool是工具调用信息。
(2)content:文本内容,就是说了什么。
(3)metadata:元数据字段,描述上下文状态的元信息,比如名称、时间戳、对话角色、轮次ID等,用于保持对话的一致性和可追踪性。matadata字段属于自定义的字段,用于对消息进行区分。所以这个数据的字段名取决于模型提供商,需要查看官方手册。
2、消息格式
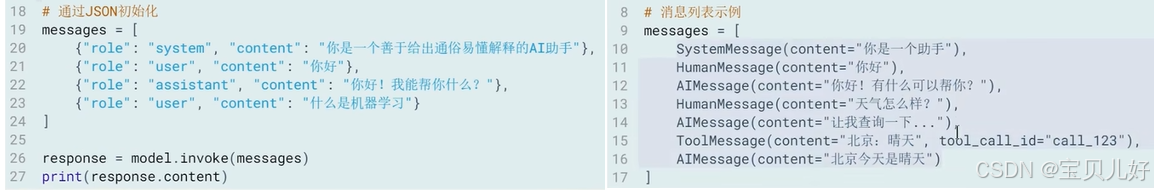
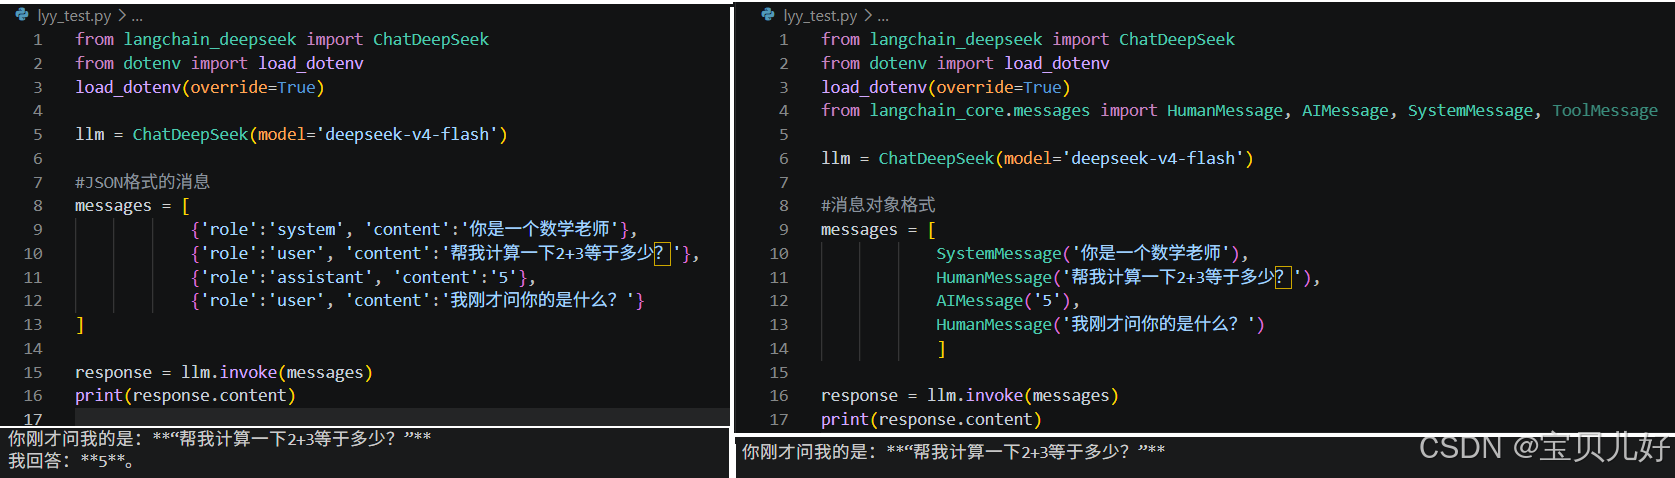
langchain支持JSON格式和对象格式的信息:
三、记忆:对话历史管理
上面例子是一轮大模型对话的输入和输出。我们知道大模型是没有记忆功能的,那要使多轮对话是连贯一致的,我们就要把每次对话的历史信息都记下来,每次对话都拿着所有前面轮次的对话内容+本论内容,一起喂入大模型,此时大模型返回的内容就是具有记忆的回答。
但是随着问答轮次的增加,对话历史会越来越长,消耗的token和时间成本也会更大,所以我们一般都是:
一是,保留所有的system消息,因为这是定义对话角色的。
二是,保留最近N论对话,丢弃更早的对话历史。
根据这个思路,我们这里写一个多轮对话聊天机器人的示例:
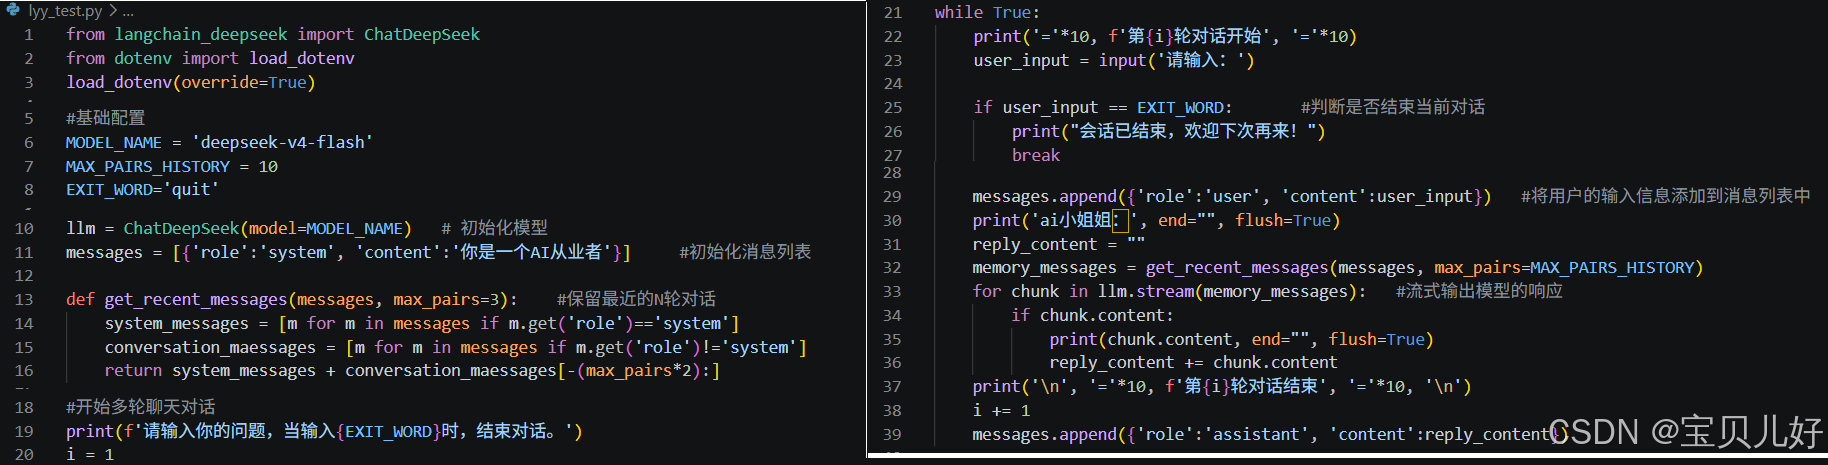
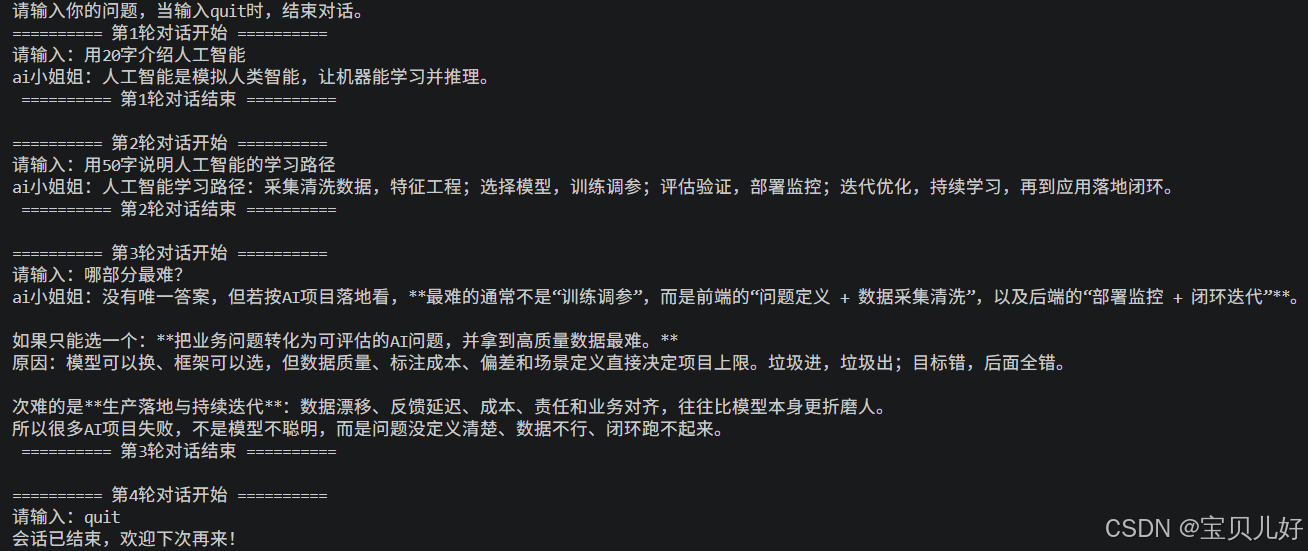
from langchain_deepseek import ChatDeepSeek
from dotenv import load_dotenv
load_dotenv(override=True)

#基础配置
MODEL_NAME = 'deepseek-v4-flash'
MAX_PAIRS_HISTORY = 3
EXIT_WORD='quit'

llm = ChatDeepSeek(model=MODEL_NAME)   # 初始化模型
messages = [{'role':'system', 'content':'你是一个AI小姐姐'}]     #初始化消息列表

def get_recent_messages(messages, max_pairs=3):    #保留最近的N轮对话
    system_messages = [m for m in messages if m.get('role')=='system']
    conversation_maessages = [m for m in messages if m.get('role')!='system']
    return system_messages + conversation_maessages[-(max_pairs*2):]

#开始多轮聊天对话
print(f'请输入你的问题,当输入{EXIT_WORD}时,结束对话。')

i = 1
while True:
    print('='*10, f'第{i}轮对话开始', '='*10)
    user_input = input('请输入:')

    if user_input == EXIT_WORD:       #判断是否结束当前对话
        print("会话已结束,欢迎下次再来!")
        break

    messages.append({'role':'user', 'content':user_input})   #将用户的输入信息添加到消息列表中
    memory_messages = get_recent_messages(messages, max_pairs=MAX_PAIRS_HISTORY)
    #print('-----messages--------', messages)
    #print('---memory_messages---', memory_messages)

    print('ai小姐姐:', end="", flush=True)
    reply_content = ""
    for chunk in llm.stream(memory_messages):   #流式输出模型的响应
        if chunk.content:
            print(chunk.content, end="", flush=True)
            reply_content += chunk.content
    print('\n', '='*10, f'第{i}轮对话结束', '='*10, '\n')
    i += 1
    messages.append({'role':'assistant', 'content':reply_content})from langchain_deepseek import ChatDeepSeek
from dotenv import load_dotenv
load_dotenv(override=True)

#基础配置
MODEL_NAME = 'deepseek-v4-flash'
MAX_PAIRS_HISTORY = 3
EXIT_WORD='quit'

llm = ChatDeepSeek(model=MODEL_NAME)   # 初始化模型
messages = [{'role':'system', 'content':'你是一个AI小姐姐'}]     #初始化消息列表

def get_recent_messages(messages, max_pairs=3):    #保留最近的N轮对话
    system_messages = [m for m in messages if m.get('role')=='system']
    conversation_maessages = [m for m in messages if m.get('role')!='system']
    return system_messages + conversation_maessages[-(max_pairs*2):]

#开始多轮聊天对话
print(f'请输入你的问题,当输入{EXIT_WORD}时,结束对话。')

i = 1
while True:
    print('='*10, f'第{i}轮对话开始', '='*10)
    user_input = input('请输入:')

    if user_input == EXIT_WORD:       #判断是否结束当前对话
        print("会话已结束,欢迎下次再来!")
        break

    messages.append({'role':'user', 'content':user_input})   #将用户的输入信息添加到消息列表中
    memory_messages = get_recent_messages(messages, max_pairs=MAX_PAIRS_HISTORY)
    #print('-----messages--------', messages)
    #print('---memory_messages---', memory_messages)

    print('ai小姐姐:', end="", flush=True)
    reply_content = ""
    for chunk in llm.stream(memory_messages):   #流式输出模型的响应
        if chunk.content:
            print(chunk.content, end="", flush=True)
            reply_content += chunk.content
    print('\n', '='*10, f'第{i}轮对话结束', '='*10, '\n')
    i += 1
    messages.append({'role':'assistant', 'content':reply_content})
待续。。。。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)