π0VLA论文阅读
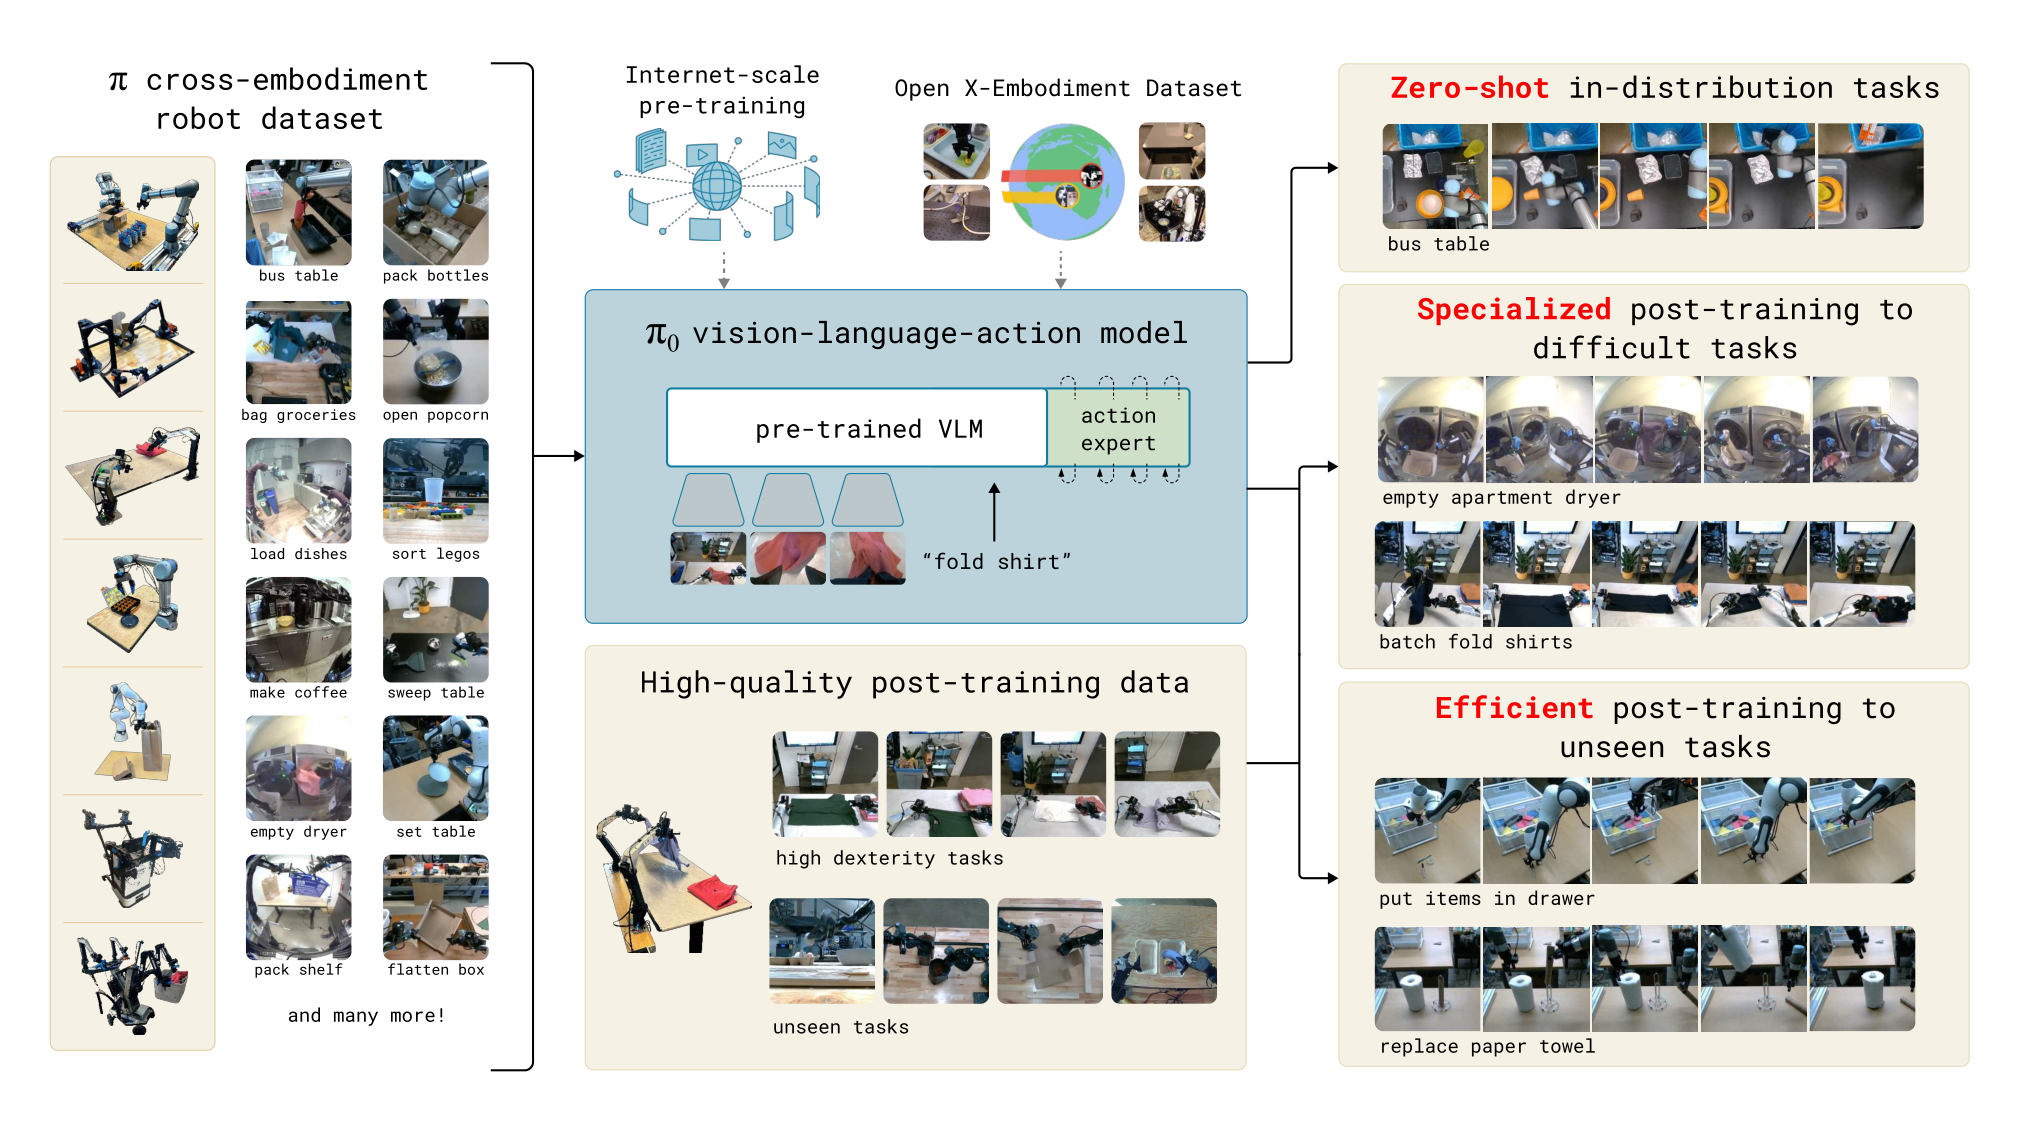 模型架构:
1、Π模型采用了预训练的VLM骨干模型,结合了包含多任务的跨体数据集。
2、添加了独立的动作专家,通过流匹配生成连续动作,从而实现精准连续的操作技能。(流匹配是连续生成模型,属于扩散模型的变体,π₀用它来生成机器人连续动作序列。)
3、为了实现对各类多样化机器人数据源的利用,采用了跨 embodiment 训练,即将多种机器人类型的数据整合到同一模型中。
4、精心设计的训练方案,即先让模型在规模庞大、内容多样的语料库上进行预训练,再在更细分、经过精心筛选的数据上进行微调,以诱导出期望的行为模式。
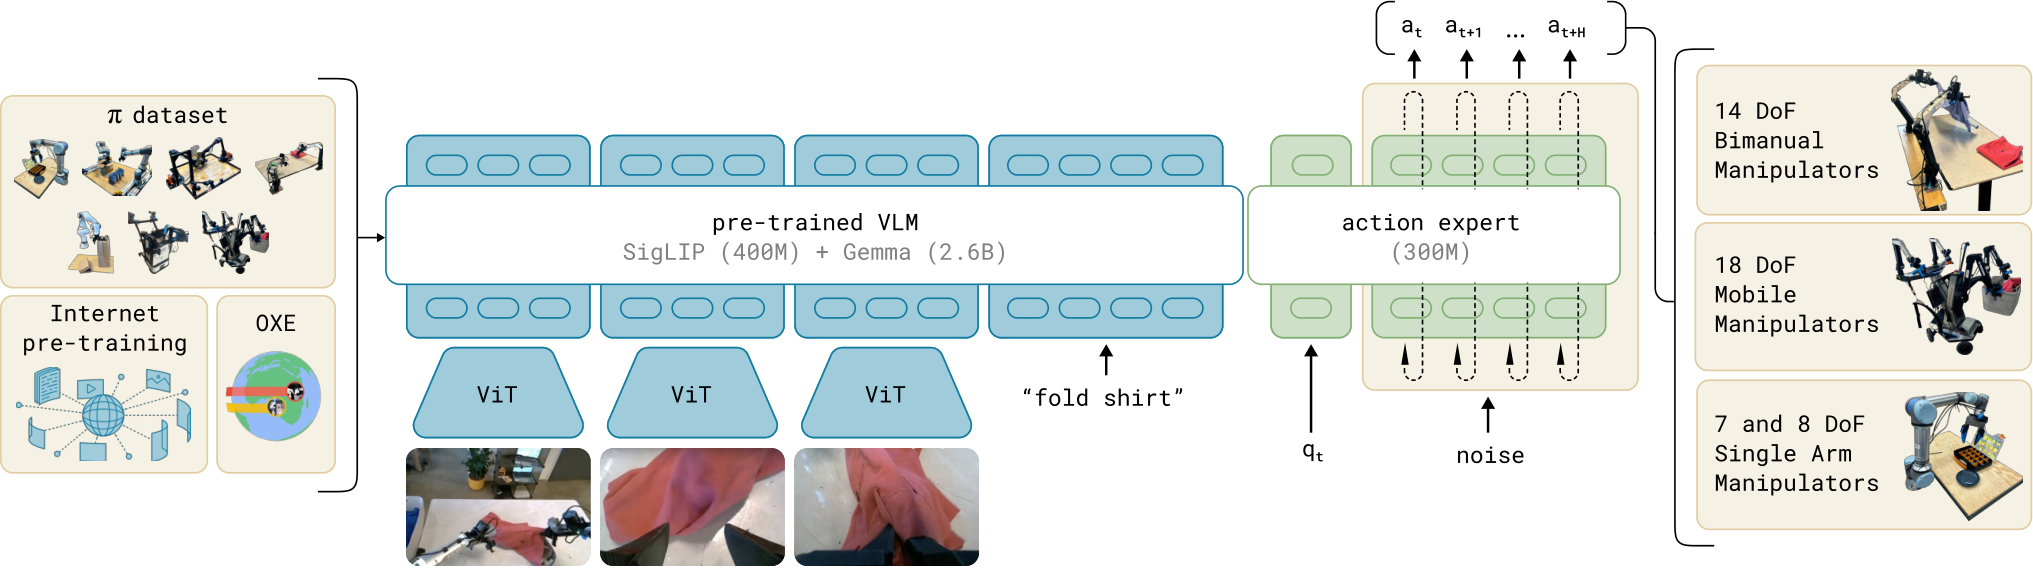
训练方式:
1、首先进行预训练,使用了大规模的混合数据集(不同机器人、不同任务),其目的是训练一个具备广泛能力和泛化性的基础模型。
2、针对复杂灵巧任务,采用了两种后训练方式:一是利用小到中等规模数据的高效后训练,二是针对叠衣服、移动操作等复杂任务,采用大规模数据集的高质量后训练。
3、对数据内容进行的处理:将机器人的关节角度状态q与预测动作设置为训练过程中维度最大的机器人一致,实验中是18维(机器人关节角度和预测动作的维度是相同的,理论上机器人有多少关节就应预测多少个关节的动作)。对于配置和空间维度低于18维度的机器人,对训练数据进行0填充,同样对于图像数量少于三个的机器人,对缺失的图像进行掩码mask处理。掩码mask与空白图像的区别,如果使用空白图像,模型会将空白图像作为信息纳入注意力计算,使用mask则直接屏蔽掉这个图像token,不影响模型的注意力以及计算损失。为什么不对动作也进行mask?而是进行补零?ai的回答是动作属于整个token,不同的维度数据属于token内部的形态,如果对token内部mask,模型会学习到错误的输入输出维度,导致损失计算时发生错误,但是为了避免模型学习到维度数据为0的地方,在计算loss的时候将这部分mask掉不参与计算。
数据形式:
1、对输入模型的数据分布进行建模,(1)机器人观测得到的多张RGB图像,(2)文本语言(3)关节角度向量。其中图像与关节角度向量首先通过对应编码器进行编码,再经过线性投影层映射到与语言标记相同的嵌入空间中。
2、动作专家训练,通过流匹配进行训练,训练中得到50个未来动作块,代表50HZ,一秒的连续轨迹。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)