JEPA-WAM 深度解读:让机器人学会预测世界的变化
0. 简介
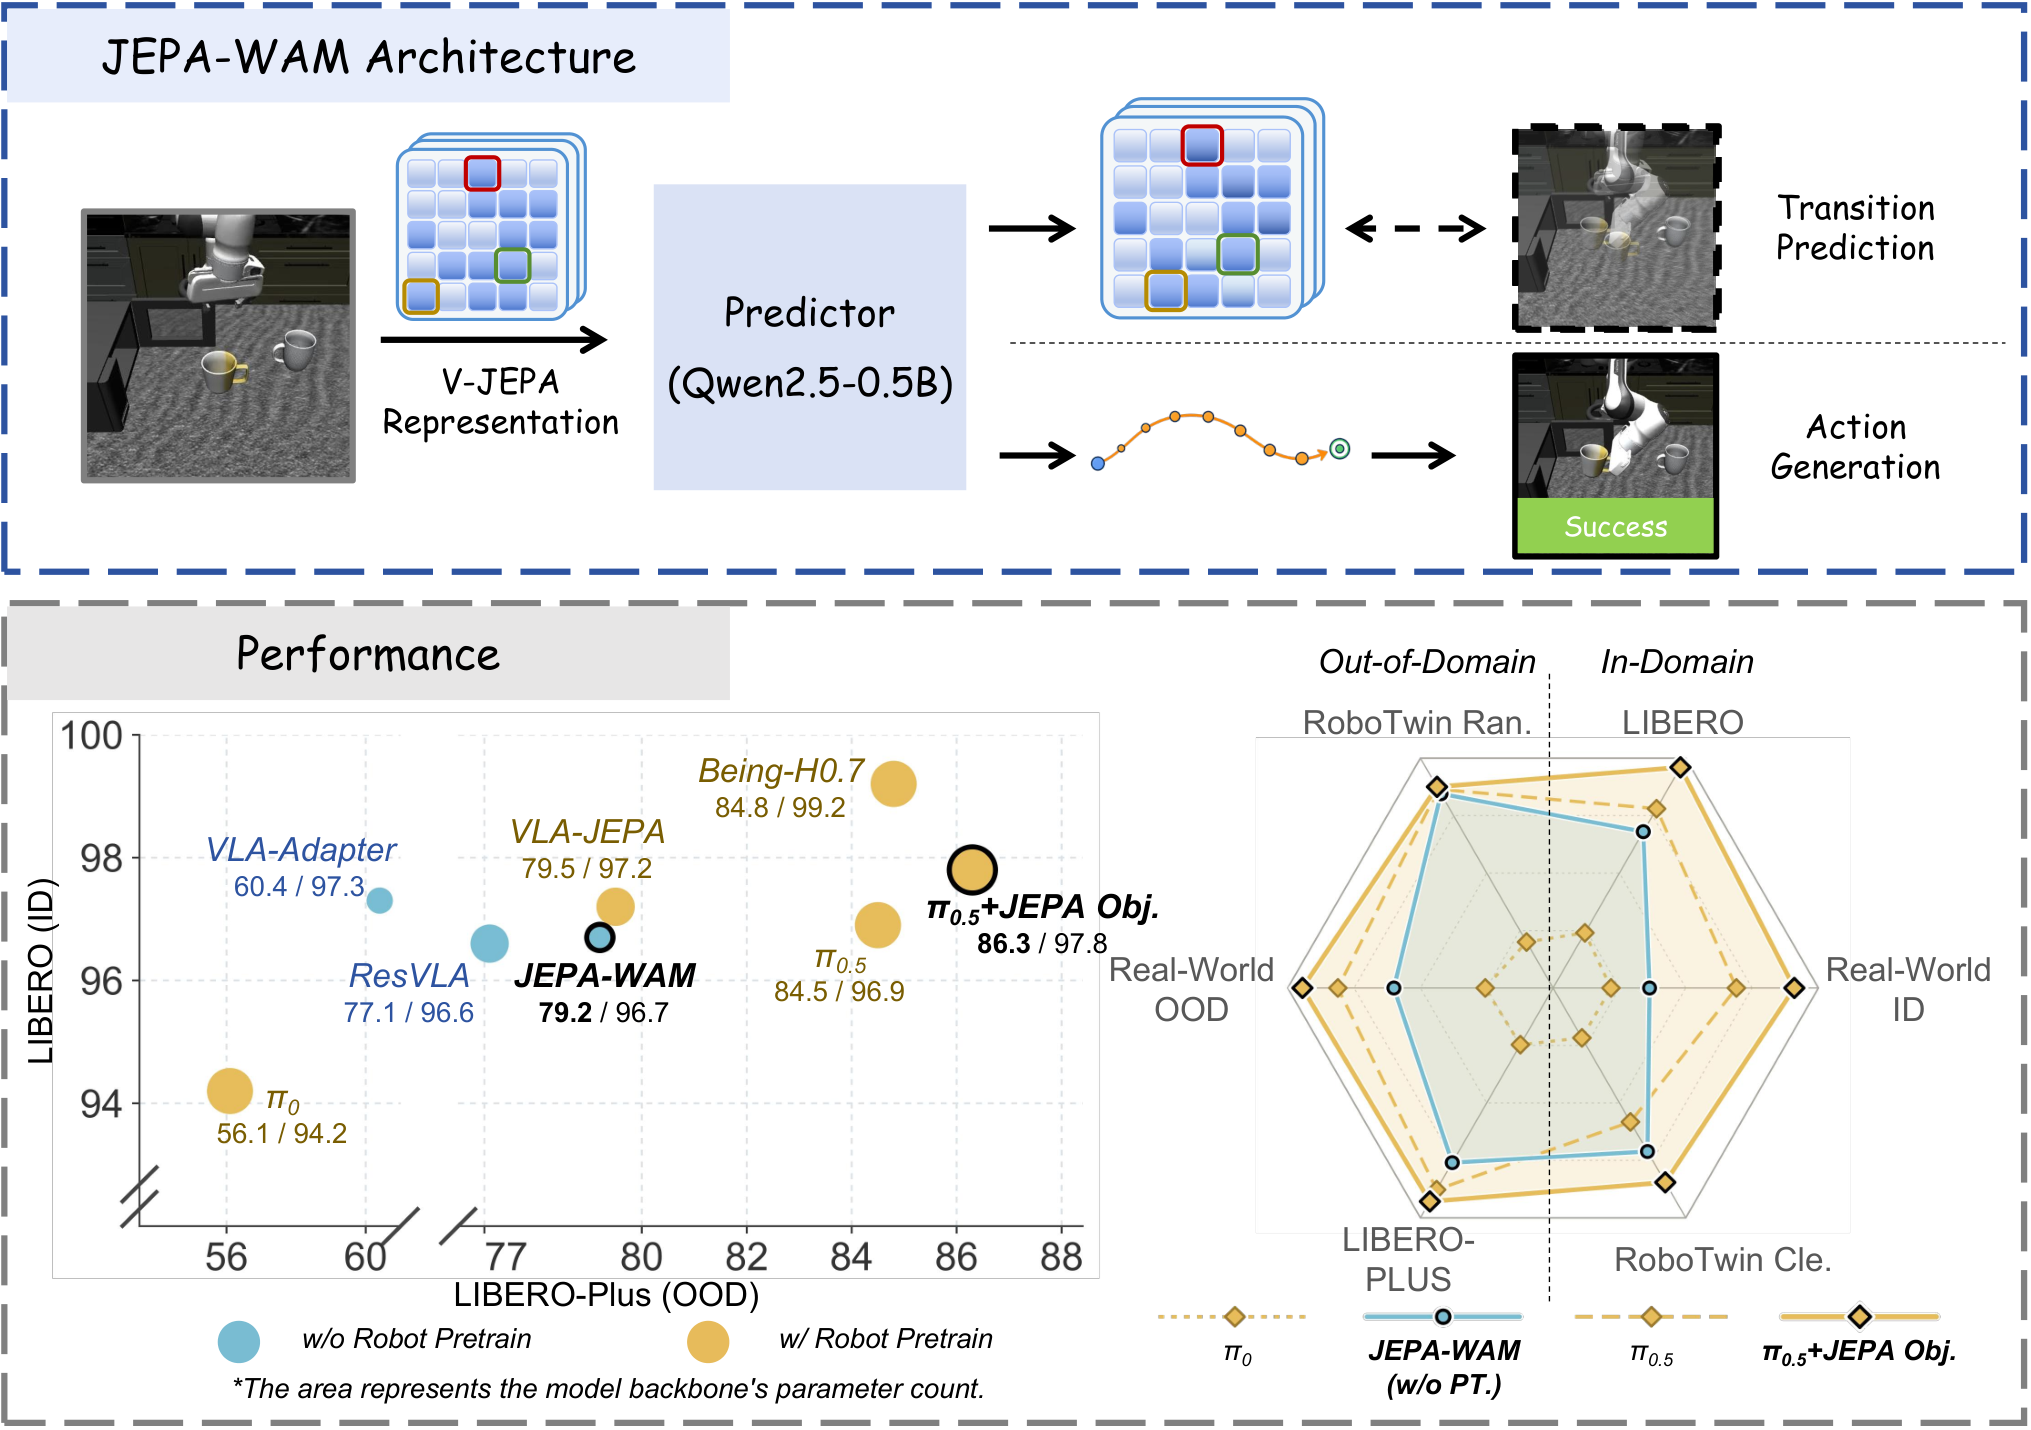
JEPA-WAM 面向视觉语言动作(VLA)机器人在相机、背景、物体布局变化下容易失效的问题,研究如何在不生成未来视频的前提下,把“当前状态将怎样变化”的信息用于动作控制。它以冻结的 V-JEPA 2.1 作为视觉表示空间,把当前帧与未来帧联合编码为保留 patch 对应关系的转移目标,再用一个共享预测器同时承担潜在状态转移预测和动作条件提取。LIBERO-Plus 上,未使用大规模机器人策略预训练的 JEPA-WAM 达到 79.2%,迁移到预训练 π 0.5 \pi_{0.5} π0.5 后达到 86.3%;RoboTwin 2.0 与真实双臂实验也显示,训练期的转移监督可以改善视觉和空间分布偏移下的稳定性。下文从问题背景、结构、损失、代码实现、实验和局限逐层拆解这套方法。
为了让没有接触过 WAM 的读者先建立坐标,可以把一次机器人操作看成一段短视频:第一帧描述手、物体和容器的相对位置,中间帧包含接触、遮挡和移动,最后一帧体现任务是否完成。普通 VLA 主要用第一帧和动作标签学习映射,JEPA-WAM 则额外要求模型从第一帧推断这段变化在视觉表示中应当留下什么痕迹。它并不要求预测唯一的像素画面,因此不会把文章重点变成视频生成,而是把“哪些局部关系会改变”作为策略学习的辅助坐标。
1. 研究问题与方法缺口
1.1 VLA 的动作相关性困境
一个典型 VLA 在训练时接收图像、语言指令和机器人状态,直接回归下一段动作。这样的目标很有效,却容易把“观测长什么样”和“应该采取什么动作”绑定成统计相关性。只要测试时更换相机高度、光照、背景纹理或物体初始位置,原先学到的相关性就可能失效。核心问题在于,动作损失并没有强迫模型解释状态从 t t t 到 t + δ t+\delta t+δ 的演化过程,模型知道“现在做什么”,却未必形成稳定的视觉动态表征。
这里的失败并不意味着 VLA 没有视觉能力,而是说明它可能依赖了训练环境中的捷径。例如训练集里杯子总是出现在画面右侧,模型便可能把“右侧出现圆形物体”当成抓取线索;当杯子被移到左侧,动作输出就会失去原来的参照。世界模型监督的作用,是让表示更多关注物体之间的相对位置、接触前后的局部变化和动作造成的结果,从而削弱对背景和固定构图的依赖。泛化不是凭空增加记忆量,而是改变模型在观测中选择什么作为因果线索。
1.2 WAM 的计算代价与潜在表示选择
World Action Model(WAM)把未来状态建模加入策略,常见路线是生成未来视频,再依据想象结果输出动作。像素级生成需要多步采样和较大的显存,部署时延很难满足双臂操作的控制频率。Latent WAM 把预测移到表示空间,避免了未来帧重建,但又出现两个选择:压缩成少量 token 会损失局部空间结构,只预测 future-only 表示则更像回答“未来在哪里”,而不是描述“当前到未来发生了什么”。JEPA-WAM 的问题定义,就是在预测成本和转移信息之间找到可训练、可部署的折中。
难点提示:把未来视频换成潜在向量,类似驾校练车时不再要求学员画出整条道路,而是判断车道线、障碍物和方向变化。表示太粗会看不见路边的小障碍,表示太细又会变成昂贵的逐帧绘画;patch 级目标正是在两者之间保留足够的空间线索。
1.3 论文在路线图中的位置
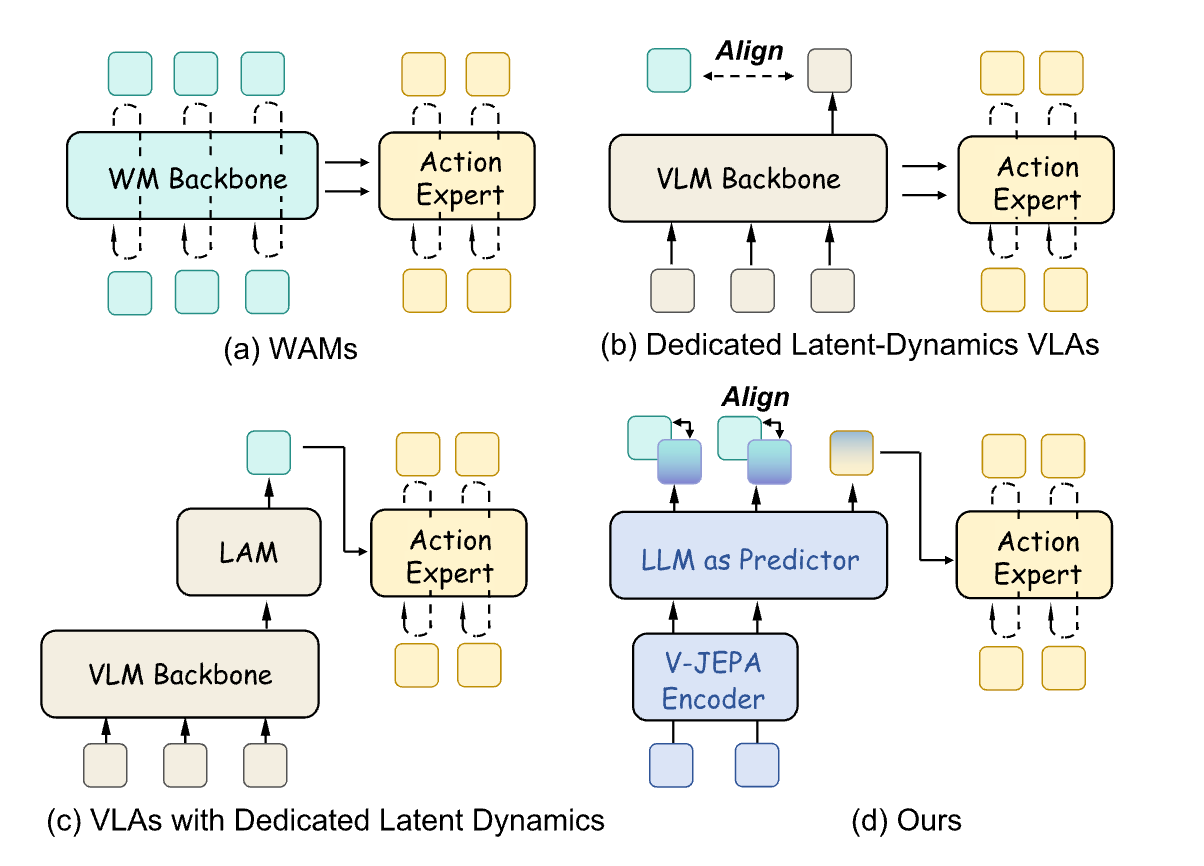
VLA、视频 WAM 和 Latent WAM 可以看作三条相交路线。
π
0
π_0
π0、OpenVLA 等方法重点提升视觉语言到动作的映射;WorldVLA、Causal World Modeling 通过未来观测显式建模因果状态;Fast-WAM、Being-H0.7、LaWAM 等工作则尝试在潜在空间或压缩 token 中降低推理成本。JEPA-WAM 的差异在于:它使用预训练 V-JEPA 的联合时序编码构造目标,并把转移预测直接放在动作 backbone 的共享预测器上,不是把世界模型当成动作策略旁边的一条独立支路。
2. 整体框架
2.1 输入、表示与输出
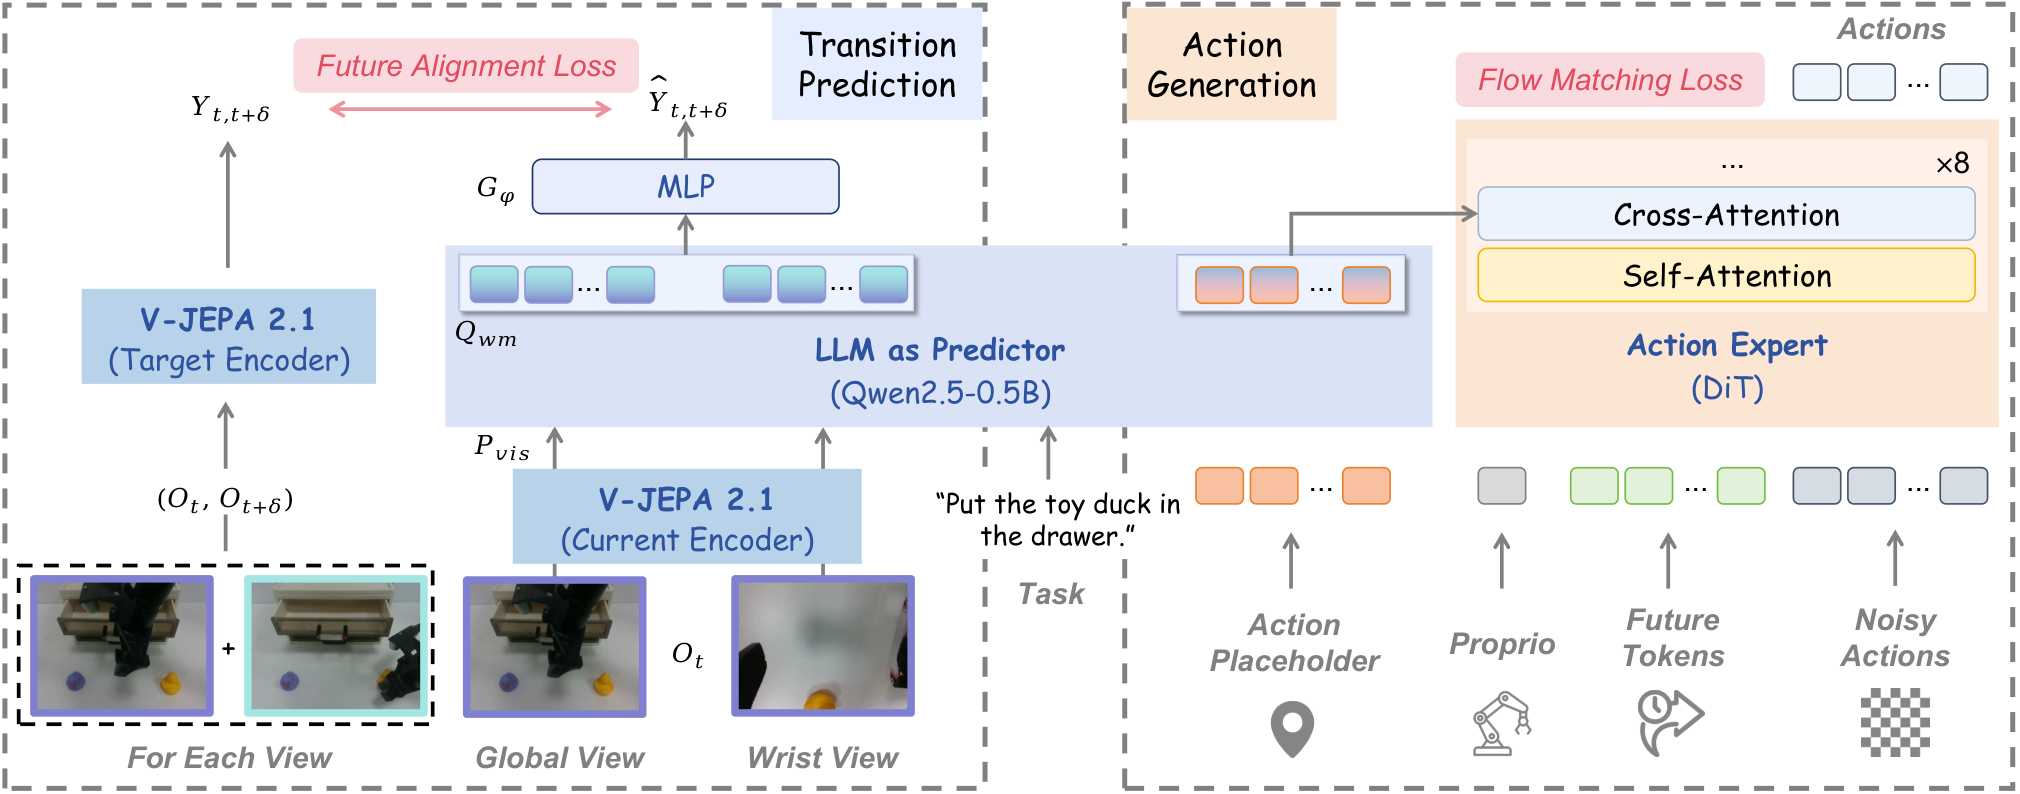
在时刻 t t t,模型输入多视角图像 O t v O_t^v Otv、语言指令 ℓ \ell ℓ、本体状态 s t s_t st。冻结的 V-JEPA 编码器逐视角提取 24 × 24 24\times24 24×24 的 patch 特征,再按固定相机顺序拼接为 Z t ∈ R N v i s × 1024 Z_t\in\mathbb{R}^{N_{vis}\times1024} Zt∈RNvis×1024。Qwen2.5-0.5B 作为共享预测器,接收投影后的视觉 token、语言 token 和 64 个 action placeholder;视觉位置输出用于预测联合目标,placeholder 输出 C t C_t Ct 交给 DiT action expert,生成长度为 H H H 的连续动作块。
读者可以把这套结构分成三个层次理解。第一层是 V-JEPA,它把原始像素转换为带有空间网格的视觉词汇;第二层是 Qwen 共享预测器,它把视觉词汇和语言指令放在同一个上下文中,形成任务相关的隐藏状态;第三层是 DiT action expert,它不再理解整幅图像,而是根据 C t C_t Ct 和本体状态生成连续控制序列。这样的分层让每个模块承担清晰职责,也解释了为什么论文可以冻结大部分预训练参数,只训练 LoRA、转移头和动作专家。
2.2 训练分支与部署分支
训练时还需要未来观测 O t + δ O_{t+\delta} Ot+δ,两帧被 V-JEPA 联合编码得到 Y t , t + δ Y_{t,t+\delta} Yt,t+δ,转移预测头输出 Y ^ \hat Y Y^ 并计算 patch-wise cosine loss。部署时不存在未来图像,目标分支和预测头被移除,只保留当前视觉编码、共享预测器与动作专家;动作专家从高斯噪声开始,用四步 Euler 积分得到动作块。训练期增加世界监督,推理期不增加未来想象,是这套设计能落地的关键不对称。
如果把训练和部署画在同一张图上,最容易产生的误解是“机器人运行时也要先看未来”。实际上,未来帧只是训练数据中的教师信号,用来告诉共享预测器什么样的表示更接近真实状态演化;运行时模型只根据当前观测输出动作。这个设计类似用带答案的模拟器训练驾驶员,真正上路时并不会把模拟器装进车里。它既降低了在线延迟,也避免因为未来预测误差叠加而把错误传递给动作控制器。
3. 核心机制一:联合当前–未来目标
3.1 为什么要联合编码
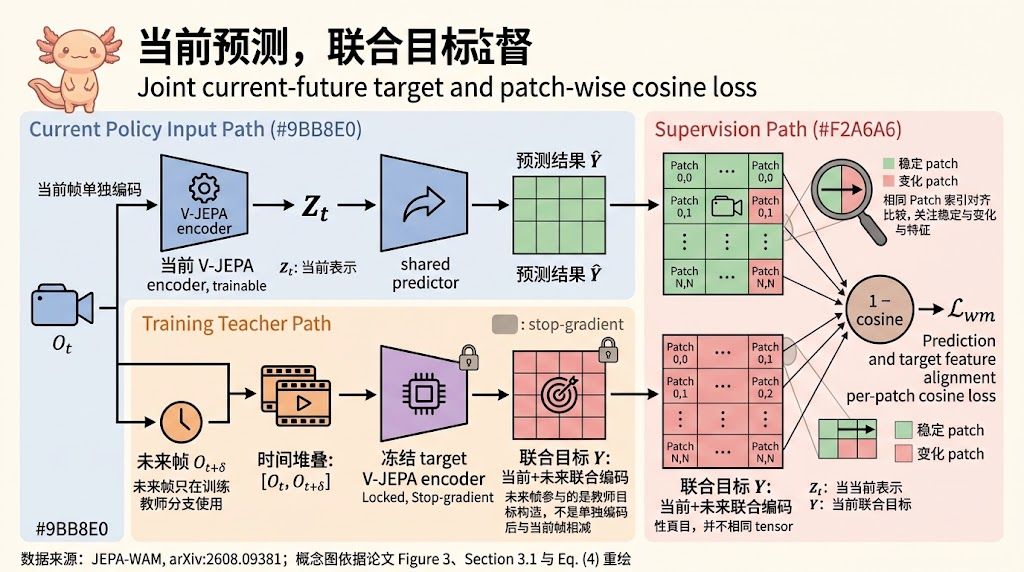
V-JEPA 的优势不只是输出一个未来向量,而是能在视频预训练中形成时间一致的视觉表征。JEPA-WAM 将同一视角的当前帧和未来帧沿时间维堆叠,再一次送入冻结编码器。这样编码器在得到目标时同时看到两个端点,表示可以把稳定区域、发生变化的区域以及局部关系重构放在同一个坐标系中。与独立编码后做差相比,联合编码不要求模型手工定义“变化就是减法”,能够保留更丰富的时序关系。
“联合”二字的含义并不是简单地把两张图片在通道维拼接,然后交给一个普通 CNN。V-JEPA 的视频 tokenizer 会把连续帧组织成时间 tubelet,编码器在训练中已经学过运动和外观的共同结构。当当前帧和未来帧组成一个两帧视频片段时,输出向量天然可以利用前后文判断一个 patch 是保持稳定、发生位移,还是因为遮挡而改变语义。因而,联合目标提供的是一种预训练视频模型已经熟悉的时序坐标,而不是研究者手工设计的像素差分规则。
这里必须把“目标构造”和“损失计算”分成两步。当前观测 O t O_t Ot 在策略路径中单独经过 V-JEPA 得到 Z t Z_t Zt,共享 predictor 再根据 Z t Z_t Zt 预测联合目标 Y ^ t , t + δ \hat Y_{t,t+\delta} Y^t,t+δ;训练教师路径则把当前帧 O t O_t Ot 与未来帧 O t + δ O_{t+\delta} Ot+δ 沿时间维堆叠后,一起送入冻结的 V-JEPA 得到 Y t , t + δ Y_{t,t+\delta} Yt,t+δ。最后才比较 Y ^ \hat Y Y^ 与 Y Y Y 的每个 patch,并计算 cosine loss。未来帧不是单独编码后与当前帧做减法,联合目标也不是未来图像本身;未来帧只在训练教师分支中参与联合编码。
3.2 Patch 级空间对应
对于每个相机视角,V-JEPA 输出固定的空间网格;多视角 token 按相机顺序拼接,因此预测结果的第 n n n 个 token 始终对应目标中的第 n n n 个 patch。这个约束让模型可以区分“杯子区域发生位移”和“桌面背景保持稳定”,而不是只得到一个全局平均变化。LIBERO 使用主视角和腕部视角,RoboTwin 再增加一个外部视角,所有视角都不做空间池化。空间结构不是可视化装饰,而是转移监督能定位局部变化的坐标系统。
Z t = Concat v ∈ V E J ( O t v ) , Y t , t + δ = Concat v ∈ V sg [ E J ( Stack t i m e ( O t v , O t + δ v ) ) ] . Z_t=\operatorname{Concat}_{v\in V}E_J(O_t^v),\qquad Y_{t,t+\delta}=\operatorname{Concat}_{v\in V}\operatorname{sg}\left[E_J\left(\operatorname{Stack}_{time}(O_t^v,O_{t+\delta}^v)\right)\right]. Zt=Concatv∈VEJ(Otv),Yt,t+δ=Concatv∈Vsg[EJ(Stacktime(Otv,Ot+δv))].
其中 E J E_J EJ 是冻结的 V-JEPA 2.1, V V V 是相机集合, sg \operatorname{sg} sg 表示停止梯度。 Y Y Y 与 Z Z Z 共享相机和 patch 顺序,因此后续可以逐 token 对齐。进一步看,这个顺序约束还让不同 batch 的监督具有可比性,训练过程不必额外学习相机排列或空间索引,也避免了预测头在相机切换时学习没有实际意义的 token 置换。
3.3 公开仓库中的配对目标构造
公开仓库先在 RLDS 轨迹变换中生成配对帧。它为每个时刻建立 [当前帧, 当前帧 + pair_target_offset] 两个索引,并在轨迹末端把越界索引截到最后一帧。所有以 image_ 开头且不是深度图的观测都会得到一个 pair_image_ 字段,因此主相机与腕部相机沿用同一套时间偏移规则。
# JEPA_WAM/prismatic/vla/datasets/rlds/traj_transforms.py
if pair_target_offset > 0:
    pair_indices = tf.broadcast_to(
        tf.constant([0, pair_target_offset], dtype=tf.int32),
        [effective_traj_len, 2],
    ) + tf.broadcast_to(
        tf.range(effective_traj_len, dtype=tf.int32)[:, None],
        [effective_traj_len, 2],
    )
    floored_pair_indices = tf.minimum(tf.maximum(pair_indices, 0), traj_len - 1)
    for key, value in old_obs.items():
        if key.startswith("image_") and not key.startswith("depth_"):
            traj["observation"][f"pair_{key}"] = tf.gather(value, floored_pair_indices)
这里的 floored_pair_indices 就是轨迹末端裁剪的真实实现。公开 LIBERO 配方把 pair_target_offset 固定为 31;随后 VLABatchTransform 将 pair_image_primary 和腕部配对帧转换为 pair_pixel_values。真正的 stop-gradient 不在数据层完成,而是在模型 forward 中由 torch.no_grad() 和后续的 detach() 共同保证。换句话说,数据管线只负责取对帧,模型层才负责把它变成不可反向更新的教师目标。
直觉理解:patch 对齐像在两张透明地图上使用同一套方格坐标。即使物体从左上格移动到右侧,模型仍然知道每个格子对应画面中的固定区域,不会因为全局池化而把局部移动平均掉。
4. 核心机制二:共享预测器与动作读取
4.1 Qwen 预测器承担两种角色
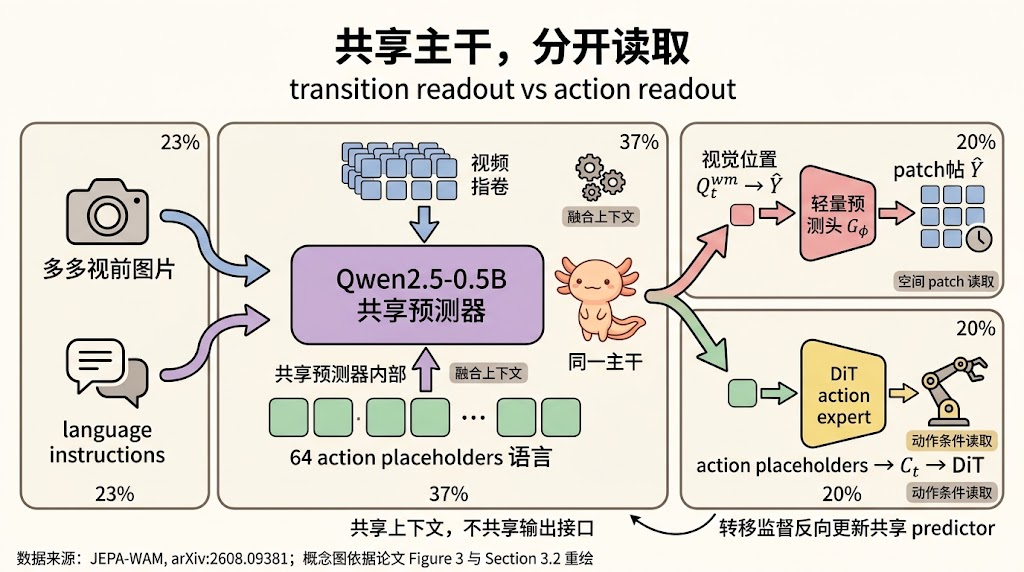
视觉 token 经过两层 projector 从 1024 维映射到 Qwen 的 896 维隐藏空间,随后与指令和 action placeholder 一起输入 Qwen2.5-0.5B。视觉位置隐藏状态 Q t w m Q_t^{wm} Qtwm 经过预测头回到 V-JEPA 空间,动作 placeholder 隐藏状态 C t C_t Ct 则作为动作条件。二者来自同一次前向,因而转移损失会直接更新动作生成所依赖的主干,而不是只训练一个动作无关的辅助网络。
这里的共享并不是让两个损失争抢同一组输出向量,而是让它们共享中间的上下文推理过程。视觉 token 需要保持 patch 的空间身份,语言 token 提供任务目标,action placeholder 则在序列末端读取已经融合的信息。转移分支关心“哪些视觉位置与未来结构对应”,动作分支关心“在这条指令下应该如何控制”,两个读出口不同但都受益于同一套跨模态上下文。这种接口设计是论文中最值得复用的工程经验之一。
更具体地说:共享预测器(Qwen backbone)在处理视觉 token、语言 token 和 action placeholder 时,会构建一个统一的、富含任务语义的隐藏状态序列。这个序列的前半部分(视觉 token 对应的隐藏状态)被用于预测联合目标( Q t w m Q_t^{wm} Qtwm),而后半部分(action placeholder 对应的隐藏状态)则被提取出来作为动作条件( C t C_t Ct)。两个损失( L w m \mathcal{L}_{wm} Lwm 和 L a c t \mathcal{L}_{act} Lact)虽然作用于不同的输出头(转移预测头和动作专家),但它们都通过反向传播来更新共享预测器内部的参数。这意味着,为了最小化转移损失,预测器必须学会从当前视觉输入中提取与未来状态变化相关的特征;同时,为了最小化动作损失,它也必须学会生成有利于动作生成的任务上下文。这两个目标在共享的中间表示层上形成了互补的监督信号,迫使模型学习一种既理解场景动态变化、又支持精确动作生成的通用表示。
一个直观的比喻:可以把共享预测器想象成一个多任务翻译器。视觉 token 像是源语言(视觉场景),语言指令是翻译要求(任务描述)。这个翻译器需要同时完成两项工作:1) 将当前场景“翻译”成未来场景的描述(转移预测);2) 根据任务描述,生成控制指令(动作生成)。虽然最终输出的“译文”格式不同(一个是 patch 向量,一个是动作轨迹),但它们都依赖于翻译器对源语言和任务要求的共同理解。这种共享的“理解”过程,正是模型获得泛化能力的关键——它不再仅仅记忆“看到A就做B”的固定映射,而是学会了“在场景A中,为了达成目标C,应该采取动作B,并且场景会如何变化”的更深层关联。
因此,JEPA-WAM 的共享机制本质上是通过一个多任务学习框架,将世界建模的监督信号直接注入到动作策略的主干网络中,而不是将其作为一个并行的、弱耦合的辅助模块。这确保了学到的动态表征能够直接服务于控制决策,从而在测试时遇到分布偏移(如视角、背景变化)时,策略仍能基于对场景动态的理解做出鲁棒的动作。
4.2 专用 action placeholder 防止目标冲突
如果把完整的最后一层 hidden states 都送给动作专家,转移预测希望保留空间细节,动作预测却更需要任务和控制上下文,两种目标可能互相争夺表示容量。论文的 Full hidden 消融在 LIBERO-Plus 上只有 73.1%,而使用专用 placeholder 的 JEPA-WAM 达到 79.2%。这个差异说明共享不等于完全混用:共享 backbone 负责知识交换,专用读取位置负责隔离输出接口。
( Q t w m , C t ) = F θ ( P v i s ( Z t ) , ℓ , P a c t ) , Y ^ t , t + δ = G ϕ ( Q t w m ) . (Q_t^{wm},C_t)=F_\theta(P_{vis}(Z_t),\ell,P_{act}),\qquad \hat Y_{t,t+\delta}=G_\phi(Q_t^{wm}). (Qtwm,Ct)=Fθ(Pvis(Zt),ℓ,Pact),Y^t,t+δ=Gϕ(Qtwm).
4.3 预测器与读取头的实现片段
这个源码没有单独定义早期草稿中用于讲解的 SharedPredictor 类,而是在 PrismaticVLM.forward 中完成视觉投影、序列拼接和双读取。序列顺序是 BOS、视觉 token、文本及末尾的 action placeholder;最终层中间的视觉区间成为 vision_memory,最后一段 placeholder 成为 action_memory。进一步看,这种写法也意味着共享预测器不是外挂模块,而是公开模型 forward 的主体路径。
# JEPA_WAM/prismatic/models/vlms/prismatic.py
projected_patch_embeddings = self.projector(patch_features)
projected_patch_attention_mask = torch.ones(
    projected_patch_embeddings.shape[:2],
    dtype=attention_mask.dtype,
    device=attention_mask.device,
)
input_embeddings = self.llm_backbone.embed_input_ids(input_ids)
fused_embeddings = torch.cat(
    [
        input_embeddings[:, :1, :],
        projected_patch_embeddings,
        input_embeddings[:, 1:, :],
    ],
    dim=1,
)
fused_attention_mask = torch.cat(
    [
        attention_mask[:, :1],
        projected_patch_attention_mask,
        attention_mask[:, 1:],
    ],
    dim=1,
)

llm_output = self.llm_backbone(
    input_ids=None,
    attention_mask=fused_attention_mask,
    inputs_embeds=fused_embeddings,
    labels=None,
    use_cache=False,
    output_hidden_states=True,
    return_dict=True,
)

llm_hidden = llm_output.hidden_states[-1]
vision_token_count = projected_patch_embeddings.shape[1]
vision_memory = llm_hidden[:, 1 : 1 + vision_token_count, :]
action_memory = self._select_action_memory(
    llm_hidden,
    fused_attention_mask,
    self.action_placeholder_tokens,
)
代码中的 vision_memory 对应论文符号
Q
t
w
m
Q_t^{wm}
Qtwm,action_memory 对应
C
t
C_t
Ct。_select_action_memory 在源码中直接截取序列末尾配置数量的 placeholder,并没有把完整 Qwen hidden sequence 交给动作头。公开训练配置再给 Qwen 挂 LoRA,训练 llm_backbone、action_head 和 visual_token_cosine_head;V-JEPA 编码器与预训练 projector 保持冻结。这里要厘清的是,LoRA 只改变可训练参数的组织方式,不改变双读取的数据流。
工程价值:这像在同一台机床上加工两种零件:主轴和导轨共享,夹具却分开。共享部分积累通用结构,专用夹具保证“预测状态”和“输出动作”不会因为接口混乱而互相拉扯。
5. 训练监督模块
5.1 Patch-wise cosine 转移损失
转移头输出的每个 patch 向量与冻结目标逐一计算 cosine 距离,再对 batch 和 token 求平均。cosine 距离关注方向而不是绝对幅值,适合比较预训练表示中的语义结构;逐 patch 聚合则保留了空间粒度。论文把 λ w m \lambda_{wm} λwm 设为 0.5,表示转移监督是重要辅助目标,但不会压过动作学习。
L w m = 1 B N v i s ∑ b = 1 B ∑ n = 1 N v i s ( 1 − cos ( Y ^ t , t + δ , n ( b ) , Y t , t + δ , n ( b ) ) ) . \mathcal{L}_{wm}=\frac{1}{BN_{vis}}\sum_{b=1}^{B}\sum_{n=1}^{N_{vis}} \left(1-\cos(\hat Y_{t,t+\delta,n}^{(b)},Y_{t,t+\delta,n}^{(b)})\right). Lwm=BNvis1b=1∑Bn=1∑Nvis(1−cos(Y^t,t+δ,n(b),Yt,t+δ,n(b))).
# JEPA_WAM/prismatic/models/action_heads.py
class VisualTokenCosineHead(nn.Module):
    def __init__(self, d_llm: int, d_target: int) -> None:
        super().__init__()
        self.fc1 = nn.Linear(d_llm, 2 * d_target, bias=True)
        self.act_fn1 = nn.GELU()
        self.fc2 = nn.Linear(2 * d_target, d_target, bias=True)
        self.apply(self._initialize_weights)

    @staticmethod
    def _initialize_weights(module: nn.Module) -> None:
        if isinstance(module, nn.Linear):
            nn.init.xavier_uniform_(module.weight)
            if module.bias is not None:
                nn.init.zeros_(module.bias)

    def align_dimension(self, llm_embedding: torch.Tensor) -> torch.Tensor:
        return self.fc2(self.act_fn1(self.fc1(llm_embedding)))

    @staticmethod
    def compute_align_loss_cosine(prediction: torch.Tensor, target: torch.Tensor) -> torch.Tensor:
        prediction = F.normalize(prediction, dim=-1)
        target = F.normalize(target, dim=-1)
        return (1 - (prediction * target).sum(dim=-1)).mean()

    def forward(self, llm_emb: torch.Tensor, target_emb: torch.Tensor) -> tuple[torch.Tensor, torch.Tensor]:
        projected = self.align_dimension(llm_emb)
        return self.compute_align_loss_cosine(projected, target_emb.detach()), projected
这段源码来自 JEPA_WAM/prismatic/models/action_heads.py。两层 MLP 的实际结构是 D_llm → 2D_target → D_target,激活函数为 GELU;预测和目标沿最后一维做 L2 归一化,随后计算所有 batch 与视觉 token 的平均 cosine distance。target_emb.detach() 明确切断教师目标的梯度,因此优化只会更新视觉对齐头与可训练的 Qwen LoRA 参数。
5.2 与 flow matching 动作损失联合
动作标签是长度为 H H H 的连续轨迹,而不是单个离散动作。训练时从高斯噪声 ϵ \epsilon ϵ 和干净动作 a a a 之间采样流时间 τ \tau τ,构造 a τ = ( 1 − τ ) ϵ + τ a a_\tau=(1-\tau)\epsilon+\tau a aτ=(1−τ)ϵ+τa,DiT action expert 预测速度 a − ϵ a-\epsilon a−ϵ。最终目标是动作损失与转移损失的加权和,两个损失都能反向更新共享预测器。核心问题在于,动作损失负责“做得对不对”,转移损失负责“是否理解变化”,二者的权重需要通过验证集观察梯度规模后再调整。
L a c t = E ϵ , τ [ ∥ A ψ ( a τ , τ , s t , C t ) − ( a − ϵ ) ∥ 2 2 ] , L = L a c t + λ w m L w m . \mathcal{L}_{act}=\mathbb{E}_{\epsilon,\tau}\left[ \left\|A_\psi(a_\tau,\tau,s_t,C_t)-(a-\epsilon)\right\|_2^2\right], \qquad \mathcal{L}=\mathcal{L}_{act}+\lambda_{wm}\mathcal{L}_{wm}. Lact=Eϵ,τ[∥Aψ(aτ,τ,st,Ct)−(a−ϵ)∥22],L=Lact+λwmLwm.
# JEPA_WAM/prismatic/models/flow_gr00t_action_head.py
compute_dtype = vl_embs.dtype
state = self._prepare_state(proprio).to(dtype=compute_dtype)
action_gt = action_gt.to(dtype=compute_dtype)
noise = torch.randn(action_gt.shape, device=action_gt.device, dtype=action_gt.dtype)
t = self.sample_time(action_gt.shape[0], device=action_gt.device, dtype=action_gt.dtype)
t = t[:, None, None]

noisy_trajectory = (1 - t) * noise + t * action_gt
velocity = action_gt - noise

t_discretized = (t[:, 0, 0] * self.num_timestep_buckets).long()
pred_actions = self._predict_velocity(vl_embs, noisy_trajectory, t_discretized, state)
loss = ((pred_actions - velocity) ** 2).mean()
return loss, pred_actions
这段原码来自 JEPA_WAM/prismatic/models/flow_gr00t_action_head.py,对应公开 LIBERO 实现的动作损失。源码采样噪声和流时间,构造 noisy_trajectory,并用均方误差回归 action_gt - noise。视觉 cosine loss 并不在这个动作头内部计算,而是在 PrismaticVLM.forward 中与 loss_action 汇总。论文中的 RoboTwin x-prediction 属于另一套实验配置,当前公开仓库固定发布的是 LIBERO velocity-prediction 路径,二者不能混写成同一个代码分支。
难点提示:flow matching 可以理解成给机器人一条从“随机动作”走向“示范动作”的连续路线。模型每次只学当前噪声状态该往哪个方向移动,四步积分就像四次大步修正,不需要在部署时反复生成未来图像。
6. 推理时的执行模块
6.1 训练与部署的计算边界
部署输入只有当前多视角图像、语言指令和本体状态。V-JEPA 编码当前图像,Qwen 生成 action placeholder 表示,DiT 从高斯噪声开始进行四步 Euler 积分。未来帧编码、转移目标、预测头和转移损失全部不执行,因此 JEPA-WAM 不会把训练时的教师信号变成在线依赖。进一步看,这个边界也简化了故障定位:在线失败可以分别归因于视觉编码、共享预测器或动作积分,而不必追踪一个未观测的未来分支。
…详情请参照古月居

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献160条内容

所有评论(0)