TrAct:用视觉轨迹把机器人的“预测“和“控制“接起来
0. 简介
机器人世界模型通过预测"候选决策会带来什么场景演化"来辅助选择动作,而策略负责产出可执行动作。TrAct 要处理的具体矛盾是:用来连接这两者的机器人动作本身,是一个薄弱的接口——动作是本体专属的,同一意图在不同机器人上对应完全不同的动作向量,从动作到像素变化又是欠定映射,导致以动作条件化的世界模型经常忽视真实动作、靠视觉先验幻想成功。TrAct 没有在"动作条件"上继续打磨,而是引入**视觉轨迹(visual tracks)**作为共享接口:让一个模型联合预测动作与轨迹,用轨迹条件化的世界模型去"想象"每个候选的视觉后果,再用视觉-语言奖励模型对照指令打分,选出预测最符合指令的候选,执行其配对动作。该方法把仿真任务成功率从 0.27 提升到 0.55,真机任务从 0.49 提升到 0.76,同时轨迹条件世界模型在五项视频质量指标上全面优于动作条件基线。下面结合论文,重点拆解三件事:为什么动作是弱接口、视觉轨迹强在哪;三阶段推理闭环如何在图像空间评估未来;以及这套方法在路线图上的位置与它没解决的问题。
这里要厘清一个常见误区:TrAct 不是又造了一个"更准的视频生成器",而是把"评估想象的未来"这件事,从隐空间搬到了可对照任务指令的图像空间。它真正卖的是这个评估位置的改变。
1. 研究问题与现有方法的缺口
1.1 动作到像素:一个欠定映射
世界模型与策略结合的标准做法,是以候选动作为条件生成未来画面,再评估哪条动作路径更接近目标。这里的关键是:动作这个条件本身不给力。动作是低维的、本体专属的关节指令,而它要生成的视觉后果是高维的、依赖场景几何的像素变化。直观理解是,给定一个动作向量,世界模型要"猜"出物体怎样被推动、接触区怎样变化,而这些信息在动作里根本不存在——映射是欠定的。
难点提示:可以把动作想象成"给司机的指令:右转 30 度"。同样的指令,在空地、在停车场、在堵车路上导致的画面变化完全不同。世界模型拿到的就是这样一个残缺条件,它只能靠视觉先验去"脑补"画面,所以才会忽略错误动作、幻想成功。
1.2 相关路线的各自缺口
把现有工作摊开,缺陷会看得更清楚。第一类,具身视频生成世界模型:Sora、Genie 这类互联网规模模型有涌现的物理理解,但缺少精密控制所需的可控性;具身世界模型通过语言、动作、本体感知、多模态输入、手部先验或视觉动作提示条件化视频预测,但动作与图像空间变化的对齐仍然很差。第二类,视觉轨迹与本体无关动作表征:一条线把预测的轨迹或光流解码成可执行动作,实现跨本体迁移;另一条线用与本体无关的运动替代本体专属指令,作为世界模型的条件信号。第三类,VLA 与闭环控制:VLA 已成主流,但开环 VLA 在分布偏移下脆弱,催生了 VLMPC、VLAC、RT-Trajectory 等闭环扩展。
这里值得注意一个共性:第二类里的工作,即使评估预测的未来,也大多在隐空间或几何空间完成,很少把评估放到可对照任务指令的图像空间。换句话说,它们把轨迹当作"用来产出或条件化预测"的工具,却没有把预测未来本身变成可评判的对象。TrAct 的差异化正在于此——它先把"评估"锚定在图像空间,让预测出的未来能直接对照语言指令打分,再让轨迹承担"连接两侧"的角色,从而同时吃到视频模型先验与图像空间动力学佐证。
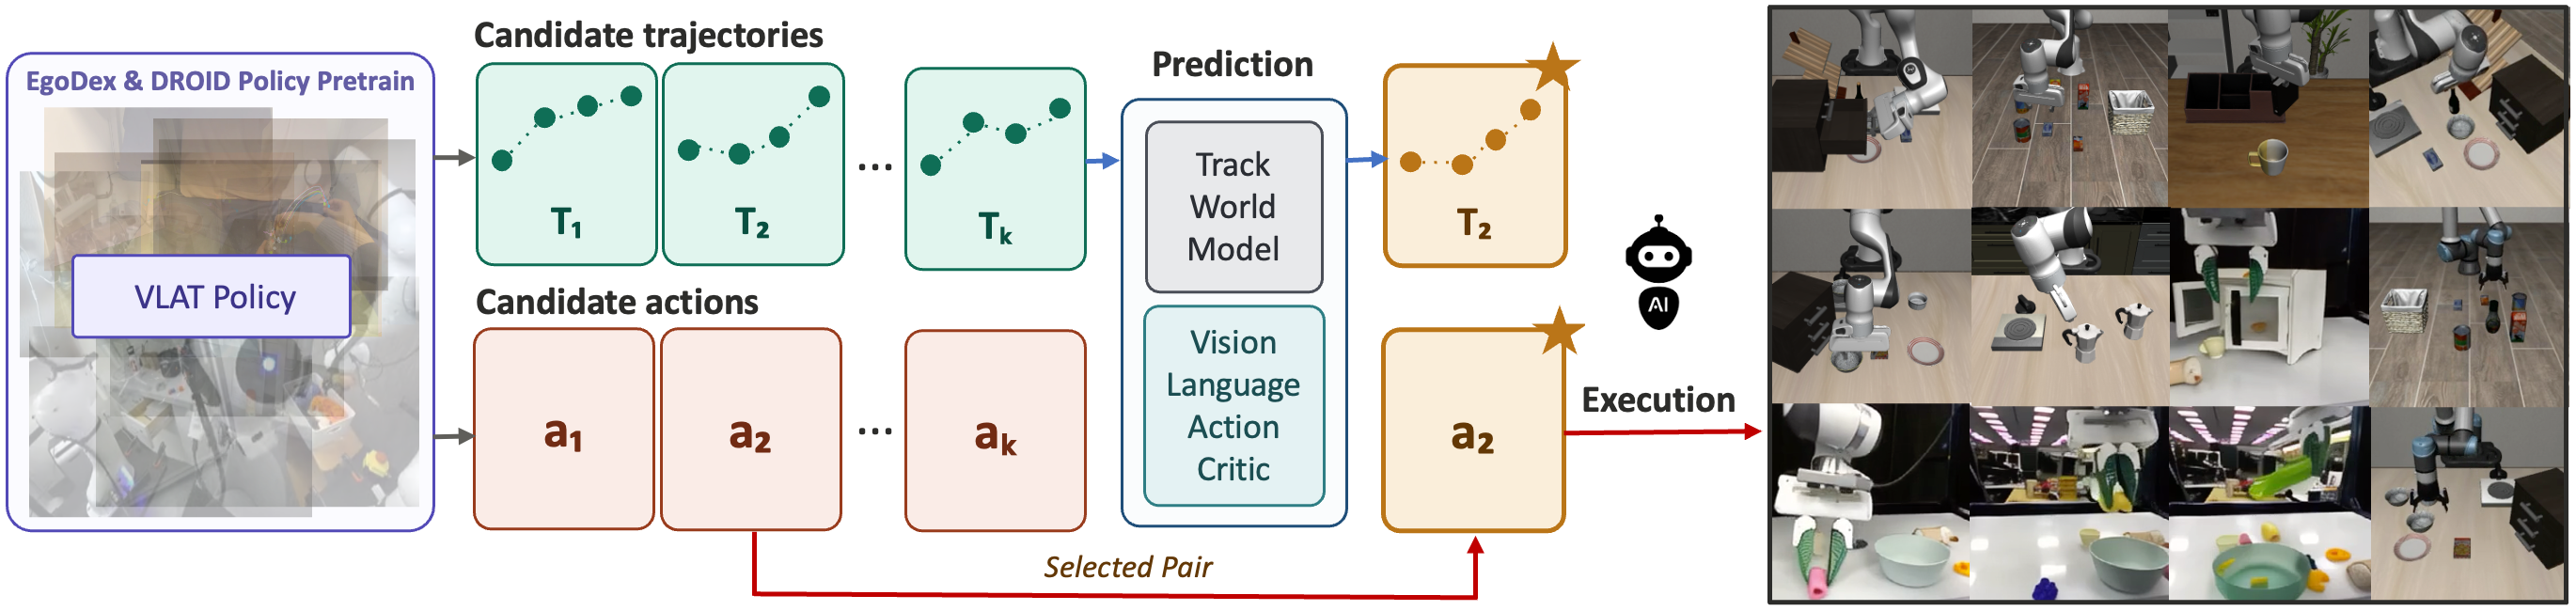
图 1:TrAct 总览。蓝色 VLAT 在大规模跨本体数据上预训练,产出候选 action-track 对;灰色 TWM 以轨迹为条件推演每个候选的视觉后果;绿色 VLAC 选出奖励最高的 rollout;机器人执行配对动作。视觉轨迹因此是"未来预测"与"机器人控制"之间的中间接口。
2. 整体框架:三阶段闭环
2.1 输入输出与三阶段拆解
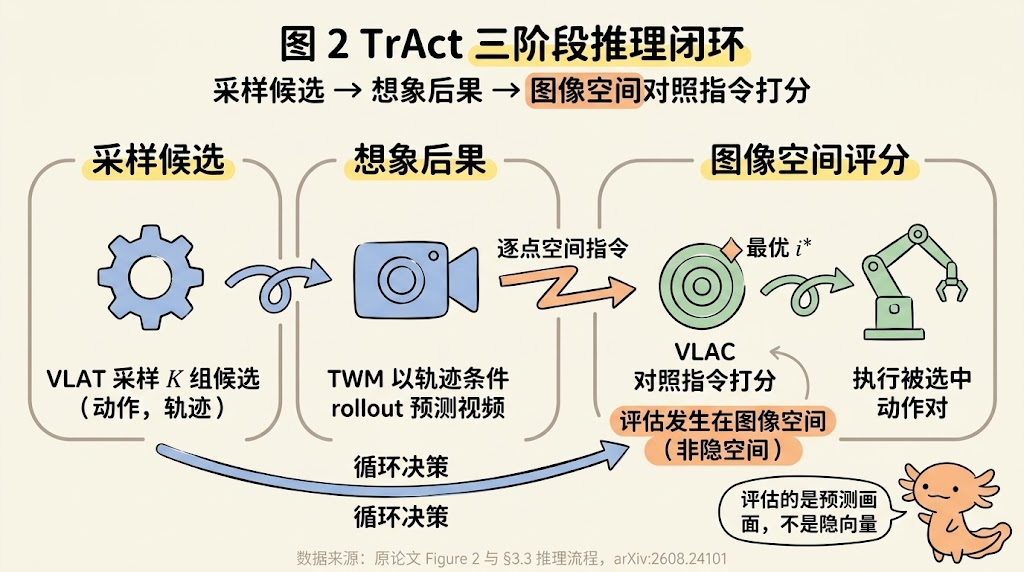
给定当前观测 o t o_t ot 与语言指令 l l l,目标是选出动作 a t a_t at,最大化任务成功率。TrAct 把决策拆成三个阶段:先由策略生成候选,再由世界模型想象后果,最后由奖励模型打分。论文沿用 VLAC 框架,选用 InternVL2 作为奖励模型。推理时采用循环决策:执行一段动作后观测新状态,再进入下一轮。
一句话理解:机器人不是在"猜哪条动作路径好",而是在"先想象每条路径会带来怎样的画面,再根据哪个画面最符合指令做选择"。
2.2 关键的不对称:评估发生在图像空间
这是 TrAct 区别于既有闭环方案的核心设计。多数闭环 VLA 用隐空间的评分器或几何度量评估候选,而 TrAct 把评估建立在由轨迹条件世界模型生成的预测视频之上,再用视觉-语言模型对照语言指令原文打分。这样评估的输入是"画像"而非"抽象隐向量",任务符合度可以直接由文本语义判定。该设计同时统一了"预测"与"控制"两侧的表征——都用视觉轨迹。
3. 第一条核心机制:联合预测动作与轨迹(VLAT)
3.1 机制核心思路
VLAT(Vision-Language-Action-and-Track)构建在预训练的基于 Flow Matching 的 VLA 策略 π 0.5 \pi_{0.5} π0.5 之上。作者修改其动作头,让它同时输出可执行动作与 2D 点轨迹——不是把轨迹当作附加输出从旁路生成,而是让它与动作头共享同一个 backbone 与同一个去噪目标,从而在训练时同步对齐"动作"与"它带来的视觉运动"。给定观测与指令,模型输出一组候选:
π θ ( o t , l ) ⟶ { ( a i , τ i ) } i = 1 K , \pi_{\theta}(o_t, l) \; \longrightarrow \; \bigl\{(a_{i},\; \tau_{i})\bigr\}_{i=1}^{K}, πθ(ot,l)⟶{(ai,τi)}i=1K,
其中 a i ∈ R H × d a a_{i}\in\mathbb{R}^{H\times d_{a}} ai∈RH×da 是长度为 H H H、动作维度为 d a d_{a} da 的动作块(action chunk), τ i ∈ R N × H × 2 \tau_{i}\in\mathbb{R}^{N\times H\times 2} τi∈RN×H×2 是同一时间跨度下 N N N 条 2D 点轨迹。轨迹覆盖两类点:机械夹爪的关键网格顶点,以及 5 × 5 5\times5 5×5 网格均匀采样的背景点与物体点。不同相机视图采用非对称策略:agent-view 头只输出夹爪网格顶点(聚焦末端执行器运动);wrist-view 头同时输出夹爪顶点与网格采样场景点(捕捉腕部相机相对环境的运动)。这份"共享轨迹、分离动作"的监督设计可以写成一段实现示意——配合附录的槽位布局与掩码逻辑,就能同时吃下机器人数据集与人类操作数据集:
# models/vlat.py(实现示意,对应论文 §3.1 联合头 + Appendix B 槽位掩码)
def forward_vlat(self, obs, lang, viewpoint):
    """同时输出动作块与 2D 轨迹;robot 表示是否带可执行动作标注。"""
    feat = self.backbone(obs, lang)                    # 视觉-语言融合特征
    action = self.flow_act_head(feat, viewpoint)       # Flow Matching 动作块
    track  = self.flow_trk_head(feat, viewpoint)       # Flow Matching 轨迹
    if not self.robot_mask:                            # 人类数据只监督轨迹头
        return None, track
    return action, track

# Appendix B:统一槽位布局,缺哪个槽位就掩码哪个
SLOTS = {"gripper": [f"g{i}" for i in range(7)],
         "grid":   [f"p{i}" for i in range(25)]}
工程价值:两类点互补——夹爪轨迹给出"末端执行器在动"的线索,网格轨迹给出"场景和相机在动"的参照。这样模型能区分"机器人造成的运动"与"相机移动造成的表观运动",是跨本体、跨视角泛化的基础。
3.2 联合优化
VLAT 用联合 Flow Matching 损失优化,动作与轨迹共享同一套 flow-matching 目标,也就是让两个头走同一条"把噪声逐步收敛到目标速度场"的训练路径,而不是各练各的。这样动作与轨迹在同一个生成框架里同步演进,训练信号更一致,也避免了为轨迹单独设计损失函数时可能出现的"两个目标相互拉扯"问题。这一步的设计是 TrAct 能在数据混合上成立的先决条件:
L VLAT = L flow ( a , a ∗ ) + λ L flow ( τ , τ ∗ ) , \mathcal{L}_{\text{VLAT}} \;=\; \mathcal{L}_{\text{flow}}(a,\, a^{*}) \;+\; \lambda \,\mathcal{L}_{\text{flow}}(\tau,\, \tau^{*}), LVLAT=Lflow(a,a∗)+λLflow(τ,τ∗),
其中 a ∗ a^{*} a∗ 与 τ ∗ \tau^{*} τ∗ 分别表示真实动作与真实轨迹, λ \lambda λ 是平衡动作项与轨迹项的权重。训练时,机器人数据集同时监督动作头与轨迹头;而人类数据集(EgoDex)只用轨迹头部监督,因为人类手部运动与机器人关节动作没有共同的控制参数化。于是整体目标写作 L = L track + 1 robot L action \mathcal{L} = \mathcal{L}_{\text{track}} + \mathbb{1}_{\text{robot}}\,\mathcal{L}_{\text{action}} L=Ltrack+1robotLaction,其展开形式是轨迹项总是生效、动作项只在带标注时生效:
L = L track + 1 robot L action , \mathcal{L} \;=\; \mathcal{L}_{\text{track}} \;+\; \mathbb{1}_{\text{robot}}\;\mathcal{L}_{\text{action}}, L=Ltrack+1robotLaction,
其中 1 robot \mathbb{1}_{\text{robot}} 1robot 指示该样本是否带可执行的动作标注。这意味着轨迹在所有数据集上都是一致的监督信号,而动作只在控制格式有效时才被监督——既能让大规模人类操作视频(EgoDex)用其轨迹监督去"喂养"视觉运动表征,又不至于把缺乏关节指令约束的动作监督强加到人类数据上。
难点提示:Flow Matching 不是直接回归轨迹坐标,而是学习"把噪声逐步变成目标"的速度场。动作与轨迹共享这份"去噪"目标,等于在同一个生成框架里同时建模两种输出,省去了单独为轨迹设计损失函数的麻烦。这种"一个生成范式、两种输出"的做法,比常见的"动作一个损失、轨迹一个损失"更省事,也更难——因为两者得共用同一个去噪方向。
3.3 预训练数据与统一轨迹表征
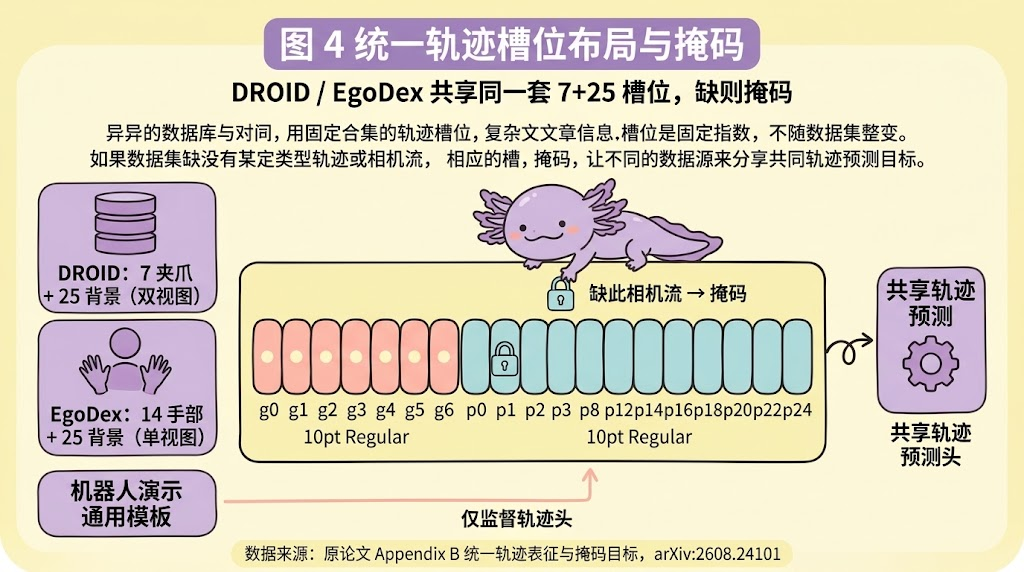
VLAT 在 DROID(76K 轨迹)与 EgoDex(150K 轨迹,取全量约一半)上按 1:2 混合预训练,30K 步、batch size 64、4 张 H100。为在异构数据上联合训练,作者引入固定的槽位(slot)布局:每个槽位对应一种轨迹类型(夹爪关键点或网格采样点),某数据集缺失某类轨迹或某相机流时,对应槽位直接掩码。DROID 的 agent-view 含 7 个夹爪关联点,wrist-view 含 7 个夹爪点加 25 个背景点;EgoDex 只有单 egocentric 视图,含 14 个手部关联点(每只手 7 个)加 25 个背景点。这套"固定槽位 + 缺失掩码"的设计,是跨本体、跨视角预训练成立的关键——它让机器人演示、人类第一视角视频、不同相机配置的数据,都能映射到同一个共享 token 空间。三种数据流如何各自填槽位、缺则掩码,用一张图最直观:
轨迹 token 由坐标、视图、槽位、时间四部分嵌入构成,每一个轨迹点在进入 Transformer 前都要打上这四类信号。之所以要把坐标之外再叠视图、槽位、时间三组嵌入,是因为同一组坐标在 agent-view 与 wrist-view 下含义不同、属于不同槽位的点语义不同、处于不同时间步的点也不可比——不区分这些,模型的表征就会乱:
z t , v , i = ϕ ( τ t , v , i ) + e view ( v ) + e slot ( i ) + e time ( t ) , z_{t,v,i} \;=\; \phi(\tau_{t,v,i}) \;+\; e_{\text{view}}(v) \;+\; e_{\text{slot}}(i) \;+\; e_{\text{time}}(t), zt,v,i=ϕ(τt,v,i)+eview(v)+eslot(i)+etime(t),
其中 τ t , v , i \tau_{t,v,i} τt,v,i 是槽位 i i i 在相机视图 v v v、时刻 t t t 的轨迹坐标, e view / e slot / e time e_{\text{view}}/e_{\text{slot}}/e_{\text{time}} eview/eslot/etime 是可学习的视图、槽位、时间嵌入。值得注意:没有使用任何本体专属嵌入——正是这一点,让模型按"交互动力学"而非"机器人形态"组织观测,从而实现本体无关的视觉运动表征。缺机械臂、缺槽位、缺该相机流、缺可用动作维度,都以二值掩码在注意力与损失计算里屏蔽。可以说,这套槽位布局是跨本体预训练能否成立的地基。
4. 第二条核心机制:轨迹条件的世界模型(TWM)
4.1 设计动机
视频生成主干选用 Stable Video Diffusion(SVD)。直接用 SVD 条件化不够——动作是稀疏低维的,无法告诉生成器"哪个点在往哪里动"。TrAct 的做法是:给 SVD 加一个 ControlNet 分支,把轨迹坐标编码成空间控制图,从而显式指定点的运动。给定观测与预测轨迹,世界模型生成未来视频。这里 o t o_{t} ot 是当前观测, τ i \tau_{i} τi 是第 i i i 个候选的预测轨迹,生成的 v ^ i \hat{v}_{i} v^i 是候选 i i i 对应的预测视频 rollout, H H H 为帧数, C C C 为通道数, W img , H img W_{\text{img}}, H_{\text{img}} Wimg,Himg 为图像宽高。世界模型本质上是在做"给定起始观测与轨迹、生成后续帧"的条件生成,训练时即最小化生成帧与真实后续帧之间的差异:
v ^ i = p ϕ ( o t , τ i ) ∈ R H × C × W img × H img , \hat{v}_{i} \;=\; p_{\phi}(o_{t},\, \tau_{i}) \;\in\; \mathbb{R}^{H\times C\times W_{\text{img}}\times H_{\text{img}}}, v^i=pϕ(ot,τi)∈RH×C×Wimg×Himg,
其中 v ^ i \hat{v}_{i} v^i 是候选 i i i 对应的预测视频 rollout, H H H 为帧数, C C C 为通道数, W img , H img W_{\text{img}}, H_{\text{img}} Wimg,Himg 为图像宽高。世界模型本质上是在做"给定起始观测与轨迹、生成后续帧"的条件生成,训练时即最小化生成帧与真实后续帧之间的差异 $ \bigl| \hat{v} - v \bigr|_2^{2} $,也就是让以轨迹为条件的预测视频,尽可能贴近真实发生的画面。这个"贴近"落在像素级差异上,而轨迹条件恰恰提供了足够的空间约束,让生成器不必靠幻想补全动作带来的后果。
直觉理解:动作条件像是给画师一个"往右挪 30 度"的抽象口令,画师得自己脑补被推动的物体;轨迹条件则像是直接告诉画师"这只杯子的把手上这个点,将在第 3 帧移到画面右下角那个位置"。后者是逐点的空间指令,歧义小得多。
4.2 多视图的通道设计
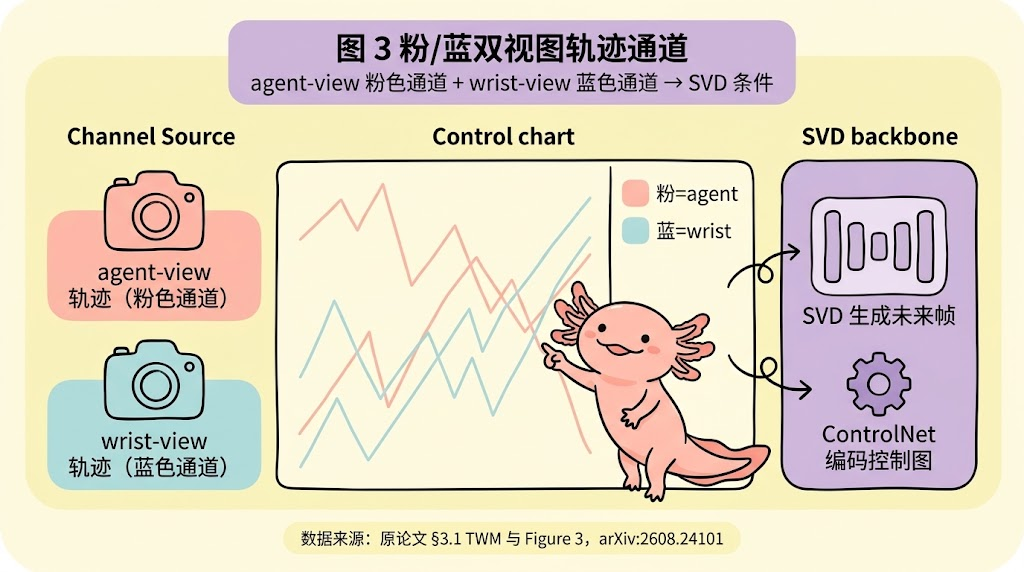
为支持多视图,作者把不同视图的轨迹渲染到 ControlNet 的独立通道:agent-view 轨迹用红色通道,wrist-view 轨迹用蓝色通道。这既让世界模型能区分不同视图的运动,又维持跨视图的时间一致性。相比之下,动作条件唯一能做的只是引入一个可学习的相机视图嵌入,信息量远不如"逐视图渲染轨迹"。把轨迹渲染成空间控制图、并拼进 ControlNet 与 SVD 主干,可写成下面这段示意:
# models/twm.py(实现示意,对应论文 §3.1 TWM + 红/蓝双通道控制图)
def render_control(track_agent, track_wrist, H, W):
    """把两视图轨迹渲染到空间控制图的不同通道。"""
    ctrl = torch.zeros(3, H, W)
    ctrl[0] = draw_polyline(track_agent)   # 红通道 = agent-view 轨迹
    ctrl[2] = draw_polyline(track_wrist)   # 蓝通道 = wrist-view 轨迹
    return ctrl

def forward_twm(self, obs, track):
    control = self.control_net(render_control(*track))   # ControlNet 分支
    return self.svd_unet(obs, control, cross_attn_kwargs=self.view_embed())
这段代码把"多视图"落在了一个很具体的实现选择上:同一张空间控制图里,agent-view 的轨迹占红通道、wrist-view 的轨迹占蓝通道,ControlNet 据此为生成器提供"这个运动属于哪个相机视角"的区分度。读者在代码里看到的 ctrl[0] 与 ctrl[2],正是把"红色=agent"与"蓝色=wrist"这条设计直接落到数组下标上。这套通道编码的几何含义与"两个视角之间为何不会互相污染",用一张图直观展示:
4.3 动作条件世界模型(AWM):对照组
为公平对比,作者训练一个动作条件变体 AWM。给定预测动作块 a i a_i ai,先用 MLP 编码到 CLIP-L/14 特征空间,再拼接一个可学习的相机视图嵌入(区分 agent-view 与 wrist-view 动作),得到视图感知的动作表征,通过交叉注意力注入 SVD 的 UNet 层。这一套动作条件化路径的复杂度,与 TWM 里"把轨迹渲染成控制图"的设计是同一量级的——两者都专门为多视图做了处理,并非简单地把动作向量塞进去。注入过程可写成:
h a = CrossAttn ( UNet ( z ) , MLP ( a i ) ⊕ e view ) , h_{a} \;=\; \text{CrossAttn}\bigl(\text{UNet}(z),\; \text{MLP}(a_{i}) \oplus e_{\text{view}}\bigr), ha=CrossAttn(UNet(z),MLP(ai)⊕eview),
其中 z z z 是 SVD 的潜特征, e view e_{\text{view}} eview 是相机视图嵌入, ⊕ \oplus ⊕ 表示拼接。AWM 与 TWM 拥有完全一致的多视图信息——唯一变量是"用什么条件化",这保证了对比的有效性。换句话说,AWM 就是专门为了"排除其它因素、只比较条件信号"而设计的对照组,它存在的意义就是让 TWM 的每一项优势都能归因到"视觉轨迹"这一个变量上。
5. 训练时的监督模块
5.1 世界模型的预训练与微调
TWM 与 AWM 都在 76K DROID 轨迹上预训练 30K 步,batch size 64。这一步之所以关键,是它决定了两个世界模型在"条件信号"之外的一切都相同——同样的主干、同样的数据、同样的训练规模,唯一差异只有"用动作还是用轨迹做条件"。微调阶段,两个变体在完全相同的 LIBERO 与真实世界数据集上训练,确保对比公平。附录中另给出更大规模混合(DROID + BridgeData V2 + 全量 EgoDex)的实验(记为 TrAct+),用 8 张 H100、60K 步、全局 batch 128 训练,用于检验数据规模能否进一步放大轨迹条件带来的增益。
5.2 轨迹监督信号的构造
…详情请参照古月居

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献160条内容

所有评论(0)