世界动作模型近期工作:从预测未来到指导行动
0. 简介
世界动作模型(World Action Model,WAM)研究的是机器人如何在同一套学习系统中回答两个相互依赖的问题:给定当前观测和指令,如果执行某个动作,世界会变成什么样;以及为了让世界朝目标变化,现在应该执行什么动作。它不是单纯的视频生成模型,因为视频里的大量纹理、光照和背景细节对抓取、插入、推拉等操作几乎没有决策价值;它也不是普通的动作策略,因为策略如果只看当前帧,很容易忽略物体速度、接触状态和动作的长程后果。近期研究的共同转向,是把“预测未来”从追求逼真画面改成学习行动相关的未来表征。这里要厘清的是,WAM 目前仍处在路线分化阶段:有的方法在推理时显式生成未来,有的方法只把未来当作训练监督,有的方法在测试时用它筛选候选动作。把这三类做法放在同一张技术地图里,比强行给出一个统一定义更接近当前研究现场。
1. WAM 要解决的真实问题
1.1 从抓杯子看未来
机器人抓一个杯子时,真正影响成败的变量往往是杯子相对于夹爪的空间关系、夹爪接近方向、接触前后的微小位移、以及桌子边缘造成的约束。相机画面中的木纹、反光、墙面颜色和光照变化,虽然会占据大量像素,却很少改变控制决策。核心问题在于,传统像素级预测会把模型容量平均分配给所有视觉细节,而控制需要的是对少数状态变量的准确预测。直观理解是,机器人不需要成为画家,它需要成为能判断“手一动,物体会怎么响应”的操作者。
1.2 为什么纯视频生成不够
视频生成模型带来了强大的动态先验,能从海量视频中学会物体遮挡、刚体运动、液体流动等常见规律,这是机器人数据难以单独提供的。进一步看,直接把视频生成搬进控制会遇到三个代价:一是多步去噪的推理时间与控制频率冲突;二是像素误差和任务误差不同,画面看起来接近不等于末端位姿正确;三是生成的未来若只在策略外部传递,动作模型很难持续利用其中信息。这里的关键是,WAM 要继承生成模型的动态知识,同时把监督目标改造成与控制、接触、几何和物理状态相关的形式。
直觉理解:可以把视频生成模型看成一个见过大量物理事件的观察者,它知道杯子倒下会滚动、抽屉拉动会露出内部空间。但机器人控制更接近驾校练习,学员真正需要的不是把路边风景画清楚,而是判断打方向盘之后车身会怎样进入弯道。像素真实性是观察者的能力,行动相关性才是操作者的能力。
1.3 三个工程约束
第一是实时性,桌面机械臂和移动操作经常需要几十毫秒内给出动作块,完整视频扩散难以满足。第二是可验证性,未来表征如果不能读出末端位姿、关节变化、物体轨迹或接触状态,预测误差再低也未必帮助控制。第三是泛化性,机器人会遇到光照、背景、材质、相机位姿和本体参数变化,模型不能把外观扰动误判为世界状态改变。换句话说,WAM 的工程目标不是生成一段漂亮的未来视频,而是学习一个能被动作条件化、能被策略使用、能被真实执行结果校验的未来接口。
2. 发展脉络:从世界模型到 VLA
2.1 早期视频预测与控制
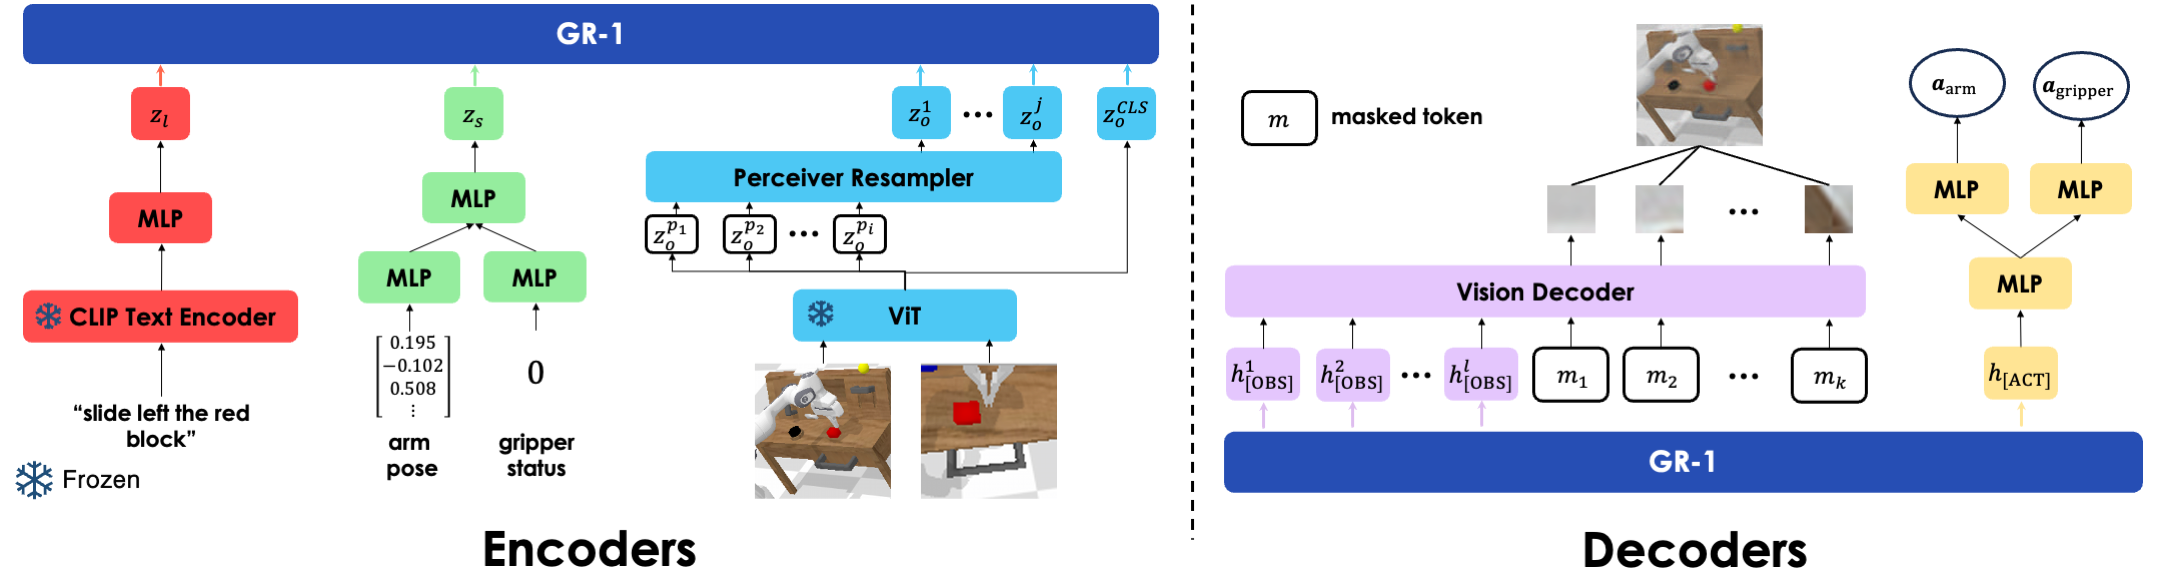
早期世界模型研究强调从观测序列中学习环境动态,再用于规划或强化学习。像素预测是一条自然路线,因为图像可以直接和真实观测比较,训练目标清晰。GR-1 是这条路线上的代表:它用 GPT 风格 Transformer 同时输入语言、历史图像和机器人状态,并在同一序列中预测动作与未来图像。官方报告显示,GR-1 在 CALVIN 上把成功率从 88.9% 提升到 94.9%,在 zero-shot 未见场景中从 53.3% 提升到 85.4%。这个结果说明,视频生成预训练确实能给机器人操作带来迁移价值。
2.2 VLA 带来的接口变化
视觉语言动作模型(VLA)把视觉、语言和动作放进一个多任务模型,使机器人可以从指令和图像直接生成控制序列。问题在于,许多 VLA 仍然是“先理解,再加动作头”的组装结构:视觉语言骨干负责感知,动作头负责控制,世界动态只在隐式中存在。WAM 对 VLA 的修正,是把未来预测变成训练或推理的一等公民,让动作 token 与未来 token 建立持续交互。这里的关键是,VLA 提供任务语义和通用先验,WAM 补上动作条件下的动态推演,两者不是替代关系,而是接口逐渐融合。
2.3 WAM 的分水岭
近一年的分水岭在于研究者不再默认“未来必须是完整视频”。UD-VLA 和 MMaDA-VLA 让未来图像与动作在扩散过程中联合生成;FRAPPE、LiLa-WAM 和 DINO-WM 转向隐空间或多种视觉基础模型特征;S-VAM、Robust-WAM、PSG-JEPA 和 4D-WAM 分别强调语义、几何、物理状态与三维轨迹;MobileWAM、DreamTrajectory、TARO、Streaming-WAM 和 GlanceWAM 则把问题推向移动操作、触觉、异步推理和测试时搜索。这意味着 WAM 正在从一种模型结构变成一套方法论:未来表征可以显式生成,可以只用于训练监督,也可以在执行前充当后果模拟器。
3. WAM 的三层实现流程
3.1 输入与表征层
一个典型 WAM 的输入包括当前和历史观测 o ≤ t o_{\le t} o≤t、机器人本体状态 s t s_t st、语言指令 l l l,有时还包括深度、触觉、末端位姿或目标图像。表征层要决定哪些信息进入 token 序列:RGB 可以变成图像 token,动作可以离散化为动作 token,DINO、CLIP、Depth Anything、V-JEPA 等模型可以提供语义、几何或时序特征。直观理解是,这一层相当于给机器人准备一套描述世界的语言;选择什么语言,会直接影响后续它能“想到”哪些变化。
3.2 世界与动作耦合层
世界模型刻画的是动作条件下的状态转移,动作模型根据当前状态和任务目标生成动作或动作块。最简形式下,WAM 同时包含“预测下一状态”和“决定当前动作”这两个函数,而两者的耦合程度正是不同路线的分界线:外部级联、联合去噪、训练时辅助监督和测试时评分,都会在这个公式之后展开成不同实现。可以写成:
z t + 1 = f θ ( z t , a t , l ) , z_{t+1} = f_\theta(z_t, a_t, l), zt+1=fθ(zt,at,l),
其中 z t z_t zt 是状态表征, a t a_t at 是动作, l l l 是语言条件。这个公式看似只是环境动力学,但工程实现必须回答三个问题:状态来自哪个编码器、动作是否离散化、未来监督作用在哪个中间层。若采用扩散或流匹配生成,未来 token 和动作 token 通常从噪声或中间分布开始,经多轮去噪逐步恢复:
x t − 1 v , a = D θ ( x t v , a , z t , l ) . x_{t-1}^{v,a} = \mathcal{D}_\theta(x_t^{v,a}, z_t, l). xt−1v,a=Dθ(xtv,a,zt,l).
这里的上标 v , a v,a v,a 表示视觉未来和动作放在同一条去噪轨迹中。进一步看,耦合方式有强弱之分:弱耦合是先生成未来再交给策略,动作只在最后读取一次结果;强耦合是两者在每一轮生成中互相约束,未来信息可以持续修正动作 token;更轻的耦合则发生在训练阶段,未来目标只作为辅助损失塑造中间特征,部署时完全删除生成分支。
3.3 训练与部署层
训练阶段通常包含动作监督、未来监督和可选的辅助对齐目标。未来监督可以是像素重建、latent 回归、特征余弦相似度、几何深度对齐、物理状态回归,或是轨迹场对齐。部署阶段则出现三种选择:推理时保留完整未来生成;只保留被未来监督塑造过的当前表征;或者在测试时采样多个候选动作,用轻量世界模型预测后果再评分。核心问题在于,未来生成不是越完整越好,而是要在任务性能、延迟、显存和鲁棒性之间取得可执行的平衡。
4. 路线一:未来与动作的联合生成
4.1 GR-1:把动作查询和未来图像查询放进同一序列
GR-1 的关键不是模型规模,而是序列组织方式。它将语言、历史观测、状态、动作查询和未来观测查询放入同一个 Transformer 输入序列,使动作预测和未来图像预测共享同一上下文。下面的代码来自官方 models/gr1.py,可以看到动作查询和未来观测查询被连续拼接到 stacked_inputs,随后统一送入 Transformer:
# models/gr1.py
if self.act_pred:
    action_queries = self.action_queries.weight
    action_queries = action_queries.view(
        1, 1, 1, self.hidden_size
    ).repeat(batch_size, sequence_length, 1, 1)
    stacked_inputs = torch.cat(
        (stacked_inputs, action_queries), dim=2
    )

if self.fwd_pred:
    obs_queries = self.obs_queries.weight
    obs_queries = obs_queries.view(
        1, 1, self.n_patch_latents + 1, self.hidden_size
    ).repeat(batch_size, sequence_length, 1, 1)
    stacked_inputs = torch.cat(
        (stacked_inputs, obs_queries), dim=2
    )
这段代码的意义在于,它没有为未来图像单独安排一个后置生成器,而是让动作和未来观测在同一注意力上下文中竞争和交换信息。换句话说,未来不是动作生成完之后的附加输出,而是训练时与动作共同塑造同一个骨干模型的辅助任务。GR-1 的实验结果给出了一个重要证据:视频生成预训练与机器人动作微调可以共享结构,而且这种共享能改善未见场景泛化。
4.2 UD-VLA:同一条离散去噪轨迹
UD-VLA 将语言、当前图像、未来图像和动作统一离散化,再通过联合离散去噪扩散过程(JD3P)同步恢复未来图像 token 和动作 token。与传统“先生成图像,再由图像导出动作”的级联结构相比,UD-VLA 让动作 token 在每轮去噪中读取逐渐清晰的未来视觉 token,因此动作不是一次性决定,而是随未来表征一起收敛。官方报告的 CALVIN ABCD 到 D 平均完成长度为 4.64,消融中去掉未来视觉生成会降到 4.21。
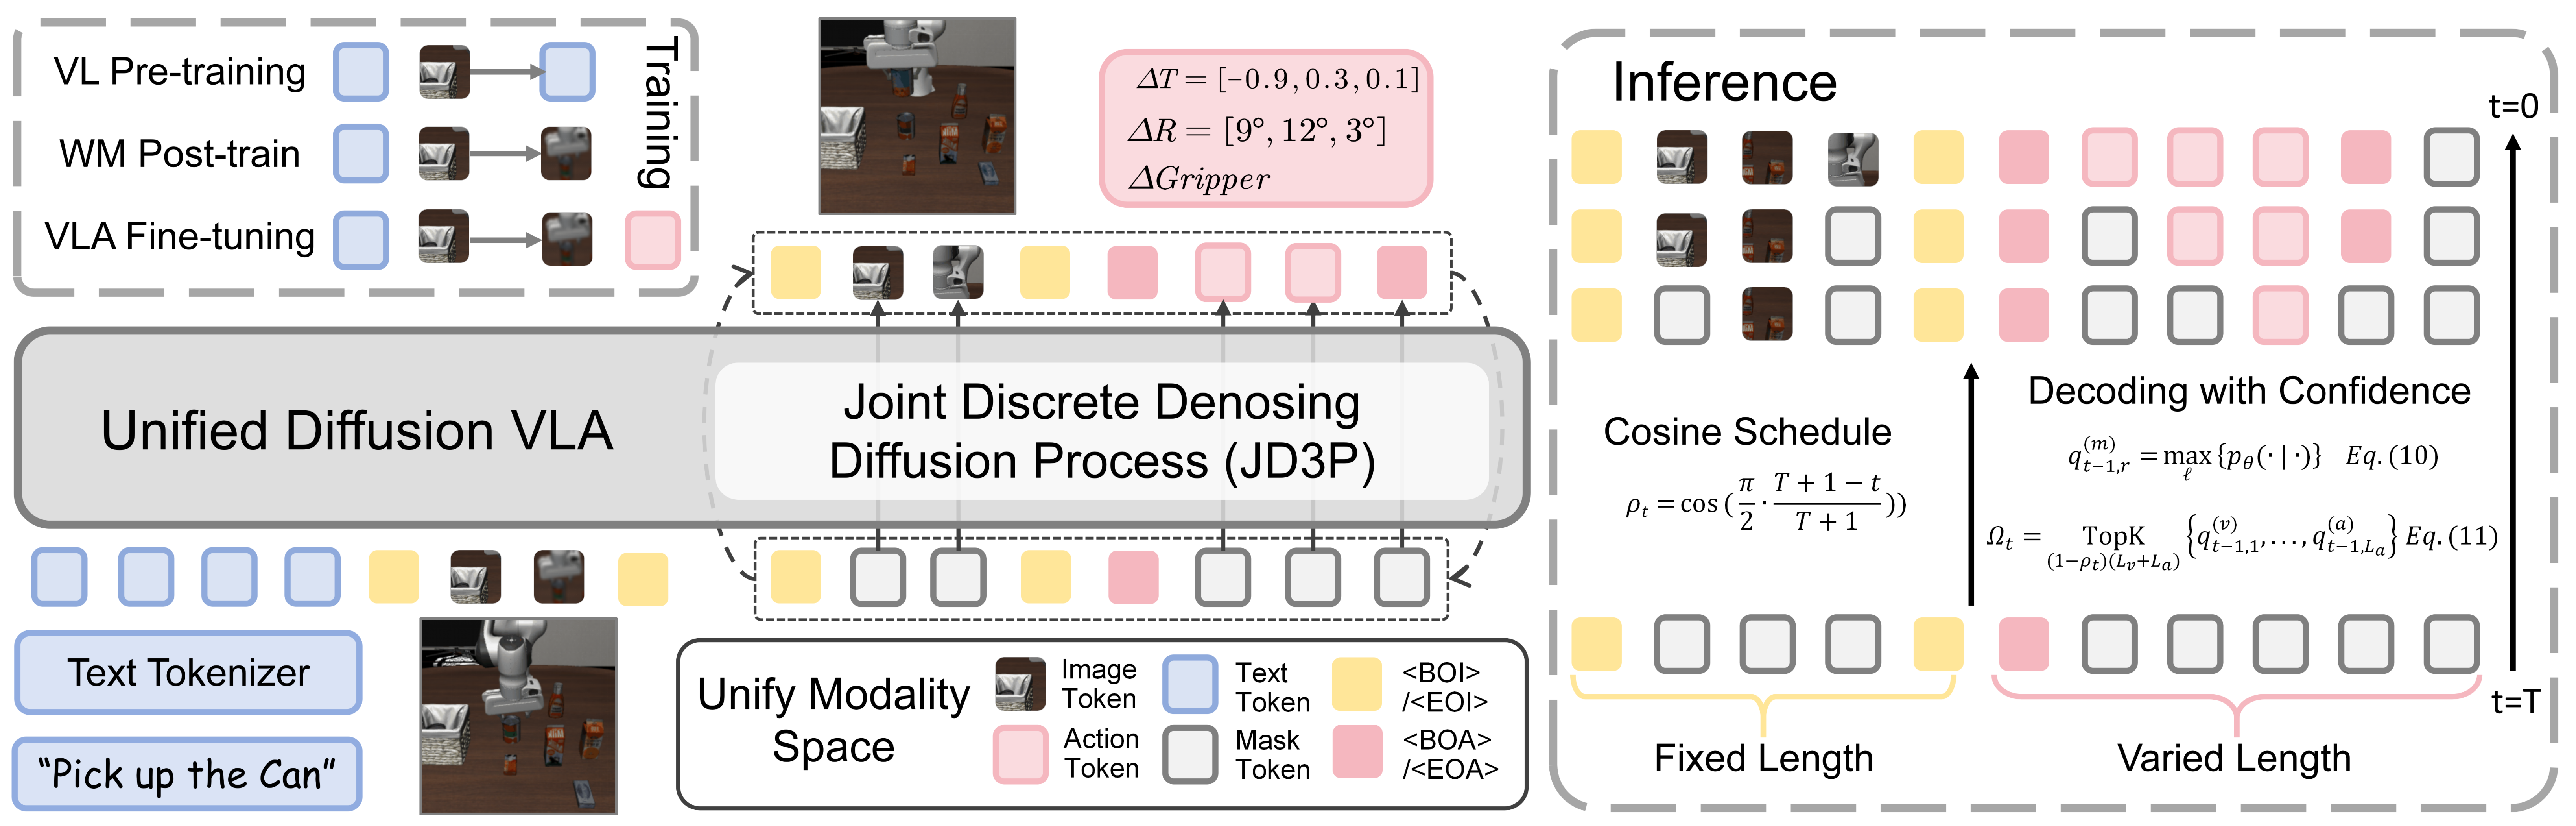
动作 token 化是这类统一 token 方案的基础:连续控制量必须先被切成有限数量的区间,才能与图像 token 和语言 token 共享离散扩散机制。UD-VLA 官方仓库中的 ActionTokenizer 先把连续动作裁剪到固定范围,再用 np.digitize 映射到 bin,最后转成词表末端 token。这个过程决定了控制量的分辨率、词表大小和生成难度,也是理解离散扩散 VLA 代码的入口:
# models/tokenizer/action_tokenizer.py
def encode_actions_to_ids(self, actions: np.ndarray) -> np.ndarray:
    actions = np.clip(
        actions, a_min=self.min_action, a_max=self.max_action
    )
    discretized_actions = np.digitize(actions, self.bins) - 1
    discretized_actions = np.clip(
        discretized_actions,
        a_min=0,
        a_max=self.bin_centers.shape[0] - 1,
    )
    action_token_ids = self.last_vocab_idx - discretized_actions
    return action_token_ids
这段代码解释了连续控制如何进入离散扩散框架:动作维度被切成有限 bin,bin 索引再映射到低频词表位置。工程上的代价是离散化粒度会影响控制精度,收益是视觉、语言和动作可以用同一套 mask-and-denoise 机制训练。这里的关键是,UD-VLA 的重点不是“多了一个动作 tokenizer”,而是让动作和未来图像在同一个生成过程中反复相互修正。
难点提示:动作离散化像把连续油门踏板改成有限的挡位。挡位太少,机器人会显得生硬,接近和抓取容易失败;挡位太多,词表和分类开销又会让训练与推理变重。工程上要先统计动作分布和误差容忍度,再决定 bin 数、裁剪范围和是否对关键维度使用更细粒度。
4.3 FRAPPE:多视觉教师定义未来
FRAPPE 的问题意识更直接:如果未来不需要画成图片,那么应该预测哪种视觉特征?CLIP 擅长语义对齐,DINO 擅长空间结构,不同基础模型带来的归纳偏置不同,押注单一教师会限制策略。FRAPPE 在 Mid-Training 阶段用 Theia 的多视觉模型蒸馏表征做全参数适配,让策略预测未来观测的隐空间表示;Post-Training 阶段再扩展为多个 Prefix 和 LoRA 专家,分别对齐不同视觉教师,并由轻量 router 汇总动作特征。推理时视觉教师全部移除,这种多模态未来表征最终被压回策略自身的条件 token。
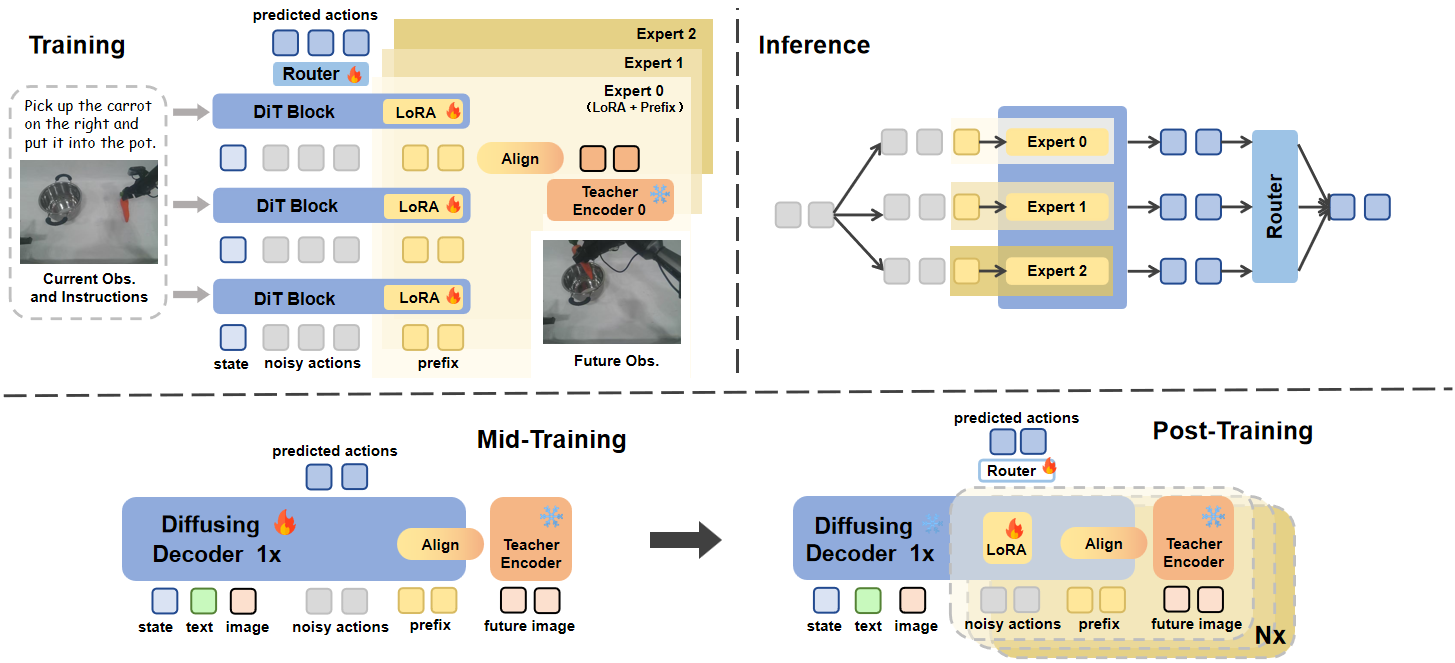
FRAPPE 官方仓库中的训练逻辑显示,未来表征对齐不是把预测特征和目标特征简单拼接,而是在多层表示上分别 normalize 后计算余弦距离。这种逐层监督很重要:浅层 token 更接近局部空间结构,深层 token 更接近任务语义,如果只约束最后一层,世界模型可能学到“全局像”,却丢掉对抓取和避障有用的局部变化:
# models/mid_train_runner.py
for i, (z, z_tilde) in enumerate(zip(zs, zs_future)):
    for j, (z_j, z_tilde_j) in enumerate(zip(z, z_tilde)):
        z_tilde_j = torch.nn.functional.normalize(
            z_tilde_j, dim=-1
        )
        z_j = torch.nn.functional.normalize(z_j, dim=-1)
        proj_loss += mean_flat(
            1 - (z_j * z_tilde_j).sum(dim=-1)
        )
proj_loss /= (len(zs) * bsz)
这段实现说明 FRAPPE 的世界模型监督作用在多层 token 上,而不是只对最后一级特征打一个全局损失。这里的关键是,多教师对齐等价于给未来建立多套判据:一套强调“这是什么物体”,一套强调“空间结构如何”,一套强调任务相关区域。策略最终输出的仍是动作,但它的内部表征被多视角的未来知识约束过。
4.4 MMaDA-VLA:统一从预训练开始
MMaDA-VLA 把统一推进到预训练阶段。它建立在原生离散扩散模型上,将语言、图像和连续机器人控制映射到共享离散 token 空间,用单一 backbone 和 masked token denoising 同时学习多模态理解、未来视觉生成和动作生成。与后置动作头或额外策略网络相比,这种设计减少了模块之间的接口损耗,也让理解、想象和行动共享同一套生成机制。换句话说,MMaDA-VLA 希望模型从训练初期就不把“看、说、想、动”当成四种孤立任务。
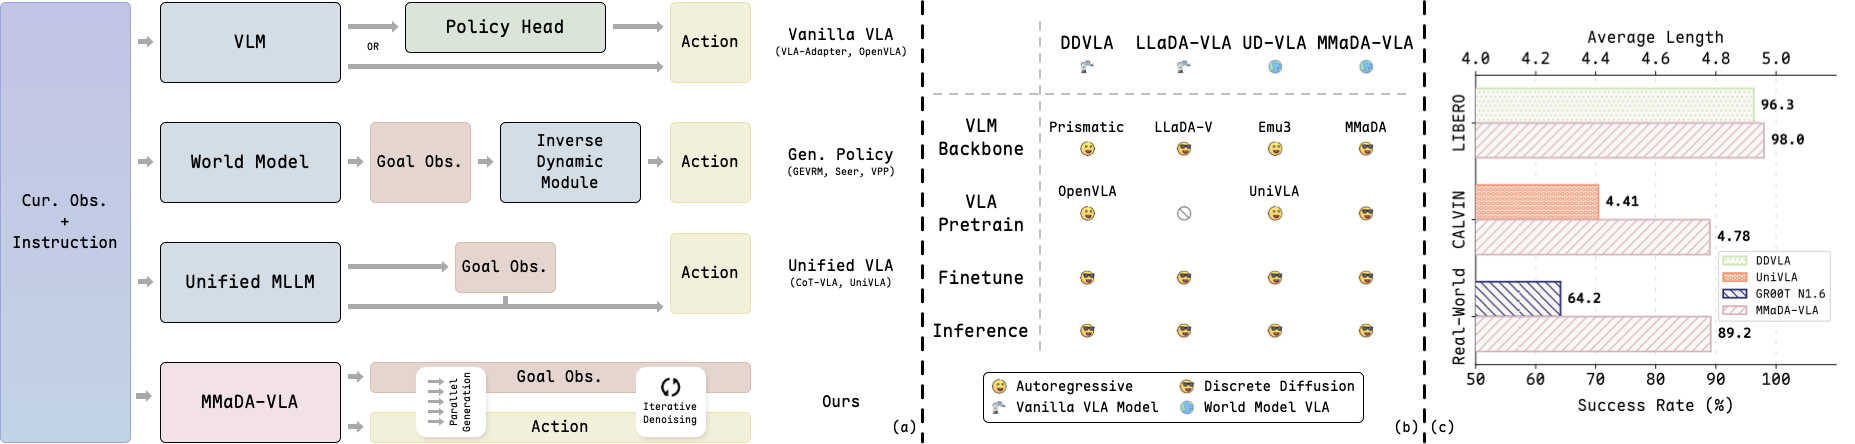
从路线图角度看,UD-VLA 主要解决推理时的联合去噪,FRAPPE 解决未来表征的多样性,MMaDA-VLA 则解决预训练阶段的目标统一。三者共同指向一个趋势:未来建模不再是一个附加模块,而是 VLA 的生成范式本身。这里要厘清的是,统一并不保证性能自动提升,它依赖 token 化粒度、mask 策略、注意力方向和数据配比,但至少减少了“视觉生成和动作生成各学各的”这种结构风险。
4.5 LiLa-WAM:冻结视觉基础模型与流匹配动作
LiLa-WAM 提供了一个更轻量的实现样本。它使用冻结 DINOv3 ViT-L/16 提取观测特征,用流匹配生成动作块,同时增加未来 DINO patch feature 的辅助预测。官方报告显示,LiLa-WAM 在 RoboTwin 2.0 的 50 个任务 clean setting 下达到 90.48% 平均成功率;完整模型约 0.5B 参数,可训练参数约 0.2B,并可在单张 RTX 5090 级别 GPU 上完成 50 任务联合训练,约 110 GPU 小时。这个结果说明,WAM 不一定必须依赖超大规模视频生成骨干,冻结视觉基础模型加上合适的未来监督同样可以形成有效闭环。
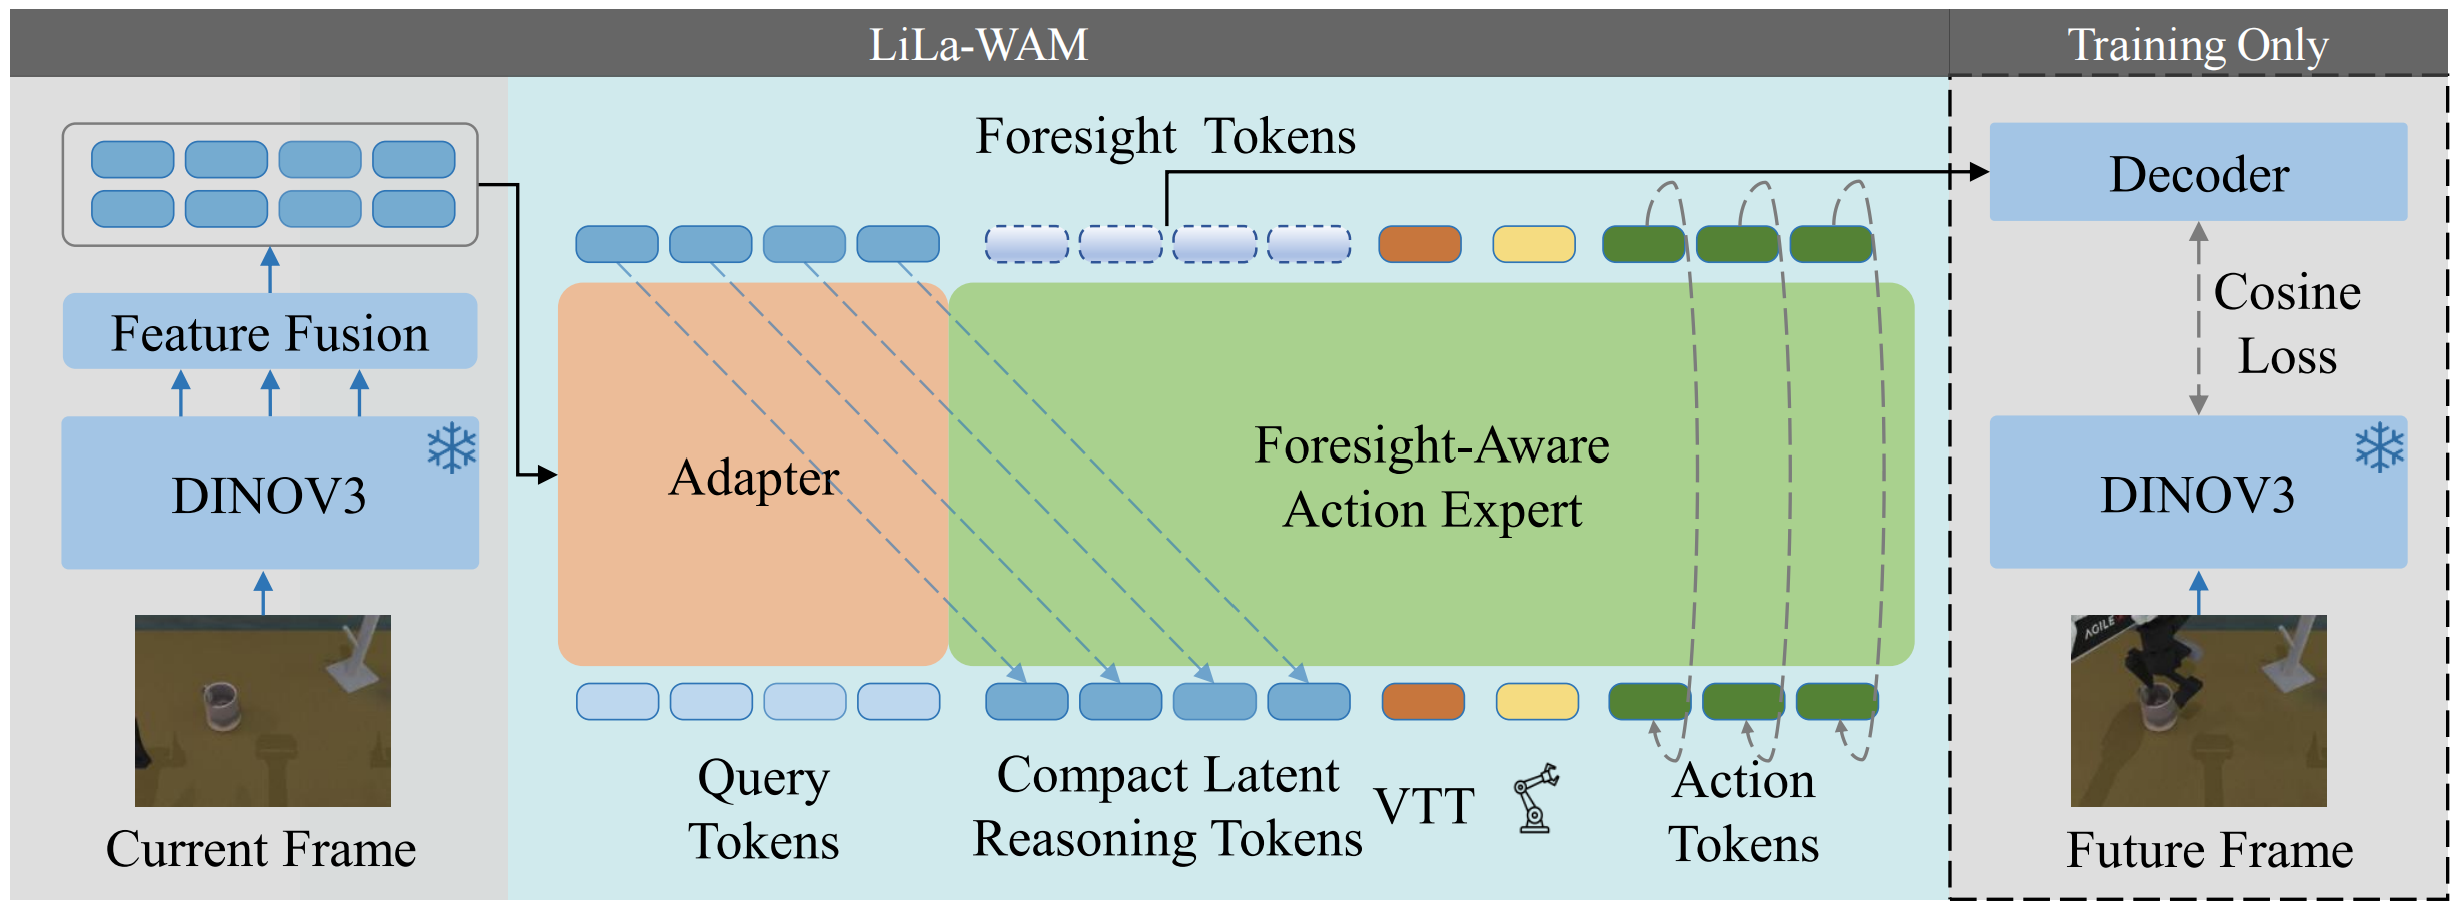
LiLa-WAM 的未来特征损失实现为逐 token 余弦距离。这个函数本身只有四行,但位置很关键:它不在图像解码器之后,而是直接比较预测 token 与真实未来帧经冻结 DINOv3 得到的 patch token。也就是说,损失衡量的是空间状态变化是否一致,而不是未来画面每个像素是否被重建出来:
# models/vla_model_fm.py
def future_feature_cosine_loss(pred, target):
    pred = F.normalize(pred.float(), dim=-1)
    target = F.normalize(target.float(), dim=-1)
    cos = (pred * target).sum(dim=-1)
    return (1.0 - cos).mean()
把这段代码还原成训练目标,可以更清楚地看到两类监督的分工:未来特征损失约束“动作之后世界会变成什么样”,流匹配损失约束“为了达到目标应该生成什么连续控制序列”。前者使用真实未来帧的教师特征,后者直接使用演示动作,两者共同把动态理解和控制输出压进同一个策略骨干。对应的目标可以写成:
L future = 1 − cos ( ϕ ^ ( o t + k ) , ϕ ( o t + k ) ) , \mathcal{L}_{\text{future}} = 1 - \cos\left( \hat{\phi}(o_{t+k}), \phi(o_{t+k}) \right), Lfuture=1−cos(ϕ^(ot+k),ϕ(ot+k)),
其中 ϕ \phi ϕ 是冻结视觉编码器, ϕ ^ \hat{\phi} ϕ^ 是策略内部对未来特征的预测;前者来自真实未来观测,后者只作为动作模型的内部条件被监督。由于教师编码器被冻结,未来损失不会把 DINOv3 的参数拉偏,同时能给动作生成提供稳定的动态目标。流匹配动作部分则学习从噪声动作 x 0 x_0 x0 到目标动作 x 1 x_1 x1 的速度场,使模型保持连续动作块的生成能力:
L action = ∥ v θ ( x t , t ) − ( x 1 − x 0 ) ∥ 2 2 . \mathcal{L}_{\text{action}} = \left\| v_\theta(x_t, t) - (x_1 - x_0) \right\|_2^2. Laction=∥vθ(xt,t)−(x1−x0)∥22.
这个组合很能说明当前 WAM 的务实取向:视觉基础模型提供稳定状态表征,未来预测只做辅助监督,动作生成保持连续控制能力。这里的关键是,训练时监督塑造的是内部条件 token,而不要求模型在部署时生成未来图像。这样既保留了世界模型带来的动态约束,也避开了视频生成在真实控制回路中的延迟和显存开销。
4.6 VLA-JEPA:把 V-JEPA 引入 VLA
VLA-JEPA 使用 Qwen3-VL-2B 与 V-JEPA2 组合,把视频自监督表征用于 VLA 的世界建模。相比像素生成,JEPA 类方法直接在 latent space 中预测未来,天然减少了纹理重建压力;相比单帧视觉编码,它更关心连续观测之间的动态变化。官方仓库提供了 LIBERO、LIBERO-Plus 和 SimplerEnv 相关评测入口,说明这类方法特别关注扰动和分布外场景,而不只报告理想条件下的成功率。
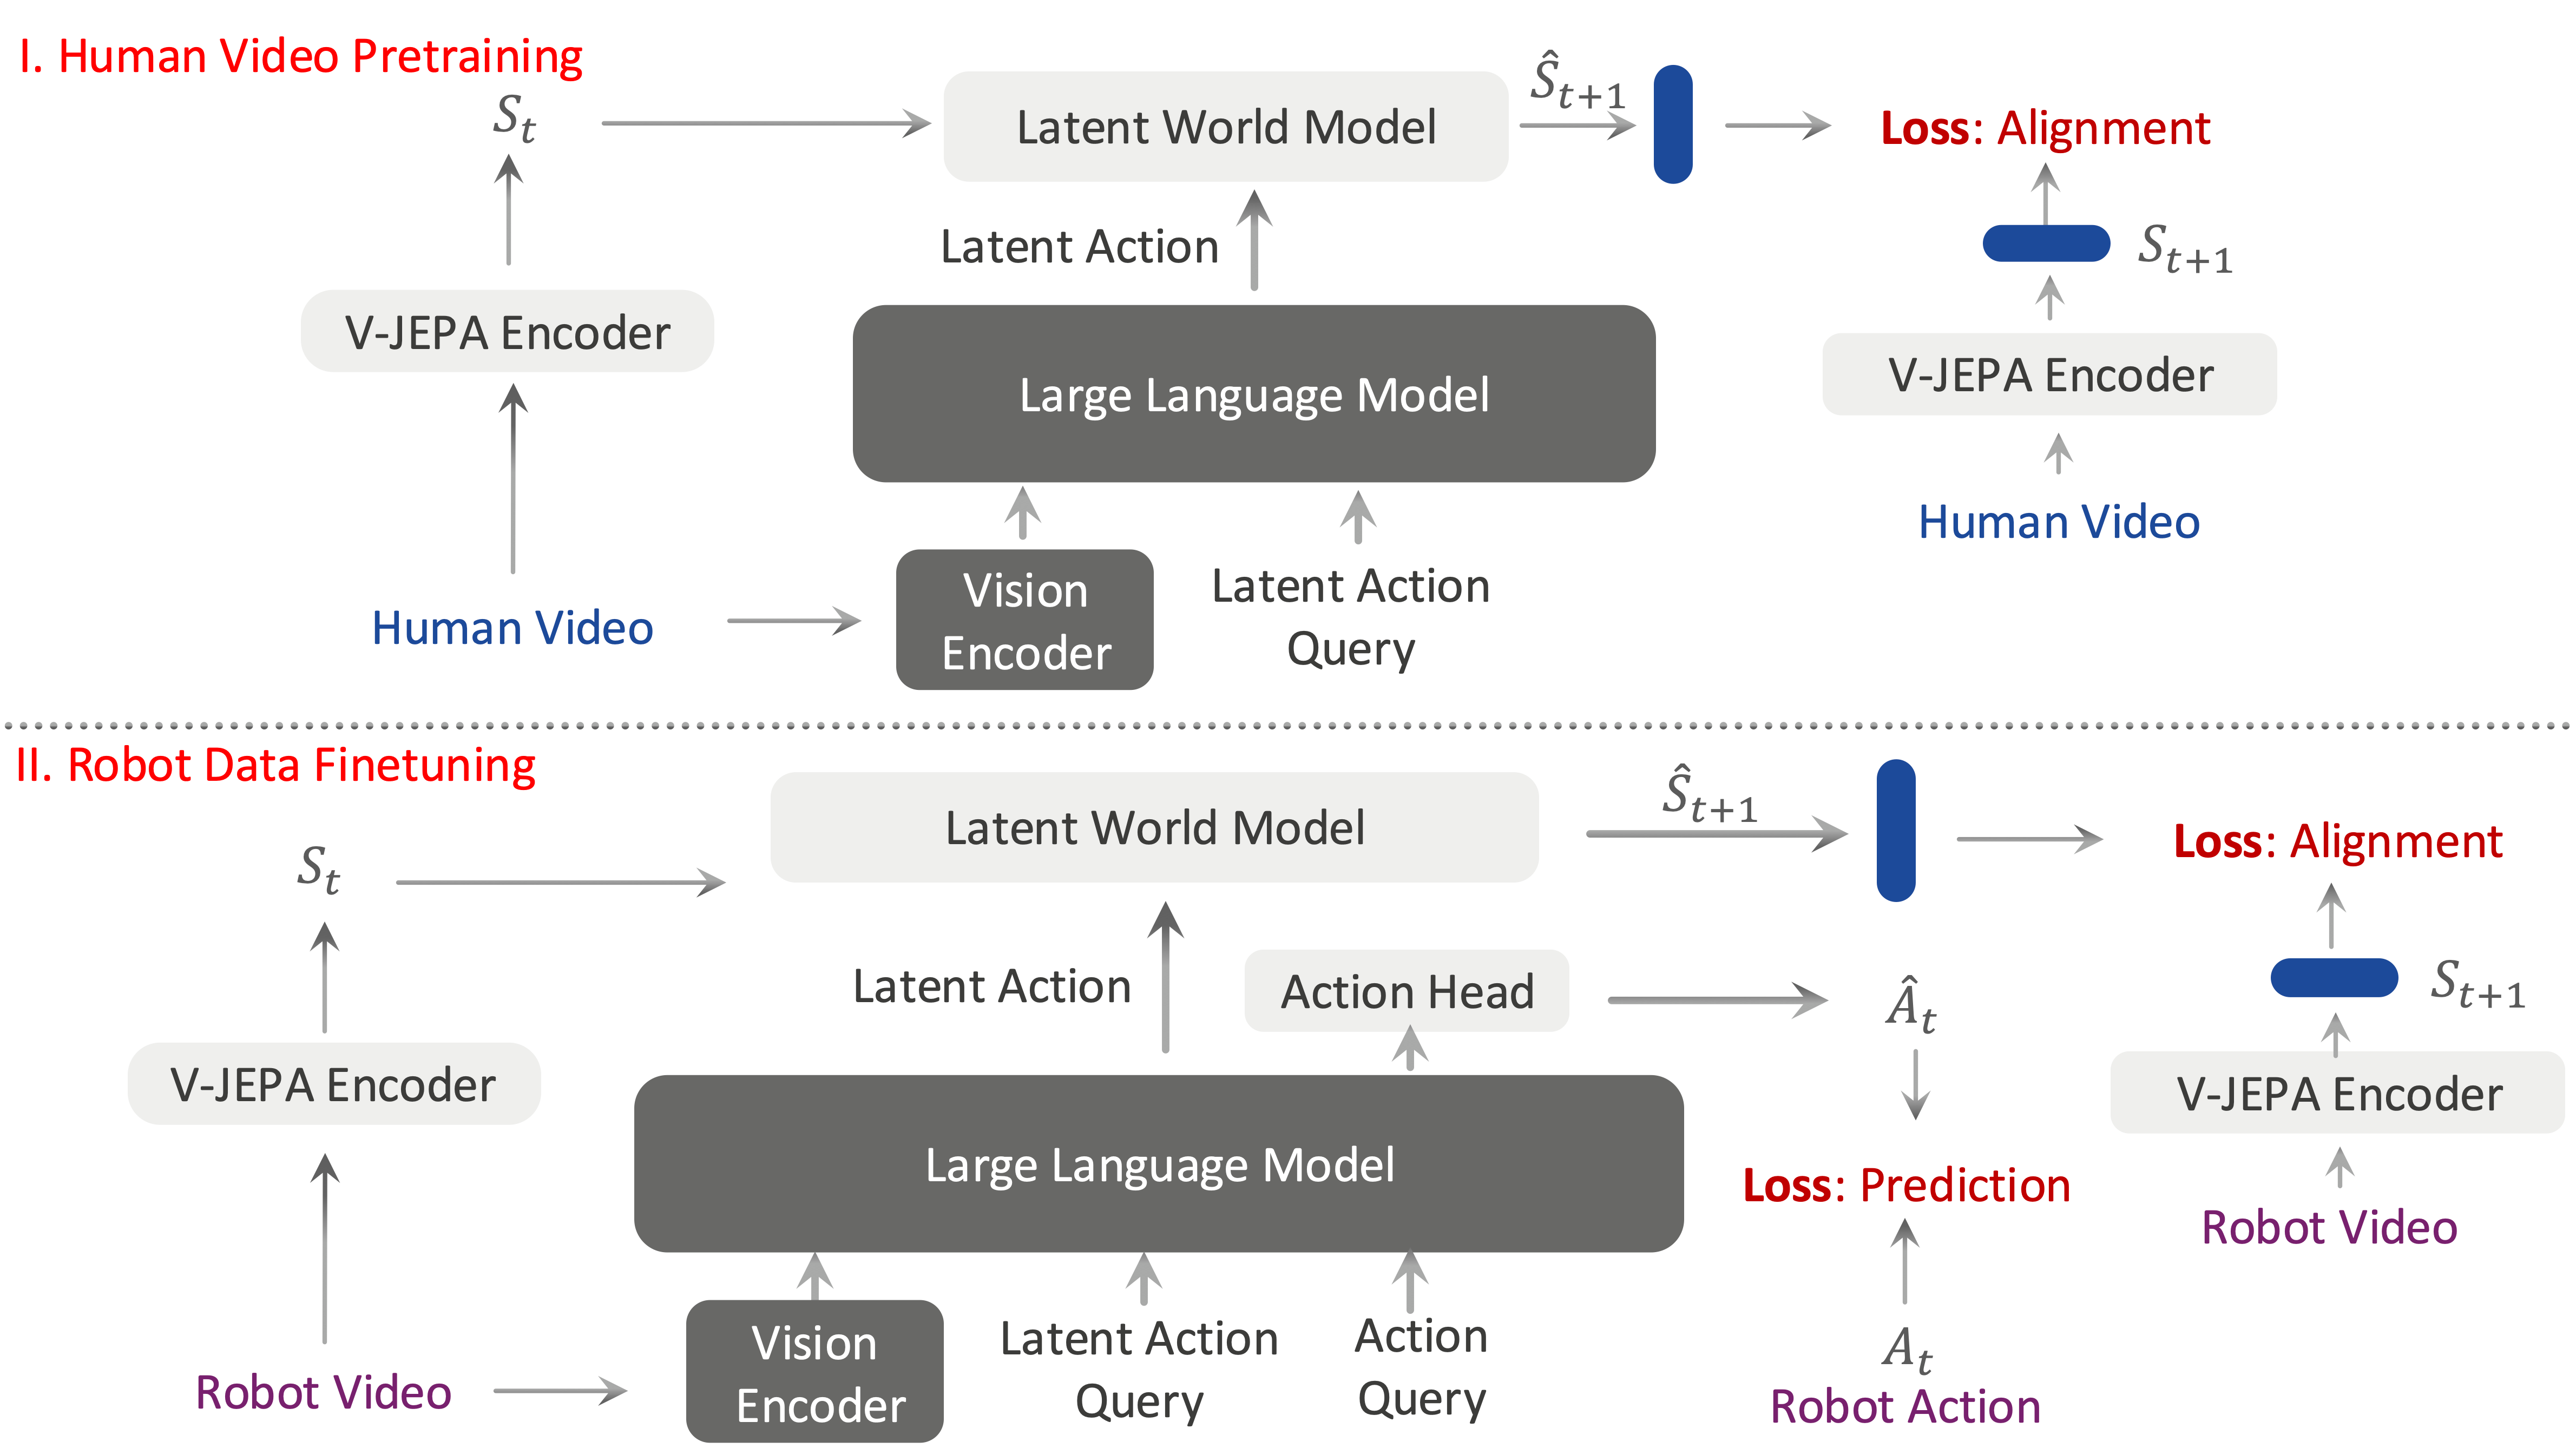
VLA-JEPA 与 FRAPPE 形成互补:FRAPPE强调多个视觉教师的显式对齐,VLA-JEPA强调预训练视频表征中的时序动态。两者都拒绝把未来固定为像素,也都希望未来监督能改变策略内部的条件表征。进一步看,这类方法的成败取决于 latent 是否携带足够的控制信息;如果 latent 只容易预测,却读不出末端状态或物体运动,它仍然可能变成无效世界模型。这也是后面 PSG-JEPA 要处理的问题。
4.7 HiF-VLA:压缩历史运动,预测未来运动
HiF-VLA 关注未来预测的前置条件:历史。单帧无法判断杯子是静止还是正在被推动,直接堆叠多帧 RGB 又会让视觉 token 快速膨胀。HiF-VLA 将历史 RGB 压缩为运动表征,编码成 Hindsight tokens;当前观测和语言提供 Insight;Foresight queries 预测未来运动;动作分支与运动分支通过 Joint Expert 和 cross-stream attention 交互,历史运动信息再通过 AdaLN 调制两条流。官方结果显示,在多视角 LIBERO-Long 上达到 96.4% 成功率,相比直接堆叠历史帧,推理延迟减少 58.3%。
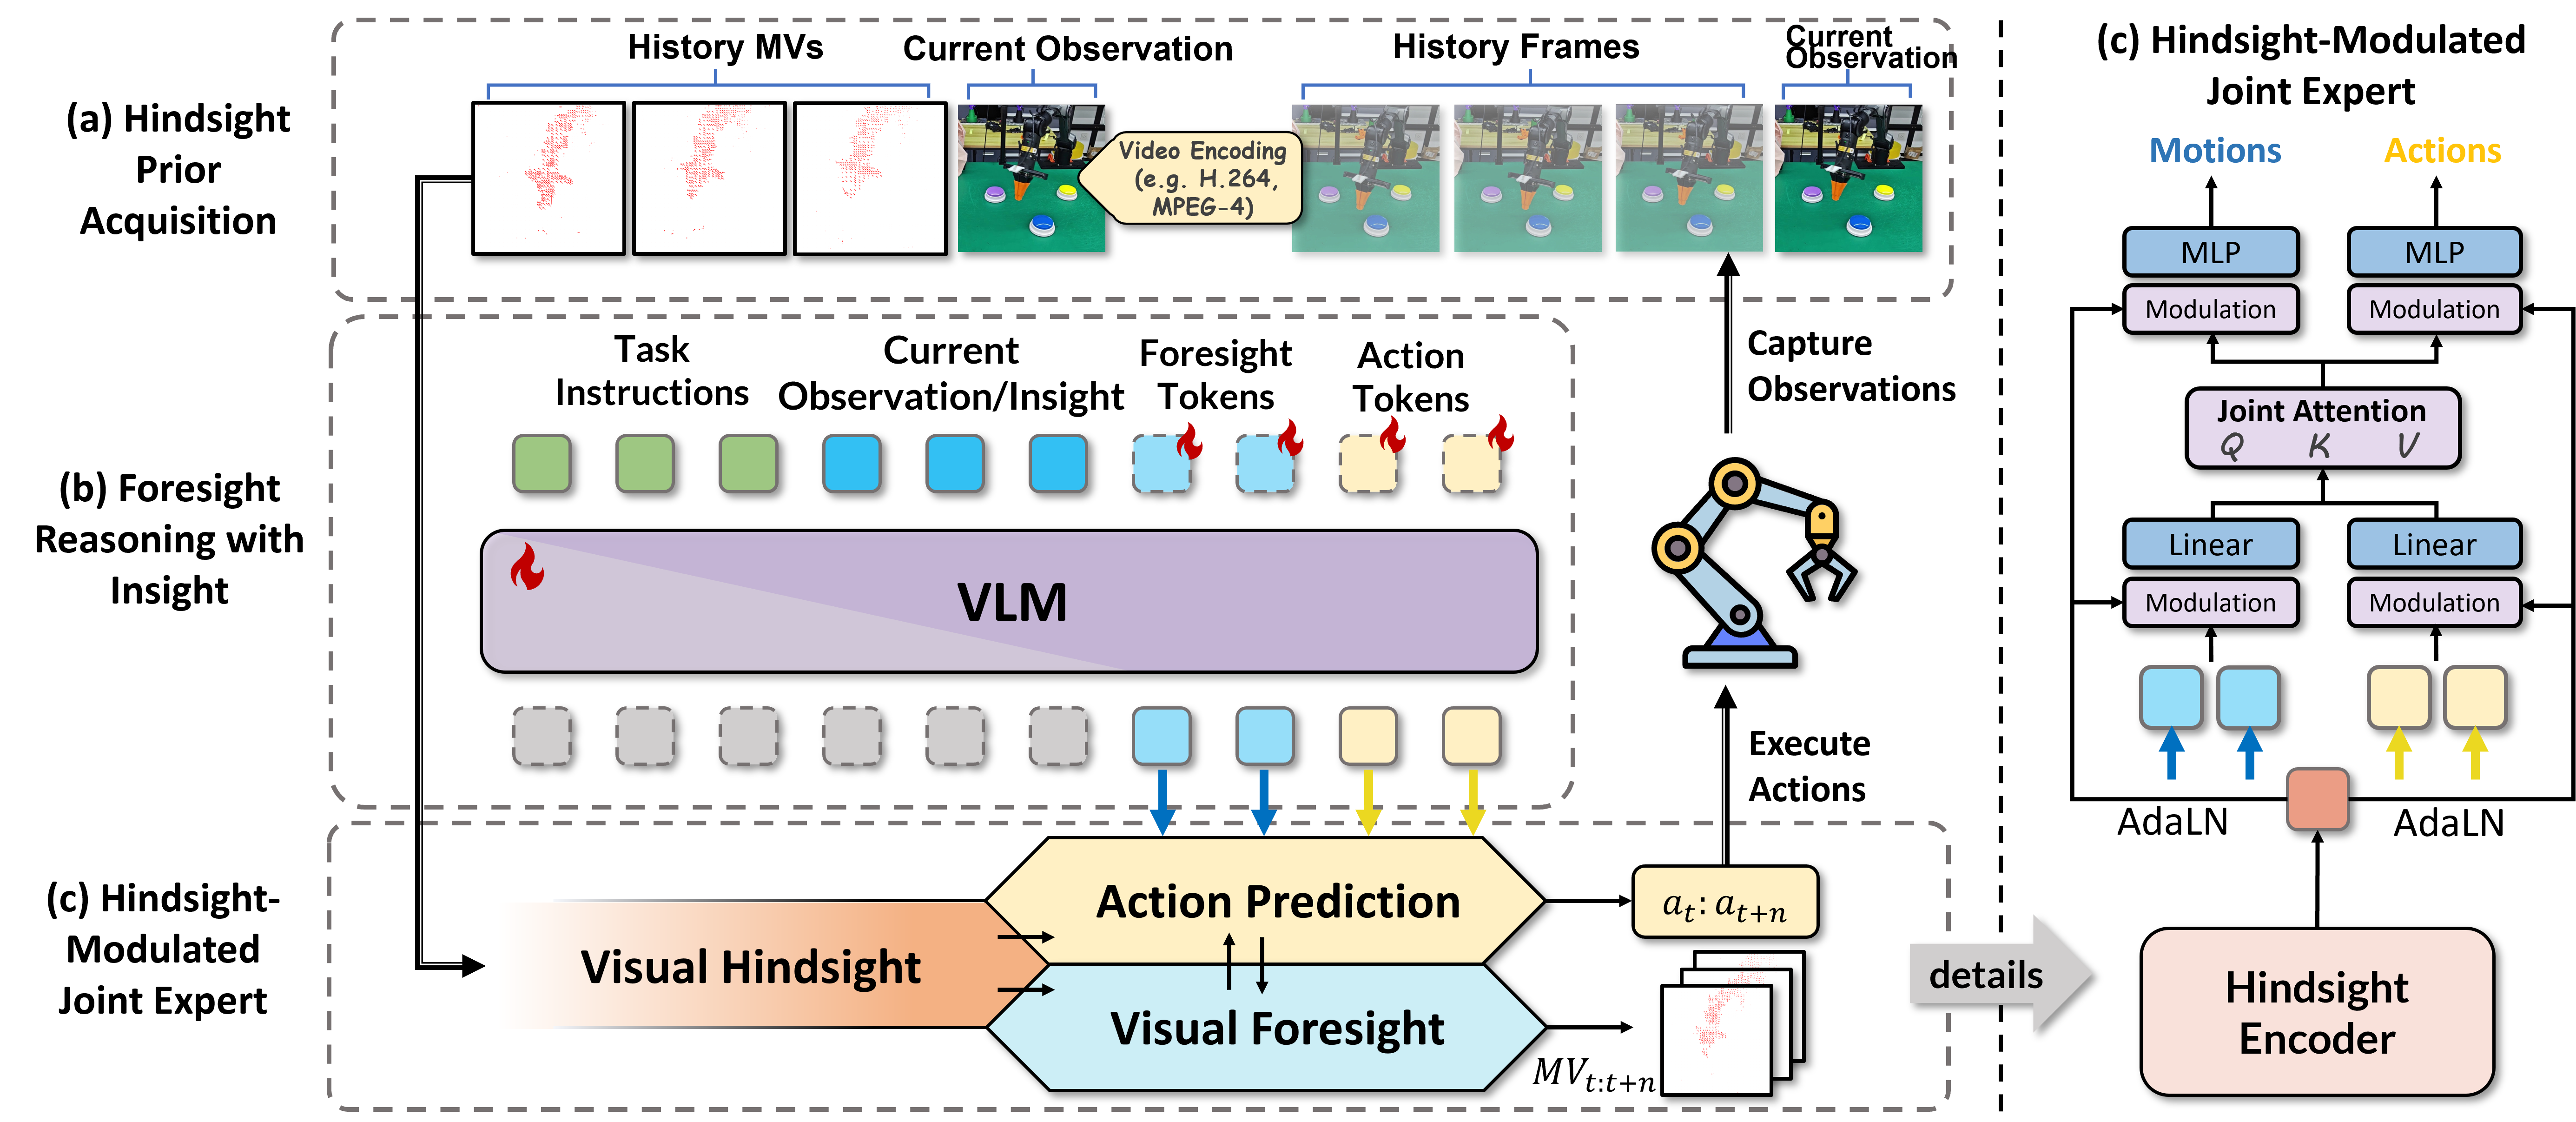
这里的关键是,HiF-VLA 并不是简单加入光流特征,而是在信息论意义上重新分配历史容量:保留“发生了什么变化”,丢弃“过去每个像素长什么样”。这意味着历史建模和未来建模可以被统一为运动语义,而不是帧序列重建。对长时程任务来说,这种压缩比逐帧回放更接近机器人真正需要的记忆形式。
5. 路线二:从像素到行动相关的未来表征
5.1 S-VAM:把慢模型蒸馏成快模型
S-VAM 面对的是速度与质量矛盾。完整视频扩散能生成高质量未来,但多轮去噪太慢;一步扩散特征快,却噪声强、几何与语义纠缠。S-VAM 的做法是先让视频扩散模型完整生成未来,再从中提取 DINOv2 语义特征和 Depth Anything v3 几何特征作为 teacher target,训练轻量 decoupler 将一步扩散特征直接映射为这两类 foresight 表征。部署时不需要完整未来梦,只需一次前向得到语义几何蓝图,整体控制频率约 25Hz。
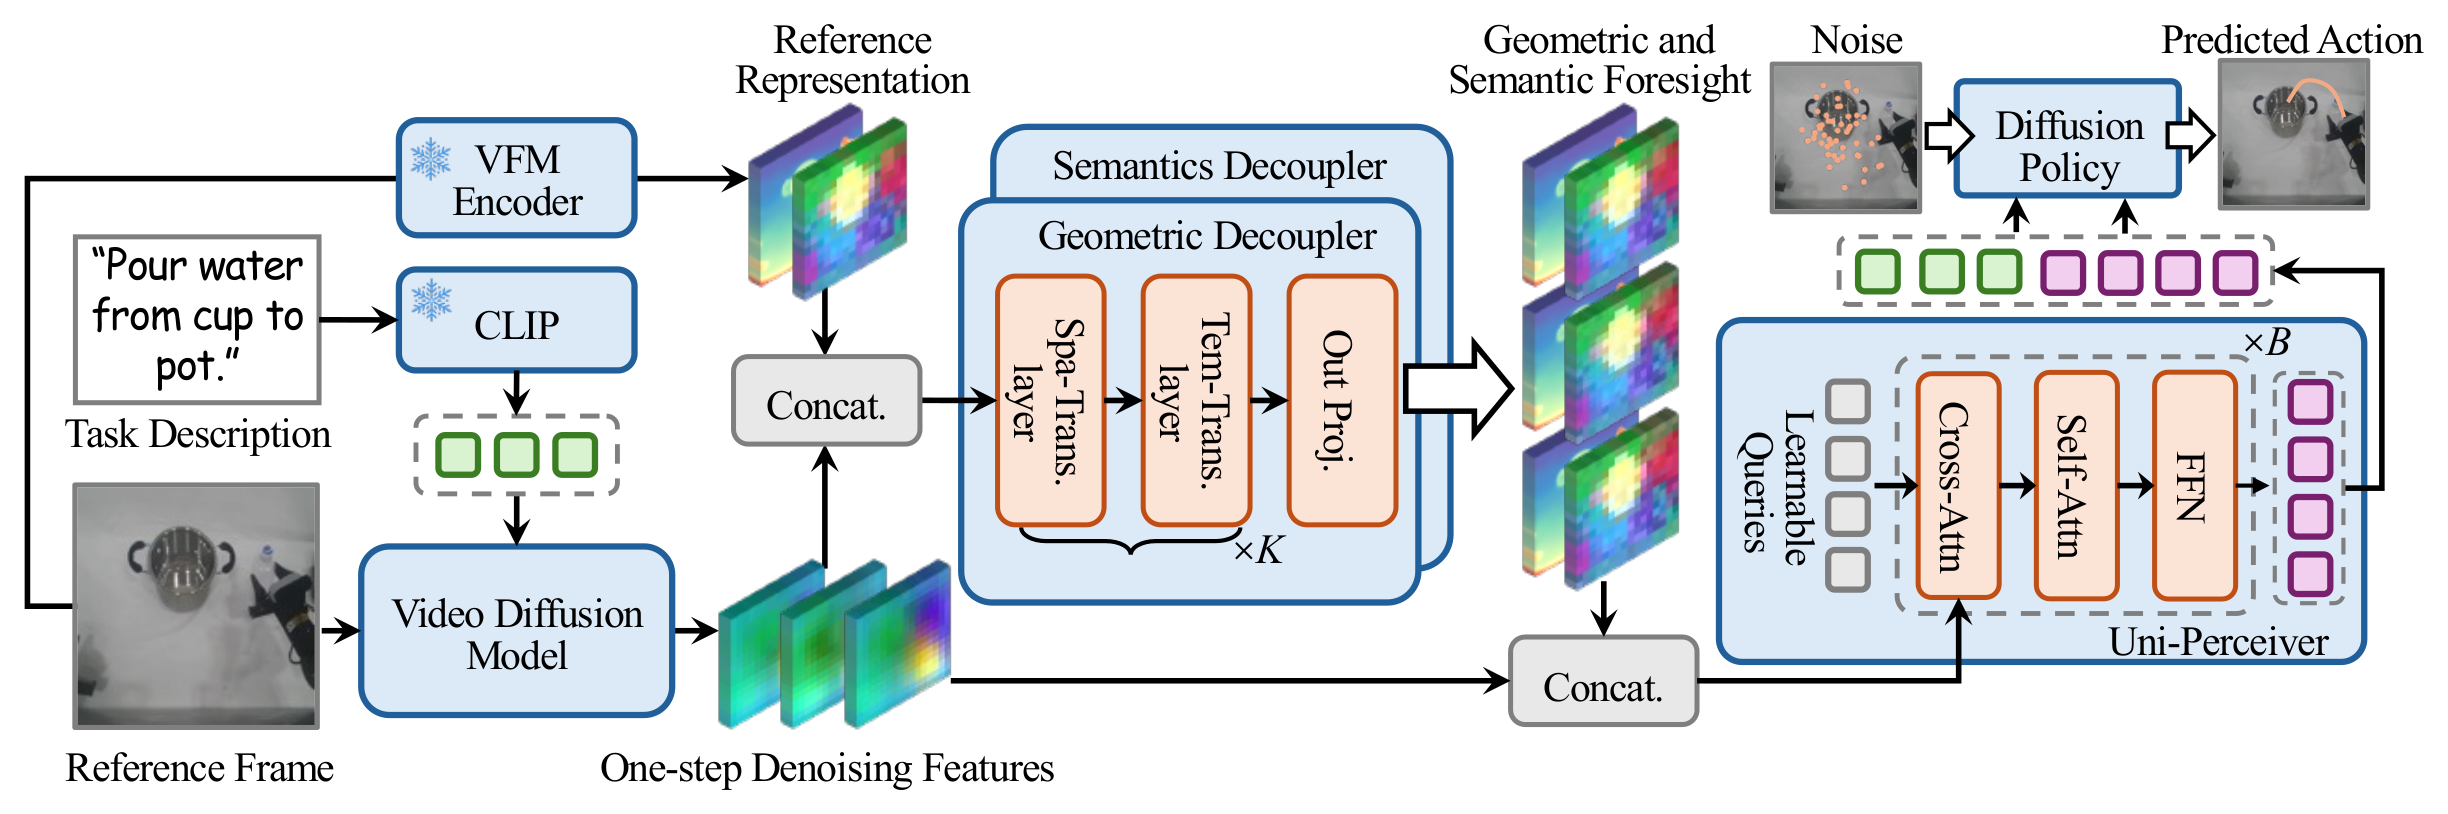
S-VAM 官方 README 将训练流程明确拆成三步:先收集 SVD 特征,再分别训练 hidden2dino 和 hidden2dpa。这三步分别对应数据特征准备、语义教师对齐和几何教师对齐。第一步决定训练样本中保留哪些视频模型的中间表示,后两步把噪声较强的一步特征分别映射到 DINOv2 语义空间和 Depth Anything v3 几何空间,说明蒸馏对象是两类对行动有不同价值的未来结构:
# README.md
python data_collector.py \
  --config_name VPP_Calvinabc_train \
  --video_model_path ${VIDEO_MODEL_PATH} \
  --text_encoder_path ${TEXT_ENCODER_PATH} \
  --root_data_dir ${CALVIN_DATA_DIR} \
  --save_dir ./vis_dataset_features

python hidden2dino/train_new_st.py \
  --data_dir ./vis_dataset_features \
  --hub_dir ${DINOV2_PATH}

python hidden2dpa/train_new_st.py \
  --data_dir ./vis_dataset_features \
  --model_dir ${DA3_PATH}
这个流程很有代表性:慢速世界模型不是最终部署组件,而是制造监督信号的教师。训练时可以花大量去噪步骤得到高质量目标,部署时只保留能一步取出语义和几何结构的映射。这里的关键是,S-VAM 把未来拆成几何与语义两种稳定结构,避免模型把容量浪费在与行动无关的纹理上。它解决的是“想得清”和“来得及”之间的工程折中。
5.2 Robust-WAM:生成先验与语义鲁棒性并存
Robust-WAM 处理另一个矛盾:视频生成模型的 VAE latent 继承了动态先验,但 VAE 以像素重建为目标,对光照、纹理和颜色敏感;DINO 类语义特征更鲁棒,却不能直接继承视频生成预训练。Robust-WAM 的选择是保留 VAE 生成通路,同时在动作流中加入语义未来监督。它在未来时间步和视角位置插入 learnable query,经 Action DiT 后对齐真实未来帧的 DINOv3 特征;query 复用对应动作 token 的时序位置编码,DINOv3 与对齐 head 只在训练时存在,部署时删除。
这类设计的价值在干净环境中不一定明显,但在光照变化、背景材质变化和外观扰动下更可靠。进一步看,它承认了两种表征的分工:VAE latent 负责保留大规模视频动态先验,DINO 语义特征负责告诉动作流哪些变化是任务相关的。换句话说,Robust-WAM 不是在生成空间和语义空间之间二选一,而是让世界先验和动作锚点分别承担不同职责。
5.3 PSG-JEPA:可预测不等于物理
PSG-JEPA 提出了一个尖锐问题:一个 forward prediction loss 很低的 latent,未必能读出末端执行器 yaw 这样的基础物理状态。JEPA 世界模型学习给定当前状态和动作后下一个 latent 应该是什么,绕开了像素冗余,但如果 latent 中没有稳定编码机器人物理状态,它仍然可能无法支撑控制。PSG-JEPA 因此加入物理 grounding:state grounding 要求单个 latent 回归机器人本体状态;transition grounding 要求从两个时刻的 latent 预测关节角变化。这些状态不作为世界模型输入,grounding head 训练后也删除,因此不增加部署成本。
官方结果显示,PSG-JEPA 在 LIBERO-Goal 上相较 LeWM 提升 7.6 个百分点,相较 DINOv2 提升 5.2 个百分点;真实机器人平均成功率相较 LeWM 提升 19.3 个百分点。这里的关键是判断标准变了:世界模型不能只用未来预测误差评价,还要检查未来表征是否保留可恢复的物理变量。直观理解是,一个人能背出下一张牌面,并不代表他知道牌是怎么被推过去的。
5.4 DINO-WM:在 DINO 特征空间规划
DINO-WM 是 latent WAM 的清晰例子。它在 DINOv2 patch feature 空间中学习 action-conditioned world model,预测未来 latent 而不生成像素,并支持 zero-shot planning。官方架构图显示,模型将历史视觉特征、本体状态和动作编码为 latent,再用 predictor 滚动预测未来状态,规划器在 latent 空间中比较预测结果与目标。相比像素 rollout,这条路径把搜索开销压到特征空间;相比纯策略模仿,它让动作可以通过“预测是否接近目标”被显式评估。
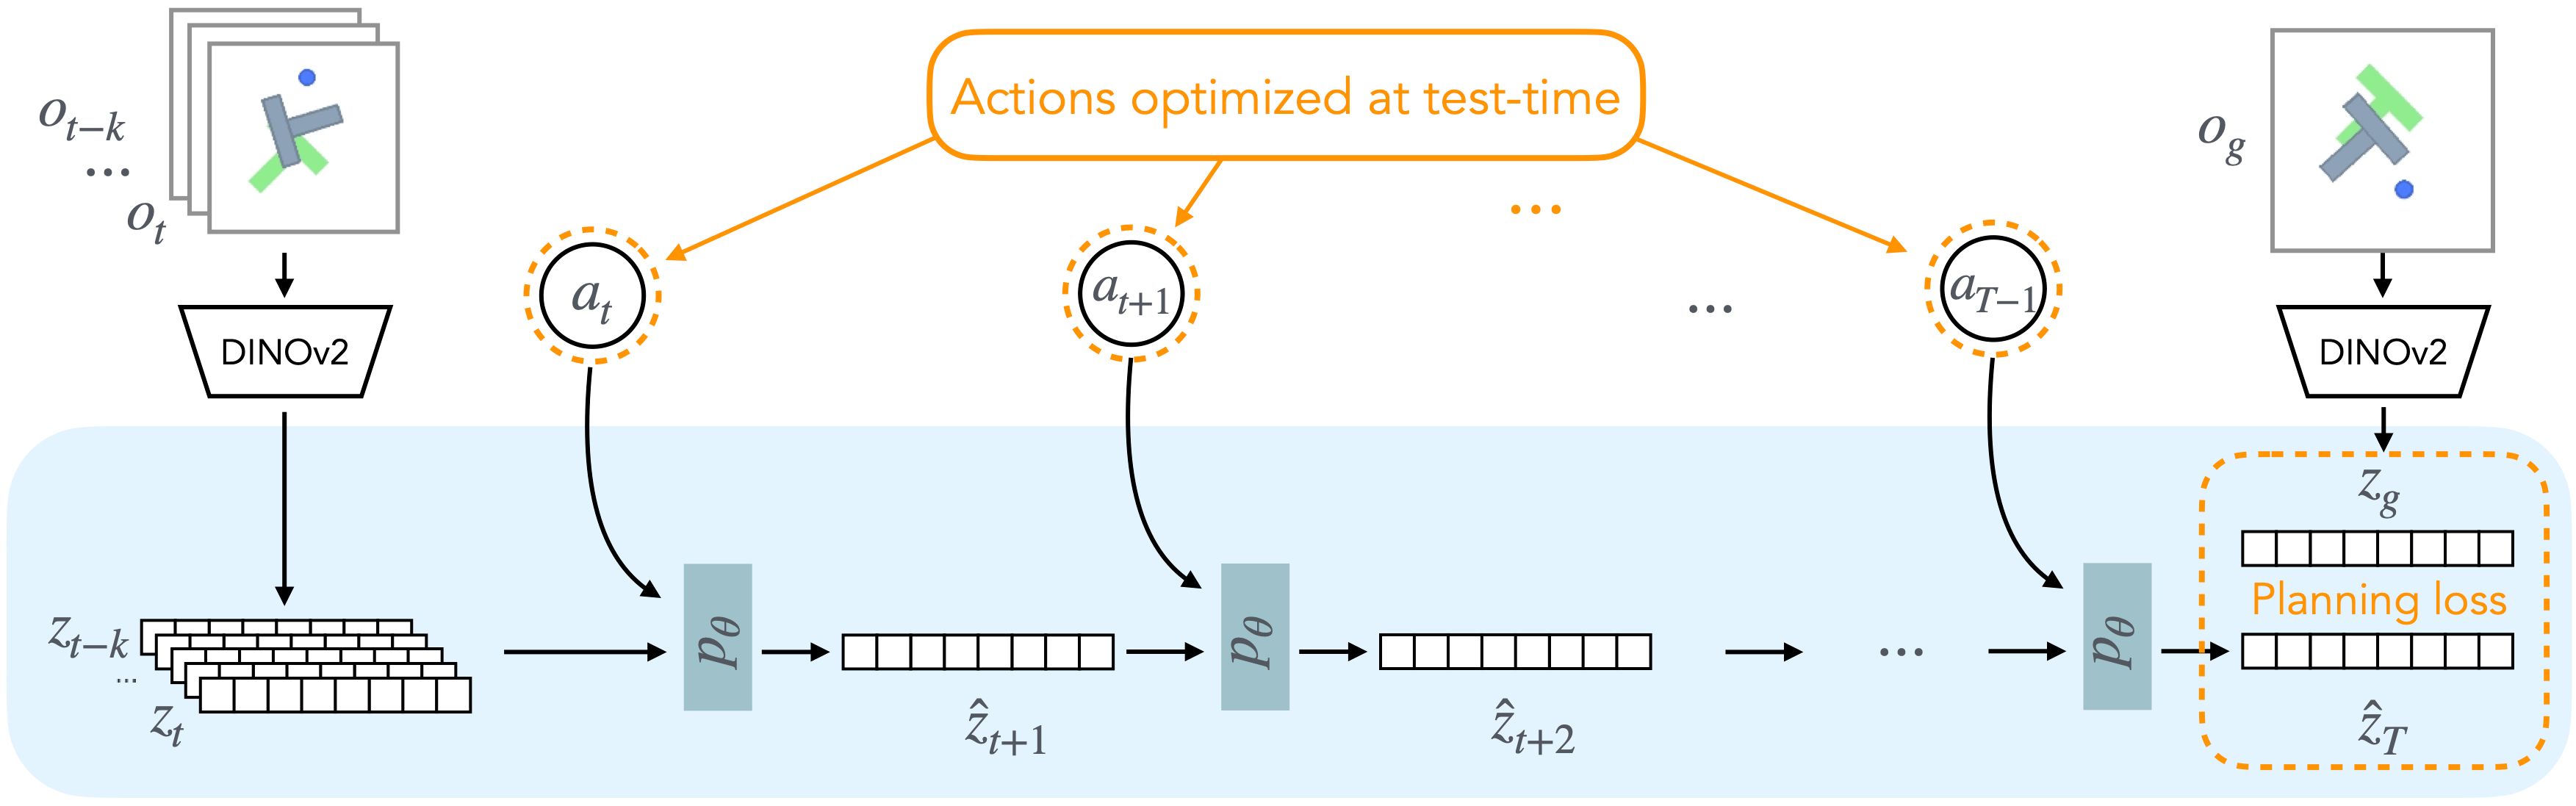
DINO-WM 的编码与预测逻辑非常直接:先让视觉特征、本体状态和动作进入同一个张量布局,再交给 predictor 处理时序和 token 之间的关系。encode_obs 提供视觉和本体状态,encode_act 把候选动作变成可交互的条件 token,随后 predictor 在同一个序列上完成状态转移。下面的代码把这三类信息编码为统一 latent,再调用 predictor 完成隐空间预测,可以把它视为世界模型的最小执行单元:
# models/visual_world_model.py
def encode(self, obs, act):
    z_dct = self.encode_obs(obs)
    act_emb = self.encode_act(act)
    if self.concat_dim == 0:
        z = torch.cat(
            [
                z_dct["visual"],
                z_dct["proprio"].unsqueeze(2),
                act_emb.unsqueeze(2),
            ],
            dim=2,
        )
    return z

def predict(self, z):
    z = rearrange(z, "b t p d -> b (t p) d")
    z = self.predictor(z)
    z = rearrange(z, "b (t p) d -> b t p d", t=T)
    return z
这个实现没有图像解码依赖,预测目标是特征序列,因此规划可以在特征空间完成。DINO-WM 的 CEM 规划器体现了测试时搜索的使用方式:采样候选动作,让世界模型滚动预测,按目标距离评分,再用 top-k 动作更新搜索分布。这个循环把世界模型从“帮助训练的辅助头”变成执行前反复调用的后果评估器:
# planning/cem.py
action = (
    torch.randn(
        self.num_samples, self.horizon, self.action_dim
    ).to(self.device)
    * sigma[traj]
    + mu[traj]
)

with torch.no_grad():
    i_z_obses, i_zs = self.wm.rollout(
        obs_0=cur_trans_obs_0,
        act=action,
    )

loss = self.objective_fn(i_z_obses, cur_z_obs_g)
topk_idx = torch.argsort(loss)[: self.topk]
topk_action = action[topk_idx]
mu[traj] = topk_action.mean(dim=0)
sigma[traj] = topk_action.std(dim=0)
CEM 的每轮迭代都在回答同一个问题:如果把当前候选动作施加给世界模型,预测出的未来状态是否会比其他候选更接近目标。搜索分布会根据 top-k 候选不断收缩,相当于先大范围探索,再围绕可靠方案细化;如果候选集合质量较差,目标函数也会决定搜索是否继续停在错误区域。对应的目标函数可以写成:
a ⋆ = arg min a d ( f θ ( z t , a ) , z g ) , a^\star = \arg\min_a d\left( f_\theta(z_t, a), z_g \right), a⋆=argamind(fθ(zt,a),zg),
其中 z g z_g zg 是目标状态表征, d d d 是任务定义的距离或目标函数。这里的关键是,DINO-WM 把世界模型从“训练辅助”推到“推理时规划器”,同时用特征空间预测规避了像素生成的开销。它适合目标状态明确的任务,但仍需要解决特征空间中接触、遮挡和物理可行动性的表达问题。
难点提示:在 latent 空间规划有点像在等高线地图上选登山路线,地图不需要画出每棵树,但必须可靠表达坡度和方向。如果特征空间把目标距离拉平,或者忽略夹爪接触后的微小位移,CEM 就会沿着看似最优、实际不可行的路径搜索。因此,特征空间的目标函数往往比采样数量更能决定规划质量。
5.5 4D-WAM:三维轨迹场监督
4D-WAM 把未来表征从二维帧推向动态三维世界。它不直接生成 3D trajectory field,而是在训练时用 4D foundation model 提取物体和场景随时间变化的轨迹表示,再用它约束 WAM 中间 feature。方法包含 Motion Alignment 和 Destination Alignment:前者对齐相邻时刻的局部运动变化,后者从起点和目标之间的相似度分布提供长程约束。实验发现,直接对齐绝对 feature 并不理想,因为两个模型的预训练目标不同,表示空间不天然对应;4D-WAM 因此对齐时间变化。
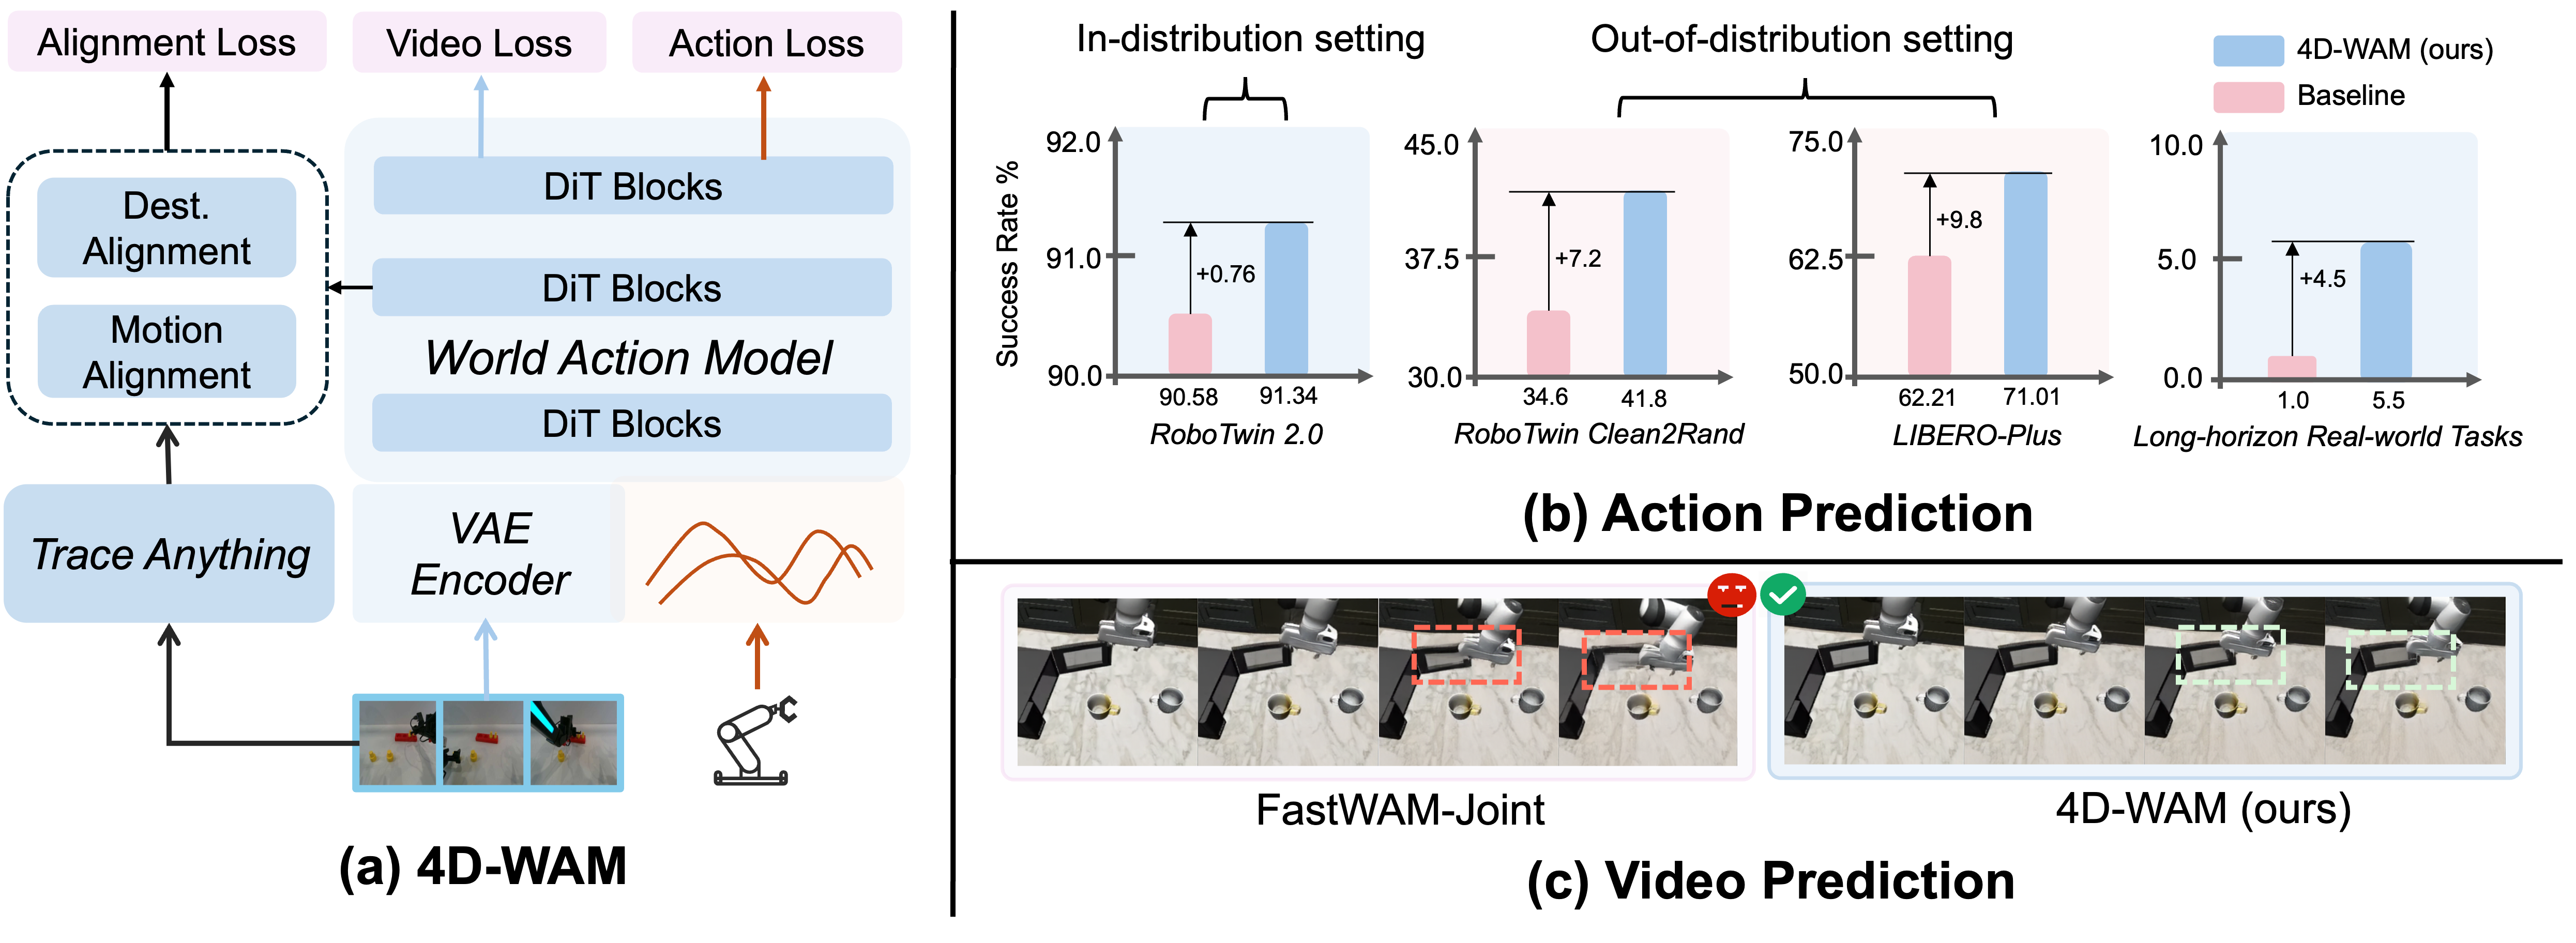
官方实现中的 motion_incremental_alignment_tokenwise 清楚体现了这个选择:先计算 WAM feature 和 trajectory feature 的相邻帧差分,再对差分方向做余弦对齐。相比直接要求两组绝对特征相等,这种写法只约束“变化方向”,降低了两个预训练模型表示空间不兼容带来的冲突,也避免 WAM 为了模仿 4D foundation model 的静态语义而牺牲自身动作建模能力:
# FastWAM/src/fastwam/models/wan22/alignment.py
delta_h = h[:, 1:] - h[:, :-1]
delta_ta = ta[:, 1:] - ta[:, :-1]

delta_h = F.normalize(delta_h, dim=-1, eps=eps)
delta_ta = F.normalize(delta_ta, dim=-1, eps=eps)
cos_sim = (delta_h * delta_ta).sum(dim=-1)
return 1.0 - cos_sim.mean()
把这个实现还原成公式,可以看到 4D-WAM 监督的核心不是物体语义本身,而是相邻时间步之间特征如何移动。它关心的不是“同一把椅子在两个模型里是否使用同一个向量表示”,而是“椅子的位移、旋转和接触变化在两个模型中是否指向同一方向”。对应损失为:
L motion = 1 − cos ( Δ h t , Δ τ t ) , \mathcal{L}_{\text{motion}} = 1 - \cos\left( \Delta h_t, \Delta \tau_t \right), Lmotion=1−cos(Δht,Δτt),
其中 Δ h t \Delta h_t Δht 是 WAM 特征的时间差分, Δ τ t \Delta \tau_t Δτt 是轨迹场特征的时间差分。这个设计比直接特征匹配更合理:两个模型不必对“这个物体是什么”达成一致,但要对“它如何运动”达成一致。这意味着轨迹场监督把优化目标从静态语义转向了时空动态,也更贴近机器人关心的物体位移、旋转和接触引起的空间变化。
5.6 RoboDreamer:组合式世界模型
RoboDreamer 提供了比单帧未来更早的组合式思路。它将语言指令拆解为低层视频生成原语,再通过因子化组合生成未来,让模型能够表达对象、空间关系、时间顺序和动作约束等结构。与端到端黑箱视频生成相比,这种做法更容易解释未来中哪一部分对应任务结构;与纯符号规划相比,它保留了视觉生成的连续性。进一步看,RoboDreamer 的价值在于把“想象”拆成可组合的操作单元,而不是要求一个模型一次性生成完整任务视频。
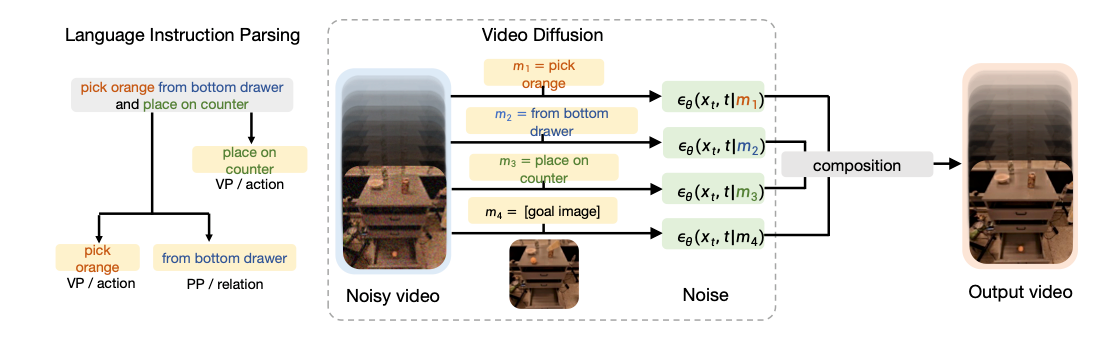
把 RoboDreamer 与 DINO-WM 放在一起,可以看到两条不同的“去像素化”路线。DINO-WM 保留视觉特征但去掉像素解码,RoboDreamer 保留视频生成但把生成过程结构化。前者偏规划和控制效率,后者偏任务分解与可解释想象。这里的关键是,WAM 的未来表示不必在“完全 latent”和“完全像素”之间二选一,中间还可以存在结构化视觉、语义 token、几何图、轨迹场和技能级接口。
5.7 PraxisWorld:技能接口与世界状态
PraxisWorld 从技能角度重新审视世界模型:一个长任务并不是一串无差别的动作帧,而是由若干技能单元、技能前置条件和技能效果连接而成。与逐帧预测相比,这种视角把“世界在变”改写成“技能执行后世界满足什么条件”,更适合解释长时程任务为什么能组合、在哪里失败以及如何恢复。它把原子技能形式化为:
K = ( R , S , X , C , I , π , β , Δ , E ) , K = (R, S, X, C, I, \pi, \beta, \Delta, E), K=(R,S,X,C,I,π,β,Δ,E),
其中包含对象锚点、状态、执行条件、控制策略、边界与效果等要素。这里的重点是,每个技能既是一个控制过程,也是一个会改变世界状态的事件;技能之间的接口可以被检查,失败后也可以定位到某个前置条件没有被满足。技能组合不是简单串联,而要满足:
Δ i ⇒ I j , \Delta_i \Rightarrow I_j, Δi⇒Ij,
即前一个技能的效果必须满足后一个技能的初始化条件。这个公式把“世界变化”变成可验证接口,而不是只存在于 latent 中的连续向量。对 WAM 来说,PraxisWorld 的提醒很直接:未来模型如果无法输出或估计技能效果 Δ \Delta Δ,就很难支撑长时程任务的组合、失败诊断和恢复。它评价世界模型的标准因此从“下一帧像不像”扩展到“下一个技能能不能接上”。
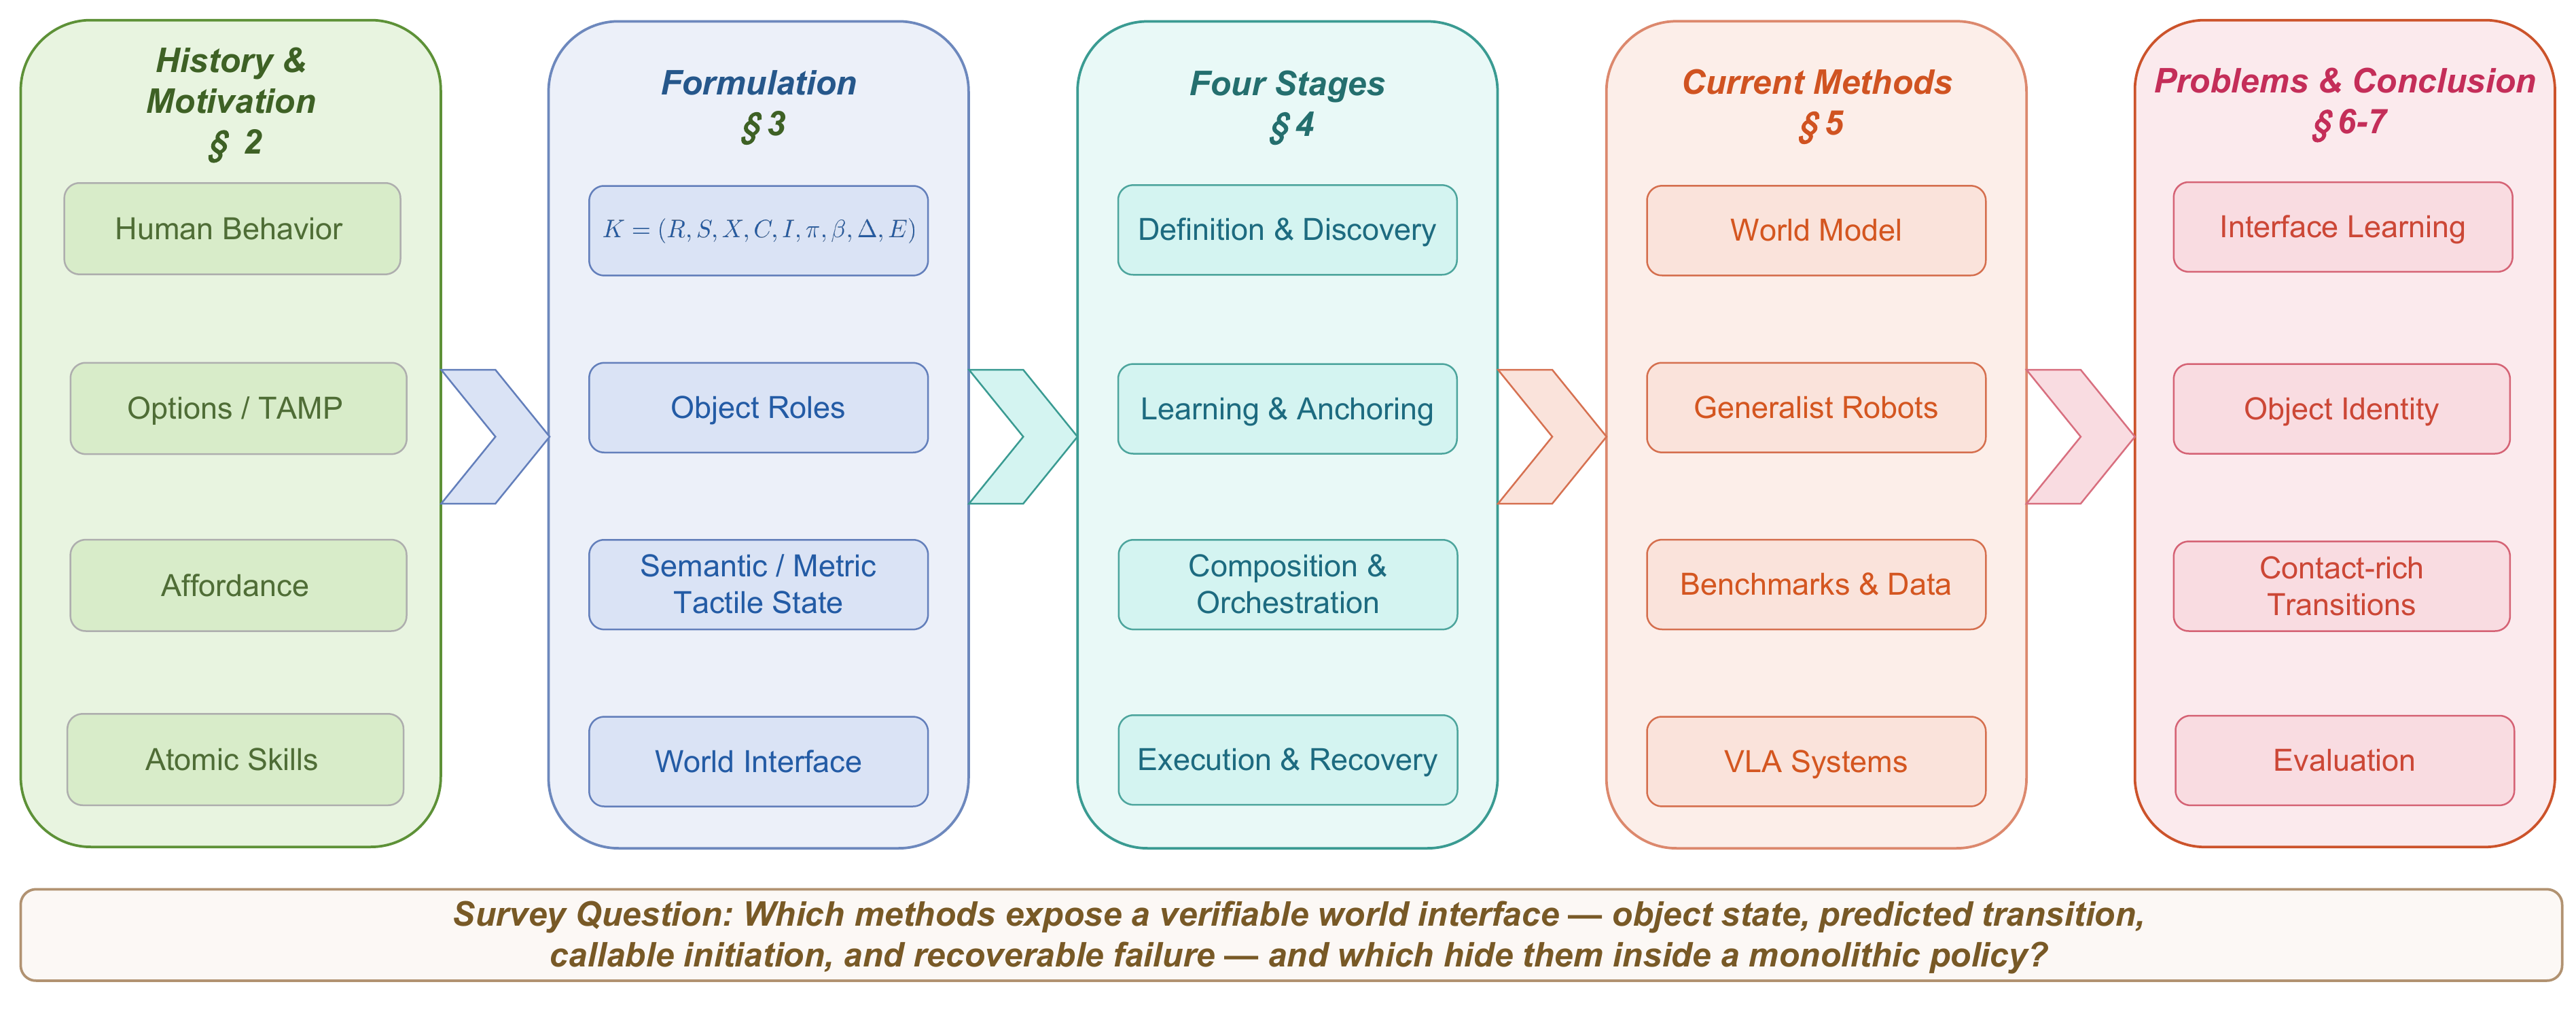
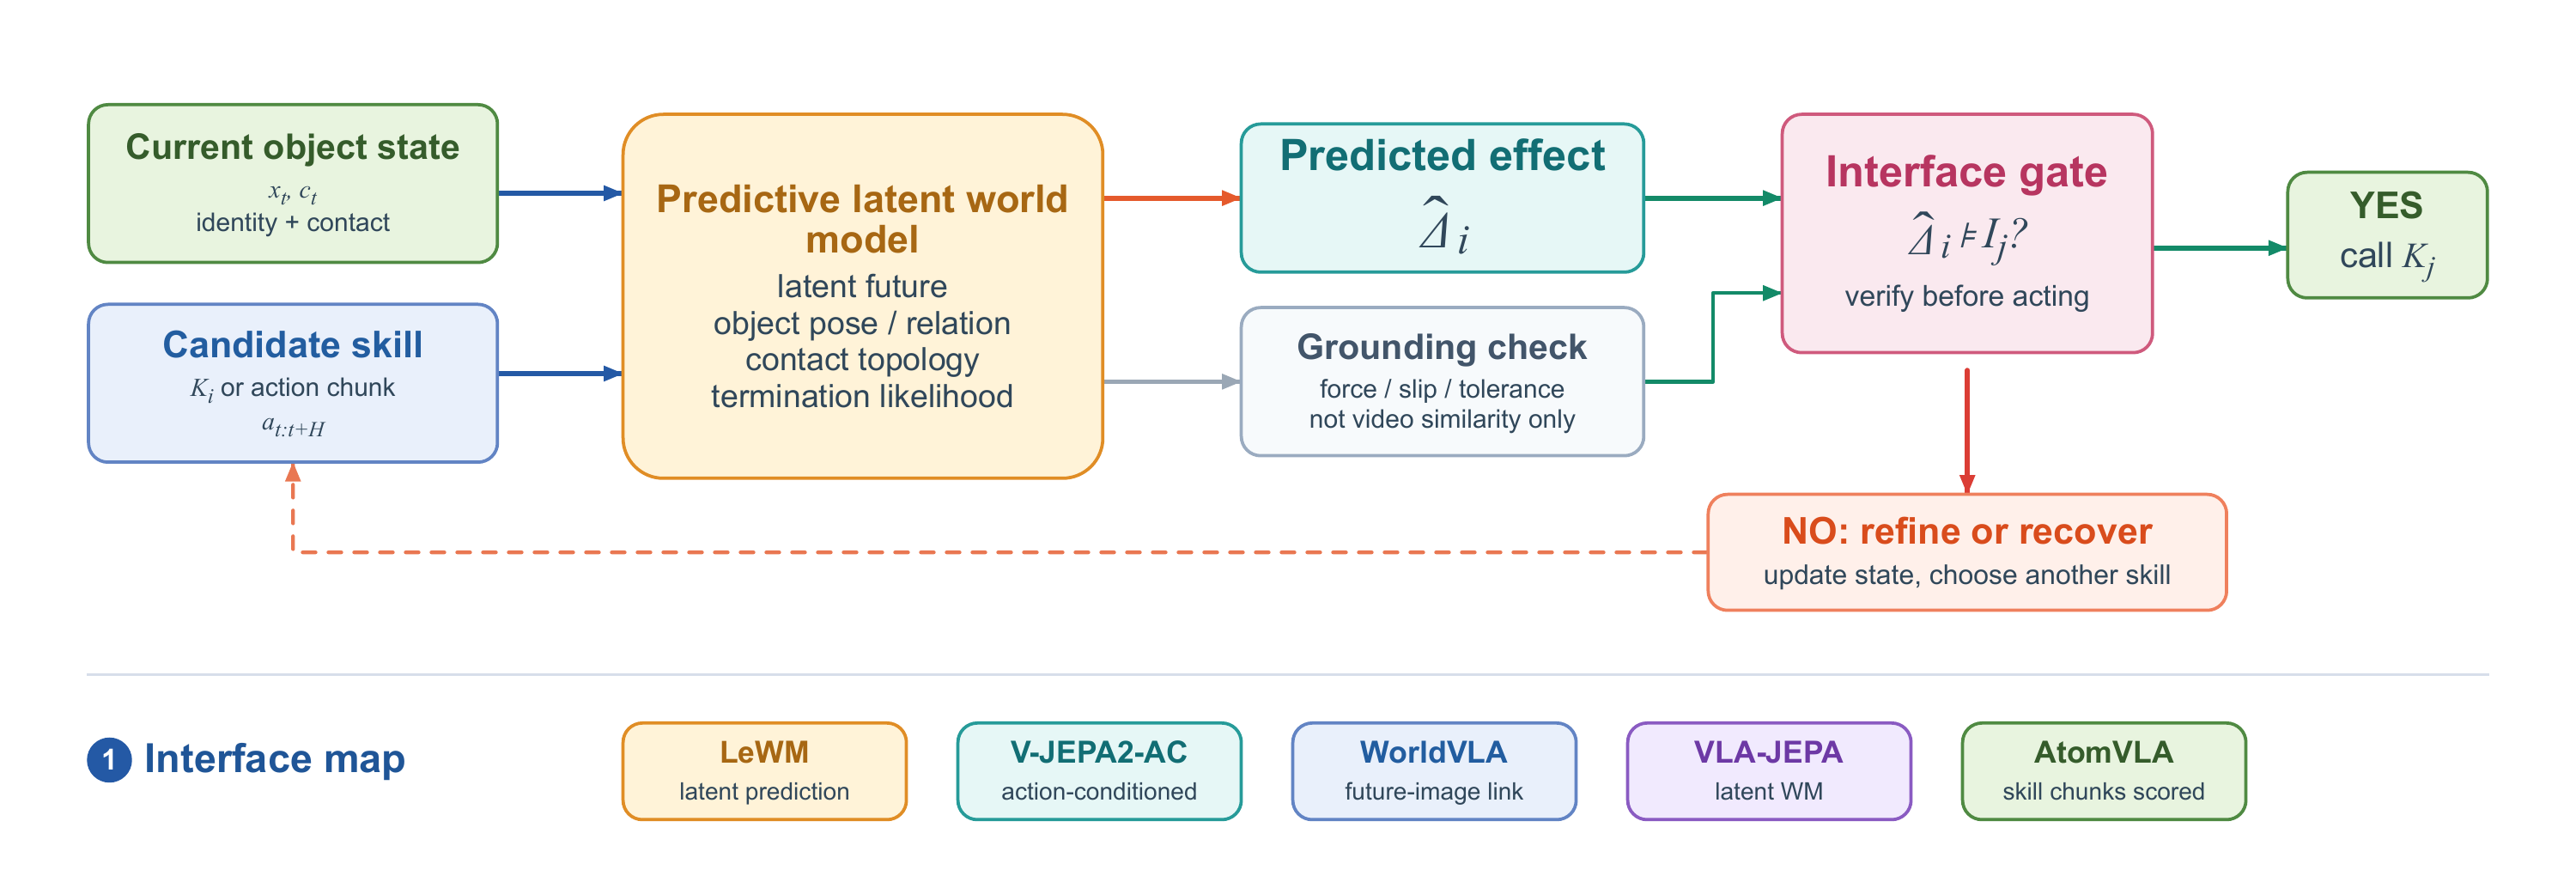
PraxisWorld 的意义在于给 WAM 增加了一个更高的评价维度:不仅要预测下一帧或下一个 latent,还要预测技能边界、异常状态和可恢复入口。直观理解是,搭积木时重要的不只是每块积木的图像,而是上一块放完后,下一块是否具备了可以继续搭的条件。这个视角把世界模型从感知预测器推向任务系统的状态机估计器。
6. 路线三:移动操作、触觉与测试时决策
6.1 MobileWAM:移动操作不是桌面加底盘
MobileWAM 面向移动操作。机械臂固定时,视角相对稳定,动作范围有限;底盘移动后,相机持续产生 ego-motion,同一任务存在大量底盘与机械臂协同路径,且移动是大尺度低频运动,抓取和接触又是小尺度高精度控制。MobileWAM 用 Wan 视频扩散 Transformer 作为 World Expert,用轻量 Action Expert 生成动作,两者逐层联合注意力,但注意力是不对称的:动作 token 可以读取视觉 token,视觉 token 不读取动作。部署时 World Expert 可退化为当前帧 encoder,当前视觉特征只计算一次并缓存,后续 action denoising 复用。
MobileWAM 还提出 Chain-of-Foresight,让多个中间层串联预测 future latent chain,为长程动态提供监督。最关键的部署选择是:未来生成与 CoF 全部删除,只保留被未来监督塑造过的当前表征和动作策略。这意味着未来可以只存在于训练阶段,充当把动态理解压入当前表征的辅助信号,而不是每次控制都要显式想象一遍。
6.2 DreamTrajectory:从生成动作到评估后果
DreamTrajectory 进一步让世界模型参与测试时决策。移动操作的 whole-body action space 很大,底盘位姿、朝向和机械臂关节共同变化,直接从图像和语言搜索完整动作块困难。它先让 Action Expert 生成 intention-level end-effector trajectory,用任务空间轨迹引导全身动作;再训练轻量 trajectory world model,输入候选动作块,预测这些动作真正执行后的末端轨迹。测试时执行 search、predict、score、execute:策略采样多个候选动作,世界模型预测后果,比较预测轨迹与目标轨迹,最后选择最接近者执行。
官方结果显示,DreamTrajectory 将 MS-HAB 成功率从 32.3% 提升到 47.5%,测试时 refinement 后达到 54.8%。这个数字的意义不只是提升幅度,而是证明了世界模型可以作为后果模拟器进入决策循环。这里的关键是,早期 WAM 的逻辑是“预测未来,从而学到更好动作”,DreamTrajectory 的逻辑变成“我有多个动作,先预测每个动作会发生什么,再决定执行哪一个”。
6.3 TARO:触觉世界动作模型
TARO 把 WAM 从视觉扩展到视觉触觉联合建模。接触密集任务中,视觉难以可靠判断微小错位、滑移和接触力,而触觉信号恰恰对这些变化敏感。TARO 将视觉和触觉观测编码到 shared latent,用 compact conditioning-free flow matching 同时生成 action chunk、future visual latent 和 future tactile latent。由于视觉和触觉变化的时间尺度不同,它对视觉 latent 使用较大时间偏移的预测,对相邻触觉 latent 保持细粒度监督。官方项目页报告,TARO 在仿真中相对最强 baseline 提升 6.8%,控制频率达到 96.6Hz。
…详情请参照古月居

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献160条内容

所有评论(0)