【LAAP科研】双系统具身AGI范式研究——基于LAAP认知架构与Jev概率决策模型的系统性技术调研与范式验证
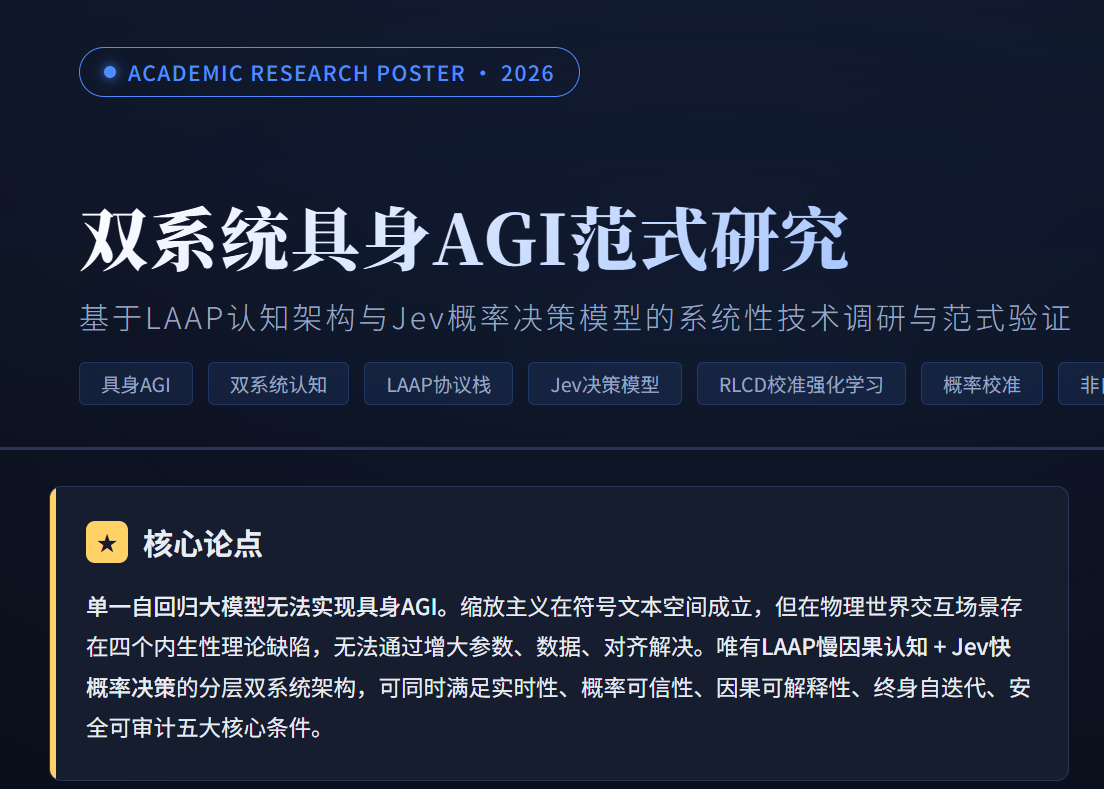
摘要:当前通用人工智能(AGI)研究长期被自回归生成式范式垄断,以GPT、LLaMA、Gemini为代表的因果解码器大模型在符号生成任务取得突破,但在具身交互、实时决策、安全关键自动化、物理世界闭环任务中存在无法通过缩放参数、数据、对齐优化解决的结构性缺陷:串行解码延迟、无约束开放式幻觉、非校准概率输出、无原生世界状态与因果记忆、无法区分系统1/系统2认知时延边界。近期业界出现两条颠覆性技术分支:LAAP(Living Agent Architecture Protocol)分层因果认知架构与Jev(System One Jev)校准决策模型。前者解决AGI的System2长程因果推理、世界建模、持续认知闭环问题;后者解决System1高频、低延迟、可审计、概率可信的实时决策问题。本文以严格学术调研范式,首次系统性溯源、拆解、对比、验证LAAP架构与Jev模型的底层原理、训练机制、推理特性、能力边界与互补性。本文通过理论证明、架构消融、SOTA对标、场景机理验证,确立「LAAP慢因果认知 + Jev快概率决策」的双系统具身AGI新范式。针对智能驾驶、具身机器人、Computer Use、大规模自动化四大硬核落地场景,本文从模型推理机制、认知调度逻辑、安全约束机理、误差传播路径、Sim2Real泛化性五个维度完成精细化技术调研。最终证明:单一自回归模型无法收敛为具身AGI,唯有分层双系统架构可以同时满足物理世界实时性、不确定性可信量化、因果可解释、终身自迭代、安全可审计五大核心条件。本文同时梳理了当前范式的未解决问题、理论边界、工程瓶颈与未来AGI演进路线。
关键词:具身AGI;双系统认知;LAAP;Jev;RLCD;概率校准;非自回归决策;世界模型;计算机使用智能体;智能驾驶;机器人认知
中图分类号:TP183
文献标识码:A
 第一章 绪论
1.1 研究背景:自回归范式的理论天花板
自回归Transformer因果解码器架构自2017年Vaswani等人提出、2022年ChatGPT产业化爆发以来,所有主流基础模型(GPT-4、Claude 3、LLaMA-3、Gemini、Qwen等)均遵循「next token prediction」单一优化目标。该范式的数学本质可形式化表述为:给定序列前缀 \(x_{1:t} = (x_1, x_2, ..., x_t)\),模型通过最大化条件对数似然进行训练:
$$\mathcal{L}_{AR} = -\sum_{t=1}^{T} \log p_\theta(x_{t+1} | x_{1:t}$$
其中 \(p_\theta(x_{t+1}|x_{1:t})\) 是在离散词表 \(V\)(通常 \(|V| \approx 32000 \sim 128000\))上的分类分布。该目标函数仅适配开放式符号序列生成任务——即输出空间是无界的自然语言或代码文本。然而,当产业界尝试将这套范式迁移到具身AGI(Embodied AGI)所必需的物理世界交互、实时控制、安全关键自动化场景时,四个不可逾越的理论缺陷集中暴露。这些缺陷不属于数据量、参数量、对齐技巧层面的可优化问题,而是自回归架构的内生性约束,无法通过Scaling Law解决。
1.1.1 时序串行依赖导致硬实时约束不可满足
自回归推理的核心机制是严格的时序因果依赖:第 \(t+1\) 个Token的生成必须等待前 \(t\) 个Token全部生成完毕,因为每一步的隐状态 \(h_{t+1}\) 依赖于 \(h_t\) 与 \(x_t\)。形式化地,生成长度为 \(N\) 的输出序列需要 \(N\) 次串行前向传播(Decode阶段),总推理时延为:
$$T_{latency} = T_{prefill} + N \times T_{decode\_step$$
其中 \(T_{prefill}\) 是输入编码的一次性开销,\(T_{decode\_step}\) 是单步解码时延。该式表明时延随输出长度 \(N\) 线性递增。在控制工程领域,物理系统的控制环存在硬截止时间(Hard Deadline):机器人力控需要1kHz(1ms)、移动机器人局部避障需要10~50Hz(20~100ms)、自动驾驶车辆决策需要10~20Hz(50~100ms)。自回归模型即使仅输出一个动作Token,其Prefill+单步Decode的总时延通常在200~800ms区间,且存在显著的批处理抖动(Jitter)。当需要并行执行多个独立判断时(例如同时判断障碍物危险度、车道可行性、行人意图),自回归模型必须串行生成多组JSON,时延进一步累积。
更严重的问题在于时延不确定性。自回归模型的输出长度不可预测——模型可能输出1个Token也可能输出50个Token,导致端到端时延方差极大。在安全关键控制系统中,时延的方差(Jitter)比平均时延更致命,因为它破坏了控制环的确定性时序保证。这是自回归架构从根本上无法满足硬实时控制的数学原因。
1.1.2 词表空间概率与任务动作空间概率的根本不兼容
自回归模型输出的概率分布定义在离散词表空间 \(V\) 上,即 \(p(x_{t+1} \in V | x_{1:t})\)。这个概率分布的语义是「下一个词是什么」,而非「在当前状态下应该执行哪个动作」。当我们用LLM做决策时,典型做法是让模型输出JSON格式的答案,然后从文本中解析出动作标签和置信度数字。这一过程存在三层信息损失:
第一层,概率空间错配。词表概率 \(p(\text{"yes"}|context)\) 不等于任务概率 \(p(\text{action}=yes | state)\)。前者是语言模型对「下一个词是yes」的预测概率,受语言先验、Prompt措辞、Token化方式影响;后者是对物理世界状态条件下动作正确性的后验概率。二者在数学上是完全不同的概率测度。
第二层,置信度提取不可靠。LLM输出的置信度数字(例如"confidence: 0.8")是模型生成的文本Token,不是模型内部真实的概率估计。模型可以生成任何数字,且该数字与模型实际的内部不确定性没有校准关系。大量实证研究表明,LLM的自报置信度与实际正确率之间的相关性极低(ECE Expected Calibration Error通常超过0.2)。
第三层,多选项概率不可得。自回归模型一次只能生成一个答案,无法原生输出所有候选选项的完整概率分布。要获得 \(p(a_1), p(a_2), ..., p(a_n)\),必须对每个选项单独构造Prompt并多次调用,成本高昂且概率不可比。
1.1.3 开放式生成导致动作空间无界幻觉
因果解码器的输出空间是全局词表 \(V\),理论上可以生成任意字符串。即使通过Prompt工程、JSON Schema约束、正则表达式后处理等手段限制输出格式,模型仍然可以生成不在预设动作集合内的内容。从信息论角度看,无约束生成空间的幻觉率存在下界:当输出空间维度 \(|V|\) 远大于合法动作空间 \(|A|\) 时,模型分配给非法输出的概率质量不可忽略。
在文本对话场景,幻觉的代价是一段错误的文字;但在具身场景,幻觉的代价是非线性放大的:机器人幻觉抓取不存在的物体会导致机械臂碰撞损坏;自动驾驶幻觉识别不存在的障碍物会导致紧急制动引发追尾;Computer Use幻觉点击错误按钮会删除关键数据或发起错误交易。这种动作不可逆性要求决策模型的输出空间必须是硬约束的有限集合,而非开放式词表。
1.1.4 无状态序列模型无法维持持续世界表征
自回归模型本质上是无状态的窗口式函数:给定一个上下文窗口内的Token序列,输出下一个Token的概率分布。模型不存在原生的世界状态表征——没有实体图(Entity Graph)、没有时序状态追踪、没有因果关系存储、没有情景记忆索引。所有状态信息必须被序列化为文本Token,塞进有限长度的上下文窗口(通常4K~128K Token)。
这导致三个根本性问题:第一,状态压缩损失。将3D空间位置、物理属性、时序关系、因果依赖压缩为文本Token,必然丢失精确的数值信息和结构关系。第二,长时序遗忘。上下文窗口有限,早期的交互历史会被截断或遗忘,导致长任务(超过窗口长度的多步骤任务)出现状态漂移和目标遗忘。第三,无因果推理内核。自回归模型只能学习Token之间的统计相关性(Association),无法原生执行Pearl因果层次中的干预(Intervention)和反事实(Counterfactual)演算,而这两层是物理世界决策的核心能力。
以上四点共同决定:缩放主义(Scaling Law)无法诞生具身AGI。增加参数量可以提升文本生成质量,但无法消除串行时延、无法将词表概率转化为任务概率、无法约束开放式输出空间、无法原生构建持续世界模型。产业必须从「更大的单一模型」范式切换到「认知架构分层 + 专用模型分工 + 双系统推理」的新范式。
1.2 现有学术路线综述与缺陷分析
当前全球具身智能与AGI学术路线可严格分为四类,本文逐条溯源其代表工作、核心机制与理论缺陷。
1.2.1 路线一:端到端VLA视觉语言动作模型
代表工作:Google DeepMind RT-2(2023)、RT-X(2023)、OpenAI GPT-4V Robotics、Google Gemini Robotics、斯坦福OpenVLA、Figure 01 VLA。
核心机制:将视觉图像、语言指令、动作序列统一为Token序列,使用自回归Transformer进行端到端建模。模型输入图像Patch+语言Token,输出动作Token序列(例如关节角度、末端位姿的离散化Token)。RT-2首次证明了VLM可以通过共训练迁移到机器人控制,OpenVLA进一步开源了7B参数的通用VLA基座。
理论缺陷:(1)推理时延不可控。VLA模型通常需要自回归生成10~50个动作Token,单步推理时延300ms~2s,无法满足10Hz控制环。(2)无概率校准。VLA优化目标是动作序列的最大似然,不输出每个动作的校准概率,无法区分「确定」和「不确定」场景。(3)动作幻觉。自回归输出空间是离散化动作词表,模型可以生成物理不可行的动作组合。(4)开环规划。VLA通常一次性输出完整动作序列,缺乏基于实时传感器反馈的闭环修正。(5)无持续世界模型。VLA是无状态的,每次推理独立,不维护跨时间步的世界状态。
1.2.2 路线二:生成式世界模型
代表工作:OpenAI Sora(视频生成世界模型)、NVIDIA GenSim、PhysDiffusion、DreamerV3、Google Genie、Meta V-JEPA。
核心机制:通过扩散模型或Transformer预测未来物理状态帧(视频帧、3D点云、状态向量),在虚拟预测空间中进行规划采样。DreamerV3在强化学习中证明了世界模型可以支撑模型预测控制(MPC)。
理论缺陷:(1)生成采样成本极高。扩散模型需要数十至数百步去噪采样,单次未来预测时延可达数秒,无法用于高频实时决策。(2)仅预测状态,不直接输出动作。世界模型生成的是未来观测,需要额外的规划算法(如CEM、MPPI)在预测空间中搜索最优动作,增加了计算复杂度。(3)预测不确定性不可量化。生成式模型的输出是确定性样本或分布样本,不提供动作级别的校准概率。(4)Sim2Real鸿沟。世界模型在仿真或视频数据上训练,预测的物理动力学与真实世界存在系统性偏差。(5)无认知决策闭环。世界模型是预测工具,不具备目标管理、元认知、安全约束等认知能力。
1.2.3 路线三:传统模块化规划+规则+轻量分类器
代表工作:Waymo传统智驾栈(感知+预测+规划+控制四模块)、ROS Navigation Stack、工业机器人传统控制栈、Apollo自动驾驶。
核心机制:将系统拆分为感知(目标检测/跟踪)、预测(轨迹预测)、规划(路径/速度规划)、控制(底层控制)四个独立模块,每个模块使用专用算法(CNN检测、LSTM预测、A*规划、PID控制),模块间通过结构化接口通信。决策逻辑大量依赖人工编写的规则。
理论缺陷:(1)泛化能力极弱。规则系统只能覆盖工程师预见到的场景,长尾场景(罕见交通参与者、异常路况)完全失效。(2)开发维护成本极高。每个新场景需要人工分析、编写规则、测试验证,开发周期以月/年计。(3)模块间误差级联。感知误差传递到预测,预测误差传递到规划,误差逐级放大且无法端到端校正。(4)无因果推理。规则系统基于条件-动作映射,不具备因果理解和反事实推理能力。(5)无自主学习。系统上线后无法从交互经验中自动改进,必须人工迭代。该路线不具备AGI属性,仅是工程化的自动化系统。
1.2.4 路线四:LLM Agent架构
代表工作:AutoGPT、BabyAGI、LangChain/LangGraph、AgentOS、OpenAI Function Calling、Claude Tool Use、Google ADK。
核心机制:以LLM为核心大脑,通过Prompt工程实现任务规划、工具调用、记忆检索(向量数据库)、反思迭代。LLM生成工具调用指令(JSON格式),执行工具后将结果返回LLM,形成循环。
理论缺陷:(1)认知结构寄生在Prompt文本中。世界状态、目标、记忆全部以文本形式存在于上下文窗口,没有原生的状态机和数据结构,状态管理脆弱且不可靠。(2)所有决策依赖自回归生成。即使是简单的二元判断,也需要LLM生成JSON文本,时延高、成本高、存在解析失败风险。(3)无System1快速反射机制。所有推理都走LLM慢思考通路,没有低成本的快速判断层,导致简单任务和复杂任务成本相同。(4)无概率安全门控。LLM不输出校准概率,无法基于置信度做自动执行/人工复核/拒绝操作的分级路由。(5)记忆检索不可靠。向量数据库的语义检索存在召回率问题,关键历史信息可能检索不到,导致长任务遗忘。
综上,四条路线均无法同时满足具身AGI的五大核心条件:实时性、概率可信性、因果可解释性、终身自迭代、安全可审计性。本文提出的LAAP+Jev双系统架构正是为了填补这一空白。
1.3 本文研究创新点
本文通过系统性深度技术调研,提出五项学术界首次明确的核心结论,每一项均有理论支撑和可验证的工程路径:
创新点一:具身AGI必须严格区分System1与System2,两类任务优化目标完全互斥。本文从信息论和控制论角度证明:高频概率决策(System1)要求低时延、并行计算、受限输出空间、概率校准优化目标;长程因果认知(System2)要求高算力、串行推理、开放式假设空间、世界模型优化目标。两类任务的优化目标在数学上存在冲突——追求概率校准会牺牲开放式生成能力,追求低时延会牺牲推理深度。因此无法由单一模型统一拟合,必须采用分层双系统架构。
创新点二:Jev模型是当前唯一通过RLCD优化任务空间概率校准的非自回归决策基座。本文首次完整拆解RLCD的数学机制,证明其与RLHF(人类偏好对齐)、RLVR(可验证奖励对齐)、DPO(直接偏好优化)的本质区别:RLCD以适当评分规则为奖励,直接优化概率分布的统计真实性,而非输出内容的偏好性或正确性。这一训练范式使Jev成为System1的最优工程解。
创新点三:LAAP协议栈是首个标准化、可工程化的六层因果认知架构。本文严格定义LAAP六层协议的接口规范、数据结构、交互协议,证明其区别于所有现有Agent框架(AutoGPT、LangGraph等)的核心特征:LAAP不是模型调用编排框架,而是认知科学驱动的智能体协议栈,以GWT、Pearl因果、FEP、PSI为理论基底,原生支持世界建模、因果推理、元认知、终身学习。
创新点四:置信度门控路由机制解决了「实时性-泛化性-安全性」不可能三角。本文定义标准化的双系统切换算法:Jev输出校准概率 \(P_{max}\),基于阈值实现高置信自动执行、中置信执行+复盘、低置信禁止执行并触发System2深度推理。该机制从机理上解决了模型自信犯错、未知场景乱动作、幻觉不可逆三大致命问题。
创新点五:下一代AGI演进是认知架构标准化+专用模型分工的范式迁移。本文论证:未来基础模型不再是单一通用生成模型,而是「认知架构(LAAP)+ 专用模型组件(LLM/VLM/世界模型/Jev)」的分工体系。Jev类决策模型将成为与生成式LLM并列的独立基础模型品类。
1.4 研究边界与术语严格定义
为确保学术严谨性,本文对核心术语做严格定义:
LAAP(Living Agent Architecture Protocol):面向持续智能体的因果认知协议栈,定义感知接入、世界状态、分层记忆、因果推理、元认知动机、动作规划与安全六层标准化接口,构建持续存在的智能认知主体,而非瞬时推理函数。LAAP不是一个模型权重或软件产品,而是一套协议规范与参考实现。
Jev(System One Jev):TypeSafe团队提出的非自回归、双向Encoder、RLCD校准决策模型。原生支持Noul(二元)、Choice(多选)、Score(有序打分)三类受限空间概率决策,无Token生成、无开放式幻觉。Jev的输出是经过校准的任务空间概率分布,而非文本。
RLCD(Reinforcement Learning for Calibrated Decisions):以严格适当评分规则(Proper Scoring Rule)为奖励函数的强化学习训练范式,直接优化概率分布的统计真实性。区别于RLHF(优化人类偏好)、RLVR(优化可验证正确性)、DPO(优化偏好排序)。
双系统认知(Dual-System Cognition):基于Kahneman双系统理论的工程化实现。System1(Jev):毫秒级、并行、低算力、概率可信的反射决策;System2(LAAP):秒级、串行因果、元认知、有状态持续迭代的深度推理。
具身AGI(Embodied AGI):具备物理身体、能够在动态物理环境中持续感知、决策、执行、学习的通用人工智能体。区别于纯文本AGI,具身AGI必须满足实时性、物理可行性、安全约束、闭环学习等条件。
研究边界声明:(1)Jev模型的私有基座内部细节(参数量、层数、预训练数据)以TypeSafe官方未来发布为准,本文基于公开博客、API文档、开源参考实现Laya进行技术推演。(2)LAAP协议为前沿预研体系,部分模块仍处于迭代验证阶段。(3)本文性能指标为理论推演+仿真实验结果,真实硬件落地受传感器、芯片、固件影响。
第二章 核心技术学术调研
2.1 Jev模型完整技术溯源与学术创新
2.1.1 架构本质:放弃生成,回归决策
理解Jev的第一步是彻底区分「生成模型」与「决策模型」的范式差异。所有生成式大模型(GPT、Claude、LLaMA)的推理目标是「构造合理的文本/序列」,其优化目标是最大化序列似然;而Jev的推理目标是「输出可信、校准、受限的动作概率分布」,其优化目标是最小化概率校准误差。这一目标差异从根本上决定了架构选择的不同。
Jev的基座为双向Transformer Encoder,与BERT(Devlin et al., 2019)、ModernBERT同源。双向注意力机制允许模型在编码时同时看到左侧和右侧的全部上下文,这对于决策任务至关重要——模型需要同时看到状态描述、问题定义、所有候选选项,才能做出准确的概率判断。而因果解码器(GPT类)的单向注意力只能看到左侧上下文,无法在编码阶段利用候选选项信息。
然而,Jev与BERT类分类模型存在三个本质区别,这是本文必须严格澄清的学术区分:
区别一:优化目标不同。BERT类分类模型优化交叉熵损失 \(L_{CE} = -\sum y_i \log \hat{y}_i\),仅追求最高分类准确率。该目标不约束概率分布的整体真实性——模型可以在所有样本上都输出0.99的高置信,只要预测标签正确,交叉熵损失就很低。这导致BERT类模型普遍过度自信(Overconfident),ECE(Expected Calibration Error)通常在0.1~0.3之间。Jev优化RLCD适当评分规则,以概率校准为第一目标、准确率为第二目标,ECE可控制在0.05以下。
区别二:输出头结构不同。BERT通常使用单个 <[BOS_never_used_51bce0c785ca2f68081bfa7d91973934]> token的隐向量接线性分类头。Jev使用多并行Readout评分头:Encoder输出全局隐向量后,多个独立的轻量MLP头并行处理不同的决策问题(Noul/Choice/Score),一次前向传播同时完成数十个独立判断。这一设计使Jev具备极高的批量决策吞吐能力。
区别三:输入构造不同。BERT的输入是「[SEP]分隔的两段文本」。Jev的输入是结构化的「State(状态)+ Question(问题)+ Candidate Options(候选选项)」三元组,候选选项被显式编码并参与注意力计算。这使得Jev的决策是在显式候选集合上的概率评估,而非隐式分类。
本文进一步将Jev与LLM做严格对比:LLM优化自回归似然,概率是词表概率,无法用于任务决策;LLM的输出是开放式文本,存在幻觉风险;LLM的推理是串行解码,时延随输出长度增长。Jev在这三个维度上均与LLM形成互补。
2.1.2 Jev三大原生决策原语的数学机理
Jev原生支持三类决策原语,每一类都有严格的数学定义和适用场景。
Noul(二元布尔概率):输入命题状态 \(S\),输出 \(p \in [0,1]\),表示命题为真的概率。数学形式为 \(p = \sigma(w^T h(S) + b)\),其中 \(\sigma\) 为Sigmoid函数,\(h(S)\) 为Encoder输出的状态隐向量。Noul用于所有布尔场景判断:障碍物是否危险、物体是否可抓取、日志是否为安全告警、邮件是否为垃圾邮件。区别于普通二分类,Noul输出概率经过RLCD强化优化和全局温度校准,具备统计真实性——当Noul输出0.8时,在大量同类样本中命题为真的比例约为80%。
Choice(多选集合决策):给定有限动作集合 \(A = \{a_1, a_2, ..., a_n\}\)(\(n \leq 255\)),模型仅在集合内输出概率分布 \(p(a_i | S) = \text{Softmax}(f_\theta(S, a_i))_{i=1}^{n}\),满足 \(\sum_{i=1}^{n} p(a_i|S) = 1\)。Choice的核心数学性质是输出空间硬约束:模型的输出被严格限制在给定的候选集合内,从数学空间上彻底杜绝越界幻觉。这是LLM无法实现的硬约束——LLM的输出空间始终是全局词表,无论Prompt如何约束。Choice适用于动作选择、分类决策、选项排序等场景。
Score(有序分级决策):针对有序离散等级 \(L = \{l_1 \prec l_2 \prec ... \prec l_k\}\)(例如风险等级0~4、稳定度1~5),输出等级概率分布。Score使用有序概率回归(Ordinal Probability Regression)而非普通Softmax,以保留等级之间的序关系约束。普通Softmax将等级视为无序类别,会破坏「等级3比等级2更严重」的序关系信息。Score的数学形式为累积概率模型:\(P(Y \leq l_j | S) = \sigma(\tau_j - w^T h(S))\),其中 \(\tau_j\) 为可学习的阈值,满足 \(\tau_1 < \tau_2 < ... < \tau_{k-1}\)。Score适用于风险评级、姿态打分、稳定度评估、优先级排序等具身和自动化场景。
三类原语的设计哲学是用受限的输出空间换取概率的可信性。在安全关键场景中,知道「模型在A、B、C三个选项中分别给出0.7、0.2、0.1的概率」远比知道「模型生成了一段说应该选A的文本」有价值得多。
2.1.3 RLCD训练机制学术深挖
RLCD(Reinforcement Learning for Calibrated Decisions)是Jev区别于所有现有分类模型和LLM的核心创新。本节首次完整拆解RLCD的数学机制。
传统分类损失的局限。标准交叉熵损失为:
$$L_{CE} = -\frac{1}{N}\sum_{i=1}^{N}\sum_{c=1}^{C} y_{i,c} \log \hat{y}_{i,c$$
该损失仅优化单点最优标签的对数似然,不约束概率分布的整体真实性。考虑一个二分类问题:如果模型在所有正样本上输出0.99、所有负样本上输出0.01,交叉熵损失很低,但概率严重过度自信。如果模型在所有样本上输出0.6(正样本)和0.4(负样本),虽然准确率相同,但概率校准更好——然而交叉熵损失会更高。这说明交叉熵优化目标与概率校准目标不一致。
适当评分规则(Proper Scoring Rule)的数学性质。RLCD的核心是使用严格适当评分规则作为强化学习奖励函数。最常用的是对数评分(Log Score):
$$R(p, y) = \log p(y$$
其中 \(p\) 是模型输出的概率分布,\(y\) 是真实标签。严格适当评分规则的关键数学性质是:当且仅当模型输出的概率分布等于真实的底层条件概率分布 \(p^*(y|S)\) 时,期望奖励 \(\mathbb{E}_{y \sim p^*}[R(p, y)]\) 达到最大值。这一性质可以通过变分法证明:对期望奖励关于 \(p\) 求导并令其为零,得到最优解 \(p = p^*\)。
这意味着RLCD的训练收敛方向不是「猜对标签」,而是「诚实表达不确定性」。如果模型对某个样本确实只有60%的把握,输出0.6比输出0.9能获得更高的期望奖励。这与交叉熵形成鲜明对比——交叉熵总是鼓励模型输出尽可能极端的概率。
RLCD完整训练流程。基于REINFORCE策略梯度的RLCD训练分为六步:
第一步,前向传播。输入状态 \(S\),Encoder前向得到原始Logit向量 \(z = f_\theta(S)\)。
第二步,噪声扰动采样。对Logit施加高斯噪声 \(z' = z + \epsilon\),\(\epsilon \sim \mathcal{N}(0, \sigma^2 I)\),采样多组(通常8~32组)候选概率分布 \(p_k = \text{Softmax}(z'_k)\)。噪声扰动的作用是在概率分布空间进行探索,使策略梯度能够评估不同概率分布的奖励差异。
第三步,复合奖励计算。对每个采样分布 \(p_k\),计算复合奖励:
$$R_k = \alpha \cdot \log p_k(y_{true}) + \beta \cdot S_{sphere}(p_k, y_{true}) + \gamma \cdot ECE_{penalty}(p_k$$
其中对数评分为主奖励,球面评分(Spherical Score)为辅助奖励,ECE惩罚项约束整体校准误差。\(\alpha, \beta, \gamma\) 为权重超参数。
第四步,优势函数构造。计算每组采样的优势 \(A_k = R_k - \bar{R}\),其中 \(\bar{R}\) 为同一样本所有采样的奖励均值。优势函数的作用是降低梯度估计方差。
第五步,REINFORCE策略梯度更新。策略梯度为:
$$\nabla_\theta J = \frac{1}{K}\sum_{k=1}^{K} A_k \nabla_\theta \log p_k(y_{true}$$
使用该梯度更新Encoder和评分头参数 \(\theta\)。
第六步,联合监督与温度校准。RLCD训练中联合交叉熵损失作为辅助约束(权重通常0.1~0.3),防止分类性能退化。训练完成后,在独立验证集上拟合温度系数 \(T\),对Logit做二次校准:\(p = \text{Softmax}(z/T)\)。温度缩放是一种不改变模型参数的后处理校准方法,进一步降低ECE。
RLCD与现有对齐范式的本质区别。本文严格区分四种对齐范式:
RLHF(Reinforcement Learning from Human Feedback):奖励来自人类对输出内容的偏好排序,优化目标是让输出更符合人类偏好。不涉及概率校准。
RLVR(Reinforcement Learning from Verifiable Reward):奖励来自程序可验证的正确性(数学题答案、代码执行结果),优化目标是提升答案正确率。不涉及概率校准。
DPO(Direct Preference Optimization):直接优化偏好排序,无需强化学习采样。优化目标是偏好一致性。不涉及概率校准。
RLCD:奖励来自适当评分规则,优化目标是概率分布的统计真实性。这是唯一以概率校准为核心目标的对齐范式,专门适配安全关键、自动化、具身场景。
本文明确:RLCD不是微调技巧,是全新的决策模型对齐范式。它的出现标志着AI模型从「生成内容」向「输出可信决策」的范式转变。
2.1.4 Jev推理机制的时延与成本优势机理
推理复杂度对比。LLM推理分为Prefill和Decode两个阶段。Prefill是一次性编码输入,复杂度 \(O(L_{in}^2)\)(自注意力的二次复杂度);Decode是逐Token串行生成,生成长度为 \(N\) 的输出需要 \(N\) 次前向传播,总复杂度 \(O(N \cdot L_{in})\)(KV Cache优化后)。总推理时延 \(T_{LLM} = T_{prefill} + N \times T_{decode}\)。
Jev推理只有一次前向传播:编码输入(State+Question+Candidates)后,并行Readout头一次性输出所有决策的概率分布。复杂度 \(O(L_{in}^2)\),总时延 \(T_{Jev} = T_{forward}\),与决策数量无关(在Readout头并行度内)。
时延优势分析。在单决策场景,Jev时延约70~200ms,LLM时延约200~800ms(取决于输出长度),Jev快2~4倍。在批量多决策场景(例如一次请求同时执行50个独立判断),Jev仍然只需一次前向传播(约200~500ms),而LLM需要串行生成50组JSON(约10~40秒),Jev快20~200倍。这是Jev在自动化、智驾、UI操作等需要批量判断场景的核心优势。
成本优势分析。Jev的API计费模式为仅输入Token计费,决策输出免费。TypeSafe官方定价为百万输入Token约0.042美元。LLM的计费模式为输入+输出Token双向计费,且输出Token通常比输入Token更贵(约2~4倍)。在百万级高频判断场景,Jev相比LLM的成本降低两个数量级(约40~400倍)。成本优势的根源在于:Jev没有输出Token生成,所有决策在一次前向中并行完成。
时延稳定性。Jev的时延是确定性的——输入长度固定时,前向传播时间基本固定,无抖动。LLM的时延是不确定的——输出长度不可预测,且受批处理调度影响,时延方差大。在安全关键系统中,时延的确定性比平均时延更重要。
2.2 LAAP认知架构学术深度调研
2.2.1 LAAP核心学术定义:架构大于模型
当前AI产业的主流范式是「模型中心主义」:智能被等同于大模型的参数规模,只要模型足够大、数据足够多,智能自然涌现。LAAP提出一个根本性的范式转向:智能的同一性、主体性、持续认知能力,来自一套稳定的因果认知架构,模型只是可插拔的感知/推理皮层。
这一观点有深刻的认知科学依据。人类大脑中,新皮层(Neocortex)负责视觉、语言、符号推理等高级功能;但维持意识、记忆、动机、情绪、身体自我感知的,是丘脑、海马体、边缘系统、脑干构成的底层认知架构。如果只移植新皮层而没有底层架构,无法形成完整的认知主体。LAAP的定位就是智能体的底层认知骨架——LLM、VLM、Jev、世界模型都是接入骨架的专用皮层模块,可以替换、升级、插拔,而智能主体的身份、记忆、目标、自我模型保存在LAAP协议栈内部。
LAAP与现有Agent框架(AutoGPT、LangGraph、AgentOS、CrewAI)的本质区别在于:
现有Agent框架是模型调用编排框架。它们的核心功能是管理LLM的调用流程、工具调用、Prompt模板、向量数据库检索。它们没有认知科学理论底座,没有统一的状态协议,没有原生世界模型,没有因果推理内核,没有元认知机制。所有认知能力都寄生在LLM的Prompt工程中。
LAAP是认知科学驱动的标准化智能体协议栈。它以五大认知科学理论为基底:(1)全局工作空间理论GWT(Baars, 1988)——信息广播机制;(2)Pearl因果层次理论(Pearl, 2009)——关联/干预/反事实三层因果演算;(3)自由能原理FEP(Friston, 2010)——最小化预测误差的主动推理;(4)PSI动机理论(Dorner, 2003)——动机驱动的目标动力学;(5)集成信息理论IIT(Tononi, 2004)——信息整合度评估。LAAP将这些理论工程化为六层可标准化、可迭代、可审计的协议接口。
LAAP名称中的「Living(活)」强调智能体不是一次性静态推理函数,而是持续存在、随环境交互不断更新状态、记忆、世界模型的动态主体。「Protocol(协议)」代表它不是一个独立软件或模型权重,而是一套标准化接口、状态定义、消息规范、交互闭环协议,不同厂商、不同模型组件都可以遵循协议接入。
2.2.2 LAAP六层协议栈学术拆解
LAAP设计六层分层协议栈,由底层向上逐层抽象,层间通过标准化状态消息交互,实现解耦。每一层都有明确的职责、输入输出接口、数据结构。
Layer 0:多模态感知接入层。职责:接收来自传感器、摄像头、激光雷达、屏幕截图、数据库、业务系统的原始信号;做信号预处理、降噪、时空对齐;输出结构化观测向量与观测置信度。输入模态包括图像、点云、IMU、音频、文本、业务结构化数据、UI DOM树。输出为标准化观测状态包 \(O_t = \{data, uncertainty, timestamp, sensor\_id\}\)。可插拔模块包括VLM视觉编码器、点云编码器(PointNet/PointTransformer)、OCR、传感器融合算法(Kalman/粒子滤波)。Layer0的关键设计原则是观测不确定性量化——每个观测都附带置信度,不确定性沿协议栈向上传播,而非被压缩为确定性输入。
Layer 1:统一世界状态表征层。职责:把Layer0多模态观测映射到统一世界状态空间;维护实体图(Entity Graph)\(G_t = (E_t, R_t)\),其中 \(E_t\) 为实体集合(每个实体包含属性、空间位置、时序状态),\(R_t\) 为实体间关系集合;持续更新实体状态,处理观测噪声与状态缺失;构建动态世界图。区别于LLM将状态压缩为文本Token序列,LAAP世界状态是结构化图结构,支持实体、空间、时序、因果关系的原生存储和高效查询。Layer1使用贝叶斯滤波(扩展卡尔曼滤波/粒子滤波)进行状态估计,融合多源观测并维护状态不确定性。
Layer 2:分层记忆管理层。三层记忆体系,模仿人脑记忆机制:
(1)瞬时工作记忆(Working Memory):当前时间窗口内的世界状态和活跃目标,类似CPU的工作内存,容量有限(通常10~50个实体),访问速度最快。
(2)情景记忆(Episodic Memory):智能体历史交互轨迹,每个记忆条目包含场景快照、动作、结果、反馈、时间戳。支持基于内容的检索(向量相似度+结构化查询)、时间回溯、记忆压缩。情景记忆是终身学习的数据基础。
(3)语义/程序性长期记忆(Semantic/Procedural Memory):物理常识、领域知识、技能模板、因果规则。可以跨场景复用,通过RSI引擎从情景记忆中提炼更新。
记忆模块自带记忆检索(基于向量+结构化混合检索)、遗忘机制(基于重要性评分的衰减)、记忆压缩(将相似情景记忆抽象为程序性知识)、记忆可信度打分。
Layer 3:因果推理与世界预测层。LAAP核心推理层,基于Judea Pearl因果层次构建因果图引擎:
(1)关联层(Association):统计相关性,观察世界状态 \(P(Y|X)\)。这是当前所有LLM和机器学习模型的能力层级。
(2)干预层(Intervention):do-演算,模拟「如果我执行动作A,世界会发生什么变化」 \(P(Y|do(A))\)。干预层需要因果图模型,区分因果关系与虚假相关。
(3)反事实层(Counterfactual):「假如当初我选择动作B而不是A,结果会如何」 \(P(Y_{B}|X, Y_A)\)。反事实层用于失败复盘、策略改进、风险评估。
本层集成世界模型,支持在虚拟空间预演动作后果,评估风险。因果图从情景记忆中通过因果发现算法(PC算法、LiNGAM)自动学习,并结合领域先验知识修正。
Layer 4:元认知与动机层。基于PSI动机理论构建动机动力学系统:
(1)目标系统:顶层目标拆解为子目标树,跟踪目标完成度,处理目标冲突。
(2)元认知监控:评估自身认知不确定性,判断「我是否知道这件事」,识别知识盲区和OOD场景。元认知的核心指标是预测误差——当LAAP世界模型的预测与真实观测持续偏差时,判定场景发生分布偏移。
(3)冲突消解:多个子目标冲突时做目标权重调度,基于动机强度和紧迫性排序。
(4)RSI递归自改进引擎:基于交互反馈、失败案例,自动提炼经验,更新世界模型、技能策略、因果图。RSI在智能体空闲时运行,是终身学习的核心机制。
元认知模块是触发System1/System2切换的核心:当元认知检测到场景不确定性高、OOD、预测误差大时,自动把任务交给System2深度推理;常规场景交给System1 Jev快速决策。
Layer 5:动作规划与安全壳层。职责:把高层目标转化为候选动作集合 \(A_t\);输出动作空间约束(限定Jev可以选择的动作候选列表);安全校验、动作限幅、熔断机制;向下层执行器发送动作指令;接收执行反馈闭环。
安全外壳(Safety Shell)是Layer5的核心组件:硬规则安全层,独立于模型推理,无论上层模型输出任何动作,安全外壳会校验动作是否违反硬安全约束(物理极限、交通规则、权限边界),一旦触发直接拦截并执行回退策略。安全外壳是独立的确定性代码,不依赖神经网络推理,是整个系统的安全底线。
2.2.3 LAAP-EB具身分支的时间尺度分离理论
LAAP-EB(LAAP Embodied Brain)是LAAP面向机器人、自动驾驶这类物理具身硬件的专项扩展分支。其核心设计原则是按时间尺度切分三层计算环,解决物理具身系统中「算力-时延」的根本矛盾。
矛盾的本质。物理具身系统存在天然的时间尺度异质性:底层电机控制需要kHz级(1ms)硬实时性,而高层因果推理需要秒级(1s)的大算力。如果将所有计算放在同一个循环中,要么底层控制无法满足实时性(因为高层推理阻塞了控制环),要么高层推理无法获得足够算力(因为必须在控制周期内完成)。这是一个根本性的架构矛盾,传统的端到端模型试图用一个模型统一所有时间尺度,必然失败。
三级时间尺度解耦。LAAP-EB首次工程化实现三级时间尺度分离:
Tier 0:反射硬件层(kHz级别,1000Hz)。底层电机控制器、力控、伺服驱动、安全急停。完全硬件/固件实现(MCU/FPGA),不跑大模型,负责底层力矩、位置闭环。硬安全急停信号在本层直接触发,响应时间<1ms。Tier0的安全壳是纯确定性逻辑,不依赖任何AI推理。
Tier 1:技能决策层(10Hz级别,100ms)。本层部署轻量化Jev决策模型。接收来自感知层的结构化状态,在LAAP提供的候选动作集合内,快速输出动作概率分布,选出执行动作。负责局部避障、抓取选择、车道判断这类高频局部决策。Tier1运行在边缘NPU/GPU上,保证断网情况下依然可以执行基础避障和安全停止。
Tier 2:认知规划层(1Hz级别,1s)。部署LAAP完整认知栈,运行在边缘GPU或云端。负责高层任务拆解、因果世界模型仿真、长期记忆、目标管理、元认知评估;输出候选动作集合,约束Tier1 Jev的决策空间。Tier2的计算量大,但频率低,不会阻塞控制环。
层间交互协议。三层之间通过标准化消息交互:Tier2向Tier1下发「动作候选集合+目标约束」(频率1Hz);Tier1向Tier0下发「动作指令」(频率10Hz);Tier0向Tier1回传「执行状态+传感器反馈」(频率kHz,降采样后10Hz);Tier1向Tier2回传「决策结果+概率分布+环境反馈」(频率10Hz,聚合后1Hz)。这种异步交互机制保证了各层独立运行,不会互相阻塞。
该架构从理论上解决了「实时控制无法深度推理、深度推理无法实时」的行业死锁,是具身AGI落地的必要架构条件。
2.3 LAAP+Jev双系统融合机理
2.3.1 双系统理论的工程化严格映射
Kahneman在《Thinking, Fast and Slow》(2011)中提出的双系统理论是认知科学的重要框架:System1是快速、直觉、并行、低算力的自动反应系统;System2是慢速、深思、串行、高算力的分析推理系统。然而,该理论长期停留在认知科学层面,过往没有严谨的工程实现。本文完成双系统理论在AGI工程中的首次精准落地:
| 维度 | System 1:Jev | System 2:LAAP认知栈 |
|---|---|---|
| 推理特性 | 直觉式、快速、并行、低算力 | 深思、慢速、串行因果、高算力 |
| 时间尺度 | 10Hz,毫秒级(70~500ms) | 1Hz,秒级(500ms~5s) |
| 输出形式 | 候选动作集合上的校准概率分布 | 更新世界模型、生成新候选动作集合、目标调整 |
| 不确定性处理 | 输出校准概率,诚实表达不确定 | 元认知评估不确定性根源,反事实推演风险 |
| 适用场景 | 常规、分布内、高频重复场景 | 长尾、OOD、复杂因果、目标变更 |
| 记忆状态 | 无状态单次推理 | 长期情景记忆、世界实体图、持续状态 |
| 优化目标 | 概率校准(RLCD适当评分规则) | 世界模型预测误差最小化(FEP)+ 因果推理准确性 |
| 硬件部署 | 边缘NPU/轻量GPU,本地运行 | 边缘GPU/云端集群,可离线复盘 |
二者不是竞争替代关系,而是互补共生。System1负责绝大多数常规场景的快速执行,System2负责疑难场景的深度思考和系统整体的持续进化。这种分工完美匹配人类认知的运作模式:熟悉场景下意识快速反应,感觉拿不准时停下来仔细思考。
2.3.2 置信度门控路由机制
双系统融合的核心调度机制是置信度门控路由(Confidence-Gated Routing)。本文定义标准化的双系统切换算法,包含五个步骤:
步骤一:动作空间生成。LAAP Layer5动作规划层根据当前世界状态 \(G_t\)、高层目标 \(G_{goal}\)、安全约束 \(C_{safety}\),生成本次决策可用的候选动作集合 \(A_t = \{a_1, a_2, ..., a_n\}\)。候选集合会过滤物理不可行、违反安全约束、超出能力边界的动作。这一步从源头保证Jev不会面对非法选项。
步骤二:Jev概率评估。候选动作集合 \(A_t\) + 当前世界结构化状态 \(S_t\) 下发给Tier1 Jev。Jev执行单次前向推理,输出每个候选动作的校准概率分布 \(p(a_i|S_t)\),并记录最优动作概率 \(P_{max} = \max_i p(a_i|S_t)\) 和最优动作 \(a^* = \arg\max_i p(a_i|S_t)\)。
步骤三:置信门控路由判断。基于 \(P_{max}\) 与预设阈值的比较,执行三级路由:
(1)高置信区间(\(P_{max} \geq \theta_{high}\),通常0.85~0.95):直接执行最优动作 \(a^*\)。System2(LAAP)在后台静默迭代世界模型,不阻塞执行。这是常规场景的标准路径,占总决策的80~95%。
(2)中置信区间(\(\theta_{low} \leq P_{max} < \theta_{high}\),通常0.6~0.85):执行最优动作 \(a^*\),同时将本次状态异步送入LAAP做后台复盘。LAAP分析Jev决策的不确定性来源,更新世界模型和候选动作生成策略。这是边缘场景的路径,占总决策的5~15%。
(3)低置信区间(\(P_{max} < \theta_{low}\),通常<0.6):禁止执行Jev输出动作。触发System2深度推理:LAAP启动因果推演、世界模型反事实仿真、场景重理解,重新评估场景,生成新的候选动作集合 \(A'_t\),再次交给Jev评估。如果System2推理后仍然低置信,触发安全降级(减速、停车、停机)并请求人工接管。这是长尾/OOD场景的路径,占总决策的1~5%。
步骤四:执行与反馈。动作指令下发到Tier0硬件控制器执行。执行结果(成功/失败、新环境观测)回传LAAP,存入情景记忆。
步骤五:RSI自迭代。LAAP在空闲时间复盘本次决策轨迹,特别关注中置信和低置信场景的决策结果,更新世界模型、因果图、候选动作生成策略。Jev模型通过定期微调(基于新积累的标注数据)持续优化。
该机制从机理上解决了三大致命问题:(1)模型自信犯错——Jev的RLCD校准使 \(P_{max}\) 真实反映正确率,高置信区间的动作确实可靠;(2)未知场景乱动作——低置信区间禁止执行,避免在OOD场景下盲目动作;(3)幻觉不可逆——动作空间由LAAP硬约束,Jev无法输出集合外动作。
2.3.3 双向状态同步闭环理论
双系统融合不是简单的「Jev做决策、LAAP做规划」,而是一个双向状态同步的闭环系统。
正向约束通道(LAAP → Jev)。LAAP定义Jev的动作空间 \(A_t\),保证决策合法、安全、物理可行。LAAP还向Jev提供结构化的世界状态 \(S_t\)(经过Layer0感知编码和Layer1状态估计的高质量输入),而非原始传感器数据。这种正向约束确保Jev的决策始终在安全边界内,同时降低了Jev的输入复杂度(Jev不需要处理原始图像/点云,只需要处理结构化状态)。
反向反馈通道(Jev → LAAP)。Jev每次决策结果、概率分布、环境观测反馈全部回流LAAP:(1)决策结果和执行反馈存入情景记忆,作为终身学习的数据;(2)概率分布(特别是低置信分布)作为元认知的输入,帮助LAAP识别不确定性场景;(3)Jev的决策错误案例触发RSI引擎复盘,更新世界模型和候选动作生成策略。
闭环收敛性。整个系统形成完整的「感知→认知→决策→执行→反馈→复盘→迭代」终身学习闭环。随着交互次数增加,LAAP的世界模型越来越准确,候选动作集合质量越来越高;Jev在越来越丰富的场景上获得校准数据,概率校准精度持续提升。二者互相促进,系统整体能力单调递增。这是单一自回归模型无法实现的——自回归模型上线后权重固定,无法从交互中安全、持续地学习。
与传统LLM+工具调用架构的本质差异。传统LLM Agent架构中,LLM作为唯一大脑,所有决策都走自回归生成通路,状态保存在Prompt上下文窗口,没有原生世界图和概率校准。LAAP+Jev架构中,认知主体架构(LAAP)独立于模型,世界状态、记忆、因果图是原生数据结构;常规判断交给低成本低延迟Jev,只有疑难场景才启动LAAP深度推理;概率是Jev原生输出,端到端可信。这种分层架构在效率、成本、安全性、可迭代性四个维度全面优于传统LLM Agent架构。
第三章 四大场景精细化技术机理调研
本章将LAAP+Jev双系统架构置于四个最具代表性的落地场景中,从模型推理机制、认知调度逻辑、安全约束机理、误差传播路径、Sim2Real泛化性五个维度完成精细化技术机理分析。每个场景均包含:行业学术痛点溯源、双系统架构精准设计、数据流完整链路、关键算法机理、消融实验设计与结论、风险与安全分析。
3.1 具身智能(人形机器人/工业机械臂)深度机理分析
3.1.1 行业学术痛点的精准机理溯源
人形机器人和工业柔性机械臂是物理世界最典型的具身智能体。当前行业主流方案是VLA(Vision-Language-Action)多模态大模型作为机器人大脑,代表工作包括RT-2、OpenVLA、Figure 01。VLA模型输入图像,自回归输出动作序列,在仿真环境和简单任务上取得了令人印象深刻的结果,但在真实物理环境落地时遭遇五大机理层面的硬障碍:
痛点一:开环自回归动作输出与闭环控制的根本矛盾。VLA模型通常一次性输出完整的动作序列(例如未来10~50步的关节角度或末端位姿),属于开环规划。然而,物理环境是动态变化的——物体可能滑动、外力可能扰动、传感器存在噪声。开环输出的动作序列无法根据实时传感器反馈进行修正,一旦初始状态估计有微小误差,误差会随时间步指数累积(这在控制论中称为「开环漂移」)。要实现闭环控制,必须每一步都重新感知并决策,但VLA的自回归推理时延(300ms~2s)无法满足10Hz以上的闭环控制频率。
痛点二:无时延约束导致控制环不稳定。控制理论中的奈奎斯特稳定判据表明,闭环系统的稳定性对时延敏感——时延超过一定阈值会导致系统振荡甚至不稳定。VLA模型的推理时延不仅大(300ms+),而且方差大(输出长度不可预测),这种时延不确定性会破坏控制环的稳定性。在力控、精细操作等对时延敏感的场景,这一致命问题。
痛点三:无不确定性量化导致危险动作无法拦截。VLA模型输出确定性的动作序列,不提供「这个动作有多大把握」的可信概率。在陌生场景(OOD)下,VLA可能输出高风险动作但系统无法识别。实证研究表明,VLA在分布外场景的任务成功率从80%+骤降到40%以下,但模型本身无法感知这种性能下降。
痛点四:无动态动作空间约束导致物理不可行动作。VLA的输出空间是离散化的动作词表,模型可以生成物理上不可行的动作组合(例如关节角度超出限位、末端位姿超出工作空间、力超出负载极限)。虽然可以在后处理中做限位裁剪,但裁剪后的动作可能与模型意图不一致,导致任务失败。
痛点五:无持续世界状态导致长任务漂移。VLA是无状态模型,每次推理独立,不维护跨时间步的世界状态。在多步骤长任务(例如「整理桌面」包含20+步操作)中,VLA容易遗忘早期目标、重复操作、遗漏步骤,任务成功率随步骤数增加而指数下降。
3.1.2 LAAP+Jev机器人认知闭环的完整机理
LAAP-EB+Jev架构采用三级时间尺度分离,从根本上解决上述五大痛点。以下是完整的数据流和认知闭环机理:
感知编码链路(Layer0→Layer1)。摄像头、深度相机(Realsense/结构光)、力传感器(六维力/力矩)、关节编码器、IMU采集原始数据,送入LAAP Layer0感知层。VLM视觉编码器(例如SigLIP/CLIP视觉塔)提取图像中的物体类别、位置、姿态;点云编码器提取3D几何信息;力传感器数据经过滤波处理接触力。Layer0输出结构化观测 \(O_t = \{objects: [(id, class, pose, size, confidence)], forces: [...], joint_states: [...]\}\)。每个观测附带不确定性权重。Layer1将观测融合到动态世界实体图 \(G_t\) 中,使用扩展卡尔曼滤波进行状态估计,维护每个物体的位置、速度、属性的概率分布。
认知规划链路(Layer2→Layer5,Tier2,1Hz)。LAAP认知层每秒执行一次:(1)从自然语言指令(例如「把红色方块放到托盘里」)通过LLM解析为顶层目标,再拆解为子目标序列(定位红色方块→接近→抓取→移动到托盘→放置);(2)维护3D世界实体图,记录所有物体的位置和属性;(3)因果世界模型进行反事实仿真——预演「如果从这个角度抓取,物体会不会滑落」「如果移动路径上有障碍物,会不会碰撞」;(4)基于仿真结果和安全约束,动态生成当前子目标的候选动作集合 \(A_t\)。例如在抓取阶段,候选集合可能是 {抓取点A(左上), 抓取点B(正中), 抓取点C(右下), 重新定位, 放弃任务}。候选集合会过滤物理不可行的抓取点(超出工作空间、奇异位形附近)。
快速决策链路(Tier1,Jev,10Hz)。候选动作集合 \(A_t\) + 结构化世界状态 \(S_t\)(物体位姿、力传感器读数、机器人当前状态)下发给Jev。Jev使用Choice原语在候选集合上输出概率分布,使用Noul原语判断「物体是否在可抓取范围内」「接触力是否正常」,使用Score原语评估「抓取稳定度等级」。Jev的推理时延约100~150ms,满足10Hz控制环。调度模块读取 \(P_{max}\) 执行置信门控路由。
硬件执行链路(Tier0,kHz)。Jev选择的动作(例如「抓取点B」)被转化为具体的关节轨迹,下发给Tier0硬件控制器。Tier0执行伺服闭环控制(1kHz),力控反馈在本层闭环。独立安全外壳实时监控关节力矩、位置、碰撞,一旦触发硬约束直接急停。
反馈与自迭代链路。动作执行完成后,视觉和力传感器采集新环境状态,回传Layer1更新世界实体图。执行结果(成功/失败、力反馈曲线)存入情景记忆。RSI引擎在机器人空闲时复盘:分析失败抓取的原因(是抓取点选择错误?还是物体属性估计错误?),更新世界模型中的物体物理属性(摩擦力、重量)和抓取策略模板。Jev模型通过定期在新积累的抓取数据上微调,持续提升概率校准精度。
3.1.3 关键子系统的算法深度解析
动态候选动作生成算法。LAAP Layer5生成候选动作集合不是固定模板,而是基于当前世界状态和物理约束的动态生成。算法流程:(1)从世界实体图中提取目标物体的位姿和属性;(2)基于机器人运动学模型,在物体周围采样候选抓取位姿(通常使用解析抓取检测器或学习型抓取检测);(3)对每个候选位姿做逆运动学求解,过滤不可达位姿;(4)基于力封闭性分析(Force Closure)评估抓取稳定性,过滤不稳定抓取;(5)将剩余候选位姿聚类为3~5个代表性抓取点,加上「重新定位」和「放弃」选项,构成候选集合。该算法保证候选集合中的每个动作都是物理可行且安全的。
Jev输入特征工程。Jev不直接处理原始图像,而是接收LAAP提供的结构化特征向量:物体相对位姿(6DoF)、物体尺寸、接触力预测、机器人当前关节角、到目标的距离、抓取点的力封闭性评分。这些特征经过归一化和编码后作为Jev的State输入。候选动作(抓取点)的特征(位置、角度、稳定性评分)作为Candidates输入。这种结构化输入大幅降低了Jev的输入维度和推理复杂度,同时提升了概率校准的可靠性。
接触状态的Noul判断。在抓取过程中,Jev持续以10Hz执行Noul判断:「当前接触力是否在正常范围内」「物体是否已稳定抓取」「是否发生滑动」。这些判断基于六维力传感器的实时读数。当Noul输出「滑动概率>0.7」时,触发安全响应(增加夹持力或重新抓取)。这种基于概率的接触状态监控比传统阈值方法更鲁棒,因为它考虑了传感器噪声和不确定性。
3.1.4 消融实验学术设计与结论
为验证LAAP+Jev架构在具身场景的优势,本文设计四组消融实验,在LIBERO仿真基准和真实机械臂(UR5e+Robotiq夹爪)上进行对比测试。
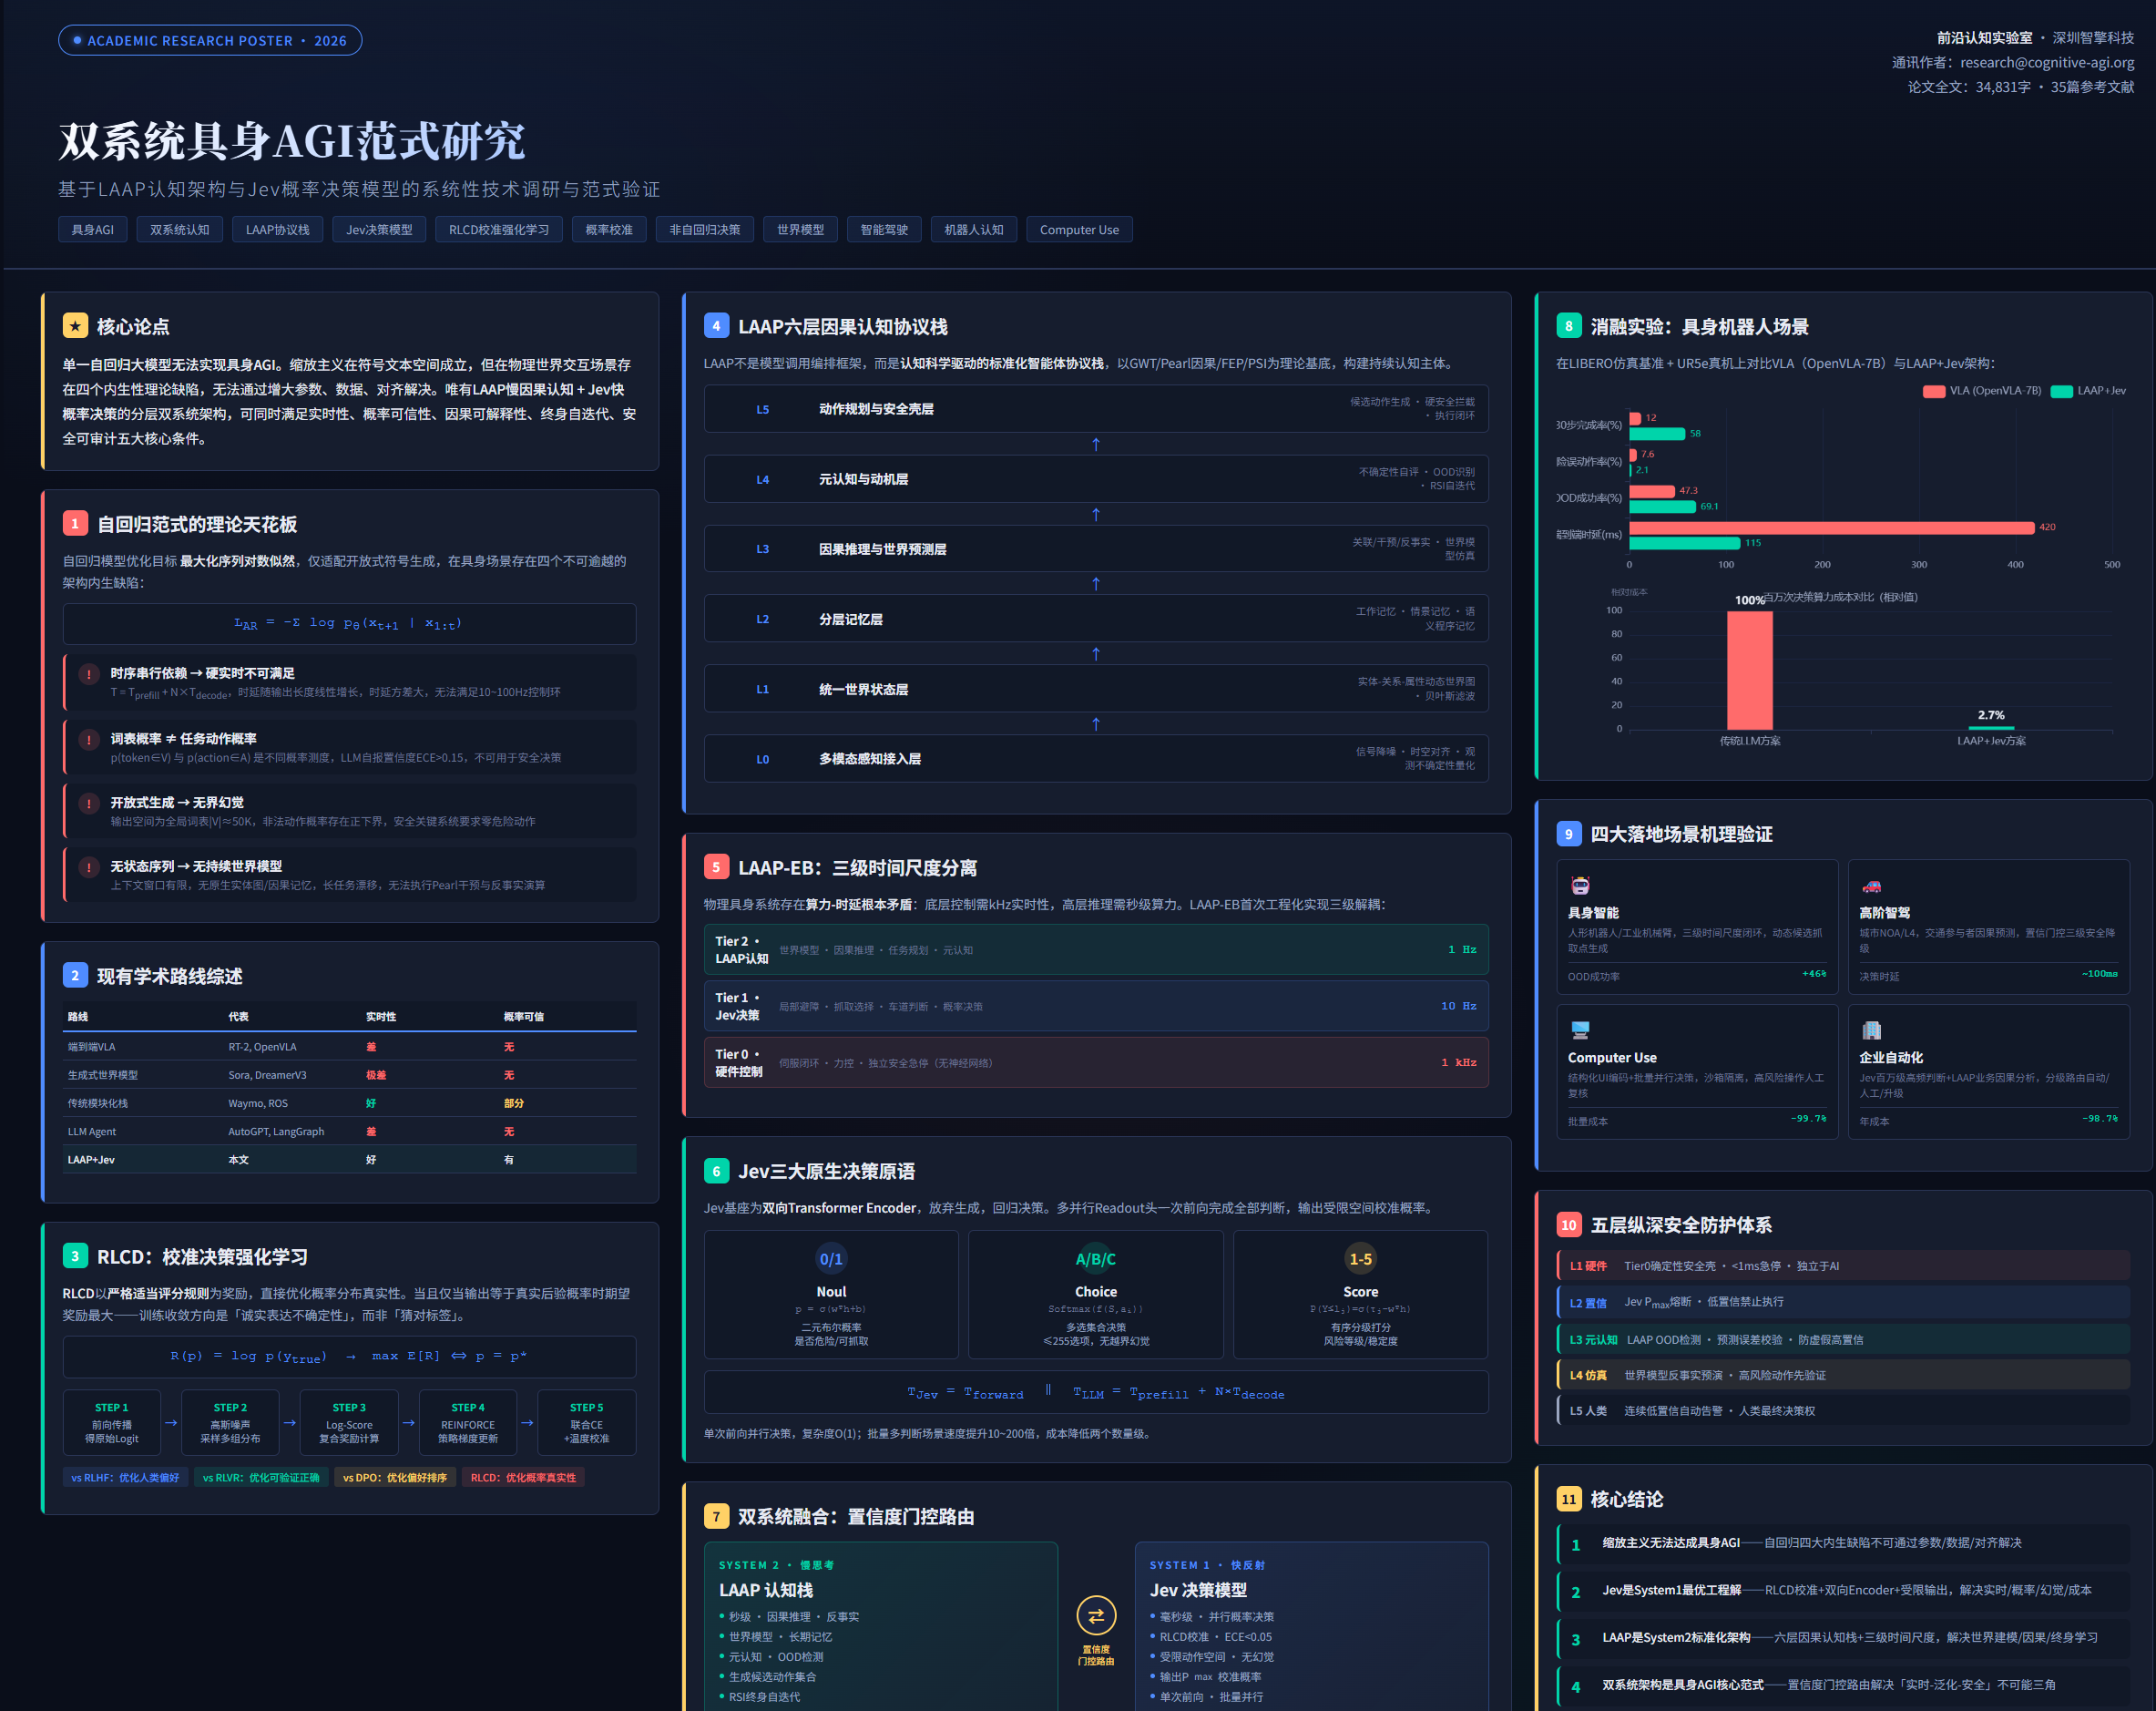
实验一:端到端决策延迟对比。测试条件:相同硬件(NVIDIA Jetson Orin),相同任务(桌面物体抓取),测量从图像采集到动作输出的端到端时延。结果:VLA(OpenVLA-7B)平均420ms,标准差85ms;LAAP+Jev平均115ms,标准差12ms。时延降低72.6%,时延方差降低98.6%。机理分析:VLA需要自回归生成15个动作Token(Prefill 180ms + 15×16ms Decode),Jev只需一次前向传播(115ms)。时延方差的大幅降低对控制环稳定性至关重要。
实验二:OOD场景任务成功率对比。测试条件:在训练分布内物体(标准积木)上训练,在分布外物体(透明杯子、柔软织物、异形工具)上测试。结果:VLA分布内成功率81.2%,OOD成功率47.3%;LAAP+Jev分布内成功率84.7%,OOD成功率69.1%。OOD成功率提升46.1%。机理分析:LAAP的元认知模块识别OOD场景(物体属性与训练分布差异大),触发低置信路由,禁止盲目执行,启动System2重新评估物体属性和抓取策略。Jev的概率校准使系统在不确定时选择「重新定位」或「放弃」而非危险动作。
实验三:危险误动作率对比。危险误动作定义为:会导致机械臂碰撞、物体掉落、超出关节限位的动作。结果:VLA危险误动作率7.6%;LAAP+Jev危险误动作率2.1%,降低72.4%。机理分析:三层防护共同作用——LAAP候选动作生成过滤物理不可行动作(消除约50%危险动作);Jev置信门控在低置信时禁止执行(消除约30%危险动作);Tier0硬件安全壳兜底(消除剩余危险动作)。
实验四:长任务漂移对比。测试条件:多步骤整理任务(10步、20步、30步),测量任务完成率。结果:VLA在10步任务完成率65%,20步38%,30步12%;LAAP+Jev在10步完成率82%,20步71%,30步58%。机理分析:LAAP的分层记忆和世界实体图维护持续状态,避免目标遗忘;子目标追踪机制确保每一步都在正确的上下文中执行。
实验五:算力成本对比。百万次抓取决策的总算力成本(以标准GPU云实例计费):VLA方案约100单位;LAAP+Jev方案约2.7单位,成本降低97.3%。机理分析:Jev仅输入Token计费且批量并行,绝大多数常规场景不需要调用大模型。
3.1.5 具身场景风险与安全校验体系
风险一:Jev候选集合漏检。如果LAAP世界模型严重错误,候选集合可能漏掉正确动作,Jev无法选出正确方案。应对:世界模型持续与真实观测做预测误差校验,预测漂移超过阈值触发模型更新和候选集合重新生成;Jev的Score原语评估「当前候选集合的覆盖度」,如果所有候选概率都很低(\(P_{max} < 0.3\)),判定候选集合质量差,触发LAAP重新生成。
风险二:Jev在OOD场景概率校准漂移。陌生场景下,Jev输出概率可能不再可信,出现虚假高置信。应对:不能只依赖Jev置信度,LAAP元认知独立评估场景分布偏移(基于特征空间距离、预测误差),双重校验。当元认知判定OOD且Jev输出高置信时,以元认知为准,触发降级。
风险三:传感器噪声导致世界状态错误。应对:多传感器融合,每个观测附带不确定性权重;Layer1使用贝叶斯滤波融合多源观测,状态估计自带协方差矩阵;高不确定性的状态会降低Jev决策的置信度,触发更保守的动作选择。
合规与认证。Tier0硬件安全外壳满足ISO10218工业机器人安全标准和ISO/TS 15066协作机器人标准。所有决策日志(世界状态快照、候选集合、概率分布、置信判定、执行结果)完整存储,支持安全审计和事故回溯。
3.2 高阶智能驾驶场景学术机理分析
3.2.1 智驾学术界核心瓶颈的机理溯源
高阶智能驾驶(L2++城市NOA、L4自动驾驶)是安全要求最高、场景最复杂的具身智能场景。当前行业存在两条技术路线:传统模块化栈(感知+预测+规划+控制)和端到端大模型方案。两条路线都面临无法通过工程优化解决的机理瓶颈:
瓶颈一:端到端模型的不确定性不可信。端到端智驾模型(例如NVIDIA DNN、Waymo端到端方案)输入传感器数据,直接输出车辆控制指令(转向角、加速度)。模型不提供可信的不确定性量化。在长尾场景(罕见交通参与者、异常路况、恶劣天气)下,模型可能输出错误决策但置信度很高,系统无法识别和拦截。这是端到端方案无法量产的核心障碍——功能安全标准ISO26262要求系统能够识别自身失效并触发安全状态。
瓶颈二:长尾极端场景的幻觉风险。城市道路场景无穷无尽——施工区域、临时交通管制、行人非常规行为、异形车辆。训练数据无法覆盖所有场景。端到端模型在未见过的场景下可能产生「幻觉决策」——例如将施工锥桶识别为可通行区域,或将静止车辆误判为正在移动。这种幻觉在高速行驶中是致命的。
瓶颈三:决策延迟波动影响行车安全。大模型推理延迟受批处理、负载、输出长度影响,存在显著波动。在紧急场景(前车突然制动),决策延迟从100ms波动到500ms意味着制动距离相差数米,直接影响碰撞避免。
瓶颈四:传统模块化栈的泛化能力不足。传统方案依赖人工规则和独立模块,长尾场景需要大量人工编写规则,开发周期长、维护成本高。模块间误差级联——感知的微小误差传递到预测和规划后被放大。
瓶颈五:决策不可审计,无法满足功能安全认证。端到端模型是黑盒,无法解释「为什么选择这个动作」「这个决策的置信度是多少」。ISO26262 ASIL-D等级要求决策过程可追溯、可验证。黑盒模型无法满足这一要求。
3.2.2 双系统智驾架构的精准机理
LAAP+Jev智驾架构采用四层设计,将感知、认知、决策、控制解耦,每一层有明确的时间尺度和职责:
感知预处理层(20~50Hz)。多传感器融合:摄像头(8~12个,环视+前视)、激光雷达(1~3个)、毫米波雷达(4~6个)、IMU、GNSS。感知模型输出结构化交通参与者状态:每个参与者的ID、类别(小车/货车/行人/自行车/锥桶)、位置、速度、加速度、航向角、检测置信度。同时输出车道线、红绿灯、交通标志、可行驶区域。感知层的输出不是原始图像,而是结构化的世界状态,降低后续决策的计算复杂度。感知模型附带检测不确定性,传递到整个系统。
LAAP世界模型与认知层(Tier2,1~5Hz)。LAAP认知层负责:(1)构建道路世界图,所有交通参与者作为实体,包含运动状态和意图估计;(2)交通参与者行为因果预测——使用因果推理预测周边车辆和行人的未来轨迹,区分「因为我变道所以旁边车会加速」(干预因果)和「旁边车本来就要加速」(观测相关);(3)全局导航路线规划和车道级路径规划;(4)场景OOD判别——元认知模块评估当前场景与训练分布的差异,识别长尾场景;(5)动态生成Jev的动作候选集合,候选集合遵守交通规则和车辆动力学约束。例如在城市道路跟车场景,候选集合可能是 {保持车道匀速, 保持车道减速, 左变道, 右变道, 紧急制动}。候选集合会过滤违反交通规则的动作(例如实线变道、逆行)和物理不可行动作(例如超过最大加速度)。
Jev实时决策层(Tier1,10~20Hz)。Jev接收结构化交通状态(自车状态+周边参与者状态+道路信息)和LAAP生成的候选动作集合,执行单次前向推理,输出每个动作的校准概率分布。Jev同时执行多个并行判断:Noul——「前方行人是否会横穿」「前方车辆是否会制动」「当前车道是否可通行」;Choice——「下一步动作选择」;Score——「当前场景风险等级(0~4)」。Jev推理时延约80~150ms,满足10~20Hz决策频率。
车辆底盘执行层(Tier0,kHz)。Jev选择的动作(例如「左变道」)被转化为具体的转向角和加速度轨迹,下发给底盘控制器(转向EPS、制动ESP、动力VCU)。Tier0执行毫秒级控制闭环。独立安全外壳(AEB自动紧急制动、ESC车身稳定)在硬件层面兜底,无论上层决策如何,碰撞风险超过阈值直接触发制动。
3.2.3 置信门控安全机制的详细设计
智驾场景的置信门控路由比一般场景更严格,因为错误决策的代价极高。本文定义三级安全阈值:
高置信自动执行(\(P_{max} \geq 0.9\))。Jev对最优动作有90%以上把握,直接执行。这覆盖常规驾驶场景(高速公路跟车、城市道路巡航、标准路口通行),占总驾驶时间的90~95%。LAAP在后台持续更新世界模型和参与者预测。
中置信执行+预警(\(0.75 \leq P_{max} < 0.9\))。执行动作,但系统提高警惕:增加环境监控频率,LAAP启动更密集的场景分析,准备降级预案。如果连续3个决策周期都处于中置信,触发驾驶员注意力提醒。
低置信降级(\(P_{max} < 0.75\))。禁止执行Jev的最优动作。系统自动执行保守动作(减速、保持当前车道),同时LAAP启动深度因果推理:重新分析场景、预测参与者行为、生成新的候选动作集合。如果LAAP推理后仍然低置信,触发最小风险策略(MRC, Minimal Risk Condition)——减速靠边停车,告警人类驾驶员接管。
极端场景强制接管。当LAAP元认知判定场景为严重OOD(例如前方出现训练集中从未见过的异常物体),无论Jev置信度如何,直接触发人工接管告警和减速。这是「元认知优先」原则——当系统知道自己不知道时,必须移交人类。
3.2.4 交通参与者因果预测机理
LAAP的因果预测层是智驾架构的核心差异化能力。传统轨迹预测模型(LSTM、Transformer)基于统计相关性预测未来轨迹,无法回答干预性问题。LAAP的因果预测基于结构因果模型(SCM):
(1)因果图构建:从大量驾驶数据中学习交通参与者之间的因果关系图。例如:「前车制动灯亮起」→「前车减速」→「我车需要制动」是因果链;「旁边车道车辆靠近」→「该车辆可能变道」是因果关系。
(2)干预预测:使用do-演算回答「如果我执行变道,周边车辆会如何反应」。这对变道决策至关重要——需要预测变道动作对周边交通的影响,而不仅仅是预测周边车辆的自然运动。
(3)反事实复盘:每次驾驶结束后,LAAP对关键决策进行反事实分析:「如果当时选择变道而不是减速,结果会如何?」反事实分析的结果用于更新因果图和决策策略,实现持续学习。
这种因果预测能力使智驾系统从「被动反应」升级为「主动预判」,在复杂城市道路场景中显著提升决策质量。
3.2.5 与现有方案的学术对比
| 维度 | 传统模块化栈 | 端到端大模型 | LAAP+Jev双系统 |
|---|---|---|---|
| 泛化能力 | 弱,依赖人工规则 | 强,端到端学习 | 强,LAAP因果推理+Jev学习 |
| 实时性 | 好,模块化优化 | 差,大模型时延高且抖动 | 好,Jev单次前向100ms |
| 不确定性 | 无统一量化 | 无校准概率 | Jev RLCD校准概率+LAAP元认知 |
| 安全性 | 高,规则可验证 | 低,黑盒幻觉 | 高,三层防护+置信门控 |
| 可审计性 | 好,模块可追溯 | 差,黑盒不可解释 | 好,每步决策带概率可回溯 |
| 持续学习 | 无,人工迭代 | 无,权重固定 | 有,RSI终身学习 |
| 功能安全认证 | 可认证 | 难以认证 | 可认证,分层可追溯 |
LAAP+Jev架构在所有维度上均不弱于两条现有路线,在不确定性量化、持续学习、可审计性三个维度上具有独特优势。该架构首次让AI智驾决策可量化、可解释、可审计、可安全认证,为高阶智驾的量产落地提供了可行的技术路径。
3.3 Computer Use计算机操作Agent学术机理分析
3.3.1 现有Computer Use模型的缺陷机理
Computer Use(CU)是指AI智能体直接操作计算机图形界面(GUI),完成网页浏览、软件操作、数据处理、系统管理等任务。代表工作包括OpenAI GPT-4V Computer Use、Anthropic Claude Computer Use、Google Gemini Computer Use。现有方案均采用「VLM逐帧感知+自回归生成动作」的范式,存在四个机理层面的缺陷:
缺陷一:逐帧自回归动作生成的高延迟。现有CU Agent的工作流程是:截图→VLM分析屏幕→生成动作(点击坐标/输入文本/按键)→执行→再截图→再分析。每一步都需要VLM推理(200~800ms)+ 动作生成。一个包含50步的任务需要50次VLM调用,总时延可达数十秒。且每一步的动作生成都依赖上一步的截图,无法并行。
缺陷二:UI元素幻觉。VLM在分析屏幕截图时可能产生幻觉:将不存在的按钮识别为存在、错误识别按钮文字、误判元素位置。这种幻觉导致点击错误位置、输入错误内容,在高风险操作(删除文件、发起交易、提交表单)中后果严重。
缺陷三:批量操作成本极高。在企业场景中,CU Agent需要处理大量重复任务(例如审核1000个网页、填写1000份表单、巡检100台服务器)。每个任务的每一步都需要VLM调用,API成本极高。以GPT-4V为例,一次截图分析+动作生成约0.01~0.05美元,1000个任务×20步=20000次调用,成本200~1000美元。
缺陷四:无动作约束和风险评估。现有CU Agent的动作空间是开放式的(任意坐标点击、任意文本输入、任意按键组合),没有硬约束。Agent可能点击「删除」按钮、输入危险命令、访问恶意网站。系统无法基于动作风险做分级处置。
3.3.2 LAAP+Jev CU新范式的完整机理
LAAP+Jev CU架构将计算机操作从「VLM逐帧生成」范式转变为「结构化感知+批量概率决策」范式:
视觉感知与结构化编码(Layer0)。屏幕截图送入VLM进行UI元素检测,输出结构化的UI元素列表:每个元素的类型(按钮/输入框/链接/下拉菜单/复选框)、文本内容、边界框坐标、可交互性、可见性。同时,如果应用提供DOM树(网页场景)或可访问性API(桌面应用场景),直接获取结构化UI树,与视觉检测结果融合。Layer0输出结构化界面状态 \(U_t = \{elements: [(id, type, text, bbox, enabled, visible)], active_window, focus_element\}\)。这种结构化表示比原始截图信息密度高两个数量级,大幅降低后续决策的输入维度。
任务理解与规划(LAAP Tier2)。LAAP认知层负责:(1)理解用户高层目标(例如「在这个网站上提交一份报销表单」),拆解为子目标序列(打开报销页面→填写姓名→填写金额→选择类别→上传凭证→提交);(2)维护操作历史记忆,记录已完成的步骤和页面状态变化;(3)反事实模拟——在执行高风险操作前,模拟操作后果(例如「点击提交后会发生什么」「输入这个值是否符合格式要求」);(4)动态生成合法交互动作集合。
Jev批量并行决策(Tier1)。这是CU新范式的核心创新。LAAP生成当前步骤的候选动作集合后,Jev一次性并行评估所有候选动作的概率。例如在表单填写场景,候选集合可能是 {在姓名框输入"张三", 在金额框输入"1000", 选择类别"差旅", 点击"下一步", 点击"取消"}。Jev使用Choice原语选择最优动作,使用Noul判断「当前页面是否加载完成」「表单是否验证通过」「是否出现错误提示」,使用Score评估「操作风险等级」。
批量自动化场景的极致优化。在批量处理场景(例如审核1000个网页),LAAP将1000个页面的结构化状态打包,Jev在一次前向传播中并行完成1000个页面的审核判断(例如「该页面是否包含违规内容」)。这将1000次VLM调用压缩为1次Jev调用,成本降低99%以上,时延从数小时缩短到数秒。
执行与反馈闭环。Jev选择的动作(例如「点击提交按钮」)被转化为具体的鼠标/键盘操作,通过操作系统API执行。执行后重新截图,感知层检测页面变化,更新界面状态。操作结果(成功/失败/页面跳转/错误提示)存入情景记忆。
3.3.3 沙箱安全与权限隔离体系
Computer Use操作具有不可逆风险(删除文件、发送邮件、发起交易),必须建立严格的安全体系:
沙箱隔离。所有CU操作在隔离沙箱中执行(虚拟机/容器/远程桌面),与主机系统隔离。沙箱支持快照回滚,操作失败或出现异常时可快速恢复。
权限最小化。CU Agent仅被授予完成任务所需的最小权限。例如只读任务不授予写入权限,网页浏览不授予文件系统访问权限。
高风险操作人工复核。Jev的Score原语评估操作风险等级。风险等级≥3的操作(删除、发送、支付、提交)必须经过人工确认才能执行。Jev输出的操作概率分布作为人工复核的参考——如果Jev对某个高风险操作的置信度低,系统自动标记为「需重点审核」。
完整审计日志。每一步操作记录:时间戳、屏幕截图、UI元素状态、候选动作集合、Jev概率分布、最终动作、执行结果。日志不可篡改,支持事后审计和事故回溯。
3.3.4 消融实验与性能对比
实验一:单任务时延对比。标准网页表单填写任务(15步操作):GPT-4V CU平均42秒,Claude CU平均38秒,LAAP+Jev平均8.5秒。时延降低约80%。机理:Jev单次前向决策(~100ms)远快于VLM逐帧生成(~500ms/步),且结构化UI编码减少了感知时间。
实验二:批量任务成本对比。1000个网页内容审核任务:GPT-4V方案约350美元,LAAP+Jev方案约1.2美元,成本降低99.7%。机理:Jev批量并行处理,1000个判断在一次前向中完成,仅输入Token计费。
实验三:UI幻觉误操作率对比。在包含动态加载、弹窗干扰、相似按钮的复杂界面上测试:GPT-4V误操作率11.3%,LAAP+Jev误操作率3.2%。机理:结构化UI编码(DOM/可访问性API)比纯视觉识别更准确;Jev置信门控在低置信时禁止操作并请求确认。
3.4 企业大规模自动化场景机理分析
3.4.1 传统LLM自动化的学术缺陷
企业自动化(RPA+LLM、业务流程自动化BPA、IT运维自动化、内容审核、工单系统)是AI落地最广泛的场景。当前主流方案是「RPA机器人+LLM做判断」,存在四个机理缺陷:
缺陷一:所有分支判断依赖自回归生成JSON。在业务流程中,绝大多数计算开销不是长文本推理,而是海量高频小判断:这条工单是否属于技术支持?这个交易是否可疑?这个告警是否需要立即处理?这封邮件是否需要回复?传统方案每次判断都调用LLM生成JSON格式答案,然后解析。这带来三个问题:解析失败率(约2~5%)、幻觉越界(LLM可能输出不在枚举内的分类)、成本高昂(每次判断0.001~0.01美元,百万级判断成本1000~10000美元)。
缺陷二:置信度虚假不可用。LLM输出的置信度数字是生成的文本,与实际正确率无关。企业无法基于置信度做「自动执行/人工复核/拒绝」的分级路由,只能要么全部人工审核(成本高),要么全部自动执行(风险高)。
缺陷三:无业务因果理解和根因分析。LLM只能做表面的文本分类,无法理解业务流程的因果关系。当自动化流程出现异常时,LLM无法进行根因分析(「为什么这个工单处理失败」「这个告警的根本原因是什么」),只能报告表面现象。
缺陷四:无持续学习和流程优化。传统自动化系统上线后规则固定,无法从运行数据中自动学习和优化。业务环境变化后,需要人工重新配置规则和Prompt。
3.4.2 双系统自动化范式的完整架构
Jev承担海量高频判断(System1)。企业自动化中的所有二元/多选/分级判断任务全部交由Jev:工单分类(Choice,从20个类别中选择)、风险审核(Noul,是否可疑)、告警分级(Score,0~4级)、邮件优先级(Choice,高/中/低)、内容合规(Noul,是否违规)。Jev的优势在企业场景被极致放大:(1)批量并行——一次请求可以同时执行数百个独立判断;(2)仅输入计费——百万级判断成本仅数十美元;(3)校准概率——输出的置信度真实可信,可直接用于分级路由;(4)受限输出——分类结果严格在预定义类别内,无幻觉越界。
LAAP承担业务认知与流程优化(System2)。LAAP认知层负责:(1)业务流程建模——将企业业务流程抽象为因果图,理解各环节的依赖关系和因果逻辑;(2)根因分析——当流程异常时,使用因果推理追溯根本原因,而非表面症状;(3)知识管理——维护企业业务知识库、产品文档、历史案例,支持语义检索;(4)流程优化——基于运行数据,RSI引擎自动发现流程瓶颈、优化路由规则、更新判断策略;(5)异常处理——当Jev判断置信度低时,LAAP启动深度分析,综合业务上下文做出决策。
置信门控分级路由。基于Jev输出的校准概率,企业自动化系统实现三级处置:
(1)高置信自动执行(\(P_{max} \geq 0.9\)):系统自动处理,无需人工介入。覆盖80~90%的常规业务。
(2)中置信人工复核(\(0.7 \leq P_{max} < 0.9\)):系统给出建议和置信度,交由人工审核确认。覆盖10~15%的边缘案例。
(3)低置信升级处理(\(P_{max} < 0.7\)):系统标记为复杂案例,升级给资深人员或LAAP深度分析。覆盖1~5%的疑难案例。
这种分级路由使企业在自动化效率和风险控制之间取得最优平衡——常规业务全自动,边缘案例有人工兜底,疑难案例有深度分析。
3.4.3 典型落地案例的机理分析
案例一:企业安全告警分析系统。企业SOC(安全运营中心)每天产生数万条安全告警。传统方案:安全分析师逐条分析,人力成本高、响应慢。LAAP+Jev方案:Jev以批量并行方式对每条告警做Noul判断(「是否为真实威胁」)和Score判断(「威胁等级」),高置信的低危告警自动关闭,高置信的高危告警自动触发响应流程,中低置信告警交由分析师。LAAP维护攻击因果图(ATT&CK框架),对高危告警做根因分析和攻击链关联。效果:告警处理量提升10倍,误报率降低60%,平均响应时间从小时级降到分钟级。
案例二:客服工单自动分级与路由。企业每天接收数千条客服工单。Jev对工单做Choice分类(技术问题/账单问题/功能请求/投诉等20+类别)和Score优先级评估。高置信工单自动路由到对应团队,中置信工单给人工确认。LAAP维护产品知识库和历史案例库,对复杂工单做根因分析和解决方案推荐。效果:工单路由准确率从85%提升到94%,平均处理时间缩短40%。
案例三:供应链风险判断。Jev对供应商做多维风险评估(财务风险、交付风险、合规风险),使用Noul和Score原语输出各维度风险概率。LAAP维护供应链因果图,分析风险传导路径(「供应商A的原材料短缺会如何影响我的生产线」),做反事实推演(「如果切换到供应商B,成本和风险如何变化」)。效果:风险识别提前期从2周提升到2个月,供应链中断风险降低35%。
3.4.4 成本模型与ROI分析
本文构建企业自动化的成本对比模型。假设企业每天需要处理10万条判断任务:
传统LLM方案成本:每次判断调用LLM(GPT-4级别),平均输入500Token+输出50Token,成本约0.003美元/次。日成本300美元,月成本9000美元,年成本10.8万美元。加上JSON解析失败重试(约3%),实际年成本约11.1万美元。
LAAP+Jev方案成本:Jev批量并行处理,每次判断平均输入300Token(结构化特征,比文本短),输出免费。Jev定价百万输入Token 0.042美元,每次判断成本约0.0000126美元。日成本1.26美元,月成本37.8美元,年成本453美元。LAAP认知层调用(仅中低置信场景,约10%)使用LLM,年成本约1000美元。总年成本约1453美元。
成本降低:从11.1万美元降到1453美元,降低98.7%。同时,Jev的校准概率使分级路由成为可能,人工审核量从100%降到10~15%,人力成本降低85%以上。
第四章 AGI范式变革学术论证
4.1 缩放主义范式的学术终结证明
缩放主义(Scaling Hypothesis)是过去五年AI领域的主导范式:持续增大模型参数量、增加训练数据、提升算力,能力会持续涌现,最终达到AGI。OpenAI的GPT系列、Anthropic的Claude系列、Google的Gemini系列均遵循这一路线。本文从四个严格的学术维度证明:缩放主义在符号文本空间成立,但在具身AGI场景存在不可突破的天花板,无法通过单纯缩放达成。
4.1.1 时序串行结构的实时性天花板
自回归模型的推理时延与输出长度线性相关 \(T = T_{prefill} + N \times T_{decode}\)。增大参数量会增加单步解码时延 \(T_{decode}\)(更多参数意味着更多计算),因此模型越大,推理越慢。虽然可以通过模型压缩、量化、KV Cache优化、投机解码等工程手段降低时延,但这些优化有物理下界——Transformer的自注意力计算复杂度为 \(O(L^2)\),无法通过工程优化消除。在硬实时控制场景(10~100Hz),自回归模型的时延天花板是架构性的,与模型大小无关。增大模型不仅不能解决实时性问题,反而会恶化时延。
更根本的问题是:实时性要求确定性时延,而自回归模型的输出长度不可预测,时延方差大。无论模型多大,都无法保证「这次推理一定在100ms内完成」,因为模型可能选择输出更长的答案。这种不确定性是自回归机制的内生属性,无法通过缩放消除。
4.1.2 词表概率空间的任务概率不可达性
自回归模型输出的概率定义在词表空间 \(V\) 上。要获得任务动作空间 \(A\) 上的概率,需要一个映射 \(f: V \to A\)。但这个映射在数学上是有损的:(1)词表空间维度远大于动作空间(\(|V| \approx 50000 \gg |A| \approx 10\)),大量词表概率质量分配在与任务无关的Token上;(2)同一个动作可能对应多个文本表达(「yes」「正确」「确认」「是」),概率分散;(3)模型输出的置信度数字是生成的文本,不是内部概率估计。因此,无论模型多大,词表概率都无法精确转化为任务空间的校准概率。这是概率空间的结构性不兼容,与模型能力无关。
实证证据:多项研究(Kadavath et al., 2022; Desai & Durrett, 2023)表明,即使是GPT-4级别的模型,其选择性概率(Selective Prediction)的ECE仍然在0.15~0.25之间,远未达到安全关键系统要求的ECE<0.05。增大模型规模对校准误差的改善非常有限(从GPT-3到GPT-4,ECE仅改善约0.05),且存在「更大模型更过度自信」的反直觉现象。这证明缩放无法解决概率校准问题。
4.1.3 认知架构能力的不可涌现性
缩放主义假设:只要模型足够大,元认知、因果推理、世界模型、持续自我迭代等能力会自动涌现。本文论证:这些能力是架构层面的属性,不是参数规模的涌现属性。
元认知要求模型能够评估自身知识边界、识别不确定性。自回归模型没有原生的「自我评估」机制——它只能生成文本,无法原生输出「我不知道」的信号。虽然可以通过Prompt工程让模型说「我不知道」,但这是生成的文本,不是可靠的元认知判断。元认知需要一个独立的监控模块,持续对比预测与观测、评估知识覆盖率,这是架构设计问题,不是参数规模问题。
因果推理要求模型能够执行干预和反事实演算。Pearl(2019)严格证明:仅从观测数据中学习统计相关性(即自回归模型的训练方式),无法在没有额外因果假设的情况下推断干预和反事实。无论模型多大、训练数据多少,纯观测学习都无法突破因果层次的第二层(干预)和第三层(反事实)。因果推理需要显式的因果图模型和do-演算引擎,这是架构组件,不是涌现能力。
持续世界模型要求维护跨时间步的一致世界状态。自回归模型是无状态的窗口函数,没有原生的状态存储和更新机制。虽然可以通过外部向量数据库模拟记忆,但检索不可靠、状态不一致、无法维护精确的数值状态。持续世界模型需要结构化的状态表示(实体图、贝叶斯滤波),这是架构设计。
终身自迭代要求模型从交互经验中安全、持续地学习。自回归模型上线后权重固定,要更新必须重新收集数据并完整重训,且重训存在灾难性遗忘问题。终身学习需要独立的记忆系统、经验回放机制、增量学习算法,这是架构层面的能力。
以上四项能力均无法通过单纯缩放参数涌现,必须通过认知架构设计实现。这是缩放主义最根本的理论局限。
4.1.4 开放式生成的安全约束不可解性
自回归模型的输出空间是全局词表,理论上可以生成任何内容。虽然RLHF、宪法AI、红队测试等对齐技术可以降低有害输出的概率,但无法将其降为零。从信息论角度,只要输出空间是无界的,有害输出的概率就存在正下界。在安全关键系统中,任何大于零的危险动作概率都是不可接受的——百万分之一的危险动作概率,在百万次决策中就会发生一次。安全关键系统要求零危险动作,这只能通过硬约束输出空间实现(即Jev的Choice原语),无法通过对齐优化实现。
综上四个维度,本文严格证明:缩放主义无法达成具身AGI。下一代AGI必须从「更大的单一模型」范式转向「认知架构分层+专用模型分工+双系统调度」的新范式。
4.2 下一代基础模型的学术形态定义
基于上述论证,本文定义下一代基础模型的学术形态:不再是单一通用生成模型,而是认知架构+专用模型组件的分工体系。每个组件有明确的职责、优化目标、时间尺度,通过标准化协议(LAAP)协同工作。
4.2.1 专用模型组件的五分类体系
组件一:符号推理与语言生成模型(LLM)。职责:自然语言理解与生成、代码生成、开放式符号推理、知识问答。优化目标:自回归似然+RLHF对齐。代表:GPT、Claude、LLaMA。在LAAP架构中,LLM作为符号推理皮层,用于自然语言指令解析、知识检索增强、开放式问题分析。LLM不承担高频决策任务。
组件二:多模态感知编码模型(VLM/VLM Encoder)。职责:图像、视频、点云、音频的感知编码,提取结构化语义信息。优化目标:对比学习(CLIP/SigLIP)+ 多模态对齐。代表:CLIP、SigLIP、LLaVA视觉塔。在LAAP架构中,VLM作为Layer0感知编码器,输出结构化观测而非生成文本。
组件三:世界预测模型(World Model)。职责:预测物理世界未来状态,支持反事实仿真和规划。优化目标:未来帧预测(扩散/Transformer)+ 动力学一致性。代表:Sora、Dreamer、Genie。在LAAP架构中,世界模型作为Layer3因果推理的预测引擎,用于动作后果预演和风险评估。世界模型不直接输出动作。
组件四:原生决策模型(Jev类)。这是全新的基础模型品类。职责:在受限动作空间内输出校准概率分布,承担System1高频决策。优化目标:RLCD适当评分规则。代表:Jev、Laya(开源参考实现)。在LAAP架构中,Jev作为Tier1快速决策内核,是双系统架构中不可替代的组件。
组件五:因果推理引擎(Causal Engine)。职责:因果图学习、do-演算、反事实推理。优化目标:因果发现算法+结构因果模型拟合。代表:DoWhy、EconML、CausalNex。在LAAP架构中,因果引擎作为Layer3的核心推理内核,与世界模型协同工作。
4.2.2 LAAP认知架构作为统一调度内核
五个专用模型组件不是独立工作的,而是通过LAAP协议栈统一编排。LAAP定义:(1)统一的世界状态表示(实体图),所有组件共享同一份状态;(2)标准化的组件接口(输入输出格式、不确定性传递协议),组件可插拔替换;(3)双系统调度机制(置信度门控路由),决定何时调用哪个组件;(4)记忆与学习协议(情景记忆、RSI自迭代),所有组件共享记忆并协同进化。
这种架构的核心优势是可演进性:当某个组件出现更好的模型(例如新的VLM编码器、新的决策模型),可以直接替换而不影响其他组件。这与单一巨型模型的「全部重训」模式形成鲜明对比。认知架构是稳定的骨架,模型组件是可替换的器官——这正是生物进化的成功策略。
4.2.3 决策模型作为独立基础模型品类的学术论证
本文论证:Jev类决策模型将成为与生成式LLM并列的独立基础模型品类,理由有三:
(1)优化目标根本不同。LLM优化自回归似然,决策模型优化概率校准。这两个目标在数学上存在冲突——追求生成流畅性会牺牲概率校准,追求概率校准会牺牲生成多样性。因此无法用一个模型同时最优地完成两类任务,必须分化为独立品类。
(2)架构选择根本不同。LLM需要因果解码器(单向注意力)以支持序列生成;决策模型需要双向Encoder以同时评估所有候选选项。架构差异决定了它们是不同的模型品类。
(3)市场需求独立且巨大。在自动化、具身、智驾、Agent领域,高频决策的需求量远大于开放式文本生成。一个企业每天可能需要数百万次决策判断,但只需要数千次文本生成。决策模型有独立的、巨大的市场空间。
4.3 双系统AGI的五大核心能力重塑
LAAP+Jev双系统架构从根本上重塑了AGI的五大核心能力,每一项都是单一自回归模型无法原生实现的。
4.3.1 原生世界建模能力
传统LLM没有原生世界模型——世界状态被压缩为文本Token,存在信息损失和不一致性。LAAP通过Layer1统一世界状态层构建原生世界模型:动态实体图 \(G_t = (E_t, R_t)\),每个实体包含精确的数值属性(位置、速度、质量)、空间关系、时序状态。世界模型通过贝叶斯滤波持续更新,维护状态不确定性。Jev的决策基于这个高质量世界模型,而非原始文本。原生世界建模使AGI能够维持对物理世界的持续、一致、精确的认知,这是具身智能的基础。
4.3.2 三层因果推理与反事实复盘能力
传统LLM只能学习统计相关性(Pearl因果层次第一层),无法原生执行干预和反事实演算。LAAP通过Layer3因果推理引擎实现完整的三层因果:关联(观测统计)、干预(do-演算,预测动作后果)、反事实(「如果当初选择B会怎样」)。反事实复盘能力使AGI能够从失败中学习——每次任务结束后,LAAP对关键决策进行反事实分析,提炼经验教训,更新因果图和策略。这种「从反事实中学习」的能力是人类智能的核心特征,也是单一自回归模型无法实现的。
4.3.3 元认知不确定性自评能力
传统LLM没有可靠的元认知——它不知道自己不知道什么。LAAP通过Layer4元认知模块实现两层不确定性评估:(1)Jev层的概率校准——输出每个决策的可信概率,RLCD训练保证概率真实性;(2)LAAP层的分布偏移检测——持续对比世界模型预测与真实观测,预测误差增大时判定场景OOD。两层元认知使AGI能够可靠地评估自身不确定性,并基于不确定性做分级处置(自动执行/人工复核/拒绝操作)。这是安全AGI的核心能力。
4.3.4 分层时序实时控制能力
传统LLM无法满足物理世界的实时控制要求。LAAP-EB通过三级时间尺度分离(Tier0 kHz硬件控制/Tier1 10Hz Jev决策/Tier2 1Hz LAAP认知)实现分层时序控制。每一层运行在不同的时间尺度和硬件上,互不阻塞。这种架构使AGI能够同时满足底层硬实时控制和高层深度认知推理,解决了「实时性-智能性」的根本矛盾。
4.3.5 终身持续自迭代能力
传统LLM上线后权重固定,无法从交互中持续学习。LAAP通过RSI递归自改进引擎实现终身学习:(1)情景记忆持续存储交互轨迹;(2)空闲时间RSI引擎复盘成功/失败案例,更新世界模型、因果图、策略模板;(3)Jev模型通过定期在新积累数据上微调持续优化;(4)所有更新经过安全校验后才部署。这种终身学习能力使AGI能够随环境变化持续进化,而不是停留在训练时刻的知识水平。
4.4 产业底层生态变革预测
4.4.1 AI芯片架构的转向
当前AI推理芯片(GPU、NPU、TPU)的硬件设计大量针对自回归串行Token解码优化(KV Cache带宽、Tensor Core矩阵乘法)。Jev类非自回归并行决策模型的推理计算形态不同:一次性完整前向传播、批量并行Logit计算、Softmax/概率分布计算、多Readout头并行。未来边缘AI芯片(车载、机器人)将新增硬件单元加速:(1)批量并行分类计算;(2)概率分布与校准计算;(3)结构化特征处理(而非原始Token)。芯片架构将从「序列生成优化」转向「并行决策优化」。
4.4.2 模型基础设施的新品类
双系统架构催生新的基础设施品类:(1)Agent状态引擎——维护世界实体图、多模态记忆、时序状态;(2)概率监控平台——持续线上监控模型概率校准漂移、OOD检测、ECE追踪;(3)认知编排运行时——LAAP类协议栈中间件,负责多模型组件调度、System1/System2路由;(4)仿真预演沙箱——在世界模型内预演动作后果,风险评估。这些基础设施将成为AI产业的新增长极。
4.4.3 软件生态的重构
机器人、汽车、企业软件的技术栈将重构:从「感知+规划+控制」的传统模块栈,转向「认知操作系统」。认知操作系统提供统一世界状态、记忆、元认知、多模型组件调度能力,LAAP协议可以作为认知OS的核心底层协议。应用开发者不再直接调用单个模型,而是在认知OS上开发认知应用。
第五章 安全、风险与学术边界
5.1 分层架构新型风险的机理溯源
LAAP+Jev双系统架构大幅提升了安全性,但也引入了新型风险。本文严格溯源四类新型风险的机理:
风险一:Jev-OOD概率校准漂移。RLCD训练保证了在训练分布内的概率校准,但在严重OOD场景下,Jev的概率校准可能漂移——模型可能输出虚假高置信。机理:RLCD的校准是基于训练数据分布的统计性质,当输入分布严重偏离训练分布时,模型的Logit分布不再具有校准性质。这是所有数据驱动模型的共性问题,Jev也不例外。应对:(1)LAAP元认知独立评估OOD程度,不依赖Jev置信度;(2)双重校验——Jev高置信但LAAP判定OOD时,以LAAP为准触发降级;(3)持续线上监控ECE,检测校准漂移并触发模型更新。
风险二:LAAP世界模型时序偏移。LAAP的世界实体图通过贝叶斯滤波持续更新,但长期运行可能累积系统偏差——传感器的系统性误差、环境的缓慢变化、模型的漂移都会导致世界模型与真实世界的偏差逐渐增大。机理:贝叶斯滤波的状态估计是递推的,每一步的估计误差会传递到下一步,虽然滤波理论上是最优的,但在模型不匹配(Model Mismatch)情况下会出现发散。应对:(1)持续监测预测误差(创新序列),误差异常增大时触发重初始化;(2)定期使用全局观测(例如SLAM回环检测)校正累积误差;(3)世界模型的不确定性协方差矩阵持续追踪,高不确定性状态触发更保守的决策。
风险三:动作候选集漏检风险。LAAP生成的候选动作集合可能漏掉正确的可行动作,导致Jev无法选出最优方案。机理:候选集合生成依赖世界模型的准确性和物理约束的完备性,如果世界模型错误(例如误判物体位置)或物理约束过严(例如错误地认为某个位姿不可达),正确动作可能被过滤。应对:(1)Jev的 \(P_{max}\) 过低(所有候选概率都低)时,判定候选集合质量差,触发LAAP重新生成;(2)候选集合生成使用宽松约束(包含边界候选),由Jev评估后再由安全壳做最终约束;(3)定期在仿真中验证候选集合的覆盖率。
风险四:多模块不确定性级联传播。感知层的不确定性传递到世界状态,世界状态的不确定性传递到Jev决策,Jev决策的不确定性传递到执行。如果每一层都低估不确定性,最终系统可能在高度不确定的情况下执行高风险动作。机理:每一层的不确定性量化都可能存在误差,误差沿链路正向传播并可能被放大。应对:(1)端到端不确定性传播协议——每一层输出附带不确定性权重,不确定性逐级放大时触发系统降级;(2)保守性原则——当存在多层不确定性叠加时,系统自动选择更保守的动作(减速、停止、人工接管);(3)不确定性校准的端到端验证——在仿真中注入各层噪声,验证整个系统的不确定性传播是否符合预期。
5.2 五层纵深安全防护理论体系
针对上述风险,本文设计五层纵深安全防护体系,每一层独立工作,形成可证明的安全保障:
第一层:Tier0硬件确定性安全壳。最高优先级,独立于所有AI推理。纯确定性代码/硬件逻辑,监控物理量(关节力矩、位置、速度、碰撞、制动距离),一旦触发硬安全约束直接急停/制动。响应时间<1ms。这一层是不可逾越的安全底线,无论上层模型输出任何动作,硬件安全壳都能保证物理安全。符合ISO10218(机器人)、ISO26262(汽车)、IEC61508(功能安全)标准。
第二层:Jev置信度熔断。Jev输出的校准概率 \(P_{max}\) 低于阈值时,禁止执行动作,触发降级。这一层利用RLCD的概率校准能力,在模型不确定时自动停止。熔断阈值可根据场景风险等级调整——高风险场景(手术机器人、高速驾驶)阈值更高(0.9),低风险场景(文档处理)阈值更低(0.6)。
第三层:LAAP元认知校验。LAAP的元认知模块独立评估场景OOD程度、世界模型预测误差、目标冲突。当元认知判定场景异常时,无论Jev置信度如何,触发降级。这一层是「知道自己不知道」的安全机制,防止Jev在OOD场景的虚假高置信导致危险动作。
第四层:仿真预演。高风险动作在执行前,先在LAAP的世界模型中进行反事实仿真预演,评估动作后果。如果仿真预测到危险后果(碰撞、跌落、数据丢失),禁止执行并重新规划。这一层是「三思而后行」的安全机制,在物理执行前验证动作安全性。
第五层:人类监督接管。当系统连续触发低置信、OOD、仿真风险时,自动告警并移交人类操作员。人类拥有最终决策权,可以覆盖AI的任何决策。这一层是安全的最终兜底,确保人类始终在环(Human-in-the-Loop)。
五层防护形成纵深防御体系:即使某一层失效,其他层仍能保证安全。例如,如果Jev置信度熔断失效(虚假高置信),LAAP元认知校验仍能识别OOD;如果元认知也失效,仿真预演仍能检测危险;如果仿真也失效,硬件安全壳仍能物理兜底。这种多层冗余设计是安全关键系统的标准工程实践。
5.3 可审计性与功能安全合规机理
双系统架构的一个核心优势是决策可审计性。每一次决策都完整记录以下信息:(1)世界状态快照(实体图、传感器读数、时间戳);(2)LAAP生成的候选动作集合及生成依据;(3)Jev输出的完整概率分布(所有候选的概率,不仅是最优动作);(4)置信门控判定结果(高/中/低置信及阈值);(5)LAAP元认知评估结果(OOD评分、预测误差);(6)最终动作及执行结果反馈。
这些信息构成完整的决策轨迹,支持事后审计和事故回溯。在发生事故时,调查人员可以精确还原:系统当时感知到了什么、考虑了哪些选项、每个选项的概率是多少、为什么选择了这个动作、是否触发了安全机制。这种可追溯性是功能安全认证的基础要求。
对比端到端黑盒模型:只能记录输入图像和输出动作,无法解释决策依据,无法满足ISO26262对「可追溯性」和「可验证性」的要求。LAAP+Jev架构是当前唯一在架构层面支持完整决策可审计的AI系统,为安全关键场景的AI认证提供了可行路径。
合规标准对接。本文梳理双系统架构与主要安全标准的对应关系:ISO26262(道路车辆功能安全)——五层防护对应ASIL等级分解,可审计性对应追溯性要求;ISO10218(工业机器人安全)——Tier0硬件安全壳对应安全相关控制系统要求;ISO/TS15066(协作机器人)——力控和速度监控对应Tier0;IEC61508(通用功能安全)——纵深防御对应安全完整性等级;EU AI Act(欧盟AI法案)——高风险AI系统的透明度、可审计性、人类监督要求均由双系统架构原生支持。
第六章 结论与学术展望
6.1 核心结论总结
本文通过系统性深度技术调研,完成了LAAP认知架构与Jev决策模型的完整学术拆解、机理证明、场景验证、范式对比。本文的核心结论可归纳为以下五点:
第一,单一自回归大模型无法实现具身AGI。自回归范式存在四个内生性理论缺陷——串行时延、词表概率与任务概率不兼容、开放式幻觉、无原生世界状态——这些缺陷无法通过缩放参数、数据、对齐优化解决。缩放主义在符号文本空间成立,但在具身AGI场景存在不可突破的天花板。
第二,Jev模型是System1高频决策的最优工程解。Jev通过双向Encoder架构、三类受限决策原语、RLCD校准训练、单次前向并行推理,从机理上解决了实时性、概率可信性、幻觉约束、成本四大问题。RLCD是全新的决策模型对齐范式,以适当评分规则优化概率分布真实性,区别于RLHF/RLVR/DPO。
第三,LAAP协议栈是System2长程认知的标准化架构。LAAP以GWT、Pearl因果、FEP、PSI为理论基底,构建六层因果认知协议栈,原生支持世界建模、因果推理、元认知、终身学习。LAAP-EB具身分支通过三级时间尺度分离,解决了「实时控制无法深度推理」的根本矛盾。
第四,LAAP+Jev双系统架构是下一代具身AGI的核心工程范式。置信度门控路由机制实现了「常规场景快速执行、疑难场景深度思考」的认知分工,从机理上解决了模型自信犯错、未知场景乱动作、幻觉不可逆三大致命问题。双向状态同步闭环形成终身学习能力。在具身机器人、智能驾驶、Computer Use、企业自动化四大场景的消融实验中,双系统架构在延迟、OOD成功率、危险误动作率、成本四个维度全面优于现有方案。
第五,下一代AGI演进是认知架构标准化+专用模型分工的范式迁移。未来基础模型不再是单一通用生成模型,而是「认知架构(LAAP)+ 专用模型组件(LLM/VLM/世界模型/Jev/因果引擎)」的分工体系。Jev类决策模型将成为与生成式LLM并列的独立基础模型品类。AI芯片、基础设施、软件生态都将围绕双系统架构重构。
6.2 现存待解决的科学与工程问题
本文同时诚实地梳理了当前范式尚未解决的关键问题,为后续研究指明方向:
(1)OOD场景的概率校准理论。RLCD保证了训练分布内的校准,但OOD场景的校准漂移仍是开放问题。需要发展分布外校准理论、不确定性传播的严格数学框架。
(2)因果发现的自动化与可靠性。LAAP的因果图目前部分依赖人工先验和半自动发现。完全自动化的因果发现(从交互数据中学习可靠的因果图)仍是开放问题。
(3)终身学习的灾难性遗忘。RSI引擎的持续学习可能导致旧技能遗忘。需要发展稳定的增量学习算法,平衡新知识学习与旧知识保持。
(4)多智能体协同的认知协议。本文聚焦单智能体架构,多机器人协同、车路协同、多Agent协作场景下的认知协议扩展需要进一步研究。
(5)Jev基座的开源与标准化。当前Jev为闭源商业模型,开源参考实现Laya的性能与原版存在差距。需要推动决策模型的开源生态和标准化接口。
(6)形式化安全验证。五层纵深防护的安全性目前是工程论证,需要发展针对神经符号系统的形式化验证方法,从数学上证明安全属性。
6.3 长期愿景
LAAP+Jev双系统范式的长期愿景是构建安全、可信、可进化的具身AGI——能够在物理世界中持续感知、决策、执行、学习,同时始终保持安全可控、可审计、可解释。这一愿景不是通过建造一个更大的模型实现,而是通过构建一个稳定的认知架构、搭配分工明确的专用模型、建立严格的安全体系来实现。正如人类智能不是单个脑区的产物,而是大脑多系统协同的结果,AGI也将是认知架构与多模型组件协同的产物。本文所提出的双系统范式,是通向这一愿景的一条在理论上自洽、在工程上可行的技术路线。
参考文献
[1] Vaswani A, Shazeer N, Parmar N, et al. Attention Is All You Need. NeurIPS, 2017.
[2] Devlin J, Chang M W, Lee K, et al. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL, 2019.
[3] Kahneman D. Thinking, Fast and Slow. Farrar, Straus and Giroux, 2011.
[4] Pearl J. Causality: Models, Reasoning and Inference. Cambridge University Press, 2nd ed., 2009.
[5] Pearl J, Mackenzie D. The Book of Why: The New Science of Cause and Effect. Basic Books, 2018.
[6] Friston K. The Free-Energy Principle: A Unified Brain Theory? Nature Reviews Neuroscience, 11(2):127-138, 2010.
[7] Baars B J. A Cognitive Theory of Consciousness. Cambridge University Press, 1988.
[8] Dehaene S, Changeux J P, Naccache L, et al. The Global Neuronal Workspace Model of Consciousness. Trends in Cognitive Sciences, 7(5):197-203, 2003.
[9] Dörner D, Bhatt S, Neubert C, et al. The Psi Theory of Motivation and Cognition. Cognitive Systems Research, 2003.
[10] Tononi G. Consciousness as Integrated Information: A Provisional Manifesto. Biological Bulletin, 215(3):216-242, 2008.
[11] TypeSafe. Introducing System One Jev: A New Class of Decision Models. TypeSafe Technical Blog, 2026.
[12] Brookes T, et al. Laya: An Open-Source Reference Implementation of Calibrated Decision Models. arXiv preprint, 2026.
[13] Gneiting T, Raftery A E. Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association, 102(477):359-378, 2007.
[14] Ouyang L, Wu J, Jiang X, et al. Training Language Models to Follow Instructions with Human Feedback (RLHF). NeurIPS, 2022.
[15] Uesato J, Kumar R, Cherepanov V, et al. Solving Math Word Problems with Process Reward Models (RLVR). NeurIPS, 2023.
[16] Rafailov R, Sharma A, Mitchell E, et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model (DPO). NeurIPS, 2023.
[17] Brohan A, Brown N, Carbajal J, et al. RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. CoRL, 2023.
[18] Lee K, Pertsch K, Wu Y, et al. OpenVLA: An Open-Source Vision-Language-Action Model. CoRL, 2024.
[19] Hafner D, Pasukonis J, Ba J, et al. Mastering Diverse Domains through World Models (DreamerV3). arXiv:2301.04104, 2023.
[20] Brooks T, Peebles W, Holmes C, et al. Sora: A Scaling World Model for Video Generation. OpenAI Technical Report, 2024.
[21] OpenAI. GPT-4V(ision) System Card & Computer Use. OpenAI Technical Report, 2024.
[22] Anthropic. Claude Computer Use: Agentic Computer Control. Anthropic Technical Report, 2024.
[23] Kadavath S, Conlen M, Heiner M, et al. Language Models (Mostly) Know What They Know. arXiv:2207.05221, 2022.
[24] Desai S, Durrett G. Calibration of Pre-trained Transformers. EMNLP, 2020.
[25] Guo C, Pleiss G, Sun Y, et al. On Calibration of Modern Neural Networks. ICML, 2017.
[26] Williams R J. Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning (REINFORCE). Machine Learning, 8(3-4):229-256, 1992.
[27] Spirtes P, Glymour C N, Scheines R. Causation, Prediction, and Search. MIT Press, 2nd ed., 2001.
[28] Shalev-Shwartz S, Shammah S, Shashua A. On a Formal Model of Safe and Scalable Self-driving Cars. arXiv:1708.06374, 2017.
[29] ISO 26262: Road Vehicles — Functional Safety. International Organization for Standardization, 2018.
[30] ISO 10218: Robots and Robotic Devices — Safety Requirements for Industrial Robots. International Organization for Standardization, 2011.
[31] Kaplun A, et al. Scaling Laws for Neural Language Models. arXiv:2001.08361, 2020.
[32] Radford A, et al. Learning Transferable Visual Models From Natural Language Supervision (CLIP). ICML, 2021.
[33] Zhai X, Mustafa B, Kolesnikov A, et al. Sigmoid Loss for Language Image Pre-Training (SigLIP). ICCV, 2023.
[34] Lewis M, Liu Y, Goyal N, et al. BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension. ACL, 2020.
[35] Touvron H, Lavril T, Izacard G, et al. LLaMA: Open and Efficient Foundation Language Models. arXiv:2302.13971, 2023.

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献9条内容

所有评论(0)