【生成式模型入门】(一):变分自编码器 VAE — 从 ELBO 推导到机器人轨迹生成
前言
- 上一期我们在【模仿学习+强化学习】BC+PPO:基于A* 专家行为克隆下的无地图雷达导航探索 提到过,当今比较火热的几个方向就有Diffusion相关的生成式模型,于是便有了本系列
- 本系列我们将从生成式模型的基础 VAE 开始,再到生成式模型的鼻祖 DDPM,再到 Diffusion Policy、Flow Matching 等一系列的算法解读与说明,我们会配合论文以及源码进行说明
- 本文将使用 LIBERO 机器人操作数据集,分别从轨迹重构、潜空间可视化、随机生成、潜空间插值四个方面验证 VAE
文章目录
1 生成式模型
1-1 什么是生成式模型
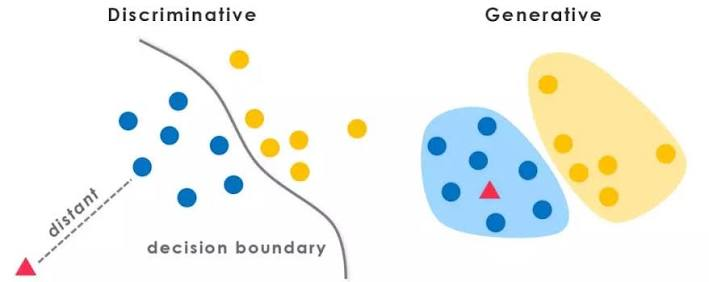
- 机器学习模型按建模对象可以分成两类,这个划分几乎决定了模型能做什么、不能做什么
- 判别模型(Discriminative Model)直接建模条件概率 p ( y ∣ x ) p(y\mid x) p(y∣x),输入 x x x 得到标签 y y y,它关心的是决策边界在哪
- 生成模型(Generative Model)建模数据本身的分布 p ( x ) p(x) p(x),它关心的是数据长什么样
- 两者的优化目标写成最大似然的形式,差别一目了然
判别模型: θ ⋆ = arg max θ ∑ i = 1 N log p θ ( y i ∣ x i ) \text{判别模型:} \quad \theta^\star = \arg\max_\theta \sum_{i=1}^{N} \log p_\theta(y_i \mid x_i) 判别模型:θ⋆=argθmaxi=1∑Nlogpθ(yi∣xi)
生成模型: θ ⋆ = arg max θ ∑ i = 1 N log p θ ( x i ) \text{生成模型:} \quad \theta^\star = \arg\max_\theta \sum_{i=1}^{N} \log p_\theta(x_i) 生成模型:θ⋆=argθmaxi=1∑Nlogpθ(xi)
- 一旦手里有了 p θ ( x ) p_\theta(x) pθ(x),"生成一个新样本"这件事就变成了从分布里采样
x new ∼ p θ ( x ) x_{\text{new}} \sim p_\theta(x) xnew∼pθ(x)
说人话:判别模型学的是"怎么把东西分开",生成模型学的是"东西本身长什么样"。学会后者之后,我们就能照着学到的那套"长相",造一个原来不存在的新样本出来。
- 这两个模型的能力差异,落到具体任务上非常直观
| 能力 | 判别模型 | 生成模型 |
|---|---|---|
| 分类 / 回归 | 支持,这是主场 | 需要绕道,通常不如判别模型直接 |
| 生成新样本 | 做不到 | 支持,这是主场 |
| 估计 p ( x ) p(x) p(x) | 不建模 | 支持 |
| 检测异常样本 | 要靠阈值凑 | 天然支持,低概率即异常 |
| 数据补全 / 去噪 | 要专门设计 | 天然支持,在条件分布下采样 |
- 我们这里的"生成"是概率意义上的生成,不是"复制训练集里的某一条"
- 一个只会在训练样本之间做插值、甚至直接背下训练集的模型,不能算学会了分布
- 判断标准是:从模型里采样出来的东西,放进真实数据里应当分辨不出来
1-2 核心思想
- 生成模型的核心思想只有一句话:用一个参数化的分布去逼近真实数据分布
- 真实数据分布 p data ( x ) p_{\text{data}}(x) pdata(x) 是未知的,我们手上只有从它里面抽出来的有限个样本 { x 1 , x 2 , … , x N } \{x_1, x_2, \dots, x_N\} {x1,x2,…,xN}
- 我们要构造一个带参数 θ \theta θ 的分布 p θ ( x ) p_\theta(x) pθ(x),让它在这些样本上"看起来"和 p data p_{\text{data}} pdata 一样
- "看起来一样"最常用的度量是最大似然(MLE,Maximum Likelihood Estimation)
θ ⋆ = arg max θ ∏ i = 1 N p θ ( x i ) = arg max θ ∑ i = 1 N log p θ ( x i ) \theta^\star = \arg\max_\theta \prod_{i=1}^{N} p_\theta(x_i) = \arg\max_\theta \sum_{i=1}^{N} \log p_\theta(x_i) θ⋆=argθmaxi=1∏Npθ(xi)=argθmaxi=1∑Nlogpθ(xi)
- 取对数不改变极值点,但把连乘变成连加,数值上稳定得多
- 条件生成把 p ( x ) p(x) p(x) 换成 p ( x ∣ c ) p(x\mid c) p(x∣c), c c c 是条件,可以是文本、图像、任务指令
θ ⋆ = arg max θ ∑ i = 1 N log p θ ( x i ∣ c i ) \theta^\star = \arg\max_\theta \sum_{i=1}^{N} \log p_\theta(x_i \mid c_i) θ⋆=argθmaxi=1∑Nlogpθ(xi∣ci)
- 举个例子:让模型根据任务指令
c
=
"把杯子放到盘子上"
c = \text{"把杯子放到盘子上"}
c="把杯子放到盘子上" 生成一段动作轨迹
x
x
x,建模的对象就是
p
(
x
∣
c
)
p(x \mid c)
p(x∣c)
- 难点在于 p θ ( x ) p_\theta(x) pθ(x) 必须是一个"合法的概率分布",它的积分为 1,这个约束并不好直接施加在神经网络上
说人话:为了构造这个参数化的分布,使用最大似然去衡量这个分布对真实样本的准确性,我们需要建模对象 p ( x ∣ c ) p(x \mid c) p(x∣c),而通常我们使用神经网络来处理这个问题,但是神经网络训练出来的 p ( x ∣ c ) p(x \mid c) p(x∣c) 可能不一定满足积分为 1,因此有了下面几个方法
- 各流派的分歧,全在于怎么表示 p θ ( x ) p_\theta(x) pθ(x)
| 路线 | 怎么表示 p θ ( x ) p_\theta(x) pθ(x) | 代表方法 |
|---|---|---|
| 隐变量模型 | 引入潜变量 z z z,对 z z z 积分得到 p ( x ) = ∫ p θ ( x ∣ z ) p ( z ) d z p(x) = \int p_\theta(x\mid z)p(z)\,dz p(x)=∫pθ(x∣z)p(z)dz | 变分自编码器 |
| 对抗博弈 | 不显式写 p θ ( x ) p_\theta(x) pθ(x),用一个判别器间接逼它 | 生成对抗网络 |
| 自回归分解 | 用链式法则拆成 p ( x ) = ∏ t p θ ( x t ∣ x < t ) p(x) = \prod_t p_\theta(x_t \mid x_{<t}) p(x)=∏tpθ(xt∣x<t) | 生成式预训练变换器 |
| 扩散去噪 | 学一个从噪声逐步还原数据的过程,反向过程即采样 | 去噪扩散概率模型 |
- 这一期我们走第一条路线,因为它最接近"概率"这两个字的字面含义,也最容易看清生成模型与自编码器的分界
1-3 常用的算法
- 生成模型的家族谱系大致如下
-
上面这张图同时也是缩写对照表,后文一律只用缩写,不再重复展开
-
这几个家族在"生成质量"、“训练稳定性”、"采样速度"三个维度上各有取舍
| 方法 | 生成质量 | 训练稳定性 | 采样速度 | 是否能算似然 |
|---|---|---|---|---|
| VAE | 偏模糊 | 稳定,单阶段 | 一次前向,极快 | 有下界 |
| GAN | 锐利 | 差,易崩 | 一次前向,极快 | 没有 |
| 自回归 | 高 | 稳定 | 逐 token,慢 | 精确 |
| DDPM | 最高 | 稳定 | 几十到上千步,慢 | 有下界 |
- 这一期的 VAE 在生成质量上确实不如后面的 DDPM,但它有两个别人替代不了的价值
- 它的潜空间是连续、可插值的,这一点在机器人领域比"图像清不清晰"重要得多
- 它的训练目标是可解释的,重构项与正则项各管一件事,出了问题能定位到是哪一项
- 换句话说,VAE 不是一个会被淘汰的过渡方案,它是后面所有隐变量生成模型的地基
1-4 生成式模型与VLA、具身智能
- VLA(Vision-Language-Action,视觉-语言-动作)模型要解决的是"看懂指令、看懂画面、输出动作"这一整条链路,其中输出动作那一段,本质上是一个生成问题
- 为什么不能把动作预测当成普通的回归问题?关键在动作分布是多峰的
- 举个例子:机械臂前方有一个障碍物,绕左边和绕右边都能完成任务
- 两条轨迹都是正确的,动作分布上就出现了两个峰
- 如果用 MSE(Mean Squared Error,均方误差)去训一个回归网络,模型会输出两峰之间的平均值
- 而平均值恰好是"从正中间撞上去",它不是任何一个峰,是一条根本不能执行的轨迹
- 这不是调参能解决的问题,是目标函数本身的性质:MSE 的极小值点是条件均值,而我们要的是分布的一个样本
| 动作建模方式 | 输出 | 多峰分布下的行为 |
|---|---|---|
| 确定性回归 + MSE | 单个动作 | 输出两峰平均,撞上障碍物 |
| 混合密度网络 | 若干高斯 | 能表达多峰,但峰数要预先定 |
| 隐变量生成模型(VAE) | 从一个潜变量解码 | 采样到哪个峰就执行哪个峰 |
| 扩散模型(Diffusion Policy) | 从噪声迭代去噪 | 采样到哪个峰就执行哪个峰 |
- 这正是 Diffusion Policy 这一类工作把"动作预测"重新表述成"条件生成"的原因
- 而要想真正读懂 Diffusion Policy 的损失函数、为什么它能采样、为什么潜空间/噪声空间是可插值的,最省事的入口就是 VAE
- 本期我们就用一套真实可跑的实验把这条路走一遍,选用的载体不是图像,而是机器人动作轨迹
- 数据用 LIBERO 数据集的 state / action,完全不使用视觉输入
- 把连续动作序列切成固定长度窗口,当成 VAE 的建模对象
- 用四个实验分别回答:能不能重构、潜空间有没有结构、能不能凭空采样、潜空间能不能插值
- 最后把动作再积分回笛卡尔空间,看看机械臂末端到底走出了什么形状
- 这四个实验合起来,回答一个问题:VAE 为什么是生成模型,而不是一个自编码器
2 AE
2-1 介绍
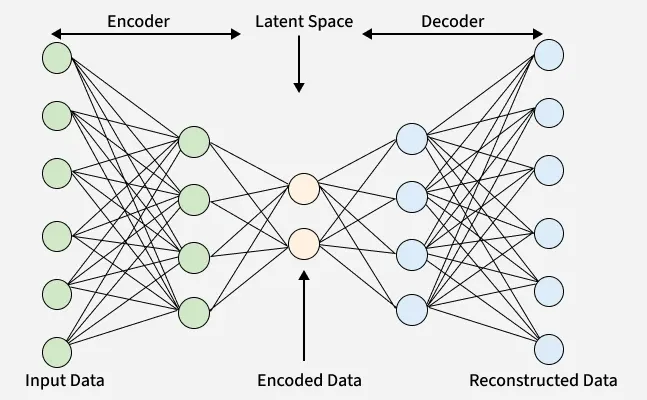
- AE(Autoencoder,自编码器)是最简单的一类"编码-解码"结构,它的目标非常朴素:让输出等于输入
说人话:AE 是两个网络拼起来的一台机器,编码器负责把数据压成一段摘要,解码器负责照着摘要把数据复原;训练时两个网络一起调,目标是复原出来的尽量贴合原来的数据。生成的时候只用得上解码器——给它一段摘要,它就吐出一条数据。
- 结构上由两部分组成,中间夹一个维度远小于输入的低维向量
z = f θ ( x ) , x ^ = g ϕ ( z ) z = f_\theta(x), \qquad \hat{x} = g_\phi(z) z=fθ(x),x^=gϕ(z)
- 以防你忘记:
- x x x:输入,比如一条 140 维的动作轨迹
- z z z:潜变量(latent variable),编码器输出的低维表示,比如 16 维
- x ^ \hat{x} x^:重构结果,维度与 x x x 相同
- f θ f_\theta fθ:编码器(Encoder),参数为 θ \theta θ
- g ϕ g_\phi gϕ:解码器(Decoder),参数为 ϕ \phi ϕ
- 训练目标就是让 x ^ \hat{x} x^ 尽量等于 x x x
min θ , ϕ ∑ i = 1 N ∥ x i − g ϕ ( f θ ( x i ) ) ∥ 2 \min_{\theta,\phi} \sum_{i=1}^{N} \lVert x_i - g_\phi(f_\theta(x_i)) \rVert^2 θ,ϕmini=1∑N∥xi−gϕ(fθ(xi))∥2
注意这里没有标签, x x x 自己既是输入又是监督信号,属于自监督学习
- 一个最小可跑的 AE,二十行就能写完
import numpy as np
import torch
import torch.nn as nn

# 先用一族正弦曲线合成 4000 条 (H=20, D=7) 的动作轨迹,
# 这样这一章的代码不依赖任何数据集,复制出去就能跑
rng = np.random.default_rng(0)
H, D, N = 20, 7, 4000
t = np.linspace(0, 1, H)[None, :, None]              # (1, H, 1)
amp = rng.uniform(0.3, 1.0, size=(N, 1, D))
freq = rng.uniform(1.0, 3.0, size=(N, 1, D))
phase = rng.uniform(0, 2 * np.pi, size=(N, 1, D))
traj = amp * np.sin(2 * np.pi * freq * t + phase)    # (N, H, D)

X = traj.reshape(N, -1).astype(np.float32)           # (N, 140),拉平
print(X.shape)                                       # (4000, 140)


class AE(nn.Module):
    def __init__(self, in_dim=140, hidden=64, latent=16):
        super().__init__()
        self.encoder = nn.Sequential(
            nn.Linear(in_dim, hidden), nn.ReLU(),
            nn.Linear(hidden, latent),                       # 压到 16 维
        )
        self.decoder = nn.Sequential(
            nn.Linear(latent, hidden), nn.ReLU(),
            nn.Linear(hidden, in_dim),                       # 还原回 140 维
        )

    def forward(self, x):
        z = self.encoder(x)
        return self.decoder(z), z


ae = AE()
opt = torch.optim.Adam(ae.parameters(), lr=1e-3)
xb = torch.from_numpy(X)

for step in range(2000):
    x_hat, _ = ae(xb)
    loss = nn.functional.mse_loss(x_hat, xb)
    opt.zero_grad(); loss.backward(); opt.step()
    if step % 500 == 0:
        print(f"step {step:4d}  mse {loss.item():.5f}")
- 上面
traj.reshape(N, -1)这一步就是后面反复出现的"拉平"操作,(N, 20, 7)变成(N, 140) - 反过来
x_hat.reshape(-1, H, D)就还原成"20 步、每步 7 维"的动作序列 - 反复用到的切片写法还有这几种,语义完全不同,别混
a = traj[0]              # (20, 7),一条完整的轨迹
a[:, :3]                 # (20, 3),每一步的前三维,即末端位移增量 dpos
a[:, 3:6]                # (20, 3),中间三维,即末端姿态增量 drot
a[:, 6]                  # (20,),最后一维,夹爪开合,切片后维度被压掉
a[:, 6:7]                # (20, 1),用冒号保住这一维,不压缩
a[0]                     # (7,),第 0 步的动作
a[:, 0]                  # (20,),所有步的第 0 维
- 注意
a[:, 6]与a[:, 6:7]的区别:前者把最后一维压掉了,形状从(20, 7)变成(20,),再想拼回去就得用a[:, None]补一维 - 这个坑在拼接多路特征时非常常见,后面第 3 章划分
mu与logvar时还会再遇到一次
说人话:AE 就是"先把东西压缩成一小段摘要,再照着摘要把它复述出来"。中间那段摘要就是潜变量,压缩得越狠,摘要里留下的就越只是最关键的骨架。
2-2 应用场景
- AE 本身很少作为最终产品,但它是很多实用方法的内核
| 场景 | 做法 | 依赖 AE 的哪一部分 |
|---|---|---|
| 数据压缩 | 只传潜变量,接收端解码 | 编码器 + 解码器 |
| 降维可视化 | 把潜变量降到二维画散点 | 只用编码器 |
| 去噪 | 输入加噪样本,监督信号用干净样本 | 编码器 + 解码器 |
| 异常检测 | 重构误差大的样本判为异常 | 重构误差本身 |
| 特征预训练 | 用编码器初始化下游网络 | 只用编码器 |
| 缺失补全 | 只对缺失位置算重构损失 | 重构损失的位置加权 |
- 在机器人领域,AE 最常见的用法是把高维观测压成低维状态,再用这个低维状态做控制或规划
- 但要注意:这种用法只用到编码器,用的是 AE 的降维能力,而不是生成能力
2-3 Encoder / Decoder
- 编码器把输入映射到潜空间,解码器把潜空间映射回输入空间
f θ : R d x → R d z , g ϕ : R d z → R d x f_\theta: \mathbb{R}^{d_x} \to \mathbb{R}^{d_z}, \qquad g_\phi: \mathbb{R}^{d_z} \to \mathbb{R}^{d_x} fθ:Rdx→Rdz,gϕ:Rdz→Rdx
- 在我们的轨迹任务里,
d
x
=
140
d_x = 140
dx=140,
d
z
=
16
d_z = 16
dz=16,压缩比接近 9 比 1
- 两个网络通常用对称的 MLP(Multi-Layer Perceptron,多层感知机),但不要求对称,可以各自独立设计
- 具体到代码,编码器与解码器都是两层线性加
ReLU(Rectified Linear Unit,修正线性单元)
- 有一处工程细节值得单独说:解码器的最后一层不加激活函数
- 因为动作是连续的、有正有负的实数,加了
ReLU会把负动作全部截成 0 - 编码器则相反,中间层必须加非线性,否则两层线性叠起来还是一个线性映射,压缩能力退化成 PCA(Principal Component Analysis,主成分分析)
- PCA我们在【玩转VLA具身智能机械臂】(四):点云分割与 OBB 夹取——从 PCA 失效到主动扫描 的
2-3提到过
- 因为动作是连续的、有正有负的实数,加了
# 对应对上文的 f_theta 与 g_phi
class Encoder(nn.Module):
    def __init__(self, in_dim=140, hidden=64, latent=16):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_dim, hidden), nn.ReLU(),        # 中间层必须有非线性
            nn.Linear(hidden, latent),
        )

    def forward(self, x):
        return self.net(x)


class Decoder(nn.Module):
    def __init__(self, latent=16, hidden=64, out_dim=140):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(latent, hidden), nn.ReLU(),
            nn.Linear(hidden, out_dim),                  # 最后一层不加激活
        )

    def forward(self, z):
        return self.net(z)
- 这里要强调一个容易被忽略的性质:AE 的编码是确定性的
- 同一个输入 x x x,无论编码多少次,得到的 z z z 一模一样,没有任何随机性
- 这个性质在第 2-7 节会变成 AE 生成能力的致命伤
2-4 Latent Space(潜空间)
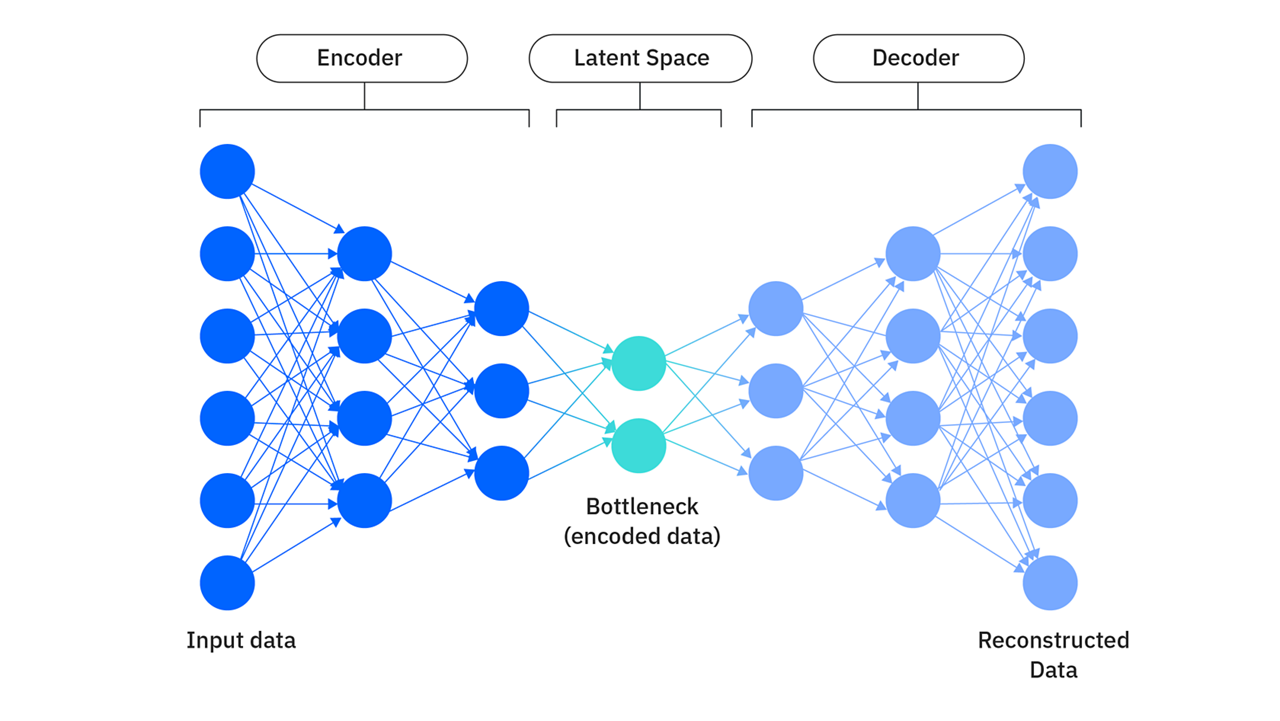
- 潜空间就是所有可能的 z z z 构成的 d z d_z dz 维空间,它是 AE 对数据的一种内部坐标系
- 为什么要在意它?因为生成模型的所有操作都在这个空间里发生
- 一个 16 维的
z我们没法直接看,但可以切出前两维画散点图,这是唯一能肉眼观察潜空间的手段
with torch.no_grad():
    Z = ae.encoder(xb).numpy()          # (4000, 16)

pca_x, pca_y = Z[:, 0], Z[:, 1]         # 切片取前两维,降成二维散点
# 更规范的做法是先做 PCA 再取前两维,见第 4 章的潜空间实验
- 切片的语义在这里很关键:
Z[:, 0]取的是所有样本的第 0 维,Z[0, :]取的是第 0 个样本的所有维- 前者是"某一维潜变量在数据集上的取值分布",后者是"某一条轨迹的潜编码",两个完全不同的东西
- 如果这 16 维里有一维对重构几乎没有贡献,它在潜空间里就会退化成一个常数,
Z[:, k]切出来是一条水平线
- 这个现象叫维度塌缩,第 3-9 节会看到它在 VAE 里同样存在,而且更隐蔽
说人话:潜空间就是 AE 给自己建的一套"坐标系"。原本 140 个数字描述一条轨迹,现在用 16 个数字描述,这 16 个数字就是这条轨迹在这套坐标系里的坐标。
2-5 Reconstruction Loss
- 最常用的重构损失是 MSE,也就是逐元素的平方误差求和
L recon = ∥ x − x ^ ∥ 2 = ∑ j = 1 d x ( x j − x ^ j ) 2 \mathcal{L}_{\text{recon}} = \lVert x - \hat{x} \rVert^2 = \sum_{j=1}^{d_x} (x_j - \hat{x}_j)^2 Lrecon=∥x−x^∥2=j=1∑dx(xj−x^j)2
- 它可以从概率角度解释:假设 p θ ( x ∣ z ) p_\theta(x \mid z) pθ(x∣z) 是各维独立的高斯分布,且方差固定,那么负对数似然就是 MSE
− log p θ ( x ∣ z ) = 1 2 σ 2 ∥ x − x ^ ∥ 2 + const -\log p_\theta(x \mid z) = \frac{1}{2\sigma^2}\lVert x - \hat{x}\rVert^2 + \text{const} −logpθ(x∣z)=2σ21∥x−x^∥2+const
- 也就是说,用 MSE 训 AE,等价于在做一个固定方差的高斯极大似然
- 如果数据是二值的,比如黑白像素,独立高斯的假设就不对了,应该换成 Bernoulli 分布,损失相应变成二元交叉熵
| 数据类型 | 似然假设 | 损失函数 | 常见用途 |
|---|---|---|---|
| 连续实数 | 高斯,方差固定 | MSE | 动作、坐标、图像回归 |
| 连续实数 | 高斯,方差可学 | 高斯负对数似然 | 需要模型自己权衡各维 |
| 二值 | Bernoulli | 二元交叉熵 | 黑白图像、掩码 |
| 计数 | Poisson | 泊松负对数似然 | 脉冲计数、点云点数 |
- 有一处细节必须说清楚:MSE 要在哪些维度上求平均、在哪些维度上求和,不是随意的
- 我们的实现是在 140 个输出维度上求和,再对 batch 求平均
# x_hat 与 x 的形状都是 (B, 140)
rec = nn.functional.mse_loss(x_hat, x, reduction="none").sum(dim=-1).mean()
#                                                        ^^^^^^^^^^^ 在 140 维上求和
#                                                                    ^^^^^^ 对 batch 求平均
- 之所以在 140 维上求和而不是求平均,是为了让两项损失的量纲可比(见第 3-7 节)
- 这里提前用到了 KL(Kullback-Leibler divergence,KL 散度)这一项,它的作用是把潜空间往先验上拉,具体推导在第 3-6 节
- 如果这里写成
.mean(dim=-1),重构项会被缩小 140 倍,正则项就会在整个损失里占据压倒性地位,模型直接塌缩
2-6 AE为什么可以降维
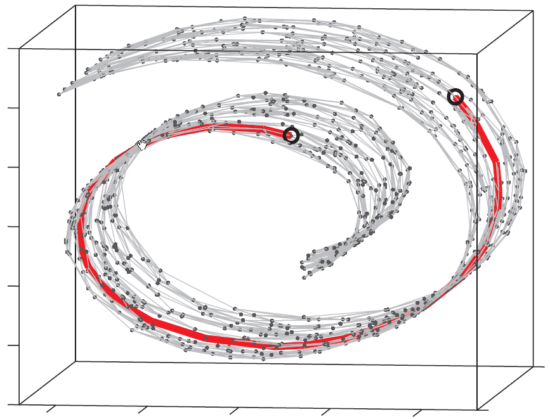
- 核心假设是流形假设:虽然数据住在 140 维空间里,但它们实际上只分布在一个低维曲面上
- 140 维空间里随便取一个点,几乎一定不是合法动作轨迹,因为相邻两步的动作必须连续、各维之间还有物理约束
- 真正合法的轨迹集合,其内在维度远小于 140
- 编码器的任务就是把这个低维曲面参数化,
z
z
z 是曲面上的一组合适坐标
- 在最简单的情形下,这个结论可以写得很干净
- 如果编码器和解码器都是线性的,并且用 MSE 训练,那么 AE 学到的子空间与 PCA 张成的子空间一致
- 设 Z = X W Z = XW Z=XW, W W W 是 d x × d z d_x \times d_z dx×dz 的投影矩阵
- 重构是 X ^ = Z W ⊤ = X W W ⊤ \hat{X} = ZW^\top = XWW^\top X^=ZW⊤=XWW⊤
- 最小化 ∥ X − X W W ⊤ ∥ F 2 \lVert X - XWW^\top\rVert_F^2 ∥X−XWW⊤∥F2 的解,正是取 X X X 的前 d z d_z dz 个主成分
- 这就解释了一件事:不做非线性的话,AE 就只是 PCA
- 反过来说,AE 相对 PCA 的全部优势,都来自中间那几层非线性激活
- 举个数:同样压到 16 维,线性 PCA 的重构
R
2
R^2
R2 是 0.957,非线性 AE 是 0.974,多出来的这 1.7 个点就是非线性的贡献
- 作为对照, β = 1 \beta = 1 β=1 的 VAE 只有 0.948,比 PCA 还低。这也正常:VAE 额外背着一项 KL,是拿重构精度去换潜空间的规整(第 3-7 节)
说人话:140 维听起来很大,但真正合法的动作轨迹只占其中很小很小的一块。AE 干的事就是找出这块"合法区域",然后用 16 个坐标把它标出来。
2-7 AE为什么不能很好地生成
2-7-1 分析
- 这是全篇最关键的一节,因为它解释了 VAE 存在的全部理由
- AE 的训练目标里,只有"让 x ^ \hat{x} x^ 接近 x x x"这一条,它从来没要求潜空间本身有什么形状
- 于是训练完之后,潜空间会变成一个很怪的样子
- 训练样本的编码点 z i z_i zi 密密麻麻地贴在某个曲面上
- 但这些点之间是空的,没有任何约束,解码器在那里没被训练过
- 更糟的是,这些点可能分布得极不均匀,有的区域挤成一团,有的区域稀稀拉拉
- 这带来一个直接后果:从潜空间随便采一个点解码,得到的多半是垃圾
2-7-2 验证
- 我们可以直接跑一段代码验证,用第 2-1 节训好的
ae
with torch.no_grad():
    z_rand = torch.randn(8, 16)                    # 直接按 N(0, I) 采样
    x_rand = ae.decoder(z_rand).numpy().reshape(8, H, D)

print("AE 采样的动作幅度  :", np.abs(x_rand).std())
print("真实数据的动作幅度  :", np.abs(traj).std())
- 在合成数据上跑这段代码,两个数字会差出一个量级,采样出来的"轨迹"要么幅度爆炸,要么塌成一条直线
- 原因很直白:AE 没有定义过
p
(
z
)
p(z)
p(z)
- 训练完之后,潜空间上的点确实有一个分布,但那是训练样本的编码点堆出来的经验分布
- 这个分布既没有解析形式,也没有被任何一项损失约束过
- 我们甚至不知道它是不是高斯的,更不知道它的均值和方差
- 所以 AE 想生成,只能退而求其次,去潜空间里插值,或者用训练集的编码点拟合一个分布再采样,两步走、还不可靠
- 还有一个隐性的问题:AE 的潜空间是不连续的
- 编码器是一般的非线性函数,它没有理由把相邻的 x x x 映射到相邻的 z z z
- 两个语义上很像的轨迹,编码点可能隔得很远;反过来,两个编码点很近,中间解码出来可能是完全无意义的动作
- 把这几条放在一起,AE 的三处硬伤就很清楚了
| 问题 | 具体表现 | 根因 |
|---|---|---|
| 没有先验 | 不知道该从哪里采样 | 损失里没有 p ( z ) p(z) p(z) 这一项 |
| 潜空间有空洞 | 采样点落在未训练区域,解码出垃圾 | 只约束了离散的编码点,没约束点与点之间 |
| 潜空间不连续 | 相邻 z z z 解码出的轨迹可能突变 | 编码器无平滑性约束 |
2-7-3 解决方法
- 那怎么办?思路很自然:给潜空间加约束,逼它长得像一个我们能采样的分布
- 最省事的选择就是标准正态分布 p ( z ) = N ( 0 , I ) p(z) = \mathcal{N}(0, I) p(z)=N(0,I),因为它好采样、有解析形式、还是各维独立的
- 但"加约束"具体怎么加?如果只是加一项 ∥ z ∥ 2 \lVert z \rVert^2 ∥z∥2 的正则,那还是只约束了单个点,点与点之间的空洞依然存在
- 真正的解法是把编码从"一个点"换成"一个分布",这就是 VAE
说人话:AE 把每条数据在潜空间里钉了一个钉子,但它不管钉子之间的空地。我们从空地上随便取一个点,解码器根本没见过这种输入,输出的自然是垃圾。VAE 要做的事,就是把这些钉子换成一片连续的"云雾",让整片区域都有定义。
3 VAE
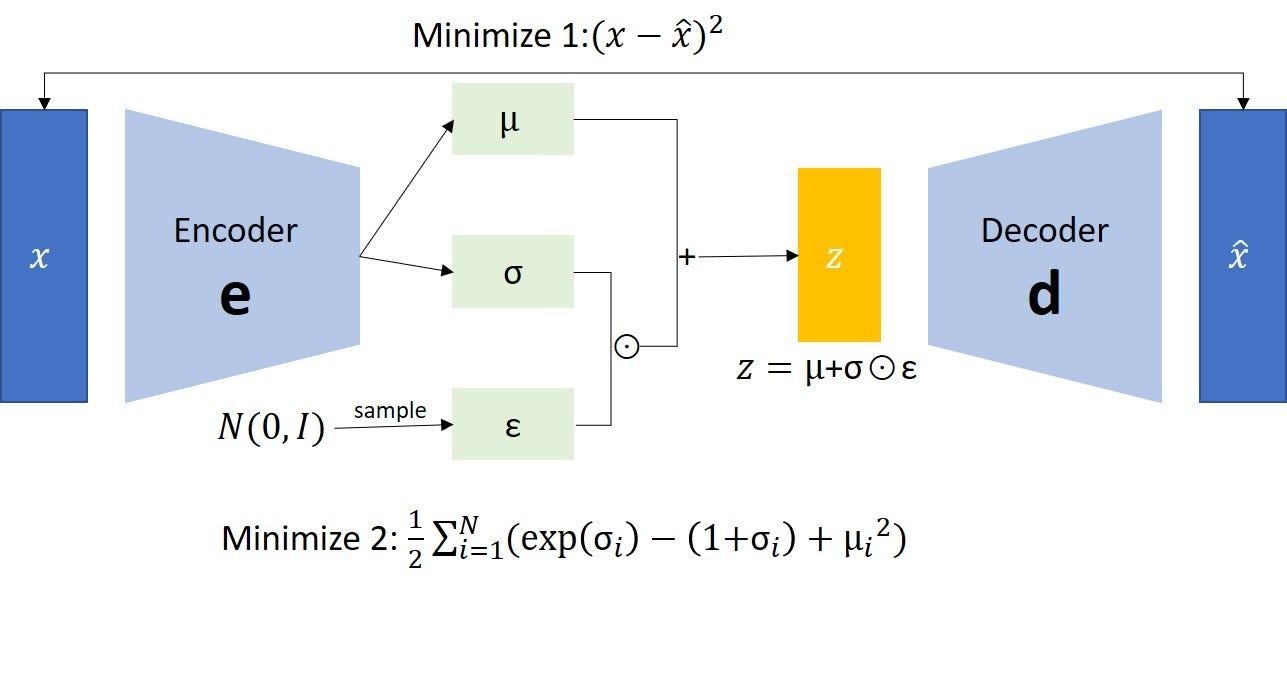
3-1 介绍
- VAE(Variational Autoencoder,变分自编码器)由 Kingma 与 Welling 在 2013 年提出,论文是 Auto-Encoding Variational Bayes
- 它要解决的就是上一节末尾留下的问题:让潜空间变成一个可以被采样的概率分布
一句话概括 VAE 与 AE 的区别:AE 把 x x x 编码成一个点,VAE 把 x x x 编码成一个分布
- 结构上的改动其实很小,只是编码器的输出从一路变成两路
- 但因为输出从"一个点"变成了"一个分布",整个模型的性质跟着变了
| 对比项 | AE | VAE |
|---|---|---|
| 编码器输出 | 一个确定的 z z z | 一个分布 q ϕ ( z ∣ x ) q_\phi(z\mid x) qϕ(z∣x),由 μ \mu μ 与 σ \sigma σ 给出 |
| 潜空间有先验吗 | 没有 | 有, p ( z ) = N ( 0 , I ) p(z) = \mathcal{N}(0, I) p(z)=N(0,I) |
| 损失函数 | 只有重构项 | 重构项 + KL 正则项(3-6 讲到) |
| 采样前向 | 编码器 | 编码器加采样 |
| 采样后向(生成) | 不可以 | 可以, z ∼ N ( 0 , I ) z \sim \mathcal{N}(0,I) z∼N(0,I) 直接解码 |
| 潜空间连续性 | 无保证 | 由 KL 项逼出来 |
| 是不是生成模型 | 不是 | 是 |
3-2 应用场景
- VAE 在工业界的落地场景比想象中多,因为它最大的优势是潜空间规整、可插值、可解释
| 场景 | 为什么用 VAE 而不是 AE |
|---|---|
| 人脸属性编辑 | 潜空间有语义方向,可以沿某个方向移动 |
| 分子生成 | 化学空间连续,插值出来的分子大多仍然合法 |
| 图像超分 / 修复 | 缺失区域可以从先验采样补全 |
| 语音转换 | 内容与音色可以在潜空间解耦 |
| 异常检测 | 用 ELBO 而不是重构误差,判别更稳 |
| 机器人技能学习 | 把一段演示压成技能潜变量,再用强化学习在这个低维空间里学 |
| 动作轨迹生成 | 与我们这一期做的事完全一致 |
- 在机器人领域,VAE 最典型的用法是把高维动作序列压成低维技能向量,也就是常说的"skill latent"
- 这么做的收益很直接:
- 强化学习要在动作空间里探索,维度越高越难;换成 16 维的 z z z 之后,探索空间一下小了两个数量级
- 解码器天然保证了输出的动作是连贯的轨迹,不会出现单步乱跳的情况
- 不同任务的轨迹在潜空间里是连续过渡的,意味着技能之间可以插值出中间技能
3-3 为什么需要概率潜变量
- 回到出发点,问一个问题:为什么非得是分布,给
z
z
z 加个正则不行吗?
- 答案是不行,原因在于"点"和"区域"的差别
- 一个确定性的 z z z 只定义了潜空间里的一个点,训练时也只有这些点被梯度触碰过
- 一个分布 q ϕ ( z ∣ x ) = N ( μ ϕ ( x ) , σ ϕ ( x ) 2 ) q_\phi(z\mid x) = \mathcal{N}(\mu_\phi(x), \sigma_\phi(x)^2) qϕ(z∣x)=N(μϕ(x),σϕ(x)2) 定义的是以 μ \mu μ 为中心、 σ \sigma σ 为半径的一整块区域
- 每一个训练样本,都在训练它周围的一整片区域,而不是一个孤立的点
说人话:我们需要数据之间的分布是有关联的,因此训练的时候最好一个点也会影响到周围的点,而不是只为了满足一个点去加正则(所谓正则,就是在损失函数里额外加一项惩罚,用来约束模型的行为,不让它只顾着拟合手上的数据)
- 这个差别带来三个直接后果
- 潜空间里不再有空洞,每个训练点的邻域都被它的 σ \sigma σ 覆盖到了
- 相邻的训练点如果 μ \mu μ 靠得近,它们的分布会互相重叠,重叠区域的解码结果被两边的样本同时约束,自然就平滑了
- 因为每个 x x x 都对应一片区域,我们可以从任意位置采样,采样出来的 z z z 大概率落在某个样本的覆盖范围里
- 再加一项约束,把全体编码分布都往标准正态上拉,整个潜空间就被"压"成了我们想要的样子(这一项就是 KL 散度,3-6 讲到)
L KL = D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) , p ( z ) = N ( 0 , I ) \mathcal{L}_{\text{KL}} = D_{KL}\big(q_\phi(z\mid x)\,\Vert\,p(z)\big), \qquad p(z) = \mathcal{N}(0, I) LKL=DKL(qϕ(z∣x)∥p(z)),p(z)=N(0,I)
- 注意这里的作用是双向的
- 它把每个 q ϕ ( z ∣ x ) q_\phi(z\mid x) qϕ(z∣x) 往先验上拉,逼潜空间填满先验所在的区域,而不是散成一堆孤岛
- 它也把先验往各个编码分布上拉,逼先验的每个角落都对应一个合法的解码结果
- 这就是 VAE 能采样的全部秘密:不是训练完之后碰巧能采样,而是损失函数里写明了要求它能采样
说人话:AE 只在潜空间里插了若干个孤立的钉子,钉子之间是空地。VAE 给每个钉子配了一个"势力范围",并规定所有势力范围加起来必须正好铺满整个潜空间。这样我们闭着眼睛随便点一个位置,都一定落在某个势力范围里,解码出来的东西才有意义。
3-4 μ、σ
- VAE 的编码器输出两路参数,分别描述这个正态分布的均值与方差
q ϕ ( z ∣ x ) = N ( z ; μ ϕ ( x ) , diag ( σ ϕ 2 ( x ) ) ) q_\phi(z\mid x) = \mathcal{N}\big(z; \mu_\phi(x), \operatorname{diag}(\sigma_\phi^2(x))\big) qϕ(z∣x)=N(z;μϕ(x),diag(σϕ2(x)))
- 协方差取对角阵,意思是各潜维度之间条件独立
- 全协方差需要 16 × 17 / 2 = 136 16 \times 17 / 2 = 136 16×17/2=136 个参数,而对角只需要 16 个
- 更重要的是,对角形式让 KL 散度有闭式解,不用做数值积分(3-6 讲到)
- 实践中编码器不是输出
σ
\sigma
σ,而是输出
log
σ
2
\log \sigma^2
logσ2,也就是
logvar,原因是数值稳定性-
σ
\sigma
σ 必须为正,直接让网络输出
σ
\sigma
σ 就得额外加约束,比如
softplus或者取绝对值 - 而 log σ 2 \log \sigma^2 logσ2 的取值范围是整个实数轴,网络可以无约束地输出,取指数之后自动为正
- 顺便还把乘法变成了加法,梯度尺度更友好
-
σ
\sigma
σ 必须为正,直接让网络输出
σ
\sigma
σ 就得额外加约束,比如
- 这里终于用上了第 2-1 节提到的那个切片坑,划分两路输出的标准写法是
# 方案一:两个独立的全连接层,推荐,两路的初始化互不干扰
mu = self.fc_mu(h)           # (B, 16)
logvar = self.fc_logvar(h)   # (B, 16)

# 方案二:一个 32 维输出,再用切片劈成两半
h2 = self.fc_head(h)         # (B, 32)
mu, logvar = h2[:, :16], h2[:, 16:]     # 切片的经典用法

# 反例:把中间维度压掉了,形状从 (B, 16) 变成 (B,)
mu, logvar = h2[:, 15], h2[:, 31]       # 错误:只剩最后一列,信息全丢
- 切片
h2[:, :16]的含义是"所有样本的前 16 维",h2[:, 16:]是"所有样本的后 16 维",正好对应两路输出 - 这个写法在本项目的实现里没有采用,用的是方案一,但两者完全等价
- 还要注意初始化的一个细节:
fc_logvar的偏置最好初始化成 0 甚至略小于 0- 如果初始
logvar太大, σ \sigma σ 很大,后验一开始就退化成先验,KL 项直接是 0,梯度消失 - 这个现象就是后验塌缩的早期形态,训练一开始就掉进去,后面很难救回来
- 如果初始
- 把两路输出代进 KL 的闭式解,就是 VAE 损失里的正则项,推导见第 3-6 节
3-5 Reparameterization Trick
3-5-1 问题分析
- 有了 μ \mu μ 和 σ \sigma σ,理论上就可以从 q ϕ ( z ∣ x ) q_\phi(z\mid x) qϕ(z∣x) 里采样了: z ∼ N ( μ , σ 2 ) z \sim \mathcal{N}(\mu, \sigma^2) z∼N(μ,σ2)
- 但这一采样,整个网络就没法训练了
- 原因在于采样这个操作本身是随机的,无法反向传播
- 前向: x x x 经过编码器得到 μ , σ \mu, \sigma μ,σ,采样得到 z z z,解码得到 x ^ \hat{x} x^,算出损失
- 反向:损失对解码器参数的梯度没问题;但损失对 μ \mu μ 和 σ \sigma σ 的梯度要经过 z z z
- 而 z z z 是从分布里抽出来的,抽签这个动作的导数是 0,梯度到 z z z 就断了
3-5-2 重参数化技巧
- 重参数化技巧(Reparameterization Trick)用一个恒等变形解决这个问题
- 关键观察是:如果 z ∼ N ( μ , σ 2 ) z \sim \mathcal{N}(\mu, \sigma^2) z∼N(μ,σ2),那么它可以等价地写成
z = μ + σ ⊙ ε , ε ∼ N ( 0 , I ) z = \mu + \sigma \odot \varepsilon, \qquad \varepsilon \sim \mathcal{N}(0, I) z=μ+σ⊙ε,ε∼N(0,I)
- 以防你忘记:
- μ \mu μ:编码器输出的均值,形状 ( B , 16 ) (B, 16) (B,16)
- σ \sigma σ:编码器输出的标准差,由 log σ 2 \log \sigma^2 logσ2 取指数再开方得到
- ε \varepsilon ε:标准正态噪声,与 μ \mu μ 同形状,这一步才是有随机性的地方
- ⊙ \odot ⊙:逐元素相乘
- 变形之后,随机性被移到了 ε \varepsilon ε 上,而 ε \varepsilon ε 与参数 θ , ϕ \theta, \phi θ,ϕ 无关
- 于是 z z z 变成了 μ \mu μ 和 σ \sigma σ 的确定性函数,梯度可以正常回传
∇ ϕ E q ϕ ( z ∣ x ) [ f ( z ) ] = E ε ∼ N ( 0 , I ) [ ∇ ϕ f ( μ ϕ ( x ) + σ ϕ ( x ) ⊙ ε ) ] \nabla_\phi \mathbb{E}_{q_\phi(z\mid x)}\big[f(z)\big] = \mathbb{E}_{\varepsilon \sim \mathcal{N}(0,I)}\Big[\nabla_\phi f\big(\mu_\phi(x) + \sigma_\phi(x) \odot \varepsilon\big)\Big] ∇ϕEqϕ(z∣x)[f(z)]=Eε∼N(0,I)[∇ϕf(μϕ(x)+σϕ(x)⊙ε)]
- 这个式子值得多看一眼:左边要对一个依赖
ϕ
\phi
ϕ 的分布求期望的梯度,右边只对一个固定分布求期望的梯度
- 右边可以直接用单次采样估计,而且是无偏的,这就是 VAE 能端到端训练的原因
- 代码只有三行
def reparameterize(self, mu, logvar):
    std = torch.exp(0.5 * logvar)     # sigma = exp(0.5 * log(sigma^2))
    eps = torch.randn_like(std)       # eps ~ N(0, I),随机性全在这里
    return mu + std * eps             # 逐元素相乘,形状 (B, 16)
- 有一处细节容易写错:
std是 exp ( 0.5 × logvar ) \exp(0.5 \times \text{logvar}) exp(0.5×logvar)- 因为
logvar存的是 log σ 2 \log \sigma^2 logσ2,要得到 σ \sigma σ 得先除以 2 再取指数 - 写成
torch.exp(logvar)得到的是 σ 2 \sigma^2 σ2,尺度就错了,训练初期就会出现很大的方差
- 因为
- 还有一处:这里的加法和乘法都是逐元素的,
mu、std、eps三者形状完全相同,都是(B, 16) - 不需要任何广播,也不该有
mu[:, None]这类补维操作,看到就说明形状设计错了 - 采样的时候用
torch.randn_like(std)而不是torch.randn(std.shape),前者自动继承设备与数据类型,写 CUDA 代码时不会踩到设备不一致的坑
说人话:本来要"抽一个签",抽签这个动作没法求导。重参数化把抽签改写成"固定抽一个标准正态的数,再拿它去乘、去加"。乘和加都能求导,梯度就通了。
-
至此,我们使用编码器输出 μ \mu μ、 σ \sigma σ 去描述一个正态分布,同时引入参数 ε \varepsilon ε 来对采样这一操作进行参数化,保证了采样这一过程能够顺利使用梯度进行反向传播
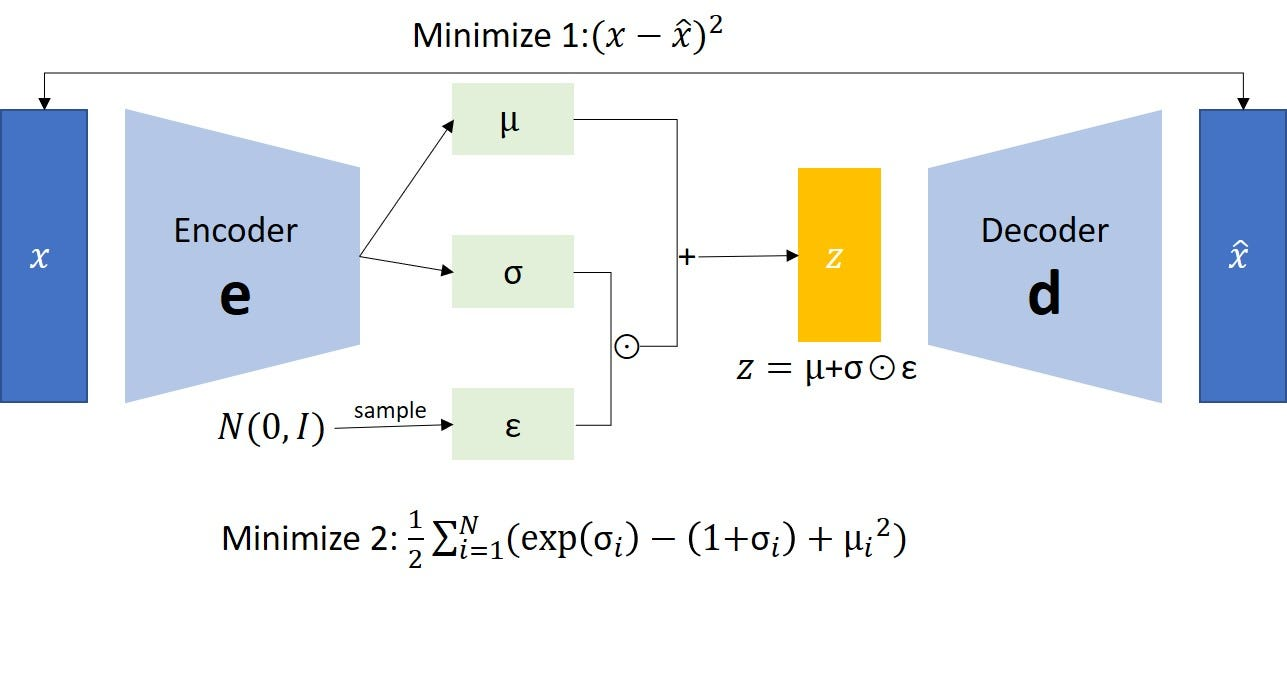
-
接下来,我们需要对解码的分布进行评估,而 KL 散度正是这个损失里的一项
3-6 KL Divergence
3-6-1 定义
- KL 散度衡量两个分布的差异,定义是
D K L ( q ( z ) ∥ p ( z ) ) = ∫ q ( z ) log q ( z ) p ( z ) d z D_{KL}\big(q(z)\,\Vert\,p(z)\big) = \int q(z) \log \frac{q(z)}{p(z)}\, dz DKL(q(z)∥p(z))=∫q(z)logp(z)q(z)dz
- 它有三个性质要记住
- 非负,当且仅当两个分布几乎处处相等时取 0,这是 Gibbs 不等式
- 不对称, D K L ( q ∥ p ) ≠ D K L ( p ∥ q ) D_{KL}(q \Vert p) \ne D_{KL}(p \Vert q) DKL(q∥p)=DKL(p∥q),所以它不是距离
- 可以理解成"用 p p p 去编码来自 q q q 的样本时,平均多付出的信息量"
在 VAE 里,我们要算的是对角高斯 q = N ( μ , diag ( σ 2 ) ) q = \mathcal{N}(\mu, \operatorname{diag}(\sigma^2)) q=N(μ,diag(σ2)) 与标准正态 p = N ( 0 , I ) p = \mathcal{N}(0, I) p=N(0,I) 之间的 KL
3-6-2 求解
- 这个 KL 有闭式解(所谓闭式解,就是能把结果写成一行只含加减乘除、平方、对数这类基本运算的公式,把 μ \mu μ、 σ \sigma σ 代进去直接算出数,不用真的去积那个分),不用做积分
D K L ( N ( μ , σ 2 ) ∥ N ( 0 , I ) ) = 1 2 ∑ j = 1 L ( μ j 2 + σ j 2 − log σ j 2 − 1 ) D_{KL}\big(\mathcal{N}(\mu, \sigma^2)\,\Vert\,\mathcal{N}(0, I)\big) = \frac{1}{2}\sum_{j=1}^{L}\Big(\mu_j^2 + \sigma_j^2 - \log \sigma_j^2 - 1\Big) DKL(N(μ,σ2)∥N(0,I))=21j=1∑L(μj2+σj2−logσj2−1)
- 这个式子可以一项一项读
- μ j 2 \mu_j^2 μj2:均值偏离 0 就要付代价,把编码分布往原点拉
- σ j 2 \sigma_j^2 σj2:方差比 1 大要付代价,防止编码分布摊得太开
- − log σ j 2 -\log \sigma_j^2 −logσj2:方差比 1 小也要付代价,防止编码分布缩成一个尖峰
- − 1 -1 −1:常数,保证当 μ j = 0 , σ j = 1 \mu_j = 0, \sigma_j = 1 μj=0,σj=1 时整个括号正好为 0
- 后两项目一起,就是"方差必须接近 1"的软约束,一个负责压、一个负责撑,两边都不让它跑
- 换成
logvar的写法,代码就一行
# 逐样本、逐维度计算,形状 (B, L)
kl_per_sample = -0.5 * (1 + logvar - mu.pow(2) - logvar.exp())

# 在 L 个潜维度上求和,再对 batch 求平均,得到标量
kld = kl_per_sample.sum(dim=-1).mean()
- 注意
dim=-1是潜维度,.mean()才是 batch 维度,两个方向不能搞反 - 保留逐维度的结果很有用,它直接告诉我们哪些潜维度被真正用上了,第 3-9 节要用
K L sample = E x [ D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) ] KL_{\text{sample}} = \mathbb{E}_x\Big[D_{KL}\big(q_\phi(z\mid x)\,\Vert\,p(z)\big)\Big] KLsample=Ex[DKL(qϕ(z∣x)∥p(z))]
- 这个量就是损失里的那一项,它的含义是"平均而言,每个样本的后验离先验有多远"
- 如果一个维度的 K L sample KL_{\text{sample}} KLsample 掉到 0,说明这个维度对任何输入都输出 μ ≈ 0 , σ ≈ 1 \mu \approx 0, \sigma \approx 1 μ≈0,σ≈1
- 也就是后验等于先验,解码器从这一维拿不到任何关于 x x x 的信息,这一维塌缩了
- 所以 K L sample KL_{\text{sample}} KLsample 是判断维度是否塌缩的标准,这个判据在后面的实验中会反复用到
3-7 VAE Loss
3-7-1 定义
- 把重构项和 KL 项拼起来,就是 VAE 的损失,也就是负的 ELBO(
3-8拆解这个名字)
L VAE = ∥ x − x ^ ∥ 2 ⏟ 重构项 + β ⋅ D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) ⏟ 正则项 \mathcal{L}_{\text{VAE}} = \underbrace{\lVert x - \hat{x} \rVert^2}_{\text{重构项}} + \beta \cdot \underbrace{D_{KL}\big(q_\phi(z\mid x)\,\Vert\,p(z)\big)}_{\text{正则项}} LVAE=重构项 ∥x−x^∥2+β⋅正则项 DKL(qϕ(z∣x)∥p(z))
- β \beta β 是 KL 项的权重, β = 1 \beta = 1 β=1 时就是标准的 VAE 目标,这个形式叫 β \beta β-VAE
- 两项分别管两件事,方向恰好相反
| 项 | 想干什么 | 如果把它去掉 |
|---|---|---|
| 重构项 | 让输出尽量还原输入 | 解码器收不到信息,输出常数 |
| KL 项 | 让潜空间长得像标准正态 | 退化成普通 AE,潜空间散开、没法采样 |
- 这两项是在互相拉扯,这也是 VAE 生成结果偏模糊的根本原因
- 重构项希望 σ \sigma σ 越小越好,最好趋近于 0,这样 z z z 就退化成确定值,重构最精确
- KL 项希望 σ \sigma σ 接近 1、 μ \mu μ 接近 0,这样才能填满先验
- 最终的 σ \sigma σ 是两者妥协的结果,于是潜变量里残留了噪声,解码出来就带一点模糊
说人话:回到一开始的问题,我们需要用 VAE 对数据的分布进行估计,同时要让这个潜空间分布长得像标准正态(也就是用 KL 散度去约束),因此损失里除了要求数据还原得像(重构项),还要要求这个分布有多像标准正态(正则项)
3-7-2 重构项权衡量纲
- 用 MSE 做重构时,这两项的量纲需要手动平衡,所以"在哪些维度上求和"这件事很关键
- 我们的实现里,重构项在 140 个输出维度上求和,KL 项在 16 个潜维度上求和
- 两边都是"求和",量级可比, β = 1 \beta = 1 β=1 就是一个合理的起点
- 如果重构项按维度求了平均,KL 项就相对放大了 140 倍,模型会直接塌缩
- 实现上,两个损失项必须分开返回,因为它们的含义完全不同
def loss(self, x, beta=1.0):
    x_hat, mu, logvar, _ = self(x)   # forward 返回四元组,最后一个用不上

    # 重构项:在 140 个输出维度上求和,再对 batch 求平均
    rec = nn.functional.mse_loss(x_hat, x, reduction="none").sum(dim=-1).mean()

    # KL 项:闭式解,在 16 个潜维度上求和,再对 batch 求平均
    kld = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp(), dim=-1).mean()

    # 返回三个值:总损失用于反向传播,后两个用于监控
    return rec + beta * kld, rec, kld
- 训练时把
rec和kld分别记录下来,这一点非常重要- 只看总损失,我们无法判断模型是"重构变差了"还是"潜空间变规整了"
- 这两件事的诊断方法和处理手段完全不同
- 本项目的训练日志里
val_recon与val_kld是分开打印的,就是为了这个
3-8 ELBO
3-8-1 解释
- 上一节那个损失是直接给出来的,这一节回答的是:凭什么一定是这两项,而不是别的
- 起点是我们真正想最大化的东西:数据对数似然 log p θ ( x ) \log p_\theta(x) logpθ(x)
- ELBO(Evidence Lower Bound,证据下界)这个名字里有"证据"和"下界"两半
- "证据"是 log p θ ( x ) \log p_\theta(x) logpθ(x) 的另一个叫法,来自贝叶斯模型比较里的 marginal likelihood
- "下界"是说 ELBO 永远不超过 log p θ ( x ) \log p_\theta(x) logpθ(x),严格证明放在 3-8-3
- 推导只有三步:把 z z z 积分进去、用 Jensen 不等式、把期望拆成两部分,而第三步拆出来的恰好就是第 3-7 节那两项
3-8-2 推导
- 把隐变量 z z z 积分进去,再用一个技巧:乘一个 q ϕ ( z ∣ x ) q_\phi(z\mid x) qϕ(z∣x) 再除掉它,值不变
log p θ ( x ) = log ∫ p θ ( x ∣ z ) p ( z ) d z = log E q ϕ ( z ∣ x ) [ p θ ( x ∣ z ) p ( z ) q ϕ ( z ∣ x ) ] \log p_\theta(x) = \log \int p_\theta(x\mid z) p(z)\, dz = \log \mathbb{E}_{q_\phi(z\mid x)}\left[\frac{p_\theta(x\mid z)\, p(z)}{q_\phi(z\mid x)}\right] logpθ(x)=log∫pθ(x∣z)p(z)dz=logEqϕ(z∣x)[qϕ(z∣x)pθ(x∣z)p(z)]
- 第二步用 Jensen 不等式。 log \log log 是凹函数,所以 log E [ ⋅ ] ≥ E [ log ⋅ ] \log \mathbb{E}[\cdot] \ge \mathbb{E}[\log \cdot] logE[⋅]≥E[log⋅]
log p θ ( x ) ≥ E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) p ( z ) q ϕ ( z ∣ x ) ] \log p_\theta(x) \ge \mathbb{E}_{q_\phi(z\mid x)}\left[\log \frac{p_\theta(x\mid z)\, p(z)}{q_\phi(z\mid x)}\right] logpθ(x)≥Eqϕ(z∣x)[logqϕ(z∣x)pθ(x∣z)p(z)]
- 第三步把右边的期望拆开。对数里是一个商,可以拆成两项之和:
log
p
θ
(
x
∣
z
)
p
(
z
)
q
ϕ
(
z
∣
x
)
=
log
p
θ
(
x
∣
z
)
+
log
p
(
z
)
q
ϕ
(
z
∣
x
)
\log\frac{p_\theta(x\mid z)\, p(z)}{q_\phi(z\mid x)} = \log p_\theta(x\mid z) + \log\frac{p(z)}{q_\phi(z\mid x)}
logqϕ(z∣x)pθ(x∣z)p(z)=logpθ(x∣z)+logqϕ(z∣x)p(z)
- 前一半 E q [ log p θ ( x ∣ z ) ] \mathbb{E}_{q}\big[\log p_\theta(x\mid z)\big] Eq[logpθ(x∣z)] 就是重构项
- 后一半 E q [ log p ( z ) q ϕ ( z ∣ x ) ] \mathbb{E}_{q}\big[\log\frac{p(z)}{q_\phi(z\mid x)}\big] Eq[logqϕ(z∣x)p(z)] 按 3-6 的定义就是 − D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) -D_{KL}\big(q_\phi(z\mid x)\,\Vert\,p(z)\big) −DKL(qϕ(z∣x)∥p(z)),也就是正则项
- 两项不是拼上去的,是这一个期望天然分成的两半,这就是 ELBO 的标准形式
L ELBO = E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] − D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) \mathcal{L}_{\text{ELBO}} = \mathbb{E}_{q_\phi(z\mid x)}\big[\log p_\theta(x\mid z)\big] - D_{KL}\big(q_\phi(z\mid x)\,\Vert\,p(z)\big) LELBO=Eqϕ(z∣x)[logpθ(x∣z)]−DKL(qϕ(z∣x)∥p(z))
- 这两项和第 3-7 节的损失是逐项对上的
- 第一项 E q [ log p θ ( x ∣ z ) ] \mathbb{E}_{q}\big[\log p_\theta(x\mid z)\big] Eq[logpθ(x∣z)] 是重构项: p θ ( x ∣ z ) p_\theta(x\mid z) pθ(x∣z) 取方差固定的高斯时,它的对数似然就是负的 MSE(2-5 讲过),最大化这一项等于最小化 ∥ x − x ^ ∥ 2 \lVert x - \hat{x}\rVert^2 ∥x−x^∥2
- 第二项 − D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) -D_{KL}\big(q_\phi(z\mid x)\,\Vert\,p(z)\big) −DKL(qϕ(z∣x)∥p(z)) 是正则项:负号来自上一步拆分时的 log p ( z ) q ϕ ( z ∣ x ) \log\frac{p(z)}{q_\phi(z\mid x)} logqϕ(z∣x)p(z),它的闭式解正是 3-6 算过的那一个
- 把最大化 ELBO 翻成最小化负 ELBO,就得到第 3-7 节那个损失函数
3-8-3 “下界”
- 3-8-1 里"下界"那半句,这里补一个严格证明
- 可以精确地算出 log p θ ( x ) \log p_\theta(x) logpθ(x) 与 ELBO 之间的差距
log p θ ( x ) − L ELBO = D K L ( q ϕ ( z ∣ x ) ∥ p θ ( z ∣ x ) ) ≥ 0 \log p_\theta(x) - \mathcal{L}_{\text{ELBO}} = D_{KL}\big(q_\phi(z\mid x)\,\Vert\,p_\theta(z\mid x)\big) \ge 0 logpθ(x)−LELBO=DKL(qϕ(z∣x)∥pθ(z∣x))≥0
-
因为 KL 散度非负,所以 ELBO 永远不超过 log p θ ( x ) \log p_\theta(x) logpθ(x),它是下界
-
差距那一项是真实后验 p θ ( z ∣ x ) p_\theta(z\mid x) pθ(z∣x) 与我们的近似后验 q ϕ ( z ∣ x ) q_\phi(z\mid x) qϕ(z∣x) 之间的距离
-
这个式子解释了两件事
- 我们想让 ELBO 尽量大,同时也就想让 q ϕ q_\phi qϕ 尽量接近真实后验,两个目标是一致的
- 真实后验 p θ ( z ∣ x ) = p θ ( x ∣ z ) p ( z ) / p θ ( x ) p_\theta(z\mid x) = p_\theta(x\mid z)p(z) / p_\theta(x) pθ(z∣x)=pθ(x∣z)p(z)/pθ(x) 里的分母 p θ ( x ) p_\theta(x) pθ(x) 要积分才能算,这正是它不可解、必须做变分近似的原因,也是"变分"两个字的出处
-
两项的分工可以再总结一遍
| 项 | 数学形式 | 等价于 | 作用 |
|---|---|---|---|
| 重构项 | E q [ log p θ ( x ∣ z ) ] \mathbb{E}_{q}[\log p_\theta(x\mid z)] Eq[logpθ(x∣z)] | 最小化 MSE | 让解码器能还原输入 |
| 正则项 | − D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) -D_{KL}(q_\phi(z\mid x) \Vert p(z)) −DKL(qϕ(z∣x)∥p(z)) | 最小化到先验的 KL | 让潜空间规整、可采样 |
说人话:ELBO 是一个"够得着的目标"。我们真正想最大化的 log p ( x ) \log p(x) logp(x) 算不出来,但可以证明有一个值永远不超过它,而且这个值能算、能求导。那就先把这个值推到最高, log p ( x ) \log p(x) logp(x) 也就跟着被顶上去了。
3-9 为什么 VAE 可以采样生成
- 到这里可以正面回答第 2-7 节那个问题了
- VAE 能采样,靠的不是训练完之后碰巧发现潜空间很规整,而是损失函数里就写了一项逼它规整
3-9-1 采样
- 采样时我们完全不看输入,直接从先验抽
z
∼
p
(
z
)
=
N
(
0
,
I
)
,
x
^
=
g
ϕ
(
z
)
z \sim p(z) = \mathcal{N}(0, I), \qquad \hat{x} = g_\phi(z)
z∼p(z)=N(0,I),x^=gϕ(z)
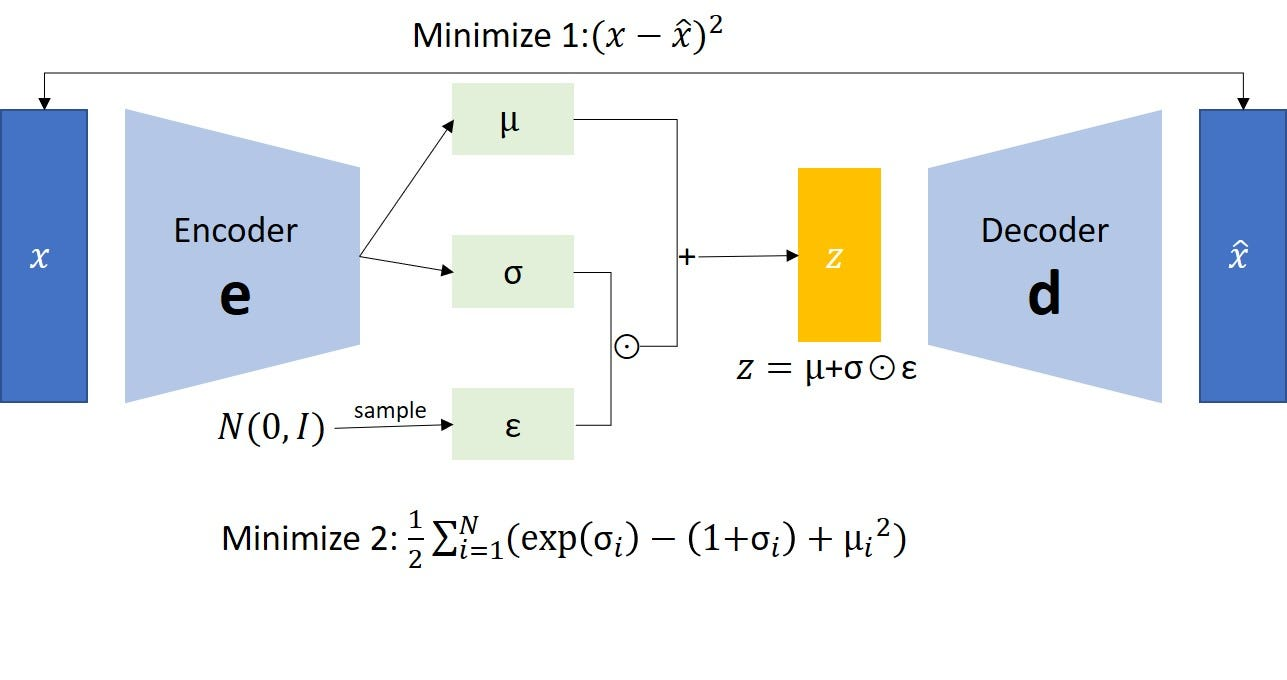
说人话:从结构图来看, ε \varepsilon ε 是直接从 N ( 0 , I ) \mathcal{N}(0, I) N(0,I) 里抽出来的,抽出来的数与输入数据无关,再和 μ \mu μ、 σ \sigma σ 组合成 z z z
- 代码就一行,注意这里没有编码器参与
@torch.no_grad()
def sample(self, n):
    z = torch.randn(n, 16)      # 直接从先验采样,与任何输入无关
    return self.decoder(z)      # 解码即生成
3-9-2 分析-聚合后验
- 为什么这么采样是合法的?因为 KL 项的作用是把聚合后验推向先验
- 聚合后验(aggregate posterior)的定义是,把数据集里所有样本的后验平均起来
q ( z ) = 1 N ∑ i = 1 N q ϕ ( z ∣ x i ) = 1 N ∑ i = 1 N N ( μ i , σ i 2 ) q(z) = \frac{1}{N}\sum_{i=1}^{N} q_\phi(z\mid x_i) = \frac{1}{N}\sum_{i=1}^{N} \mathcal{N}\big(\mu_i, \sigma_i^2\big) q(z)=N1i=1∑Nqϕ(z∣xi)=N1i=1∑NN(μi,σi2)
- 它描述的才是"从数据集里随便挑一条轨迹,它的编码在潜空间里落在哪"
- 采样时我们抽的是 z ∼ p ( z ) z \sim p(z) z∼p(z),解码器见到的输入分布是 p ( z ) p(z) p(z),而训练时它见到的输入分布是 q ( z ) q(z) q(z)
- 这两个分布一致,采样才有效。KL 项正是在做这件事
说人话:之所以能脱离原数据、直接从 N ( 0 , I ) \mathcal{N}(0, I) N(0,I) 里采样,是因为损失里 KL 散度那一项在训练时不停地把每条轨迹的后验往 N ( 0 , I ) \mathcal{N}(0, I) N(0,I) 上拽;所有轨迹一起被拽,聚合起来的那团编码也就贴上了标准正态,于是生成时随便抽一个 z z z,解码器见到的仍是自己熟悉的区域,出来的才是一条像样的轨迹
- 注意 q ( z ) q(z) q(z) 是一个高斯混合,不是单个高斯,算它的方差要按全方差公式分成两项
E [ z ] = 1 N ∑ i = 1 N μ i , Var [ z ] = 1 N ∑ i = 1 N σ i 2 ⏟ 组内方差 + 1 N ∑ i = 1 N ( μ i − μ ˉ ) 2 ⏟ 组间方差 \mathbb{E}[z] = \frac{1}{N}\sum_{i=1}^{N} \mu_i, \qquad \operatorname{Var}[z] = \underbrace{\frac{1}{N}\sum_{i=1}^{N} \sigma_i^2}_{\text{组内方差}} + \underbrace{\frac{1}{N}\sum_{i=1}^{N} \big(\mu_i - \bar{\mu}\big)^2}_{\text{组间方差}} E[z]=N1i=1∑Nμi,Var[z]=组内方差 N1i=1∑Nσi2+组间方差 N1i=1∑N(μi−μˉ)2
- 两项缺一不可
- 组内方差:每个样本自己的 σ i 2 \sigma_i^2 σi2 求平均
- 组间方差:各样本均值 μ i \mu_i μi 之间的离散程度
3-9-3 逐样本 KL 与聚合后验 KL
- 最后要说清楚一个最容易混淆的点:逐样本 KL 与聚合后验 KL,回答的是两个不同的问题
| 记号 | 定义 | 回答的问题 |
|---|---|---|
| K L sample KL_{\text{sample}} KLsample | E x [ D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) ] \mathbb{E}_x[D_{KL}(q_\phi(z\mid x) \Vert p(z))] Ex[DKL(qϕ(z∣x)∥p(z))],逐样本算再平均,就是损失里那一项 | 解码器用不用这一维 |
| K L agg KL_{\text{agg}} KLagg | 聚合后验的矩匹配高斯对先验的 KL | 边缘形状像不像先验 |
- 本项目实测,这两个指标给出了相反的印象:16 个维度的边缘全部贴合先验(
μ
\mu
μ 落在
−
0.06
-0.06
−0.06 到
+
0.05
+0.05
+0.05,
σ
\sigma
σ 落在 0.99 到 1.07,
K
L
agg
KL_{\text{agg}}
KLagg 共 0.025 nats),但
z[7]这一维的 K L sample = 0.000 KL_{\text{sample}} = 0.000 KLsample=0.000,已经塌缩,解码器完全不读它- 不矛盾:塌缩维度的后验本来就等于先验,边缘分布看起来当然完美,所以判断塌缩只能看 K L sample KL_{\text{sample}} KLsample
- 反向也不成立: K L sample KL_{\text{sample}} KLsample 很大不代表采样会失败,只要聚合后验还贴合先验,先验采样依然落在解码器见过的区域里
- 把这一节的结论收拢成三句话
- VAE 是生成模型,因为它的潜空间上有一个显式写出来的先验分布 p ( z ) = N ( 0 , I ) p(z) = \mathcal{N}(0,I) p(z)=N(0,I)
- 采样之所以有效,是因为训练逼着聚合后验 q ( z ) q(z) q(z) 去贴近这个先验
- 潜维度是否被使用,看 K L sample KL_{\text{sample}} KLsample;能不能采样,看 K L agg KL_{\text{agg}} KLagg,两者不能互相替代
说人话:AE 学完之后,潜空间是一盘散沙,我们不知道从哪下嘴。VAE 在训练时就被要求"把潜空间整理成标准正态的样子",所以训完之后,闭着眼睛按标准正态抽一个 z z z,解码出来就是一条像模像样的轨迹。这就是"生成模型"这四个字的具体含义。
4 机器人轨迹 VAE 代码实现
4-1 介绍
- 这一节我们使用机器人轨迹数据集,对 VAE 进行部署
- 很简单:拿到的数据集是 LIBERO 里的机器人操作轨迹,每条样本是一条 20 步、每步 7 维的动作序列
- 输入:把
(20, 7)拉平成 140 维向量 - VAE:编码器压到 16 维潜变量,解码器再还原回 140 维
- 输出:同样是 140 维,重塑回
(20, 7)就是一条轨迹
- 输入:把
- 总共做四个实验,分别回答四个问题
- 能不能重构:把留出的验证轨迹编码再解码,看还原得像不像
- 潜空间有没有结构:把 16 维潜编码投到二维,看同类动作会不会聚在一起
- 能不能凭空采样:只从先验 N ( 0 , I ) \mathcal{N}(0, I) N(0,I) 抽 z z z,看解码出来的是不是像样的动作
- 潜空间能不能插值:在两个潜编码之间走直线,看解码结果是不是连续变化
- 这四个做完,再把动作积分回笛卡尔空间看末端走出了什么形状,最后用 β \beta β 消融看一眼 KL 权重到底在权衡什么
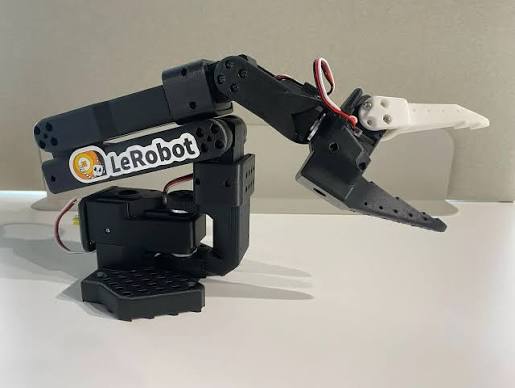
4-2 机器人轨迹数据集
4-2-1 介绍
- 数据用
lerobot/libero,托管在 HuggingFace,格式是 LeRobot v3.0 - 数据集链接:lerobot/libero
- LeRobot 是一套机器人数据集的统一格式规范,一个数据集由
meta/与data/两部分组成meta/info.json记录数据集的整体信息:帧率、特征名、各特征形状、episode 划分meta/tasks.parquet记录全部任务的语言指令data/chunk-*/file-*.parquet是真正的数据分片,每一行是一帧
- LIBERO 是一个机器人操作任务基准,全部是桌面级的抓取与放置,任务指令是自然语言
- 说句题外话:后续会更新一个关于lerobot的实战教程,就在我们的VLA系列的教程之后
4-2-2 数据集分析
- 本项目只使用 state 与 action,不使用任何视觉输入,这一点是刻意的
- 视觉输入会让问题变成"图像加动作",VAE 的结构反而被图像编码器盖住了
- 只留动作,模型小到 21300 个参数,训练 100 个 epoch 只要 141 秒,全部结构都看得清
- 数据集的关键统计如下
| 项目 | 值 |
|---|---|
| episode 数 | 1693 |
| task 数 | 40 |
| 总帧数 | 273465 |
| 单个 action 维度 | 7,即 3 平移加 3 旋转加 1 夹爪 |
| 控制频率 | 10 Hz |
| episode 长度 | 75 到 505 帧,中位数 140 |
| 切窗后样本数 | 241298,取 H=20、stride=1 |
- 下载只取
data/与meta/两个目录。同一个仓库里还有 1.9 GB 的相机视频,本实验一个字节都不需要,所以实际下载量只有 22 MB
hf download lerobot/libero \
    --repo-type dataset \
    --include "data/**" --include "meta/**" \
    --local-dir data/libero
- 限流量的就是那两个
--include - 动作
action与状态observation.state的语义完全不同,不能混用action是 7 维增量:[dpos(3), drot(3), gripper(1)],dpos是"这一步末端要往哪个方向挪一点",不是绝对坐标observation.state是 8 维:[eef_pos(3), eef_axis_angle(3), gripper_qpos(2)],前三维是真实的末端位置
- 这个区别在第 4-8 节把动作积分回末端轨迹时会变得非常关键
4-2-3 为什么必须做按维归一化
- 七个动作维度的量纲差了 25.5 倍,直接对 140 维算 MSE 会出问题
| 维度 | a[0] | a[1] | a[2] | a[3] | a[4] | a[5] | a[6] |
|---|---|---|---|---|---|---|---|
| std | 0.336 | 0.379 | 0.445 | 0.039 | 0.063 | 0.078 | 1.000 |
- 平移量级约 0.4,旋转量级约 0.04,夹爪是正负 1 的开关量
- MSE 是平方误差,旋转那三维的误差会被夹爪维度的平方项淹掉,模型会干脆放弃学旋转
- 所以按维度做 z-score 归一化
X ~ = X − μ dim σ dim \tilde{X} = \frac{X - \mu_{\text{dim}}}{\sigma_{\text{dim}}} X~=σdimX−μdim
- 这里的 μ dim \mu_{\text{dim}} μdim 与 σ dim \sigma_{\text{dim}} σdim 只在训练集 episode 上统计,避免用到验证集的信息
- 两个统计量会存进 checkpoint,所有报出来的指标都会反归一化回物理动作单位,数字才有意义
class ActionScaler:
    def __init__(self, mean, std):
        self.mean, self.std = mean, std          # 形状都是 (7,)

    @classmethod
    def fit(cls, episodes, episode_ids):
        # 只在训练集 episode 上统计,累积用 float64 避免精度损失
        stacked = np.concatenate([episodes.actions[i] for i in episode_ids]).astype(np.float64)
        std = stacked.std(axis=0)
        std = np.where(std < 1e-6, 1.0, std)     # 常量通道不动它,避免除零
        return cls(stacked.mean(axis=0), std)

    def transform(self, x):
        # x 的形状是 (N, H, 7),mean/std 是 (7,),靠广播自动对齐到最后 1 维
        return (x - self.mean) / self.std

    def inverse(self, x):
        return x * self.std + self.mean
- 注意广播是怎么对齐的:
(N, H, 7)减(7,),numpy 与 PyTorch 都会把(7,)看成(1, 1, 7)再逐元素运算 - 这也是为什么统计量要按最后一维存,而不是按
(140,)存 - 除以零的防护放在
fit里做(std < 1e-6的通道直接置 1),而不是在每次变换时加eps。加eps会偷偷改变所有维度的尺度,1.0 的夹爪维会变成 1 / 1.000001 1/1.000001 1/1.000001,反归一化时又不能完全还原
4-2-4 切分按 episode,不按窗口
- 这是整个数据管线里最容易出错、后果也最严重的一步
- 相邻两个窗口共享 19 个动作,如果按窗口随机切分,验证集里几乎每个窗口都能在训练集里找到"只差一步"的兄弟
- 这样测出来的验证损失会好得离谱,但完全不代表泛化能力
- 正确做法是按 episode 切,90% 的 episode 进训练集,10% 进验证集,验证集 episode 里的所有窗口整段进验证集
# 先按 episode 划分 id,再各自切窗
rng = np.random.default_rng(seed)
perm = rng.permutation(len(episodes))
n_val = max(1, int(round(len(perm) * val_ratio)))
val_ids, train_ids = perm[:n_val], perm[n_val:]

train_ws = build_windows(episodes, window=H, stride=1, episode_ids=train_ids)
val_ws = build_windows(episodes, window=H, stride=1, episode_ids=val_ids)
- 最终得到训练窗口 218277 条、验证窗口 23021 条
4-3 核心思路
- 整个方法可以用一行式子概括
Action Trajectory ⟶ VAE ⟶ Action Trajectory \text{Action Trajectory} \longrightarrow \text{VAE} \longrightarrow \text{Action Trajectory} Action Trajectory⟶VAE⟶Action Trajectory
- 具体地,取一个 LIBERO episode
episode
├── t=0   action[7]
├── t=1   action[7]
├── t=2   action[7]
├── ...
└── t=T   action[7]
- 按固定长度 H = 20 H = 20 H=20 切成窗口,得到
X ∈ R 20 × 7 X \in \mathbb{R}^{20 \times 7} X∈R20×7
- 拉平成 140 维
X ∈ R 140 X \in \mathbb{R}^{140} X∈R140
- 然后过 VAE
X ∈ R 140 → Encoder h ∈ R 64 → fc μ , fc log σ 2 ( μ , log σ 2 ) ∈ R 16 → 重参数化 z ∈ R 16 → Decoder X ^ ∈ R 140 \begin{aligned} X \in \mathbb{R}^{140} \;&\xrightarrow{\ \text{Encoder}\ } \; h \in \mathbb{R}^{64} \;\xrightarrow{\ \text{fc}_\mu,\ \text{fc}_{\log\sigma^2}\ }\; \big(\mu, \log\sigma^2\big) \in \mathbb{R}^{16} \\ &\xrightarrow{\ \text{重参数化}\ } \; z \in \mathbb{R}^{16} \;\xrightarrow{\ \text{Decoder}\ }\; \hat{X} \in \mathbb{R}^{140} \end{aligned} X∈R140 Encoder h∈R64 fcμ, fclogσ2 (μ,logσ2)∈R16 重参数化 z∈R16 Decoder X^∈R140
- 最后 reshape 回动作序列的形状
140 ⟶ 20 × 7 140 \longrightarrow 20 \times 7 140⟶20×7
4-3-1 张量形状速查
- 整条链路上每个张量的形状如下,后面所有的实验都建立在这几个形状上,写代码时对不上就是这一步错了
| 阶段 | 形状 | 含义 |
|---|---|---|
| 原始 episode | (T, 7) | T 帧,每帧 7 维动作,T 因 episode 而异 |
| 切窗后 | (N, 20, 7) | N 条样本,每条 20 步,每步 7 维 |
| 拉平 | (N, 140) | VAE 的输入,20 乘 7 |
| 编码隐层 | (N, 64) | 编码器中间层输出 |
| 后验参数 | (N, 16) 两份 | mu 与 logvar,形状完全相同 |
| 潜变量 | (N, 16) | 重参数化采样得到的 z |
| 解码输出 | (N, 140) | 与输入同形状,才能算重构损失 |
| 重塑回轨迹 | (N, 20, 7) | 出图与积分用这个形状 |
- 有一处形状约定很容易搞混:批大小 N 永远在第 0 维,所以沿着
dim=-1求和得到的是"每条样本一个标量",沿着dim=0求和得到的是"每个维度一个统计量" - 第 3-6 节算逐样本 KL 用的是
dim=-1,第 4-2-3 节算各维 std 用的是dim=0,两者不能互换
4-3-2 切片与形状操作
- 上面表格里的每一次形状变化,都对应一个具体的切片操作,值得单独写一遍
import numpy as np

# 1. 从 episode 里切出一个窗口:(T, 7) 取第 k 到 k+20 步
win = actions[k : k + 20]                 # (20, 7)

# 2. 拉平成一维,这就是 VAE 的输入
x = win.reshape(-1)                       # (140,)
# 等价写法:win.flatten(),但 flatten 总是拷贝,reshape 能省则省

# 3. 解码回来之后重塑成轨迹
traj = x_hat.reshape(20, 7)               # (20, 7)

# 4. 按语义切开七维动作,验证模型有没有学歪
dpos, drot, grip = traj[:, :3], traj[:, 3:6], traj[:, 6]

# 5. 整个数据集用滑窗一次性切完,(T, 7) 变成 (T-19, 7, 20)
windows = np.lib.stride_tricks.sliding_window_view(actions, 20, axis=0)
# 新轴在末尾,要搬到中间才是 (T-19, 20, 7)
windows = np.ascontiguousarray(windows.transpose(0, 2, 1))
- 第 5 步有个坑必须提醒:
sliding_window_view把新轴放在最后- 输入形状
(T, 7),指定axis=0,输出是(T-19, 7, 20)而不是(T-19, 20, 7) - 它是在原轴上滑动,滑出来的窗口维度追加到末尾,不是插在
axis的位置 - 少了这一步转置,切出来的"窗口"里混的是不同维度的数据,模型照样能训,但学到的东西完全不对,而且不报错
- 输入形状
- 另外,
sliding_window_view返回的是视图不是拷贝,写操作会污染原数组,需要可写副本时记得.copy()
说人话:这一章做的事就是"把机器人连续动作切成 20 步一段,压成 16 个数字,再还原回 20 步"。前面三章讲的所有公式,落到代码里就是这段切片。
4-3-3 完整模型代码
- 把第 3 章讲的所有东西拼起来,就是这个项目的模型定义
- 下面这份代码一共 21292 个参数,比项目里跑的版本少 1 个 —— 那个参数是高斯似然重构模式下用于学习观测噪声的标量
log_sigma2,本项目的recon默认走 MSE,用不到它,为了不干扰阅读这里略去了
import torch
import torch.nn as nn
import torch.nn.functional as F


def mlp(sizes, activate_last=True):
    """按 sizes 串一串全连接层,中间夹 ReLU"""
    layers = []
    for i in range(len(sizes) - 1):
        layers.append(nn.Linear(sizes[i], sizes[i + 1]))
        # 最后一层是否加激活由 activate_last 决定
        if i < len(sizes) - 2 or activate_last:
            layers.append(nn.ReLU())
    return nn.Sequential(*layers)


class TrajVAE(nn.Module):
    """动作轨迹上的变分自编码器,输入输出都是拉平的 (B, H*D)"""

    def __init__(self, obs_dim, hidden=64, latent=16, layers=1):
        super().__init__()
        self.obs_dim = obs_dim
        self.latent = latent

        # 编码器把 140 维压到 64 维隐层
        self.encoder = mlp([obs_dim] + [hidden] * layers)
        # 两路独立的头,对应第 3-4 节的 mu 与 logvar
        self.fc_mu = nn.Linear(hidden, latent)
        self.fc_logvar = nn.Linear(hidden, latent)
        # 解码器把 16 维还原回 140 维,最后一层不加激活
        self.decoder = mlp([latent] + [hidden] * layers + [obs_dim], activate_last=False)

        self.reset_parameters()

    def reset_parameters(self):
        for module in self.modules():
            if isinstance(module, nn.Linear):
                nn.init.kaiming_normal_(module.weight, nonlinearity="relu")
                nn.init.zeros_(module.bias)
        # 输出头初始化为 0,训练从"预测均值"开始,起步更稳
        nn.init.zeros_(self.decoder[-1].weight)
        nn.init.zeros_(self.decoder[-1].bias)

    def encode(self, x):
        h = self.encoder(x)
        return self.fc_mu(h), self.fc_logvar(h)

    def reparameterize(self, mu, logvar):
        # 对应第 3-5 节:z = mu + sigma * eps
        std = torch.exp(0.5 * logvar)
        return mu + std * torch.randn_like(std)

    def decode(self, z):
        return self.decoder(z)

    def forward(self, x):
        mu, logvar = self.encode(x)
        z = self.reparameterize(mu, logvar)
        return self.decode(z), mu, logvar, z

    @torch.no_grad()
    def sample(self, n, device=None):
        # 对应第 3-9 节:直接从先验采样再解码,不经过编码器
        device = device or next(self.parameters()).device
        z = torch.randn(n, self.latent, device=device)
        return self.decode(z)

    def loss(self, x, beta=1.0):
        """负 ELBO,返回 (总损失, 重构项, KL 项) 三个值"""
        x_hat, mu, logvar, _ = self(x)

        # 重构项:在 140 个输出维度上求和,再对 batch 求平均
        rec = F.mse_loss(x_hat, x, reduction="none").sum(dim=-1).mean()

        # KL 项:第 3-6 节的闭式解,在 16 个潜维度上求和
        kld = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp(), dim=-1).mean()

        return rec + beta * kld, rec, kld

    @torch.no_grad()
    def reconstruct(self, x, sample=False):
        """重构。sample=True 时用采样得到的 z,否则用后验均值 mu"""
        mu, logvar = self.encode(x)
        return self.decode(self.reparameterize(mu, logvar) if sample else mu)
- 有两处实现细节值得单独说
reconstruct默认用后验均值mu而不是采样。重构实验要看的是"模型学到了什么",用均值能去掉采样噪声,指标更干净- 输出头零初始化。如果输出头随机初始化,训练第一步的预测是随机的大数,重构损失极大,梯度会把编码器冲坏,起步阶段很容易直接塌缩
4-3-4 训练循环与两项损失的监控
- 训练循环本身没有什么特别的,关键在两项损失必须分开记录
model = TrajVAE(obs_dim=140, hidden=64, latent=16).to(device)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for epoch in range(1, 101):
    model.train()
    for (batch,) in train_loader:
        batch = batch.to(device)
        loss, rec, kld = model.loss(batch, beta=1.0)   # 三个值都要

        optimizer.zero_grad(set_to_none=True)
        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 5.0)   # 梯度裁剪
        optimizer.step()

    # 验证集上同样把两项分开算,evaluate 就是把 model.loss 在 val_loader 上跑一遍
    # 再顺手把重构误差反归一化回物理动作单位
    val_metrics = evaluate(model, val_loader, device)
    print(f"[epoch {epoch:3d}] val={val_metrics['loss']:9.2f} "
          f"recon={val_metrics['recon']:9.2f} kld={val_metrics['kld']:8.2f}")
- 每训完一个 epoch 就把 checkpoint 存一次,只保留验证损失最低的那一份
- 本项目还会在每个 epoch 结束时把
history.csv落盘一次,这样一次长训练可以从外部观察进度,也能中途安全终止 - 本文实验用到的超参数如下,复现时直接照抄
| 超参数 | 值 | 超参数 | 值 |
|---|---|---|---|
| 窗口长度 H H H | 20 | 潜维度 L L L | 16 |
| 窗口步长 stride | 1 | 隐层宽度 | 64 |
| 验证集 episode 比例 | 0.1 | 隐层数 | 1 |
| epoch 数 | 100 | 优化器 | Adam |
| batch size | 256 | 学习率 | 10 − 3 10^{-3} 10−3 |
| 随机种子 | 0 | 权重衰减 | 0 |
| β \beta β | 1.0 | 梯度裁剪 | 5.0 |
- 分开记录的理由在第 3-7 节说过,这里落到实践上:
val_recon涨,说明模型表达能力不够,或者 β 太大把重构压死了val_kld掉到接近 0,说明后验塌缩了,解码器已经不看 z z z- 只看总损失,这两个完全相反的问题会表现出同一种症状,根本没法定位
- 本次训练的实测曲线如下,两条曲线分别在左右两个子图
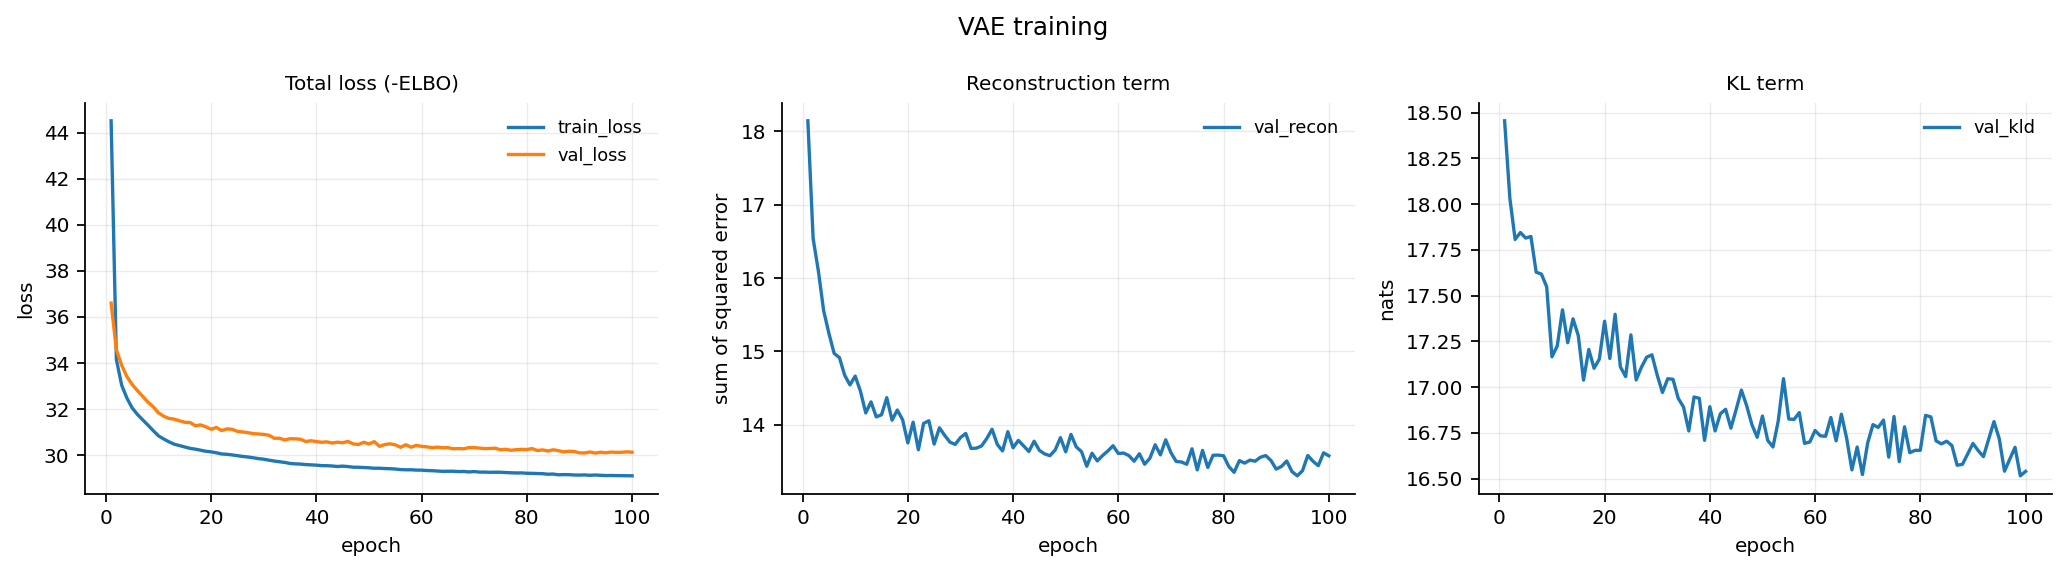
- 最优验证损失是 30.080,出现在第 93 个 epoch,全程 141 秒,单卡 CUDA
4-4 Trajectory Reconstruction
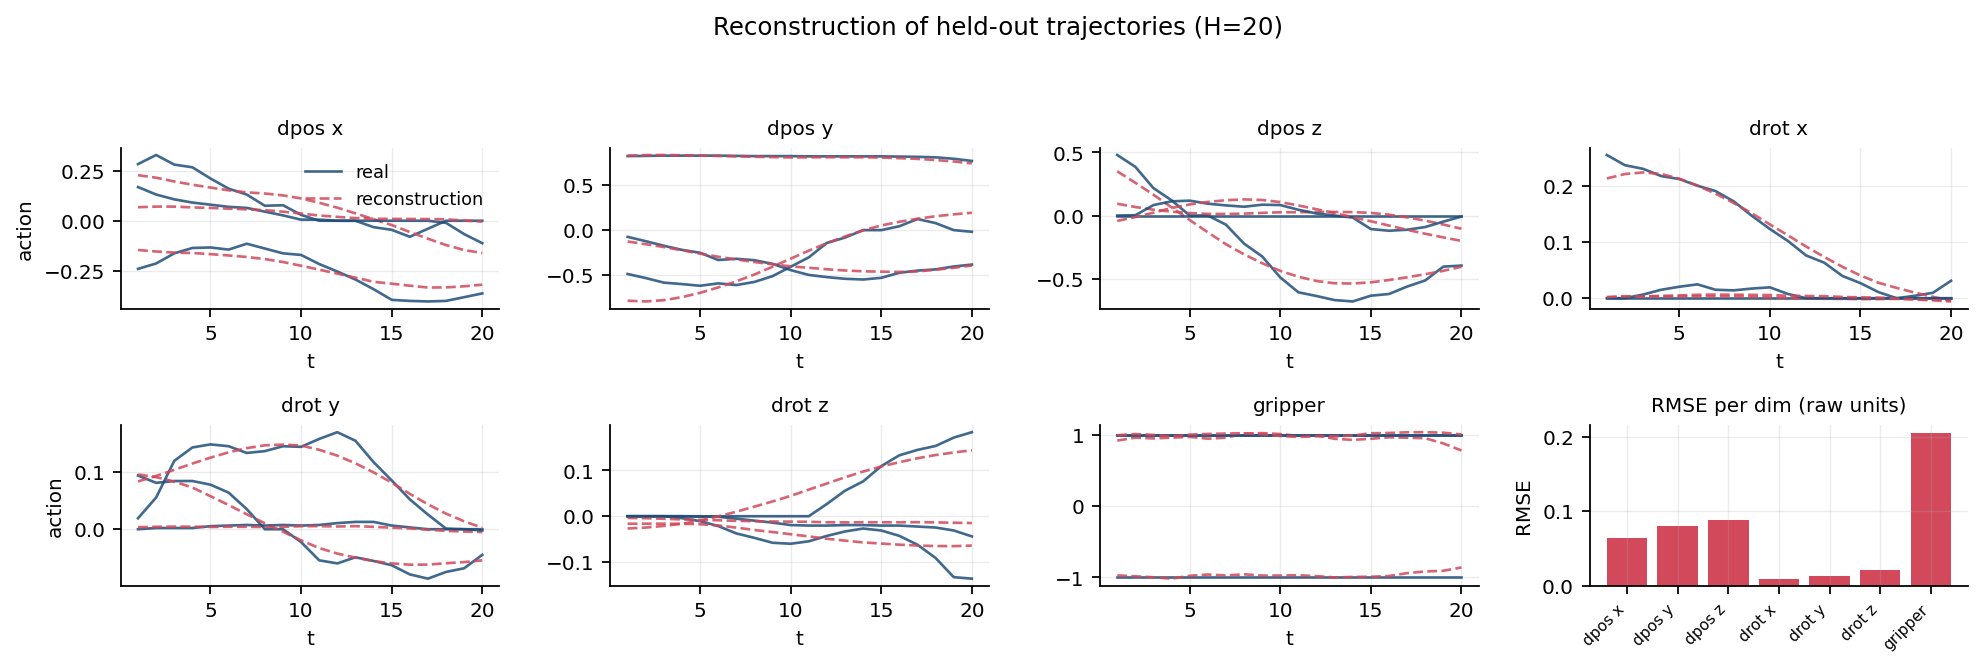
- 第一个实验最直接:取验证集里没训过的 episode,编码再解码,看还原得怎么样
真实: a1, a2, a3, ..., a20
VAE : a1', a2', a3', ..., a20'
- 结果如下,七个动作维度各一个子图,实线是真实、虚线是重构,第八个子图是各维 RMSE
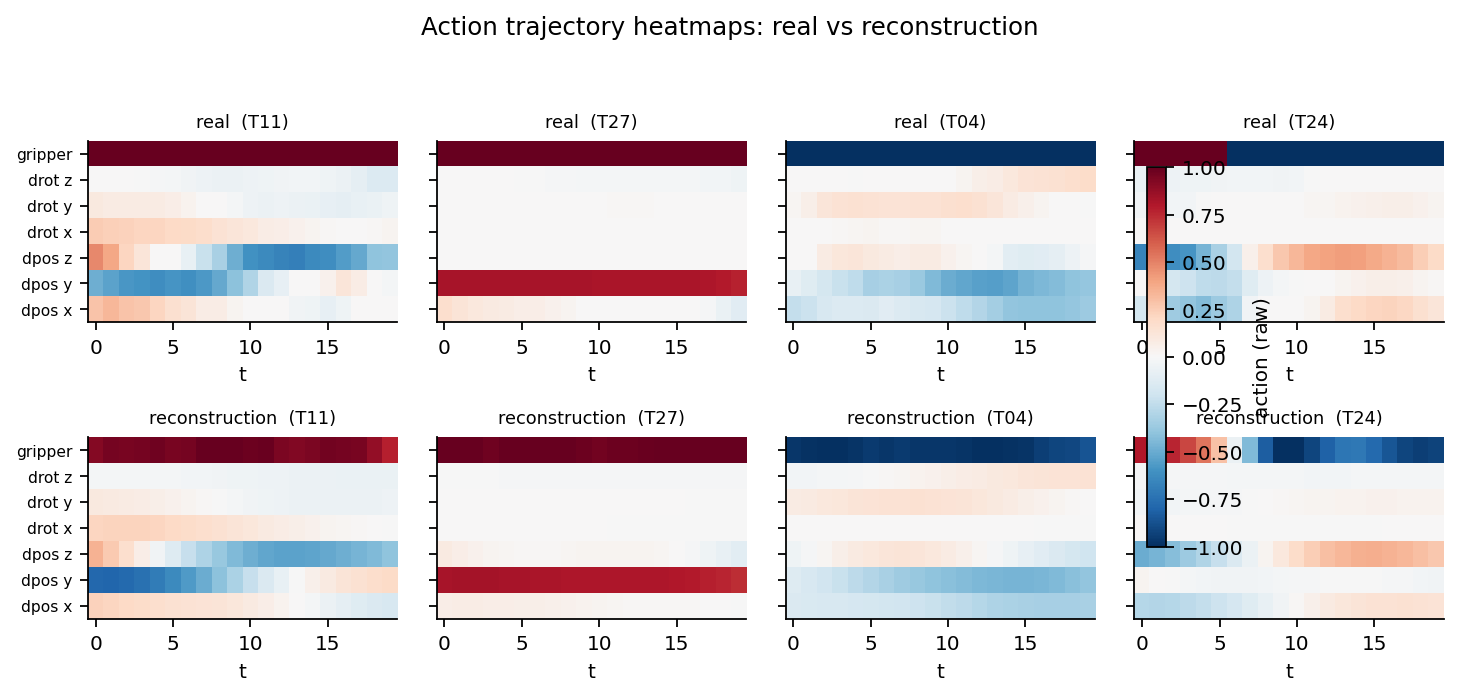
- 再换一个角度看,真实与重构的 20×7 热力图对照
4-4-1 为什么用 R² 而不是只看 RMSE
- 量化指标用每维 RMSE 与 R 2 R^2 R2,两者回答的问题不一样
RMSE = 1 n ∑ i = 1 n ( y i − y ^ i ) 2 , R 2 = 1 − ∑ i ( y i − y ^ i ) 2 ∑ i ( y i − y ˉ ) 2 \text{RMSE} = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2}, \qquad R^2 = 1 - \frac{\sum_i (y_i - \hat{y}_i)^2}{\sum_i (y_i - \bar{y})^2} RMSE=n1i=1∑n(yi−y^i)2,R2=1−∑i(yi−yˉ)2∑i(yi−y^i)2
-
说人话,两者的差别在于"有没有把数据的自身尺度除掉"
- RMSE 是绝对误差,单位就是动作本身的单位,数值大不代表模型差,可能只是这一维动作本来就大
- R 2 R^2 R2 是相对误差,分母是这一维自身的方差,等于在问"模型解释了这一维多少的波动"
-
所以 R 2 R^2 R2 比 RMSE 更能说明"结构有没有被保住",而不同维度的 RMSE 不能直接横向比较
-
举个例子:夹爪的 RMSE 是 0.197,旋转的 RMSE 只有 0.011,差了将近 18 倍,但两者的 R 2 R^2 R2 分别是 0.960 和 0.936,模型对它们的建模水平其实差不多
-
R 2 R^2 R2 还有两个好用的性质
- 恒等映射的 R 2 R^2 R2 是 1,永远输出均值的"傻子模型" R 2 R^2 R2 是 0,所以 0 是一条天然的分界线
- R 2 R^2 R2 可以是负数,负得越多说明模型比直接输出均值还差,通常意味着训练方向反了
-
逐维结果
| 维度 | dpos x | dpos y | dpos z | drot x | drot y | drot z | gripper |
|---|---|---|---|---|---|---|---|
| R² | 0.940 | 0.948 | 0.959 | 0.936 | 0.940 | 0.953 | 0.960 |
| RMSE(原始单位) | 0.080 | 0.087 | 0.093 | 0.011 | 0.016 | 0.018 | 0.197 |
- 平均
R
2
=
0.948
R^2 = 0.948
R2=0.948,七个维度没有一个被放弃,最低的 drot x 也有 0.936
- 这正好验证了第 4-2-3 节的判断:不做按维归一化,旋转那三维的 R 2 R^2 R2 会明显掉下去
- 夹爪的 RMSE 0.197 看起来最大,但它的量纲本来就是正负 1 的开关量, R 2 R^2 R2 反而是最高的 0.960
- 验证集重构 RMSE 反归一化之后是 0.096,而动作本身的池化 std 是 0.46,误差大约两成
4-5 Latent Space Visualization
- 把验证集轨迹编码成 z ∈ R 16 z \in \mathbb{R}^{16} z∈R16,再用 PCA 与 t-SNE 降到二维,按 LIBERO task 上色
- t-SNE(t-distributed Stochastic Neighbor Embedding,t 分布随机邻域嵌入)是一种非线性降维方法,比 PCA 更擅长展示局部邻域结构
- 40 个 task 的图例只标
T00到T39,它们是 LIBERO 任务列表里的编号
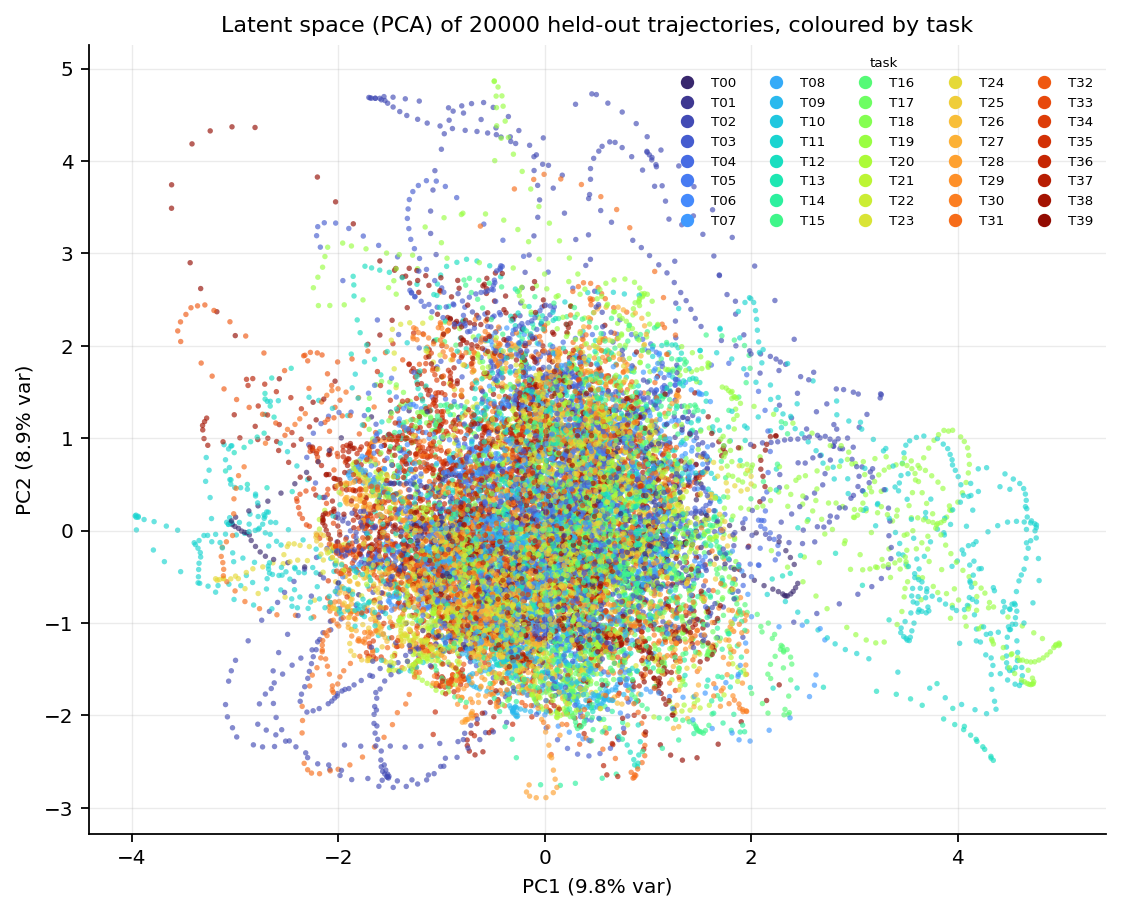
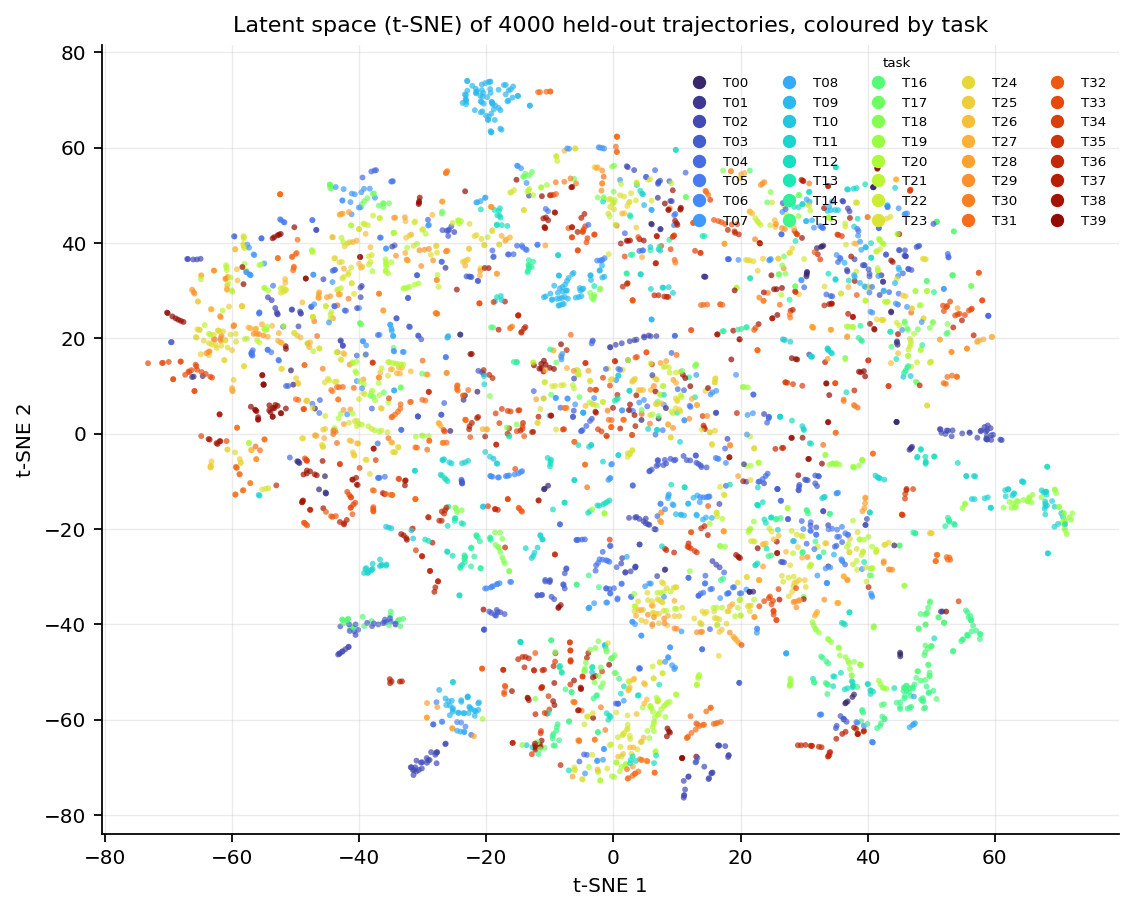
4-5-1 潜空间散点怎么读
- 这两张图要看的不是"有没有分开",而是同色点有没有聚在一起、不同色点之间有没有连续过渡
- 判断标准可以拆成三条
- 同一个 task 的窗口应该聚成一团,因为同一个任务的动作风格是稳定的
- 相邻的两团之间应当有过渡点,而不是一刀切开的鸿沟,有过渡才说明潜空间是连续的
- 不同 task 的点互相交叠是正常的,因为底层动作原语本来就重叠
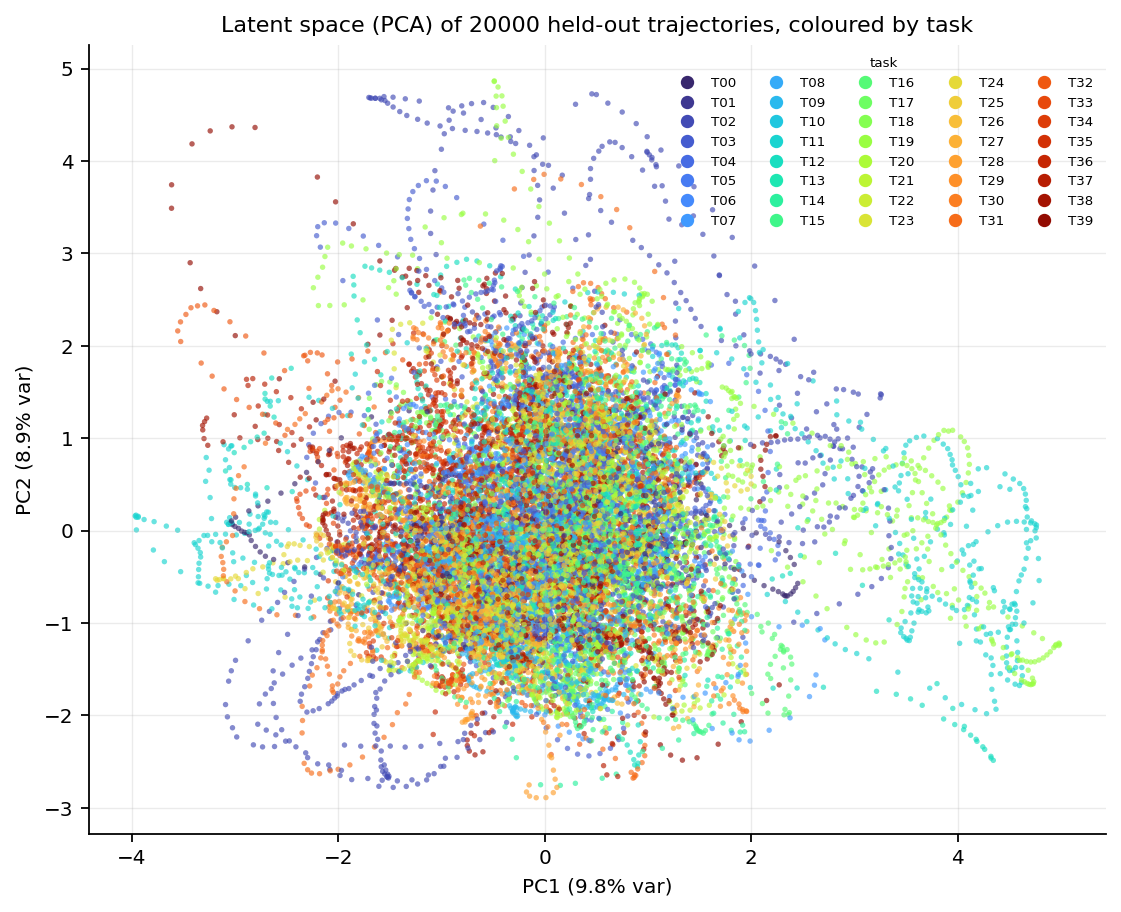
- PCA 前两维只解释了 18.7% 的方差,看起来不高,但这不等于失败
- 40 个 task 的底层动作原语高度重叠,都是"伸过去、夹住、抬起来、放下"这四步,差别只在目标物体与位置
- 潜空间本来就不该按 task 分成 40 坨,我们也没有理由期待它分得开
- 这个实验真正要看的是:VAE 是否学到了一个能描述动作轨迹的低维表示,以及这个表示的连续性
说人话:这两张散点图回答两个问题:动作轨迹的低维表示连不连续,同一个任务聚不聚得起来。前者看团与团之间是平滑过渡还是一刀切开的鸿沟,后者看同色点有没有抱成一团。
4-5-2 逐维 KL 与塌缩判据
- 真正能说明问题的是第三张图,也是 AE 完全没有的一张图:每个潜维度的聚合后验分布,与标准正态先验的对照
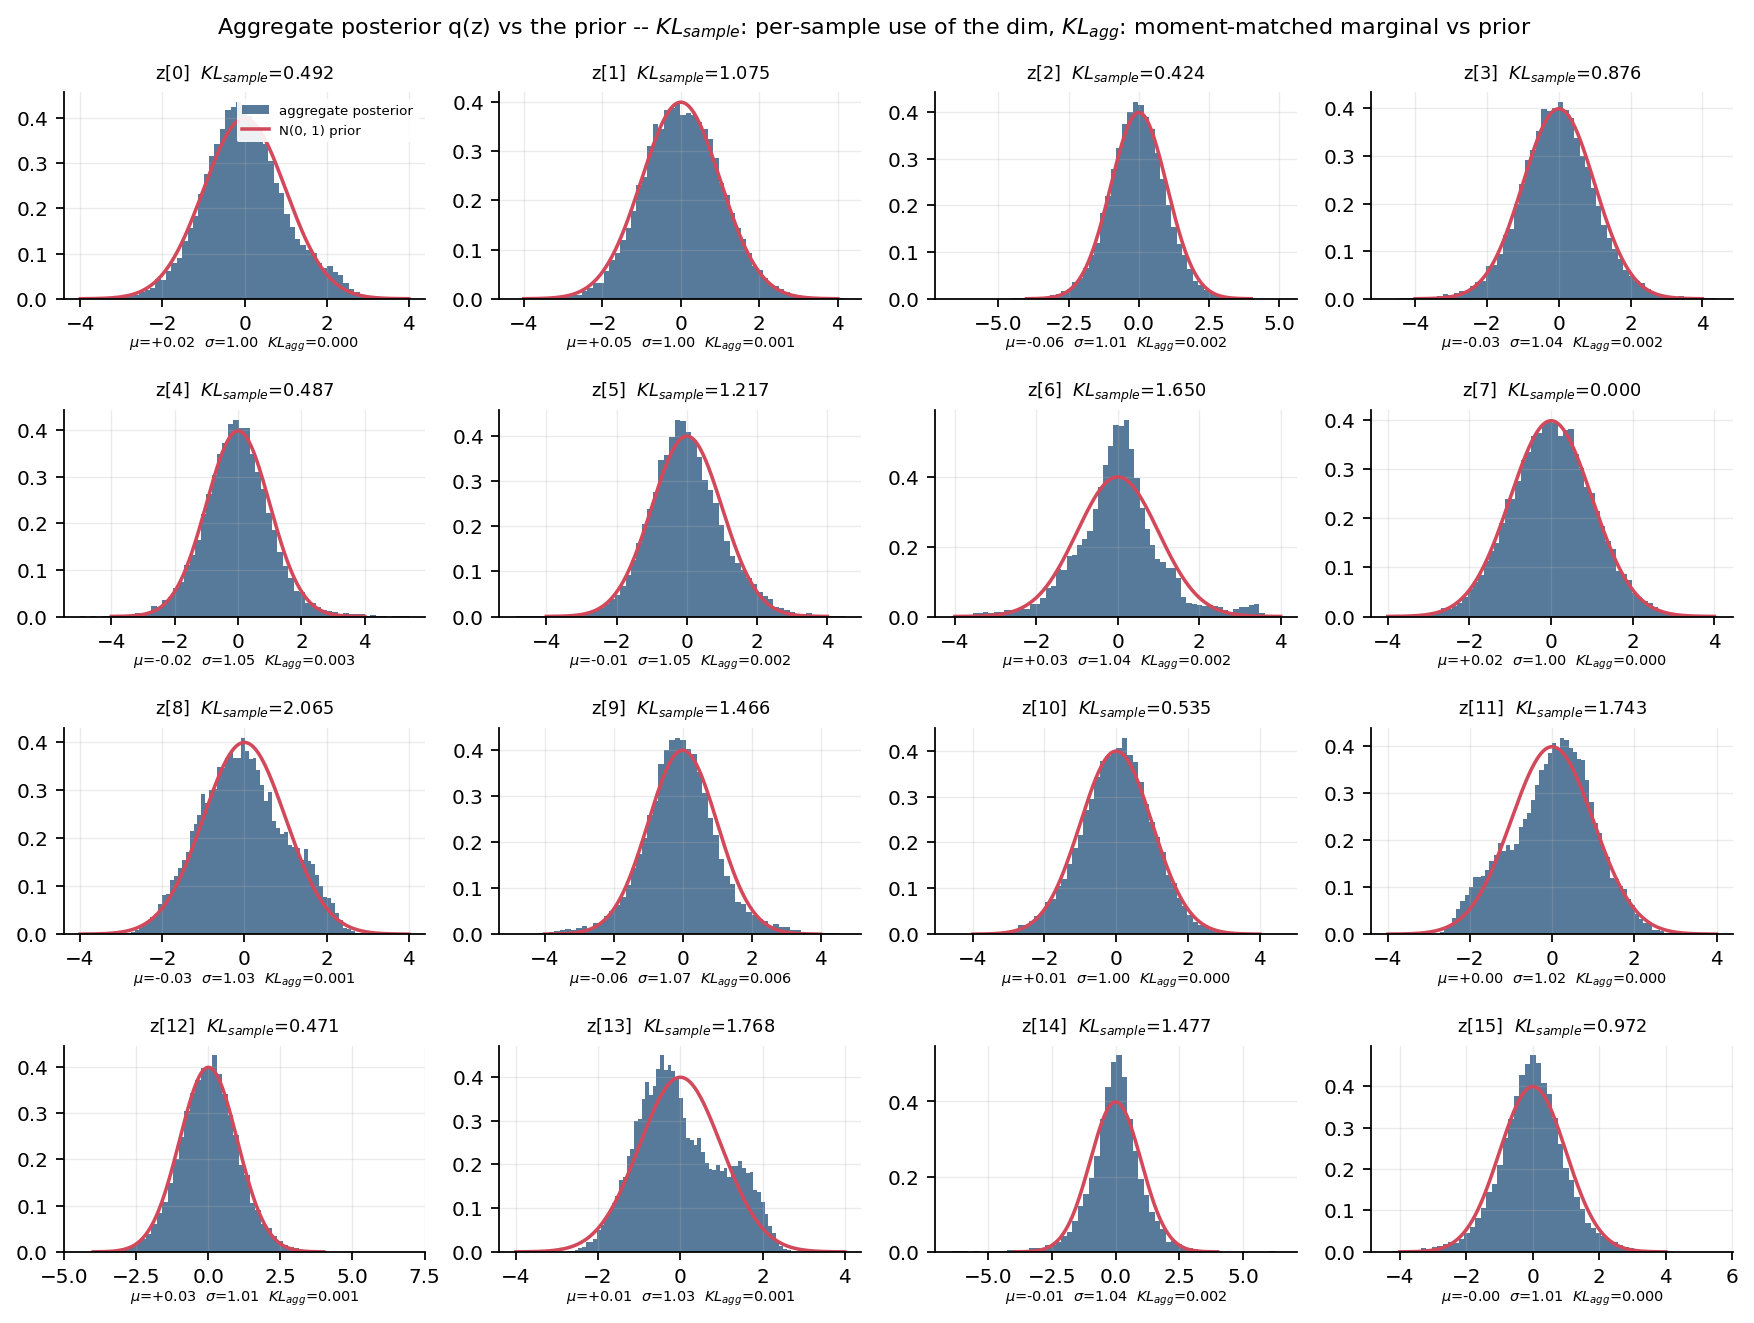
- 每个子图上方的标题标的是该维的 K L sample KL_{\text{sample}} KLsample,横轴标签标的是矩匹配的 K L agg KL_{\text{agg}} KLagg,两者含义不同
- 每个子图的读法是
- 灰色直方图是从验证集所有窗口采样出的 z z z 在该维上的分布,也就是聚合后验的经验版本
- 黑色曲线是标准正态先验的密度
- 两者贴合说明这一维的边缘像先验,标题里的 K L sample KL_{\text{sample}} KLsample 才说明解码器用不用这一维
- 实测结果
| 量 | 值 |
|---|---|
| 逐样本总 KL(损失里那一项) | 16.72 nats,16 维平均约 1.04 nats 每维 |
| 边缘总 KL(矩匹配) | 0.025 nats |
| 边缘 μ \mu μ 范围 | − 0.06 -0.06 −0.06 到 + 0.05 +0.05 +0.05 |
| 边缘 σ \sigma σ 范围 | 0.99 到 1.07 |
| 塌缩维度 | 1 个,即 z[7],
K
L
sample
=
0.000
KL_{\text{sample}} = 0.000
KLsample=0.000 |
| 活跃维度的 K L sample KL_{\text{sample}} KLsample 范围 | 0.42 到 2.06 |
- 把这几个数字放在一起,正好复现第 3-9 节那个反直觉的结论
- 16 个维度的边缘分布全都贴合先验, σ \sigma σ 全落在 0.99 到 1.07 之间, K L agg KL_{\text{agg}} KLagg 总共 0.025 nats
- 但
z[7]已经塌缩了,所有输入的 μ \mu μ 都挤在 0.019, σ \sigma σ 约等于 1.0,解码器完全不读它
- 边缘分布像不像先验,完全不能告诉我们解码器用没用这一维。 一个塌缩维度就是先验本身,边缘看起来当然完美
- 判断塌缩只能看 K L sample KL_{\text{sample}} KLsample,本项目用它作为唯一的判据
4-6 Random Generation
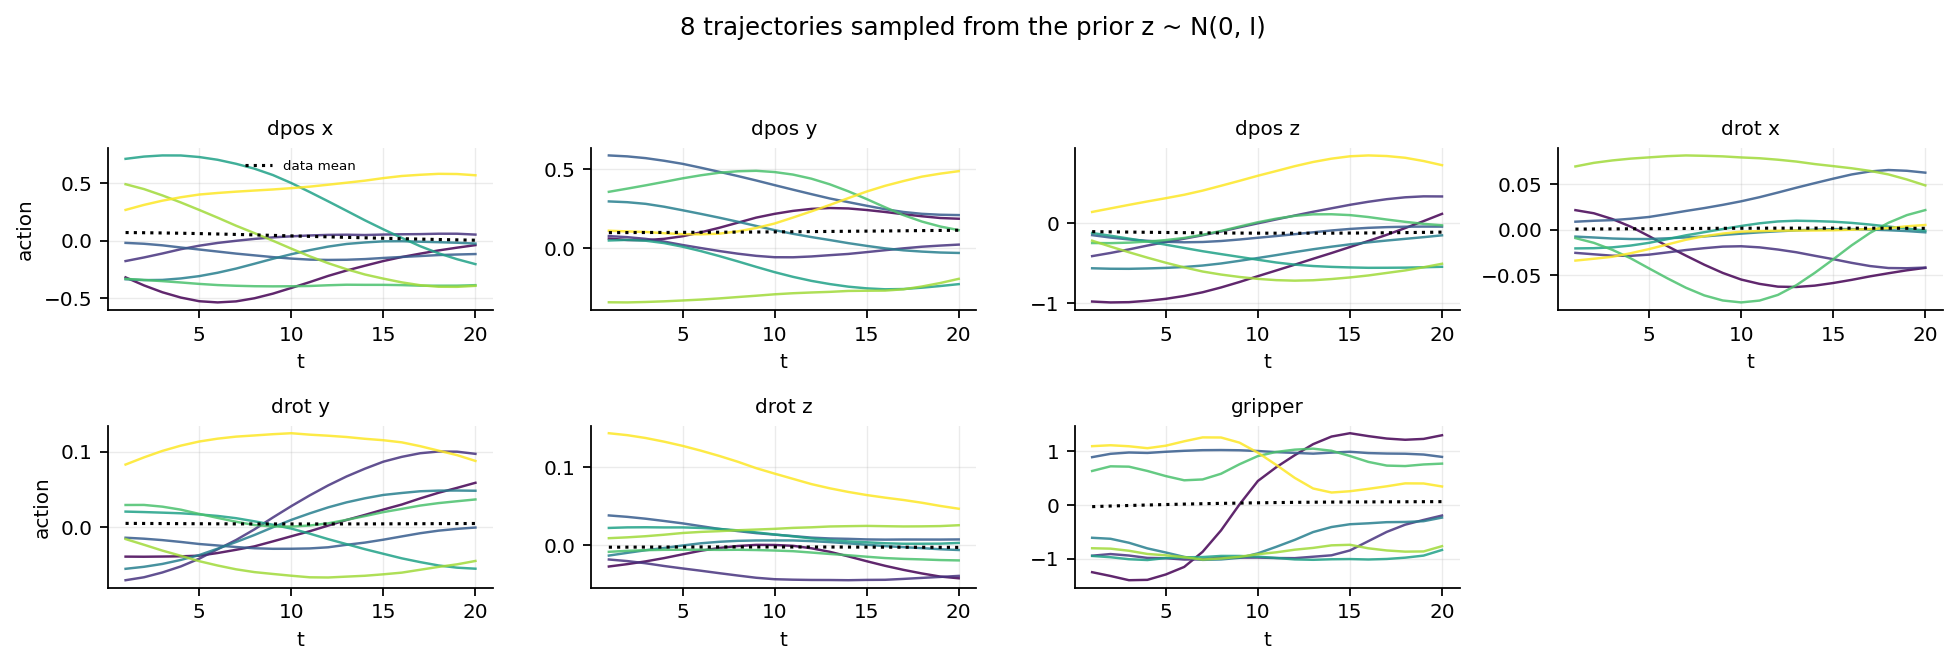
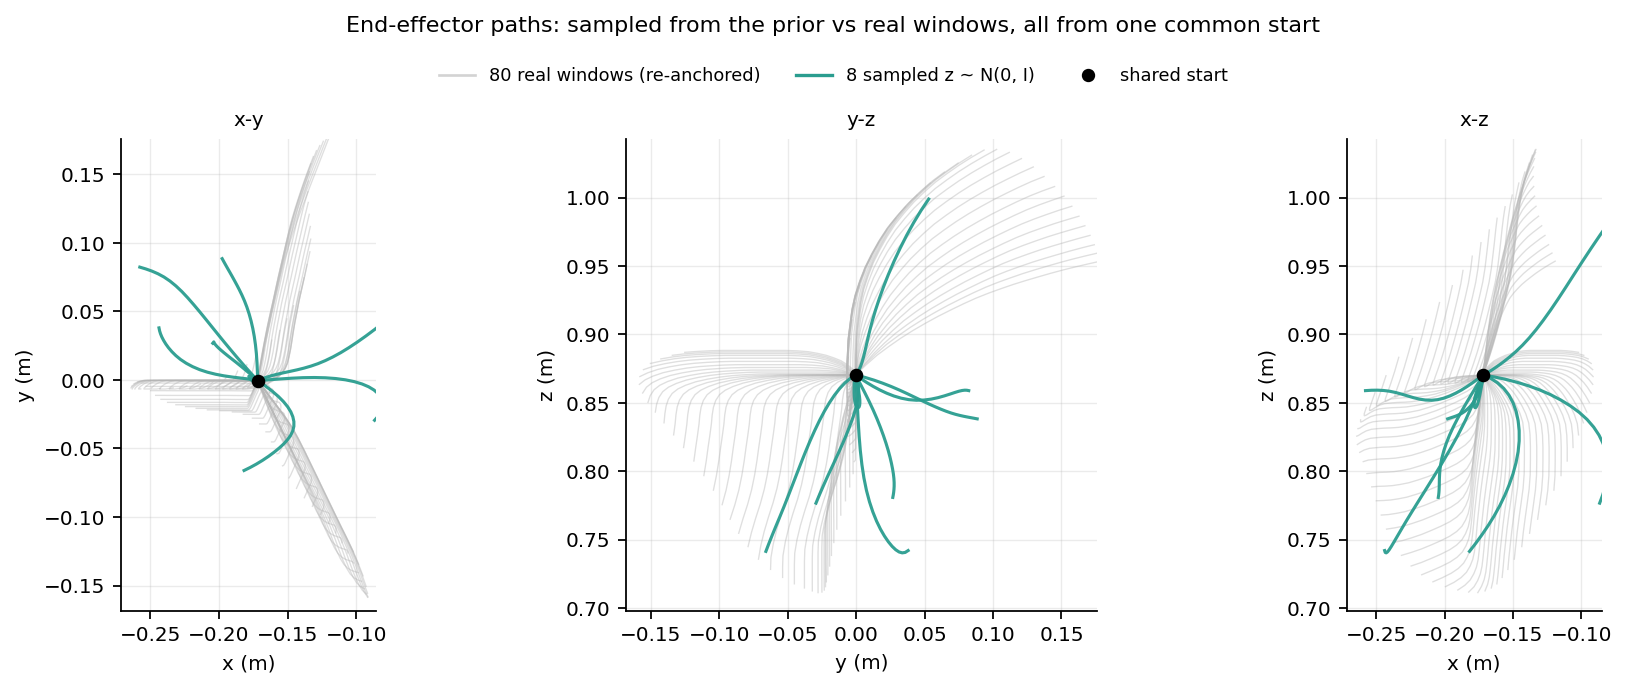
- 这是从自编码器迈向生成模型的关键一步:不输入任何真实轨迹,直接从先验采样 z ∼ N ( 0 , I ) z \sim \mathcal{N}(0, I) z∼N(0,I),解码得到全新的动作轨迹
@torch.no_grad()
def sample(self, n, device=None):
    device = device or next(self.parameters()).device
    z = torch.randn(n, self.latent, device=device)   # 16 维,直接从先验抽
    return self.decode(z)                            # 解码即生成
- 采样 8 条,七个动作维度各一个子图
4-6-1 判断生成质量的三项对照
- 只看"曲线长得像不像"是不够的。曲线画得像,可能只是因为它长得像一条平均轨迹,而平均轨迹本身往往不是任何一条真实轨迹
- 所以还要做三项定量对照
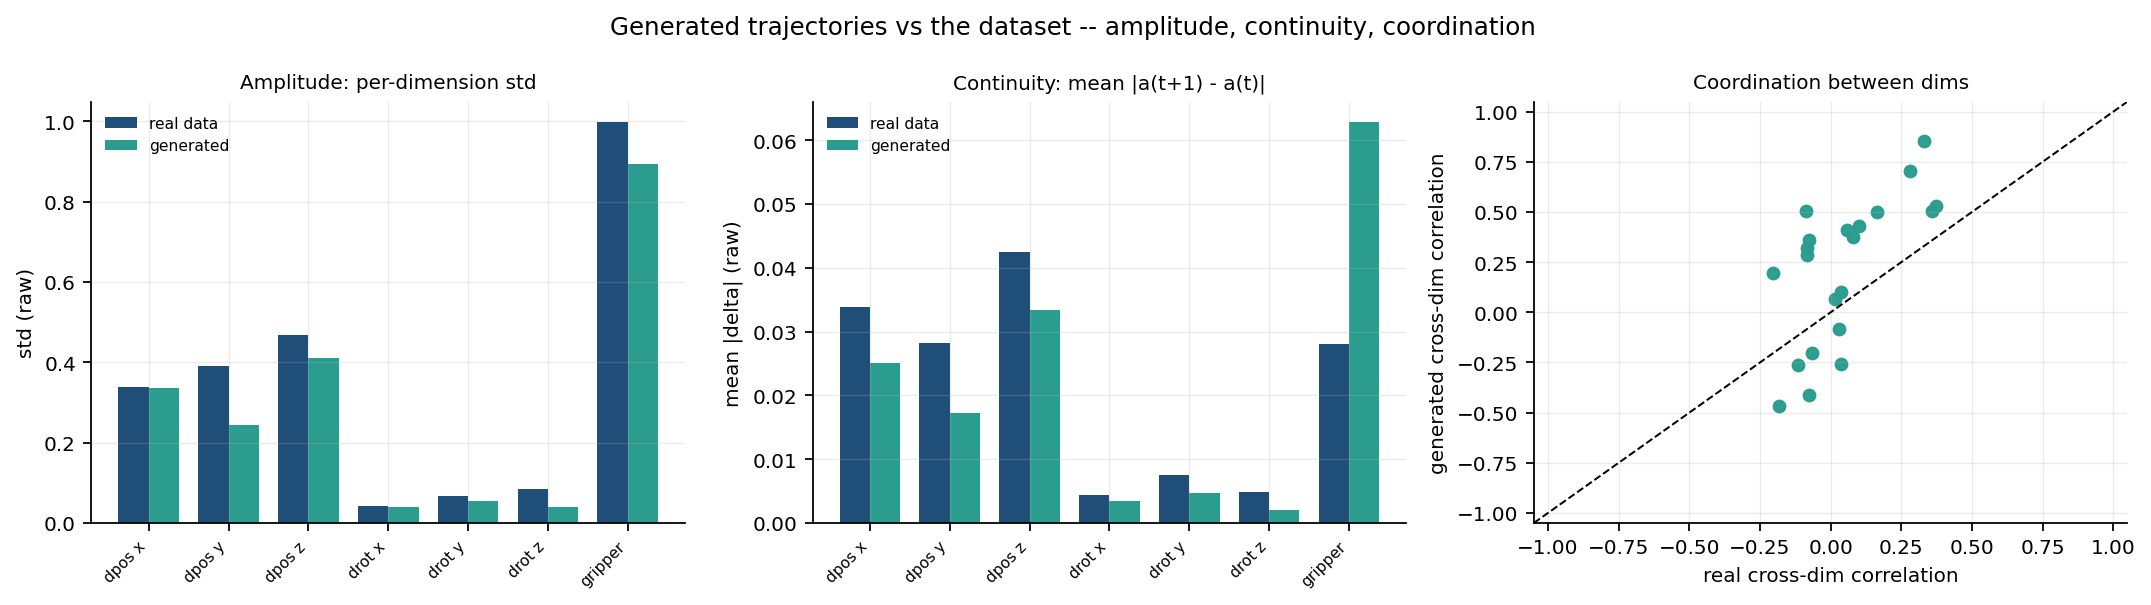
- 三项对照分别是动作幅度、时间连续性、维度协调关系,各自对应生成模型的一个失效模式
- 动作幅度对应"输出向均值收缩",生成的东西幅度普遍比真实小
- 时间连续性对应"动作抖动",相邻两步之间跳变过大
- 维度协调关系对应"维度解耦",每一维单独看都对,但组合起来不像人做的
- 动作幅度,逐维对比生成与真实的 std
| 维度 | dpos x | dpos y | dpos z | drot x | drot y | drot z | gripper |
|---|---|---|---|---|---|---|---|
| 生成 / 真实 std 比 | 0.99 | 0.63 | 0.88 | 0.94 | 0.80 | 0.46 | 0.89 |
-
时间连续性,统计平均的相邻步变化量 ∣ a ( t + 1 ) − a ( t ) ∣ \lvert a(t+1) - a(t) \rvert ∣a(t+1)−a(t)∣,越大越抖
- 平移与旋转各维是真实的 0.6 到 0.8 倍,比真实更平滑
- 但夹爪维反而是真实的 2.2 倍,0.063 对 0.028,采样出的夹爪开合比真实更频繁
- 这是生成质量最明显的一处缺陷,夹爪是开关量,模型对它的多峰结构拟合得不好
-
维度协调关系,算 7×7 的跨维相关矩阵,真实与生成逐点对比
- 非对角元素与真实的相关系数是 r = 0.657
- 维度之间的协调关系大体学到了,但没有完全复现
-
生成样本幅度普遍偏小,尤其 drot z 只有真实的 46%
-
这不是玄学,原因在下一节的 β 消融里能定量地看出来:部分潜维度塌缩了,解码器能拿到的信息变少,输出就向均值收缩
-
这也是生成模型特有的分布覆盖问题,AE 根本没有 β 这一项可选,也就谈不上权衡
4-7 Latent Interpolation
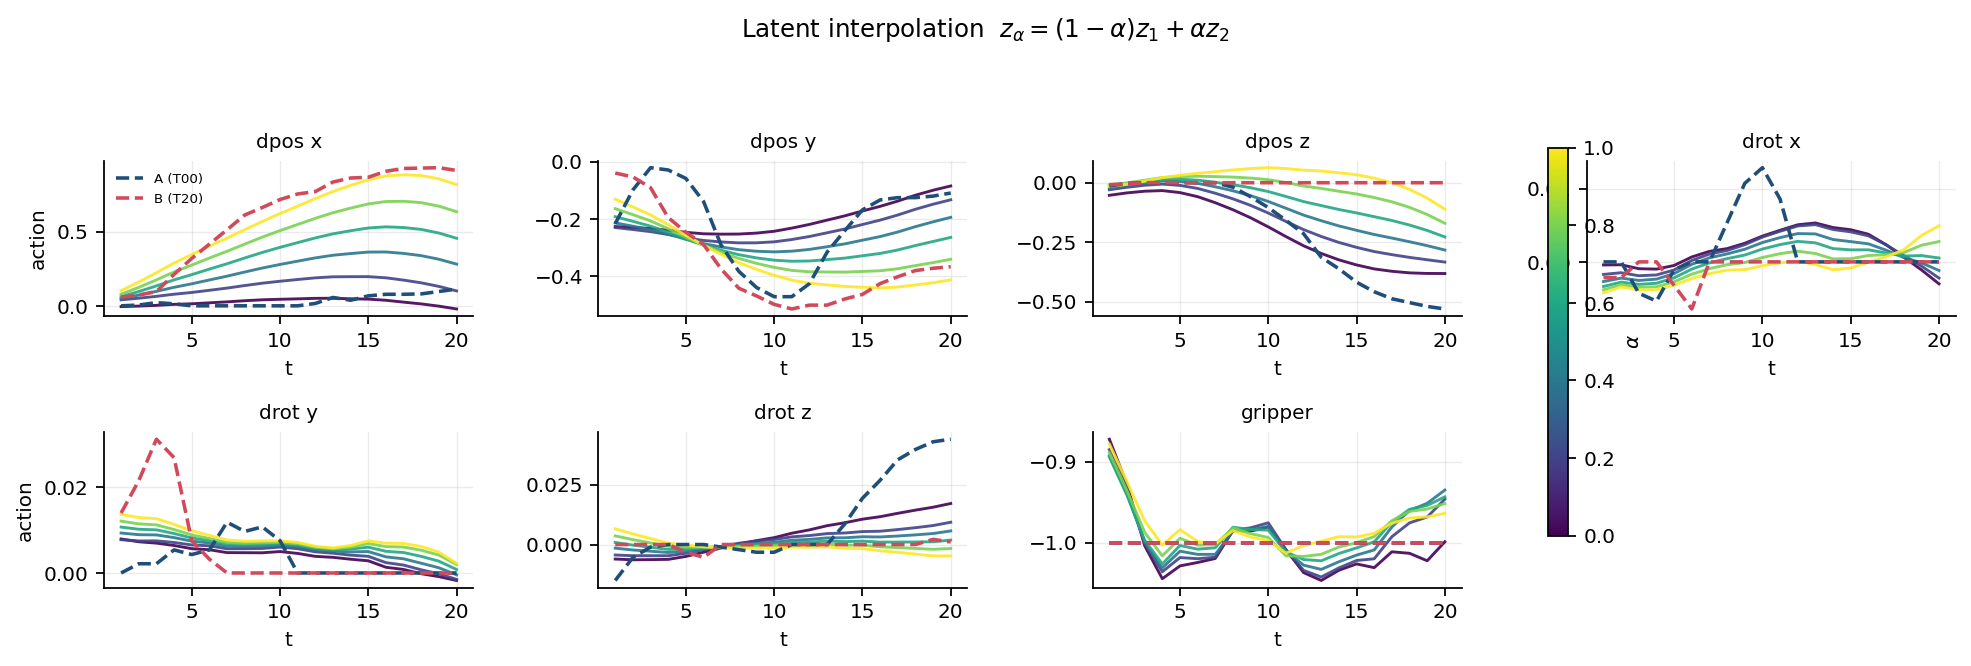
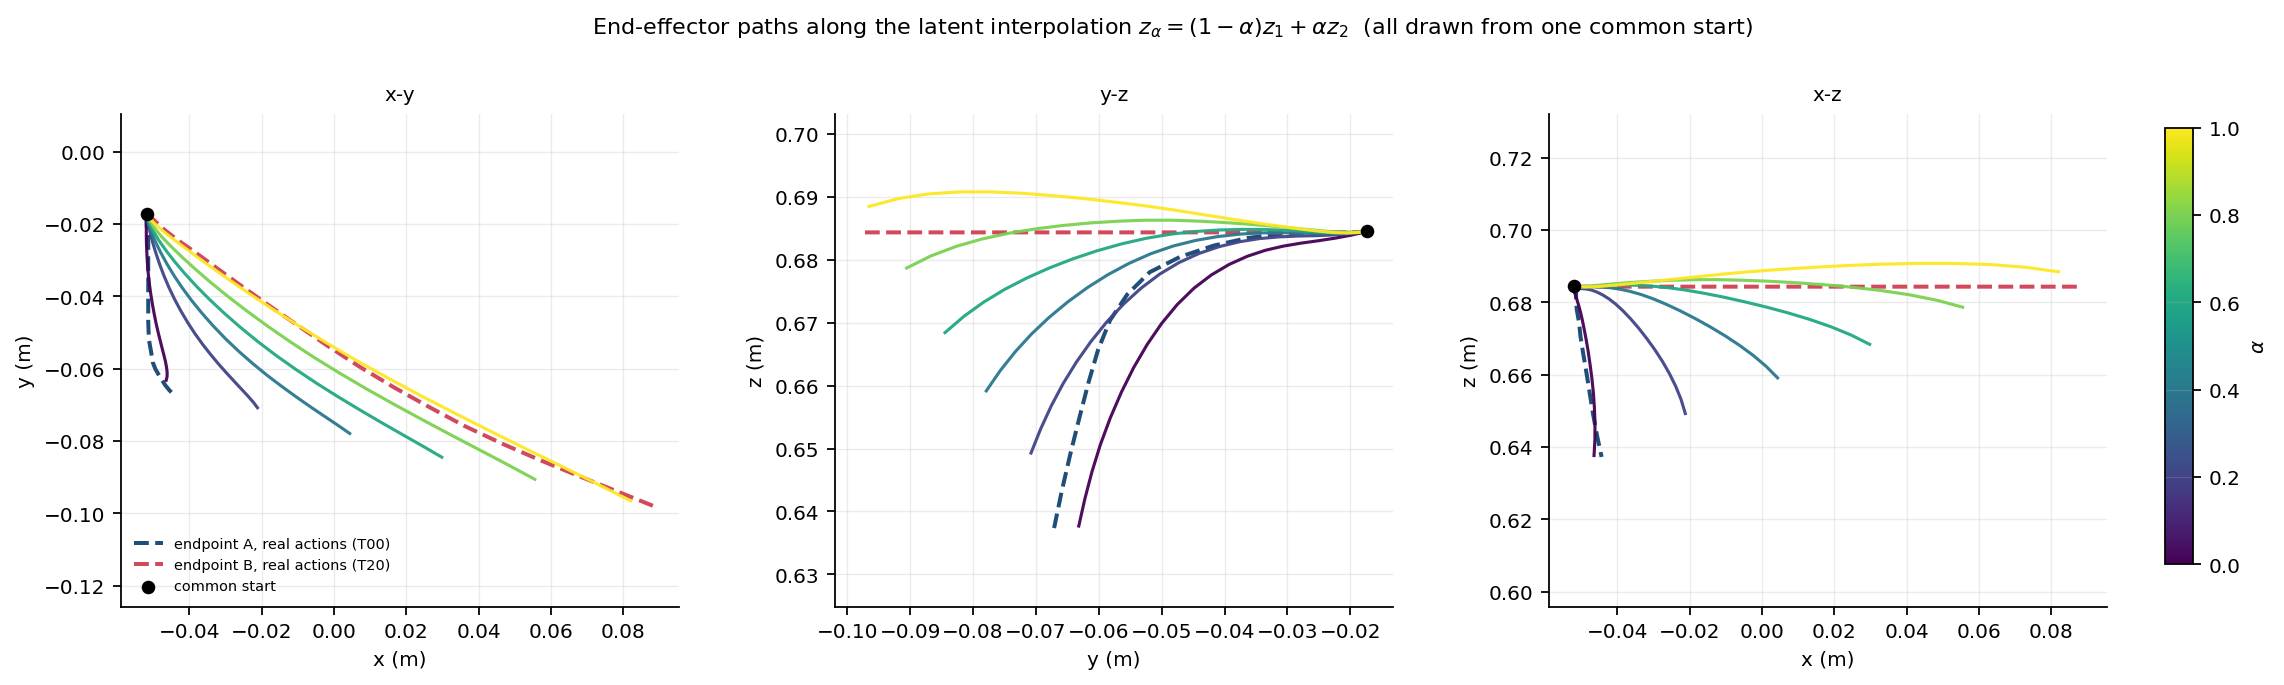
- 取两条不同 task 的真实轨迹 A 1 , A 2 A_1, A_2 A1,A2,编码得到 z 1 , z 2 z_1, z_2 z1,z2,在线段上线性插值
z α = ( 1 − α ) z 1 + α z 2 , α ∈ [ 0 , 1 ] z_\alpha = (1 - \alpha) z_1 + \alpha z_2, \qquad \alpha \in [0, 1] zα=(1−α)z1+αz2,α∈[0,1]
- 代码就是两行加权,注意
alpha是标量时可以直接广播
z1, z2 = encode(A1), encode(A2)                  # 各是 (16,)
z_alpha = (1 - alpha) * z1 + alpha * z2          # 标量乘向量,广播
traj = decode(z_alpha).reshape(20, 7)
- 各 α 解码出的轨迹叠在一起,颜色即 α,虚线是两条真实端点轨迹
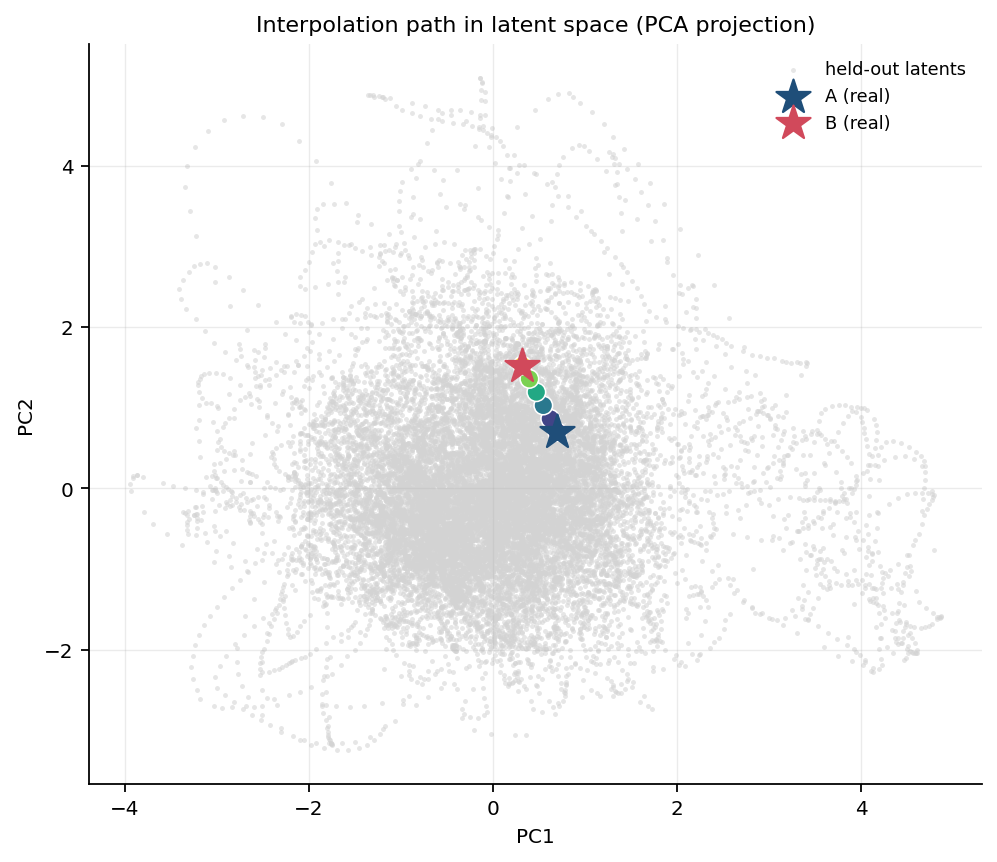
- 把插值路径投影到 PCA 平面上,灰色背景是验证集潜变量分布
- 选的两条轨迹是 task
T00(放杯子)与 taskT20(拿橙汁)
| 量 | 值 |
|---|---|
| ∥ z 1 − z 2 ∥ \lVert z_1 - z_2 \rVert ∥z1−z2∥ | 2.768 |
| 相邻 α 之间的解码变化量 | 0.605 / 0.633 / 0.626 / 0.639 / 0.650 |
| 端点重构 RMSE(A / B) | 0.0653 / 0.0432 |
| 末端路径长度随 α | 72 / 77 / 90 / 110 / 132 / 156 mm |
- 解码变化量的最大值与最小值之比是 1.074,几乎是均匀的
4-7-1 插值检验的是潜空间的什么性质
- 这个指标检验的是潜空间的连续性与凸性
- 如果潜空间是"碎"的,点与点之间是空洞,中间 α 解码出来的轨迹会变得毫无意义,动作乱跳、幅度爆炸或者塌成一条直线
- 变化量突变则说明潜空间里存在断层,跨过断层时解码结果会跳变
- 实测变化量基本均匀,说明两点之间没有断层,中间 α 解码出来的都是合法的动作序列,不是噪声
- 末端路径长度随 α 单调递增,说明从 A 的动作形状到 B 的动作形状是连续变形过去的
- 这一条性质在机器人领域价值很高:它是"技能插值"与"技能组合"的前提,也是后面 Diffusion Policy 能被用作数据增强的原因
4-8 把动作积分成末端空间轨迹
- 前面五组图画的都是 action 对 t,但一条轨迹好不好,最终要看机械臂在空间里怎么动
- 所以每个实验都额外出一张笛卡尔空间的末端轨迹图
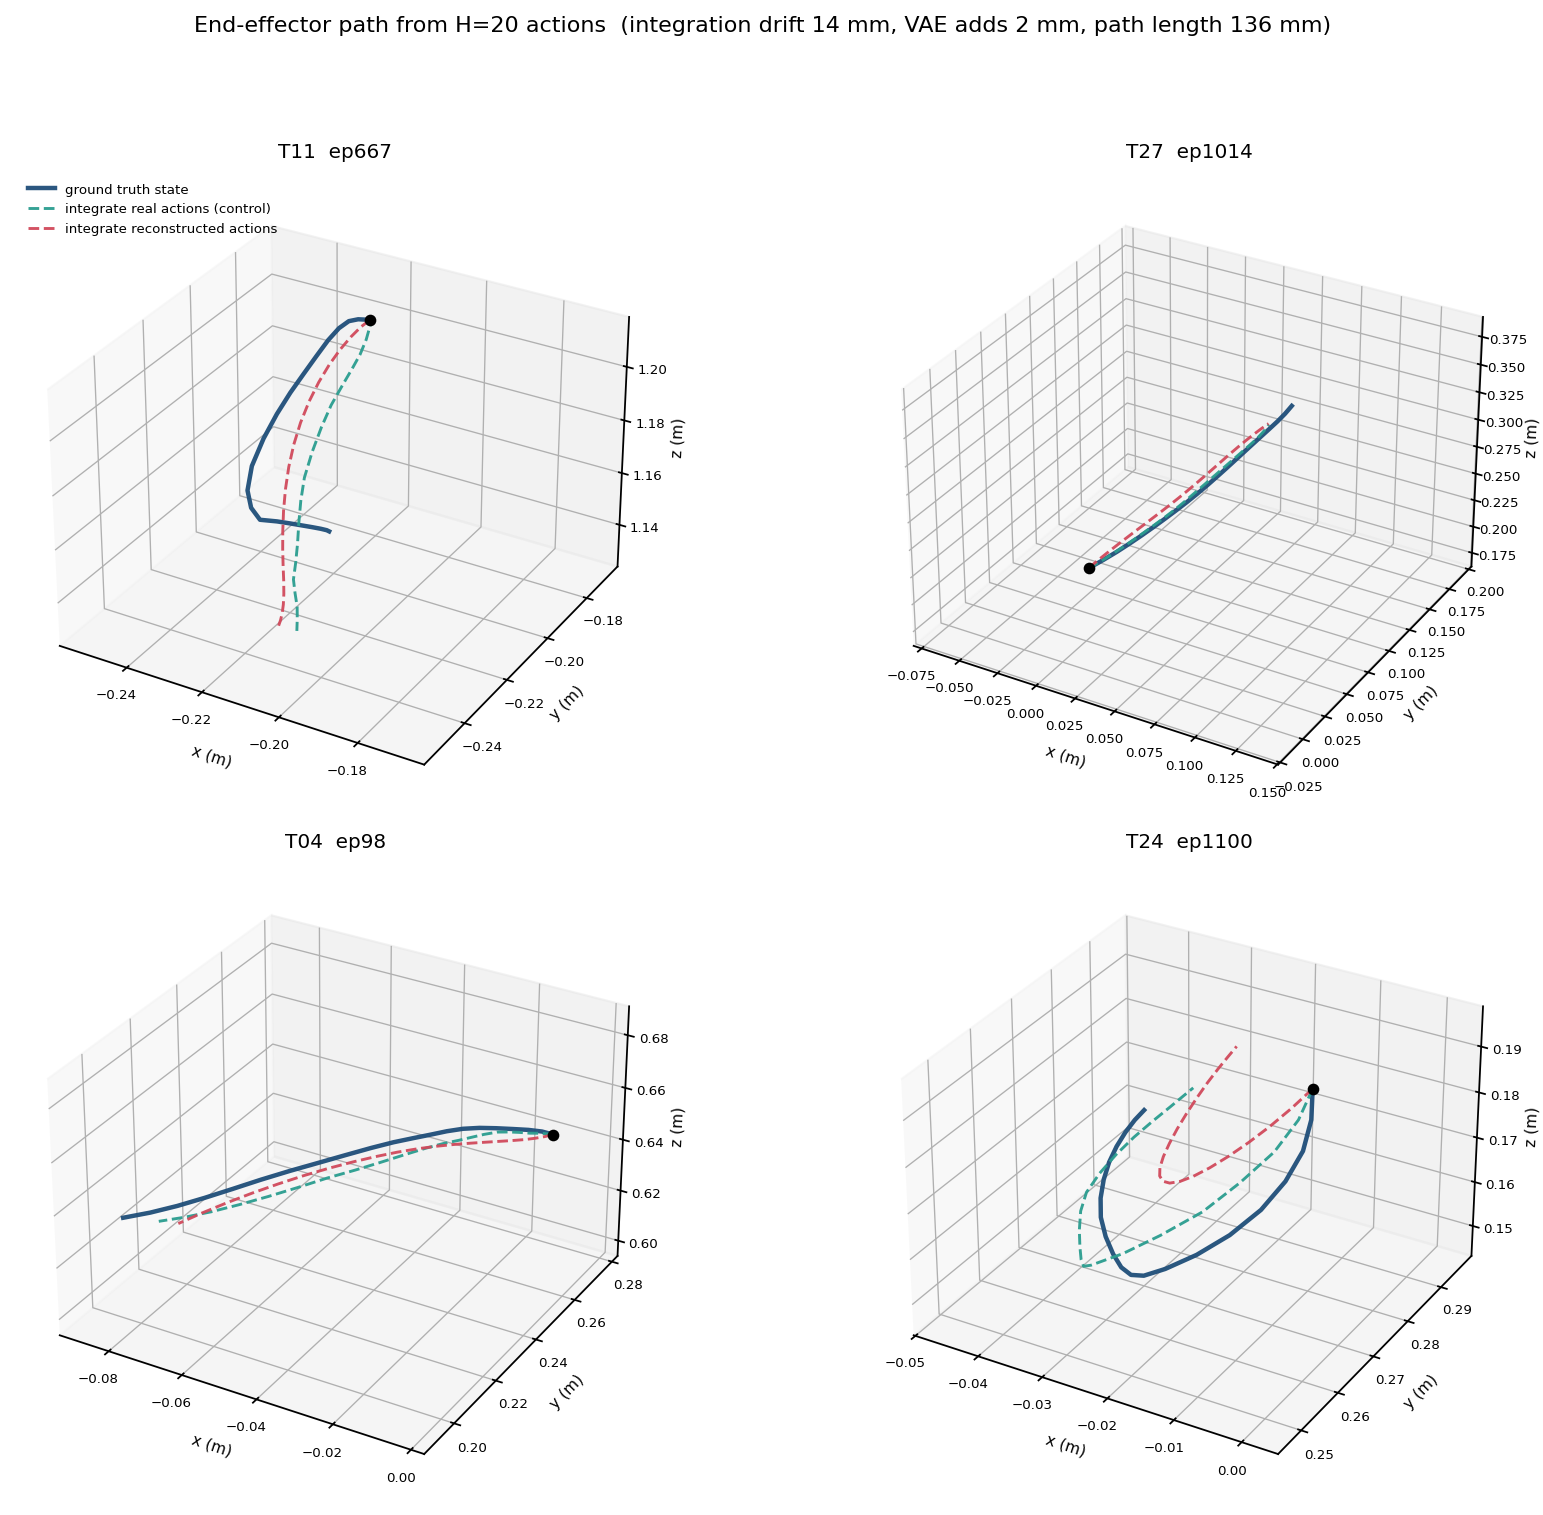
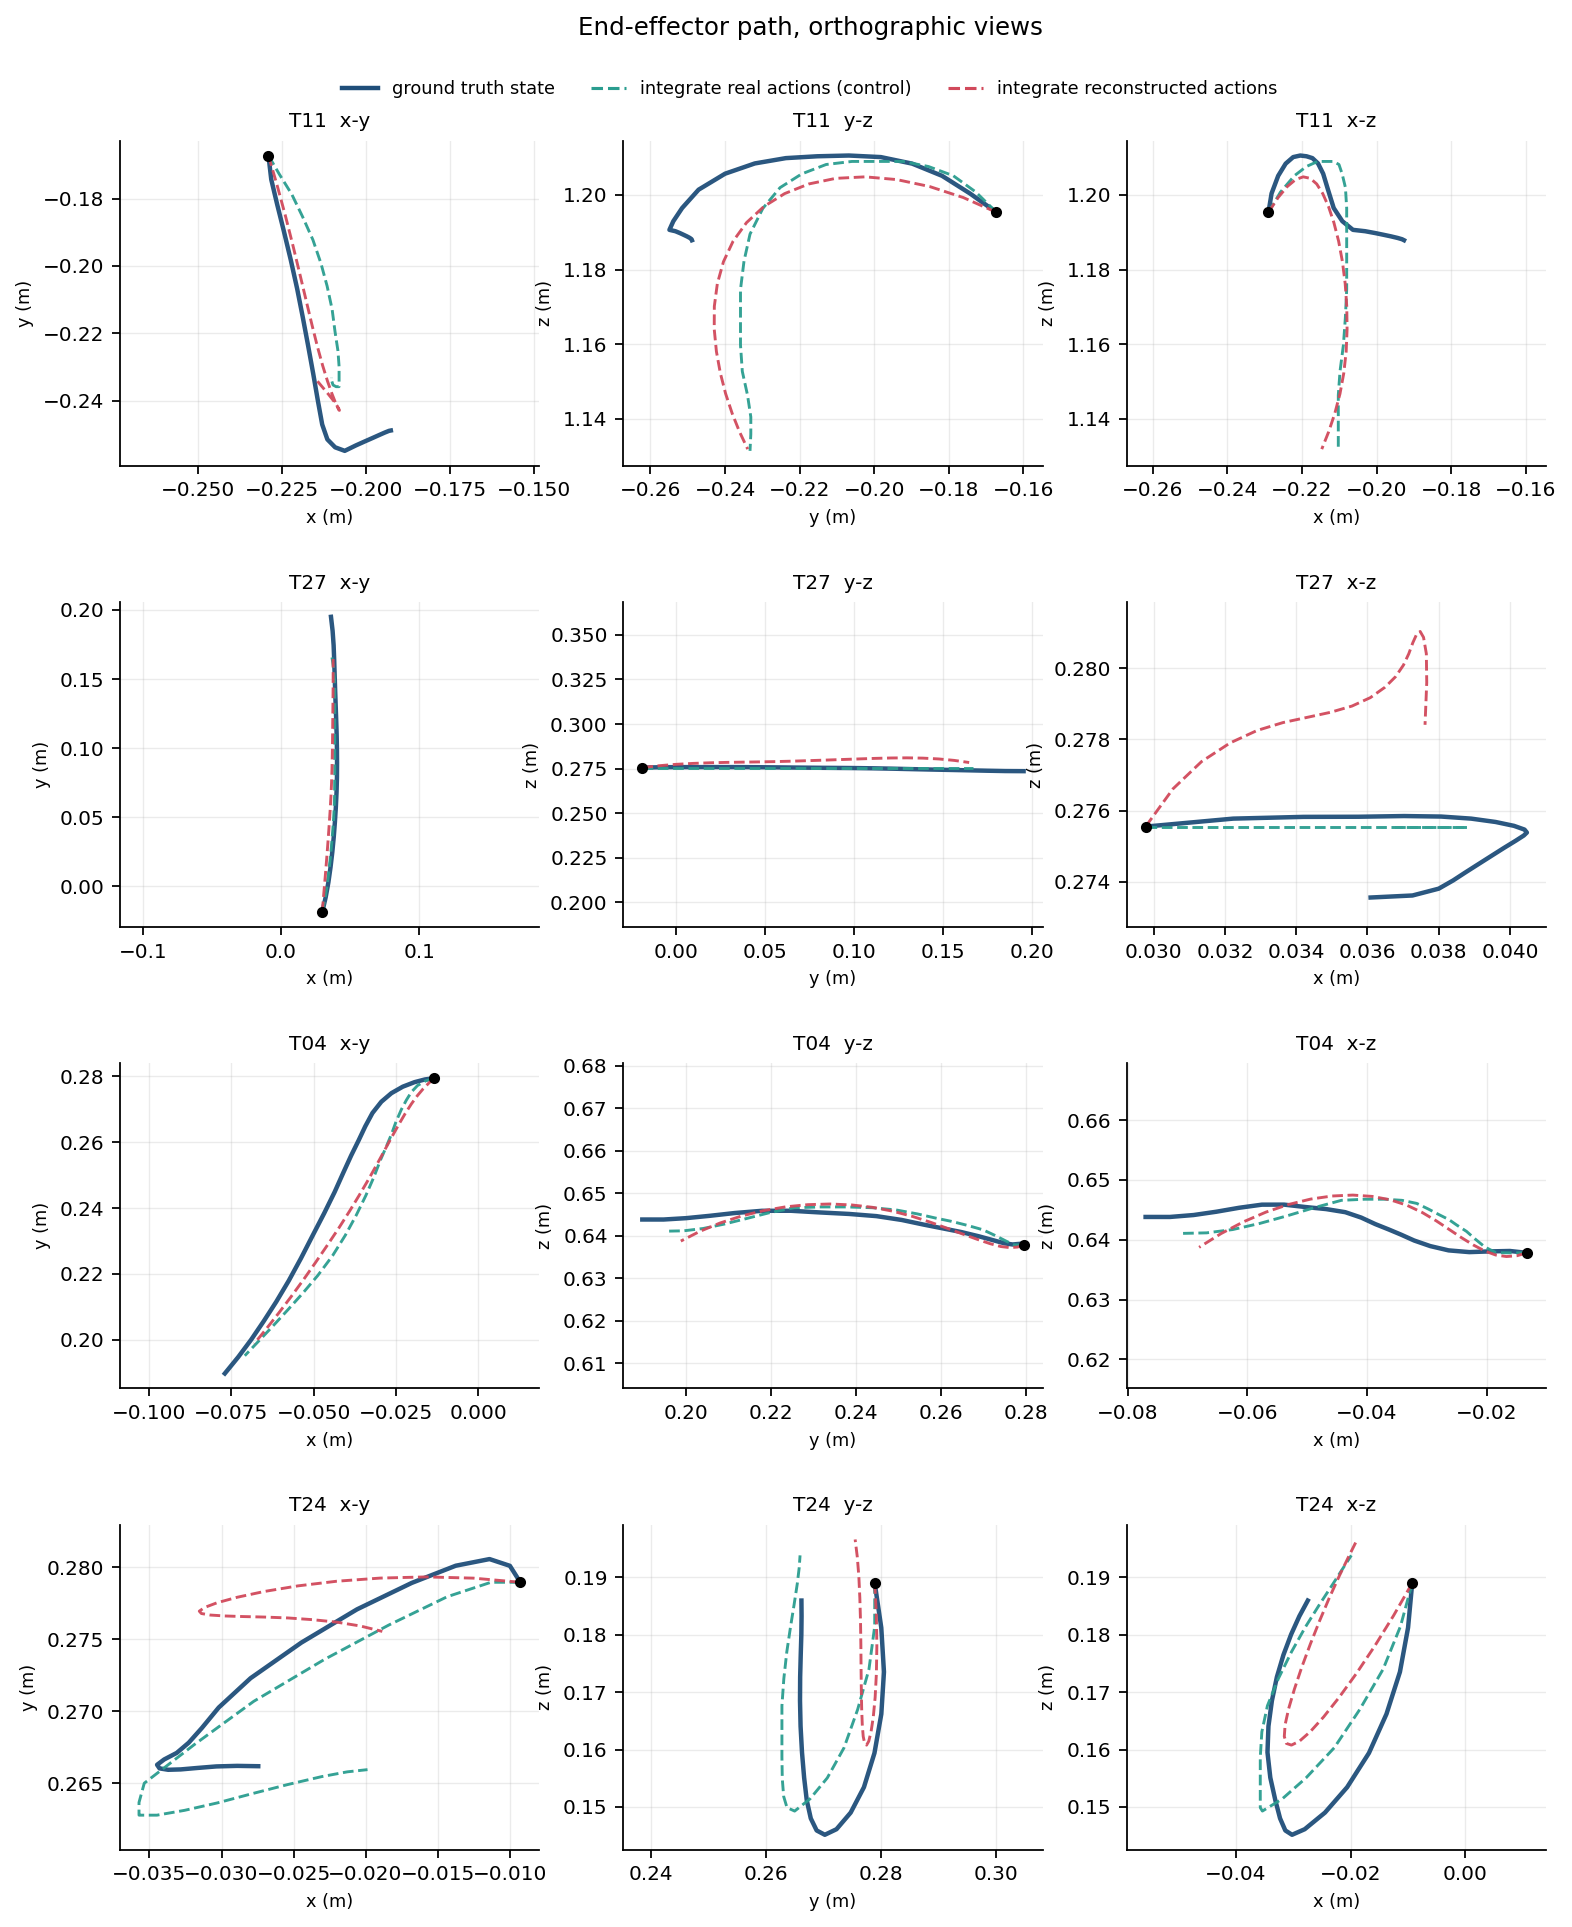
4-8-1 动作尺度 k 为什么必须拟合
- 这里遇到第一个真正的方法问题:LIBERO 的 action 是增量,不是位姿
action[t] = [dpos(3), drot(3), gripper(1)],dpos是"这一步末端要往哪个方向挪一点",不是绝对坐标- 所以画轨迹必须做一次累加
p t + 1 = p t + k ⋅ a t , : 3 p_{t+1} = p_t + k \cdot a_{t,:3} pt+1=pt+k⋅at,:3
- 难点在 k k k,也就是"一个动作单位等于多少米"
- 这个数数据集里没有给,因为它是控制器的性质,不是这个场景的性质
- 所以不能写死一个常数,正确的做法是从训练集 episode 上用最小二乘拟合
k ⋆ = arg min k ∑ t ∥ ( p t + 1 − p t ) ⏟ 真实位移 − k ⋅ a t , : 3 ∥ 2 = ∑ t a t , : 3 ⊤ ( p t + 1 − p t ) ∑ t a t , : 3 ⊤ a t , : 3 k^\star = \arg\min_k \sum_{t} \big\lVert \underbrace{(p_{t+1} - p_t)}_{\text{真实位移}} - k \cdot a_{t,:3} \big\rVert^2 = \frac{\sum_t a_{t,:3}^\top (p_{t+1} - p_t)}{\sum_t a_{t,:3}^\top a_{t,:3}} k⋆=argkmint∑ 真实位移 (pt+1−pt)−k⋅at,:3 2=∑tat,:3⊤at,:3∑tat,:3⊤(pt+1−pt)
# trajvae/data.py: fit_action_scale
num += (cmd * delta).sum()      # cmd 是真实动作的前三维,delta 是真实位置差
den += (cmd * cmd).sum()
return num / den                # k 约等于 0.011346 m/unit
-
起点 p 0 p_0 p0 直接取
observation.state的前三维,那是真实的末端位置,只对增量做积分 -
拟合出的 k = 0.011346 k = 0.011346 k=0.011346 m/unit,这个值会存进 checkpoint 与
metrics.json -
这个近似有多准? 用真实动作积分出来的路径,和真实末端位置对一下,训练前会打印
-
漂移是随步数累积的,所以必须分尺度看,混在一起讲会得出完全相反的结论
| 尺度 | 积分漂移 | 加上 VAE 误差 | 参照长度 |
|---|---|---|---|
| 单窗口(H=20) | 13.5 mm | 15.0 mm | 路径 136 mm |
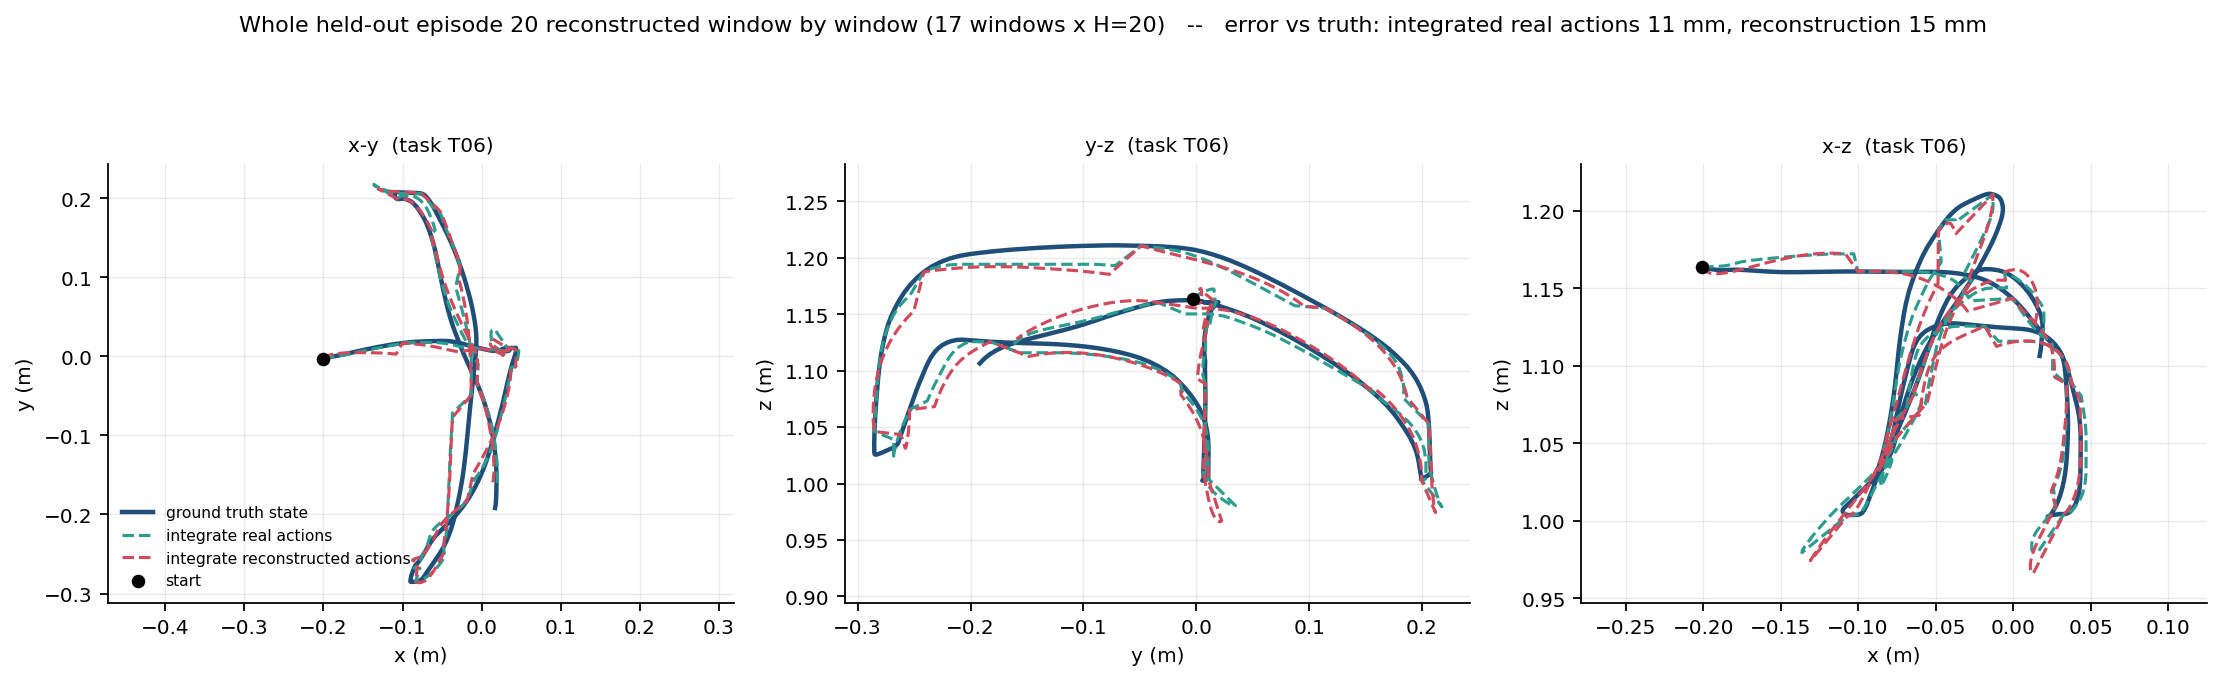
| 整段 episode,逐窗口重锚定 | 11.1 mm | 14.5 mm | 无 |
| 整段 episode,从头连续积分 | 87.5 mm | 无 | 净位移 326 mm |
- 整段 episode 连续积分时,RMSE 87.5 mm,端点误差 97.5 mm,占净位移 326 mm 的 30%,单步漂移率 0.54 mm 每步
- 也就是说:积分本身就有可观漂移,来源是增量控制的量化误差与夹爪开合期间的零点漂移
- 一个 20 步窗口内约占路径的 10%,但跨几十步就会累积到净位移的 30%
这正是不把整段 episode 的原始积分直接画出来的原因:漂移会把图彻底画歪。
h20_z16_12_trajectory_episode.png里每个窗口都用自己的真实起点重新锚定,才把漂移压回窗口尺度,让 VAE 的误差显出来。
4-8-2 三条控制线分别隔离了什么
- 上面那个表说明了一件事:画出来的红线偏了,不能直接算成 VAE 的错
- 误差有两个来源,必须设计一组对照才能分开,所以每张轨迹图都同时画三条线
| 线 | 含义 |
|---|---|
实线 ground truth state | observation.state 里的真实末端位置 |
虚线 integrate real actions | 对真实动作积分,隔离出积分漂移 |
虚线 integrate reconstructed actions | 对 VAE 重构的动作积分,漂移与模型误差都在里面 |
-
虚线与实线的差距是积分漂移,两条虚线的差距才是 VAE 自己的误差
- 没有中间这条控制线,我们无法判断一条画歪了的线上到底是模型的问题还是积分的问题
- 实测结论很明确:单窗口上积分漂移 13.5 mm,VAE 只额外贡献 1.5 mm,约占总误差的十分之一
- 空间轨迹的误差主要来自积分,不是来自 VAE
-
把一整个 episode 的 17 个窗口拼起来,单个 20 步窗口只有几厘米,看不出任务结构,拼完能看见完整的"伸过去、夹住、抬起来、放下"
- 先验采样出的 8 条轨迹,叠在 80 条真实窗口上,都从同一个起点画起,形状可以直接比较
-
沿 z α z_\alpha zα 插值出来的末端路径,可见从 A 的动作形状连续变形成 B 的
-
采样的末端路径长度 129.8 mm,真实是 165.2 mm,同样反映第 4-6 节说的幅度偏小
因为 k k k 是拟合出来的,
integrate_paths的绝对尺度依赖它,换数据集要重新拟合。不要把这个数当成常数写进代码,本项目把它存进了 checkpoint。
4-9 β 消融:KL 权重到底在权衡什么
- 这是全文最能说明"VAE 为什么是生成模型"的一组实验
- 同数据、同随机种子、同架构,只改
model.beta,各训一次
./run_beta_sweep.sh                          # beta 取 0.1 与 4.0,各训加评测加对比,约 8 分钟
BETAS="0.01 0.1 1 10" ./run_beta_sweep.sh    # 换成别的 beta 组合
- β 等于 1.0 不重训,它就是默认配置,已经在
runs/h20_z16训好了,脚本直接复用
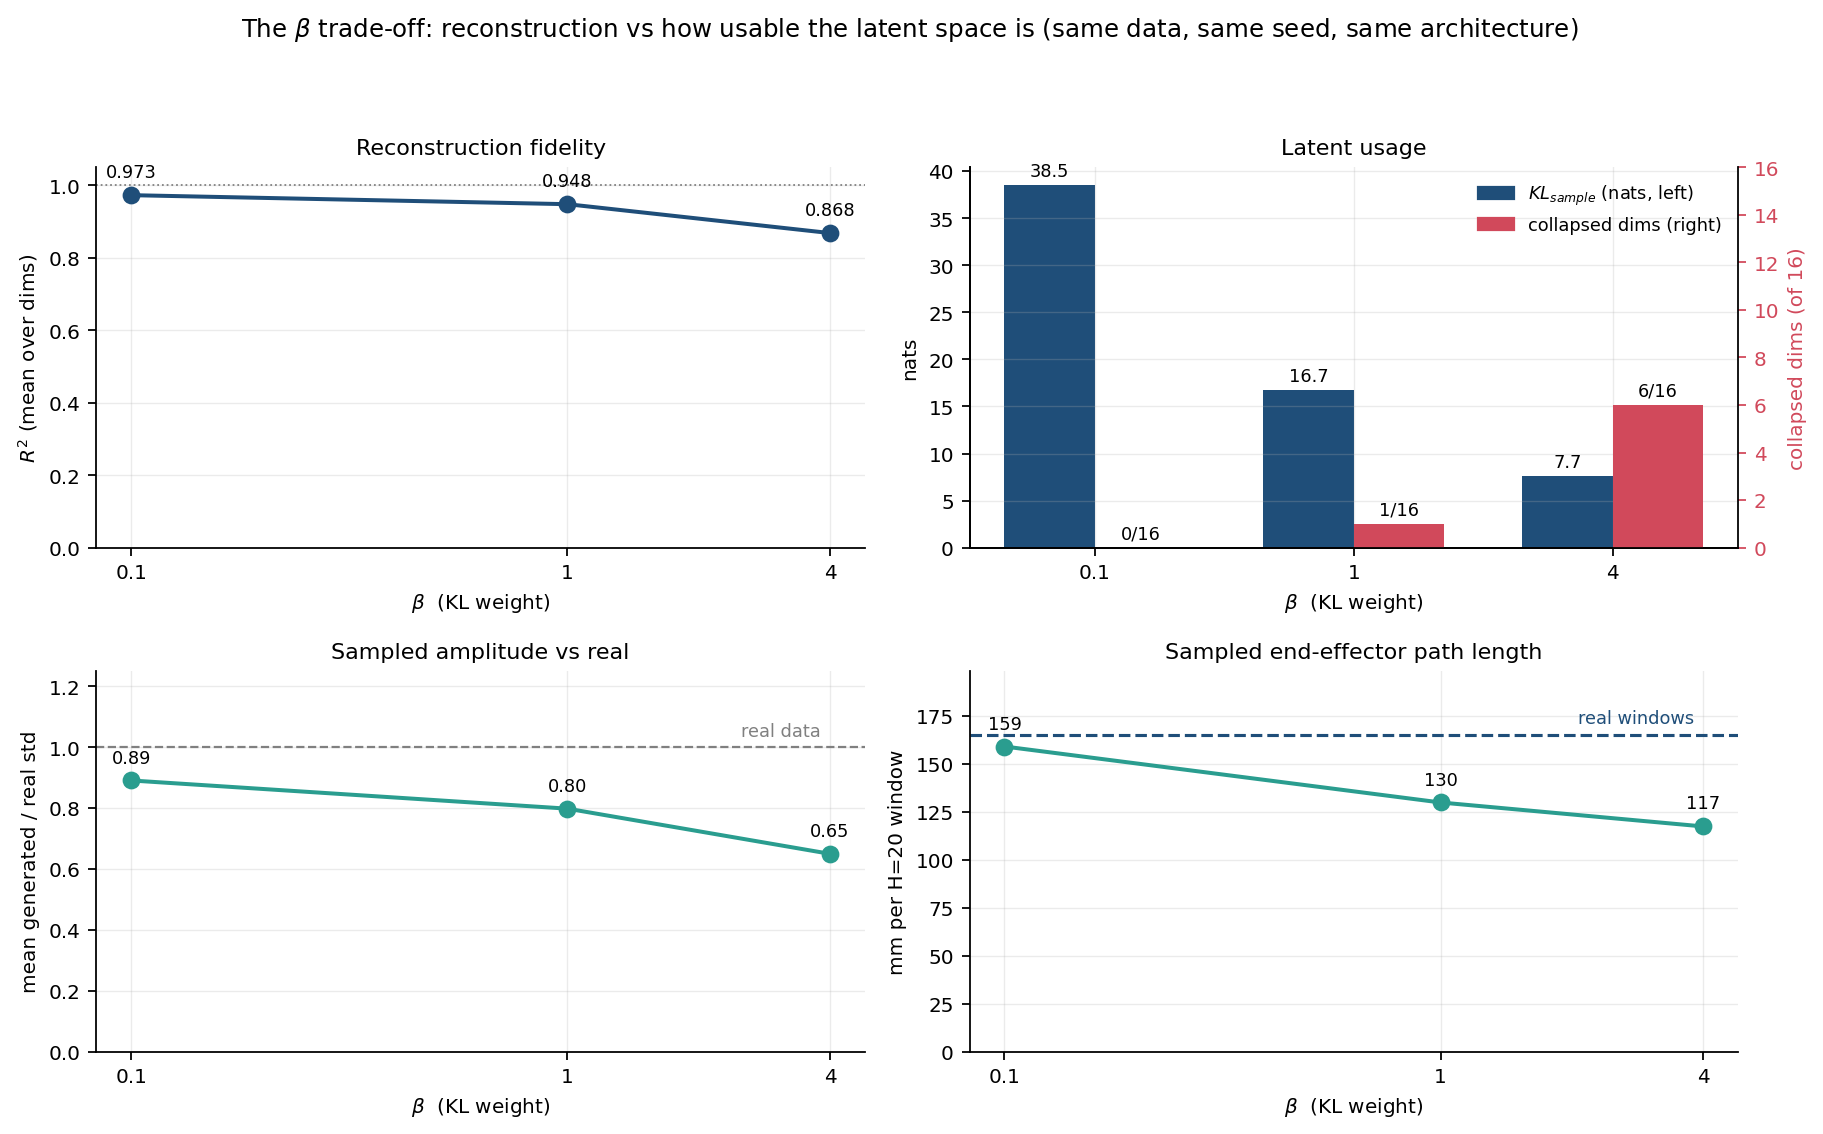
| β | 重构 R 2 R^2 R2 | K L sample KL_{\text{sample}} KLsample | 塌缩维度 | 生成 / 真实幅度 | 跨维相关 r | 采样路径长度 |
|---|---|---|---|---|---|---|
| 0.1 | 0.973 | 38.5 | 0/16 | 0.89 | 0.532 | 159 mm |
| 1.0 | 0.948 | 16.7 | 1/16 | 0.80 | 0.657 | 130 mm |
| 4.0 | 0.868 | 7.7 | 6/16 | 0.65 | 0.510 | 117 mm |
| 真实 | 无 | 无 | 无 | 1.00 | 无 | 165 mm |
- 三个趋势
- β 变大,重构变差, R 2 R^2 R2 从 0.973 掉到 0.868。β 趋近 0 就退化成普通自编码器AE
- β 变大,潜空间更"规矩", K L sample KL_{\text{sample}} KLsample 从 38.5 降到 7.7,后验更贴近先验
- β 变大,塌缩维度变多,从 0 个到 1 个再到 6 个
说人话:这两项是此消彼长的。你想要潜空间更像标准正态,数据的还原就不准;你想还原得更准,潜空间就不像标准正态。 β \beta β 就是拧这两个方向的旋钮。
- 第三条解释了幅度那一行:β 等于 4 时 16 维里有 6 维是死的,解码器能用的信息变少,于是它对任何
z
z
z 都输出"平均轨迹"
- 幅度收缩到真实的 0.65,末端路径只剩 117 mm
- 所以"生成得不够多样"不是玄学,是后验塌缩的可测量后果
- β 等于 0.1 时 0 维塌缩,幅度 0.89、路径 159 mm,最接近真实
- 代价是 K L sample = 38.5 KL_{\text{sample}} = 38.5 KLsample=38.5,潜空间离先验很远,理论上 z ∼ N ( 0 , I ) z \sim \mathcal{N}(0,I) z∼N(0,I) 采样已经"出分布"了
- 但它仍然采得出合理轨迹,因为边缘分布依然贴合先验, K L agg KL_{\text{agg}} KLagg 只有 0.033
- 这正好再次说明第 3-9 节那个结论:能不能采样,看的是聚合后验,而不是单个后验有多贴近先验
- 没有免费的午餐:β 等于 1 在跨维协调性上最好, r = 0.657 r = 0.657 r=0.657,另外两个 β 都更差
- β 也影响插值的端点保真度,方向和重构一致
| β | 0.1 | 1.0 | 4.0 |
|---|---|---|---|
| 插值两端点偏离真实路径 | 2.9 / 2.6 mm | 6.4 / 5.3 mm | 11.9 / 18.5 mm |
- 这组实验也证明了可复现性:删掉两个 β 的运行目录后从头重跑,验证损失 8.795 与 61.850、 R 2 R^2 R2、KL、幅度、路径长度全部逐位重现
4-10 评估代码
- 4-4 到 4-8 报出来的每一个数字,都是下面这几段算出来的。方法本身在上面各节都讲过了,这一节只把代码补齐,让这些数字能被独立复算
- 4-9 的 β 消融没有新代码,它就是把这套评估在四个 run 上各跑一遍(第 4-10-6 节)
- 先说一条贯穿始终的约定:所有指标都在验证集上算,编码时用后验均值
μ
\mu
μ,不用采样出来的
z
z
z
- 用均值是确定性的,同一个输入永远给同一个输出,图和数都能复现
- 也把采样噪声从指标里摘了出去:这里要量的是"模型学到了什么",不是"这一次抽签抽得怎么样"
4-10-1 编码与解码
@torch.no_grad()
def encode_mu(model, x_norm, device, batch=4096):
    """编码到后验均值 mu,确定性,所以图和数都可复现"""
    model.eval()
    out = []
    for s in range(0, len(x_norm), batch):
        chunk = torch.from_numpy(x_norm[s : s + batch]).to(device)
        mu, _ = model.encode(chunk)
        out.append(mu.cpu().numpy())
    return np.concatenate(out, axis=0)


@torch.no_grad()
def encode_stats(model, x_norm, device, batch=4096):
    """返回每个样本后验的均值与方差,算逐维 KL 要用"""
    mus, vars_ = [], []
    for s in range(0, len(x_norm), batch):
        chunk = torch.from_numpy(x_norm[s : s + batch]).to(device)
        mu, logvar = model.encode(chunk)
        mus.append(mu.cpu().numpy())
        vars_.append(logvar.exp().cpu().numpy())
    return np.concatenate(mus), np.concatenate(vars_)


@torch.no_grad()
def decode_raw(model, z, scaler, device, window, batch=4096):
    """解码成物理单位的轨迹,形状 (N, H, D)"""
    out = []
    for s in range(0, len(z), batch):
        chunk = torch.from_numpy(np.asarray(z[s : s + batch], dtype=np.float32)).to(device)
        out.append(model.decode(chunk).cpu().numpy())
    return scaler.inverse_traj(np.concatenate(out, axis=0), window)
- 分 batch 是因为验证集有两万多个窗口,一次前向会占满显存,分批和不分批的结果完全一样
decode_raw里inverse_traj那一步把拉平的(N, 140)先拆回(N, 20, 7),这样(7,)的mean/std才能广播到最后那一维
4-10-2 重构指标
def per_dim_r2(real, recon):
    """R^2 per action dimension over the whole evaluation set."""
    ss_res = ((real - recon) ** 2).sum(axis=0)
    ss_tot = ((real - real.mean(axis=0)) ** 2).sum(axis=0)
    return 1.0 - ss_res / np.maximum(ss_tot, 1e-12)


# real_all / recon_all 都是 (N, H, D) = (20000, 20, 7),且都已反归一化
rmse_raw_per_dim = np.sqrt(((real_all - recon_all) ** 2).mean(axis=0))    # (H, D)
r2_per_dim = per_dim_r2(real_all, recon_all)                            # (H, D)
rmse_raw_mean = float(np.sqrt(((real_all - recon_all) ** 2).mean()))     # 一个标量
r2_mean = float(r2_per_dim.mean())
real_all是验证集里随机抽的 20000 个窗口,recon_all是它们过模型再反归一化的结果,两者形状都是(20000, 20, 7)- 求和只压掉了
axis=0也就是样本维,所以两个结果是(20, 7)而不是(7,):20 个时间步各 7 个动作维度,一共 140 格 - 4-4 表里那两行是再沿时间步取一次平均得到的,即
r2_per_dim.mean(axis=0)与rmse_raw_per_dim.mean(axis=0),各有 7 个数 r2_mean是 140 格的总平均,也就是表里"平均 R 2 = 0.948 R^2 = 0.948 R2=0.948"那个数。它和"逐维 R 2 R^2 R2 再平均"不完全相等,因为每个时间步的方差不一样- 两个 RMSE 都在物理动作单位上算,因为
inverse_traj已经把归一化撤掉了 - 4-4 正文里"反归一化之后是 0.096"那句,就是这里的
rmse_raw_mean - 顺带说清楚另一处容易混的:训练收尾时写进
summary.json的final_val_rmse_raw大约是 0.072,它不是这个数- 那个数在训练循环里另算:先把归一化空间的逐格 RMSE 乘回该维的
std,再对 140 格取平均,见trajvae/train.py的evaluate - 它是对整块验证集的逐格平均,这里是子采样两万窗口后的池化 RMSE,两者不是同一个量,不要拿来互相核对
- 那个数在训练循环里另算:先把归一化空间的逐格 RMSE 乘回该维的
4-10-3 潜空间指标
- 逐样本 KL 就是损失里那一项,逐维算完在样本维取平均
mu_s, var_s = encode_stats(model, val_norm, device)          # 都是 (N, L)

# KL_sample:每个样本的后验对先验的 KL,再对样本取平均
kl_sample = 0.5 * (mu_s**2 + var_s - np.log(np.maximum(var_s, 1e-12)) - 1.0).mean(axis=0)
- 聚合后验 q ( z ) q(z) q(z) 是高斯混合,它的矩要按全方差公式算,两行都不能少
# E[z]  = mean(mu_i)
# Var[z] = mean(var_i) + var(mu_i)      <- 组内 + 组间,缺了第一项就全错
mu_all  = mu_s.mean(axis=0)
var_all = var_s.mean(axis=0) + mu_s.var(axis=0)

# 高斯混合没有闭式 KL,这里算的是矩匹配高斯对先验的 KL
kl_agg = 0.5 * (mu_all**2 + var_all - np.log(np.maximum(var_all, 1e-12)) - 1.0)

# 画直方图要从每个样本自己的后验里抽一次,这才是聚合后验的真实样本
z_agg = mu_s + np.sqrt(var_s) * rng.standard_normal(mu_s.shape)
var_s.mean(axis=0)是组内方差,mu_s.var(axis=0)是组间方差。漏掉第一项,每个维度都会变成一根尖峰,塌缩维的 KL 会被算成无穷大- 直方图这里有个更容易踩的坑:不能直接对
mu_s做直方图。那样得到的是"后验均值"的分布,宽度比真实的聚合后验小了 E [ σ ] \mathbb{E}[\sigma] E[σ],每一格的图都会画错 - PCA 散点是对
encode_mu出来的 16 维z做的,解释方差比 18.7% 指的是这一层,不是对 140 维动作做的 PCA
4-10-4 生成质量指标
# 时间连续性:相邻步变化量的平均,越大越抖。生成和真实各调一次
def smoothness(traj):
    """Mean absolute first difference per action dimension."""
    return np.abs(np.diff(traj, axis=1)).mean(axis=1)        # (N, H, D) -> (N, D)


torch.manual_seed(int(cfg.train.seed))                       # 固定种子,换台机器也是同一批样本
with torch.no_grad():
    z = torch.randn(n, model.latent, device=device)          # n = eval.n_generate = 8
    gen = scaler.inverse_traj(model.decode(z).cpu().numpy(), window)   # (n, H, D)

real = bundle["val"].x.astype(np.float32)                    # (23021, H, D)
gen_flat, real_flat = gen.reshape(-1, dim), real.reshape(-1, dim)

# 1. 动作幅度
std_real, std_generated = real_flat.std(axis=0), gen_flat.std(axis=0)
amplitude_ratio = std_generated / np.maximum(std_real, 1e-9)

# 2. 时间连续性
step_real, step_gen = smoothness(real).mean(axis=0), smoothness(gen).mean(axis=0)

# 3. 维度协调关系:7 乘 7 的跨维相关矩阵,真实与生成逐点对比
corr_real, corr_gen = np.corrcoef(real_flat.T), np.corrcoef(gen_flat.T)
off = ~np.eye(dim, dtype=bool)                               # 去掉对角线
corr_offdiag_r = float(np.corrcoef(corr_real[off], corr_gen[off])[0, 1])
- 三项各对应一个失效模式,缺一项就可能漏掉一类问题:只看幅度,看不出动作抖;只看幅度和平滑度,看不出维度之间配合得对不对
- 这里有一处统计上的注意事项:真实那一侧用了全部两万多个验证窗口,生成那一侧只有
n = 8条轨迹。8 条轨迹内部 20 步是相关的,等效样本量接近 8 而不是 160,所以幅度比这类数字的相对不确定度在两成左右- 换句话说,0.63 与 0.46 这种单个维度的比值,只能当"明显偏小"来读,不能当成两位有效数字
- β 消融那张表里的 0.89 / 0.80 / 0.65 是三条曲线各自的均值,趋势可信,但相邻两档之间的差距不宜过度解读
- 要让这几个数真正稳,把
eval.n_generate从 8 提到 256 再重跑run_experiments.py即可,其余代码不用动
4-10-5 插值指标
# 两条端点轨迹取自两个不同 task:task 列表里的第一个和中间那个
z_a = encode_mu(model, val_norm[idx_a : idx_a + 1], device)[0]       # (L,)
z_b = encode_mu(model, val_norm[idx_b : idx_b + 1], device)[0]

alphas = np.linspace(0.0, 1.0, steps)                                # steps = eval.interp_steps = 6
z_path = np.stack([(1 - a) * z_a + a * z_b for a in alphas])         # (steps, L)
decoded = decode_raw(model, z_path, scaler, device, window)          # (steps, H, D)

# 相邻 alpha 之间的解码变化量:突变说明潜空间里有断层
step_change = np.linalg.norm(np.diff(decoded, axis=0), axis=(1, 2))
# 实测 0.605 / 0.633 / 0.626 / 0.639 / 0.650,最大最小之比 1.074

# 末端路径长度,单位 mm。所有曲线都从同一个 origin 积分出来,
# 否则各自的起点不同,形状就没法直接比
interp_paths = integrate_paths(decoded, origin, scale)               # (steps, H+1, 3)
path_len = [np.linalg.norm(np.diff(p, axis=0), axis=1).sum() * 1000 for p in interp_paths]

# 解码路径偏离真实路径多少,同样在末端空间量。动作空间的 RMSE 说不出这件事,
# 单步很小的误差也能积分成肉眼可见的偏移
for tag, real_path, rec_path in (("A", path_a, interp_paths[0]), ("B", path_b, interp_paths[-1])):
    err = np.linalg.norm(rec_path - real_path, axis=1) * 1000        # (H+1,),单位 mm
    endpoint_error[tag] = {"mean_mm": err.mean(), "final_mm": err[-1], "max_mm": err.max()}
step_change那五个数就是 4-7 表里"相邻 α 之间的解码变化量"那一行,最大最小之比 1.074 也是从它来的path_len是 4-7 表里"末端路径长度随 α"那一行:72 / 77 / 90 / 110 / 132 / 156 mm- 这两个指标要一起看:
step_change几乎均匀,说明动作是平滑变形过去的;path_len单调变长,说明变的是形状而不是幅度。只看其中一个会得出相反的印象 - 端点误差必须在末端路径上量,不能在动作空间量,原因就是第 4-8 节那条:单步误差会累积
4-10-6 β 消融
- 4-9 没有单独的评估代码。它就是把上面四个实验在每一个 run 上各跑一遍,再把这些标量并排
- 所以
compare_betas.py做的事只有两件:读每个 run 目录下的metrics.json,按 β \beta β 排序后画成对比图 - 这也是为什么那组实验敢说"只改了 β":评估代码完全共用,任何一个数字的差异都只能来自训练
总结
- 本文从生成模型的基本概念出发,先讲清楚 AE 的结构与它为什么不能生成,再由这个缺口引出 VAE 的概率潜变量、重参数化、KL 散度与 ELBO 推导,最后用一套完整的机器人轨迹实验把这套理论跑通,并配合切片代码逐段对照了张量形状
- 核心要点回顾:
- 判别模型建模 p ( y ∣ x ) p(y \mid x) p(y∣x),生成模型建模 p ( x ) p(x) p(x),后者一旦学到,生成就是从分布里采样
- AE 的三处硬伤:损失里没有 p ( z ) p(z) p(z),潜空间有空洞,潜空间不连续。所以它只能重构,不能生成
- VAE 的关键改动只有一处:编码器输出从"一个点"变成"一个分布",即
μ
\mu
μ 与
log
σ
2
\log \sigma^2
logσ2 两路,再由切片
h2[:, :16]、h2[:, 16:]劈开 - 重参数化 z = μ + σ ⊙ ε z = \mu + \sigma \odot \varepsilon z=μ+σ⊙ε 把随机性挪到与参数无关的 ε \varepsilon ε 上,让采样这一步变得可导
- 损失是负 ELBO,由重构项与 KL 项组成,两项量纲要手动对齐,本项目是在 140 个输出维度与 16 个潜维度上分别求和
- 聚合后验 q ( z ) q(z) q(z) 是高斯混合,方差有组内与组间两项,缺一项会算出违反 Jensen 不等式的荒谬结果
-
K
L
sample
KL_{\text{sample}}
KLsample 判断维度是否塌缩,
K
L
agg
KL_{\text{agg}}
KLagg 判断能否采样,实测 16 维边缘全部贴合先验,但
z[7]依然塌缩 - β 消融给出了完整因果链:β 变大导致塌缩维度变多,塌缩维度变多导致生成幅度收缩,从 0.89 掉到 0.65
- 动作积分回笛卡尔空间时误差主要来自积分而非模型,单窗口漂移 13.5 mm,VAE 只额外贡献 1.5 mm
- 下一期我们会在此基础上进入 DDPM,看扩散模型是怎么把"一次采样"换成"逐步去噪"的,以及它为什么能在生成质量上超过 VAE
- 如有错误,欢迎指出!
- 感谢观看!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献28条内容

所有评论(0)