2026外滩大会物理智能圆桌深度解析:具身智能不能照搬数字AI路线(第一篇:概念入门)
前段时间很受关注的外滩大会,我们来聊一聊“具身智能”,VLA和世界模型
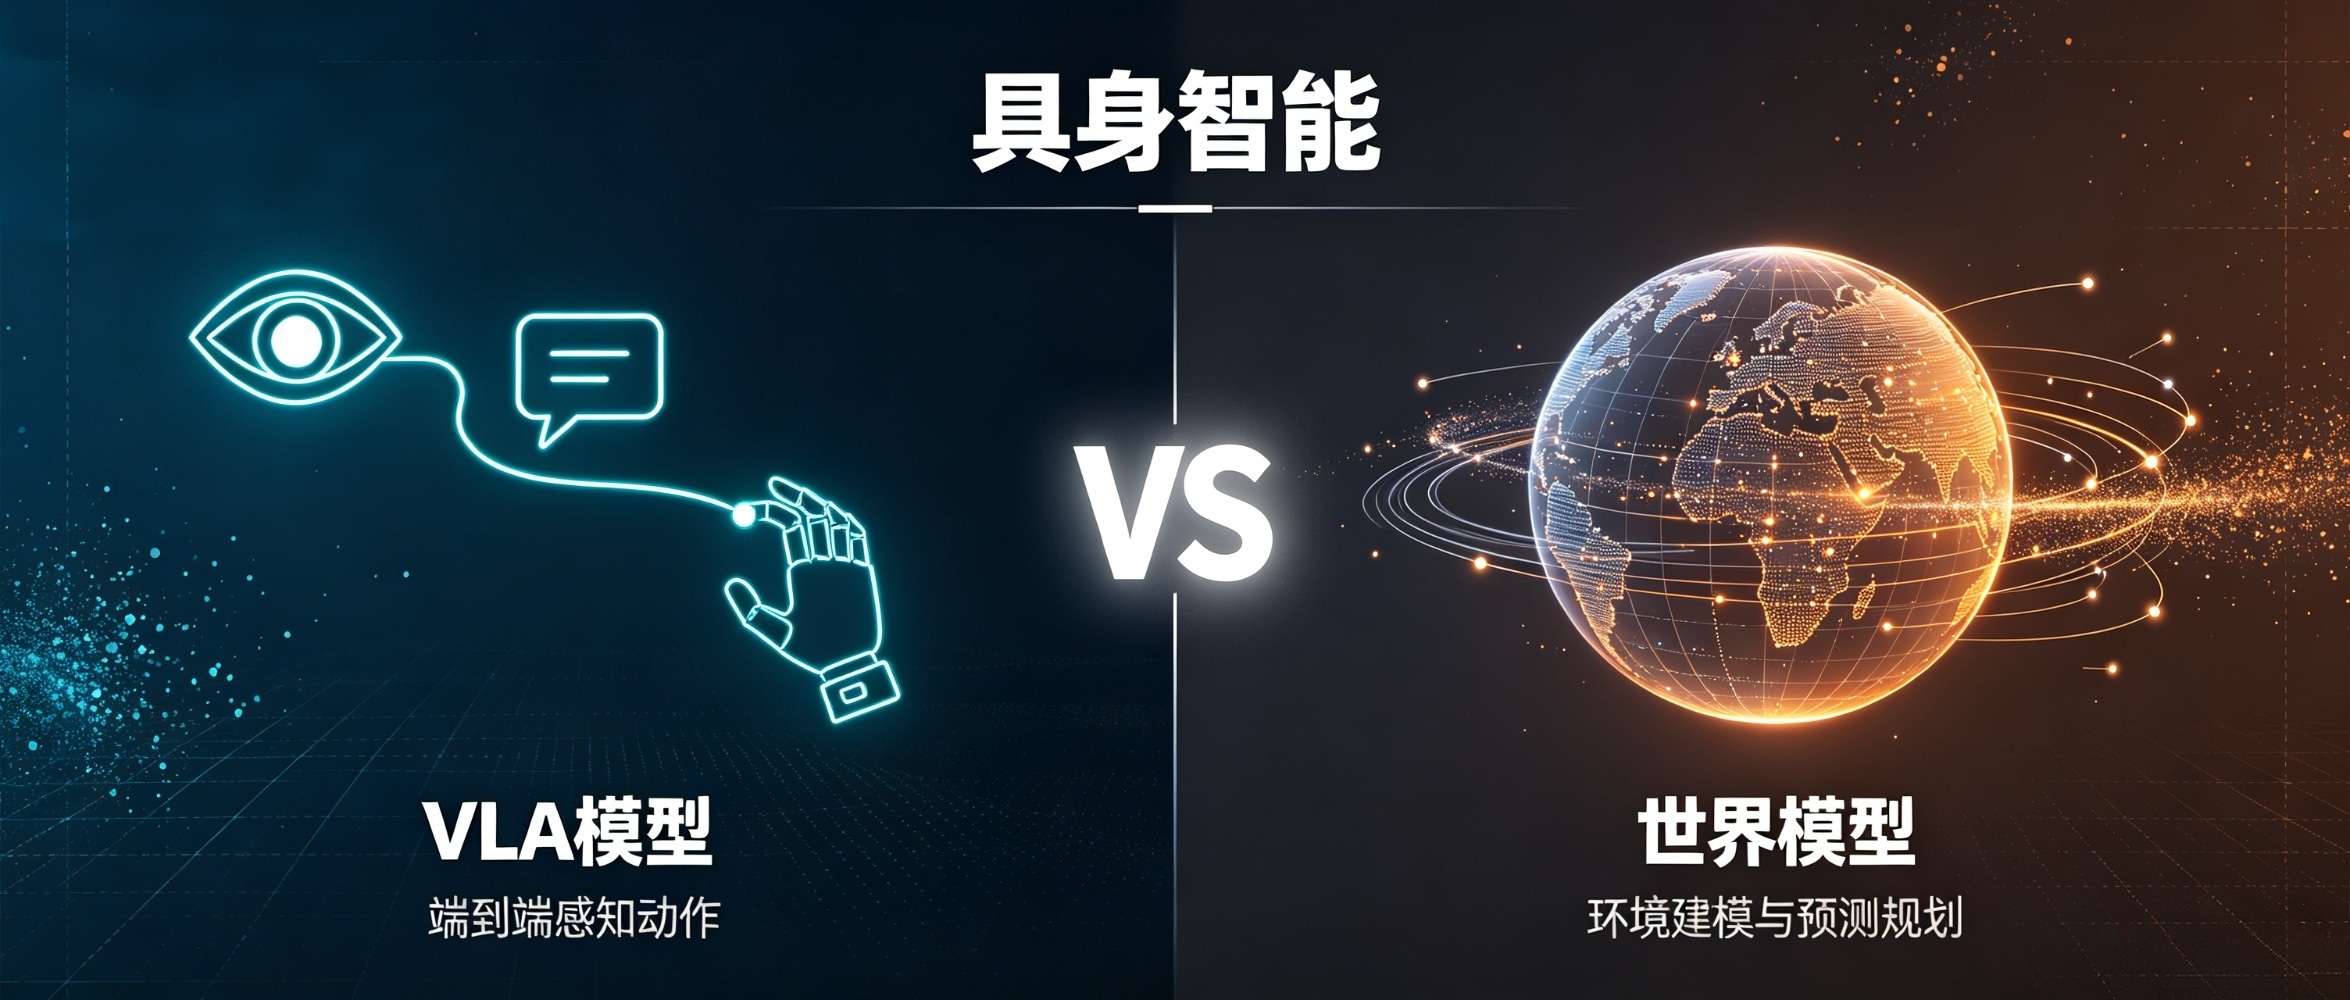
入门第一篇:
一、先搞懂一个大背景:具身智能是什么?
"具身智能"简单说,就是让AI拥有"身体",能在真实物理世界里干活。
以前的AI(比如ChatGPT)只活在屏幕里,你问它问题,它给你答案——它不需要"动手"。但具身智能不一样,它要操控机器人、机械臂、自动驾驶汽车,在真实世界里搬东西、拧螺丝、端杯子。
这就带来了一个全新的挑战:AI光"聪明"不够,还得"会动手"。
而VLA和WA,就是目前让机器人"会动手"的两条主流技术路线。
二、VLA是什么?——"靠嘴指挥手"的机器人
VLA = Vision(视觉)+ Language(语言)+ Action(动作)
你可以把VLA想象成一个**"会看、会听、会动手"的全能实习生**。
它的工作流程是这样的:
-
看(Vision):用摄像头观察周围环境,识别出杯子、桌子、人这些东西
-
听/想(Language):理解你说的话——"把那杯水端过来"是什么意思
-
做(Action):指挥机械臂伸手、抓住、端回来
它解决了什么问题?
以前的工业机器人,你得给它写死程序——"抬30厘米、左转15度、下降10厘米、抓"。换个杯子位置,它就傻了。
VLA的革命性在于:你直接用人话跟它说就行,不用编程。 而且换个场景、换个物体,它也能适应,因为它"理解"了你要干什么。
一句话记住VLA:靠语言理解来指挥动作的机器人大脑。
三、WA/WAM是什么?——"靠手感干活"的机器人
WA = World Action(世界动作),也叫WAM = World Action Model(世界动作模型)
你可以把WA想象成一个**"手上活特别好的老师傅"**。
老师傅干活不靠菜谱,靠的是手感——揉面知道用多大劲,颠锅知道翻多高,切菜知道下刀深浅。为什么?因为他干了几十年,脑子里对"物理世界怎么运转"有直觉了。
WA就是给机器人装了这么一个"老师傅的脑子":
-
它不纠结"这个东西叫什么名字"
-
它关心的是"我这么伸手过去,会不会碰倒杯子?""用这么大劲抓,鸡蛋会不会碎?"
-
它会在脑子里"预演"一下动作的后果,然后选最稳的方式出手
它解决了什么问题?
VLA机器人经常"手笨"——它知道要拿杯子,但手伸过去要么碰倒了、要么抓太轻掉了、要么抓太重捏变形了。因为它只"理解"了语义,没"掌握"物理。
WA补的就是这块短板:让机器人拥有物理直觉,手更稳、活更细。
一句话记住WA:靠物理直觉和预判来指挥动作的机器人大脑。
四、一张表秒懂区别
|
VLA(视觉-语言-动作) |
WA(世界动作模型) | |
|---|---|---|
|
像什么人 |
会说话的学霸 |
手艺好的老师傅 |
|
核心能力 |
听懂人话、理解语义 |
预判物理、手感精准 |
|
思维方式 |
"这是什么?该怎么做?" |
"这么干会怎样?怎么干最稳?" |
|
强项 |
听懂复杂指令、换场景也能干活 |
精密操作、应对突发变化 |
|
弱项 |
手上没数、容易"翻车" |
听不懂抽象指令、语义理解弱 |
|
类比 |
照着菜谱做菜的厨师 |
凭手感颠勺的大厨 |
五、为什么这两个词最近突然火了?
因为机器人行业正在经历一个关键转折——从"只能在工厂里按程序干活",走向"能在真实世界里灵活干活"。
2026年外滩大会上,蚂蚁灵波首席科学家沈宇军说了一句很到位的话:"具身可能会走跟数字世界相同的发展模式,但一定不会走相同的技术路线。"
什么意思?就是说,机器人会像手机、互联网一样普及,但不能直接把ChatGPT那套技术搬过来用。因为数字AI是"一问一答"的——你问它一个问题,它想一会儿给你答案。但机器人不行,它干活的时候眼睛不能闭、世界不会暂停,它必须边干边看边调整。
这就是VLA和WA正在解决的根本问题:怎么让AI在物理世界里也能"聪明地干活"。
如果本文对你有一点帮助,请点赞关注收藏,下一篇我们来深度分析技术原理以及行业深度场景。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)