《VLA 系列》五篇 VLA 轻量化与实时化 | 开源
让 VLA 跑得上、跑得动、跑得快:五篇轻量化与实时化工作全景解读
文章摘要
视觉-语言-动作(VLA)模型正在从"云端大模型"走向"机器人本体"。本文系统解读 2026 年五篇代表性的高效 VLA 工作,它们分别从不同层面回答同一个问题——如何让 VLA 在消费级/嵌入式硬件上实时运行:
- TurboVLA(模型架构层):砍掉 LLM 中枢,0.2B 参数在 RTX 4090 上跑到 32 Hz、显存 <1 GB;
- CoTinyVLA(训练监督层):用 CoT 蒸馏代替堆参数,0.9B 模型在 LIBERO-Plus 上反超最强 7B 基线 4.7~15.9 分;
- vla.cpp(推理引擎层):基于 llama.cpp 的 C++ 运行时,一个二进制服务 7 种 VLA 架构,从 RTX 3060 跑到 8 GB 的 Jetson Orin Nano;
- Reflex(系统调度层,ICML 2026):流式推理框架,50 Hz 稳定输出、推理加速 2.58×、峰值显存省 27%;
- Evo-Depth(感知增强层):0.9B 隐式深度增强策略,真机 90% 成功率、3.2 GB 显存 / 12.3 Hz。
阅读本文你将获得:五篇工作的核心思路与框架拆解、关键数据对比表、开源资源清单,以及一份"按场景选型"的实用指南。
关键词:VLA、具身智能、实时推理、流式推理、模型轻量化、边缘部署、GGUF、Flow Matching
目录
- 一、汇总分析:五条技术路线,一个共同目标
- 二、TurboVLA:去掉 LLM 的 V+L→A 直连范式
- 三、CoTinyVLA:用结构化监督代替堆参数
- 四、vla.cpp:一个 C++ 运行时统一七种 VLA
- 五、Reflex:把 Flow Matching VLA 变成流式系统
- 六、Evo-Depth:给轻量 VLA 补上"空间感"
- 七、总结与选型建议
一、汇总分析:五条技术路线,一个共同目标
1.1 全局思维导图
1.2 核心思路一句话总结
| 工作 | 层面 | 一句话思路 |
|---|---|---|
| TurboVLA | 模型架构 | 做减法:动作预测不必经过 LLM,视觉与语言特征直接双向交互后一次解码出动作块 |
| CoTinyVLA | 训练监督 | 做蒸馏:把 35B 教师的推理链(Plan/Think)蒸馏进 0.9B 学生,用监督结构换鲁棒性 |
| vla.cpp | 推理引擎 | 做移植:把 Python/PyTorch 技术栈编译成自包含 GGUF,无 Python 依赖跑在嵌入式板上 |
| Reflex | 系统调度 | 做流水:感知编码与动作去噪解耦成异步双流,KV 缓存三分区实现 O(1) 增量更新 |
| Evo-Depth | 感知增强 | 做加法(轻量的):从多视角 RGB 提取隐式深度,以 FiLM 调制方式注入空间信息 |
1.3 关键指标对比表
⚠️ 注意:各工作的评测基准与硬件不同,下表用于感知量级,不能直接横向判优劣。
| 维度 | TurboVLA | CoTinyVLA | vla.cpp | Reflex | Evo-Depth |
|---|---|---|---|---|---|
| 性质 | 新模型架构 | 小模型+训练方法 | 推理引擎(服务 7 种架构) | 推理系统(不改模型) | 新模型架构 |
| 参数量 | 0.2B | 0.9B | 0.45B~3B(被服务模型) | π0.5 / π0 / SmolVLA | 0.9B |
| 旗舰指标 | LIBERO 平均 97.7% | LIBERO-Plus 平均 86.4%(超 7B 基线) | SmolVLA 较 PyTorch 7.95× 加速 | 50 Hz 流式、加速 2.58× | LIBERO 95.4%、真机 90% |
| 延迟/频率 | 31.2 ms(32 Hz) | 稳态 1.37 s / 8 步 chunk | Orin Nano 上 84.76~458.84 ms/步 | 推理 135.2→52.4 ms | 12.3 Hz |
| 显存 | 0.9 GB(RTX 4090) | 2.25 GiB 峰值(L40S) | BitVLA 1.3 GiB 100% 成功 | 峰值 VRAM 省 27%(LIBERO) | 3.2 GB(RTX 4090D) |
| 目标硬件 | 消费级 GPU | 单卡 GPU | RTX 3060 → AGX Orin → Orin Nano | RTX 4090 + AgileX PiPer | RTX 4090D + xArm6 |
| 开源程度 | 代码+权重+训练 | 代码+权重+评测管线 | 代码+Demo+基准脚手架 | 代码(GitHub) | 代码+权重+训练脚本 |
1.4 统一视角:它们其实在解决同一个控制环路的不同段
【重点】五篇工作互不冲突、可以叠加:你完全可以用 TurboVLA 的架构、CoTinyVLA 的蒸馏数据、Reflex 的流式调度,最后部署在 vla.cpp 上。这正是"高效 VLA"赛道 2026 年的图景——架构、数据、系统、引擎四条线同时收敛。
二、TurboVLA:去掉 LLM 的 V+L→A 直连范式
2.1 简介
| 项目 | 内容 |
|---|---|
| 论文 | TurboVLA: Real-Time Vision-Language-Action Model at 32 Hz on an RTX 4090 with <1 GB VRAM(arXiv:2607.27205,2026.07) |
| 团队 | 华中科技大学 H-EmbodVis + 华为 |
| 代码 | https://github.com/H-EmbodVis/TurboVLA |
| 权重 | Hugging Face H-EmbodVis/TurboVLA |
| 项目主页 | https://H-EmbodVis.github.io/TurboVLA |
一句话:TurboVLA 对主流 VLA 做了一次"范式手术"——既然执行层的任务指令已经明确,每次动作预测为什么还要跑一遍大语言模型?
2.2 要解决的问题
主流 VLA(OpenVLA、π0 等)采用 V→L→A 通路:视觉特征先投影到 LLM 的词向量空间,与指令 token 拼接后一起过 LLM,再解码成动作。LLM 在这里是感知与动作之间的"中央接口",但每次策略调用都要付出十亿参数级的计算与显存代价。
2.3 思路流程与框架
TurboVLA 把通路重构为 V+L→A 直接映射。官方框架图(论文 Figure 3):
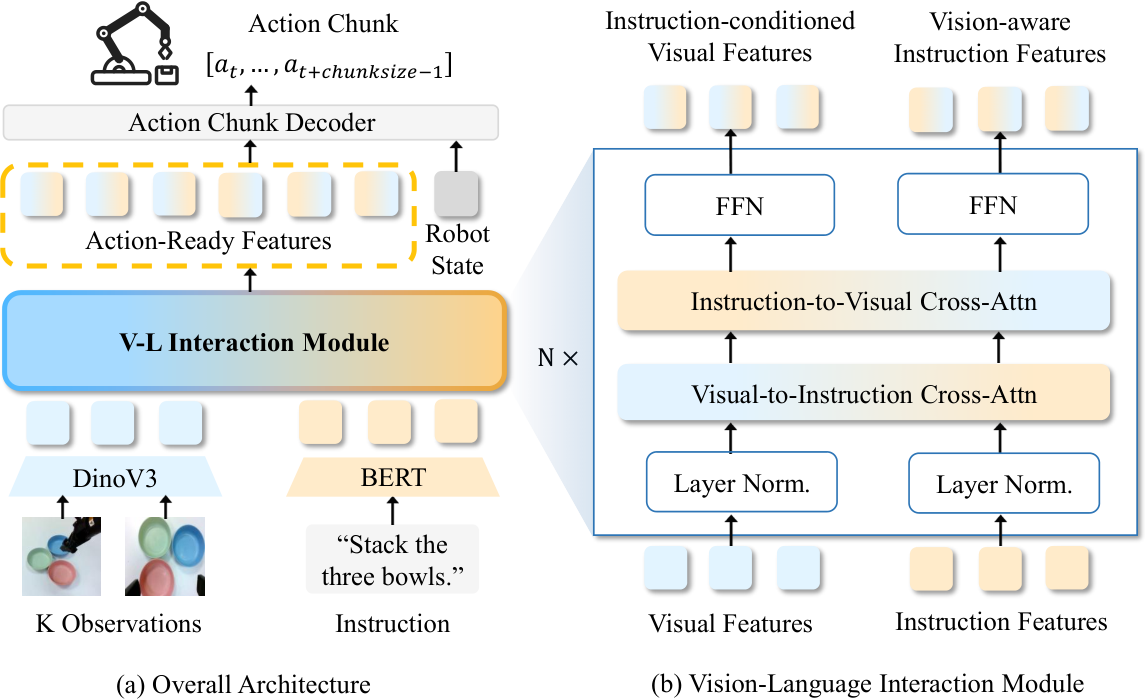
图:左为 V+L→A 总体管线——DINOv3 视觉特征与 BERT 指令特征经双向交互模块融合后,由 ACT 式解码器单次前向输出动作块;右为双向视觉-语言交互模块的层结构。
用 mermaid 重绘的数据流如下:
【重点】三个关键设计:
- 轻量双向交互替代 LLM:N=6 层堆叠的双向交叉注意力——视觉特征"查询"指令定位目标,指令特征"查询"场景完成接地(grounding)。消融显示层数从 2→6 成功率从 93.5% 稳步升至 97.7%,N=8 反而略降(96.6%);
- 非自回归并行解码:ACT 风格解码器用 H 个可学习 action query 一次前向输出整个动作块,无动作 token 化、无逐词生成;动作视界 H=12 最优(H=8 时 96.4%,H=15 时降至 95.6%);
- 训练极简:纯行为克隆 + L1 损失,无需任何辅助语言建模目标。
2.4 实验结果
【重点】LIBERO 基准:仅 0.2B 参数(约为 π0.5 的 6%),平均成功率 97.7%,匹配甚至超越参数量大一个数量级的 VLA 系统。
【重点】效率(RTX 4090):
| 指标 | 数值 |
|---|---|
| 端到端策略延迟 | 31.2 ms(≈32 Hz 在线动作预测) |
| 推理显存 | 0.9 GB(<1 GB) |
| 参数量 | 0.2B |
此外在 RoboTwin 双臂任务与真机任务(叠碗、抓取滚筒等)上保持有效。依赖的外部资产:DINOv3(LIBERO 用 ViT-B,RoboTwin 用 ViT-L)、BERT-base、GroundingDINO Swin-T。
2.5 开源使用说明
git clone https://github.com/H-EmbodVis/TurboVLA.git
cd TurboVLA
# LIBERO 与 RoboTwin 建议分开建 Python 3.10 环境
pip install torch==2.3.1 torchvision==0.18.1 --index-url https://download.pytorch.org/whl/cu121
pip install -e ".[libero]"
# 下载官方权重
hf download H-EmbodVis/TurboVLA --local-dir pretrained/TurboVLA
一条命令即可在指定 suite 上评测(experiments/libero/evaluate.py,支持 bf16)。TODO 列表中还包括对华为昇腾 NPU 的支持。
2.6 亮点与局限
- ✅ 亮点:证明了执行级控制不必以 LLM 为中心;参数/显存/延迟三项同时降一个数量级而性能不降;设计简单、可复现性强。
- ⚠️ 局限:放弃了 LLM 的开放世界知识与推理能力,对长尾语义指令、需要多步推理的任务可能受限——这恰好是下一篇 CoTinyVLA 想补的东西。
三、CoTinyVLA:用结构化监督代替堆参数
3.1 简介
| 项目 | 内容 |
|---|---|
| 论文 | CoTinyVLA: Chain-of-Thought Distillation for a Sub-Billion-Parameter Vision-Language-Action Model(arXiv:2607.25487,2026.07) |
| 代码 | https://github.com/BrainJellyPie/CoTinyVLA |
| 权重 | Hugging Face euphoria-64/CoTinyVLA-Qwen3.5-0.8B |
| 骨干 | Qwen3.5-0.8B |
一句话:LIBERO-Plus 鲁棒性榜单上的领先者都在用 3B~7B 骨干,CoTinyVLA 证明把监督信号结构化,0.9B 也能反超。
3.2 思路流程与框架
官方框架图(论文 Figure 1):
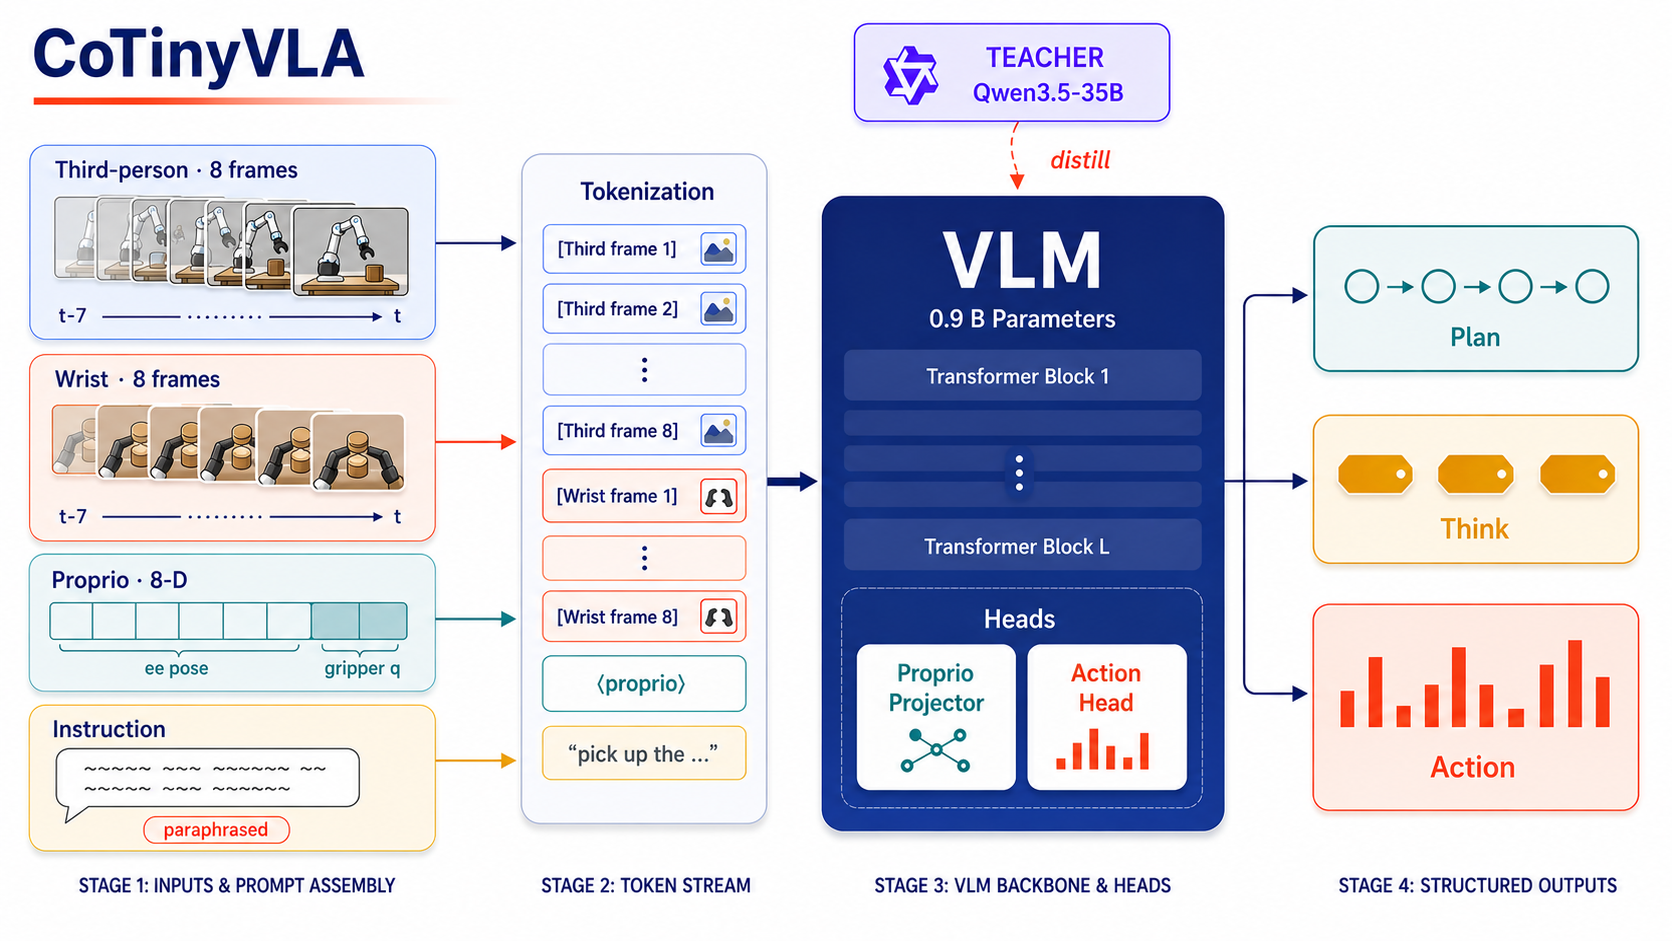
图:四阶段管线——多模态输入装配(双视角 16 帧历史 + 相机/时间文本标记)→ 层级 CoT(回合级 Plan + 块级 Think)→ 视觉-语言推理与本体投影 → 动作头输出 8 步 chunk。
三大组件的思维导图:
三个组件分别瞄准不同的问题轴:时序输入解决"看不清物理状态",CoT 蒸馏解决"不会推理",复述增广解决"听不懂换一种说法"。推理时流程为:观测 → 生成 Plan/Think 推理 span → 视觉-语言推理 → 本体投影器 → 动作头输出 8 步 chunk。
3.3 实验结果
【重点】LIBERO-Plus(10,030 个扰动任务、7 个扰动维度、每任务 1 次 rollout):
| 模型 | 参数 | Spatial | Object | Goal | Long | 平均 |
|---|---|---|---|---|---|---|
| π0 | 3.3B | 60.7 | 61.4 | 44.9 | 48.4 | 53.9 |
| OpenVLA-OFT | 7B | 84.0 | 66.5 | 63.0 | 66.4 | 70.0 |
| OpenVLA-OFT+ | 7B | 86.1 | 84.5 | 70.7 | 77.7 | 79.8 |
| CoTinyVLA | 0.9B | 90.8 | 87.3 | 86.6 | 80.7 | 86.4 |
四个套件分别领先最强 7B 基线 +4.7 / +2.8 / +15.9 / +3.0 分,且所有置信区间不含零。参数量只有对手的约 1/8。在标准 LIBERO 上平均 97.5%,与最强 7B 持平、比最强亚十亿参数基线高 2.7 分。
【重点】最硬的增益在"机器人初始状态"扰动上:11 个已发布基线在该维度没有任何一个超过 53.2%,而 CoTinyVLA 在 Goal 套件达到 73.6%(最强基线仅 39.9%)——时序帧输入 + CoT 的组合显著改善了物理状态感知。
闭环推理画像(L40S,每卡 3 路并发 rollout):
| 属性 | 数值 |
|---|---|
| 峰值显存 | 2.25 GiB |
| 回合初始延迟 | 2.76 s |
| 稳态延迟 | 1.37 s / 8 步 chunk |
| 每 chunk 推理 token | 26 个 |
| Plan 缓存收益 | 稳态延迟 -48.5%,推理 token -63.2%(成功率不变) |
测试时干预实验(权重冻结,只改输入)非常有说服力:把 Plan 换成空白/矛盾文本,成功率掉 40~45 分;移除推理 span 直接归零;而礼貌前缀、训练集复述零影响——说明性能确实由"推理内容"支撑,而非语言风格。
3.4 开源使用说明
仓库提供完整管线:数据转换(convert_libero_plus.py)→ 推理标签生成(vLLM + Qwen3.5-35B-A3B-GPTQ-Int4 教师)→ 训练(torchrun 8 卡,--lm_loss_weight 0.1)→ 推理与多 GPU 动态评测(SQLite 队列分配任务、断点续评)。评测代码把 LIBERO-Plus 挂为 libero_plus.libero 独立命名空间,可与标准 LIBERO 共存于同一环境。
3.5 亮点与局限
- ✅ 亮点:提出"监督结构 > 参数规模"的强证据;干预实验严谨地证明了推理链是承重墙而非装饰;2.25 GiB 峰值显存对嵌入式部署友好。
- ⚠️ 局限:稳态 1.37 s/chunk 的延迟尚谈不上"实时";训练依赖 35B 教师生成监督,数据管线成本不低。
四、vla.cpp:一个 C++ 运行时统一七种 VLA
4.1 简介
| 项目 | 内容 |
|---|---|
| 论文 | vla.cpp: A Unified Inference Runtime for Vision-Language-Action Models(arXiv:2606.08094,2026.06) |
| 团队 | VinRobotics、TU Darmstadt、马普智能系统研究所、斯图加特大学、DFKI 等 |
| 项目页/Demo | https://fai-modelopt-tech.github.io/vla-cpp.github.io/ |
| 生态 | 构建于 llama.cpp / ggml 之上,Hugging Face vrfai(VinRobotics) |
一句话:VLA 策略几乎都以"假设工作站级 GPU 的 Python/PyTorch 技术栈"发布,而机器人本体通常是 8 GB 统一内存的 Jetson——vla.cpp 填的就是这个部署鸿沟。
4.2 思路流程与框架
【重点】它是首个原生支持 flow-matching/扩散 VLA 推理模式的 ggml 类引擎:缓存的视觉-语言前缀(prefix)被交叉注意力的动作专家在多个求解器步上反复消费。一个二进制、一套请求/响应协议、一种 bundle 格式,服务 7 种架构、5 种骨干、4 类动作头:
| 模型 | 视觉骨干 | 语言骨干 | 动作头 | 参数 | 求解步数 T |
|---|---|---|---|---|---|
| SmolVLA | SigLIP-So400m | SmolLM2-360M | FM 交叉注意力专家 | 450M | 10 |
| Evo-1 | InternViT-300M | Qwen2.5-0.5B | 交叉注意力 DiT | 770M | 32 |
| BitVLA | BitSigLIP-L | BitNet-2B | MLP 回归(单趟无循环) | 2.4B | – |
| π0 | SigLIP-So400m | Gemma-2B | FM 联合注意力专家 | 3B | 10 |
| GR00T-N1.5/1.6 | SigLIP2-400M | Qwen3-1.7B | AltVL DiT | 3B | 4 |
| GR00T-N1.7 | Qwen3-VL ViT | Qwen3-VL | AltVL DiT | 3B | 4 |
官方系统架构图(论文 Figure 1):
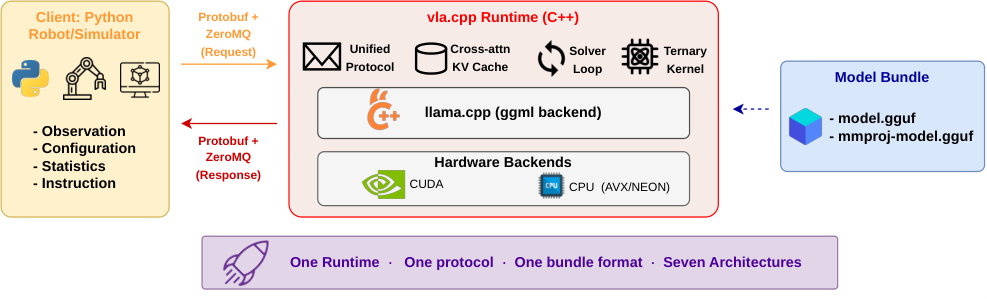
图:无状态 C++ 服务器加载一个 GGUF bundle,对每条 Protobuf 观测执行 VLA 推理,经 ZeroMQ 返回反归一化的动作块;轻量 Python 客户端持有闭环控制,可驱动模拟器或真实机器人。
用 mermaid 重绘如下:
从 VLM 运行时到 VLA 运行时要补四个缺口(论文 Appendix A):暴露 LM 完整隐状态作交叉注意力源、前缀用双向掩码编码、显式的跨注意力缓存生命周期、以及用模型自带统计量反归一化动作——每一项都是"静默出错"的高发区。
4.3 实验结果
行为保真:LIBERO-Object 全套件(10 任务 × 20 回合 = 200 回合/架构),七种架构均复现参考 checkpoint 行为,差距在一个回合以内;BitVLA 200/200 满分,常驻内存仅 1.3 GiB。
【重点】对 PyTorch 参考实现的加速(同权重、同 BF16、同模拟器):
- SmolVLA:每环境步 28.16 ms vs 223.96 ms = 7.95× 加速,峰值显存基本持平(1410 vs 1406 MiB)——PyTorch eager 的主机端 kernel 发射开销让算力大量空转,vla.cpp 继承 llama.cpp 的静态图一次捕获、逐次回放;
- 跨硬件每步延迟(ms)与 8 GB Orin Nano 峰值 RSS:
| 模型 | RTX 3060 | AGX Orin | Orin Nano | Nano 峰值 RSS |
|---|---|---|---|---|
| SmolVLA | 28.16 | 65.41 | 141.81 | 2031 MiB |
| BitVLA | 37.85 | 101.11 | 355.65 | 2199 MiB |
| Evo-1 | 63.60 | 131.01 | 458.84 | 2135 MiB |
| GR00T-N1.5 | 14.17 | 28.78 | 84.76† | 5975 MiB |
| π0 | 9.74 | 27.90 | 39.10† | 6068 MiB |
| GR00T-N1.6/1.7 | ~10.3 | ~26.8 | 装不下 | — |
† 模拟器需卸载到另一台机器。【重点】8 GB 模块上 7 个架构只有 5 个能加载——决定能否部署的是显存容量而非延迟。
Roofline 洞见:batch-1 VLA 前向由高算力强度的视觉-语言前缀主导(compute-bound),低 token 数的动作专家是 memory-bound;因此部署杠杆是算力利用率 + 内存容量,而不是带宽。据此把 BitVLA 的三元 W2A8 矩阵乘从 dp4a(CUDA 核)迁到 IMMA 张量核:RTX 3060 每步 172.8→37.85 ms(4.6×)、AGX Orin 406.6→101.11 ms(4.0×),输出逐比特一致、成功率不变。
真机压力测试(ALOHA 臂 + GR00T-N1.6):同 checkpoint 同模块,vla.cpp 每 chunk 推理 ≈470 ms vs PyTorch ≈620 ms,闭环成功率 87.5% vs 40.0%(95% Wilson 区间不重叠)——每次重规划的观测新鲜约 150 ms,优势在长程任务上复利。
一个值得所有部署者警惕的发现:视觉塔的位置编码索引在 FP32/FP16 下舍入不同,会选错几乎每个 patch 的嵌入行,动作块偏移最高 ≈1.97(归一化单位,约 2σ,集中在夹爪通道)——任务直接失败且无任何报错;flow matching 的多步积分会把扰动放大而非抵消。vla.cpp 的对策是构建期逐块数值对齐门禁(fail-loud)。
4.4 开源使用说明
每个模型打包为自包含 GGUF bundle(语言模型+动作头+归一化统计+架构配置,视觉编码器内嵌或以 mmproj 伴随文件提供);服务端无状态、C++ 常驻加载,客户端 Python 负责闭环控制,ZeroMQ+Protobuf 传输,同一引擎不改代码驱动模拟器或真实机器人。当前支持 CUDA 与 CPU 后端,结构上可扩展至移动 NPU。
4.5 亮点与局限
- ✅ 亮点:第一个把 7 种异构 VLA 收进单一自包含二进制的运行时;"compute-bound 前缀 / memory-bound 专家"的测量结论与 IMMA 核增益有普适指导意义;数值对齐门禁是工程教科书级实践。
- ⚠️ 局限:无动态权重换入换出机制,大模型在 8 GB Nano 上仍装不下;原生低比特量化目前仅覆盖 BitVLA 的三元配置。
五、Reflex:把 Flow Matching VLA 变成流式系统
5.1 简介
| 项目 | 内容 |
|---|---|
| 论文 | Reflex: Real-Time VLA Control through Streaming Inference(ICML 2026,arXiv:2607.14695) |
| 团队 | 北京邮电大学计算机学院 |
| 代码 | https://github.com/9yc/Reflex |
| 验证模型 | π0.5(2.3B)、π0(3.1B)、SmolVLA(500M) |
一句话:瓶颈不在于单次推理多慢,而在于同步等待让机器人停下来思考——Reflex 不重训模型,而是把整个服务环路重构为异步流式架构。
5.2 要解决的问题
Flow matching VLA 的迭代去噪与实时控制存在根本冲突:全局时间步注入使 KV 缓存失效——去噪步 k 变了,所有层的内部状态都跟着变,缓存立即作废,只能在"慢到不可用的 O(N²) 重算"和"数学上错误的缓存复用"之间二选一。论文实测朴素 KV 缓存会产生 MSE>1.0 的灾难性误差和任务全败。
5.3 思路流程与框架
核心洞察是 Timestep-Invariance Property(时间步不变性):感知编码器在功能上独立于去噪循环(∂Enc/∂t_k=0)。官方系统架构图(论文 Figure 3):
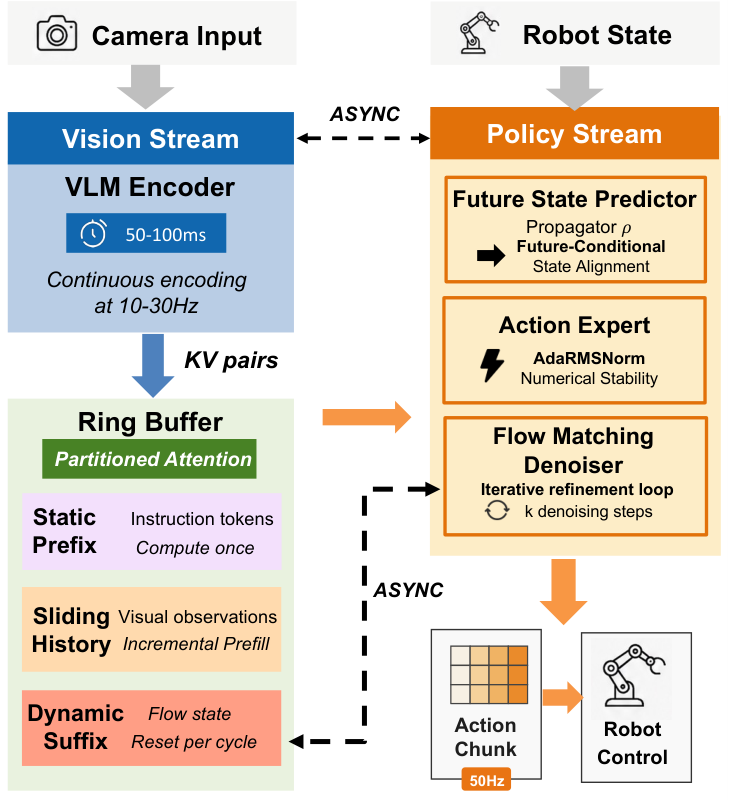
图:视觉流(10–30 Hz)持续编码观测写入三分区环形缓冲区;策略流(50 Hz)经未来状态预测器、动作专家(AdaRMSNorm)与 Flow Matching 去噪器输出动作块;两流异步交换 KV。
据此 Reflex 有三大组件:
- 分区注意力(Partitioned Attention)——正确性:上下文切成静态前缀/滑动历史/动态后缀三区,只有动态后缀每个去噪步需要重算,实现 O(1) 增量缓存更新;在固定观测窗口与固定输入下输出与全批注意力完全等价(实测 MSE=0.00,附录给出证明)。配套"手动缓存合并":进入去噪循环前把前缀与历史合并为连续显存,消除高频循环里的
torch.cat分配; - AdaRMSNorm——稳定性:50 Hz 连续运行让模型接触高方差初始噪声的频率是离线训练的 50 倍,标准 BFloat16 RMSNorm 在 120~220 步后数值崩溃。AdaRMSNorm 用 FP32 计算 RMS 统计 + BF16 门控 MLP(以 flow 相位与本体状态为条件),代价远低于全 FP32 归一化,实现 >2000 步无 NaN/Inf 的无限时域流式推理;
- 异步流水线——吞吐:视觉线程做"生产者"持续编码推 KV,策略线程做"消费者"查询最新缓存生成动作;未来状态预测用最近一次指令动作近似未来状态(ŝ_{t+Δ}≈a_t^cmd,100 ms 前瞻内末端偏差 ❤️ cm);自适应重叠调度按实测延迟动态调整提前量 K。底层再配合算子融合(QKV 打包、SwiGLU Gate+Up 合并、FlashNorm、FusedAdaLN,每层 kernel 发射减半、动作专家前向延迟 -18%)与静态环形缓冲区(24/7 运行零动态分配)。
5.4 实验结果
【重点】效率(RTX 4090,上下文窗口 K=10):
| 指标 | 数值 |
|---|---|
| 推理加速(π0.5, LIBERO) | 135.2 ms → 52.4 ms(2.58×) |
| 推理加速(π0, 3.1B) | 2.73×(规模越大收益越大) |
| 推理加速(SmolVLA 500M) | 2.29×(架构无关) |
| 峰值 VRAM | LIBERO -27%、Kinetix -24%(内存占用变平) |
| 反应延迟 | 最高 -54%(151.9→82.5 ms) |
| 停顿率 | 同步基线 100% → 0% |
| 控制频率 | 稳定 50 Hz 流式 |
任务性能:LIBERO 与同步基线持平(Long 套件 +3.6%/+4.0%);动态物理基准 Kinetix 上 +7.4%(π0.5)/ +6.7%(π0)——低延迟在动态场景直接转化为成功率。真机 AgileX PiPer 三任务 180 回合:成功率 +11/+14/+17 pp,反应延迟 101~110 ms、0% 停顿。
5.5 开源使用说明
代码位于 GitHub 9yc/Reflex。实现要点(附录 B/C):StreamingInputManager 管理缓存逐出与位置 ID;环形缓冲区在模型加载时一次性预分配;AdaRMSNorm 的门控 MLP 为单隐层 SiLU 结构;评测协议为 LIBERO 每套件 10 任务 × 50 回合、Kinetix 每任务 100 回合,延迟报 95 分位。
5.6 亮点与局限
- ✅ 亮点:把"加速单个推理步"的范式升级为"流式异步执行";分区注意力的等价性有证明且实测 MSE=0;AdaRMSNorm 揭示了无限时域部署独有的数值稳定性问题;纯系统侧改造,不重训、不掉点。
- ⚠️ 局限:仅适用于感知编码器时间步不变的架构(统一 DiT 式、时间步进入视觉编码器的模型不在范围内);未来状态预测是一阶近似启发式,非学习模型。
六、Evo-Depth:给轻量 VLA 补上"空间感"
6.1 简介
| 项目 | 内容 |
|---|---|
| 论文 | Evo-Depth: A Lightweight Depth-Enhanced Vision-Language-Action Model(arXiv:2605.14950,2026.05) |
| 团队 | 上海交通大学 MINT 实验室(Evo-1 同团队) |
| 代码 | https://github.com/MINT-SJTU/Evo-Depth |
| 权重 | HF:MINT-SJTU/EVO-Depth-LIBERO、EVO-Depth-MetaWorld、EVO-Depth-Arena |
一句话:纯 2D 的 VLA 在精确定位、精细放置、遮挡判断上成功率显著下滑;显式 3D 方案依赖深度传感器且对标定敏感——Evo-Depth 走中间路线:从多视角 RGB 隐式学深度,不加任何硬件。
6.2 思路流程与框架
官方架构图(仓库 Evo_depth/assets/model_overview.png,已本地化):
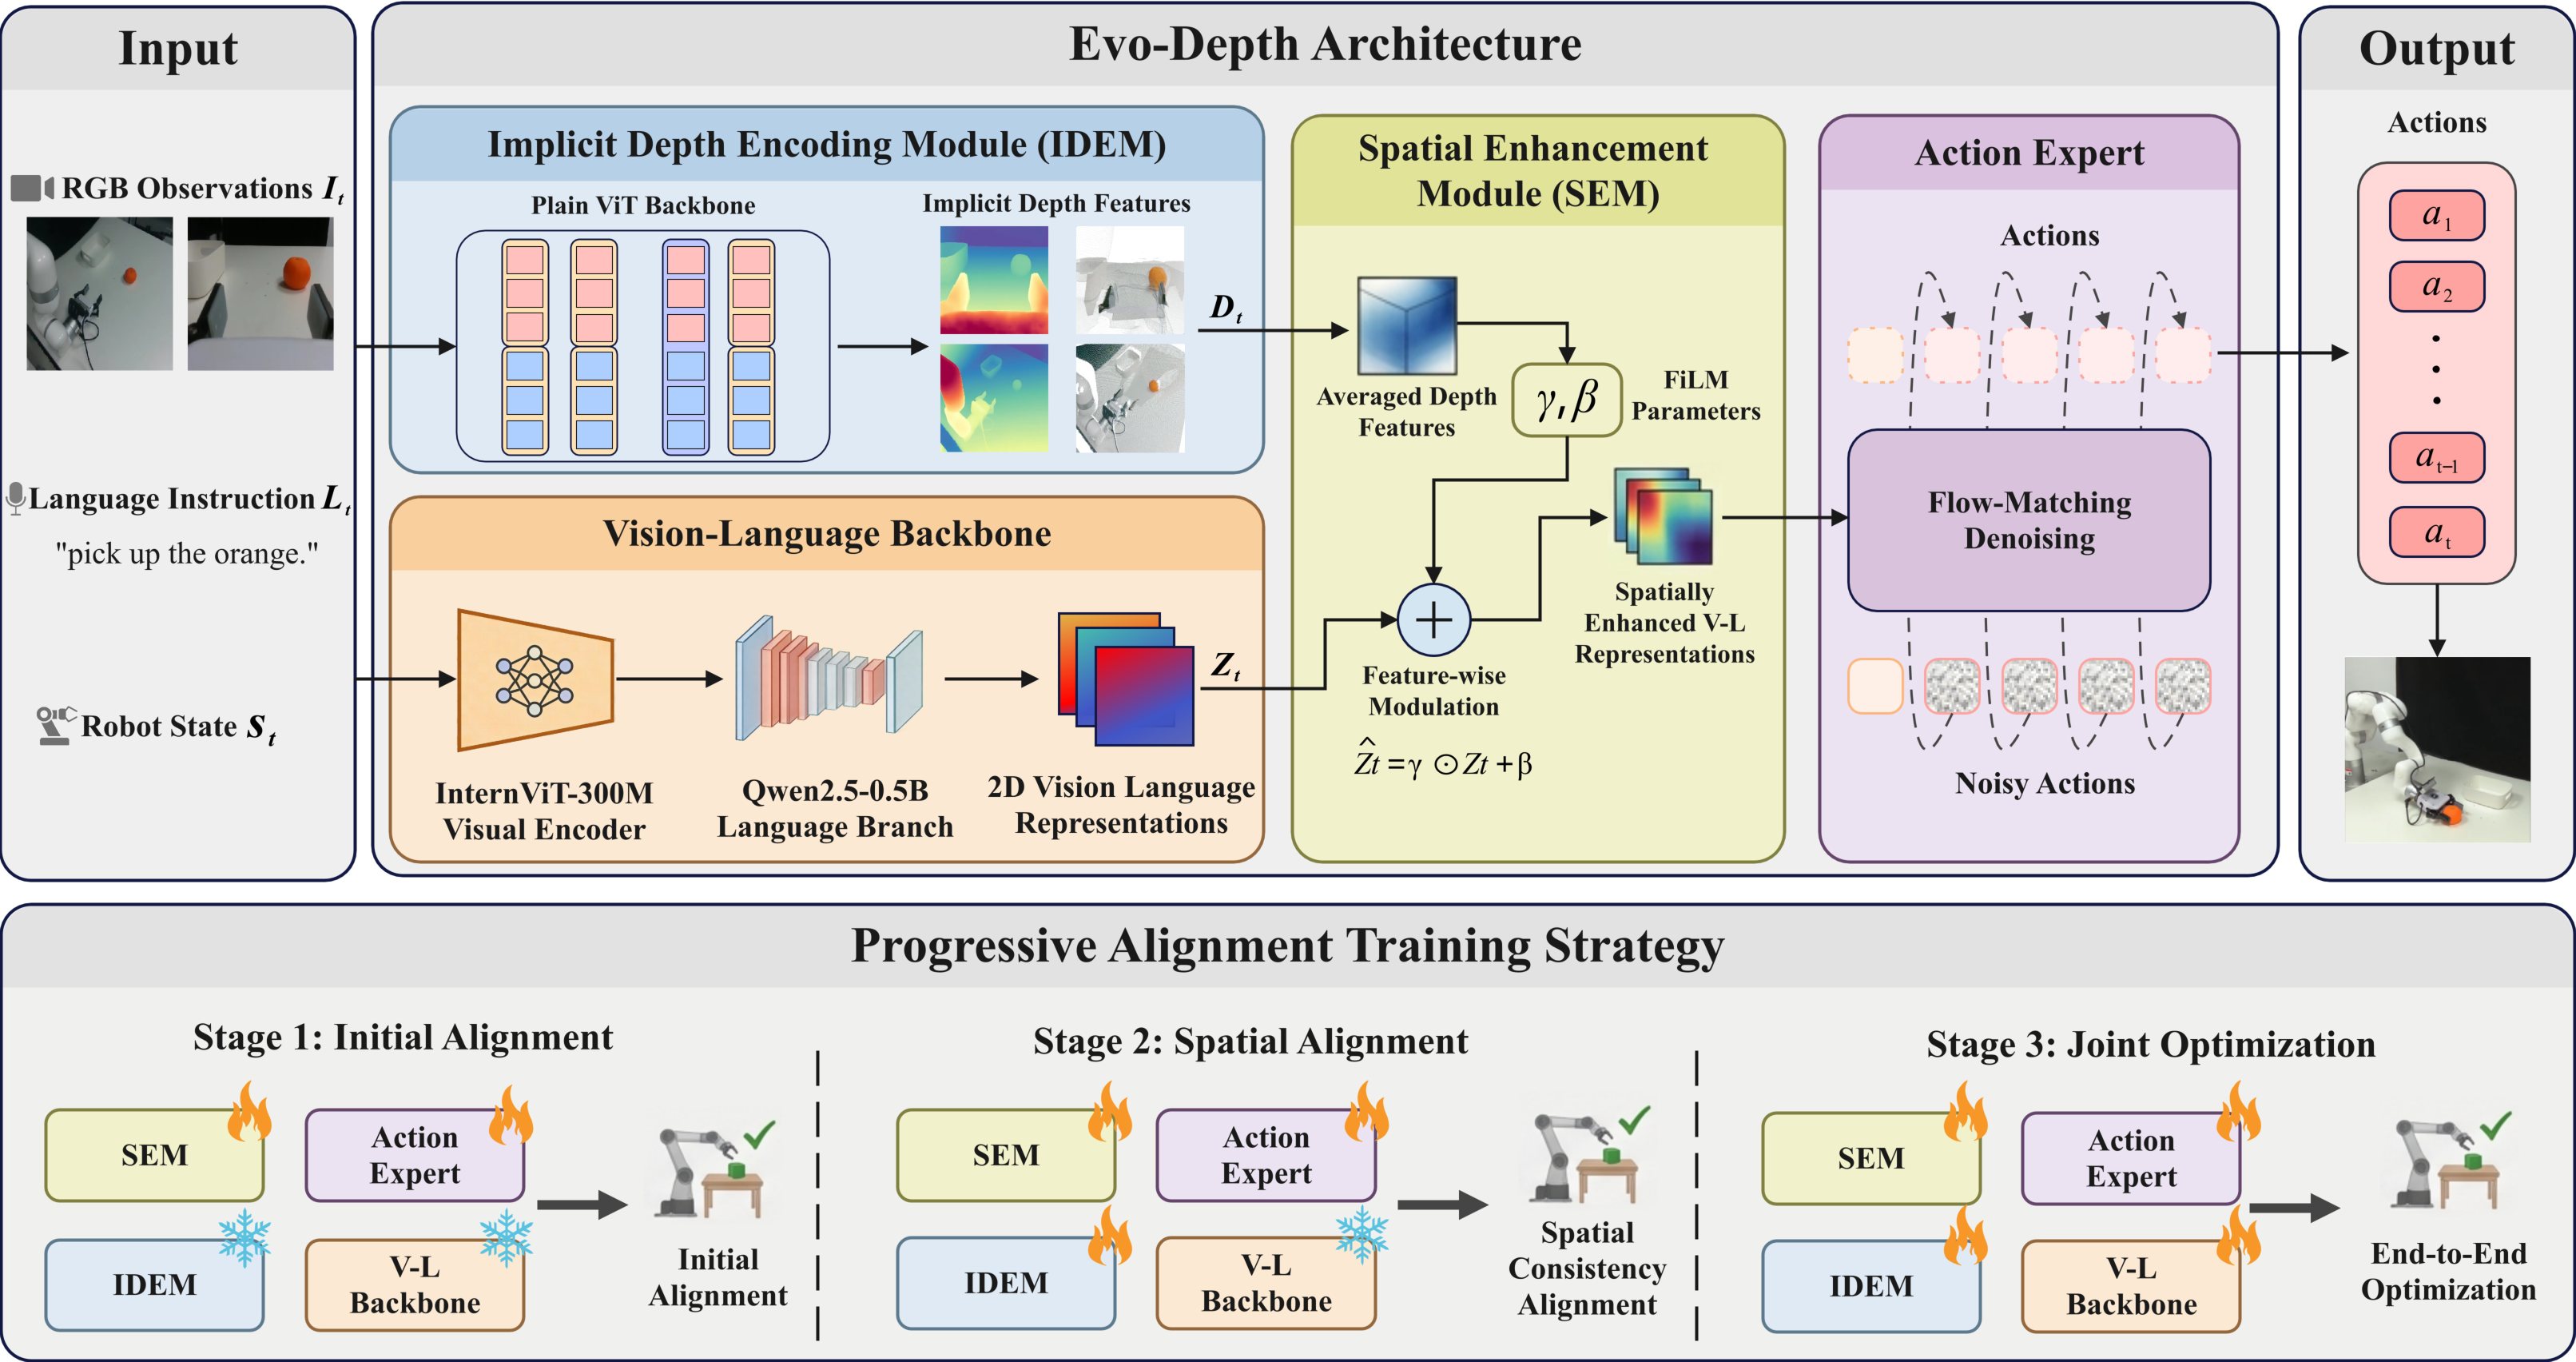
图:上半部分为模型架构——IDEM 提取隐式深度、SEM 以 FiLM 调制视觉-语言表征、Flow-Matching 动作专家输出动作块;下半部分为三阶段渐进对齐训练策略。
用 mermaid 重绘的数据流如下:
【重点】三个设计决策:
- IDEM(隐式深度编码模块):约 0.13B 的轻量 ViT,从多视角 RGB 提取紧凑深度特征,以 Depth Anything 3 的多视角深度预训练初始化——强调空间布局与相对几何关系,不生成高成本的显式 3D 中间表示;
- SEM(空间增强模块):把深度特征作为 FiLM 调制信号(Ẑ=γ⊙Z+β)注入视觉-语言表征,而非对称拼接。消融证明:拼接(Concat)明显最差,交叉注意力与 SEM 接近,SEM 最好——调制式注入既保留 2D 表征的主导地位,又补进空间信号;
- 渐进对齐训练(三阶段):Stage 1 只训 SEM+动作专家(冻骨干与 IDEM)→ Stage 2 解冻 IDEM 做空间对齐 → Stage 3 全模块端到端联合优化。消融显示三阶段 > 两阶段 > 单阶段,渐进对齐显著优于直接联合训练。
6.3 实验结果
仿真(0.9B 参数):
| 基准 | 成绩 | 说明 |
|---|---|---|
| Meta-World MT50 | 84.4% | SOTA,medium/hard/very hard 各难度档均最佳 |
| LIBERO | 95.4% | 各套件均衡 |
| LIBERO-Plus | 69.6% | 多扰动维度稳健 |
| VLA-Arena | 41.1% | 干扰物与长程设定表现突出 |
真机(xArm6,三任务:放橙子、存网球、叠杯子):平均成功率 90% 为对比方法最高,同时模型最小、显存最低(3.2 GB)、推理频率最高(12.3 Hz)(RTX 4090D 平台)。四类扰动泛化实验中全面优于基线,位置扰动与精细物体交互场景优势最大。去除 IDEM 的消融在 camera/robot/layout 三个维度掉点最明显——印证隐式深度对视角变化、本体变化、物体排布的鲁棒性贡献。
6.4 开源使用说明
仓库提供统一的 websocket 推理服务器(默认端口 9000)+ LIBERO / LIBERO-Plus / MetaWorld MT50 / VLA-Arena 四套评测客户端;预训练权重按基准分三个 HF 仓库发布;训练侧支持 LeRobot v2.1 格式自定义数据,train.sh 内置完整三阶段渐进对齐配方(Accelerate + DeepSpeed 多卡)。
6.5 亮点与局限
- ✅ 亮点:在"无 3D 硬件"与"重 3D 表征"之间找到实用甜点;部署指标(3.2 GB / 12.3 Hz)与成功率同时公开,工程参考价值高;消融完整(模块、训练阶段、融合策略三组)。
- ⚠️ 局限:12.3 Hz 离高动态任务还有距离;三阶段训练管线比单阶段复杂,复现成本略高。
七、总结与选型建议
7.1 全文思维导图
7.2 结语
五篇工作共同勾勒出 2026 年 VLA 工程化的清晰脉络:
- 架构上,"LLM 是否必须是动作执行的中枢"开始被认真质疑——TurboVLA 的 V+L→A 直连证明执行层可以非常轻;
- 监督上,参数规模不再是鲁棒性的唯一来源——CoTinyVLA 用结构化的推理链监督把 0.9B 推过 7B;
- 系统上,"停下思考再行动"不是 VLA 的固有属性——Reflex 证明它是可以被流式架构消除的设计选择;
- 引擎上,部署鸿沟正在被 GGUF 生态填平——vla.cpp 让七种架构从消费 GPU 一路跑到 8 GB 嵌入式模块,并留下两条普适教训:前缀 compute-bound / 专家 memory-bound、低精度部署必须数值门禁;
- 感知上,空间能力可以用很轻的方式补上——Evo-Depth 的隐式深度调制是"性能-成本-实时性"三角的实用平衡点。
对从业者的一句话建议:先想清楚瓶颈在架构、数据、系统还是部署,再选对应的工具——而且它们大多可以组合使用。
参考链接
- TurboVLA:https://arxiv.org/abs/2607.27205 | https://github.com/H-EmbodVis/TurboVLA
- CoTinyVLA:https://arxiv.org/abs/2607.25487 | https://github.com/BrainJellyPie/CoTinyVLA
- vla.cpp:https://arxiv.org/abs/2606.08094 | https://fai-modelopt-tech.github.io/vla-cpp.github.io/
- Reflex:https://arxiv.org/abs/2607.14695 | https://github.com/9yc/Reflex
- Evo-Depth:https://arxiv.org/abs/2605.14950 | https://github.com/MINT-SJTU/Evo-Depth
分享完成~

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献54条内容

所有评论(0)